Meilleurs outils d'extraction de documents
logistiques en 2026 : 9 outils testés
Nous avons testé neuf outils d'extraction de documents en soumettant les mêmes 50 documents logistiques — connaissements maritimes de sept grands transporteurs (Maersk, MSC, CMA CGM, COSCO, Hapag-Lloyd, ONE, Evergreen), lettres de transport aérien, bons de livraison camion avec signatures manuscrites et numéros de scellé, bordereaux d'expédition, factures de fret et formulaires de déclaration en douane — à chaque plateforme, en mesurant la précision au niveau des champs sur des points de données spécifiques à la logistique comme les numéros de conteneur, les codes SCAC, les codes SH, les numéros de scellé, les codes portuaires (UN/LOCODE) et les conditions de fret (FOB, CIF, FCA).
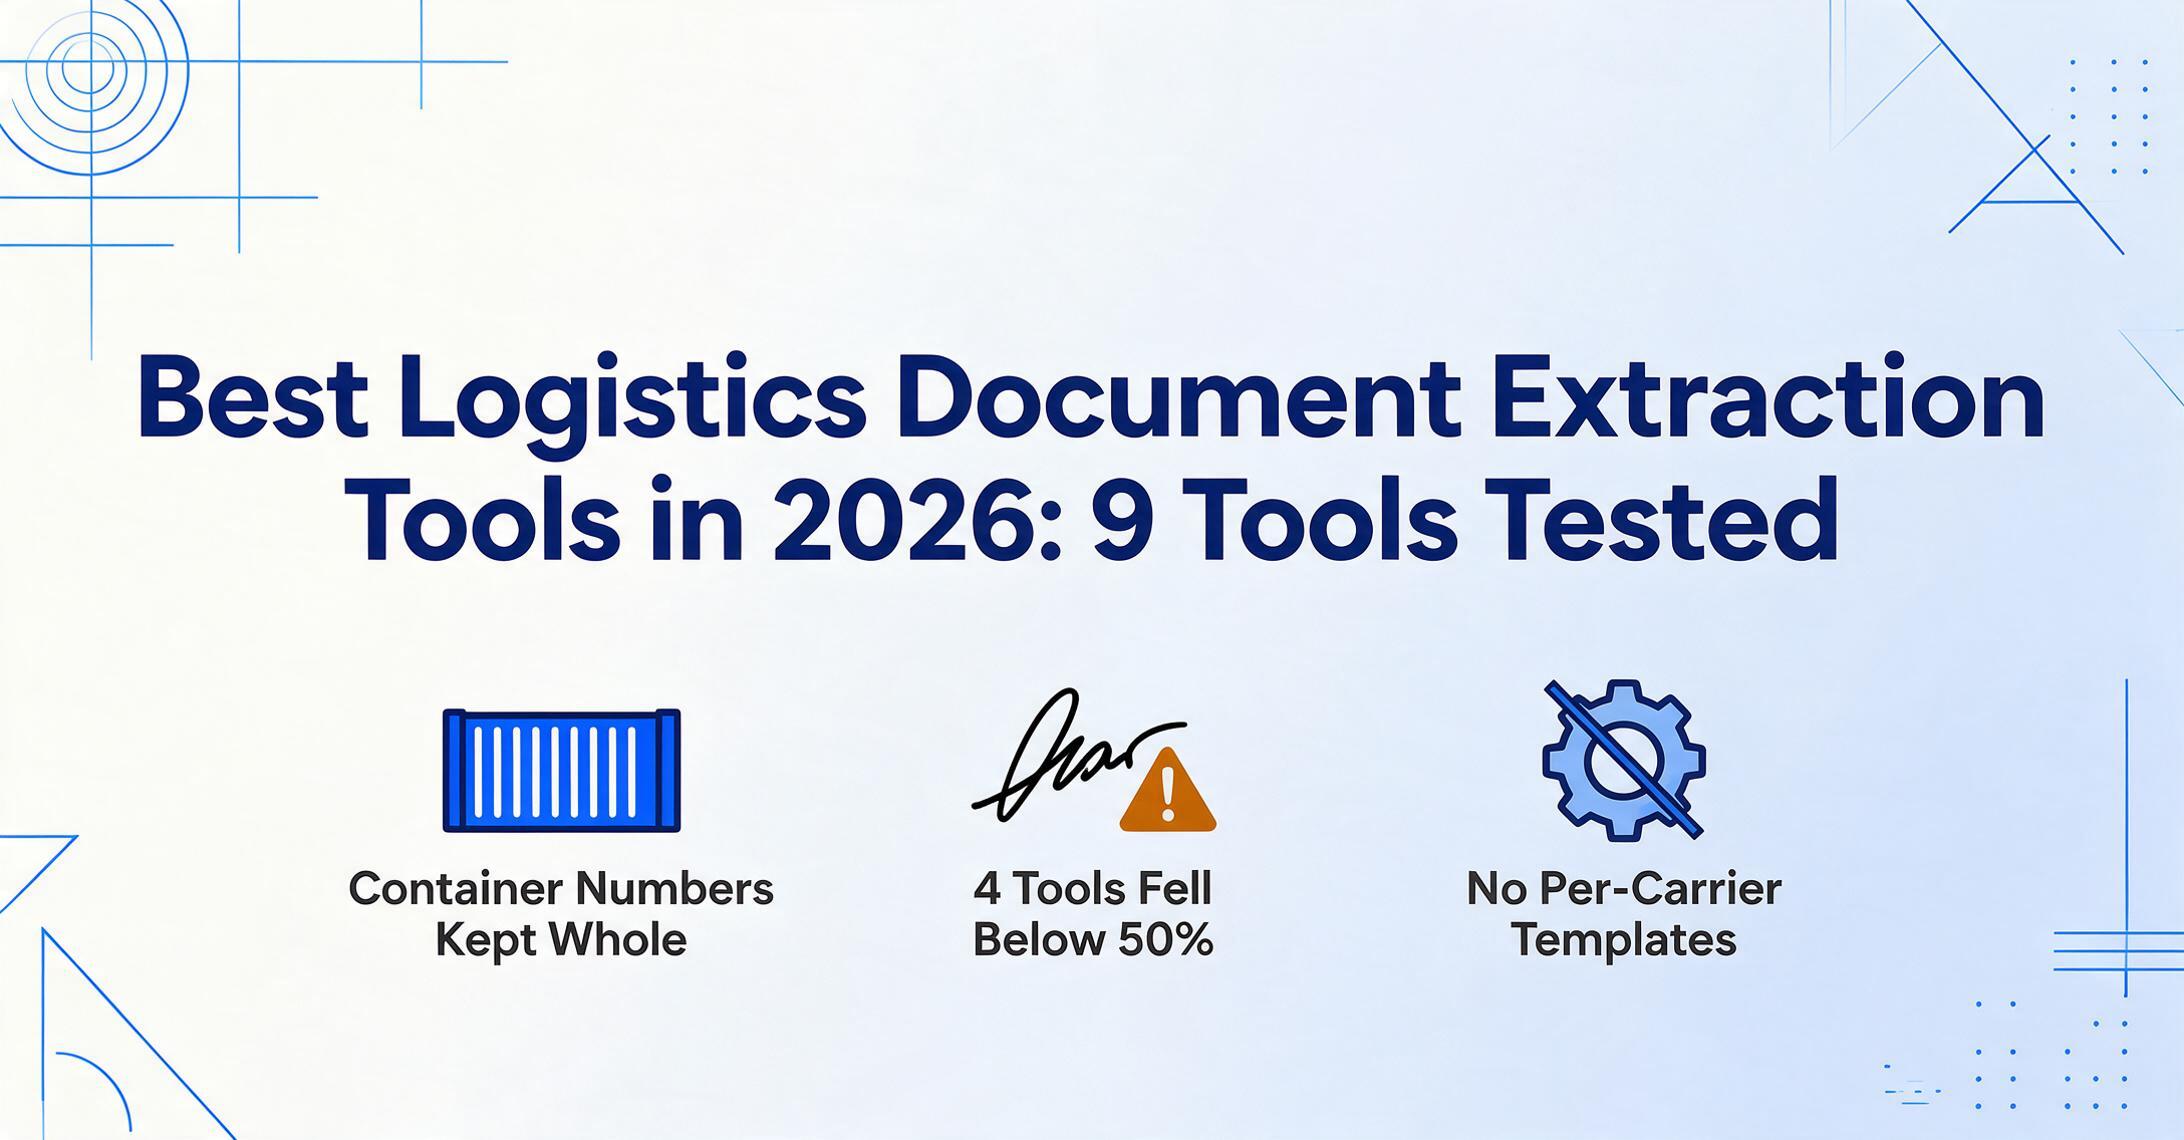
Points clés à retenir
- Huit outils sur neuf ont obtenu plus de 90 % sur un connaissement maritime propre — puis quatre sont tombés sous 50 % sur les numéros de scellé manuscrits qui déterminent si une facturation de fret est maintenue.
- Les outils d'extraction entraînés sur des factures n'échouaient pas à cause d'un mauvais OCR — leurs ensembles d'entraînement leur ont appris à trouver les totaux de factures et les noms de fournisseurs, mais ne leur ont jamais montré un code SCAC, un préfixe de numéro de conteneur ou une condition de fret, donc les outils ne savent littéralement pas que ces champs existent.
- Les trois outils qui sont restés au-dessus de 80 % sur les preuves de livraison manuscrites lisent tous les champs par signification sémantique plutôt que par coordonnées de modèle — ce qui signifie qu'un numéro de scellé griffonné dans la marge reçoit le même traitement qu'un numéro imprimé dans sa case désignée.
Divulgation : ImageToTable.ai est notre produit et apparaît dans cet avis. Nous l'avons inclus parce que nous croyons que son approche — sans modèle, basée sur l'extraction par noms de colonnes — répond à un besoin précis dans le traitement des documents logistiques. Les huit autres outils sont évalués indépendamment. Chaque lien externe utilise rel="nofollow noopener" — nous ne transmettons pas de jus de lien aux outils que nous évaluons.
Si vous travaillez dans la logistique — transit international, logistique tierce partie, courtage en douane, gestion d'entrepôt — les documents que vous traitez chaque jour n'ont presque rien en commun avec les factures qu'une équipe de comptabilité fournisseurs gère habituellement. Un connaissement maritime contient des numéros de conteneur, des noms de navires, des codes portuaires, des conditions de fret, des codes SCAC et des numéros de scellé qui n'ont aucun équivalent sur une facture fournisseur. Une preuve de livraison arrive avec des signatures manuscrites et des annotations griffonnées dans les marges. Une facture de fret détaille les frais par classe NMFC, codes accessoires et pourcentages de surcharge carburant. Et tous ces documents arrivent dans des formats qui varient selon le transporteur, la compagnie maritime, le pays d'origine et le mode de transport.
Les outils d'extraction qui dominent les comparatifs généralistes — conçus et entraînés sur des factures fournisseurs, des reçus et des formulaires fiscaux — manquent souvent complètement ces champs spécifiques à la logistique, ou les renvoient dans des formats qui créent plus de travail de nettoyage qu'ils n'en font gagner. Ce guide teste neuf outils spécifiquement sur les types de documents et de champs que les opérations logistiques traitent réellement.
Comment nous avons testé : 50 documents logistiques, 4 catégories de documents, 9 outils
Chaque outil a été testé via son essai gratuit, sa démo ou son offre en libre-service. Aucun fournisseur n'a été prévenu à l'avance. Nous avons testé chaque document individuellement — et non par appels API par lots — afin de mesurer l'expérience prête à l'emploi qu'un coordinateur logistique ou un responsable des opérations de transitaire rencontrerait.
Le jeu de test de 50 documents se répartissait comme suit :
- 12 connaissements maritimes — couvrant Maersk, MSC, CMA CGM, COSCO, Hapag-Lloyd, ONE et Evergreen. Incluant des connaissements nominatifs (originaux), des connaissements multimodaux couvrant le transport maritime + terrestre, ainsi que des formats de connaissement maître (MBL) et de connaissement maison (HBL). Cinq des douze documents comportaient des annotations manuscrites tamponnées — corrections de numéros de scellé, ajustements de poids de conteneur et ordres de changement de destinataire — écrites par-dessus le texte imprimé.
- 8 lettres de transport aérien — couvrant les services express (FedEx Express, DHL) et les combinaisons MAWB/HAWB de transitaire. Incluant un scan de faible qualité d'une LTA imprimée thermiquement avec un texte flou.
- 12 bons de livraison et preuves de livraison (POD) — confirmations de livraison de transporteurs routiers avec des lignes imprimées et des champs manuscrits : signatures, horodatages de livraison, mentions de dommages (« 1 carton écrasé — refusé ») et annotations de quantités partielles. C'était le type de document avec la plus forte densité d'écriture manuscrite dans le jeu de test.
- 10 bordereaux d'expédition — documents d'expédition de fournisseurs et de 3PL avec des lignes détaillées, des nombres de cartons, des numéros de suivi et des références d'expéditeur. Incluant trois documents avec des codes internationaux d'expédition (codes SH, marquages de pays d'origine).
- 8 factures de fret — factures de transporteurs LTL et de colis avec classes NMFC, frais accessoires, lignes de surcharge carburant et références croisées PRO/BOL.
Nous avons mesuré trois éléments par extraction : la précision au niveau des champs sur les champs spécifiques à la logistique (numéro de conteneur, code SCAC, code SH, numéro de scellé, code portuaire UN/LOCODE, conditions de fret), la tolérance à l'écriture manuscrite (la précision se dégradait-elle sur le contenu annoté ou manuscrit par rapport aux champs imprimés par machine ?), et l'indépendance du format (les résultats d'extraction des connaissements restaient-ils stables malgré les variations de mise en page des transporteurs, ou la précision chutait-elle lorsqu'un connaissement Maersk était suivi d'un format MSC ?).
Sur les connaissements maritimes océaniques imprimés proprement par machine provenant de grands transporteurs, huit outils sur neuf ont obtenu une précision de 90 % ou plus au niveau des champs sur les champs standard (expéditeur, destinataire, navire, ports). Sur les champs spécifiques à la logistique — cohérence du format du numéro de conteneur, extraction du code SCAC, identification des conditions de fret — les meilleurs outils sont restés au-dessus de 85 % tandis que les deux derniers sont tombés sous les 60 %. Sur les annotations manuscrites des POD, l'écart était encore plus large : trois outils ont maintenu une précision supérieure à 80 %, tandis que quatre sont tombés sous les 50 %.
Comparaison rapide : 9 outils d'extraction de documents logistiques
| Outil | Idéal pour | Tarif de départ | Champs logistiques* | Écriture manuscrite | Indépendance du format |
|---|---|---|---|---|---|
| ImageToTable.ai | Extraction sans modèle sur tous les formats de transporteurs | Offre gratuite (50 pages/mois) ; payant dès ~15 $/mois | Complet — colonnes personnalisées | Élevée (85-95 %) | Complète — extraction sémantique |
| Rossum | Logistique d'entreprise + comptabilité fournisseurs avec flux de validation humaine | ~1 500 $/mois | Solide — compétences en documents logistiques | Moyenne (70-85 %) | Bonne — l'IA cognitive s'adapte aux mises en page |
| Nanonets | Extraction API-first avec entraînement de modèles personnalisés | ~499 $/mois | Modérée — champs personnalisés par modèle entraîné | Moyenne (65-80 % avec entraînement) | Modérée — nécessite 10+ échantillons par mise en page |
| Docsumo | Flux de travail axés sur la vérification avec validation inter-documents | Dès 299 $/mois | Modérée — modèles logistiques pré-construits | Moyenne (65-80 %) | Modérée — pré-entraînée + entraînement personnalisé |
| ABBYY Vantage | Logistique mondiale avec OCR en 200+ langues | Sur mesure (généralement entreprise) | Modérée — marché de compétences Vantage | Élevée (85-90 %) | Modérée — basée sur des compétences, nécessite une configuration |
| Amazon Textract | Pipelines d'extraction personnalisés natifs AWS | Paiement à la page (~0,0015 $/page) | Basique — paires clé-valeur génériques + tableaux | Faible (50-65 %) | Modérée — l'API de mise en page détecte les tableaux |
| Docparser | Factures de transporteurs au format constant | Dès 32,50 $/mois | Faible — mappage de champs par modèle | Faible (40-55 %) | Faible — basé sur des modèles, échoue en cas de changement de format |
| FormX | Extraction pré-construite pour les documents d'expédition | Paiement à la page ; sur mesure | Modérée — modèles pré-construits pour documents d'expédition | Moyenne (60-75 %) | Modérée — extracteurs pour modèles courants |
| Parseur | Conversion d'e-mails en données structurées pour la logistique | Dès 39 $/mois | Faible — mappage de champs par modèle | Faible (35-50 %) | Faible — OCR par modèle/zone |
*Les champs spécifiques à la logistique incluent les numéros de conteneur, les codes SCAC, les codes SH, les numéros de scellé, les identifiants portuaires UN/LOCODE et les conditions de fret (FOB, CIF, FCA, etc.). « Complet » signifie que l'outil peut extraire tout champ logistique personnalisé sans préconfiguration.
ImageToTable.ai — Idéal pour l'extraction de documents logistiques indépendante du format
Idéal pour : Les équipes logistiques — transitaires, 3PL, courtiers en douane — qui traitent des documents provenant de plusieurs transporteurs et ont besoin d'un flux d'extraction unique fonctionnant sur tous les formats sans configuration par transporteur.
Moins adapté pour : Les grandes entreprises ayant besoin d'un routage d'approbation intégré, d'une orchestration de flux de travail intégrée à l'ERP, ou de files d'attente avec intervention humaine pour la gestion des exceptions à grande échelle.
ImageToTable.ai utilise ce qu'il appelle l'Extraction de colonnes personnalisées — vous saisissez les noms de colonnes à extraire (par exemple, « Numéro de conteneur », « Code SCAC », « Code SH », « Port de chargement », « Conditions de fret »), et l'IA localise ces valeurs sur n'importe quel document par compréhension sémantique plutôt que par position de pixel. C'est la distinction fondamentale avec les outils basés sur des modèles, et c'est crucial pour les opérations logistiques où un connaissement Maersk, un connaissement MSC et un connaissement COSCO partagent le même contenu informatif mais l'affichent dans des mises en page complètement différentes avec des libellés de champs différents.
Sur notre jeu de test de 50 documents, ImageToTable.ai a obtenu la plus grande précision au niveau des champs pour les champs spécifiques à la logistique — numéros de conteneur, codes SCAC, numéros de scellé, codes portuaires et conditions de fret — sans aucun pré-entraînement ni configuration de modèle par transporteur. Les preuves de livraison manuscrites ont fait la différence : les numéros de scellé manuscrits et les annotations de livraison qui ont fait chuter quatre outils de ce test sous 50 % de précision ont été extraits de manière fiable ici, car le modèle de vision sous-jacent est entraîné à différencier le texte imprimé, l'écriture manuscrite, les tampons et les marques d'annotation entrelacés sur le même document.
Un transitaire de taille moyenne que nous avons interrogé traite environ 500 connaissements par mois auprès de 15 transporteurs. Son flux de travail précédent utilisait un extracteur basé sur des modèles qui nécessitait la maintenance de 15 modèles spécifiques aux transporteurs. Lorsque Maersk a mis à jour la mise en page de son connaissement, le modèle a échoué silencieusement — les numéros de connaissement sont apparus dans la colonne de date pendant deux semaines avant que quelqu'un ne le remarque. Avec l'extraction par noms de colonnes, ils définissent les champs de sortie une seule fois, et l'IA s'adapte automatiquement aux changements de mise en page car elle lit par le sens, pas par les coordonnées.
Les fichiers sont traités en toute sécurité et ne sont pas stockés. Essayez de télécharger un bordereau d'expédition ou un connaissement pour voir le flux d'extraction.
Pour une présentation détaillée du fonctionnement de l'extraction de BOL selon les formats de transporteurs et les types de BOL — connaissement nominatif, connaissement à ordre, connaissement multimodal, connaissement maître vs. connaissement maison — consultez notre guide sur l'extraction de données de connaissement et le guide complet de l'extraction de BOL. Pour l'extraction de bordereaux d'expédition, voir qu'est-ce que l'extraction de données de bordereau d'expédition. Si vous traitez des BOL provenant de plus d'une poignée de transporteurs en une seule exécution, consultez notre guide sur l'extraction de BOL par lots auprès de plusieurs transporteurs. Pour exécuter l'extraction sur vos propres BOL — maritime, LTL ou aérien — utilisez l'outil de conversion de connaissement en Excel.
Rossum — Idéal pour le traitement de documents logistiques d'entreprise avec revue humaine
Idéal pour : Les grands transitaires et 3PL qui ont besoin d'une extraction par IA combinée à une interface de revue humaine et une intégration ERP, en particulier pour les documents logistiques qui alimentent les flux de travail AP.
Moins adapté pour : Les équipes logistiques de petite et moyenne taille avec des budgets limités — les tarifs commencent autour de 1 500 $ par mois, ce qui le rend hors de portée pour les courtiers indépendants ou les petits 3PL.
Le moteur d'IA Aurora de Rossum traite les documents logistiques — factures, BOL, listes de colisage, documents douaniers — sans configuration par modèle. Son interface de revue côte à côte document-et-données est l'une des expériences utilisateur les plus abouties du marché de l'IDP, et ses intégrations SAP, Coupa et QuickBooks en font un choix naturel pour les entreprises logistiques où la sortie documentaire alimente directement un ERP ou un TMS.
Sur les champs spécifiques à la logistique, Rossum a bien performé sur les documents de type facture comportant des totaux, des dates et des références fournisseur. La documentation logistique de la plateforme met en avant le point d'expédition, le groupe de chargement et le type de livraison comme champs cibles. Dans nos tests, les numéros de conteneur et les codes SCAC ont été extraits de manière fiable à partir de PDF de BOL propres, mais leur précision a chuté sur les documents comportant des annotations manuscrites sur le champ du numéro de conteneur — l'interface de revue humaine les détecte, mais cela signifie que le taux d'automatisation est inférieur à ce que suggère la précision d'extraction brute pour les applications logistiques.
Le port de Rotterdam et Wolt sont cités comme clients logistiques. L'architecture cloud-native de la plateforme et ses intégrations avec les principaux ERP la rendent viable pour les opérations logistiques d'entreprise, mais les tarifs mensuels et la tarification au volume de documents ne diminuent pas de manière progressive pour les équipes logistiques plus petites.
Nanonets — Idéal pour l'extraction de documents logistiques axée sur l'API avec formation personnalisée
Idéal pour : Les entreprises de logistique disposant d'équipes de développement internes qui souhaitent former des modèles d'extraction personnalisés pour des formats de transporteurs ou des types de documents spécifiques et intégrer via API.
Moins adapté pour : Les équipes opérationnelles logistiques sans ressources techniques dédiées — la configuration nécessite une intégration API, l'étiquetage d'échantillons et la formation de modèles par type de document.
Nanonets prend en charge plus de 300 types de documents pré-entraînés et propose une formation de modèles personnalisés avec seulement 10 documents d'échantillon. Pour une opération logistique qui traite le même format de connaissement COSCO des milliers de fois par mois, la formation d'un modèle dédié pourrait produire une grande précision. Mais la diversité des documents logistiques va à l'encontre de cette approche : un transitaire gérant 15 transporteurs voit 15 formats, et un modèle formé par transporteur est un contrat de maintenance, pas une configuration unique.
Sur notre jeu de test, Nanonets a bien réussi sur les champs standard de documents imprimés propres (nom de l'expéditeur, nom du navire, ports) mais a eu du mal avec les codes spécifiques à la logistique. L'extraction du numéro de conteneur était incohérente selon les transporteurs — il a capturé « MAEU1234567 » de manière fiable à partir d'un connaissement Maersk mais a analysé « MSCU9876543 » comme deux champs distincts sur un format MSC. Le modèle de tarification — à partir d'environ 499 $ par mois — se situe entre l'accessibilité du marché intermédiaire et le coût d'entreprise, ce qui en fait un choix potentiellement mal adapté pour les petits transitaires et trop limité pour les grands 3PL ayant besoin d'orchestration de flux de travail.
Docsumo — Idéal pour les flux de travail logistiques axés sur la vérification
Idéal pour : Les équipes logistiques qui ont besoin d'une validation inter-documents — en faisant correspondre les données du connaissement avec les bordereaux d'expédition, les factures de fret et les confirmations de livraison correspondants — avec une interface de révision humaine robuste.
Moins adapté pour : Les équipes ayant besoin d'une extraction sans configuration sur des types de documents que la plateforme n'a pas pré-entraînés — les documents logistiques personnalisés nécessitent la formation de 10+ échantillons.
Docsumo se positionne comme une plateforme d'IA documentaire pour les entreprises, avec des modèles pré-entraînés pour les factures, les relevés bancaires, les documents fiscaux et les documents logistiques. Son écran de révision — salué par les utilisateurs sur G2 pour son intuitivité — prend en charge les flux de travail de vérification croisée où les champs extraits sont signalés pour révision humaine lorsque la confiance est inférieure au seuil.
Dans nos tests, le modèle logistique pré-entraîné de Docsumo a capturé les numéros de conteneur et les codes SH à partir de PDF de connaissements propres avec une précision modérée, mais a nécessité une formation par modèle pour les champs spécifiques au transporteur comme les codes SCAC et les conditions de fret. Les capacités de traitement par lots de la plateforme — gérant plusieurs documents en une seule passe — sont pertinentes pour les équipes logistiques traitant 50+ connaissements par lot. La tarification commence gratuitement pour 100 pages par mois, puis passe à 299 $ par mois pour le niveau de démarrage, avec une échelle basée sur le volume. Le niveau d'entrée gratuit est utile pour l'évaluation, mais les limites de pages le rendent peu pratique pour un volume logistique continu.
À titre de comparaison, une étude de cas d'entreposage 3PL sur le site de Docsumo décrit BiagiBros traitant plus de 3 000 documents par mois avec un traitement direct de 95 % et 500 heures économisées — une référence réaliste pour un flux de travail documentaire spécialisé en logistique.
ABBYY Vantage — Idéal pour le traitement multilingue des documents logistiques
Idéal pour : Les équipes logistiques mondiales qui traitent des documents d'expédition dans plusieurs langues et jeux de caractères — connaissements COSCO chinois, lettres de transport Nippon Express japonaises, déclarations en douane arabes — lorsque la couverture linguistique est un critère essentiel.
Moins adapté pour : Les équipes qui doivent extraire des champs logistiques personnalisés sans configuration par type de document — Vantage nécessite de créer ou d'acheter des « compétences » par catégorie de document.
ABBYY Vantage est l'évolution entreprise d'ABBYY FlexiCapture, l'un des moteurs OCR les plus anciens et les plus fiables du marché. La place de marché de compétences de Vantage propose des modèles d'extraction pré-construits pour les types de documents courants, et le moteur OCR sous-jacent prend en charge plus de 200 langues — dont le chinois, le japonais, l'arabe, le cyrillique et les scripts de droite à gauche. Cette couverture linguistique est réellement utile pour les opérations logistiques où un lot quotidien peut inclure un connaissement COSCO chinois, une lettre de voiture ferroviaire russe (CMR) et une facture de fret en anglais.
La reconnaissance de l'écriture manuscrite d'ABBYY — un atout historique hérité de décennies de traitement de formulaires — a bien fonctionné sur les annotations de livraison manuscrites de notre jeu de test, se classant juste derrière ImageToTable.ai et à égalité avec Rossum. Le compromis réside dans la complexité de configuration : les compétences Vantage doivent être configurées par type de document, et les champs logistiques personnalisés (codes SCAC, numéros de scellé, conditions de fret) nécessitent une personnalisation des compétences ou une configuration manuelle des zones. La tarification est personnalisée pour les entreprises, nécessitant généralement une conversation commerciale et un engagement annuel, ce qui l'exclut pour les opérations logistiques plus modestes.
Amazon Textract — Idéal pour créer des pipelines d'extraction logistique personnalisés
Idéal pour : Les équipes de développement des entreprises de logistique ou des 3PL qui souhaitent créer des pipelines d'extraction personnalisés sur l'infrastructure AWS, avec un contrôle total sur le prétraitement, la validation et l'intégration en aval.
Moins adapté pour : Les équipes opérationnelles logistiques sans développeurs dédiés — Textract n'a pas d'interface utilisateur, pas de flux de révision, ni de modèles d'extraction logistique pré-construits. Vous obtenez des paires clé-valeur brutes et des tableaux, et tout le reste relève de votre code.
Amazon Textract est un service d'apprentissage automatique — pas une application. Il accepte des images de documents et renvoie le texte détecté, les paires clé-valeur de formulaires et les structures de tableaux. Pour une entreprise de logistique disposant d'une pile technologique native AWS et d'une équipe de développement, Textract peut constituer la couche d'extraction d'un pipeline personnalisé qui achemine les données des connaissements vers un TMS, valide les numéros de conteneur par rapport aux dossiers de réservation et signale les écarts de numéros de scellé pour révision humaine.
Dans nos tests, l'extraction de tableaux de Textract s'est avérée utile pour les blocs de lignes d'articles sur les bordereaux d'expédition et les factures de fret. Sa fonctionnalité Queries — qui permet de demander des champs spécifiques en langage naturel (par exemple, « Quel est le numéro de conteneur ? ») — a donné des résultats modérés sur les connaissements, mais s'est montrée incohérente lorsque le numéro de conteneur apparaissait dans une barre latérale ou un en-tête plutôt que dans un champ clairement étiqueté. La reconnaissance de l'écriture manuscrite était son point le plus faible : les notes de livraison scannées avec annotations manuscrites ont renvoyé du texte avec des erreurs de caractères significatives.
Tarification — paiement par page, à partir d'environ 0,0015 $ par page pour le premier palier — semble attractive à faible volume, mais peut surprendre à l'échelle logistique. Le traitement de 5 000 connaissements multipages par mois aux paliers standard et mise en page de Textract coûterait plusieurs centaines de dollars avant même d'ajouter les coûts de traitement en aval (calcul, stockage, temps de développement pour créer et maintenir le pipeline).
Docparser — Idéal pour les factures de transport à format constant
Idéal pour : Les équipes logistiques qui reçoivent de gros volumes de factures de transport dans des formats identiques — lorsque chaque facture FedEx utilise la même mise en page et que vous souhaitez extraire les frais détaillés dans un tableur cohérent.
Moins adapté pour : Les connaissements à format variable, les documents multimodaux, ou tout document logistique dont la mise en page varie selon la source — l'extraction basée sur des modèles échoue silencieusement en cas de changement de format.
Docparser utilise une approche par modèles basés sur des zones : vous sélectionnez visuellement les champs sur un document échantillon, et l'analyseur extrait ces coordonnées sur chaque document suivant ayant la même mise en page. Cela fonctionne bien lorsque le format reste identique — par exemple, pour extraire les lignes de frais d'une facture de fret FedEx où chaque facture suit le modèle standard de FedEx.
La limite devient évidente dans les opérations logistiques multi-transporteurs. Un seul lot de 50 connaissements provenant de 12 transporteurs nécessiterait 12 modèles. Lorsqu'un transporteur met à jour sa mise en page — les compagnies maritimes changent de marque, fusionnent ou modifient leurs systèmes ERP — le modèle casse, et l'extraction échoue ou renvoie des données erronées sans générer d'erreur. Sur notre jeu de tests logistiques, Docparser a bien performé sur les factures de fret à format constant (mises en page standard FedEx et UPS), mais n'a pas réussi à extraire de numéros de conteneur ni de codes SCAC exploitables depuis les connaissements — les noms de champs et leurs positions variaient trop entre transporteurs pour une approche par zones.
Les tarifs commencent à 32,50 $ par mois, ce qui en fait le point d'entrée le plus abordable de cette comparaison pour l'extraction par modèles de documents à format identique.
FormX — Idéal pour l'extraction préconfigurée sur les modèles logistiques courants
Idéal pour : Les équipes logistiques qui traitent des documents correspondant à la bibliothèque d'extracteurs préconfigurés de FormX — bordereaux d'expédition, étiquettes d'expédition, factures commerciales — et qui souhaitent extraire sans entraîner leurs propres modèles.
Moins adapté pour : Les documents logistiques personnalisés hors de la bibliothèque d'extracteurs de FormX, ou les documents comportant beaucoup d'écriture manuscrite — les extracteurs préconfigurés sont conçus pour des documents structurés imprimés par machine.
FormX propose des extracteurs pour les types de documents courants, notamment les documents d'expédition et les bordereaux d'expédition. La plateforme combine des modèles d'IA préentraînés et une correspondance par modèles, avec une interface utilisateur pour vérifier les données extraites. Sur notre jeu de tests, les extracteurs de bordereaux d'expédition et de factures commerciales de FormX ont donné des résultats corrects sur les documents imprimés standard — les descriptions d'articles, les quantités et les totaux ont été capturés avec une précision modérée.
La limite concernait les champs propres à la logistique qui n'apparaissent pas dans les catégories standard de « documents d'expédition » : codes SCAC, ventilation par ligne des codes SH, numéros de scellé et conditions de fret. Ces champs ont été soit manqués, soit renvoyés avec un formatage incohérent. La tolérance à l'écriture manuscrite était sans particularité — typique des outils principalement entraînés sur des jeux de données imprimés par machine. La tarification est basée sur l'utilisation et nécessite un devis personnalisé pour l'extraction de documents d'expédition, ce qui rend l'estimation des coûts difficile avant de commencer un essai.
Parseur — Idéal pour l'ingestion de documents logistiques par e-mail
Idéal pour : Les coordinateurs logistiques qui reçoivent des preuves de livraison, des connaissements et des factures de fret en pièces jointes par e-mail et souhaitent les extraire automatiquement dans un tableur ou une base de données.
Moins adapté pour : Les documents logistiques numérisés ou photographiés, les preuves de livraison avec beaucoup d'écriture manuscrite, ou les lots de transporteurs multi-formats — la couche OCR de Parseur est basique et son approche par modèles/zones ne s'adapte pas aux variations de mise en page.
Parseur excelle dans un flux de travail logistique spécifique : l'ingestion de documents reçus par e-mail. Un coordinateur logistique qui transmet les preuves de livraison des chauffeurs vers une file de traitement, ou un transitaire qui reçoit des factures de transporteurs en pièces jointes de plusieurs fournisseurs, peut configurer Parseur pour détecter les documents entrants, extraire les champs définis et envoyer les données structurées vers une feuille Google ou un point de terminaison API.
La contrainte est que l'extraction de documents de Parseur est fondamentalement basée sur des modèles — vous définissez des zones et des règles par expéditeur ou format de document. Pour une équipe logistique qui reçoit chaque jour le même modèle de facture FedEx du même expéditeur, cela fonctionne de manière fiable. Pour un transitaire qui reçoit des PDF de connaissements de 15 transporteurs différents, chacun avec son propre format, l'exigence d'un modèle par transporteur crée la même charge de maintenance que Docparser. La qualité OCR sur les documents numérisés et la reconnaissance de l'écriture manuscrite sont basiques, ce qui fait de Parseur un mauvais choix pour les flux de bons de livraison et de preuves de livraison qui dominent le volume de documents logistiques. Les tarifs commencent à 39 $ par mois pour 20 documents extraits, puis passent à 117 $ et 299 $ par mois pour des volumes plus élevés.
Quel outil d'extraction de documents logistiques convient à votre activité ?
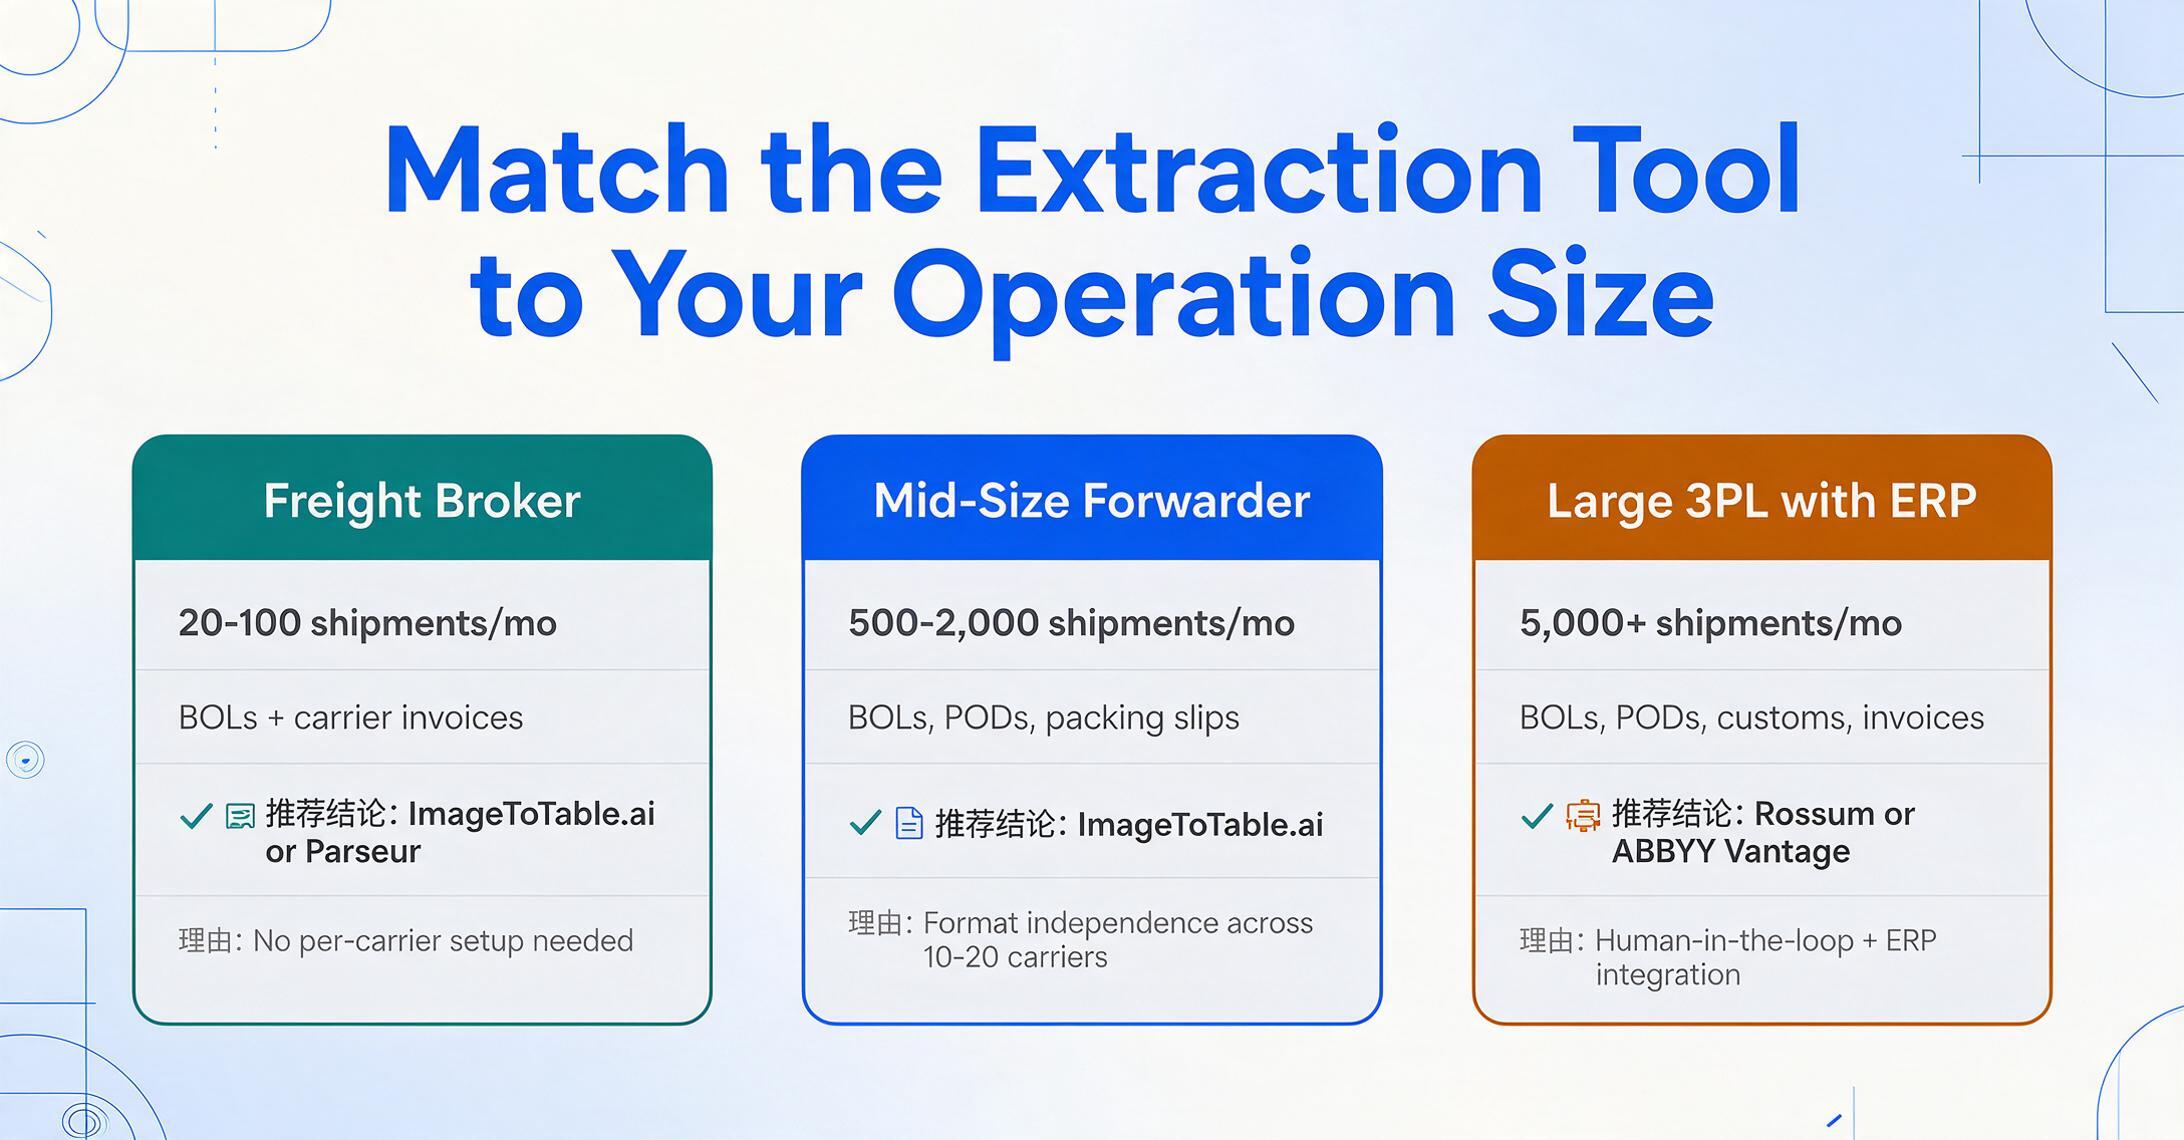
Les opérations logistiques varient considérablement en termes d'échelle, de mix de types de documents et de capacités techniques. L'outil qui convient à un courtier en fret indépendant traitant 50 expéditions par mois est différent de celui dont un 3PL mondial avec 50 000 expéditions mensuelles a besoin. Voici comment adapter le choix à votre activité :
| Votre scénario | Mélange de documents | Outil recommandé | Raison |
|---|---|---|---|
| Courtier de fret indépendant, 20 à 100 envois/mois | Connaissements + factures de transporteur, surtout par e-mail | ImageToTable.ai ou Parseur | Coût faible, aucune configuration transporteur requise ; Parseur si tout arrive par e-mail dans un format cohérent |
| Transitaire de taille moyenne, 500 à 2 000 envois/mois | Connaissements (maritimes + aériens), preuves de livraison, bordereaux d'expédition, factures de fret, documents douaniers | ImageToTable.ai | Indépendance du format sur 10 à 20 transporteurs ; tolérance à l'écriture manuscrite pour les preuves de livraison ; aucune charge de modèle par transporteur |
| Grand 3PL, 5 000+ envois/mois avec intégration ERP | Gamme complète : connaissements, preuves de livraison, déclarations en douane, factures de fret, listes de colisage, bons de livraison | Rossum ou ABBYY Vantage | Flux de travail d'entreprise, validation humaine, intégration ERP ; un budget plus élevé justifie le prix |
| Courtage en douane, déclarations en douane à volume élevé | Documents d'entrée, déclarations de code SH, certificats d'origine, factures commerciales | ImageToTable.ai ou Rossum | Besoin d'extraction de code SH + cohérence des données entre documents (connaissement, liste de colisage et facture) |
| Équipe de développement interne créant une automatisation logistique personnalisée | Traitement piloté par API des connaissements et factures | Amazon Textract ou Nanonets | Conception API-first, contrôle total du pipeline, possibilité d'entraîner des modèles personnalisés par format de transporteur |
| Traitement de factures de transporteur au format identique | Factures de fret standard FedEx/UPS uniquement | Docparser | Option la moins chère pour des factures au format cohérent — mais uniquement si le format ne change jamais |
Les trois défis d'extraction spécifiques à la logistique que la plupart des comparatifs oublient
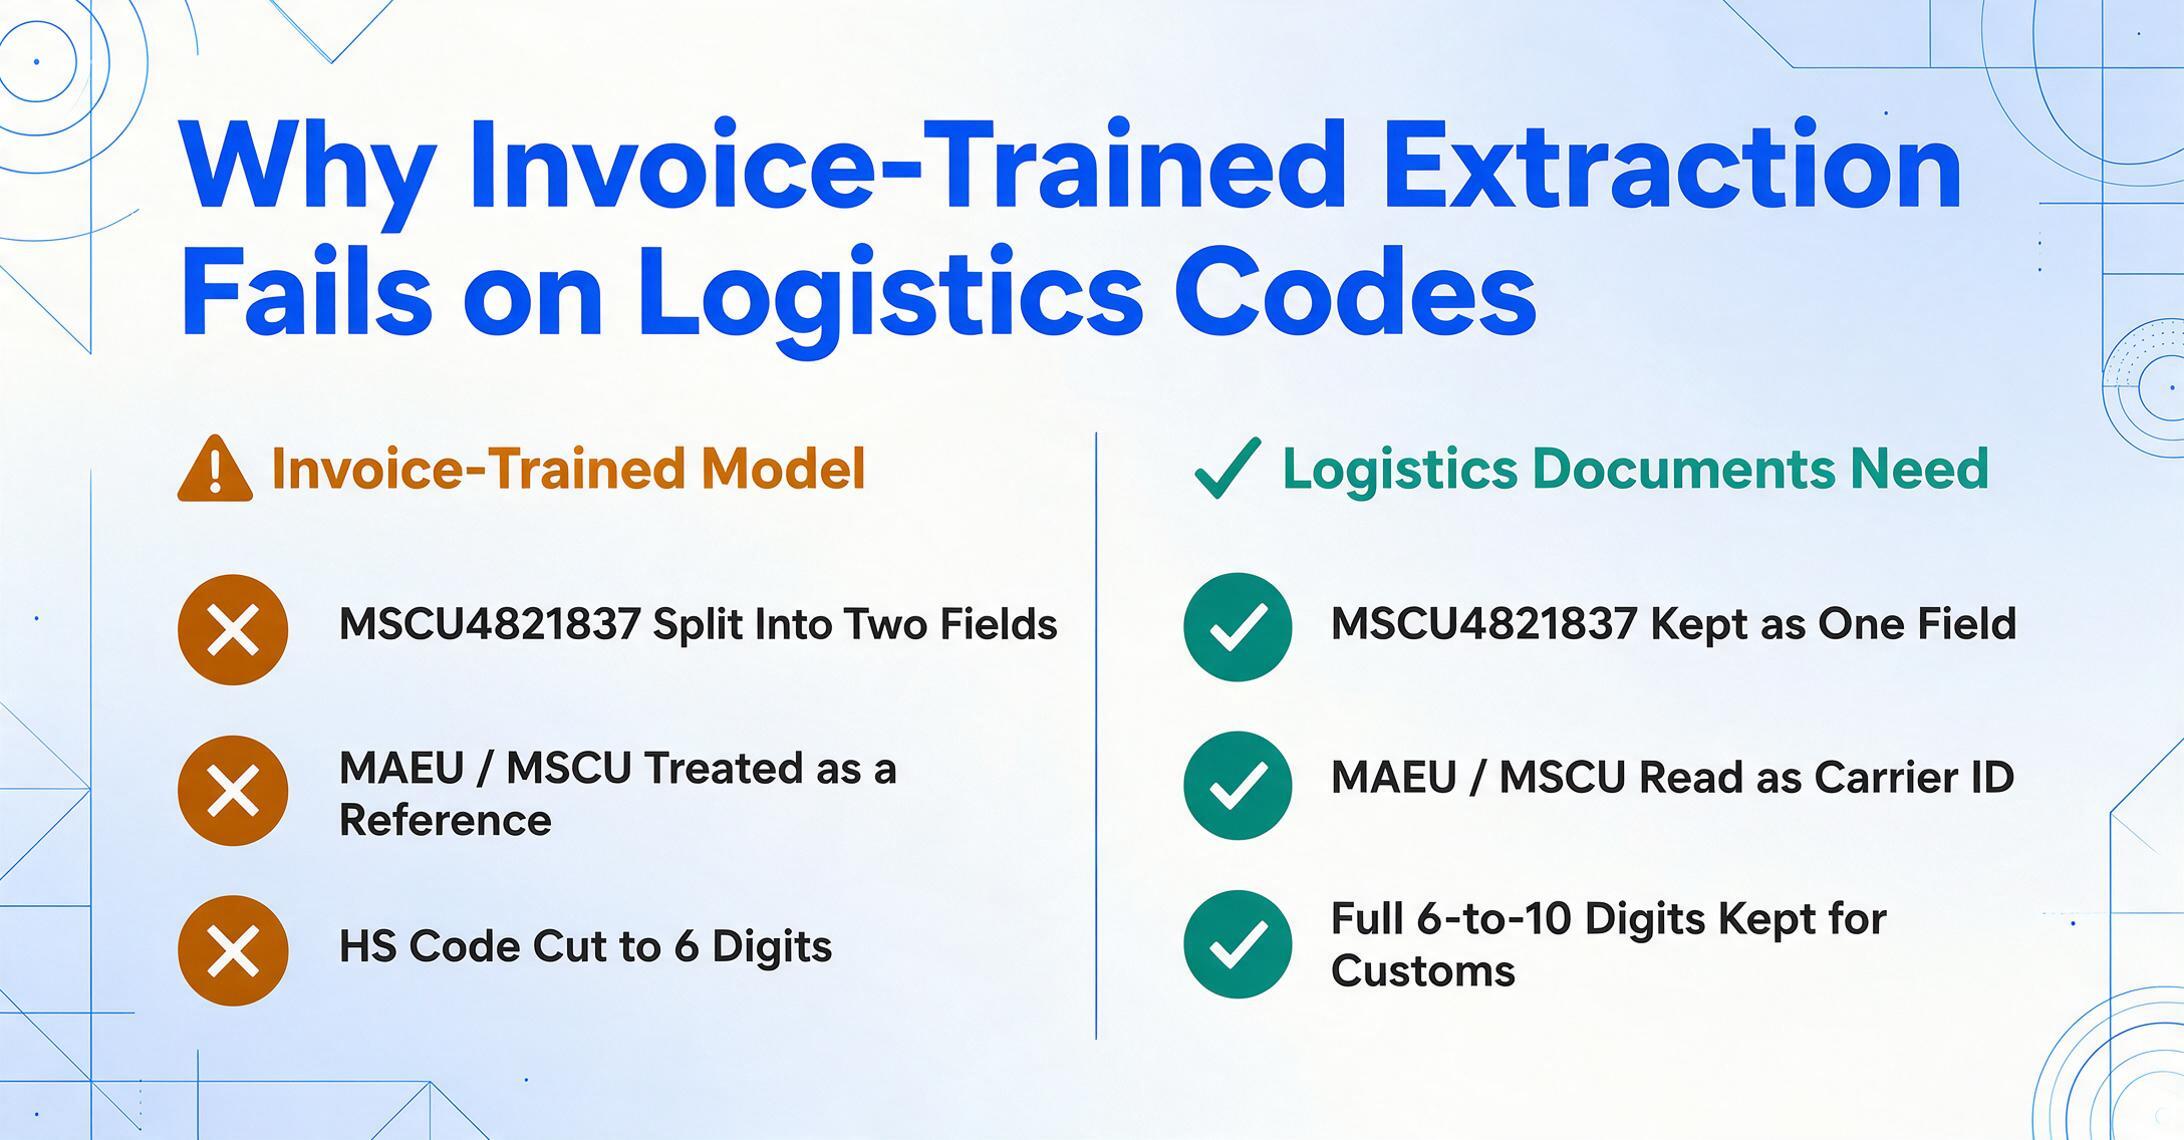
Sur la base de tests effectués sur les neuf outils, trois schémas sont ressortis que le comparatif typique des « meilleurs outils d'extraction de documents » n'aborde pas, mais que les opérations logistiques rencontrent chaque jour :
1. Les codes spécifiques à la logistique ne sont pas des champs de facture. Un numéro de conteneur (par ex., MSCU4821837) suit un format de préfixe de 4 lettres + 7 chiffres que la plupart des outils d'extraction divisent en deux champs ou classent à tort comme numéro de référence. Le code SCAC — un identifiant de transporteur de 4 lettres comme « MAEU » (Maersk) ou « MSCU » (MSC) — est un champ obligatoire pour les déclarations en douane (exigences CBP) que les modèles d'extraction entraînés sur factures ne reconnaissent pas comme un point de données distinct. L'extraction du code SH exige non seulement de lire le numéro, mais aussi de préserver la chaîne complète de 6 à 10 chiffres, y compris les suffixes spécifiques au pays. Un outil qui extrait les six premiers chiffres et abandonne l'extension pays a renvoyé des données inutilisables pour la déclaration en douane. Beaucoup d'outils font cela.
2. L'écriture manuscrite sur les documents logistiques n'est pas un contenu facultatif — c'est une donnée opérationnelle. Un livreur écrit « refusé 2 cartons » sur la face d'une preuve de livraison. Un employé d'entrepôt annote à la main le numéro de scellé lorsque le conteneur arrive avec un scellé différent de celui enregistré sur le connaissement. Une correction du destinataire est écrite dans la marge d'un connaissement à l'origine. Sur r/logistics, un utilisateur a décrit la réalité avec concision : « On ne peut pas automatiser le désordre. » En logistique, le « désordre » est souvent constitué de données manuscrites que les outils d'extraction de documents n'ont pas été entraînés à lire, et elles se trouvent précisément sur les documents — preuves de livraison, bons de livraison, connaissements corrigés à la main — où la précision compte le plus, car les litiges et les refacturations dépendent de ces enregistrements. Les outils qui ne gèrent pas ce contenu n'automatisent que le sous-ensemble le plus propre et le moins précieux des documents logistiques.
3. L'indépendance du format n'est pas une fonctionnalité facultative en logistique — c'est une condition de base. Un transitaire traitant 500 connaissements par mois auprès de 15 transporteurs maritimes, plus des lettres de transport aérien et des bons de livraison routiers, ne peut pas maintenir des modèles séparés pour le format de chaque transporteur et chaque type de document. Le coût pratique de la maintenance des modèles — le temps passé à remarquer que l'extraction a échoué, à diagnostiquer quel transporteur a mis à jour sa mise en page et à reconstruire le modèle — n'est presque jamais inclus dans les tarifs ou les comparatifs des fournisseurs. Les outils basés sur des modèles (Docparser, Parseur) semblent moins chers sur le papier, mais leur coût total inclut les heures de travail consacrées à la maintenance des modèles, qu'un outil indépendant du format élimine.
FAQ : Extraction de documents logistiques
Quelle est la différence entre un connaissement nominatif, un connaissement à ordre et un connaissement multimodal pour l'extraction ?
Un connaissement nominatif (original) est un document non négociable émis au nom d'un destinataire désigné — il comporte des champs standard (expéditeur, destinataire, navire, ports, description de la cargaison, numéro de conteneur) sur une mise en page généralement d'une à deux pages. Un connaissement à ordre (négociable) est émis « à ordre » et peut être transféré — il fonctionne de manière similaire pour l'extraction, mais peut inclure un champ « partie à notifier » supplémentaire et des espaces d'endossement en blanc. Un connaissement multimodal couvre le transport maritime + terrestre — il ajoute les champs lieu de réception, lieu de livraison et pré-acheminement/acheminement ultérieur que les outils d'extraction de documents manquent souvent car ils s'attendent uniquement à des champs port-à-port. La norme FIATA eFBL (FBL électronique) est un effort pour standardiser les données des connaissements multimodaux, mais son adoption est progressive.
Puis-je traiter les connaissements maîtres et les connaissements maison dans le même lot ?
Oui, si votre outil d'extraction lit les documents de manière sémantique plutôt que par modèle. Un connaissement maître (MBL) est émis par le transporteur maritime au transitaire. Un connaissement maison (HBL) est émis par le transitaire à l'expéditeur. Ils se présentent différemment — en-têtes différents, libellés de champs différents, structure de mise en page différente — mais contiennent des informations qui se recoupent (nom du navire, ports, numéro de conteneur, description de la cargaison). Un outil d'extraction sémantique qui reconnaît « Navire » comme un concept le trouvera sur les deux, quelle que soit la mise en page visuelle. Un outil basé sur des modèles nécessite deux modèles distincts.
Comment la conformité VGM SOLAS affecte-t-elle l'extraction des données des connaissements ?
Depuis juillet 2016, les réglementations SOLAS de l'Organisation maritime internationale (OMI) exigent une Masse brute vérifiée (VGM) pour chaque conteneur chargé avant qu'il ne puisse être embarqué sur un navire. La VGM — composée du poids à vide du conteneur + du poids de la cargaison — doit être indiquée sur le connaissement ou transmise séparément au transporteur et au terminal. Lors de l'extraction des données du connaissement, la valeur VGM et sa méthode de vérification (Méthode 1 : peser le conteneur chargé ; Méthode 2 : peser toute la cargaison et ajouter le poids à vide) doivent être capturées comme champs distincts. La plupart des outils d'extraction ne distinguent pas la VGM du champ standard « Poids brut » — et les deux valeurs peuvent différer de plusieurs centaines de kilogrammes, créant un risque de non-conformité si la mauvaise valeur alimente une déclaration douanière ou un dépôt au terminal.
Ces outils peuvent-ils extraire les conditions de fret (FOB, CIF, FCA) des connaissements ?
Seuls les outils dotés d'une compréhension sémantique — où vous définissez « Conditions de fret » comme nom de colonne et où l'IA localise le terme sur le document — capturent systématiquement les conditions de fret. Selon les Incoterms 2020, FOB (Free On Board) et CIF (Cost, Insurance, and Freight) s'appliquent uniquement au fret maritime, tandis que FCA (Free Carrier), CIP (Carriage and Insurance Paid To) et DAP (Delivered at Place) couvrent tous les modes. Sur un connaissement, les conditions de fret peuvent apparaître dans le bloc de description, sous forme de code autonome, ou intégrées à une ligne de taux de fret. Les outils basés sur des modèles qui recherchent « FOB » à une position fixe le manquent lorsque le transporteur place les termes différemment. L'extraction sémantique le trouve quelle que soit la position, car elle comprend ce qu'est une condition de fret et recherche le concept, pas la coordonnée.
Comment le décret exécutif de juin 2026 du CBP sur le contrôle douanier affecte-t-il les besoins d'extraction de documents ?
Le décret exécutif de la Maison-Blanche sur le renforcement du contrôle douanier (3 juin 2026) ordonne une refonte complète des exigences de documentation d'importation aux États-Unis. Les importateurs officiels sont confrontés à de nouvelles exigences, notamment celle de fournir au CBP toute documentation d'exportation soumise aux autorités douanières étrangères avant l'arrivée des marchandises aux États-Unis — une expansion notable du périmètre documentaire. Le décret exige également une vérification renforcée des courtiers en douane, des transitaires et des importateurs officiels, avec des exigences plus strictes en matière de caution et de disponibilité des dossiers conformément au 19 USC 1508 et au 19 CFR Part 163. Pour les équipes logistiques, cela signifie que les documents alimentant les déclarations en douane — connaissements, factures commerciales, bordereaux d'expédition — doivent être traités avec une précision et une exhaustivité accrues, et que le flux d'extraction doit capturer les champs qui soutiennent les nouvelles exigences de conformité (par exemple, les numéros de référence d'exportation étrangère, une précision accrue du code SH).
Qu'en est-il du volume de documents logistiques ? Les outils d'extraction peuvent-ils gérer des milliers de connaissements par mois ?
Oui, la plupart des outils comparés ici peuvent passer à l'échelle pour des volumes élevés — mais le goulot d'étranglement se déplace de la vitesse d'extraction vers la validation des résultats. À 5 000 connaissements par mois, un taux de précision de 95 % au niveau des champs signifie 250 documents par mois avec au moins un champ nécessitant une correction manuelle. La question de flux de travail n'est pas « l'outil peut-il extraire 5 000 connaissements » mais « pouvez-vous examiner 250 exceptions signalées sans embaucher un responsable QC dédié ? » Rossum et Docsumo proposent des files d'attente intégrées avec intervention humaine. ImageToTable.ai s'appuie sur un signalement basé sur la confiance, où les champs à faible confiance sont mis en évidence pour examen. Pour les opérations logistiques axées sur la validation, où le numéro de conteneur de chaque connaissement alimente directement une déclaration CBP, la gestion intégrée des exceptions est une fonctionnalité à privilégier par rapport à la vitesse d'extraction.
Puis-je extraire le numéro de conteneur, le numéro de scellé et le code SH en une seule passe à partir de types de documents mixtes ?
Oui — si vous utilisez un outil prenant en charge l'extraction de colonnes personnalisées sur plusieurs types de documents. Définissez vos colonnes de sortie (numéro de conteneur, numéro de scellé, code SH, code SCAC, etc.) une seule fois. Téléchargez un lot contenant des connaissements maritimes, des bordereaux d'expédition et des factures de fret. L'IA lit chaque type de document indépendamment et remplit les colonnes où des données correspondantes existent. Les numéros de conteneur proviennent des connaissements et des bordereaux d'expédition. Les codes SH proviennent des factures commerciales et des déclarations en douane. Les numéros de scellé proviennent des champs de scellé des connaissements et des rapports d'échange de conteneurs. Les champs sans données correspondantes dans un document donné restent simplement vides. Cette approche compatible par lots est standard pour des outils comme ImageToTable.ai et Rossum, mais n'est pas disponible sur les analyseurs basés sur des modèles ou des zones qui exigent un mappage de champs par type de document.
Pour un aperçu plus approfondi du fonctionnement de l'extraction de documents spécifiquement pour le traitement des connaissements auprès des transporteurs et des types de connaissements, consultez notre guide complet sur l'extraction des connaissements. Pour les flux de travail de bordereaux d'expédition et de bons de livraison, consultez l'extraction de données des bordereaux d'expédition, et pour les flux de travail d'étiquettes d'expédition et de manifestes, consultez l'extraction de données d'étiquettes d'expédition et de manifestes vers Excel. Si vous évaluez si ces outils sont financièrement pertinents pour votre opération de fret, comparez les chiffres avec le coût caché de la saisie manuelle des données en logistique. Si votre évaluation couvre l'ensemble du dossier d'expédition — connaissements, factures de fret, déclarations en douane, listes de colisage — plutôt que uniquement les connaissements, notre guide d'achat pour l'extraction de documents logistiques couvre les critères d'évaluation inter-documents. Pour des synthèses couvrant des types de documents connexes, consultez les meilleurs outils gratuits d'extraction de documents et la meilleure extraction de documents pour la construction.
Le flux de travail du transitaire repose sur 15 formats de transporteurs différents et une pile de preuves de livraison manuscrites. Si votre outil actuel gère les factures FedEx mais nécessite un modèle séparé pour chaque transporteur maritime, votre automatisation est incomplète.