小さなフォントが
OCR精度を損なう理由 — 4つの根本原因と対策
契約書をスキャンし、細かい文字が並ぶ銀行明細書からデータを抽出し、密集した表のスクリーンショットから明細データを取得しようとした経験はありませんか。10ptや12ptの文字は問題なく読み取れたのに、小さな文字 — 6ptの脚注、7ptの免責事項、仕入先見積書の下部にある細かい単価 — は、文字化けしたり、まったく読み取れなかったりしました。これはAIが小さなフォントを読むのが苦手だからではありません。問題は物理的な制約です。150 DPIでスキャンした場合、6ptの文字は高さ約12ピクセルになります。12ピクセルでは、「8」と「6」、「rn」と「m」を区別するのに十分な情報がありません。これは人間でも機械でも同じです。
重要なポイント
- 150 DPIでスキャンした6ptの文字は、高さわずか12ピクセルです。「8」と「6」を区別する特徴は、その12ピクセルのうち2ピクセルを占めるにすぎず、スキャナのノイズが1ピクセルあるだけでその違いは消えてしまいます。これはAIの問題ではなく、市場のあらゆる抽出ツールに共通する物理的な問題です。
- 20ピクセルの法則:文字の高さが20〜25ピクセル未満の場合、「rn」と「m」、「5」と「S」の違いは1ピクセルの曖昧さにまで縮まります。ほとんどのオフィス用複合機のスキャナはデフォルトで200 DPIのため、10pt未満の文字はすべて危険ゾーンに入ります。本文は問題なく抽出できるのに、表の値はノイズになってしまうのです。
- 一度失われたピクセルを後から追加することはできませんが、物理法則に逆らうのをやめることはできます。小さなフォントの文書は400 DPI以上でスキャンし、ワークフローで実際に必要なデータにのみ抽出列を定義し、7pt未満の文字は修正すべき失敗ではなく、ハードリミットとして扱いましょう。
問題はAIではなく物理にある
OCRエンジンやビジョンAIモデルが小さな文字を認識できないと、まずソフトウェアを疑うのが普通だ。しかし、本当のボトルネックはAI処理が始まる前に存在する。それは、1文字あたりに利用可能なピクセル数によって決まる。
計算式を示す。タイポグラフィにおける「ポイント」は1/72インチである。150 DPI(dots per inch、一般的なFAXや低解像度スキャナの解像度)の場合、文字のピクセル高は次のようになる:
ピクセル高 = フォントサイズ(pt)× DPI / 72
150 DPIで6ptの文字の場合:
6 × 150 / 72 = 12.5 ピクセル
12ピクセルは、OSのターミナルウィンドウで許可される最小フォントサイズの1文字の高さにほぼ等しい。このスケールで文字内部で何が起こるかを考えてみよう。「8」と「6」を区別する特徴(上部の閉じたループと下部の閉じたループ)は、せいぜい2〜3ピクセルにしか及ばない。スキャナセンサーからの1ピクセルのノイズ、わずかなページの傾き、またはスマートフォンの写真からのJPEG圧縮ブロックによって、その区別は完全に失われる。小さいサイズでは、文字「m」と「rn」のペアは同じ2〜3ピクセルの列幅を占めるため、構造的に同一になる。
これは、より優れたAIトレーニングや高度なOCR後処理で解決できる問題ではない。入力信号には、あらゆる認識システムが正しい出力を生成するために必要な情報が欠落している。この記事で紹介する後続の修正はすべて、この制約を回避するか軽減するものだが、制約自体は不可避である。
文字に実際に必要なピクセル数
小さなフォントがいつ実用的な問題になるかを理解するには、フォントサイズとスキャン解像度をピクセル高にマッピングする。類似したグリフを確実に識別するための文字認識の臨界閾値は、おおよそ20〜25ピクセルの文字高である:
| フォントサイズ | 150 DPI | 200 DPI | 300 DPI | 400 DPI | 600 DPI |
|---|---|---|---|---|---|
| 6 pt | 12 px ✗ | 17 px ✗ | 25 px ⚠ | 33 px ✓ | 50 px ✓ |
| 7 pt | 15 px ✗ | 19 px ⚠ | 29 px ✓ | 39 px ✓ | 58 px ✓ |
| 8 pt | 17 px ✗ | 22 px ⚠ | 33 px ✓ | 44 px ✓ | 67 px ✓ |
| 10 pt | 21 px ⚠ | 28 px ✓ | 42 px ✓ | 56 px ✓ | 83 px ✓ |
| 12 pt | 25 px ✓ | 33 px ✓ | 50 px ✓ | 67 px ✓ | 100 px ✓ |
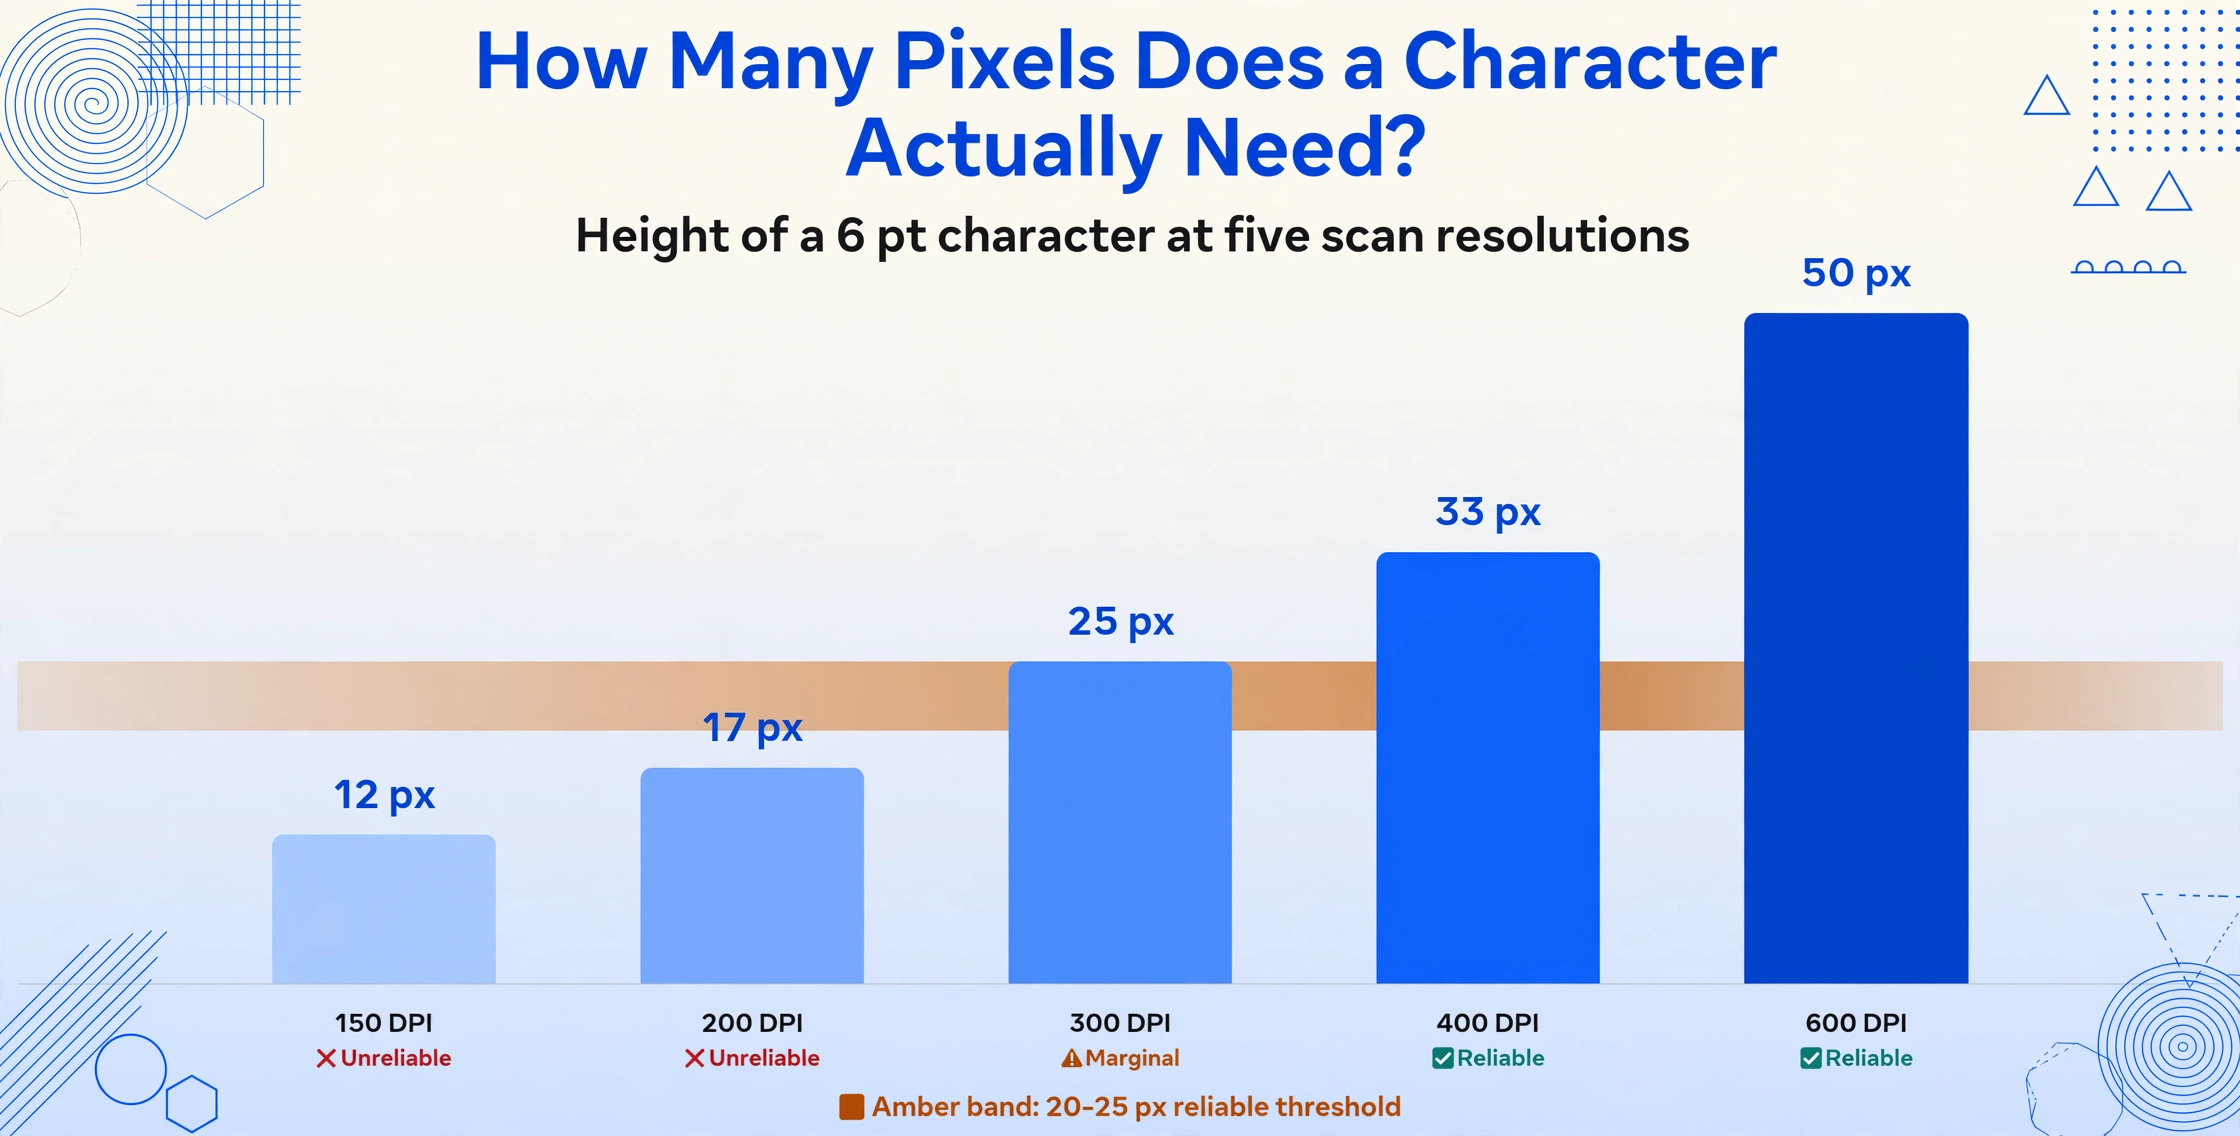
✗ = 信頼性なし ⚠ = 限界 ✓ = 印刷テキストでは概ね信頼性あり。これらは文字の高さの推定値です。認識精度は、ストローク幅、コントラスト、フォントデザインにも依存します。
この表からパターンは明らかです。標準的な300 DPIでは、6ptのテキストはちょうど限界ラインに位置します。200 DPI(多くのオフィス用複合機やファックス文書の解像度)では、10pt未満はすべて限界または信頼性なしとなります。150 DPI(ファックスや低品質PDFで一般的)まで下げると、信頼性があるのは12pt以上のみです。
原因1:スキャン解像度が200 DPI未満
小さなフォントの抽出に失敗する最も一般的な原因は、対象テキストに対してスキャン解像度が低すぎることです。問題はスキャナーのハードウェア自体が不十分なのではなく、スキャン作業が読みやすいテキスト(約10〜12ptの本文)向けに設計されており、脚注、表のセル、法的免責事項、フォームの説明文に現れる小さな文字に合わせて調整されていないことにあります。
200 DPIが危険な閾値である理由:200 DPIでは、多くの表のセル値やフォームのラベルで一般的な8ptの文字は、高さわずか22ピクセルしか生成されません。「e」や「c」のような文字は、開いたカウンター(文字の内部空間)が1ピクセルに潰れるため、ほぼ区別がつかなくなります。「8」のループと「6」のボウルは同じ2ピクセルの垂直空間を占めます。これが、FAX送信された請求書やスキャンされた契約書で、本文は正常に見えるのに小さなフォントのセクションで抽出エラーが頻発する理由です。
確認すべきこと:スキャンしたPDFが、デフォルトの「標準品質」モードに設定されたオフィス用MFP(多機能プリンター)で作成された場合、ほぼ確実に200 DPIです。FAX送信された文書は、送信元の機器に応じて100〜200 DPIで届きます。抽出ツールを疑う前に、入力画像の実効DPIを確認してください。任意の画像ビューアでファイルのプロパティを開き、ピクセル幅を物理的なページ幅(インチ)で割ってください。結果が250 DPI未満で、文書に10pt未満のテキストが含まれている場合、解像度が根本的な原因である可能性が高いです。
画像品質がさまざまな文書タイプの抽出精度にどのように影響するかの詳細については、スキャン文書のOCR精度低下に関するガイドをご覧ください。
原因2:フォントの選択が解像度の問題を増幅する
すべての8ptの文字が同じように作られているわけではありません。フォントデザインは、利用可能なピクセル予算のうち実際に認識に使用できる量を決定します。
小さなサイズでのサンセリフ vs セリフ。Times New Romanのようなセリフフォントは、文字のストロークの端に装飾的なストローク(セリフ)を追加します。10pt以上では、これらのセリフは可読性を高めます。200 DPIスキャンの6〜8ptでは、セリフがメインのストロークに溶け込み、文字が予測不能に太くなり、隣接する文字の分離が難しくなります。サンセリフフォント(Arial、Helvetica、Calibri)にはこれらの余分なストロークがないため、そのシンプルな形状は低解像度のスキャンでもよりよく生き残ります。Tesseract自身のドキュメントや複数のライブラリのガイドラインは、OCRに適した文書にはサンセリフフォントを特に推奨しています。
細い/ライトなフォントウェイト。モダンなブランドデザイン、財務レポートのヘッダー、ミニマリストなUIで人気のあるフォントファミリーの「Light」または「Thin」ウェイトは、一般的なスキャン解像度でわずか1ピクセル幅のストロークを使用する場合があります。ストローク幅が1ピクセルということは、ノイズ、圧縮アーティファクト、スキャナーセンサーのばらつきが、ストロークを壊す(文字が見えなくなる)か、非対称に太らせる(文字の形が変わる)かのどちらかを引き起こすことを意味します。同じ解像度で2〜3ピクセルのストローク幅を持つボールドおよびレギュラーウェイトは、これらのアーティファクトに対する耐性が大幅に高くなります。
曖昧なグリフを持つフォント。特定のフォントデザインは、OCRにとってすでに難しい文字をさらに難しくします。たとえばArialは、小文字の「l」(エル)と大文字の「I」(アイ)を同一にレンダリングします。唯一の識別シグナルは文脈であり、従来のOCRにはそれがありません。小さなサイズでは、残っている視覚的な違い(セリフやストロークの高さの数分の1ピクセル)が完全に消えてしまうため、この曖昧さはさらに悪化します。
実用的なパターン:文書内の小さな文字がモダンな軽量サンセリフフォント(欧州の銀行明細書、SaaSの請求書、投資レポートで一般的)で書かれている場合、太字やセリフ主体のフォントなら読み取り可能なサイズでも、抽出エラーが発生します。フォントの選択自体が問題を引き起こすわけではありませんが、問題が顕在化するピクセル高さを決定づけます。
原因3:優先順位をつけずにすべてを抽出しようとする
これは技術的な問題というより、ワークフロー設計の問題です。しかし、小さな文字の抽出に関する不満の最も一般的な原因の1つです。
多くのユーザーは、ページ上のすべて(各行項目、各免責事項、各脚注、各欄外注記)を抽出しようとします。銀行明細書の下部にある6ptの法的免責事項が文字化けすると、抽出全体が失敗したように感じられます。実際には、本文と主要な財務数値は完璧に抽出されているかもしれません。失敗は、実際のワークフローでは誰も必要としないテキスト部分に限定されていたのです。
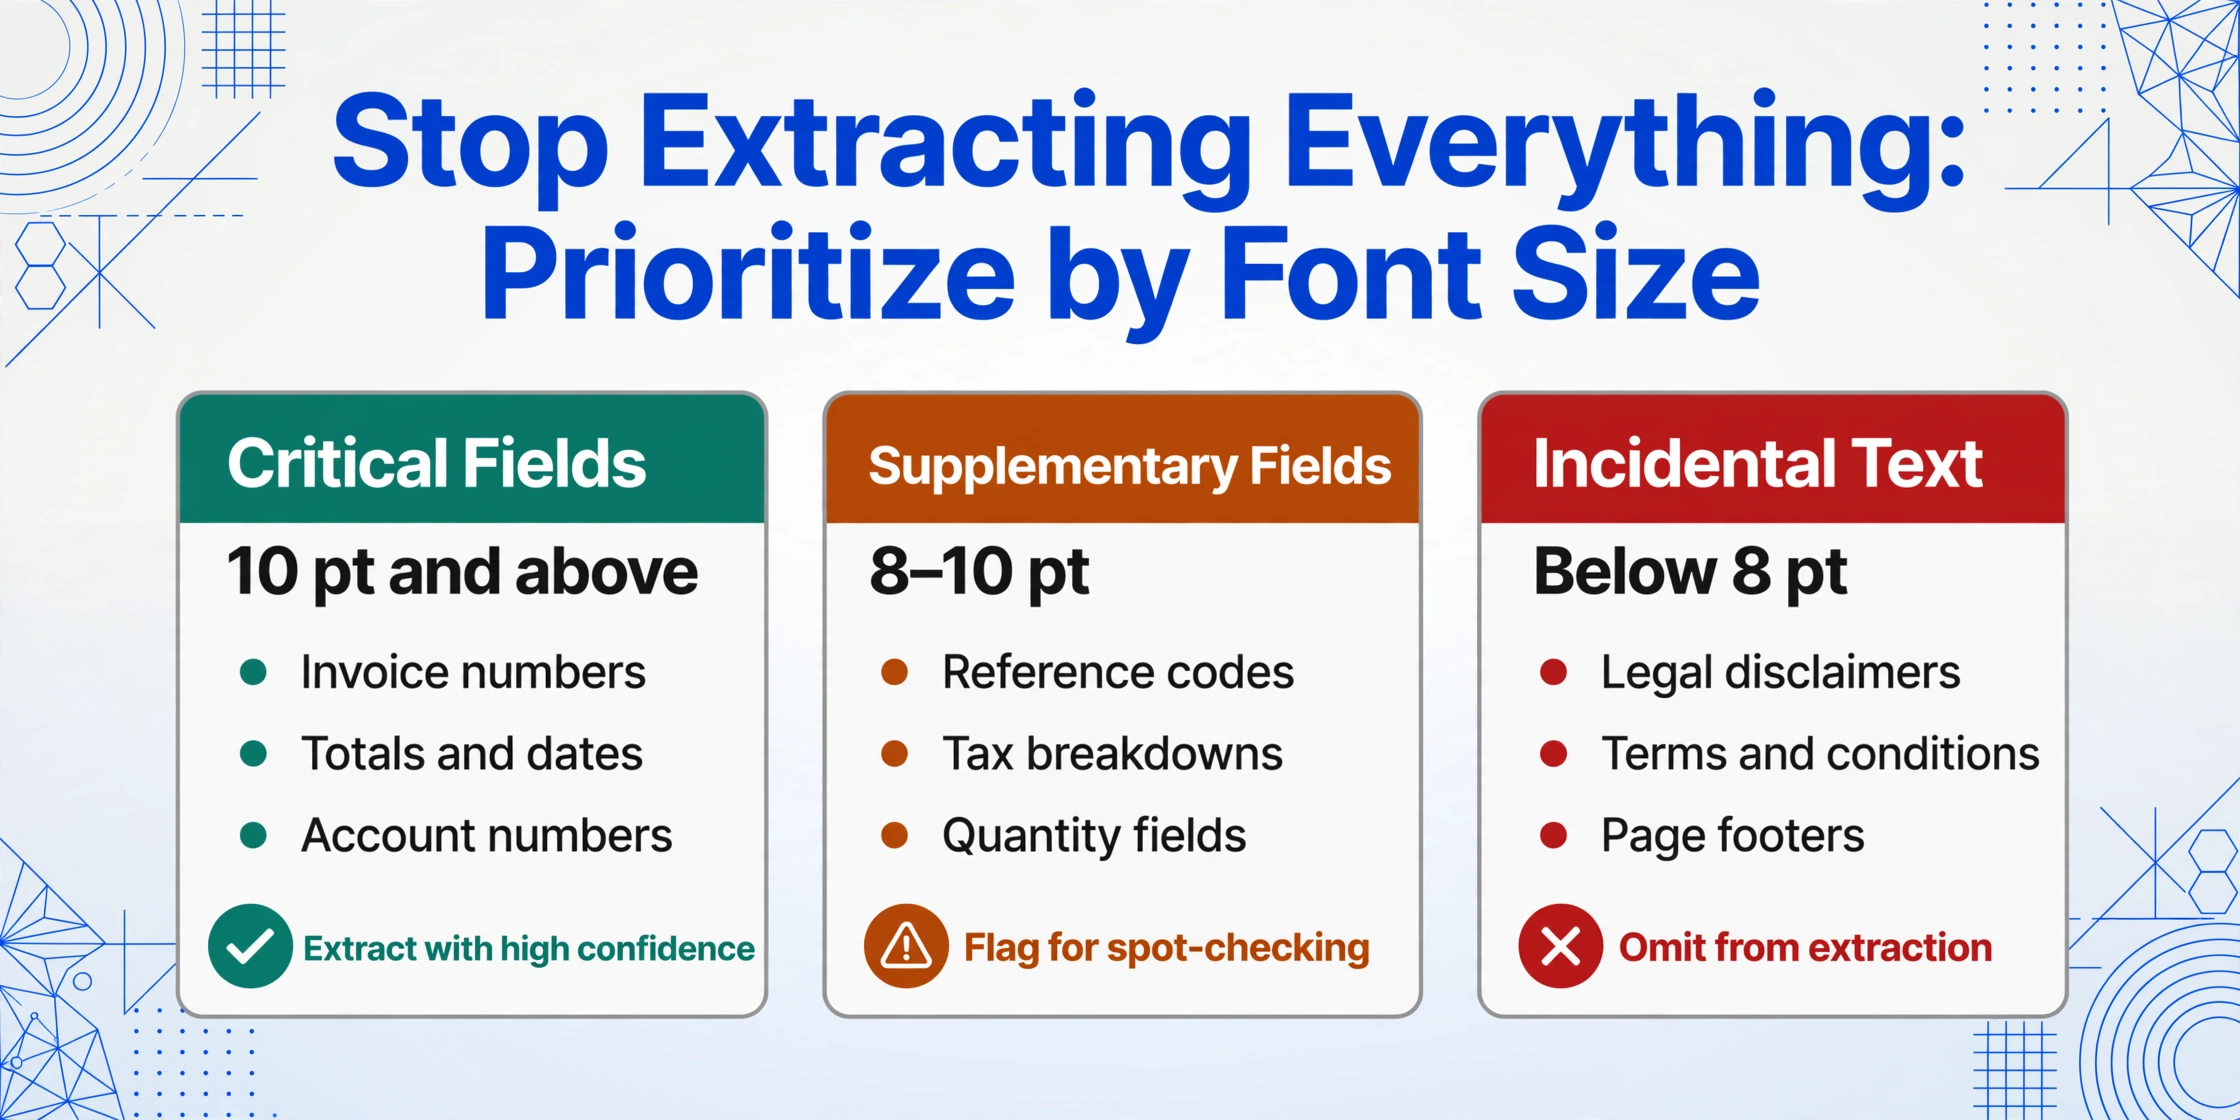
フィールド優先順位戦略:抽出前に、文書の内容を3つのカテゴリに分けます:
- 重要フィールド(10pt以上) — 請求書番号、合計金額、日付、ベンダー名、口座番号、保険証券番号。これらはほぼ常に読みやすいフォントサイズで設定され、財務上・運用上の重要性を持ちます。これらは高い信頼度で抽出します。
- 補足フィールド(8〜10pt) — 参照コード、部門名、税額明細、数量フィールド。通常は300 DPIで抽出可能ですが、低解像度では限界的な場合があります。これらはスポットチェック用にフラグを立てます。
- 付随テキスト(8pt未満) — 法的免責事項、著作権表示、利用規約、ページフッター、細かい字の説明。これらが構造化データワークフローで必要になることはほとんどありません。これらのフィールドのエラーが全体的な結果への信頼を損なうくらいなら、抽出から完全に除外することを検討してください。
カスタム列抽出を備えたAI抽出ツールを使用する場合(必要な列名を入力すると、AIが意味的に値を特定する)、この優先順位付けは設計上ワークフローに組み込まれています。必要なデータの列のみを定義するため、AIは要求していない文書セクションに処理能力を浪費しません。列に小さなフォント領域の値が含まれている場合、その信頼度スコアは手動レビューのための自然なフラグとなります。
同じ原則はバッチ処理にも当てはまります。50件のサプライヤー見積書を抽出していて、細かい字の条件が混在した精度で各行に出力される場合、そもそもそれらの条件がスプレッドシートに必要かどうかを検討してください。多くの場合、答えは「いいえ」であり、それらを除外することで抽出速度と出力の認識品質の両方が向上します。
原因4:スクリーンショットにおけるサブピクセルレンダリングのアーティファクト
この原因は、人間の目にはほぼ見えませんが(文字通り)、最も混乱を招く抽出失敗の一部を引き起こします。スクリーンショットのみに影響しますが、ドキュメント処理のかなりの割合がスクリーンキャプチャ(ダッシュボードのエクスポート、Webポータルの請求書、モバイルアプリのスクリーンショット)として始まるため、多くの人が認識するよりも多くのワークフローに影響します。
最新のオペレーティングシステムは、LCD画面でのテキストの明瞭さを向上させるためにサブピクセルレンダリング(WindowsのClearType、macOSのCore Text)を使用しています。この技術は、各画面ピクセル内の個々の赤、緑、青のサブピクセルを処理することで機能し、テキストレンダリングの水平解像度を実質的に3倍にします。肉眼では、画面上の小さなテキストが鮮明でくっきりと見えます。しかし、スクリーンショットをフラットな画像として処理するOCRエンジンにとっては、同じテキストが色付きのフリンジ(文字境界の赤と青のエッジ)を伴って届き、エッジ検出、2値化、文字セグメンテーションを混乱させます。
閾値処理(認識前に画像を白黒に変換する)に依存する従来のOCRエンジンは、このアーティファクトに特に敏感です。2値化ステップで赤いサブピクセルのフリンジを持つ文字エッジに遭遇すると、そのフリンジを文字の一部または別のオブジェクトとして解釈する可能性があり、どちらにせよ文字の境界が予測不能にずれます。通常のドキュメントサイズ(10〜12pt)では、アーティファクトは文字に比べて小さく、OCRエンジンは正しく推測できます。6〜8ptでは、サブピクセルのフリンジが文字のストローク自体と同じくらいの幅になり、テキストではなく「色付きノイズ」を読み取っているように見える出力を生成します。
これをテストする方法:スクリーンショットからは悪い結果が得られるのに、同じドキュメントを300 DPIでスキャンすると問題なく機能し、かつテキストが小さくて人間の目でも画面上で読みにくい場合、サブピクセルレンダリングが原因の可能性があります。スクリーンショットを撮る前にブラウザまたはアプリケーションを150%にズームしてみてください。これにより、文字あたりのピクセル予算が増え、サブピクセルのフリンジが比例的により小さくなります。
色、コントラスト、スケーリングの問題を含む、スクリーンショット固有の抽出課題の詳細については、色付きの背景や透かしでOCR抽出が失敗する理由を参照してください。小さなテキストを含むスクリーンショットにも、同じ画像品質の原則の多くが適用されます。
実際に効果がある方法:実用的な修正優先順位
以下の修正は、効果が高く・手間が少ない順に並んでいます。上から順に試し、ワークフローに適した精度になった時点で止めてください。
修正1:小さな文字の文書は300+ DPIを目標にする
スキャン工程を管理できる場合、これが最も効果的な対策です。10pt未満の文字が含まれる文書は、標準の300 DPIではなく400〜600 DPIでスキャンしてください。ピッツバーグ大学のOCRベストプラクティスガイドでも、小さな文字の文書には400〜600 DPIが推奨されています。欠点はファイルサイズが大きくなり処理が遅くなることですが、小さな文字の精度が重要なページでは価値があります。FAXやメール添付など、解像度を制御できない文書については、ワークフローの既知の制約として記録しておいてください。すべての文書を同じ精度で抽出できるわけではなく、期待値を適切に設定すれば問題ありません。
修正2:抽出設計でフィールドの優先順位を適用する
列定義を見直し、小さな文字の付随テキストを対象とするフィールドを削除してください。6ptのフッター行にあるベンダー登録番号を実際に照合で使ったことがなければ、その列は削除しましょう。列を減らすごとに、確認不要となる低信頼度の出力が減ります。カスタム列抽出を使用する場合は、ツールの信頼度シグナルを確認してください。フィールドが一貫して低信頼度の値を返す場合、元のテキストが小さすぎてAIが推測している可能性があります。その場合は、手動確認を含めてそのフィールドを維持する価値があるか、別の方法でデータを取得できるかを判断してください。
修正3:超解像アップスケーリング — 使用は慎重に
AIベースのアップスケーリング(超解像、またはSR)は、既存のピクセル間に新しいピクセルを補間することで、150 DPIのスキャンを見かけ上300 DPIに拡大できます。小さなフォントのテキストに対する結果はまちまちです。単純な最近傍法やバイリニア補間によるアップスケーリングは新しい情報を追加しません — 同じ12ピクセルをより広い領域に広げるだけです。文書画像でトレーニングされたAI超解像モデル(SRGAN、ESRGAN、Real-ESRGAN)は、中程度に劣化したテキスト、特に印刷された高コントラストの文字で、ストロークのディテールの一部を復元できます。しかし、識別可能なピクセル特徴をすでに欠いている小さなフォントのテキストの場合、SRは決してキャプチャされなかった特徴を発明することはできません — 視覚的にはより滑らかな出力を生成するかもしれませんが、文字レベルの精度を実際に向上させることはありません。SRの最も信頼できるユースケースは、抽出ツールに渡す前に、すでに限界解像度のスキャン(例:200 DPIから400 DPI)のテキストを拡大することです — ファックスレベルの解像度でキャプチャされたテキストをSRが救うとは期待しないでください。
抽出前の前処理テクニック(アップスケーリング、二値化、傾き補正を含む)については、OCR画像前処理ガイドをご覧ください。
修正4:可能な場合はより良いソースドキュメントを再リクエストする
多くのプロフェッショナルなワークフロー — 特に買掛金管理、契約管理、税務文書処理 — では、より良いソースをリクエストするオプションがあります。ベンダーが150 DPIのファックス送信された請求書を送り、7ptの明細行の説明が一貫して読み取れない場合、ベンダーにデジタルPDFをメールで送ってもらうよう依頼してください。下請け業者が署名済みフォームのコピーのコピーを提出した場合、原本または鮮明な写真を依頼してください。この修正は常に利用できるわけではありません(一部のレガシーベンダーはファックスのみ、一部の政府フォームは固定の印刷形式のみ)が、チームが想定するよりも頻繁に利用可能です。メール1通のリクエストのコストは、バッチ全体で50件の抽出エラーを手動で修正するコストよりも低くなります。
正直な限界:7pt未満はどのシステムでも信頼できない
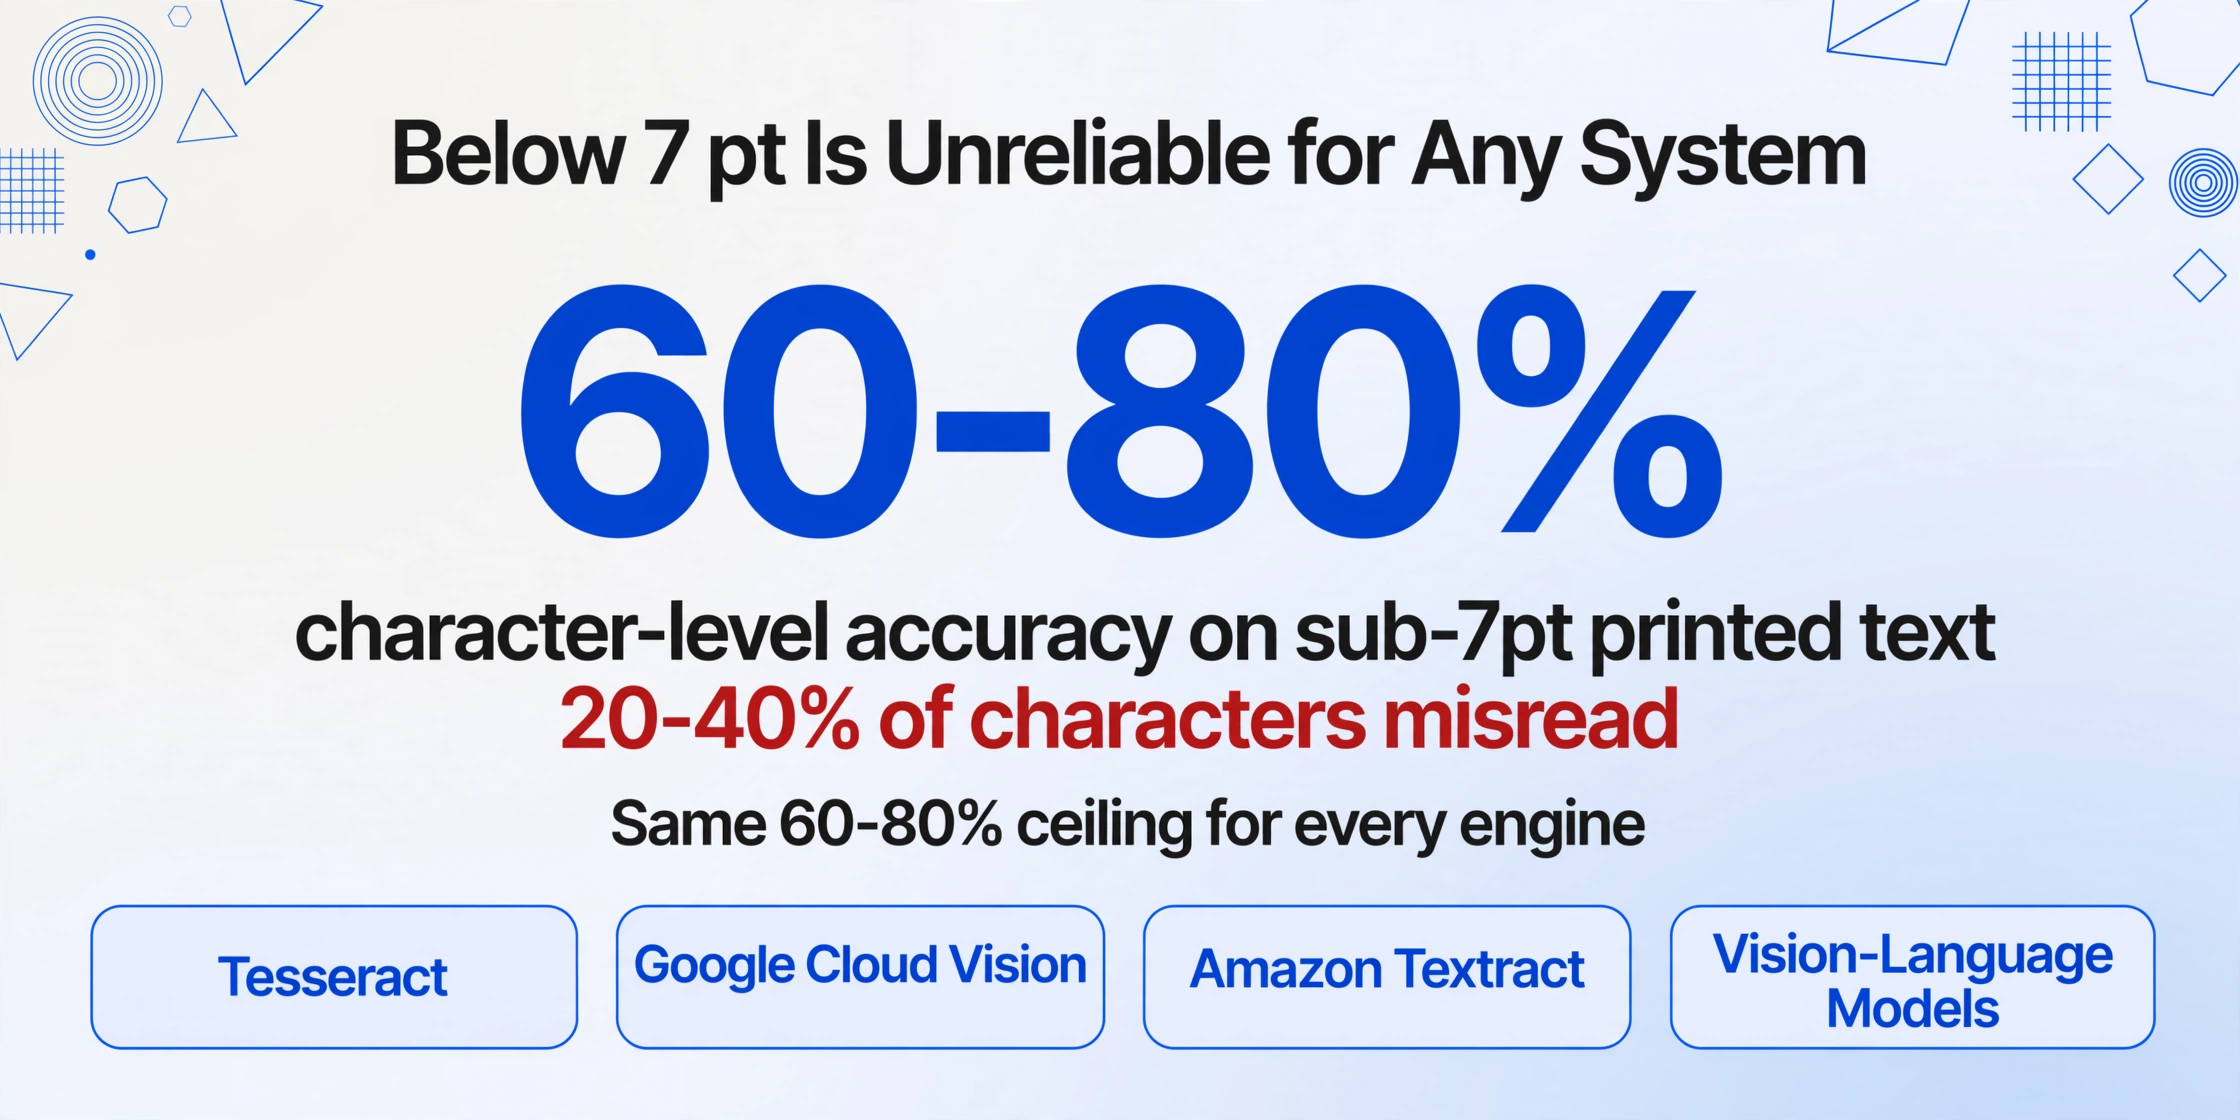
精度の向上、ワークフローの調整、ツールのアップグレードのいずれによっても、200 DPIスキャンから6ptのテキストを確実に抽出することはできません。ピクセル数の予算がそもそも足りないのです。7pt未満の印刷テキストに対する認識精度は、従来のOCRエンジンであれ最新のビジョン言語モデルであれ、文字レベルでおおよそ60〜80%で頭打ちになります。つまり、20〜40%の文字が誤読されるということです。請求書に記載された6ptの数字を99%のフィールドレベル精度で抽出することは不可能であり、デジタル化の物理的制約が支えられない入力を中心にワークフローを最適化する時間を費やすよりも、手動検証または省略を計画するというのが責任ある回答です。
この限界は、現在運用されているすべてのシステムに当てはまります。Tesseractだけでなく、従来のOCRだけでなく、Google Cloud Vision、Amazon Textract、ビジョン言語モデルベースのツールにも同様に当てはまります。小さいフォントのテキストに対するこれらのツール間の違いは、桁違いではなく数パーセントポイントで測定されます。ビジョンAIモデルは、周囲の文脈を使用して欠落した文字を推測するため、7pt未満のテキストで有利です。AIが「Inv_ice N_mber」を馴染みのある請求書ヘッダーの中で見た場合、正しい値を推測できます。ただし、この文脈に基づく推測には限界があります。特定のピクセルしきい値を下回る文字が真に曖昧な場合、推論はせいぜい教育的な推測に過ぎません。
さまざまなドキュメントタイプと条件にわたる精度の期待値のより広い見解については、OCR精度を向上させるための実践ガイドを参照してください。
よくある質問
高価な、または専門特化したAIツールは小さなフォントの抽出を解決できますか?
部分的には解決できますが、完全には解決できません。文脈の中でテキストを処理するビジョン言語モデルは、周囲のデータから推測することで小さなフォントの文字の一部を復元できます。例えば、「Invoic_ N_mber: INV-2026-0_4_」を読み取り、期待される請求書番号の形式に基づいて欠けた文字を補完できます。この文脈補正により、同じ小さなフォント入力に対する従来のOCRと比較して、フィールドレベルの精度を5〜15%ポイント向上させることができます。ただし、基本的なピクセル予算は変わりません。入力解像度が低すぎてAIがピクセルレベルで「5」と「S」を区別できない場合、いかなる文脈推論でも正しい答えを保証することはできません。信頼できる解決策は、より良いソース解像度のままです。
スキャンする代わりにスマートフォンで書類を撮影しても、小さなフォントの抽出を改善できますか?
確実にはできません。通常の距離(30〜40cm)から12MPの解像度で撮影したスマートフォンの写真は、書類に対して約150〜200の実効DPIになります。ファックスよりは良いですが、300DPIのフラットベッドスキャナーには及びません。さらに重要なのは、スマートフォンの写真には遠近歪み(スマートフォンを書類と完全に平行に保たない場合)、照明の不均一さ、モーションブラーの可能性が生じることです。これらはすべて小さなフォントの文字をさらに劣化させます。スマートフォンを使用する場合は、書類を平らな面に置き、均一な照明の下でスマートフォンを平行に保ち、フレームを書類で満たすように少しズーム(1.5〜2倍)してください。後でトリミングされる広角ショットよりも良い結果が得られます。
小さなフォントの場合、AI抽出は従来のOCRよりも大幅に優れていますか?
ぎりぎりの解像度(例:200DPIで7〜8pt)の小さなフォントテキストの場合、AI抽出は通常、従来のOCRよりも10〜25%ポイント優れています。文脈の理解により、文字単位のOCRエンジンでは解決できない曖昧さをAIが解決できます。非常に小さなテキスト(7pt未満)または非常に低い解像度(150DPI未満)では、両方のシステムが同じ根本的なピクセル不足に直面するため、差は縮まります。ツールの選択が最も重要になるのは、文脈推論と意味理解がまだ機能する境界領域です。これらのアプローチの詳細なフィールドレベルの比較については、AI OCR 対 従来のOCRの精度をご覧ください。
低解像度画像をアップスケーリングすると、小さなフォントのOCR精度は向上しますか?
はい、でも限定的です。単純な画像リサイズ(最近傍補間やバイリニア補間)は画像を大きくするだけで、情報を追加するわけではありません。文字のピクセルレベルの曖昧さは変わらず、ただ広がるだけです。ドキュメント画像で学習されたAIベースの超解像モデルは、失われたエッジ情報の一部を復元できますが、小さなフォントのテキストに対する改善は限定的で(通常、相対精度で5〜10%の向上)、元の画像品質に大きく依存します。アップスケーリングは前処理ステップとして試す価値はありますが、十分なソース解像度の代わりにはなりません。高DPIの原稿から始めることが常に信頼性の高い方法です。詳細は画像前処理ガイドをご覧ください。
言語や文字体系によって、小さなフォントの抽出は難しくなりますか?
はい。文字あたりのストローク複雑度が高い文字体系(デーヴァナーガリー、アラビア語、中国語、日本語、韓国語)は、識別特徴が多く細かいため、信頼性の高い認識には文字あたりのピクセル数がより多く必要です。200 DPIでの7ptのデーヴァナーガリー文字はOCRでは事実上読み取れないかもしれませんが、同じ解像度の7ptのラテン文字はかろうじて読み取れる可能性があります。ドキュメントに非ラテン文字が含まれる場合は、推奨最小DPIをそれに応じて引き上げてください。小さなテキストを含む混在文字ドキュメントでは、400 DPIを上限ではなく下限と考えるべきです。
小さなフォントの抽出には物理的な限界がありますが、その範囲内であれば、適切なワークフローの選択 — 十分な解像度、フィールドの優先順位付け、ツールの選定 — によって、信頼できるバッチとやり直しが必要なバッチの違いが生まれます。ご自身の小さなフォントの文書でテストし、実際の精度の上限を確認してください。
文書の抽出をテストする