Por que fontes pequenas quebram a
Precisão do OCR — 4 causas raiz e correções
Você digitalizou um contrato, rodou a extração em um extrato bancário com termos em letras miúdas, ou tentou capturar dados de itens de linha a partir de uma captura de tela de uma tabela densamente formatada. Os campos de 10pt e 12pt saíram bem. Mas o texto pequeno — a nota de rodapé de 6pt, o aviso legal de 7pt, os preços unitários em letras miúdas no final de uma cotação de fornecedor — produziu lixo ou nada. O problema não é que a IA seja ruim em ler fontes pequenas. O problema é física: a 150 DPI, um caractere de 6pt tem cerca de 12 pixels de altura. Doze pixels não são informação suficiente para nenhum sistema — humano ou máquina — distinguir um "8" de um "6" ou um "rn" de um "m".
Principais conclusões
- Um caractere de 6pt digitalizado a 150 DPI tem 12 pixels de altura — doze. As características que distinguem um "8" de um "6" ocupam 2 desses 12 pixels, e um único pixel de ruído do scanner apaga a diferença. Isso não é um problema de IA; é um problema de física que toda ferramenta de extração no mercado compartilha.
- A regra dos 20 pixels: se um caractere ocupa menos de 20–25 pixels de altura, a diferença entre "rn" e "m" ou "5" e "S" se reduz a um pixel de ambiguidade. A maioria dos scanners MFP de escritório usa 200 DPI por padrão, o que empurra tudo abaixo de 10pt para essa zona de perigo — seu texto corrido é extraído bem enquanto os valores da tabela viram ruído.
- Você não pode adicionar pixels que nunca foram capturados, mas pode parar de lutar contra a física: digitalize documentos com fontes pequenas a 400+ DPI, defina colunas de extração apenas para os dados que seu fluxo de trabalho realmente precisa, e trate texto abaixo de 7pt como um limite rígido em vez de uma falha a corrigir.
O Problema É Física, Não IA
Quando um mecanismo de OCR ou um modelo de IA de visão falha em textos pequenos, o primeiro instinto é culpar o software. Mas o verdadeiro gargalo aparece antes de qualquer processamento de IA começar — ele é determinado pelo número de pixels disponíveis por caractere.
Eis a matemática. Um "ponto" em tipografia é 1/72 de polegada. A 150 DPI (pontos por polegada, a resolução de um fax típico ou scanner de baixo custo), a altura em pixels de um caractere é:
altura em pixels = tamanho da fonte (pt) × DPI / 72
Para um caractere de 6pt a 150 DPI:
6 × 150 / 72 = 12,5 pixels
Doze pixels é aproximadamente a altura de uma única letra no menor tamanho de fonte que seu sistema operacional permite em uma janela de terminal. Agora considere o que acontece dentro de um caractere nessa escala. As características distintivas que separam "8" de "6" — um laço superior fechado vs. um laço inferior fechado — ocupam no máximo 2 a 3 pixels. Um único pixel de ruído do sensor do scanner, um grau fracionário de inclinação da página ou o bloco de compressão JPEG de uma foto de celular pode eliminar essa distinção por completo. O caractere "m" e o par "rn" ocupam a mesma largura de coluna de 2-3 pixels em tamanhos pequenos — eles se tornam estruturalmente idênticos.
Este não é um problema que um melhor treinamento de IA ou um pós-processamento de OCR mais sofisticado possa resolver. O sinal de entrada está sem a informação necessária para que qualquer sistema de reconhecimento produza a saída correta. Toda correção subsequente neste artigo contorna essa restrição ou a reduz — mas a restrição em si é inevitável.
Quantos Pixels um Caractere Realmente Precisa?
Para entender quando uma fonte pequena se torna um problema prático, relacione o tamanho da fonte e a resolução de digitalização com a altura em pixels. O limiar crítico para o reconhecimento de caracteres é de aproximadamente 20-25 pixels de altura de caractere para uma discriminação confiável entre glifos semelhantes:
| Tamanho da Fonte | 150 DPI | 200 DPI | 300 DPI | 400 DPI | 600 DPI |
|---|---|---|---|---|---|
| 6 pt | 12 px ✗ | 17 px ✗ | 25 px ⚠ | 33 px ✓ | 50 px ✓ |
| 7 pt | 15 px ✗ | 19 px ⚠ | 29 px ✓ | 39 px ✓ | 58 px ✓ |
| 8 pt | 17 px ✗ | 22 px ⚠ | 33 px ✓ | 44 px ✓ | 67 px ✓ |
| 10 pt | 21 px ⚠ | 28 px ✓ | 42 px ✓ | 56 px ✓ | 83 px ✓ |
| 12 pt | 25 px ✓ | 33 px ✓ | 50 px ✓ | 67 px ✓ | 100 px ✓ |
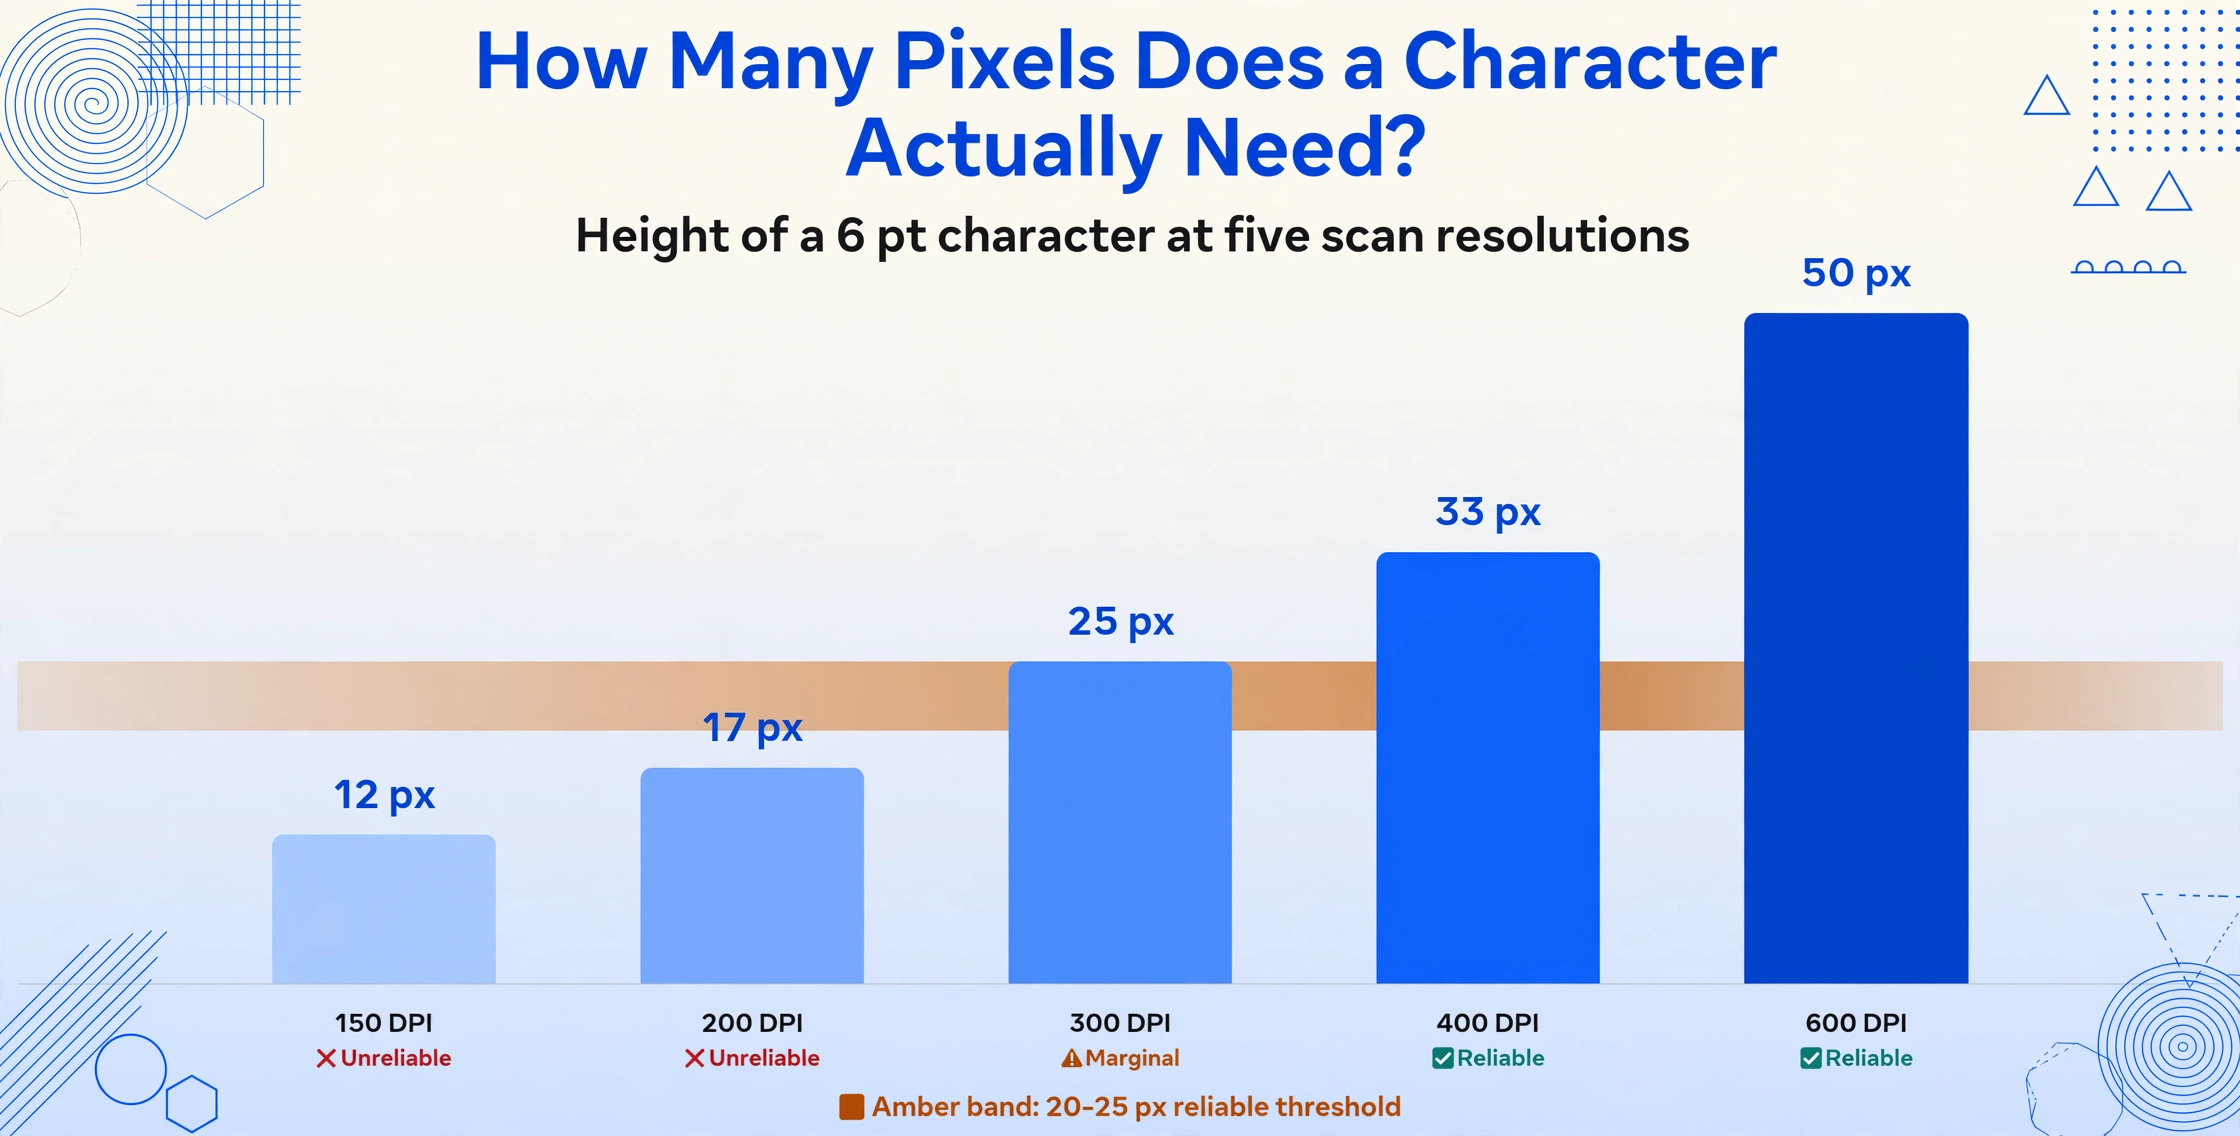
✗ = não confiável ⚠ = marginal ✓ = geralmente confiável para texto impresso. Estas são estimativas de altura de caractere — o reconhecimento também depende da largura do traço, do contraste e do design da fonte.
A tabela deixa o padrão evidente: a 300 DPI padrão, o texto de 6pt fica bem na linha marginal. A 200 DPI — a resolução de muitas impressoras multifuncionais de escritório e da maioria dos documentos enviados por fax — tudo abaixo de 10pt é marginal ou não confiável. Quando você chega a 150 DPI (comum em faxes e PDFs de baixa qualidade), apenas 12pt ou mais é confiável.
Causa 1: Resolução de digitalização abaixo de 200 DPI
A causa única mais comum de falha na extração de fontes pequenas é a resolução de digitalização muito baixa para o texto desejado. O problema não é que o hardware do scanner em si seja inadequado — é que o fluxo de digitalização foi projetado para texto legível (~10-12pt de corpo de texto) e ninguém o ajustou para os caracteres menores que aparecem em notas de rodapé, células de tabela, avisos legais e instruções de formulários.
Por que 200 DPI é o limiar de perigo: A 200 DPI, um caractere de 8pt — o tamanho típico de muitos valores de células de tabela e rótulos de formulários — produz apenas 22 pixels de altura. Caracteres como "e" e "c" tornam-se quase indistinguíveis porque o contador aberto (o espaço interior da letra) colapsa para 1 pixel. A volta de um "8" e a barriga de um "6" ocupam o mesmo espaço vertical de 2 pixels. É por isso que faturas enviadas por fax e contratos digitalizados rotineiramente produzem erros de extração em seções com fontes pequenas, enquanto o corpo principal do texto parece bom.
O que verificar: Se o seu PDF digitalizado foi produzido por uma MFP de escritório (impressora multifuncional) configurada no modo padrão de "qualidade padrão", quase certamente está a 200 DPI. Documentos enviados por fax chegam a 100-200 DPI, dependendo do equipamento do remetente. Antes de culpar a ferramenta de extração, verifique o DPI efetivo da imagem de entrada: abra as propriedades do arquivo em qualquer visualizador de imagens e divida a largura em pixels pela largura física da página em polegadas. Se o resultado for inferior a 250 DPI e o seu documento contiver texto abaixo de 10pt, a resolução provavelmente é a causa raiz.
Para saber mais sobre como a qualidade da imagem interage com a precisão da extração em diferentes tipos de documentos, consulte nosso guia sobre baixa precisão de OCR em documentos digitalizados.
Causa 2: A escolha da fonte amplifica o problema de resolução
Nem todos os caracteres de 8pt são criados iguais. O design da fonte determina quanto do orçamento de pixels disponível é realmente utilizável para reconhecimento:
Sans-serif vs. serif em tamanhos pequenos. Uma fonte serifada como Times New Roman adiciona traços decorativos (serifas) nas extremidades das hastes das letras. A 10pt e acima, essas serifas auxiliam a legibilidade. A 6-8pt em uma digitalização de 200 DPI, as serifas se fundem à haste principal, espessando o caractere de forma imprevisível e tornando caracteres adjacentes mais difíceis de separar. Fontes sans-serif (Arial, Helvetica, Calibri) não possuem esses traços extras, o que significa que suas formas mais simples sobrevivem melhor à digitalização em baixa resolução. A própria documentação do Tesseract e várias diretrizes de bibliotecas recomendam especificamente fontes sans-serif para documentos compatíveis com OCR.
Pesos de fonte finos/leves. O peso "Light" ou "Thin" de uma família de fontes — popular no design de marcas modernas, cabeçalhos de relatórios financeiros e UI minimalista — usa hastes que podem ter apenas 1 pixel de largura nas resoluções de digitalização comuns. Um único pixel de largura de haste significa que qualquer ruído, artefato de compressão ou variação do sensor do scanner irá quebrar a haste (tornando o caractere invisível) ou espessá-la assimetricamente (alterando a forma do caractere). Pesos negrito e regular, com larguras de haste de 2-3 pixels na mesma resolução, têm significativamente mais tolerância a esses artefatos.
Fontes com glifos ambíguos. Certos designs de fontes tornam caracteres que já são difíceis para o OCR ainda mais difíceis. Arial, por exemplo, renderiza o "l" minúsculo (L) e o "I" maiúsculo (i) de forma idêntica — o único sinal distintivo é o contexto, que o OCR tradicional não possui. Em tamanhos pequenos, essa ambiguidade piora porque qualquer diferença visual restante (uma fração de pixel na serifa ou na altura da haste) desaparece completamente.
O padrão prático: se o texto pequeno no seu documento usa uma fonte sans-serif leve moderna (comum em extratos bancários europeus, faturas de SaaS e relatórios de investimento), você verá erros de extração em tamanhos nos quais uma fonte mais negrito ou com serifas ainda produziria saída legível. A escolha da fonte não causa o problema — mas determina em qual altura de pixel o problema se torna visível.
Causa 3: Tentar Extrair Tudo em Vez de Priorizar
Isso é menos um problema técnico e mais um problema de design de fluxo de trabalho — mas é uma das fontes mais comuns de frustração com a extração de fontes pequenas.
Muitos usuários abordam a extração com a mentalidade de que tudo na página deve ser capturado: cada item de linha, cada aviso legal, cada nota de rodapé, cada anotação à margem. Quando um aviso legal de 6pt na parte inferior de um extrato bancário produz saída ilegível, parece que toda a extração falhou. Na prática, o corpo do texto e os principais valores financeiros podem ter sido extraídos perfeitamente — a falha ficou isolada em uma seção de texto que nenhum fluxo de trabalho prático realmente precisa.
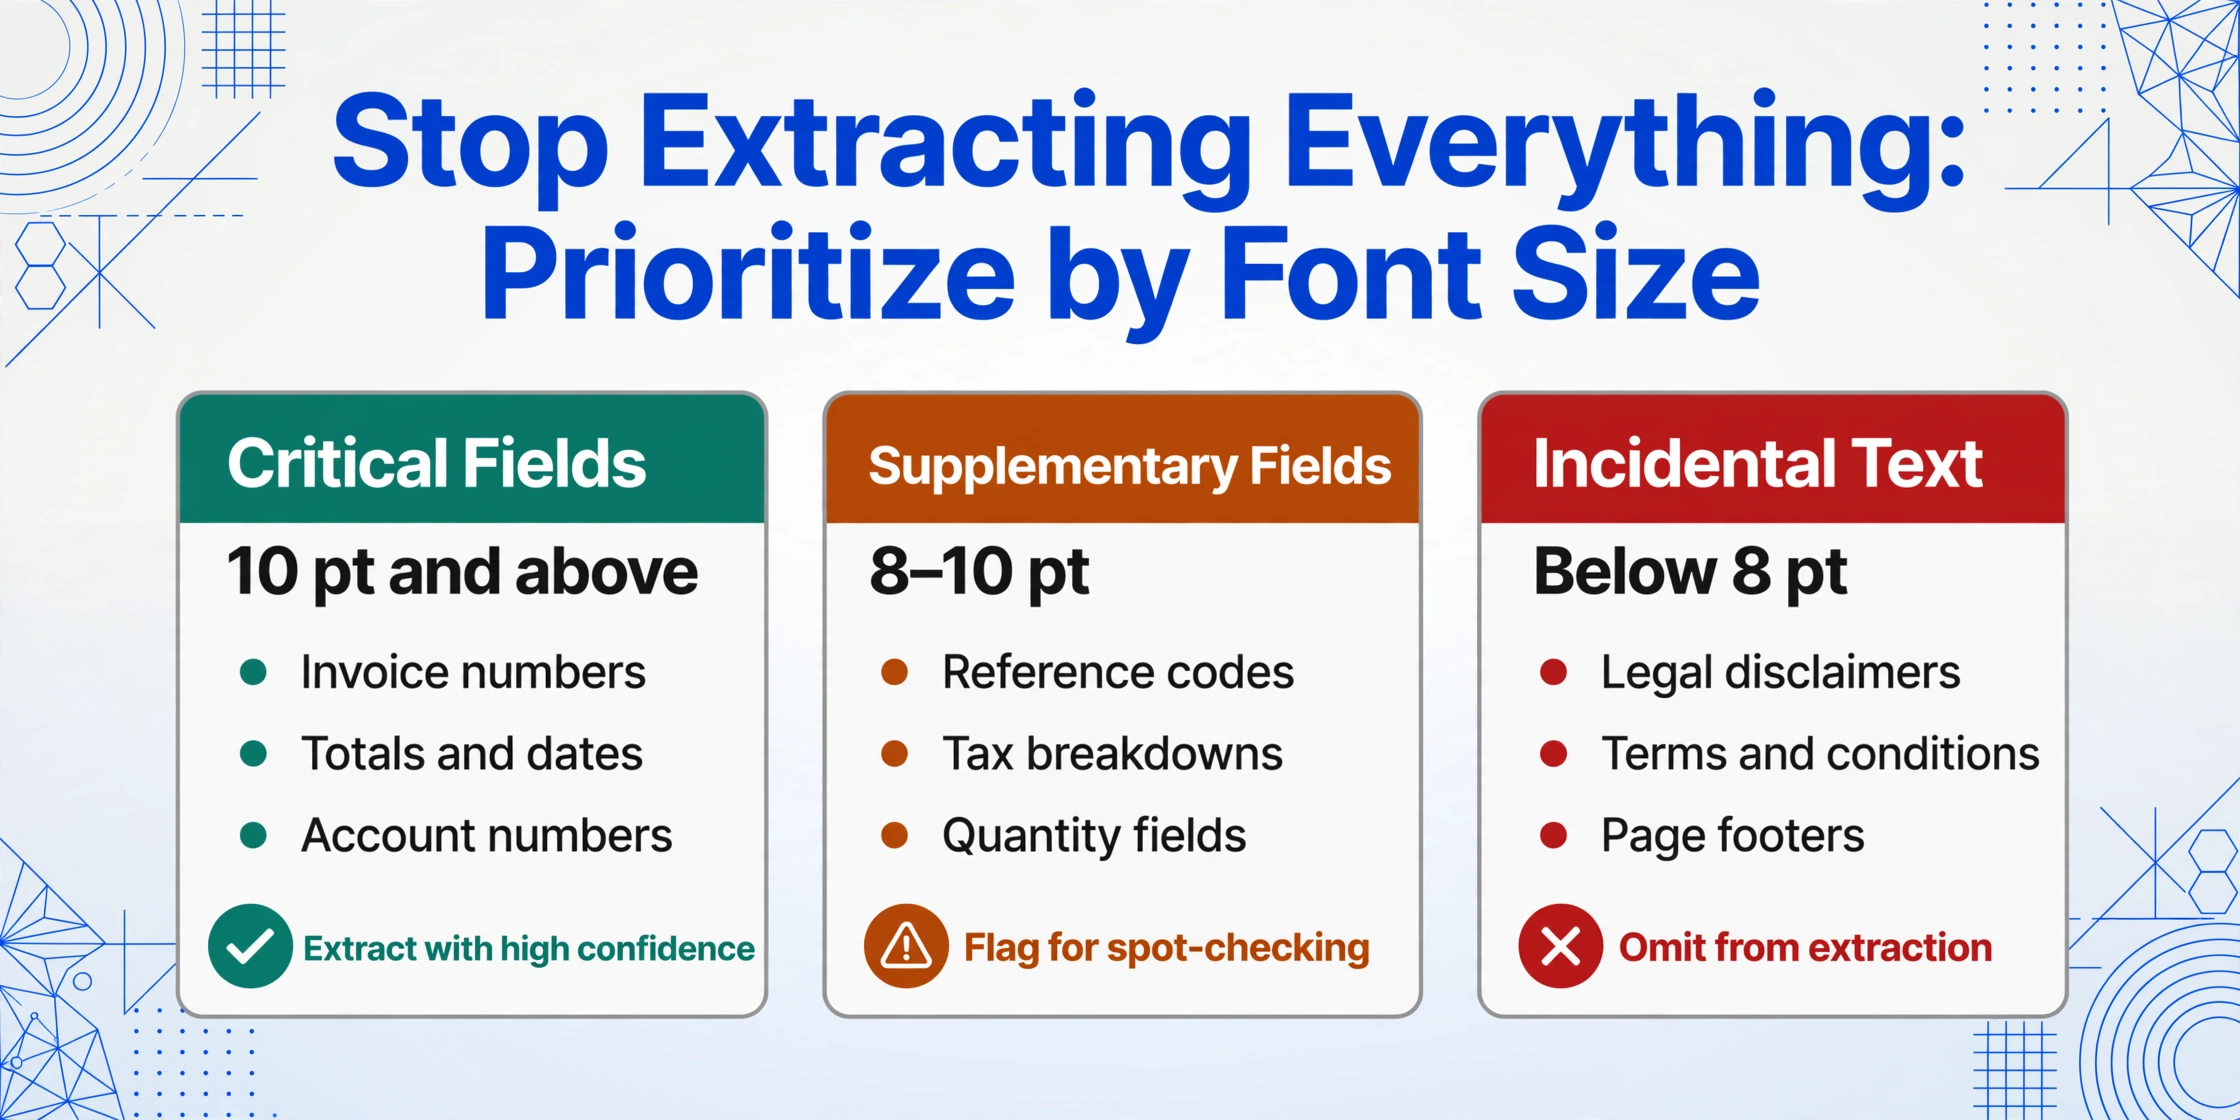
A estratégia de priorização de campos: Antes de extrair, separe o conteúdo do documento em três categorias:
- Campos críticos (10pt+) — números de fatura, totais, datas, nomes de fornecedores, números de conta, números de apólice. Estes quase sempre estão em um tamanho de fonte legível e carregam o peso financeiro ou operacional. Extraia-os com alta confiança.
- Campos suplementares (8-10pt) — códigos de referência, nomes de departamentos, detalhamentos de impostos, campos de quantidade. Geralmente extraíveis a 300 DPI, possivelmente marginais em resoluções mais baixas. Marque-os para verificação pontual.
- Texto incidental (abaixo de 8pt) — avisos legais, avisos de direitos autorais, termos e condições, rodapés de página, instruções em letras miúdas. Raramente são necessários em um fluxo de trabalho de dados estruturados. Considere omiti-los completamente da extração em vez de deixar erros nesses campos minarem a confiança no resultado geral.
Ao usar uma ferramenta de extração com IA com Extração de Colunas Personalizadas (onde você digita os nomes das colunas que precisa e a IA localiza os valores semanticamente), essa priorização já está incorporada ao fluxo de trabalho por design: você só define colunas para os dados que realmente precisa. A IA não desperdiça capacidade de processamento em seções do documento que você nunca solicitou. Se uma coluna contém um valor de uma região de fonte pequena, sua pontuação de confiança oferece um sinal natural para revisão manual.
O mesmo princípio se aplica ao processamento em lote: se você está extraindo 50 cotações de fornecedores e os termos em letras miúdas aparecem em todas as linhas com precisão variável, pergunte-se se você precisa desses termos na planilha. Muitas vezes a resposta é não — e descartá-los melhora tanto a velocidade de extração quanto a qualidade percebida da saída.
Causa 4: Artefatos de renderização de subpixel em capturas de tela
Esta causa é quase invisível (literalmente) ao olho humano, mas produz algumas das falhas de extração mais confusas. Ela afeta apenas capturas de tela — mas, como uma fração crescente do processamento de documentos começa como capturas de tela (exportações de dashboards, faturas de portais web, capturas de tela de aplicativos móveis), ela importa para mais fluxos de trabalho do que a maioria das pessoas imagina.
Os sistemas operacionais modernos usam renderização de subpixel (ClearType no Windows, Core Text no macOS) para melhorar a clareza do texto em telas LCD. A técnica funciona endereçando subpixels individuais vermelhos, verdes e azuis dentro de cada pixel da tela, efetivamente triplicando a resolução horizontal para a renderização de texto. Para o seu olho, isso faz com que textos pequenos na tela pareçam nítidos e bem definidos. Para um mecanismo de OCR processando a captura de tela como uma imagem plana, o mesmo texto chega com franjas coloridas — bordas vermelhas e azuis nos limites dos caracteres — que confundem a detecção de bordas, a binarização e a segmentação de caracteres.
Mecanismos de OCR tradicionais que dependem de limiarização (converter a imagem para preto e branco antes do reconhecimento) são particularmente sensíveis a esse artefato. Quando a etapa de binarização encontra uma borda de caractere com uma franja de subpixel vermelha, ela pode interpretar a franja como parte do caractere ou como um objeto separado — de qualquer forma, o limite do caractere se desloca de maneira imprevisível. Em tamanhos normais de documento (10-12pt), o artefato é pequeno em relação ao caractere e o mecanismo de OCR ainda consegue adivinhar corretamente. Em 6-8pt, a franja de subpixel pode ser tão larga quanto o próprio traço do caractere, produzindo uma saída que parece "ler" ruído colorido em vez de texto.
Como testar isso: Se você está obtendo resultados ruins de uma captura de tela, mas o mesmo documento digitalizado a 300 DPI funciona bem — e o texto é pequeno o suficiente para que o olho humano tenha dificuldade em lê-lo na tela — a renderização de subpixel é um provável contribuinte. Tente ampliar o navegador ou o aplicativo para 150% antes de tirar a captura de tela, o que aumenta o orçamento de pixels por caractere e torna a franja de subpixel proporcionalmente menor.
Para uma análise mais detalhada dos desafios de extração específicos de capturas de tela, incluindo problemas de cor, contraste e escala, consulte por que a extração por OCR falha em fundos coloridos e marcas d'água — muitos dos mesmos princípios de qualidade de imagem se aplicam a capturas de tela com texto pequeno.
O que realmente funciona: uma hierarquia prática de correções
As correções abaixo estão ordenadas do maior impacto / menor esforço ao menor impacto / maior esforço. Comece pelo topo e pare quando a precisão estiver aceitável para o seu fluxo de trabalho.
Correção 1: mire em 300+ DPI para documentos com texto pequeno
Se você controla a etapa de digitalização, esta é a ação mais eficaz de todas. Para documentos que se sabe conterem texto abaixo de 10pt, digitalize a 400-600 DPI em vez dos 300 DPI padrão. O guia de boas práticas de OCR da Universidade de Pittsburgh confirma que 400-600 DPI é recomendado especificamente para documentos com fontes pequenas. A contrapartida são arquivos maiores e processamento mais lento, mas para o subconjunto de páginas em que a precisão de fontes pequenas importa, o aumento vale a pena. Para documentos enviados por fax ou e-mail, em que você não pode controlar a origem, registre o limite de resolução como uma restrição conhecida no seu fluxo de trabalho — nem todos os documentos podem ser extraídos com a mesma precisão, e isso é aceitável desde que as expectativas sejam definidas de acordo.
Correção 2: aplique a priorização de campos no seu design de extração
Revise suas definições de coluna e remova qualquer campo que tenha como alvo texto incidental em fonte pequena. Se a linha de rodapé em 6pt contém um número de registro de fornecedor que você nunca usou de fato na conciliação, elimine a coluna. Cada coluna removida é uma fonte de saída de baixa confiança que não precisa mais ser verificada. Ao usar Extração de Colunas Personalizadas, explore os sinais de confiança da ferramenta — se um campo retorna consistentemente valores de baixa confiança, verifique se o texto de origem é pequeno o suficiente para que a IA esteja genuinamente adivinhando. Se for o caso, decida se o campo vale a pena manter com verificação manual ou se você pode obtê-lo de outra forma.
Correção 3: Upscaling com Super-Resolução — Use com Cautela
O upscaling baseado em IA (super-resolução, ou SR) pode ampliar um scan de 150 DPI para aparentes 300 DPI, interpolando novos pixels entre os existentes. Os resultados em textos com fontes pequenas são mistos: o upscaling simples por vizinho mais próximo ou bilinear não adiciona novas informações — apenas espalha os mesmos 12 pixels por mais espaço. Modelos de super-resolução por IA (SRGAN, ESRGAN, Real-ESRGAN) treinados em imagens de documentos podem recuperar alguns detalhes de traços em textos moderadamente degradados, especialmente em caracteres impressos de alto contraste. Para textos com fontes pequenas que já não possuem características de pixel distintivas, no entanto, a SR não pode inventar características que nunca foram capturadas — ela pode produzir uma saída visualmente mais suave sem realmente melhorar a precisão em nível de caractere. O caso de uso mais confiável para a SR é ampliar o texto de um scan com resolução já marginal (por exemplo, 200 DPI para 400 DPI) antes de passá-lo a uma ferramenta de extração — não espere que a SR salve textos capturados em resolução de fax.
Para técnicas de pré-processamento que funcionam antes da extração, incluindo upscaling, binarização e correção de inclinação, consulte nosso guia de pré-processamento de imagens para OCR.
Correção 4: Solicite Novamente Documentos de Origem Melhores Quando Possível
Em muitos fluxos de trabalho profissionais — particularmente contas a pagar, gestão de contratos e processamento de documentos fiscais — você tem a opção de solicitar uma origem melhor. Se um fornecedor envia uma fatura por fax a 150 DPI e as descrições dos itens de linha em 7pt são consistentemente ilegíveis, peça ao fornecedor que envie um PDF digital por e-mail. Se um subcontratado envia uma fotocópia de uma fotocópia de um formulário assinado, peça o original ou uma foto limpa. Essa correção nem sempre está disponível (alguns fornecedores legados só usam fax, alguns formulários governamentais só vêm em formato impresso fixo), mas está disponível com mais frequência do que as equipes supõem. O custo de um pedido por e-mail é menor do que o custo de corrigir manualmente 50 erros de extração em um lote.
O Limite Honesto: Abaixo de 7pt É Não Confiável para Qualquer Sistema
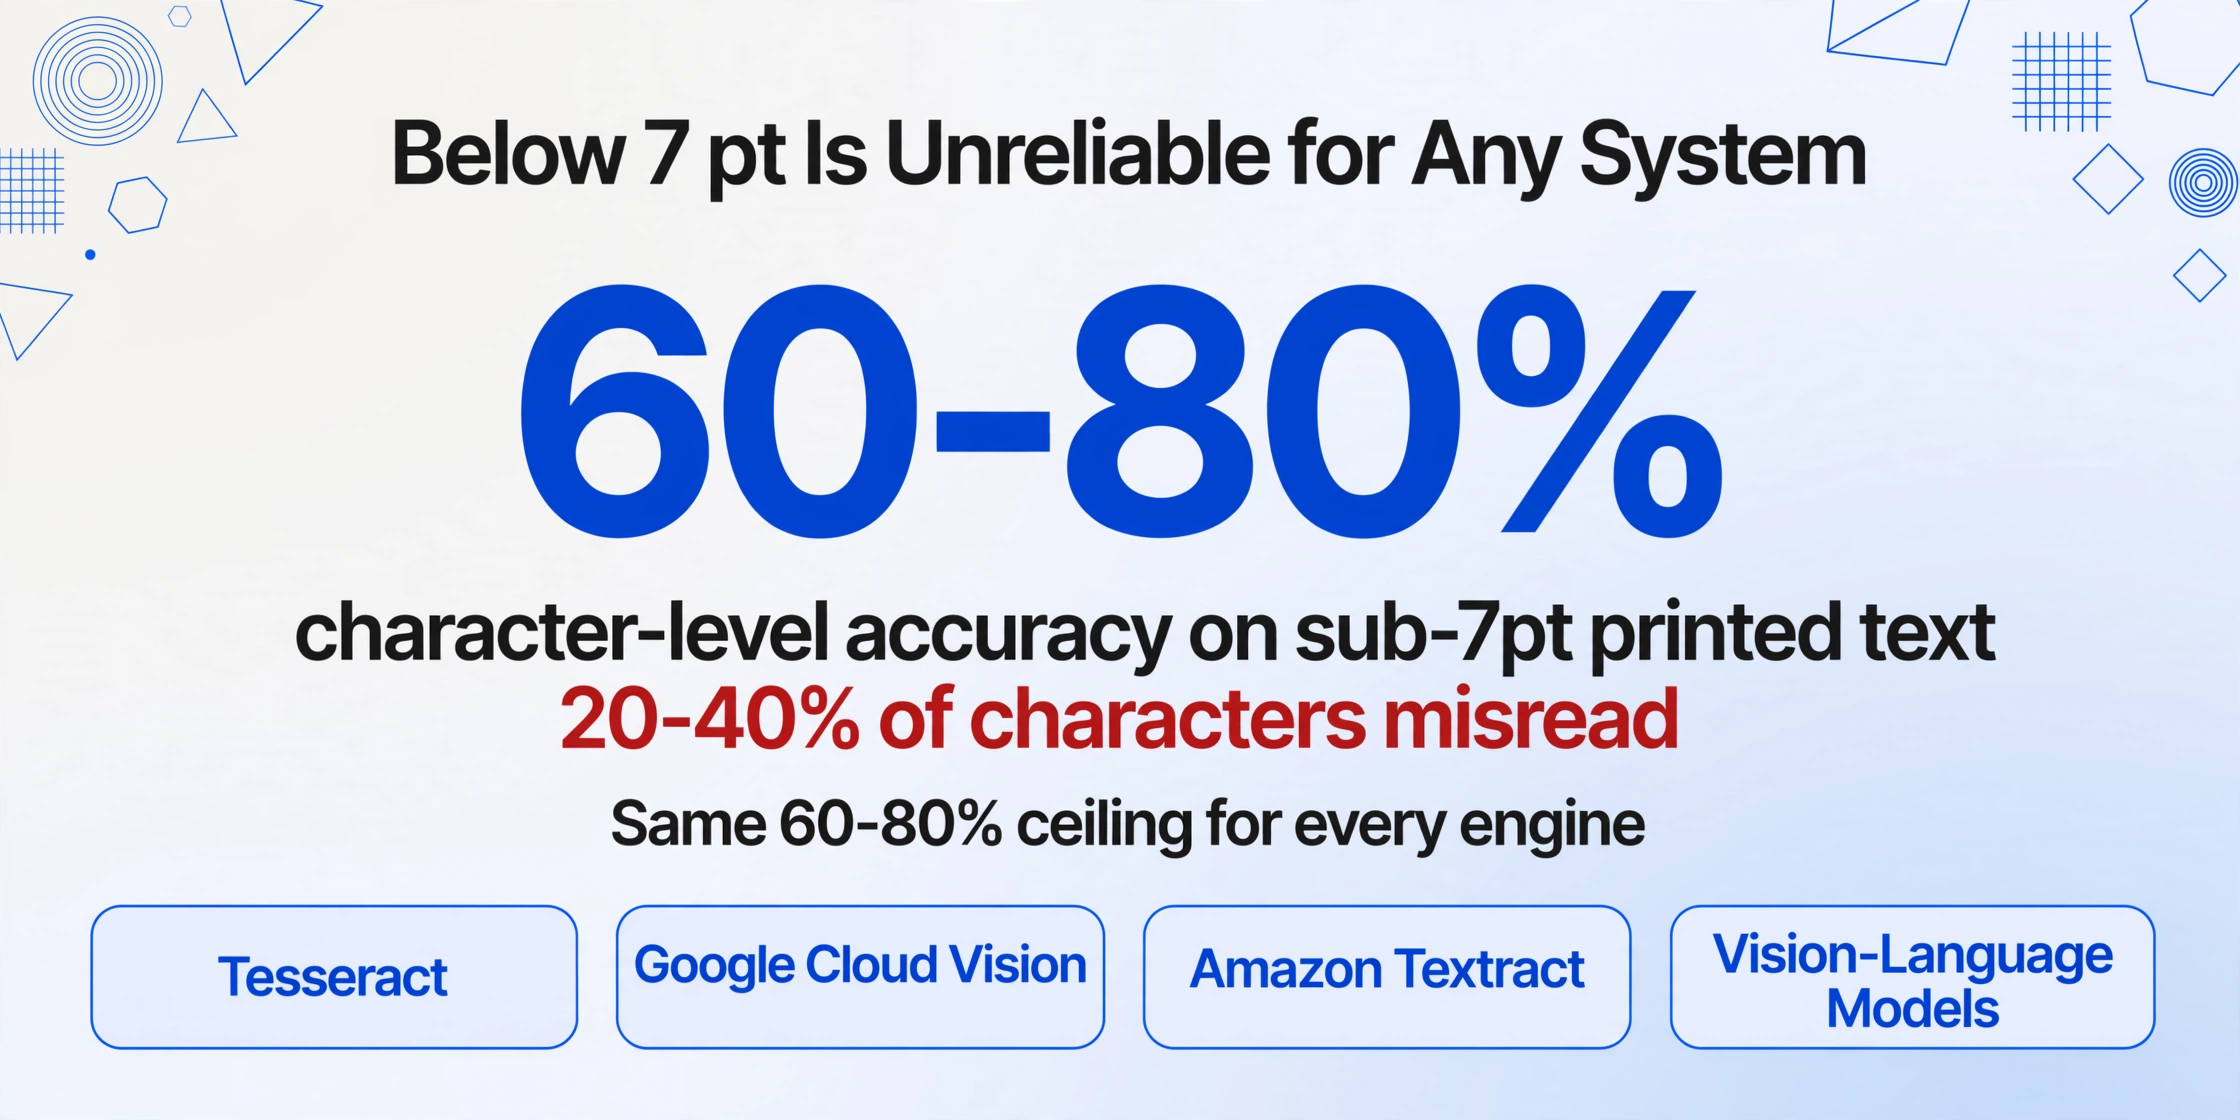
Nenhuma melhoria de precisão, ajuste de fluxo de trabalho ou atualização de ferramenta tornará o texto de 6pt extraível de forma confiável a partir de uma digitalização de 200 DPI. O orçamento de pixels simplesmente não está lá. A precisão de reconhecimento em texto impresso abaixo de 7pt atinge um patamar de aproximadamente 60-80% em nível de caractere — ou seja, 20-40% dos caracteres são mal lidos — independentemente de o mecanismo ser OCR tradicional ou um modelo moderno de visão-linguagem. A margem naquele número de 6pt na sua fatura não será extraível com 99% de precisão em nível de campo, e a resposta responsável é planejar para verificação manual ou omissão em vez de gastar tempo otimizando um fluxo de trabalho em torno de uma entrada que a física da digitalização não pode suportar.
Este limite se aplica a todos os sistemas atualmente em produção. Não apenas Tesseract, não apenas OCR legado — aplica-se ao Google Cloud Vision, Amazon Textract e ferramentas baseadas em modelos de visão-linguagem igualmente. A diferença entre essas ferramentas em texto de fonte pequena é medida em pontos percentuais, não em ordens de magnitude. Modelos de IA de visão têm uma vantagem em texto abaixo de 7pt porque usam o contexto ao redor para adivinhar um caractere ausente — se a IA vê "Inv_ice N_mber" entre cabeçalhos de fatura familiares, ela pode inferir os valores corretos — mas esse trabalho de adivinhação contextual tem um teto. Quando caracteres abaixo de um certo limiar de pixels são genuinamente ambíguos, a inferência é um palpite educado na melhor das hipóteses.
Para uma visão mais ampla das expectativas de precisão em diferentes tipos de documentos e condições, consulte nosso guia prático para melhorar a precisão do OCR.
Perguntas Frequentes
Uma ferramenta de IA mais cara ou especializada resolveria a extração de fontes pequenas?
Parcialmente, mas não completamente. Um modelo de visão e linguagem que processa texto em contexto pode recuperar alguns caracteres de fontes pequenas inferindo-os a partir dos dados ao redor — por exemplo, lendo "Invoic_ N_mber: INV-2026-0_4_" e preenchendo os caracteres ausentes com base no formato esperado do número da fatura. Essa correção contextual pode melhorar a precisão no nível do campo em 5 a 15 pontos percentuais em relação ao OCR tradicional na mesma entrada de fonte pequena. No entanto, ela não altera o orçamento fundamental de pixels. Se a resolução de entrada for baixa demais para a IA distinguir entre "5" e "S" no nível do pixel, nenhuma quantidade de raciocínio contextual pode garantir a resposta correta. A solução confiável continua sendo uma resolução de origem melhor.
Posso tirar uma foto de um documento com o celular em vez de digitalizá-lo para obter uma melhor extração de fontes pequenas?
Não de forma confiável. Uma foto tirada com o celular a uma distância normal (30-40 cm) com resolução de 12 MP produz cerca de 150-200 DPI efetivos do documento — melhor que um fax, mas não tão bom quanto uma digitalização em mesa de 300 DPI. Mais importante ainda, fotos de celular introduzem distorção de perspectiva (a menos que o celular seja mantido perfeitamente paralelo ao documento), iluminação irregular e possível desfoque de movimento — todos os quais degradam ainda mais os caracteres de fontes pequenas. Se você precisar usar um celular, coloque o documento em uma superfície plana sob luz uniforme, mantenha o celular paralelo e aplique um leve zoom (1,5-2x) para preencher o quadro com o documento. Isso produz resultados melhores do que uma foto ampla que será recortada depois.
A extração por IA é significativamente melhor que o OCR tradicional para fontes pequenas?
Em texto de fonte pequena com resolução marginal (por exemplo, 7-8pt a 200 DPI), a extração por IA geralmente supera o OCR tradicional em 10 a 25 pontos percentuais — a compreensão contextual dá à IA uma vantagem na resolução de ambiguidades que um mecanismo de OCR caractere por caractere não consegue resolver. Em texto muito pequeno (abaixo de 7pt) ou resolução muito baixa (abaixo de 150 DPI), a diferença diminui porque ambos os sistemas enfrentam a mesma escassez subjacente de pixels. A escolha da ferramenta importa mais nos limites — onde a inferência contextual e a compreensão semântica ainda podem operar. Para uma comparação detalhada no nível do campo dessas abordagens, consulte Precisão do OCR por IA vs. OCR tradicional.
Aumentar a resolução de uma imagem de baixa resolução melhora a precisão do OCR em fontes pequenas?
Sim e não. O redimensionamento simples da imagem (vizinho mais próximo ou interpolação bilinear) torna a imagem maior, mas não adiciona informação — os caracteres ainda têm a mesma ambiguidade em nível de pixel, apenas distribuída por mais pixels. Modelos de super-resolução baseados em IA treinados em imagens de documentos podem recuperar parte da informação de bordas perdida, mas a melhoria em textos com fontes pequenas é modesta (normalmente 5-10% de ganho relativo de precisão) e depende muito da qualidade da imagem original. Vale a pena tentar o aumento de resolução como etapa de pré-processamento, mas ele não substitui uma resolução de origem adequada. Partir de um original com DPI mais alto é sempre o caminho mais confiável, como discutido em nosso guia de pré-processamento de imagens.
O idioma ou o alfabeto tornam a extração de fontes pequenas mais difícil?
Sim. Alfabetos com alta complexidade de traços por caractere (devanágari, árabe, chinês, japonês, coreano) exigem mais pixels por caractere para um reconhecimento confiável, porque as características distintivas são mais numerosas e mais finas. Um caractere devanágari de 7pt a 200 DPI pode ser efetivamente ilegível para o OCR, enquanto um caractere latino de 7pt na mesma resolução ainda pode ser marginalmente legível. Se seus documentos contêm alfabetos não latinos, aumente a recomendação de DPI mínimo de acordo — 400 DPI deve ser considerado o piso para documentos com alfabetos mistos e textos pequenos, não o teto.
A extração de fontes pequenas tem um limite físico rígido, mas dentro desse limite as escolhas certas de fluxo de trabalho — resolução adequada, priorização de campos e seleção de ferramenta — fazem a diferença entre um lote em que você confia e um lote que você refaz. Teste nos seus próprios documentos com fontes pequenas e veja onde seu teto de precisão realmente está.
Testar extração no seu documento