Por qué las fuentes pequeñas rompen
la precisión del OCR — 4 causas raíz y soluciones
Escaneó un contrato, ejecutó la extracción en un extracto bancario con términos en letra pequeña, o intentó capturar datos de partidas de una captura de pantalla de una tabla densamente formateada. Los campos de 10pt y 12pt salieron bien. Pero el texto pequeño — la nota al pie de 6pt, el aviso legal de 7pt, los precios unitarios en letra pequeña al final de una cotización de proveedor — produjo basura o nada en absoluto. El problema no es que la IA sea mala leyendo fuentes pequeñas. El problema es la física: a 150 DPI, un carácter de 6pt mide aproximadamente 12 píxeles de alto. Doce píxeles no son información suficiente para que ningún sistema — humano o máquina — distinga un "8" de un "6" o una "rn" de una "m".
Conclusiones clave
- Un carácter de 6pt escaneado a 150 DPI mide 12 píxeles de alto — doce. Las características que distinguen un "8" de un "6" ocupan 2 de esos 12 píxeles, y un solo píxel de ruido del escáner borra la diferencia. Esto no es un problema de IA; es un problema de física que comparten todas las herramientas de extracción del mercado.
- La regla de los 20 píxeles: si un carácter ocupa menos de 20–25 píxeles de alto, la brecha entre "rn" y "m" o "5" y "S" se reduce a un píxel de ambigüedad. La mayoría de los escáneres multifunción de oficina usan 200 DPI por defecto, lo que empuja todo lo que está por debajo de 10pt a esa zona de peligro — su texto principal se extrae bien mientras que los valores de la tabla se convierten en ruido.
- No puede añadir píxeles que nunca se capturaron, pero puede dejar de luchar contra la física: escanee documentos con fuentes pequeñas a 400+ DPI, defina columnas de extracción solo para los datos que su flujo de trabajo realmente necesita, y trate el texto por debajo de 7pt como un límite duro en lugar de un fallo que hay que corregir.
El problema es la física, no la IA
Cuando un motor de OCR o un modelo de IA visual falla con texto pequeño, el primer instinto es culpar al software. Pero el verdadero cuello de botella aparece antes de que comience cualquier procesamiento de IA: lo determina la cantidad de píxeles disponibles por carácter.
Aquí están los números. Un "punto" tipográfico equivale a 1/72 de pulgada. A 150 DPI (puntos por pulgada, la resolución típica de un fax o escáner de gama baja), la altura en píxeles de un carácter es:
altura en píxeles = tamaño de fuente (pt) × DPI / 72
Para un carácter de 6pt a 150 DPI:
6 × 150 / 72 = 12.5 píxeles
Doce píxeles es aproximadamente la altura de una letra en el tamaño de fuente más pequeño que permite su sistema operativo en una ventana de terminal. Ahora considere lo que sucede dentro de un carácter a esa escala. Los rasgos distintivos que separan "8" de "6" — un bucle superior cerrado frente a un bucle inferior cerrado — abarcan como máximo 2 o 3 píxeles. Un solo píxel de ruido del sensor del escáner, una fracción de grado de inclinación de la página o el bloque de compresión JPEG de una foto de teléfono pueden eliminar esa distinción por completo. El carácter "m" y el par "rn" ocupan el mismo ancho de columna de 2-3 píxeles en tamaños pequeños — se vuelven estructuralmente idénticos.
Este no es un problema que se pueda resolver con mejor entrenamiento de IA o un post-procesamiento de OCR más sofisticado. La señal de entrada carece de la información necesaria para que cualquier sistema de reconocimiento produzca la salida correcta. Cada solución posterior en este artículo sortea esta limitación o la reduce, pero la limitación en sí misma es ineludible.
¿Cuántos píxeles necesita realmente un carácter?
Para entender cuándo la fuente pequeña se convierte en un problema práctico, relacione el tamaño de fuente y la resolución de escaneo con la altura en píxeles. El umbral crítico para el reconocimiento de caracteres es aproximadamente 20-25 píxeles de altura del carácter para una discriminación fiable entre glifos similares:
| Tamaño de fuente | 150 DPI | 200 DPI | 300 DPI | 400 DPI | 600 DPI |
|---|---|---|---|---|---|
| 6 pt | 12 px ✗ | 17 px ✗ | 25 px ⚠ | 33 px ✓ | 50 px ✓ |
| 7 pt | 15 px ✗ | 19 px ⚠ | 29 px ✓ | 39 px ✓ | 58 px ✓ |
| 8 pt | 17 px ✗ | 22 px ⚠ | 33 px ✓ | 44 px ✓ | 67 px ✓ |
| 10 pt | 21 px ⚠ | 28 px ✓ | 42 px ✓ | 56 px ✓ | 83 px ✓ |
| 12 pt | 25 px ✓ | 33 px ✓ | 50 px ✓ | 67 px ✓ | 100 px ✓ |
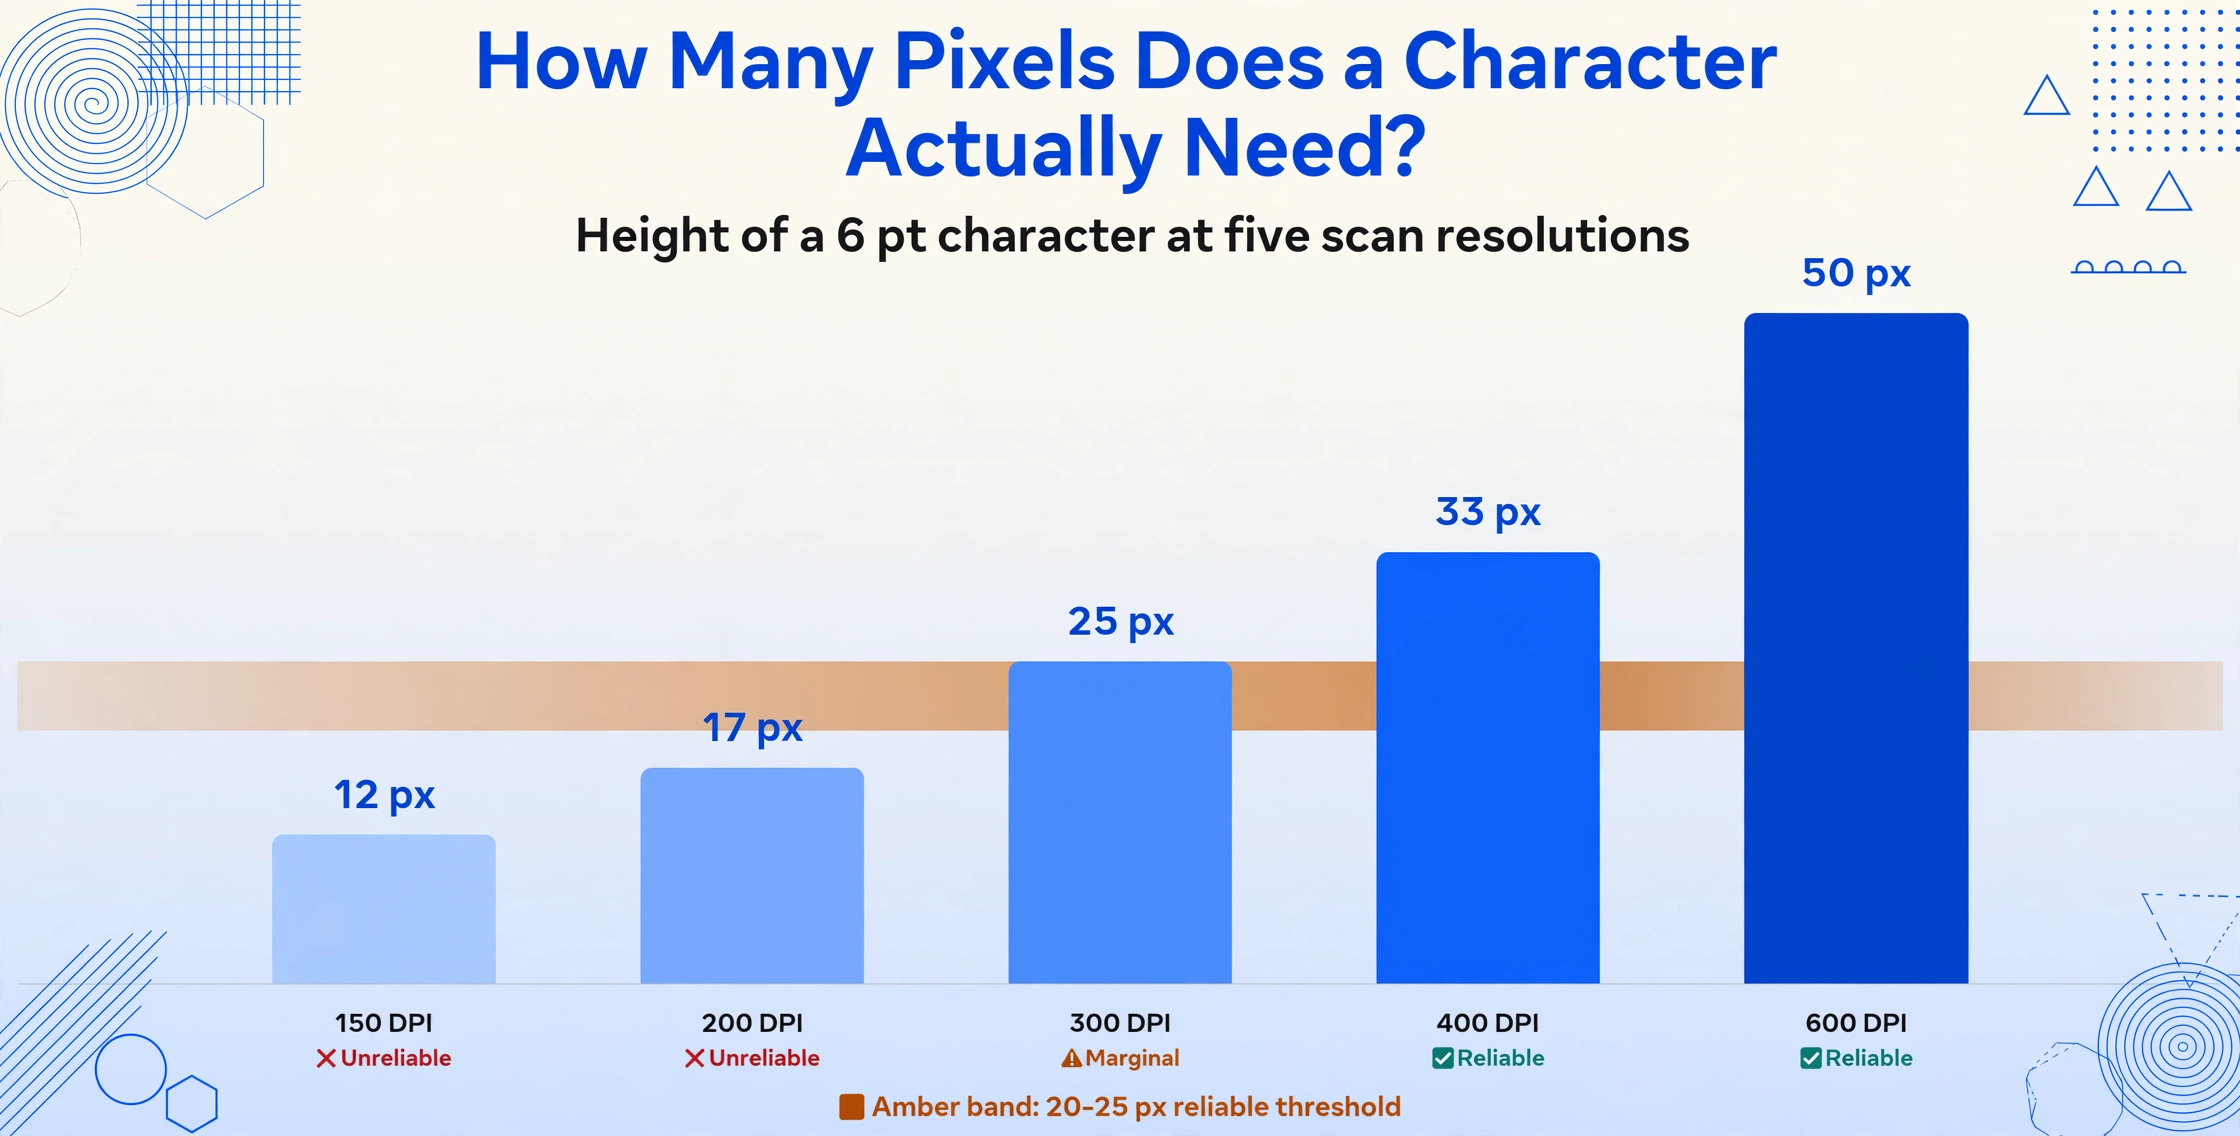
✗ = no fiable ⚠ = marginal ✓ = generalmente fiable para texto impreso. Estas son estimaciones de altura de carácter: el reconocimiento también depende del grosor del trazo, el contraste y el diseño de la fuente.
La tabla hace evidente el patrón: a 300 DPI estándar, el texto de 6 pt se encuentra justo en la línea marginal. A 200 DPI —la resolución de muchas impresoras multifunción de oficina y de la mayoría de los documentos por fax— todo lo que esté por debajo de 10 pt es marginal o no fiable. Cuando se baja a 150 DPI (común en faxes y PDF de baja calidad), solo 12 pt o más es fiable.
Causa 1: Resolución de escaneo inferior a 200 DPI
La causa individual más común de fallos en la extracción de texto pequeño es una resolución de escaneo demasiado baja para el texto objetivo. El problema no es que el hardware del escáner sea inadecuado — es que el flujo de trabajo de escaneo se diseñó para texto legible (cuerpo de texto de ~10-12pt) y nadie lo ajustó para los caracteres más pequeños que aparecen en notas al pie, celdas de tablas, avisos legales e instrucciones de formularios.
Por qué 200 DPI es el umbral de peligro: A 200 DPI, un carácter de 8pt — el tamaño típico de muchos valores de celdas de tabla y etiquetas de formularios — produce solo 22 píxeles de altura. Caracteres como "e" y "c" se vuelven casi indistinguibles porque el contador abierto (el espacio interior de la letra) se colapsa a 1 píxel. El bucle de un "8" y la curva de un "6" ocupan el mismo espacio vertical de 2 píxeles. Esta es la razón por la que las facturas por fax y los contratos escaneados producen rutinariamente errores de extracción en secciones de fuente pequeña mientras que el texto del cuerpo principal se ve bien.
Qué verificar: Si su PDF escaneado fue producido por una MFP de oficina (impresora multifunción) configurada en su modo predeterminado de "calidad estándar", casi con certeza está a 200 DPI. Los documentos por fax llegan a 100-200 DPI dependiendo del equipo del remitente. Antes de culpar a la herramienta de extracción, verifique los DPI efectivos de la imagen de entrada: abra las propiedades del archivo en cualquier visor de imágenes y divida el ancho en píxeles por el ancho físico de la página en pulgadas. Si el resultado es inferior a 250 DPI y su documento contiene texto por debajo de 10pt, la resolución es probablemente la causa raíz.
Para más información sobre cómo la calidad de imagen interactúa con la precisión de extracción en diferentes tipos de documentos, consulte nuestra guía sobre baja precisión de OCR en documentos escaneados.
Causa 2: La elección de fuente amplifica el problema de resolución
No todos los caracteres de 8pt son iguales. El diseño de la fuente determina cuánto del presupuesto de píxeles disponible es realmente utilizable para el reconocimiento:
Sans-serif vs. serif en tamaños pequeños. Una fuente serif como Times New Roman añade trazos decorativos (serifas) en los extremos de los tallos de las letras. A 10pt y más, esas serifas ayudan a la legibilidad. A 6-8pt en un escaneo de 200 DPI, las serifas se fusionan con el trazo principal, engrosando el carácter de manera impredecible y dificultando la separación de caracteres adyacentes. Las fuentes sans-serif (Arial, Helvetica, Calibri) carecen de estos trazos adicionales, lo que significa que sus formas más simples sobreviven mejor al escaneo de baja resolución. La propia documentación de Tesseract y múltiples guías de bibliotecas recomiendan específicamente fuentes sans-serif para documentos compatibles con OCR.
Grosor de fuente fino/claro. El grosor "Light" o "Thin" de una familia de fuentes — popular en el diseño de marcas modernas, encabezados de informes financieros y UI minimalista — utiliza trazos que pueden tener solo 1 píxel de ancho en resoluciones de escaneo comunes. Un ancho de trazo de un solo píxel significa que cualquier ruido, artefacto de compresión o variación del sensor del escáner romperá el trazo (haciendo el carácter invisible) o lo engrosará asimétricamente (cambiando la forma del carácter). Los grosores negrita y regular, con anchos de trazo de 2-3 píxeles a la misma resolución, tienen una tolerancia significativamente mayor a estos artefactos.
Fuentes con glifos ambiguos. Ciertos diseños de fuentes hacen que caracteres que ya son difíciles para el OCR sean aún más difíciles. Arial, por ejemplo, representa la "l" minúscula (L) y la "I" mayúscula (i) de manera idéntica — la única señal distintiva es el contexto, del cual carece el OCR tradicional. En tamaños pequeños, esta ambigüedad empeora porque cualquier diferencia visual restante (una fracción de píxel en la serifa o la altura del tallo) desaparece por completo.
El patrón práctico: si el texto pequeño de su documento utiliza una fuente sans-serif moderna y ligera (común en extractos bancarios europeos, facturas SaaS e informes de inversión), verá errores de extracción en tamaños donde una fuente más gruesa o con serifas aún produciría resultados legibles. La elección de la fuente no causa el problema, pero determina a qué altura de píxel el problema se vuelve visible.
Causa 3: Intentar Extraerlo Todo en Lugar de Priorizar
Esto es menos un problema técnico y más un problema de diseño del flujo de trabajo, pero es una de las fuentes más comunes de frustración con la extracción de texto pequeño.
Muchos usuarios abordan la extracción con la mentalidad de que todo lo que aparece en la página debería obtenerse: cada línea de detalle, cada aviso legal, cada nota al pie, cada anotación marginal. Cuando un aviso legal de 6pt al final de un extracto bancario produce resultados ilegibles, parece que toda la extracción falló. En la práctica, el texto principal y las cifras financieras clave pueden haberse extraído perfectamente; el fallo se limitó a una sección de texto que ningún flujo de trabajo práctico necesita realmente.
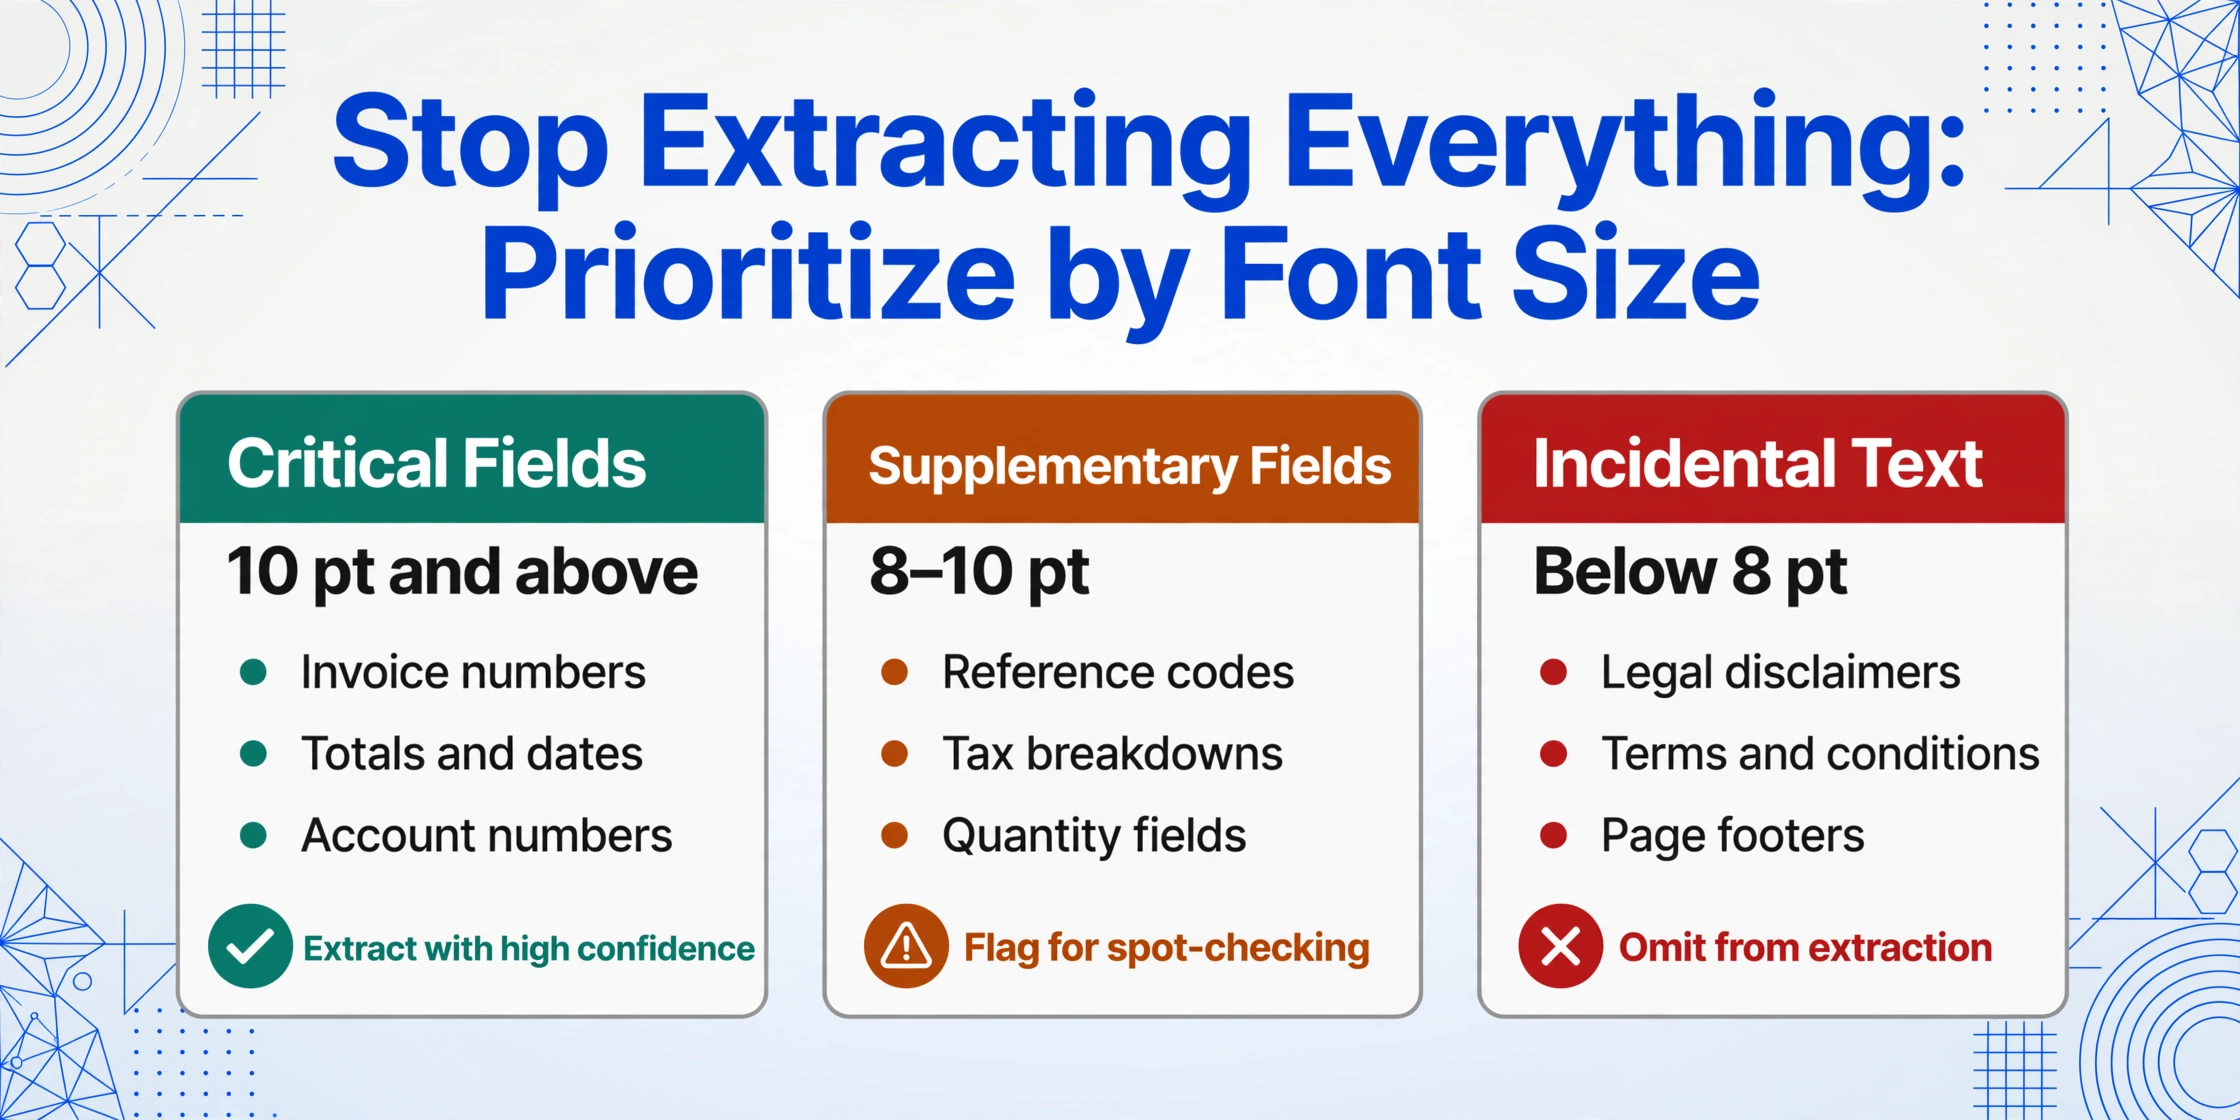
La estrategia de priorización de campos: Antes de extraer, separe el contenido del documento en tres categorías:
- Campos críticos (10pt+) — números de factura, totales, fechas, nombres de proveedores, números de cuenta, números de póliza. Estos casi siempre están configurados en un tamaño de fuente legible y tienen el peso financiero u operativo. Extráigalos con alta confianza.
- Campos complementarios (8-10pt) — códigos de referencia, nombres de departamento, desgloses de impuestos, campos de cantidad. Generalmente extraíbles a 300 DPI, posiblemente marginales a resoluciones más bajas. Márquelos para verificación puntual.
- Texto incidental (menos de 8pt) — avisos legales, avisos de derechos de autor, términos y condiciones, pies de página, instrucciones en letra pequeña. Rara vez se necesitan en un flujo de trabajo de datos estructurados. Considere omitirlos por completo de la extracción en lugar de permitir que los errores en estos campos erosionen la confianza en el resultado general.
Al utilizar una herramienta de extracción con IA con Extracción de Columnas Personalizadas (donde usted escribe los nombres de las columnas que necesita y la IA localiza los valores semánticamente), esta priorización está integrada en el flujo de trabajo por diseño: solo define columnas para los datos que realmente necesita. La IA no desperdicia capacidad de procesamiento en secciones del documento que usted nunca solicitó. Si una columna contiene un valor de una región de texto pequeño, su puntuación de confianza le brinda una señal natural para revisión manual.
El mismo principio se aplica al procesamiento por lotes: si está extrayendo 50 cotizaciones de proveedores y los términos en letra pequeña llegan a cada fila con precisión mixta, pregúntese si realmente necesita esos términos en la hoja de cálculo. A menudo la respuesta es no, y omitirlos mejora tanto la velocidad de extracción como la calidad percibida del resultado.
Causa 4: Artefactos de renderizado subpíxel en capturas de pantalla
Esta causa es casi invisible (literalmente) para el ojo humano, pero produce algunos de los fallos de extracción más confusos. Solo afecta a las capturas de pantalla — pero dado que una fracción creciente del procesamiento de documentos comienza como capturas de pantalla (exportaciones de paneles, facturas de portales web, capturas de aplicaciones móviles), es relevante para más flujos de trabajo de lo que la mayoría de la gente cree.
Los sistemas operativos modernos utilizan el renderizado subpíxel (ClearType en Windows, Core Text en macOS) para mejorar la claridad del texto en pantallas LCD. La técnica funciona abordando subpíxeles individuales rojos, verdes y azules dentro de cada píxel de pantalla, triplicando efectivamente la resolución horizontal para el renderizado de texto. Para su ojo, esto hace que el texto pequeño en pantalla se vea nítido y bien definido. Para un motor de OCR que procesa la captura como una imagen plana, el mismo texto llega con franjas de color — bordes rojos y azules en los límites de los caracteres — que confunden la detección de bordes, la binarización y la segmentación de caracteres.
Los motores de OCR tradicionales que dependen del umbralizado (convertir la imagen a blanco y negro antes del reconocimiento) son particularmente sensibles a este artefacto. Cuando el paso de binarización encuentra un borde de carácter con una franja subpíxel roja, puede interpretar la franja como parte del carácter o como un objeto separado — de cualquier manera, el límite del carácter se desplaza de manera impredecible. En tamaños de documento normales (10-12pt), el artefacto es pequeño en relación con el carácter y el motor de OCR aún puede adivinar correctamente. A 6-8pt, la franja subpíxel puede ser tan ancha como el trazo del carácter mismo, produciendo una salida que parece "leer" ruido de color en lugar de texto.
Cómo probar esto: Si obtiene malos resultados de una captura de pantalla pero el mismo documento escaneado a 300 DPI funciona bien — y el texto es lo suficientemente pequeño como para que el ojo humano tenga dificultad para leerlo en pantalla — el renderizado subpíxel es un contribuyente probable. Intente hacer zoom en el navegador o la aplicación al 150% antes de tomar la captura, lo que aumenta el presupuesto de píxeles por carácter y hace que la franja subpíxel sea proporcionalmente más pequeña.
Para una mirada más detallada a los desafíos de extracción específicos de capturas de pantalla, incluidos problemas de color, contraste y escala, consulte por qué la extracción por OCR falla en fondos de color y marcas de agua — muchos de los mismos principios de calidad de imagen se aplican a capturas de pantalla con texto pequeño.
Lo que realmente funciona: una jerarquía práctica de correcciones
Las correcciones a continuación están ordenadas de mayor impacto / menor esfuerzo a menor impacto / mayor esfuerzo. Empiece por la primera y deténgase cuando la precisión sea aceptable para su flujo de trabajo.
Corrección 1: Apunte a 300+ DPI para documentos con texto pequeño
Si controla el paso de escaneo, esta es la acción más efectiva. Para documentos que se sabe que contienen texto por debajo de 10pt, escanee a 400-600 DPI en lugar de los 300 DPI estándar. La guía de mejores prácticas de OCR de la Universidad de Pittsburgh confirma que se recomiendan 400-600 DPI específicamente para documentos con fuente pequeña. La contrapartida son archivos más grandes y un procesamiento más lento, pero para el subconjunto de páginas donde la precisión de la fuente pequeña importa, vale la pena el aumento. Para documentos enviados por fax o correo electrónico donde no puede controlar la fuente, anote el límite de resolución como una restricción conocida en su flujo de trabajo; no todos los documentos se pueden extraer con la misma precisión, y eso es aceptable siempre que las expectativas se establezcan en consecuencia.
Corrección 2: Aplique priorización de campos en el diseño de su extracción
Revise sus definiciones de columnas y elimine cualquier campo que apunte a texto incidental de fuente pequeña. Si la línea de pie de página de 6pt contiene un número de registro de proveedor que nunca ha utilizado realmente en la conciliación, elimine la columna. Cada columna que elimina es una fuente de resultados de baja confianza que ya no necesita verificación. Al usar la Extracción de Columnas Personalizadas, explore las señales de confianza de la herramienta; si un campo devuelve valores de baja confianza de manera consistente, verifique si el texto de origen es lo suficientemente pequeño como para que la IA esté realmente adivinando. Si es así, decida si vale la pena mantener el campo con verificación manual o si puede obtenerlo de otra manera.
Corrección 3: Ampliación por superresolución: úsela con precaución
La ampliación basada en IA (superresolución, o SR) puede ampliar un escaneo de 150 DPI a un aparente 300 DPI interpolando nuevos píxeles entre los existentes. Los resultados en texto de fuente pequeña son variados: la ampliación simple por vecino más cercano o bilineal no añade información nueva — solo distribuye los mismos 12 píxeles en más espacio. Los modelos de superresolución con IA (SRGAN, ESRGAN, Real-ESRGAN) entrenados con imágenes de documentos pueden recuperar algo de detalle de trazo en texto moderadamente degradado, particularmente en caracteres impresos de alto contraste. Sin embargo, para texto de fuente pequeña que ya carece de características distintivas de píxeles, la SR no puede inventar características que nunca se capturaron — puede producir una salida visualmente más suave sin mejorar realmente la precisión a nivel de caracteres. El caso de uso más fiable para la SR es ampliar texto de un escaneo de resolución ya marginal (p. ej., de 200 DPI a 400 DPI) antes de pasarlo a una herramienta de extracción — no espere que la SR rescate texto capturado a resolución de fax.
Para técnicas de preprocesamiento que funcionan antes de la extracción, incluida la ampliación, la binarización y la corrección de inclinación, consulte nuestra guía de preprocesamiento de imágenes para OCR.
Corrección 4: Solicite de nuevo mejores documentos de origen cuando sea posible
En muchos flujos de trabajo profesionales — particularmente cuentas por pagar, gestión de contratos y procesamiento de documentos fiscales — usted tiene la opción de solicitar una mejor fuente. Si un proveedor envía una factura por fax a 150 DPI y las descripciones de partidas a 7pt son constantemente ilegibles, pídale al proveedor que envíe un PDF digital por correo electrónico en su lugar. Si un subcontratista presenta una fotocopia de una fotocopia de un formulario firmado, solicite el original o una foto limpia. Esta corrección no siempre está disponible (algunos proveedores heredados solo usan fax, algunos formularios gubernamentales solo vienen en un formato impreso fijo), pero está disponible más a menudo de lo que los equipos suponen. El costo de una solicitud por correo electrónico es menor que el costo de corregir manualmente 50 errores de extracción en un lote.
El límite honesto: por debajo de 7 pt no es fiable para ningún sistema
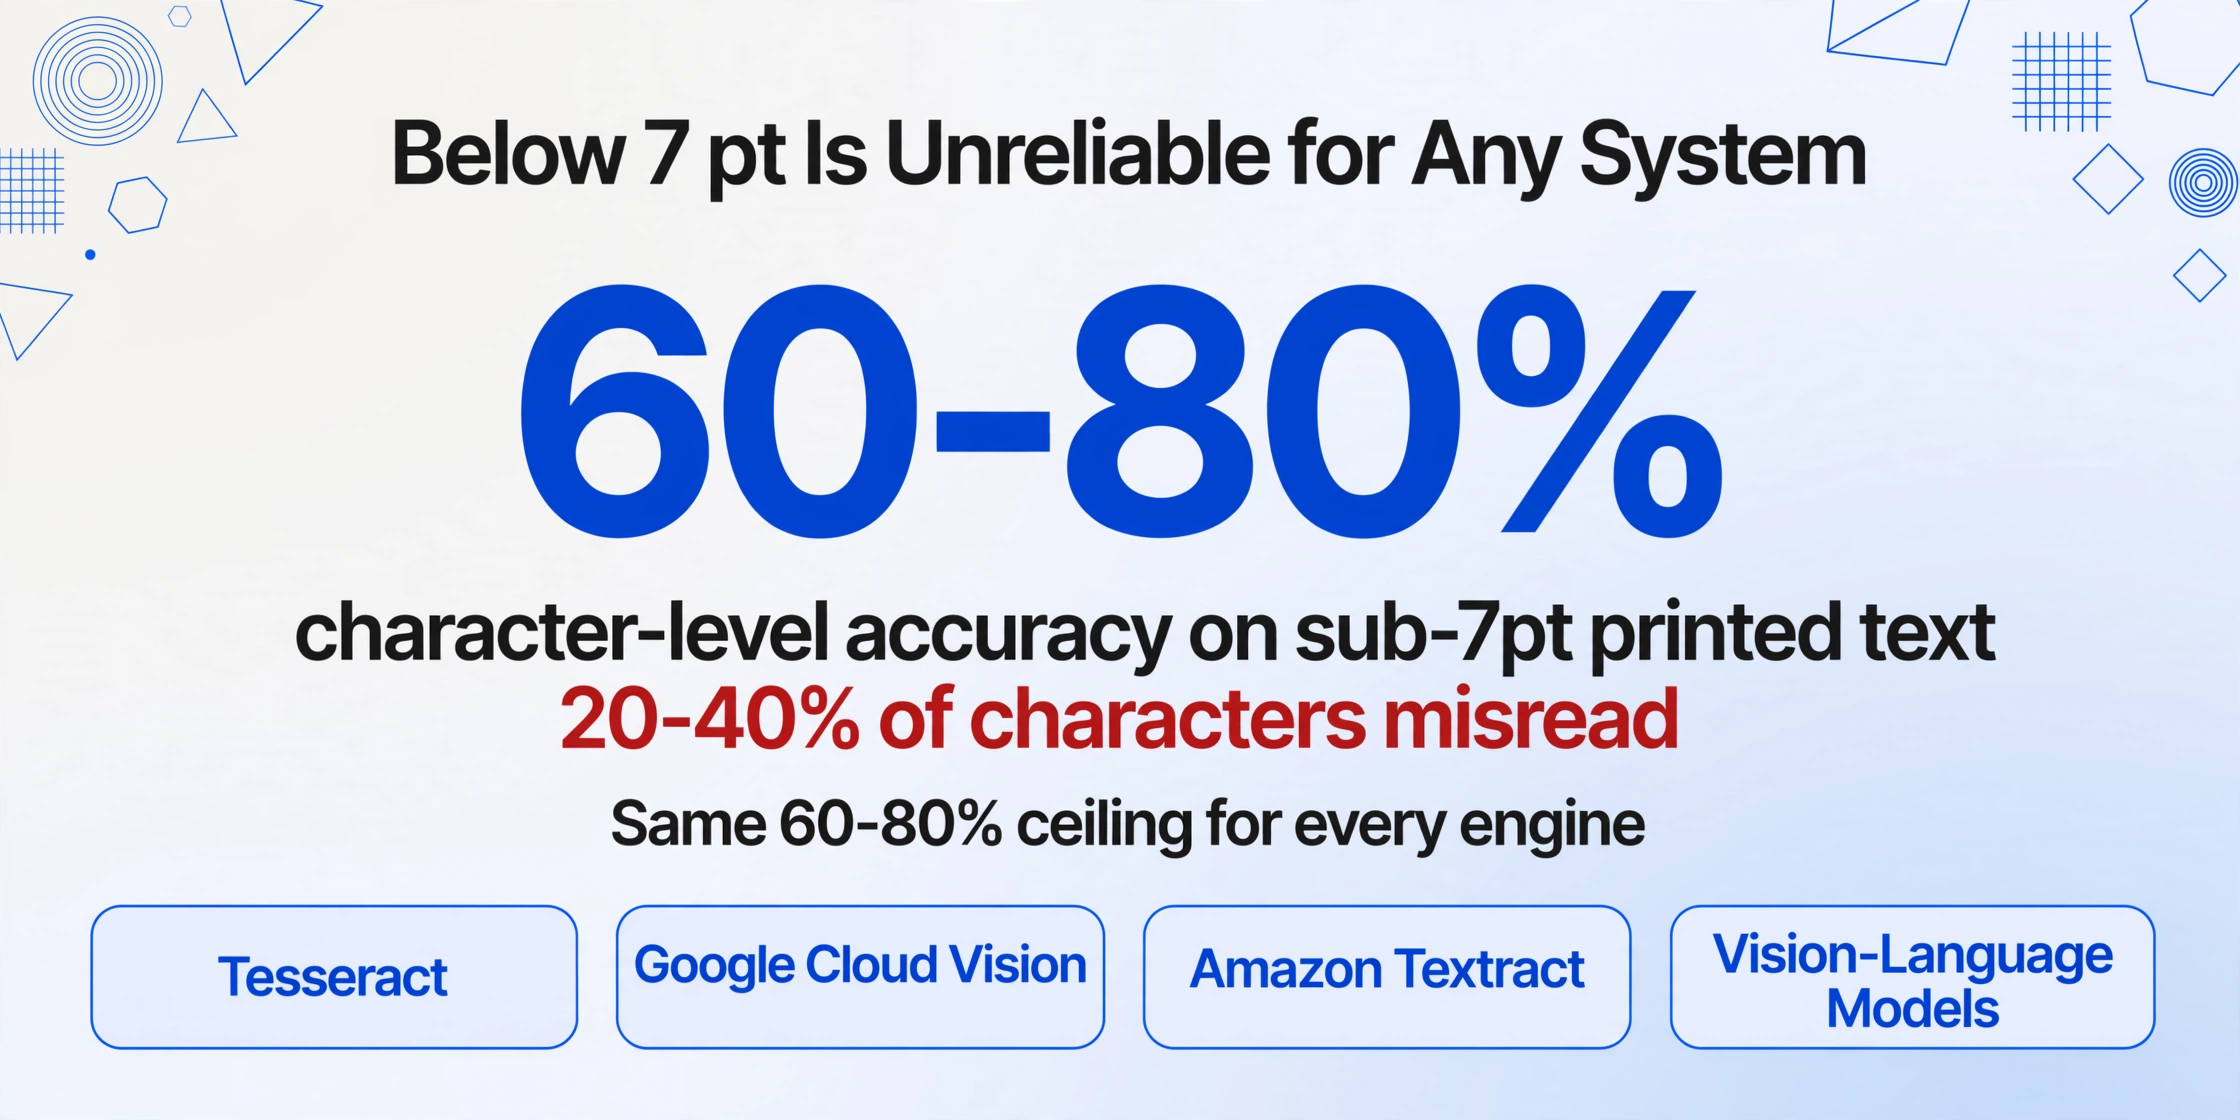
Ninguna mejora de precisión, ajuste del flujo de trabajo ni actualización de herramientas hará que el texto de 6 pt se pueda extraer de forma fiable a partir de un escaneo de 200 DPI. El presupuesto de píxeles simplemente no está ahí. La precisión del reconocimiento en texto impreso inferior a 7 pt se estabiliza en aproximadamente 60-80% a nivel de carácter — lo que significa que el 20-40% de los caracteres se leen mal — independientemente de si el motor es OCR tradicional o un modelo moderno de visión y lenguaje. El margen de ese número de 6 pt en su factura no se podrá extraer con una precisión del 99% a nivel de campo, y la respuesta responsable es planificar la verificación manual o la omisión en lugar de dedicar tiempo a optimizar un flujo de trabajo en torno a una entrada que la física de la digitalización no puede soportar.
Este límite se aplica a todos los sistemas actualmente en producción. No solo a Tesseract, no solo al OCR heredado — se aplica por igual a Google Cloud Vision, Amazon Textract y a las herramientas basadas en modelos de visión y lenguaje. La diferencia entre estas herramientas en texto de fuente pequeña se mide en puntos porcentuales, no en órdenes de magnitud. Los modelos de IA de visión tienen una ventaja en texto inferior a 7 pt porque utilizan el contexto circundante para adivinar un carácter faltante — si la IA ve «Inv_ice N_mber» entre encabezados de factura familiares, puede inferir los valores correctos — pero esta conjetura contextual tiene un techo. Cuando los caracteres por debajo de cierto umbral de píxeles son genuinamente ambiguos, la inferencia es, en el mejor de los casos, una suposición fundamentada.
Para una visión más amplia de las expectativas de precisión en diferentes tipos de documentos y condiciones, consulte nuestra guía práctica para mejorar la precisión del OCR.
Preguntas Frecuentes
¿Resolvería una herramienta de IA más costosa o especializada la extracción de fuentes pequeñas?
Parcialmente, pero no por completo. Un modelo de lenguaje visual que procesa texto en contexto puede recuperar algunos caracteres de fuentes pequeñas infiriéndolos a partir de los datos circundantes — por ejemplo, leyendo "Invoic_ N_mber: INV-2026-0_4_" y completando los caracteres faltantes según el formato esperado del número de factura. Esta corrección contextual puede mejorar la precisión a nivel de campo en 5-15 puntos porcentuales en comparación con el OCR tradicional sobre la misma entrada de fuente pequeña. Sin embargo, no cambia el presupuesto fundamental de píxeles. Si la resolución de entrada es demasiado baja para que la IA distinga entre "5" y "S" a nivel de píxel, ninguna cantidad de razonamiento contextual puede garantizar la respuesta correcta. La solución confiable sigue siendo una mejor resolución de origen.
¿Puedo tomar una foto del documento con el teléfono en lugar de escanearlo para obtener una mejor extracción de fuentes pequeñas?
No de manera confiable. Una foto tomada con el teléfono desde una distancia normal (30-40 cm) a 12 MP produce aproximadamente 150-200 DPI efectivos del documento — mejor que un fax, pero no tan buena como un escaneo de cama plana a 300 DPI. Más importante aún, las fotos con el teléfono introducen distorsión de perspectiva (a menos que el teléfono se sostenga perfectamente paralelo al documento), iluminación desigual y posible desenfoque por movimiento — todo lo cual degrada aún más los caracteres de fuentes pequeñas. Si debe usar el teléfono, coloque el documento sobre una superficie plana con luz uniforme, sostenga el teléfono en paralelo y haga zoom ligeramente (1.5-2x) para llenar el encuadre con el documento. Esto produce mejores resultados que una toma amplia que se recorta después.
¿Es la extracción con IA significativamente mejor que el OCR tradicional para fuentes pequeñas?
En texto de fuente pequeña con resolución marginal (por ejemplo, 7-8pt a 200 DPI), la extracción con IA típicamente supera al OCR tradicional en 10-25 puntos porcentuales — la comprensión contextual le da a la IA una ventaja para resolver ambigüedades que un motor de OCR carácter por carácter no puede. En texto muy pequeño (por debajo de 7pt) o resolución muy baja (por debajo de 150 DPI), la brecha se reduce porque ambos sistemas enfrentan la misma escasez subyacente de píxeles. La elección de la herramienta importa más en los márgenes — donde la inferencia contextual y la comprensión semántica aún pueden operar. Para una comparación detallada a nivel de campo de estos enfoques, consulte Precisión de IA OCR vs. OCR tradicional.
¿Mejora la precisión del OCR en fuentes pequeñas ampliar una imagen de baja resolución?
Sí y no. El redimensionado simple de imágenes (interpolación de vecino más cercano o bilineal) agranda la imagen pero no añade información: los caracteres siguen teniendo la misma ambigüedad a nivel de píxel, solo que repartida en más píxeles. Los modelos de superresolución basados en IA entrenados con imágenes de documentos pueden recuperar parte de la información de bordes perdida, pero la mejora en texto de fuente pequeña es modesta (normalmente una ganancia relativa de precisión del 5-10 %) y depende en gran medida de la calidad de la imagen original. Ampliar la imagen merece la pena como paso de preprocesamiento, pero no sustituye a una resolución de origen adecuada. Partir de un original con mayor DPI es siempre la vía más fiable, como se explica en nuestra guía de preprocesamiento de imágenes.
¿El idioma o el sistema de escritura dificultan la extracción de fuentes pequeñas?
Sí. Los sistemas de escritura con alta complejidad de trazos por carácter (devanagari, árabe, chino, japonés, coreano) requieren más píxeles por carácter para un reconocimiento fiable, porque los rasgos distintivos son más numerosos y finos. Un carácter devanagari de 7 pt a 200 DPI puede resultar ilegible para el OCR, mientras que un carácter latino de 7 pt a la misma resolución podría seguir siendo mínimamente legible. Si sus documentos contienen sistemas de escritura no latinos, aumente la recomendación mínima de DPI en consecuencia: 400 DPI debe considerarse el mínimo para documentos con escritura mixta y texto pequeño, no el máximo.
La extracción de fuentes pequeñas tiene un límite físico duro, pero dentro de ese límite, las decisiones correctas del flujo de trabajo — resolución adecuada, priorización de campos y selección de herramientas — marcan la diferencia entre un lote en el que confía y un lote que debe rehacer. Pruebe con sus propios documentos de fuentes pequeñas y vea dónde está realmente su techo de precisión.
Probar la extracción en su documento