毎月のPDFレポートでPower Queryが壊れる理由
その原因と対策
月初めの最初の更新が、先月と同じメッセージで失敗します: The column 'Jan 2026' of the table wasn't found. Power Queryエディターを開き、古い列名がハードコードされているステップを見つけて修正し、再度更新するとレポートが読み込まれます。あなたはこれを10回も繰り返してきましたが、来月もまた同じことをするでしょう。なぜなら、この修正はレポートの一つのバージョンを直すだけで、変化し続ける根本的な問題を解決していないからです。
クエリ自体は悪くありません。問題は、毎月誰かが編集するレポートにクエリが縛られていることであり、その縛りこそがすべての問題の根源です。この記事では、どこで縛りが発生するのか、なぜ一部のエラーは顕著で一部は静かなのか、そして列の位置に依存しない解析に変えると実際に何が変わるのかを説明します。
重要なポイント
- 毎月15分の修正が、1つのレポートで年間3時間、5つのレポートで約15時間になります。
- 更新を止めるエラーはまだ安上がりです。本当にコストがかかるのは、更新が成功して間違った列にデータが入ってしまうことです。
- 列を名前や位置ではなく意味で定義すれば、レポートが並び替えられてもクエリが壊れることはありません。
毎月失敗する更新
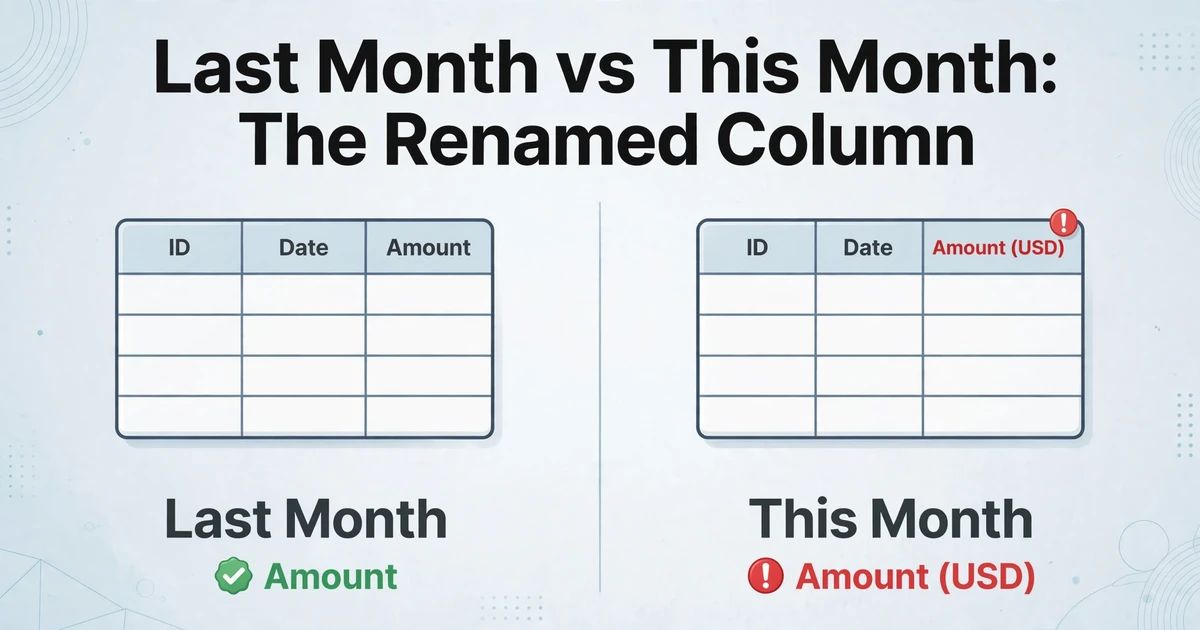
定期的なレポートは、めったに固定されたファイルではありません。銀行の明細書には新しい月の列が追加されます。仕入先の月末エクスポートは、システム更新後に「Amount」を「Amount (USD)」に名前変更します。廃止されたフィールドはレイアウトから完全に消えます。あなたが作成したクエリは先月の出力に対して正しく構築されており、誰も出力が変わったことをクエリに知らせませんでした。
マイクロソフトの公式ドキュメントは、この失敗を正確に説明しています。データソースの列ヘッダーがクエリ作成後に変更された場合、Power Query は「期待される列名が見つからなくなる可能性があり」、エラー The column '<column name>' of the table wasn't found. を返します。通常の修復方法は、Go To Error を選択し、問題のあるステップを開いて、数式を修正するか、ステップを削除してエディターに再構築させることです。
このパターンは、定期的なレポートに対してクエリを維持している人にはおなじみです。クエリは今週は機能し、異なるヘッダーを持つ新しいファイルが届き、次の更新で列が見つからないと報告されます。レポート内で変更が発表されることはなく、クエリ側もそれに備えていませんでした。
修復のたびに、クエリはレポートの1つのバージョンに対して機能するように復元されます。次のバージョンはすでに生成されています。
クエリが実際に行っていること
ブレークが繰り返し発生する理由を理解するには、Power Queryが実際に何を保存しているかを見てください。 Applied Stepsペインはレシピのようなもので、各ステップは触れる列を名前で指定するMコードの行です。Rename Column、Changed Type、Remove Columns、Reorder Columnsはすべて、名前または位置によって列を明示的に参照します。
Microsoftのデータ型ドキュメントはその構造を直接示しています。自動のChanged Typeステップは列名を数式に書き込みます: Table.TransformColumnTypes(#"Promoted Headers",{{"OrderID", type
number}, {"CustomerID", type text}, ...}).
That example is fine for a fixed source. Point it at a monthly report that
renames a field and the step is now looking for something that no longer
exists. The same is true of the rename function: if a referenced column is
missing, the operation raises an error unless you explicitly tell it to
ignore or null the miss.
The second half of the problem sits in how Power Query reads a PDF in the first place. A PDF is not a spreadsheet. It is a set of glyphs placed at coordinates, with no built-in notion of rows, columns, or field names. The connector infers a table by reading the spatial layout, so a small change in margins, spacing, or a moved signature block can be interpreted as a different column structure. That is the "position" in position-based parsing: the parser builds the table from where things sit, then the transformation steps describe that built table by name. Merged headers, spanning cells, and multi-page tables each add their own structural distortion, the kind collected in this guide to 結合セルの抽出を修正。
1つの依存関係は位置から、もう1つは名前から生じます。どちらかが変わる定期レポートは、正常に動くクエリを毎月の修理作業に変えてしまいます。
ブレークが構造的なものであり、クエリが悪いわけではない理由
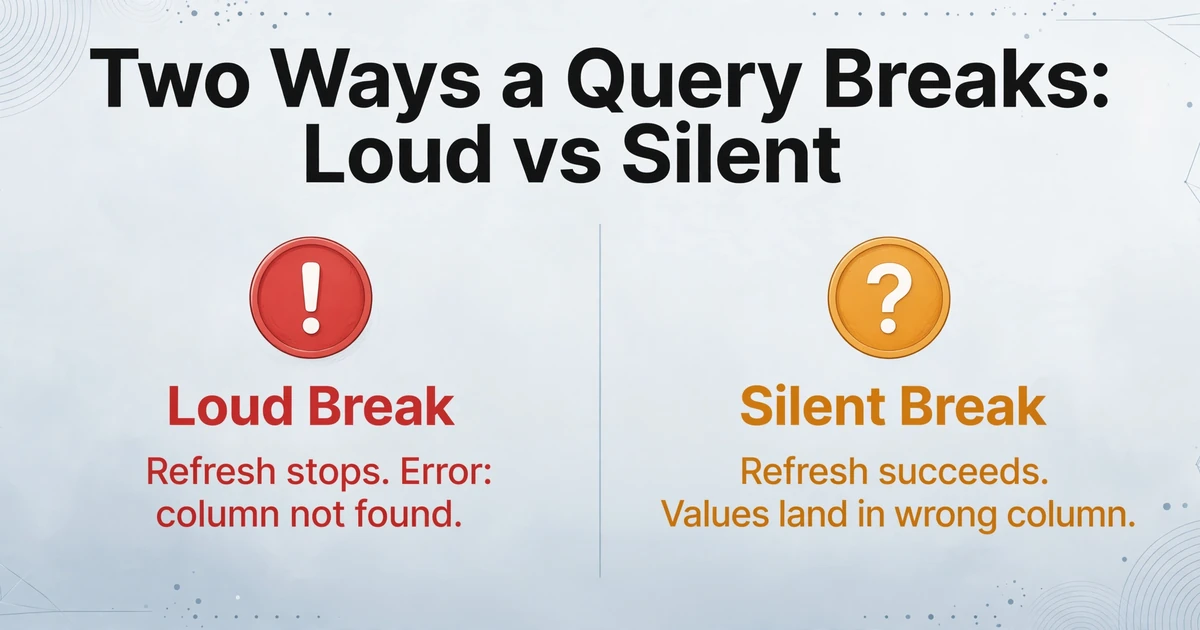
この失敗には2つの異なるパターンがあり、それぞれコストが異なります。
大きなブレークはリフレッシュを停止します。ハードコードされた列名が存在しなくなると、Power Queryは「wasn't found」エラーを発生させ、誰かが修正するまでレポートは読み込まれません。痛みは伴いますが、目に見えます。データは間違っているか存在しないかのどちらかで、どちらかがわかります。
静かなブレークはリフレッシュを成功させ、間違った列を埋めます。これは、レポートがフィールド名を維持したまま列を並べ替えたり再構成したりする場合、またはコネクタがシフトしたレイアウトを新しい列として読み取る場合に発生します。エラーは発生しません。値が単に間違った場所に配置され、エラーは下流で合計のずれやフィールドの不一致として表面化します。これが 一貫性のない抽出結果の背後にある障害モードであり、 フィールドの設計がフィールドの位置と同じくらい重要である理由です。この点は 一般的なフィールド設計の間違いで説明されています。
そして、リフレッシュが残す残骸があります。クエリが前回の読み込み時よりも少ない列を返す場合、それが供給するExcel Tableは常にそれに合わせて縮小するとは限りません。 Microsoft Tech Communityのユーザーは、その結果を「ゴースト」列、つまり前回の読み込みの構造から引き継がれた空白の列が実際のデータの隣に表示され続けるものと表現しました。 クエリの出力はクリーンですが、宛先はクリーンではありません。
これが、一般的な回避策が半分しか治療にならない理由です。列を名前で参照するのをやめ、代わりに位置で参照することができます。Table.ColumnNamesを使用して、名前に関係なく「3番目の列」を取得します。これは名前の変更には耐えます。しかし、並べ替えには耐えられません。並べ替えによって3番目の列が変わってしまうからです。名前の依存関係を位置の依存関係に交換しただけで、レポートはどちらも変更できます。名前が変更された列や削除された列を指す下流の数式は、その上に独自の壊れた参照を表面化させます。
大きな失敗は目立つが、コストがかかるのは静かに間違った列にデータを入れてしまうリフレッシュの成功だ。
明細化されない修理代
15分のクエリ修正で経費報告書を提出する人はいない。だからこそ、そのコストは見えないままだ。それでも計算してみよう。月1回の修正、各15分で、1つのレポートにつき年間3時間になる。5つの定期的なレポートを管理しているなら、およそ15時間、つまり2営業日近くを、自動で動くはずだった設定の修復に費やしていることになる。
その数字は、もっと大きなスプレッドシート保守のパターンの中に位置している。分析前のデータのクリーニングと準備は、アナリストの時間に対するおなじみの負担だ。壊れやすいパースはその予算の中の1つの項目に過ぎないが、決して縮小することなく繰り返される項目でもある。
定期的なレポートのシナリオは、そのパターンをより明確にする。同じ 12ヶ月分の月次明細を1つのワークフローで処理する チームは、クエリを一度だけ構築すればよいが、年に12回それを維持し続けなければならない。また、知識リスクも内在している。Applied Stepsを理解している人は、多くの場合、それを修正できる唯一の人物でもある。その人が休暇を取っている間、レポートは待たされる。
毎月修正が必要な一度きりのセットアップは、一度きりのセットアップではない。変動する請求書が付くサブスクリプションだ。
修正方法: 列を位置ではなく意味にバインドする
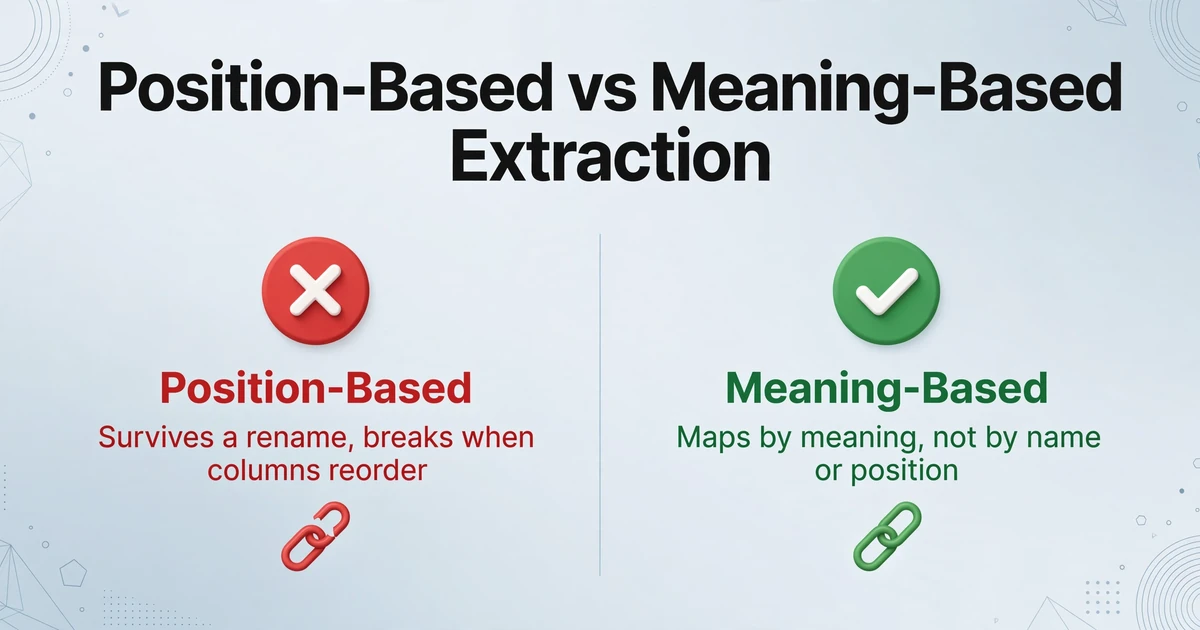
修復サイクルが続くのは、パース層が2つのバージョン固有の質問をし続けるからだ: この値はどの位置にあるのか、そして今月この列は何と呼ばれているのか。質問を「この値は何を意味するのか」に変えれば、レポートのレイアウトはクエリの契約の一部ではなくなる。
それがカスタム列抽出の仕組みだ。ゾーンを描いたり、位置に対してルールを書いたりする代わりに、「Statement Date」「Total Amount」「Account Number」など、必要な列名を入力する。AIはドキュメントを読み、列名の意味を理解して各値を特定する。値がどこにあっても、ソースのラベルが何であっても関係ない。「Amount」から「Amount (USD)」へのリネームでも、「Total Amount」列へのマッピングは維持される。マッピングが正確なテキストや座標ではなく意味に基づいているからだ。
現在維持しているステップにマッピングすると、その変更は単純明快だ。月名をハードコードするChanged Typeステップは不要になる。組み込まれたテーブルのヘッダーに固定されるものは何もないからだ。レポートが並び替えても壊れるReorderステップもない。出力列を一度定義すれば、同じ定義がレポートのすべてのバージョンに対して実行される。
ファイルは安全に処理され、保存されません。
抽出後に行われるクリーンアップを担う、関連する2つの機能があります。このツールのデータ後処理では、同じパスで指定した形式に日付、金額、参照番号を正規化できるため、「Statement Date (YYYY-MM-DD)」という名前の列も、追加のフォーマット処理を必要とせず、最初から一貫した形で返されます。これは、さまざまな形式のベンダーデータを標準化するためのガイドで説明したのと同じ方針です。また、バッチ処理が最初から組み込まれているため、毎月のレポートのフォルダーを一度にアップロードして、ファイルごとに1つの出力ではなく、1つの結合されたスプレッドシートを取得できます。
重要な境界線は、これが何を置き換えるかです。セマンティック抽出は、レポートの位置や名前に関連付けられていたドキュメント読み取り層を引き継ぎます。Power Queryをワークフローから削除するわけではありません。このツールは、クリーンで構造化済みのスプレッドシートを返し、Power Queryは、その後のすべての処理(ビジネスロジック変換、マージ、表形式のデータに対する計算列)に優れたツールであり続けます。解析側を単独で確認したいチーム向けに、PDFからクリーンなテーブルを抽出する手順と、一般的なPDFからスプレッドシートへの変換パスで、その仕組みを説明しています。
これが解決しないこと
誇張した説明よりも正直さが重要です。なぜなら、過大な主張に基づいたワークフローの判断は、クエリと同じように失敗するからです。
既存のクエリには触れません。 このツールはドキュメントを読み取り、スプレッドシートを返します。Power Query に書き戻したり、Applied Steps を再生成したり、クエリを自動更新したりはしません。解析ステップを置き換えるのであって、古いステップのメンテナンスを自動化するわけではありません。
ドキュメント間のフィールド照合は行いません。 各ドキュメント内のフィールドを、指定した列にマッピングします。あるドキュメントの値を別のドキュメントの値と比較して自動的に判断することは別の作業であり、このステップではなく、後段のロジックで行うべきものです。
レポートにない値を発明することはできません。 1月の列が存在すれば、それを見つけます。レポートがフィールドを完全に省略している場合、本来何があったべきかを知る方法はありません。空白が表示されるので、それを確認用にフラグ付けします。意味的な読み取りも、やはり読み取りです。
認識精度は入力の質に依存します。 クリーンなスキャンやデジタル生成のPDFで最も高い結果が得られます。著しく退色したスキャンや低解像度のスキャンでは精度が低下し、そのような出力はレビューが必要です。目的は人間の判断を排除することではありません。その判断を、クエリの再構築から、再確認が必要な値のチェックへと移すことです。
よくある質問
列名が変わると、なぜPower Queryが壊れるのですか?
変換ステップが、操作対象の列名を保存しているからです。Changed Type、Rename、または Remove Columns ステップは特定の名前を探します。ソースのヘッダーが変わると、Power Query はそれを見つけられなくなり、「The column of the table wasn't found.」というエラーが返ります。修正方法は、今月のファイルに合わせてそのステップを修正することですが、そのため次のバージョンで同じ問題が再発します。
Power Queryのゴースト列とは何ですか?
ゴースト列とは、更新後にExcel Tableに残る空白の列で、通常はクエリが前回の読み込みよりも少ない列を返す場合に発生します。クエリの出力は正しいのですが、宛先のTableには以前の構造の列が残ります。コミュニティの報告では、これが予測不能に発生することが説明されており、信頼できる修正方法は、古い形状の上で更新するのではなく、Tableを再構築することです。
Power Queryで列を名前ではなく位置で参照できますか?
はい、Table.ColumnNamesを使用して列をインデックスで選択できます。これにより、クエリが列の名前を気にしなくなるため、名前変更の問題は解決します。ただし、列の位置が変わるため、並べ替えの問題は解決しません。脆弱性を移動しただけで、除去したわけではなく、列が名前変更または削除されると、下流の参照は依然として壊れます。
ImageToTable.aiはPower Queryを更新または書き戻しますか?
いいえ。ドキュメント読み取りステップを置き換え、構造化されたスプレッドシートを返します。クエリを編集したり、Applied Stepsを変更したり、Power Query内で実行したりすることはありません。多くのチームは、下流のビジネスロジックにPower Queryを維持し、以前は壊れていた解析に抽出を使用しています。
列全体が消えるレポートは処理できますか?
欠落したフィールドに対しては、捏造するのではなく、空の値を返します。それが正しい動作です。ソースから本当に必要なフィールドが消えた場合、正しい対応は空白に気づき、ソースレポートを確認することであり、合成された数値を受け入れることではありません。
一度構築したセットアップは、そのまま維持されるべきです。毎月の修理チケットは、解析が値の場所と今月のヘッダー名を尋ね続けるため、自動的に発生します。代わりに値の意味を尋ねるようになれば、レポートはレイアウトを変更しても、クエリを巻き添えにすることはありません。