RAG幻覚の根本原因
は壊れたパースにある
検索拡張生成システムからの誤った回答は、モデルの問題のように見えます。回答は流暢で具体的で自信に満ちており、それが幻覚の特徴です。しかしモデルはテキストのチャンクに対して推論するよう求められ、そのチャンクに対して忠実に推論しました。問うべきなのは誰がそのチャンクを作ったかです。なぜなら、モデルがそれを目にする頃には、ドキュメントはすでに一度、ほとんどのチームが検査しないパーサーによって読み取られているからです。
失敗の連鎖は一方向に進みます。弱いパースは質の低いチャンクを生み、質の低いチャンクは弱い検索を生み、弱い検索はモデルをして破損した証拠から回答させます。この記事では、その連鎖をドキュメントから上向きに辿り、最も大きな損害をもたらすパースの失敗を挙げ、プロンプトのチューニングにさらにスプリントを費やす前に、皆さん自身の取り込み層を確認する方法を示します。
重要なポイント
- 皆さんは、実際には検査したことのないチャンクから来た誤った回答について、モデルを責めていました。
- 8,561ドキュメントのベンチマークで最高のスキャンからテキストへのソフトウェアでも、クリーンな構造化データには少なくとも14%及ばず、そのギャップが皆さんの回答になります。
- 最も明確なテストは、モデルが回答したページの正解テキストをモデルに与えることです。クリーンなテキストからの正しい回答は、障害が取り込みにあることを示すからです。
障害の連鎖は検索の前に始まる
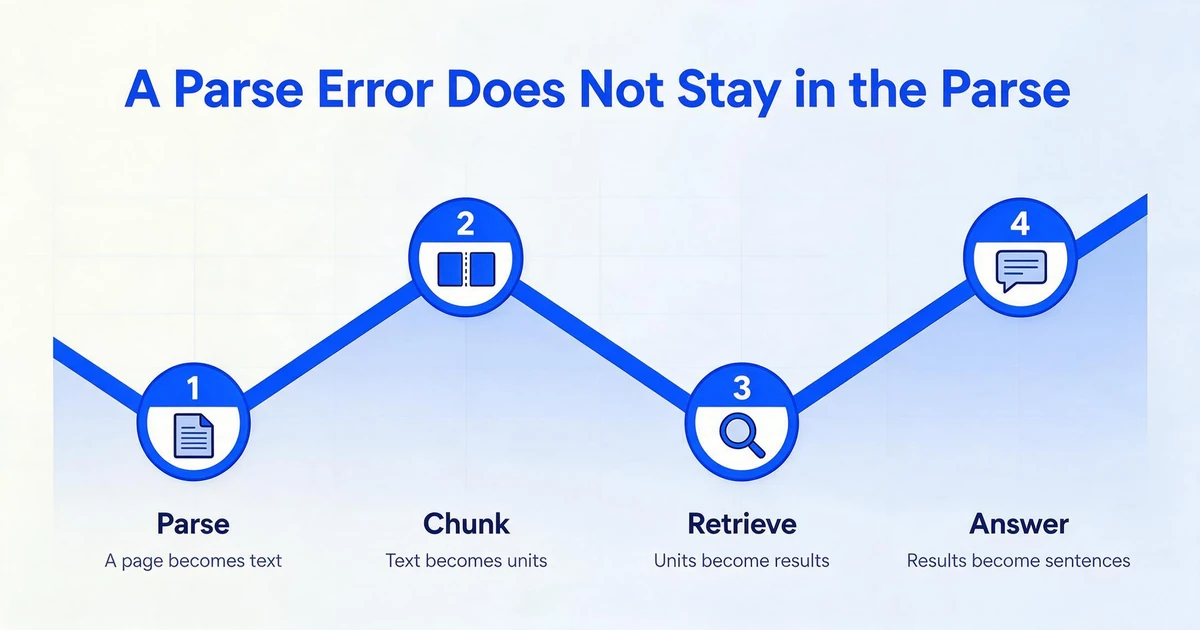
検索拡張生成(RAG)は4段階のチェーンであり、各段階は直前の段階が生成したものをそのまま引き継ぎます。パーサーはページをテキストに変換し、可能であれば構造も変換します。チャンカーはそのテキストを検索単位に分割します。検索器は単位を選択します。モデルは検索器が渡したものから回答を生成します。
このチェーンが重要なのは、チャンカーはパーサーが渡したものしか分割できず、パーサーが破棄した構造を追加で復元できないからです。テーブルが1本の長い行に平坦化されて届いた場合、チャンカーには尊重すべき行境界がありません。2つの列がインターリーブされて届いた場合、どのチャンクサイズでもそれらを分離できません。パース段階が下限を設定し、それ以降のすべての段階はその上に積み重なります。
これはまれなエッジケースではありません。ICCV 2025で発表されたOHR-Bench研究は、7つの実際のRAGアプリケーションドメインにわたる8,561枚の非構造化ドキュメント画像と8,498組の質問と回答のペアからなるテストセットを構築し、OCRノイズが検索と生成を通じてどのように連鎖するかを測定しました。ベンチマーク内の最良のOCRソリューションでさえ、クリーンな正解テキストの構造化データに対して少なくとも14%不足しており、意味的ノイズが軽度から重度に上がるにつれて、ほとんどの検索器と言語モデルはパフォーマンスのほぼ半分を失いました(Zhang et al.、「OCR Hinders RAG」、arXiv:2412.02592)。
その14%のギャップは、チームが過小評価している部分です。パースエラーはパース内に留まりません。それはチャンクになり、次に埋め込みになり、次に検索結果になり、次に回答内の文になります。
パースはその上のすべての上限を設定します。どのチャンキング戦略でも、パーサーが平坦化したテーブルの行を追加で復元したり、読み取った2つの列を分離したりすることはできません。
モデルが非難される理由
実際の運用でRAGシステムが失敗する場合、その原因は通常、生成側ではなく検索またはコンテンツにあります。Deakin Universityの経験レポートでは、3つの本番RAGケーススタディと、15,000件のドキュメントと1,000件の質問に対する実証実験を分析し、7つの失敗ポイントを分類しました。そのうちの3つはまさにこのパターンを説明しています:回答が返されるほど高いランクに到達しなかった、検索されたがコンテキスト組み立ての過程で失われた、またはコンテキスト内に存在したにもかかわらずモデルがそれを抽出できなかった——著者らはこれを、ノイズが多すぎるか、矛盾する情報に起因するとしています(Barnett et al., "Seven Failure Points When Engineering a RAG System", arXiv:2401.05856)。
「ノイズまたは矛盾する情報」という表現が重要です。数値がラベルを失ったチャンク上で推論するモデルは、実際に存在するが誤って抽出されたものに基づいており、ラベルが欠落していることを知る方法がありません。ドキュメントが多い環境では、ある実践者が、数週間にわたるチャンク変更、埋め込みの交換、リランカーの試行錯誤の後に同じ発見を報告しました:ソースドキュメント自体がテキストへの変換が不十分で、見かけ上の幻覚の多くは、誤って抽出されたものにモデルが基づいていることによるものでした (r/Rag、2026年3月)。
そして、誰もが最初に試す修正策があります:モデルにより多くのコンテキストを与えることです。これは、役立つことよりも裏目に出ることが多いです。
言語モデルが長い入力をどのように使用するかに関する研究では、U字型のパフォーマンス曲線が見つかりました。モデルは、情報がコンテキストの最初または最後にある場合に最もよく使用し、関連する箇所が中間に埋もれているとパフォーマンスが低下します。あるオープンドメインのテストでは、検索ドキュメントを20件から50件に増やしても、リーダーの精度はわずか約1.5%しか向上せず、入力量は大幅に増加しました(Liu et al., "Lost in the Middle", arXiv:2307.03172)。
top-kまたはコンテキストウィンドウを増やすと、モデルが推論するための材料が増えます。しかし、破損した材料がきれいになるわけではありません。
RAGを実際に壊すパース失敗
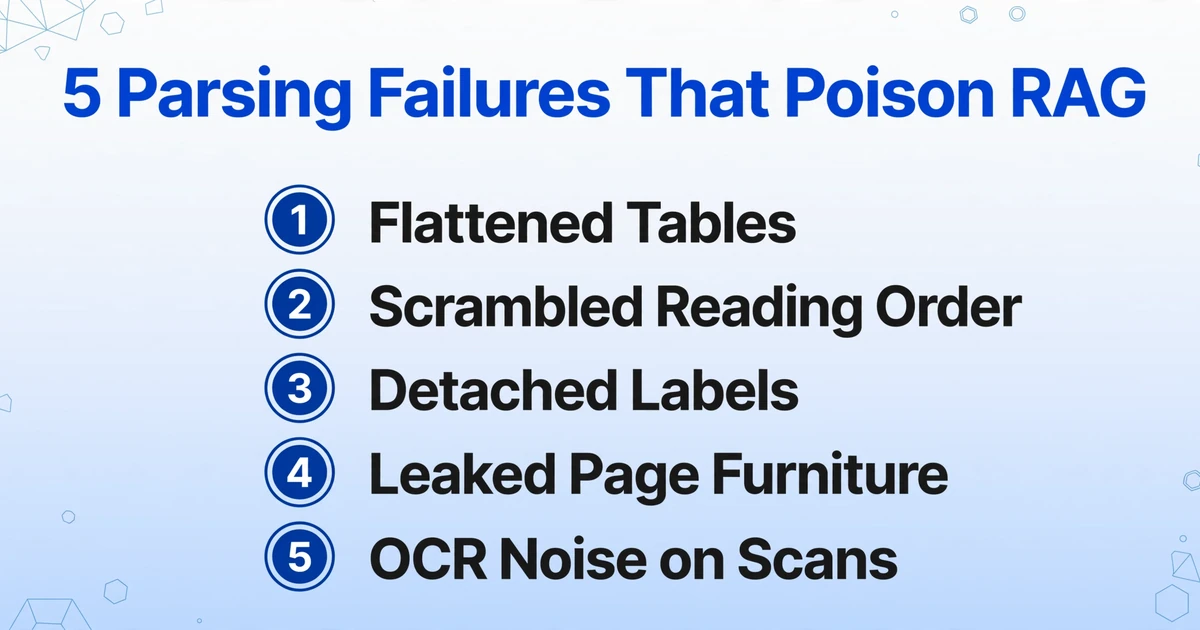
取り込みの失敗はランダムに起こるわけではありません。そのほとんどは、繰り返し発生する少数のタイプに分類され、それぞれがチェーンの下流に認識可能な症状を残します。以下の表にまとめました。
| パース失敗 | テキストで壊れる箇所 | 下流での現れ方 |
|---|---|---|
| テーブルの平坦化 | 行と列が1行に潰れ、セルがその名前を示すヘッダーを失います。 | 検索エンジンは正しいページを返しますが、チャンクに「3.5」が「Henry Hub」なしで含まれるため、値に関する質問で回答が欠落したり誤ったりします。 |
| 読む順序の乱れ | 多段組みページで、パーサーが段間をまたいで読み、無関係な2つの段を混在させます。 | チャンクは流暢な散文として読めますが、2つの異なる内容が混ざっています。検索はそれに一致し、モデルは誤った内容から回答します。 |
| ラベルの分離と階層の喪失 | 値がラベルから分離し、見出しがそのレベルを失います。 | チャンクがセクションの境界をまたぎます。「解約違約金: 2%」が孤立したトークンになり、モデルは見つけられる最も近い数字を当てはめます。 |
| ページ装飾の混入 | 柱、フッター、ページ番号が本文に入り込みます。 | 繰り返される定型文がチャンクを汚染し、埋め込みを希釈するため、関連する箇所のスコアが必要以上に低くなります。 |
| スキャン画像のOCRノイズ | 文字や数字が誤読されたり、低品質のスキャンでテキストが欠落したりします。 | 数字や識別子が微妙に誤って届きます。回答は自信満々で、1桁ずれています。 |
人間は平坦化されたテーブルを読むとき、文脈からグリッドを再構築できることがよくあります。しかし、チャンカーにはそれができず、埋め込みにもできません。数字とそのヘッダーとの関係は、パーサーがそれを捉えた場合にのみ存在します。これが2つのパース手法の違いです。位置ベースのOCRは文字を読み取り、その位置から構造を推測しますが、ビジョンモデルは意味によってページを読み取り、ラベルをその値に結び付けたままにできます。この違いの背後にあるベンチマークの証拠は、従来のOCRとドキュメントパース用ビジョンモデルを比較したリファレンスページにあります。
パース層が原因かどうかを見分ける方法
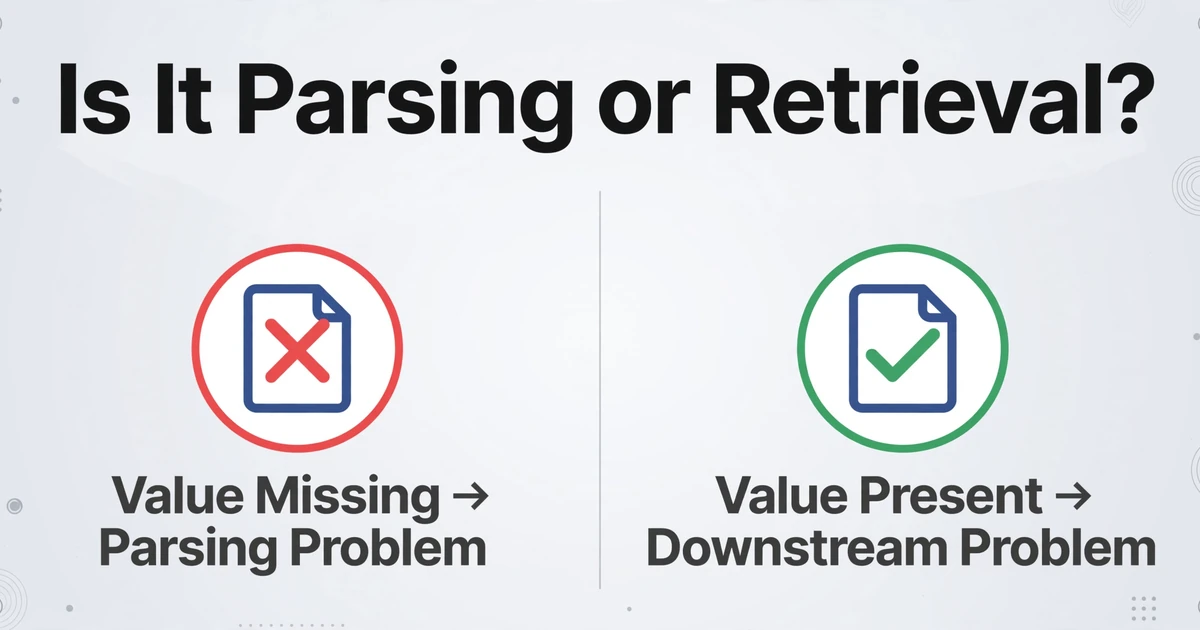
どの段階で失敗したかを推測する必要はありません。チェーンの各リンクにテストがあり、そのテストは安価です。順番に実行して、答えが得られた時点で停止してください。
誤った回答に対して検索が返したチャンクを取得する
ほとんどすべてのRAGスタックは、プロンプトに含まれたチャンクをログに記録できます。監査の残りは、モデルが実際に受け取ったコンテキスト(要約ではなく)を確認することに依存しているため、まずここから始めてください。
それらのチャンク内で正しい値を検索する
ソースドキュメントに答えが明確に含まれているのに、取得したチャンクには含まれていない場合、パースまたはチャンク境界で値が失われています。値が存在し正しいのにモデルが誤って回答した場合、問題はパースより下流にあります。
テーブルを含むページを検査する
そのページのパーサー出力をプレーンテキストビューに貼り付けます。行と列が保持されていれば、テーブルは無傷です。それらが1行に潰れていれば、そのドキュメント内のすべてのテーブル質問が危険にさらされています。
2段組ページで読み順を確認する
人間がページを読むように、抽出されたテキストを読みます。無関係な2つの段の間を行き来している場合、そのページから抽出されたチャンクは、一貫しているように見えても意味的に混在しています。
本文テキストにページ装飾がないか探す
抽出されたテキスト内でページ番号または柱(ランニングヘッダー)を検索します。それらが段落内に現れる場合、コンテンツであるかのように埋め込まれており、ページ上のすべてのチャンクを希釈しています。
正解テキストに対して質問を実行する
回答の出典となったページの手動修正版または正解テキストをモデルに与えます。クリーンなテキストからは正しく回答し、パースされたテキストからは誤って回答する場合、障害を取り込みに特定でき、検索とモデルはそのままにしておけます。
最も明確な単一テスト:モデルに、回答の出典となったページの正解テキストを与えることです。それで正しい答えが得られれば、検索と生成は問題ではなかったことになります。
これらのチェックは一般的な抽出トラブルシューティングと重複しており、特定のドキュメントタイプが同じように失敗し続ける場合には、ドキュメント抽出の問題を診断するためのガイドにある症状と原因の対応表が役立ちます。測定に関する注意点が1つあります。文字レベルのスコアは、優れたパーサーを最悪のパフォーマーとしてランク付けする可能性があるため、CERがドキュメントパースで誤解を招く理由の分析で説明されているように、単一のパース品質の数値は慎重に扱ってください。
抽出レイヤーでの修正
修正は、ページを最初にテキストに変換するレイヤーに属します。なぜなら、構造を保持できるのはそのレイヤーだけだからです。パース出力が生の文字ストリームである場合、チャンカーは境界を発明することになり、レトリーバーはノイズをランク付けすることになります。パース出力がすでに構造化されラベル付けされていれば、後続のステップは正直なデータを扱うことができます。
実際のシフトは、位置ベースの読み取りから意味ベースの読み取りへの移行です。位置ベースのOCRはページを文字に変換し、座標で配置してから、レイアウトルールに依存して見出し、値、テーブルセルを推測します。ビジョンモデルは代わりにページを意味で読むことができ、これはカスタム列抽出の背後にあるアプローチです。「請求書番号」「口座番号」「契約額」など、必要な列名を入力すると、AIがフィールドの意味を理解してページ上のどこでも各値を見つけます。各ドキュメントは、定義したラベルに値がすでに紐付けられた行として出力されます。
RAGパイプラインの場合、これによりチャンカーへの入力が変わります。数字の壁の代わりに、テーブル行はヘッダーを保持します。ラベルが値から切り離されて浮遊する代わりに、ペアは1つのユニットとして移動します。抽出レイヤーはチャンク境界を決定したり、埋め込みモデルを選択したりしません。次のステージに構造化されラベル付けされた出力を渡すため、そこから構築されるチャンクは破損したテキストに基づいていません。
ファイルは安全に処理され、保存されません。
抽出レイヤーをスプレッドシートではなく自社のコードに組み込む場合、v1 APIが統合ポイントになります。ドキュメントのアップロードとバッチジョブを受け付け、構造化されたJSONを返し、処理完了時にWebhookでシステムへ通知できるため、抽出を自社のアプリケーションやワークフローの背後に配置できます。銀行明細書や契約書のように、1つの論理ドキュメントが複数ページにまたがるコーパスの場合、Multi-Page Mergeがページを1つのレコードにまとめ直すため、チャンクがドキュメントの半分から構築されることはありません。データの後処理では、抽出中に日付や金額を固定フォーマットに正規化することもでき、チャンク間で識別子の一貫性が保たれます。
これが置き換えるのはドキュメント読み取りのステップであり、RAGスタック全体ではありません。ほとんどのチームは、検索器、ベクターストア、モデルを維持します。抽出レイヤーは、すでに壊れたテキストをそれらに供給するのを止めるだけです。パースタスク単体として説明した同じ仕組みは、AIドキュメントパーサーのページにあります。
これが解決しないこと
ここでは、きれいな売り込みよりも正直さが重要です。過大な主張に基づくRAGプロジェクトは、パイプラインと同じように失敗するからです。
RAGシステムを構築したり実行したりはしません。検索に供給するドキュメント読み取りレイヤーを処理します。ベクターデータベースのセットアップ、検索戦略の選択、生成ステップの実行は行いません。
チャンクの境界や埋め込みモデルを選ぶことはしません。それらはパイプラインの判断として残ります。抽出レイヤーは、それらの判断が操作するテキストの品質を変えるだけです。
ドキュメント間でフィールドを照合することはしません。各ドキュメント内のフィールドを指定された列にマッピングします。あるドキュメントの値を別のドキュメントの値と比較して自動的に判断することは別の仕事であり、下流のロジックに属します。
ドキュメントにない値を発明することはできません。フィールドが本当に存在しない場合、出力は捏造ではなく空白になります。それが正しい動作であり、空白は信頼すべき数値ではなく、ソースを確認すべき信号です。
品質の悪いスキャンは依然として精度を低下させます。色あせた感熱レシート、大きな傾き、低解像度の写真は、どのシステムでも難しいままです。それらの出力はレビューパスに値します。目標は、人間の判断をパイプラインの修正から、再確認が必要な少数の値のチェックへと移すことです。
よくある質問
検索結果が関連しているように見えるのに、RAGが幻覚を起こすのはなぜですか?
関連性と正確性は別物です。検索されたチャンクは、質問とトピック的に類似していても、その質問に答える値を欠いていたり、その値がラベルから切り離されて含まれていたりすることがあります。OHR-Benchの研究では、パースノイズが検索と生成の両方を低下させることが測定されており、関連性があるように見える結果でも、モデルが忠実に推論している証拠が破損している可能性があります。
コンテキストウィンドウを大きくしたり、top-kを高くすればRAGの幻覚は修正できますか?
ほとんど効果がありません。長いコンテキストを持つモデルに関する研究では、モデルはコンテキストの最初と最後の情報を最もよく利用し、中間部分では性能が低下することが示されています。また、ある時点を超えてドキュメントを追加しても、得られる利得はごくわずかです。コンテキストを増やすと、モデルが推論するための材料が増えますが、壊れたパースから構築されたチャンクを修復することはできません。
どのようなドキュメントパースエラーがRAGの失敗を最も多く引き起こしますか?
テーブルの平坦化、マルチカラムページでの読み順の乱れ、ラベルから切り離された値、セクション階層の喪失、ヘッダーとフッターの漏れ、スキャン画像のOCRノイズです。テーブルの失敗が最も深刻です。なぜなら、セルとヘッダーの関係は、パーサーがそれを捕捉した場合にのみ存在し、パースを生き延びなかったグリッドを後段のステップで再構築することはできないからです。
RAGの問題がパースにあるのか検索にあるのかをテストするにはどうすればよいですか?
既知の誤った回答に対して検索が返したチャンクを取得し、その中に正しい値がないか確認してください。テーブルページの生のパース出力を元の文書と照合し、2カラムページの読み順を確認してください。次に、同じページの正解テキストをモデルに与えてください。クリーンなテキストから正しく回答できれば、問題は検索ではなく取り込みにあります。
ImageToTable.aiはRAGパイプラインを構築または実行しますか?
いいえ。これは抽出レイヤーです。ドキュメントを読み取り、構造化されたラベル付きデータをExcel、CSV、JSON、またはWordとして返します。検索、ベクターストア、生成は皆さんのもののままです。この製品は、それらのシステムに供給するパースステップを処理し、それ以上は処理しません。
抽出レイヤーはRAGパイプラインに対してどのような出力を生成しますか?
皆さんが指定した列を持つドキュメントごとに1行と、v1 APIを通じた構造化JSONです。値が定義したラベルに紐づいて届くため、下流のチャンク処理と検索は、生の文字ストリームではなく構造化テキストに対して機能します。
スキャンしたPDFや複数ページのドキュメントを処理できますか?
パスワード保護されたPDF、JPGおよびPNG画像、WebPおよびAVIFファイル、スクリーンショットを受け付け、印刷テキストと手書きテキストの両方を認識します。Multi-Page Mergeは、同じ論理ドキュメントのページを1つのレコードにグループ化するため、ステートメントや契約書の一部からチャンクが構築される場合に役立ちます。非常に品質の低いスキャンでは精度が依然として低下するため、そのような出力はレビューを行う価値があります。
最もコストのかかるRAGバグは、モデルの問題のように見えて、プロンプト、チャンクサイズ、リランカーを調整させられる一方で、実際の損害は検索が実行される前に発生しているものです。まずパースを監査してください。パイプラインに入るテキストが構造化され、正しくラベル付けされている場合、モデルはようやく信頼に値する証拠に基づいて推論しています。