A Causa Raiz das Alucinações de RAG
É a Análise Quebrada
Uma resposta errada de um sistema de geração aumentada por recuperação parece um problema do modelo. A resposta é fluente, específica e confiante, que é como uma alucinação se parece. Mas o modelo foi solicitado a raciocinar sobre um segmento de texto, e ele raciocinou sobre esse segmento fielmente. A pergunta que vale a pena fazer é quem construiu o segmento, porque quando o modelo o viu, o documento já havia sido lido uma vez, por um analisador que a maioria das equipes nunca inspeciona.
A cadeia de falhas corre em uma direção. Uma análise fraca produz segmentos ruins, segmentos ruins produzem recuperação fraca, e recuperação fraca deixa o modelo responder com evidências corrompidas. Este artigo percorre essa cadeia do documento para cima, nomeia as falhas de análise que causam mais dano e mostra como verificar sua própria camada de ingestão antes de gastar mais um sprint ajustando prompts.
Principais Conclusões
- Você culpou o modelo por uma resposta errada que na verdade veio de um segmento que você nunca inspecionou.
- Até o melhor software de conversão de digitalização para texto em um benchmark de 8.561 documentos ficou pelo menos 14% aquém de dados estruturados limpos, e essa lacuna se torna sua resposta.
- O teste mais limpo é alimentar o modelo com o texto de referência da página da qual ele respondeu, já que uma resposta correta a partir de texto limpo mostra que a falha estava na ingestão.
A cadeia de falhas começa antes da recuperação
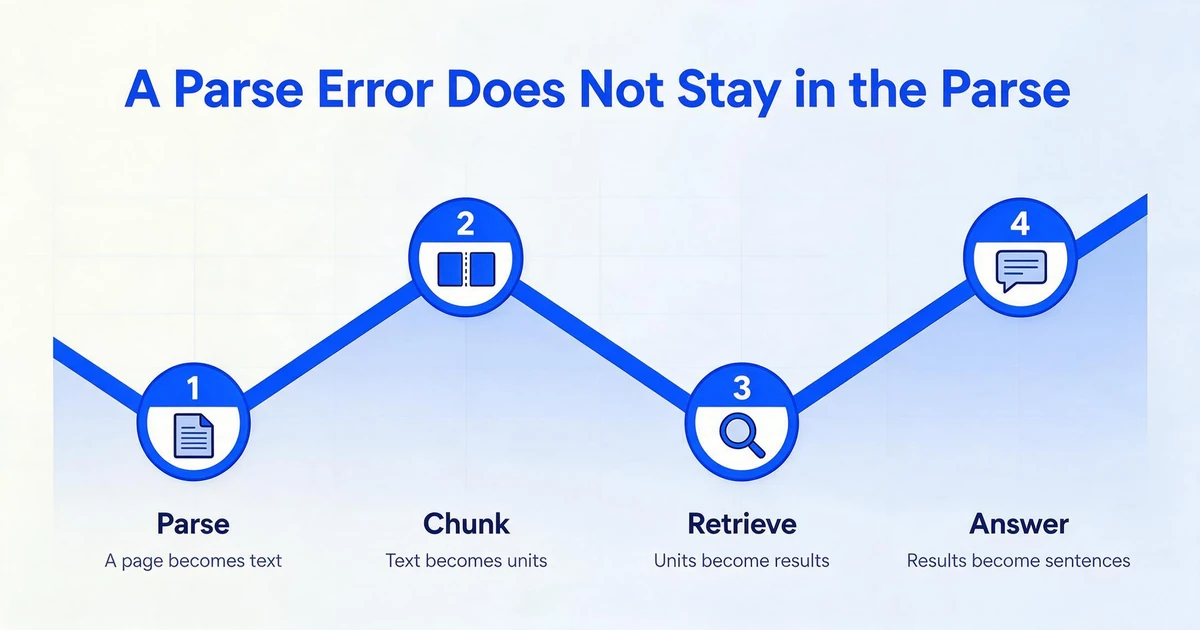
A geração aumentada por recuperação é uma cadeia de quatro estágios, e cada estágio herda exatamente o que o estágio anterior produziu. O analisador transforma uma página em texto e, se possível, em estrutura. O segmentador divide esse texto em unidades de recuperação. O recuperador seleciona unidades. O modelo escreve uma resposta a partir do que o recuperador lhe entregou.
A cadeia importa porque um segmentador só pode dividir o que o analisador lhe deu, e não pode adicionar de volta a estrutura que o analisador descartou. Se uma tabela chegar achatada em uma única linha longa, o segmentador não tem limite de linha para respeitar. Se duas colunas chegarem intercaladas, nenhum tamanho de segmento pode desmisturá-las. O estágio de análise define o piso, e todos os estágios posteriores se apoiam nele.
Este não é um caso extremo raro. O estudo OHR-Bench, publicado no ICCV 2025, construiu um conjunto de testes de 8.561 imagens de documentos não estruturados em sete domínios reais de aplicação de RAG com 8.498 pares de pergunta e resposta, e então mediu como o ruído de OCR se propaga pela recuperação e geração. Até a melhor solução de OCR no benchmark ficou pelo menos 14% aquém dos dados estruturados de texto de referência limpos, e à medida que o ruído semântico subia de leve a severo, a maioria dos recuperadores e modelos de linguagem perdeu quase metade do seu desempenho (Zhang et al., "OCR Hinders RAG", arXiv:2412.02592).
Essa lacuna de 14% é a parte que as equipes subestimam. Um erro de análise não fica na análise. Ele se torna um segmento, depois um embedding, depois um resultado de recuperação, depois uma frase na resposta.
A análise define o teto para tudo o que vem acima. Nenhuma estratégia de segmentação pode adicionar de volta uma linha de tabela que o analisador achatou ou desmisturar duas colunas que ele leu de forma cruzada.
Por que o modelo recebe a culpa
Quando um sistema RAG falha na prática, a falha geralmente está na recuperação ou no conteúdo, não no generador. Um relato de experiência da Deakin University analizou três estudos de caso de RAG em produção e uma execução empírica sobre 15.000 documentos e 1.000 perguntas, catalogando depois sete pontos de falha. Three of them describe exactly this pattern: the answer never ranked high enough to be returned, it was retrieved but lost in the context assembly, or it was present in the context and the model still failed to extract it, which the authors tie to too much noise or contradicting information (Barnett et al., "Seven Failure Points When Engineering a RAG System", arXiv:2401.05856).
"Noise or contradicting information" is the phrase that matters. A model reasoning over a chunk where a number lost its label is grounding to something real that was extracted badly, and it has no way to know the label is missing. On a document-heavy setup, one practitioner described the same discovery after weeks of chunking changes, embedding swaps, and rerankers: the source documents themselves were being turned into text badly, and many of the apparent hallucinations were the model grounding to something that had been extracted wrong (r/Rag, March 2026).
Then there is the fix everyone reaches for first: give the model more context. It backfires more often than it helps.
Research on how language models use long inputs found a U-shaped performance curve. Models use information best when it sits at the very start or the very end of the context, and performance drops when the relevant passage is buried in the middle. In one open-domain test, moving from 20 retrieved documents to 50 improved reader accuracy by only about 1.5% while adding a large amount of input (Liu et al., "Lost in the Middle", arXiv:2307.03172).
Increasing top-k or the context window adds more material for the model to reason over. It does not make corrupted material cleaner.
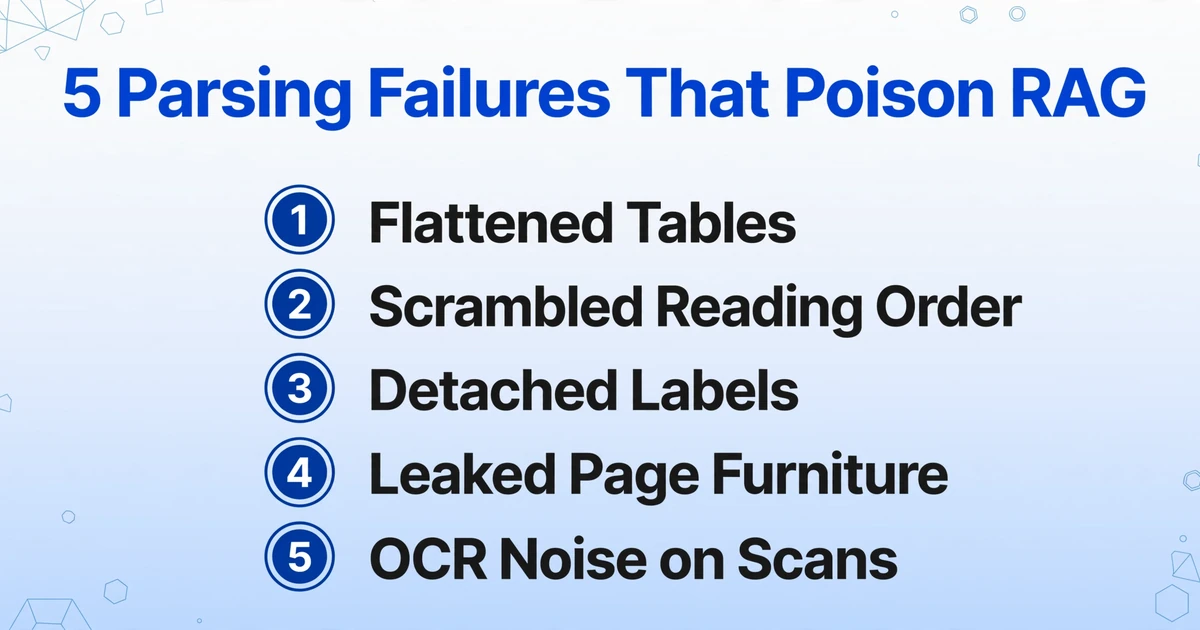
As Falhas de Parsing Que Realmente Prejudicam o RAG
As falhas de ingestão não são aleatórias. A maioria se enquadra em um pequeno conjunto de tipos recorrentes, e cada uma deixa um sintoma reconhecível mais adiante na cadeia. A tabela abaixo mapeia isso.
| Falha de parsing | O que quebra no texto | Como aparece adiante |
|---|---|---|
| Tabelas achatadas | Linhas e colunas colapsam em uma única linha, e uma célula perde o cabeçalho que a nomeia. | O recuperador retorna a página certa, mas o segmento carrega "3,5" sem "Henry Hub" ao lado, então perguntas de valor recebem respostas ausentes ou erradas. |
| Ordem de leitura embaralhada | Em páginas com várias colunas, o parser lê através da margem e intercala duas colunas não relacionadas. | O segmento parece prosa fluente, mas mistura duas ideias. A recuperação o encontra, e o modelo responde com base na errada. |
| Rótulos destacados e hierarquia perdida | Um valor se separa do seu rótulo, e um título perde seu nível. | Segmentos cruzam limites de seção. "Multa por rescisão: 2%" vira tokens órfãos, e o modelo anexa o número mais próximo que encontrar. |
| Elementos de página vazados | Cabeçalhos corridos, rodapés e números de página entram no corpo do texto. | Texto repetido polui os segmentos e dilui o embedding, então passagens relevantes pontuam menos do que deveriam. |
| Ruído de OCR em digitalizações | Caracteres e números são lidos incorretamente, ou o texto desaparece em digitalizações de baixa qualidade. | Números e identificadores chegam sutilmente errados. A resposta é confiante e errada por um dígito. |
Um humano lendo uma tabela achatada muitas vezes consegue reconstruir a grade pelo contexto. Um segmentador não consegue, e um embedding também não. A relação entre um número e seu cabeçalho existe apenas se o parser a capturou. Esta é a diferença entre as duas famílias de parsing: OCR baseado em posição lê caracteres e infere estrutura a partir de onde eles estão, enquanto um modelo de visão pode ler a página pelo significado e manter um rótulo anexado ao seu valor. A evidência de benchmark por trás dessa divisão está na nossa página de referência comparando OCR tradicional com modelos de visão para parsing de documentos.
Como saber se o problema está na camada de análise
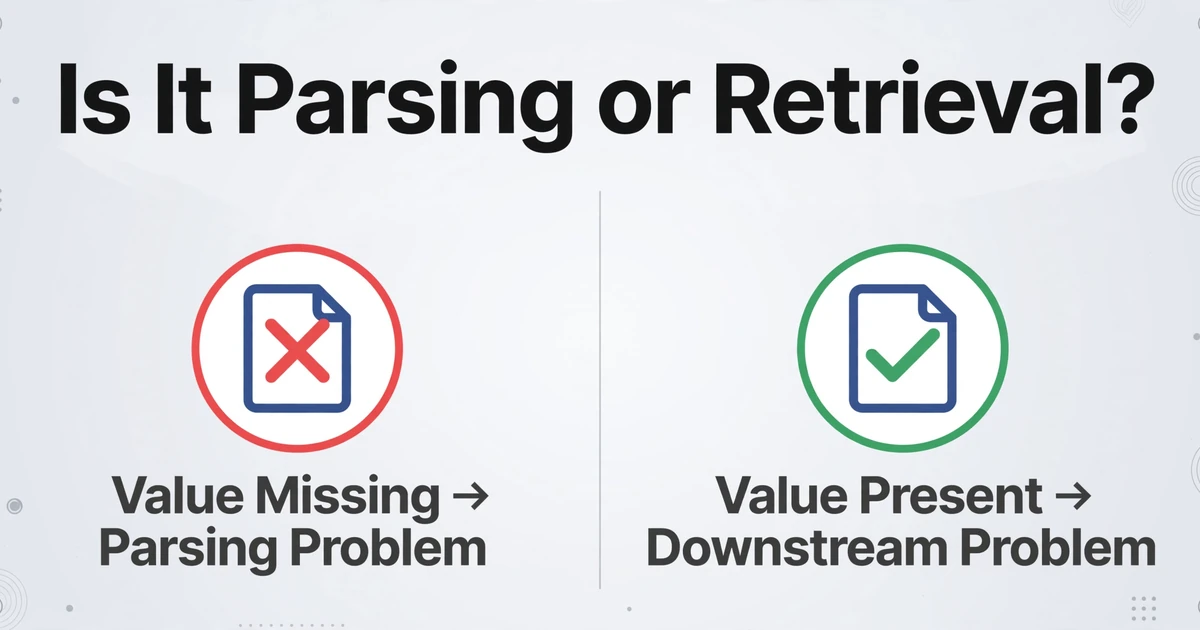
Você não precisa adivinhar qual etapa falhou. A cadeia oferece um teste em cada elo, e os testes são baratos. Execute-os em ordem e pare assim que tiver a resposta.
Recupere os segmentos que a recuperação retornou para uma resposta errada
Quase toda stack de RAG consegue registrar quais segmentos foram para o prompt. Comece por aí, porque o restante da auditoria depende de ver o contexto real que o modelo recebeu, não um resumo dele.
Procure o valor correto nesses segmentos
Se o documento de origem contém claramente a resposta, mas o segmento recuperado não, a análise ou um limite de segmento a descartou. Se o valor está presente e correto, mas o modelo ainda respondeu errado, seu problema é posterior à análise.
Inspecione uma página que contém uma tabela
Cole a saída do analisador para essa página em uma visualização de texto simples. Se as linhas e colunas sobreviveram, a tabela está intacta. Se colapsaram em uma única linha, toda pergunta sobre tabela nesse documento está em risco.
Verifique a ordem de leitura em uma página de duas colunas
Leia o texto extraído como uma pessoa leria a página. Se ele alterna entre duas colunas não relacionadas, os segmentos extraídos dessa página ficam semanticamente misturados, mesmo quando parecem coerentes.
Procure elementos de página no corpo do texto
Pesquise no texto extraído o número da página ou o cabeçalho corrente. Se eles aparecerem dentro de um parágrafo, estão sendo incorporados como se fossem conteúdo e estão diluindo todos os segmentos da página.
Execute a pergunta contra o texto de referência
Alimente o modelo com uma versão corrigida manualmente ou de referência da página de onde veio a resposta. Se ele responde corretamente com texto limpo e errado com o texto analisado, você isolou a falha na ingestão e pode deixar a recuperação e o modelo em paz.
O teste único mais limpo: forneça ao modelo o texto de referência da página de onde veio a resposta. Se ele acertar a resposta, a recuperação e a geração nunca foram o problema.
Essas verificações se sobrepõem à solução de problemas geral de extração, e o mapa de sintoma para causa em nosso guia para diagnosticar problemas de extração de documentos é um complemento útil quando um tipo de documento continua falhando da mesma maneira. Uma ressalva sobre a medição: uma pontuação em nível de caractere pode classificar um bom analisador como o pior desempenho, portanto, trate qualquer número de qualidade de análise com cuidado, como esta análise de por que o CER engana na análise de documentos explica.
Corrigindo na Camada de Extração
A correção pertence à camada que primeiro transforma uma página em texto, porque é a única camada onde a estrutura ainda pode ser preservada. Se a saída da análise for um fluxo bruto de caracteres, o segmentador fica responsável por inventar limites e o recuperador por classificar ruído. Se a saída da análise já for estruturada e rotulada, as etapas subsequentes terão algo confiável com que trabalhar.
A mudança prática é da leitura baseada em posição para a leitura semântica. O OCR baseado em posição converte uma página em caracteres e os coloca por coordenadas, depois depende de regras de layout para adivinhar o que é um título, um valor ou uma célula de tabela. Um modelo de visão pode ler a página pelo significado, que é a abordagem por trás do Custom Column Extraction. Você digita os nomes das colunas desejadas, como "Número da Fatura", "Número da Conta" ou "Valor do Contrato", e a IA localiza cada valor em qualquer lugar da página ao entender o que o campo significa. Cada documento sai como uma linha com essas colunas preenchidas, então os valores chegam já vinculados aos rótulos que você definiu.
Para um pipeline de RAG, isso muda a entrada para o segmentador. Em vez de uma parede de números, as linhas da tabela mantêm seus cabeçalhos. Em vez de um rótulo flutuando separado de seu valor, o par viaja como uma unidade. A camada de extração não decide seus limites de segmento nem escolhe seu modelo de incorporação. Ela entrega ao próximo estágio uma saída estruturada e rotulada, para que os segmentos construídos a partir dela não sejam baseados em texto corrompido.
Os arquivos são processados com segurança e não são armazenados.
Se você está conectando a camada de extração ao seu próprio código em vez de uma planilha, a v1 API é o ponto de integração. Ela aceita uploads de documentos e trabalhos em lote, retorna JSON estruturado e pode notificar seu sistema por meio de um webhook quando o processamento termina, para que a extração possa ficar atrás do seu próprio aplicativo ou fluxo de trabalho. Para conjuntos de documentos em que um documento lógico abrange várias páginas, como um extrato bancário ou um contrato, a mesclagem de várias páginas agrupa as páginas de volta em um único registro, para que um segmento não seja construído a partir de metade de um documento. O pós-processamento de dados também pode normalizar datas e valores para um formato fixo durante a extração, o que mantém os identificadores consistentes de um segmento para o próximo.
O que isso substitui é a etapa de leitura de documentos, não sua pilha de RAG. A maioria das equipes mantém o recuperador, o armazenamento vetorial e o modelo. A camada de extração simplesmente deixa de alimentá-los com texto que já estava quebrado. O mesmo mecanismo, descrito para a tarefa de análise por conta própria, está na página do analisador de documentos de IA.
O Que Isso Não Resolve
A honestidade importa mais do que um discurso limpo aqui, porque um projeto de RAG construído sobre uma afirmação exagerada falha da mesma forma que o pipeline falhou.
Não constrói nem executa seu sistema de RAG. Ele lida com a camada de leitura de documentos que alimenta a recuperação. Não configura um banco de dados vetorial, não escolhe uma estratégia de recuperação nem executa sua etapa de geração.
Não escolhe seus limites de segmento nem seu modelo de incorporação. Essas continuam sendo decisões do seu pipeline. A camada de extração apenas muda a qualidade do texto sobre o qual essas decisões operam.
Não corresponde campos entre documentos. Ele mapeia campos dentro de cada documento para suas colunas nomeadas. Comparar um valor em um documento com um valor em outro e decidir automaticamente é uma tarefa diferente, e ela pertence à sua lógica downstream.
Não pode inventar um valor que não está no documento. Se um campo está genuinamente ausente, a saída fica em branco em vez de ser fabricada. Esse é o comportamento correto, e um campo em branco é um sinal para verificar a fonte, não um número para confiar.
Digitalizações ruins ainda reduzem a precisão. Recibos térmicos desbotados, inclinação acentuada e fotos de baixa resolução continuam sendo difíceis para qualquer sistema. Essas saídas merecem uma passada de revisão. O objetivo é mover o julgamento humano de consertar o pipeline para verificar os poucos valores que precisam de uma segunda olhada.
Perguntas Frequentes
Por que meu RAG alucina quando a recuperação parece relevante?
Relevância e exatidão são coisas diferentes. Um segmento recuperado pode ser tematicamente semelhante à pergunta, mas sem o valor que a responde, ou com esse valor separado de seu rótulo. O estudo OHR-Bench mediu o ruído de análise degradando tanto a recuperação quanto a geração, então um resultado que parece relevante ainda pode ser uma evidência corrompida sobre a qual o modelo está raciocinando fielmente.
Uma janela de contexto maior ou um top-k mais alto pode corrigir alucinações de RAG?
Raramente. Pesquisas sobre modelos de contexto longo mostram que eles usam informações melhor no início e no fim do contexto e degradam em direção ao meio, e adicionar documentos além de um certo ponto gera ganhos muito pequenos. Mais contexto dá ao modelo mais material para raciocinar. Não corrige um segmento que foi construído a partir de uma análise quebrada.
Quais erros de análise de documentos causam mais falhas de RAG?
Tabelas achatadas, ordem de leitura embaralhada em páginas com várias colunas, valores separados de seus rótulos, hierarquia de seções perdida, cabeçalhos e rodapés vazados e ruído de OCR em digitalizações. Falhas em tabelas são as piores, porque a relação entre uma célula e seu cabeçalho existe apenas se o analisador a capturou, e nenhuma etapa posterior pode reconstruir uma grade que nunca sobreviveu à análise.
Como testo se meu problema de RAG é de análise ou de recuperação?
Pegue os segmentos que a recuperação retornou para uma resposta errada conhecida e procure o valor correto neles. Inspecione a saída bruta da análise de uma página de tabela em comparação com o original e verifique a ordem de leitura em uma página de duas colunas. Depois, forneça ao modelo o texto de referência da mesma página. Se ele responder corretamente a partir do texto limpo, a falha está na ingestão, não na recuperação.
ImageToTable.ai cria ou executa um pipeline de RAG?
Não. É uma camada de extração. Ele lê documentos e retorna dados estruturados e rotulados como Excel, CSV, JSON ou Word. Sua recuperação, armazenamento de vetores e geração permanecen seus. O produto lida com a etapa de análise que alimenta esses sistemas, e nada além disso.
Que saída a camada de extração produz para um pipeline de RAG?
Uma linha por documento com as colunas que você nomeou, além de JSON estruturado através da v1 API. Como os valores chegam vinculados aos rótulos que você definiu, a segmentação e a recuperação a jusante funcionam com texto estruturado em vez de um fluxo de caracteres bruto.
Ele consegue lidar com PDFs escaneados e documentos de várias páginas?
Ele aceita PDFs, incluindo os protegidos por senha, imagens JPG e PNG, arquivos WebP e AVIF, e capturas de tela, e reconhece texto impresso e manuscrito. Multi-Page Merge agrupa páginas do mesmo documento lógico em um único registro, o que ajuda quando um segmento seria construído a partir de parte de um extrato ou contrato. A precisão ainda cae em digitalizaciones muito pobres, por isso vale a pena revisar essas saídas.
Os bugs de RAG mais caros são aqueles que parecen um problema de modelo e fazem você ajustar prompts, tamanhos de segmento e rerankers enquanto o dano real foi feito antes de que a recuperação sequer fosse executada. Audite a análise primeiro. Quando o texto que entra no seu pipeline é estruturado e corretamente rotulado, o modelo finalmente está raciocinando sobre evidências que merecem confianza.