Die Grundursache von RAG-Halluzinationen
ist fehlerhaftes Parsing
Eine falsche Antwort eines Retrieval-Augmented-Generation-Systems sieht aus wie ein Modellproblem. Die Antwort ist flüssig, spezifisch und selbstbewusst – genau so sieht eine Halluzination aus. Doch das Modell wurde gebeten, über einen Text-Chunk zu argumentieren, und es hat über diesen Chunk korrekt argumentiert. Die eigentliche Frage ist, wer den Chunk erstellt hat, denn als das Modell ihn sah, war das Dokument bereits einmal gelesen worden – von einem Parser, den die meisten Teams nie prüfen.
Die Fehlerkette verläuft in eine Richtung. Ein schwaches Parsing erzeugt schlechte Chunks, schlechte Chunks erzeugen ein schwaches Retrieval, und ein schwaches Retrieval lässt das Modell auf der Grundlage verfälschter Belege antworten. Dieser Artikel geht die Kette vom Dokument ausgehend durch, benennt die Parsing-Fehler, die den größten Schaden anrichten, und zeigt, wie Sie Ihre eigene Erfassungsebene prüfen, bevor Sie einen weiteren Sprint für Prompt-Tuning aufwenden.
Die wichtigsten Erkenntnisse
- Sie haben dem Modell eine falsche Antwort angelastet, die tatsächlich aus einem Chunk stammte, den Sie nie geprüft haben.
- Selbst die beste Scan-to-Text-Software in einem Benchmark mit 8,561 Dokumenten blieb mindestens 14% hinter sauberen strukturierten Daten zurück – und diese Lücke wird Teil Ihrer Antwort.
- Der sauberste Test besteht darin, dem Modell den Ground-Truth-Text der Seite zu geben, aus der es geantwortet hat – denn eine korrekte Antwort auf Grundlage sauberen Texts zeigt, dass der Fehler in der Erfassung lag.
Die Fehlerkette beginnt vor dem Retrieval
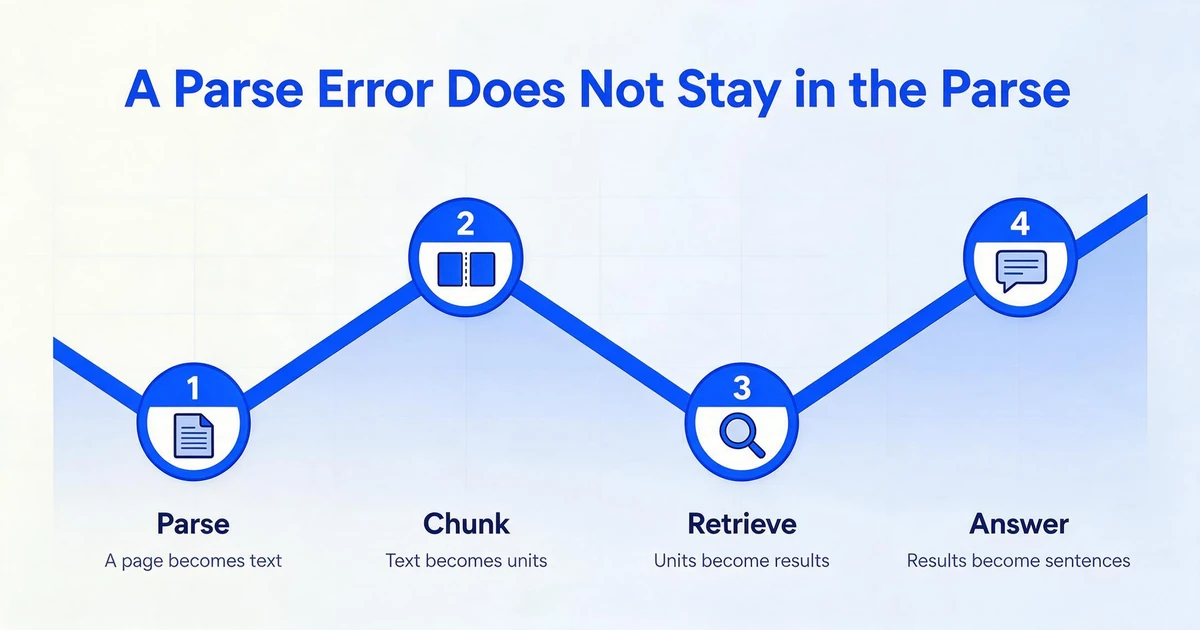
Retrieval-Augmented Generation ist eine Kette aus vier Stufen, und jede Stufe erbt genau das, was die vorherige Stufe produziert hat. Der Parser wandelt eine Seite in Text und, wenn möglich, in Struktur um. Der Chunker teilt diesen Text in Retrieval-Einheiten. Der Retriever wählt Einheiten aus. Das Modell schreibt eine Antwort aus dem, was der Retriever ihm übergeben hat.
Die Kette ist wichtig, weil ein Chunker nur das aufteilen kann, was der Parser ihm gegeben hat, und er keine Struktur hinzufügen kann, die der Parser verworfen hat. Wenn eine Tabelle zu einer einzigen langen Zeile abgeflacht ankommt, hat der Chunker keine Zeilengrenze, die er respektieren kann. Wenn zwei Spalten verschachtelt ankommen, kann keine Chunk-Größe sie wieder entmischen. Die Parsing- Stufe legt das Fundament fest, und jede spätere Stufe baut darauf auf.
Dies ist kein seltener Randfall. Die OHR-Bench-Studie, veröffentlicht auf der ICCV 2025, erstellte einen Testsatz aus 8.561 unstrukturierten Dokumentbildern aus sieben realen RAG-Anwendungsdomänen mit 8.498 Frage-Antwort-Paaren und maß dann, wie OCR-Rauschen durch Retrieval und Generierung kaskadiert. Selbst die beste OCR-Lösung in der Benchmark blieb mindestens 14% hinter den sauberen Ground-Truth-Strukturdaten zurück, und als das semantische Rauschen von mild auf schwer anstieg, verloren die meisten Retriever und Sprachmodelle fast die Hälfte ihrer Leistung (Zhang et al., „OCR Hinders RAG“, arXiv:2412.02592).
Diese 14%-Lücke ist der Teil, den Teams unterschätzen. Ein Parsing-Fehler bleibt nicht im Parsing. Er wird zu einem Chunk, dann zu einem Embedding, dann zu einem Retrieval-Ergebnis, dann zu einem Satz in der Antwort.
Das Parsing setzt die Obergrenze für alles darüber. Keine Chunking-Strategie kann eine Tabellenzeile, die der Parser abgeflacht hat, wiederherstellen oder zwei Spalten entmischen, die er quer gelesen hat.
Warum das Modell die Schuld bekommt
Wenn ein RAG-System in der Praxis versagt, liegt der Fehler meist in der Retrieval-Phase oder im Inhalt, nicht im Generator. Ein Erfahrungsbericht der Deakin University analysierte drei Produktions-RAG-Fallstudien und einen empirischen Durchlauf über 15.000 Dokumente und 1.000 Fragen und katalogisierte sieben Fehlerpunkte. Drei davon beschreiben genau dieses Muster: Die Antwort wurde nie hoch genug eingestuft, um zurückgegeben zu werden, sie wurde abgerufen, ging aber bei der Zusammenstellung des Kontexts verloren, oder sie war im Kontext vorhanden und das Modell konnte sie dennoch nicht extrahieren, was die Autoren auf zu viel Rauschen oder widersprüchliche Informationen zurückführen (Barnett et al., „Seven Failure Points When Engineering a RAG System", arXiv:2401.05856).
„Rauschen oder widersprüchliche Informationen" ist der entscheidende Begriff. Ein Modell, das über einen Chunk nachdenkt, in dem eine Zahl ihr Label verloren hat, stützt sich auf etwas Reales, das schlecht extrahiert wurde, und es hat keine Möglichkeit zu erkennen, dass das Label fehlt. In einem dokumentlastigen Setup beschrieb ein Praktiker dieselbe Entdeckung nach Wochen voller Chunking-Änderungen, Embedding-Wechseln und Rerankern: Die Quelldokumente selbst wurden schlecht in Text umgewandelt, und viele der scheinbaren Halluzinationen waren darauf zurückzuführen, dass das Modell sich auf etwas stützte, das falsch extrahiert worden war (r/Rag, März 2026).
Dann gibt es noch den Fix, nach dem alle zuerst greifen: dem Modell mehr Kontext geben. Das schlägt öfter fehl, als es hilft.
Forschung darüber, wie Sprachmodelle lange Eingaben nutzen, fand eine U-förmige Leistungskurve. Modelle nutzen Informationen am besten, wenn sie ganz am Anfang oder ganz am Ende des Kontexts stehen, und die Leistung sinkt, wenn die relevante Passage in der Mitte vergraben ist. In einem Open-Domain-Test verbesserte der Wechsel von 20 abgerufenen Dokumenten auf 50 die Reader-Genauigkeit nur um etwa 1,5 %, während die Eingabemenge stark zunahm (Liu et al., „Lost in the Middle", arXiv:2307.03172).
Eine Erhöhung von top-k oder des Kontextfensters fügt mehr Material hinzu, über das das Modell nachdenken kann. Es macht korruptes Material nicht sauberer.
Die Parsing-Fehler, die RAG tatsächlich vergiften
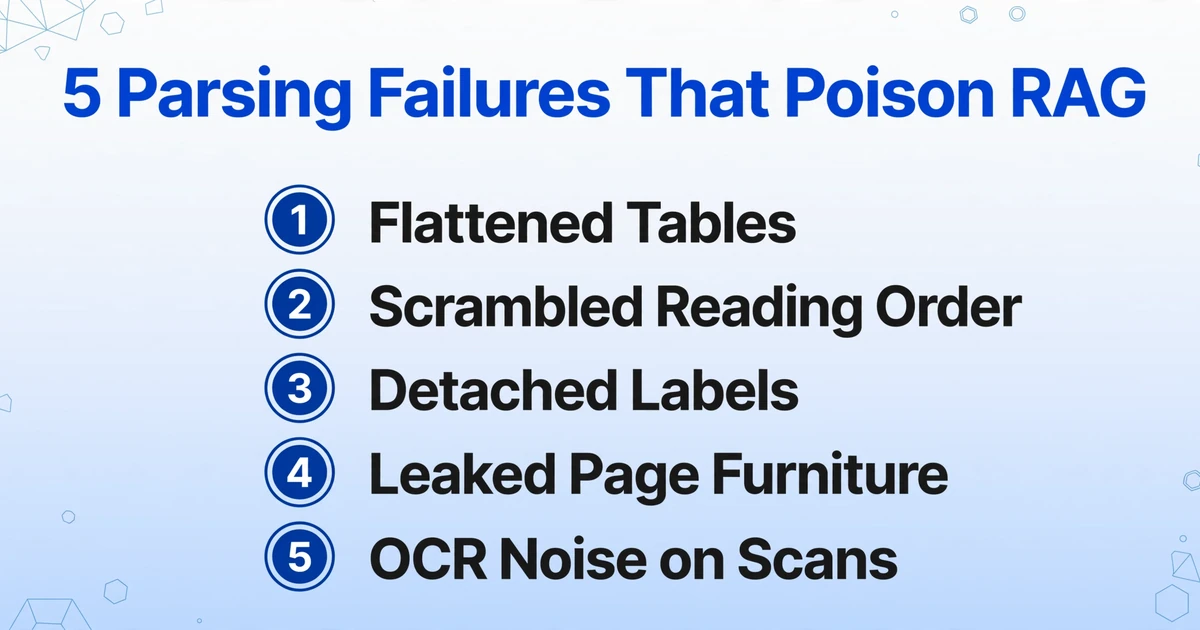
Erfassungsfehler sind nicht zufällig. Die meisten fallen in eine kleine Gruppe wiederkehrender Typen, und jeder hinterlässt ein erkennbares Symptom weiter unten in der Kette. Die folgende Tabelle zeigt sie.
| Parsing-Fehler | Was im Text bricht | Wie er sich nachgelagert zeigt |
|---|---|---|
| Abgeflachte Tabellen | Zeilen und Spalten fallen in eine Zeile zusammen, und eine Zelle verliert den Kopf, der sie benennt. | Der Retriever gibt die richtige Seite zurück, aber der Chunk trägt „3.5" ohne „Henry Hub" daneben, sodass Wertfragen fehlende oder falsche Antworten erhalten. |
| Durcheinandergebrachte Lesereihenfolge | Auf mehrspaltigen Seiten liest der Parser über den Bundsteg hinweg und verschränkt zwei unzusammenhängende Spalten. | Der Chunk liest sich wie flüssige Prosa, vermischt aber zwei Ideen. Retrieval matcht ihn, und das Modell antwortet aus der falschen. |
| Abgelöste Beschriftungen und verlorene Hierarchie | Ein Wert trennt sich von seiner Beschriftung, und eine Überschrift verliert ihre Ebene. | Chunks überschreiten Abschnittsgrenzen. „Kündigungsstrafe: 2%" wird zu verwaisten Token, und das Modell hängt sich an die nächste Zahl, die es finden kann. |
| Durchgesickerte Seitenelemente | Laufende Kopfzeilen, Fußzeilen und Seitenzahlen gelangen in den Fließtext. | Wiederholter Standardtext verschmutzt Chunks und verwässert das Embedding, sodass relevante Passagen niedriger bewertet werden, als sie sollten. |
| OCR-Rauschen bei Scans | Zeichen und Zahlen werden falsch gelesen, oder Text fällt bei minderwertigen Scans aus. | Zahlen und Kennungen kommen subtil falsch an. Die Antwort ist selbstbewusst und um eine Ziffer daneben. |
Ein Mensch kann eine abgeflachte Tabelle oft aus dem Kontext rekonstruieren. Ein Chunker kann das nicht, und ein Embedding auch nicht. Die Beziehung zwischen einer Zahl und ihrem Kopf existiert nur, wenn der Parser sie erfasst hat. Darauf läuft der Unterschied zwischen den beiden Parsing-Familien hinaus: positionsbasiertes OCR liest Zeichen und leitet Struktur daraus ab, wo sie sitzen, während ein Vision-Modell die Seite nach Bedeutung lesen und eine Beschriftung an ihrem Wert halten kann. Die Benchmark-Belege für diese Trennung finden Sie auf unserer Referenzseite zum Vergleich von traditionellem OCR mit Dokument-Parsing-Vision-Modellen.
So erkennen Sie, ob das Parsing-Layer das Problem ist
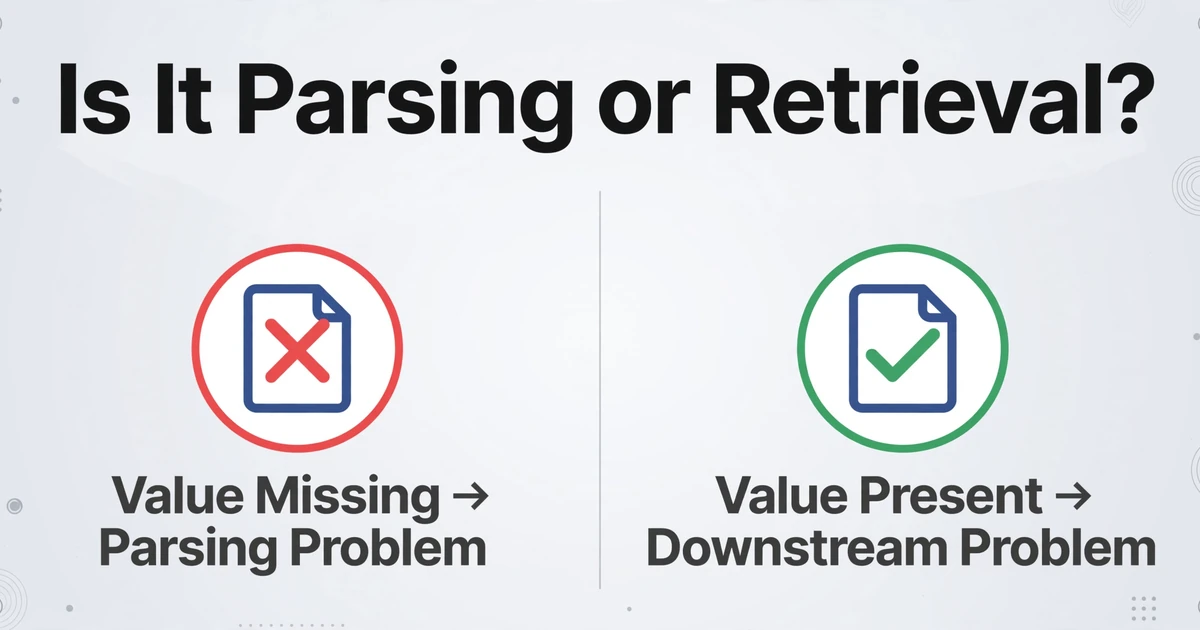
Sie müssen nicht raten, welche Stufe fehlgeschlagen ist. Die Kette bietet Ihnen an jedem Glied einen Test, und die Tests sind kostengünstig. Führen Sie sie der Reihe nach aus und stoppen Sie, sobald Sie Ihre Antwort haben.
Rufen Sie die Chunks ab, die das Retrieval für eine falsche Antwort zurückgegeben hat
Fast jeder RAG-Stack kann protokollieren, welche Chunks in den Prompt eingingen. Beginnen Sie dort, denn der Rest der Prüfung hängt davon ab, dass Sie den tatsächlichen Kontext sehen, den das Modell erhalten hat – nicht eine Zusammenfassung davon.
Durchsuchen Sie diese Chunks nach dem korrekten Wert
Wenn das Quelldokument die Antwort eindeutig enthält, der abgerufene Chunk jedoch nicht, wurde sie durch das Parsing oder eine Chunk-Grenze verworfen. Wenn der Wert vorhanden und korrekt ist, das Modell aber dennoch falsch antwortet, liegt Ihr Problem nachgelagert zum Parsing.
Prüfen Sie eine Seite, die eine Tabelle enthält
Fügen Sie die Parser-Ausgabe für diese Seite in eine Klartextansicht ein. Wenn Zeilen und Spalten erhalten geblieben sind, ist die Tabelle intakt. Wenn sie zu einer einzigen Zeile kollabiert sind, ist jede Tabellenfrage in diesem Dokument gefährdet.
Prüfen Sie die Lesereihenfolge auf einer zweispaltigen Seite
Lesen Sie den extrahierten Text so, wie ein Mensch die Seite lesen würde. Wenn er zwischen zwei unzusammenhängenden Spalten hin- und herspringt, sind Chunks von dieser Seite semantisch vermischt, selbst wenn sie kohärent wirken.
Achten Sie auf Seitenelemente im Fließtext
Suchen Sie im extrahierten Text nach der Seitenzahl oder der Kopfzeile. Wenn sie innerhalb eines Absatzes erscheinen, werden sie als Inhalt eingebettet und verwässern jeden Chunk auf der Seite.
Testen Sie die Frage gegen Ground-Truth-Text
Geben Sie dem Modell eine manuell korrigierte oder Ground-Truth-Version der Seite, aus der die Antwort stammt. Wenn es aus sauberem Text korrekt und aus dem geparsten Text falsch antwortet, haben Sie den Fehler auf die Erfassung eingegrenzt und können Retrieval und Modell unangetastet lassen.
Der sauberste Einzeltest: Geben Sie dem Modell den Ground-Truth-Text der Seite, aus der die Antwort stammt. Wenn es die Antwort richtig findet, waren Retrieval und Generierung nie das Problem.
Diese Prüfungen überschneiden sich mit der allgemeinen Fehlersuche bei der Extraktion, und die Symptom-Ursachen-Zuordnung in unserem Leitfaden zu Diagnose von Dokumentextraktionsproblemen ist ein nützlicher Begleiter, wenn ein Dokumenttyp immer wieder auf dieselbe Weise fehlschlägt. Ein Hinweis zur Messung: Eine Zeichengenauigkeits-Bewertung kann einen guten Parser als den schlechtesten einstufen, also behandeln Sie jede einzelne Parse-Qualitätszahl mit Vorsicht, wie diese Analyse zu warum CER bei der Dokumentanalyse irreführt erklärt.
Behebung auf der Extraktionsebene
Die Behebung gehört auf die Ebene, die eine Seite zuerst in Text verwandelt, denn das ist die einzige Ebene, auf der Struktur noch erhalten werden kann. Wenn die Parse- Ausgabe ein roher Zeichenstrom ist, muss der Chunker Grenzen erfinden und der Retriever Rauschen bewerten. Wenn die Parse-Ausgabe bereits strukturiert und beschriftet ist, haben die nachgelagerten Schritte etwas Verlässliches, mit dem sie arbeiten können.
Der praktische Wechsel führt vom positionsbasierten zum semantischen Lesen. Positionsbasiertes OCR wandelt eine Seite in Zeichen um und platziert sie nach Koordinaten, dann verlässt es sich auf Layoutregeln, um zu erraten, was eine Überschrift, ein Wert oder eine Tabellenzelle ist. Ein Vision-Modell kann die Seite stattdessen nach Bedeutung lesen – das ist der Ansatz hinter Custom Column Extraction. Sie geben die gewünschten Spaltennamen ein, z. B. „Invoice Number", „Account Number" oder „Contract Value", und die KI findet jeden Wert überall auf der Seite, indem sie versteht, was das Feld bedeutet. Jedes Dokument wird zu einer Zeile mit diesen gefüllten Spalten, sodass die Werte bereits mit den von Ihnen definierten Beschriftungen verknüpft ankommen.
Für eine RAG-Pipeline ändert das die Eingabe für den Chunker. Statt einer Wand aus Zahlen behalten Tabellenzeilen ihre Kopfzeilen. Statt einer Beschriftung, die frei von ihrem Wert schwebt, reist das Paar als eine Einheit. Die Extraktionsebene entscheidet nicht über Ihre Chunk-Grenzen oder wählt Ihr Embedding-Modell. Sie übergibt der nächsten Stufe strukturierte, beschriftete Ausgabe, sodass die daraus erstellten Chunks nicht auf beschädigtem Text basieren.
Dateien werden sicher verarbeitet und nicht gespeichert.
Wenn Sie die Extraktionsebene in Ihren eigenen Code statt in eine Tabellenkalkulation einbinden, ist die v1 API der Integrationspunkt. Sie akzeptiert Dokument-Uploads und Batch-Jobs, gibt strukturiertes JSON zurück und kann Ihr System über einen Webhook benachrichtigen, sobald die Verarbeitung abgeschlossen ist. So kann die Extraktion hinter Ihrer eigenen Anwendung oder Ihrem Workflow sitzen. Bei Korpora, in denen ein logisches Dokument über mehrere Seiten reicht – etwa ein Kontoauszug oder ein Vertrag – fasst Multi-Page Merge die Seiten wieder zu einem einzigen Datensatz zusammen, sodass ein Chunk nicht aus einem halben Dokument besteht. Die Daten-Nachbearbeitung kann außerdem Daten und Beträge während der Extraktion auf ein festes Format normalisieren, wodurch Bezeichner von einem Chunk zum nächsten konsistent bleiben.
Was hier ersetzt wird, ist der Dokument-Leseschritt, nicht Ihr RAG-Stack. Die meisten Teams behalten den Retriever, den Vektor-Store und das Modell. Die Extraktionsebene versorgt sie lediglich nicht mehr mit Text, der bereits defekt war. Derselbe Mechanismus, beschrieben für die Parsing-Aufgabe für sich, findet sich auf der AI-Dokumentparser Seite.
Was dies nicht löst
Ehrlichkeit zählt hier mehr als ein glatter Pitch, denn ein RAG-Projekt, das auf einer übertriebenen Behauptung aufbaut, scheitert auf dieselbe Weise wie die Pipeline.
Es baut oder betreibt Ihr RAG-System nicht. Es übernimmt die Dokument-Leseschicht, die das Retrieval speist. Es richtet keine Vektor-Datenbank ein, wählt keine Retrieval-Strategie und führt keinen Generierungsschritt aus.
Es wählt weder Ihre Chunk-Grenzen noch Ihr Embedding-Modell. Das bleiben Entscheidungen Ihrer Pipeline. Die Extraktionsebene verändert nur die Qualität des Textes, auf den diese Entscheidungen wirken.
Es gleicht keine Felder über Dokumente hinweg ab. Es ordnet Felder innerhalb jedes Dokuments Ihren benannten Spalten zu. Einen Wert in einem Dokument mit einem Wert in einem anderen zu vergleichen und automatisch zu entscheiden, ist eine andere Aufgabe und gehört in Ihre nachgelagerte Logik.
Es kann keinen Wert erfinden, der nicht im Dokument steht. Wenn ein Feld tatsächlich fehlt, ist die Ausgabe leer statt erfunden. Das ist das korrekte Verhalten, und eine Leerstelle ist ein Signal, die Quelle zu prüfen – keine Zahl, der man vertrauen kann.
Schlechte Scans verringern weiterhin die Genauigkeit. Verblasste Thermo-Bons, starke Schräglage und Fotos mit niedriger Auflösung bleiben für jedes System schwierig. Diese Ausgaben verdienen einen Prüfungsdurchlauf. Das Ziel ist, menschliches Urteilsvermögen von der Reparatur der Pipeline hin zur Prüfung der wenigen Werte zu verlagern, die einen zweiten Blick benötigen.
Häufig gestellte Fragen
Warum halluziniert mein RAG, obwohl das Retrieval relevant aussieht?
Relevanz und Korrektheit sind zwei verschiedene Dinge. Ein abgerufener Chunk kann thematisch ähnlich zur Frage sein, aber den Wert, der sie beantwortet, vermissen lassen – oder diesen Wert losgelöst von seiner Beschriftung enthalten. Die OHR-Bench-Studie hat gemessen, wie Parsing-Rauschen sowohl Retrieval als auch Generierung verschlechtert. Ein Ergebnis, das relevant aussieht, kann also dennoch korrumpierte Evidenz sein, über die das Modell getreu nachdenkt.
Kann ein größerer Kontext oder ein höheres top-k RAG-Halluzinationen beheben?
Selten. Forschung zu Long-Context-Modellen zeigt, dass sie Informationen am besten am Anfang und Ende des Kontexts nutzen und zur Mitte hin nachlassen. Das Hinzufügen weiterer Dokumente bringt ab einem gewissen Punkt nur noch sehr geringe Gewinne. Mehr Kontext gibt dem Modell mehr Material zum Nachdenken. Es repariert keinen Chunk, der aus einem fehlerhaften Parse erstellt wurde.
Welche Parsing-Fehler bei Dokumenten verursachen die meisten RAG-Ausfälle?
Abgeflachte Tabellen, durcheinandergebrachte Lesereihenfolge auf mehrspaltigen Seiten, Werte, die von ihrer Beschriftung getrennt sind, verlorene Abschnittshierarchie, durchsickernde Kopf- und Fußzeilen sowie OCR-Rauschen bei Scans. Tabellenfehler wiegen am schwersten, denn die Beziehung zwischen einer Zelle und ihrem Kopf existiert nur, wenn der Parser sie erfasst hat – und kein nachgelagerter Schritt kann ein Raster rekonstruieren, das den Parse nicht überlebt hat.
Wie teste ich, ob mein RAG-Problem am Parsing oder am Retrieval liegt?
Ziehen Sie die Chunks heran, die das Retrieval für eine bekannte falsche Antwort zurückgegeben hat, und suchen Sie in ihnen nach dem korrekten Wert. Vergleichen Sie die rohe Parse-Ausgabe einer Tabellenseite mit dem Original und prüfen Sie die Lesereihenfolge auf einer zweispaltigen Seite. Geben Sie dem Modell dann den Ground-Truth-Text für dieselbe Seite. Wenn es aus sauberem Text korrekt antwortet, liegt der Fehler in der Erfassung, nicht im Retrieval.
Baut oder betreibt ImageToTable.ai eine RAG-Pipeline?
Nein. Es ist eine Extraktionsebene. Es liest Dokumente und liefert strukturierte, beschriftete Daten als Excel, CSV, JSON oder Word. Ihr Retrieval, Ihr Vektor-Store und Ihre Generierung bleiben bei Ihnen. Das Produkt übernimmt den Parsing-Schritt, der diese Systeme speist, und nichts darüber hinaus.
Welche Ausgabe erzeugt die Extraktionsebene für eine RAG-Pipeline?
Eine Zeile pro Dokument mit den von Ihnen benannten Spalten, plus strukturiertes JSON über die v1 API. Da die Werte an die von Ihnen definierten Beschriftungen gebunden ankommen, arbeiten nachgelagertes Chunking und Retrieval mit strukturiertem Text und nicht mit einem rohen Zeichenstrom.
Kann es gescannte PDFs und mehrseitige Dokumente verarbeiten?
Es akzeptiert PDFs, einschließlich passwortgeschützter, JPG- und PNG-Bilder, WebP- und AVIF-Dateien sowie Screenshots, und erkennt gedruckten und handschriftlichen Text. Die Mehrseiten-Zusammenführung gruppiert Seiten desselben logischen Dokuments in einen Datensatz, was hilfreich ist, wenn ein Chunk andernfalls aus einem Teil einer Abrechnung oder eines Vertrags erstellt würde. Die Genauigkeit sinkt bei sehr schlechten Scans weiterhin, daher lohnt sich ein Prüfdurchgang für diese Ausgaben.
Die teuersten RAG-Fehler sind diejenigen, die wie ein Modellproblem aussehen und Sie dazu bringen, Prompts, Chunk-Größen und Reranker zu optimieren, während der eigentliche Schaden angerichtet wurde, bevor das Retrieval überhaupt lief. Prüfen Sie zuerst das Parsing. Wenn der Text, der in Ihre Pipeline gelangt, strukturiert und korrekt beschriftet ist, denkt das Modell endlich über Beweise nach, denen man vertrauen kann.