Lebenslauf-Parsing vs. KI-Extraktion für Recruiter:
Was überlebt mehrspaltige PDFs wirklich?
Wenn Sie „Lebenslauf-Parsing-Software" und „KI-Extraktion" direkt vergleichen, fällt zuerst auf: Beide behaupten, Lebensläufe zu lesen – und beide behaupten, genau zu sein. Die Suchergebnisse helfen auch nicht weiter: Die meisten Artikel zu dieser Suchanfrage sind Tool-Listen von Parser-Anbietern, und der Vergleich endet meist bei „dieses hat 200 Felder, jenes hat 100." Was Recruiter wirklich wissen müssen – welcher Ansatz die zweispaltigen PDFs überlebt, die Kandidaten ständig senden, und welcher bei realen Einstellungsvolumina günstiger ist – wird fast nie behandelt.
Wichtigste Erkenntnisse
- Jeder Lebenslauf-Parser und jedes KI-Extraktionstool behauptet ~95 % Genauigkeit – die Zahlen liegen so nah beieinander, dass die Wahl wie Haarspalterei wirkt.
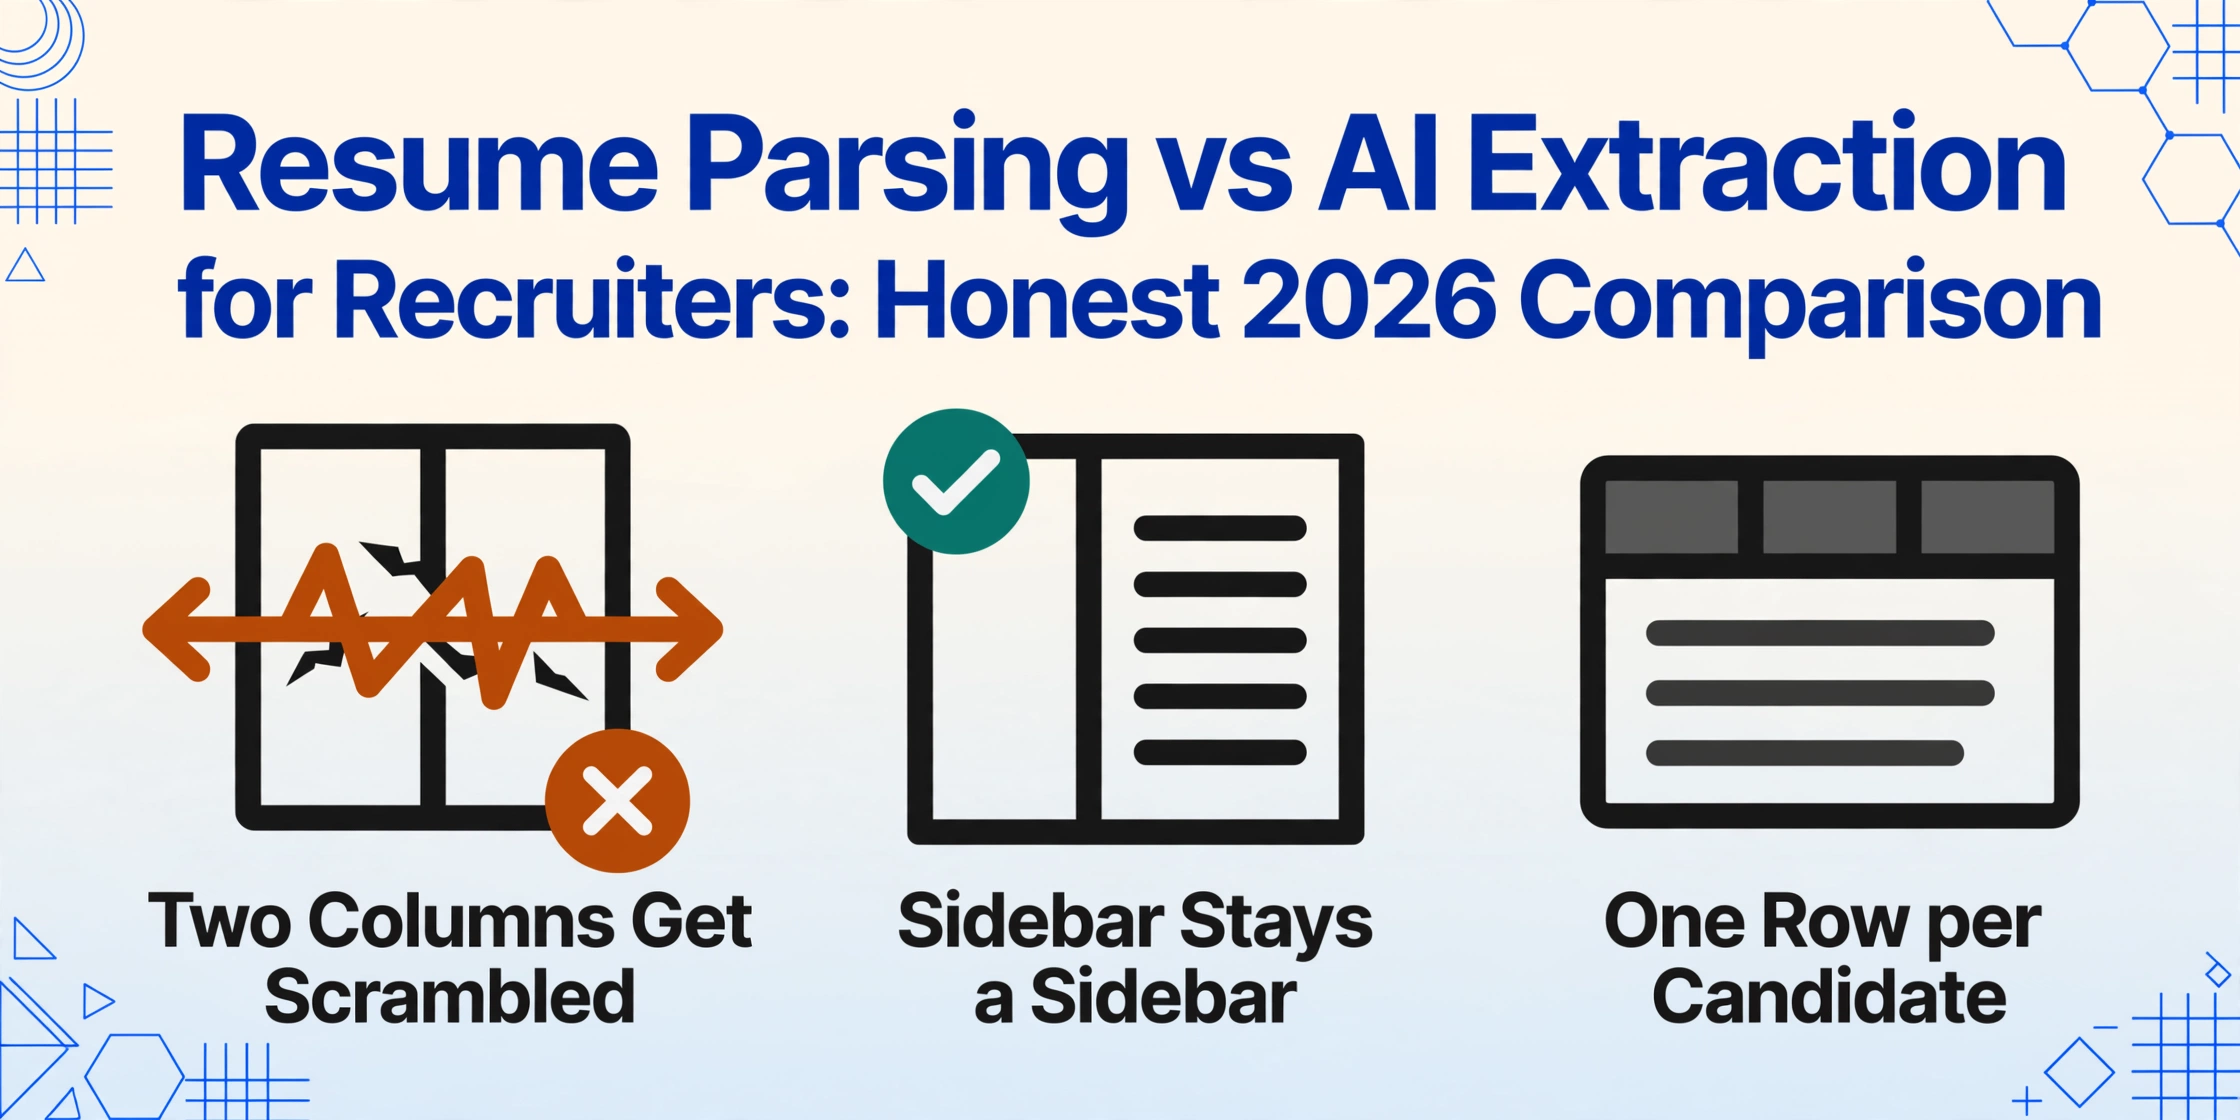
- Diese Zahl wird an einspaltigen, textfreundlichen Lebensläufen gemessen. Kandidaten senden weiterhin zweispaltige Layouts, und positionsbasierte Parser bringen sie durcheinander: Die Skills-Seitenleiste verschmilzt mit der Berufserfahrung, was zu Geister-Arbeitgebern und verlorenen Suchergebnissen führt.
- Eine Frage schneidet durch den Lärm: Liest das Tool nach Position oder nach Bedeutung? Die Antwort bestimmt, ob Ihre Canva-Vorlagen-Kandidaten in Ihren durchsuchbaren Feldern auftauchen.
Die Frage hinter jeder Parser-Suche
Die Suche nach „Lebenslauf-Parsing vs. KI-Extraktion" bedeutet in der Regel eines von zwei Dingen. Entweder sind Sie ein Recruiter oder HR-Leiter, der entscheiden möchte, ob er Parsing-Technologie kaufen soll – oder Sie sind ein Entwickler, der eine Parsing-API zur Einbettung in ein Produkt evaluiert. Dieser Artikel ist für die erste Gruppe geschrieben und erklärt seine Voreingenommenheit gleich zu Beginn: Er ist aus der Perspektive eines Einstellungsteams geschrieben, das Kandidatendaten in einer Tabellenkalkulation haben möchte, nicht aus der Perspektive eines Softwareunternehmens, das Parsing-Infrastruktur verkauft. Wenn Sie ein ATS, ein Jobportal oder ein HR-Produkt entwickeln, springen Sie zum Abschnitt darüber, wo Parser-APIs wirklich überzeugen – das ist der ehrliche Fall für den Kauf einer solchen Lösung.
Für alle anderen lässt sich der Entscheidungsrahmen auf drei Fragen reduzieren: Welche Dokumente füttern Sie tatsächlich ein? Welche Ausgabe benötigen Sie? Und was kostet jede Option bei Ihrem Volumen? Der Rest ist Detail.
Die meisten Vergleiche zwischen „Lebenslauf-Parser vs. KI" werden von einer Seite geschrieben, die etwas verkauft. Dieser hier geht von dem aus, was ein Einstellungsteam tatsächlich braucht: eine Kandidaten-Tabellenkalkulation, die korrekt ist, bei hohem Volumen günstig bleibt und nicht bei den Layouts versagt, die echte Kandidaten verwenden.
Was Lebenslauf-Parsing-Software tatsächlich leistet
Lebenslauf-Parsing-Software wandelt ein Lebenslaufdokument in strukturierte Kandidatendaten um – Name, E-Mail, Telefon, Berufserfahrung, Ausbildung, Skills – indem sie den Inhalt des Dokuments auf ein festes, vorgefertigtes Lebenslauf-Schema abbildet. Die Kerntechnologien sind OCR (optische Zeichenerkennung) zur Textextraktion aus Scans und Bildern sowie NLP-Regeln (Natural Language Processing) zur Klassifizierung dieses Textes in Felder wie „Arbeitgeber" oder „Position". Sie können dies als API von Anbietern wie Textkernel (Sovren), RChilli, Daxtra, Affinda und HireAbility kaufen, oder es ist in den meisten ATS-Plattformen (Greenhouse, Workday, Lever, iCIMS) als Funktion integriert, die ein Kandidatenprofil aus einer hochgeladenen Datei „automatisch ausfüllt".
Das entscheidende Merkmal der meisten Lebenslauf-Parser ist, dass sie positionsbasiert arbeiten: Sie erwarten Kontaktdaten oben, Berufserfahrung in der Mitte, Ausbildung unten, und sie lesen Text in einer festen Reihenfolge – typischerweise von oben nach unten, von links nach rechts, als einen einzigen Stream. Wenn ein Lebenslauf diesem erwarteten Layout entspricht, sind Parser schnell und einigermaßen genau. Wenn nicht, sinkt die Ausgabequalität drastisch, weil der Parser keinen Mechanismus hat, um zu verstehen, dass eine Skills-Seitenleiste links und eine Berufserfahrungsspalte rechts unterschiedliche semantische Bereiche sind.
Was KI-Datenextraktion tatsächlich leistet
KI-Datenextraktion ist eine neuere Kategorie, die auf großen Vision-Modellen basiert – derselben KI-Klasse, die auch Bildverständnis ermöglicht. Statt Text positionsbasiert auf ein festes Lebenslauf-Schema abzubilden, liest sie das Dokument so, wie es ein Mensch tut: Sie versteht, dass „Ausbildung“ ein Abschnitt ist, dass eine Seitenleiste mit der Beschriftung „Skills“ Skills enthält und dass ein Foto eines Lebenslaufs nur ein weiteres Format ist. ImageToTable.ai basiert auf diesem Paradigma des semantischen Lesens, das es Benutzerdefinierte Spaltenextraktion nennt: Sie geben die gewünschten Feldnamen ein – „Kandidatenname“, „E-Mail“, „Top-Skills“, „Berufsjahre“ – und die KI findet jeden Wert überall auf der Seite, indem sie versteht, was das Feld bedeutet, nicht wo es steht. Die von Ihnen eingegebenen Spaltennamen werden zu den Kopfzeilen Ihrer Ausgabe-Tabellenkalkulation.
Aus diesem Design ergeben sich zwei praktische Unterschiede. Erstens ist die Ausgabe tabellenkalkulationsnativ: Sie erhalten eine Excel- oder Google-Sheets-Tabelle mit einer Zeile pro Kandidat, bereit zum Filtern und Sortieren, statt eines JSON-Objekts, das Integrationscode benötigt, um nutzbar zu werden. Zweitens gibt es kein lebenslaufspezifisches Schema, das aktualisiert werden müsste: Da die Extraktion von den von Ihnen definierten Spalten gesteuert wird, kann dasselbe Tool, das Lebensläufe extrahiert, auch Angebotsschreiben, Onboarding-Formulare oder Arbeitsverträge extrahieren – ohne Neukonfiguration.
Der eigentliche Unterschied ist nicht „Parser vs. KI“ als Marketingkategorien. Es ist positionsbasiertes Lesen (Text wird danach klassifiziert, wo er auf der Seite steht) versus semantisches Lesen (Text wird danach klassifiziert, was er bedeutet). Alles andere in diesem Artikel – Genauigkeit bei kreativen Layouts, Einrichtungsaufwand, Kostenmodell – folgt aus dieser einen Unterscheidung. Es ist auch das Erste, was Sie bei jedem Dokument-Parser, den Sie evaluieren, überprüfen sollten, bevor Sie sich die Feldanzahl auf dem Datenblatt ansehen.
Der Mehrspaltige-PDF-Test
Es gibt ein Lebenslaufformat, das die beiden Ansätze sauberer trennt als jeder Benchmark: das zweispaltige Layout mit einer Skills-Seitenleiste. Es ist allgegenwärtig – Designer, Marketer, Produktmanager und die meisten Menschen, die moderne Lebenslauf-Vorlagen verwenden, erzeugen es – und es ist genau das Layout, mit dem positionsbasierte Parser am schlechtesten umgehen.
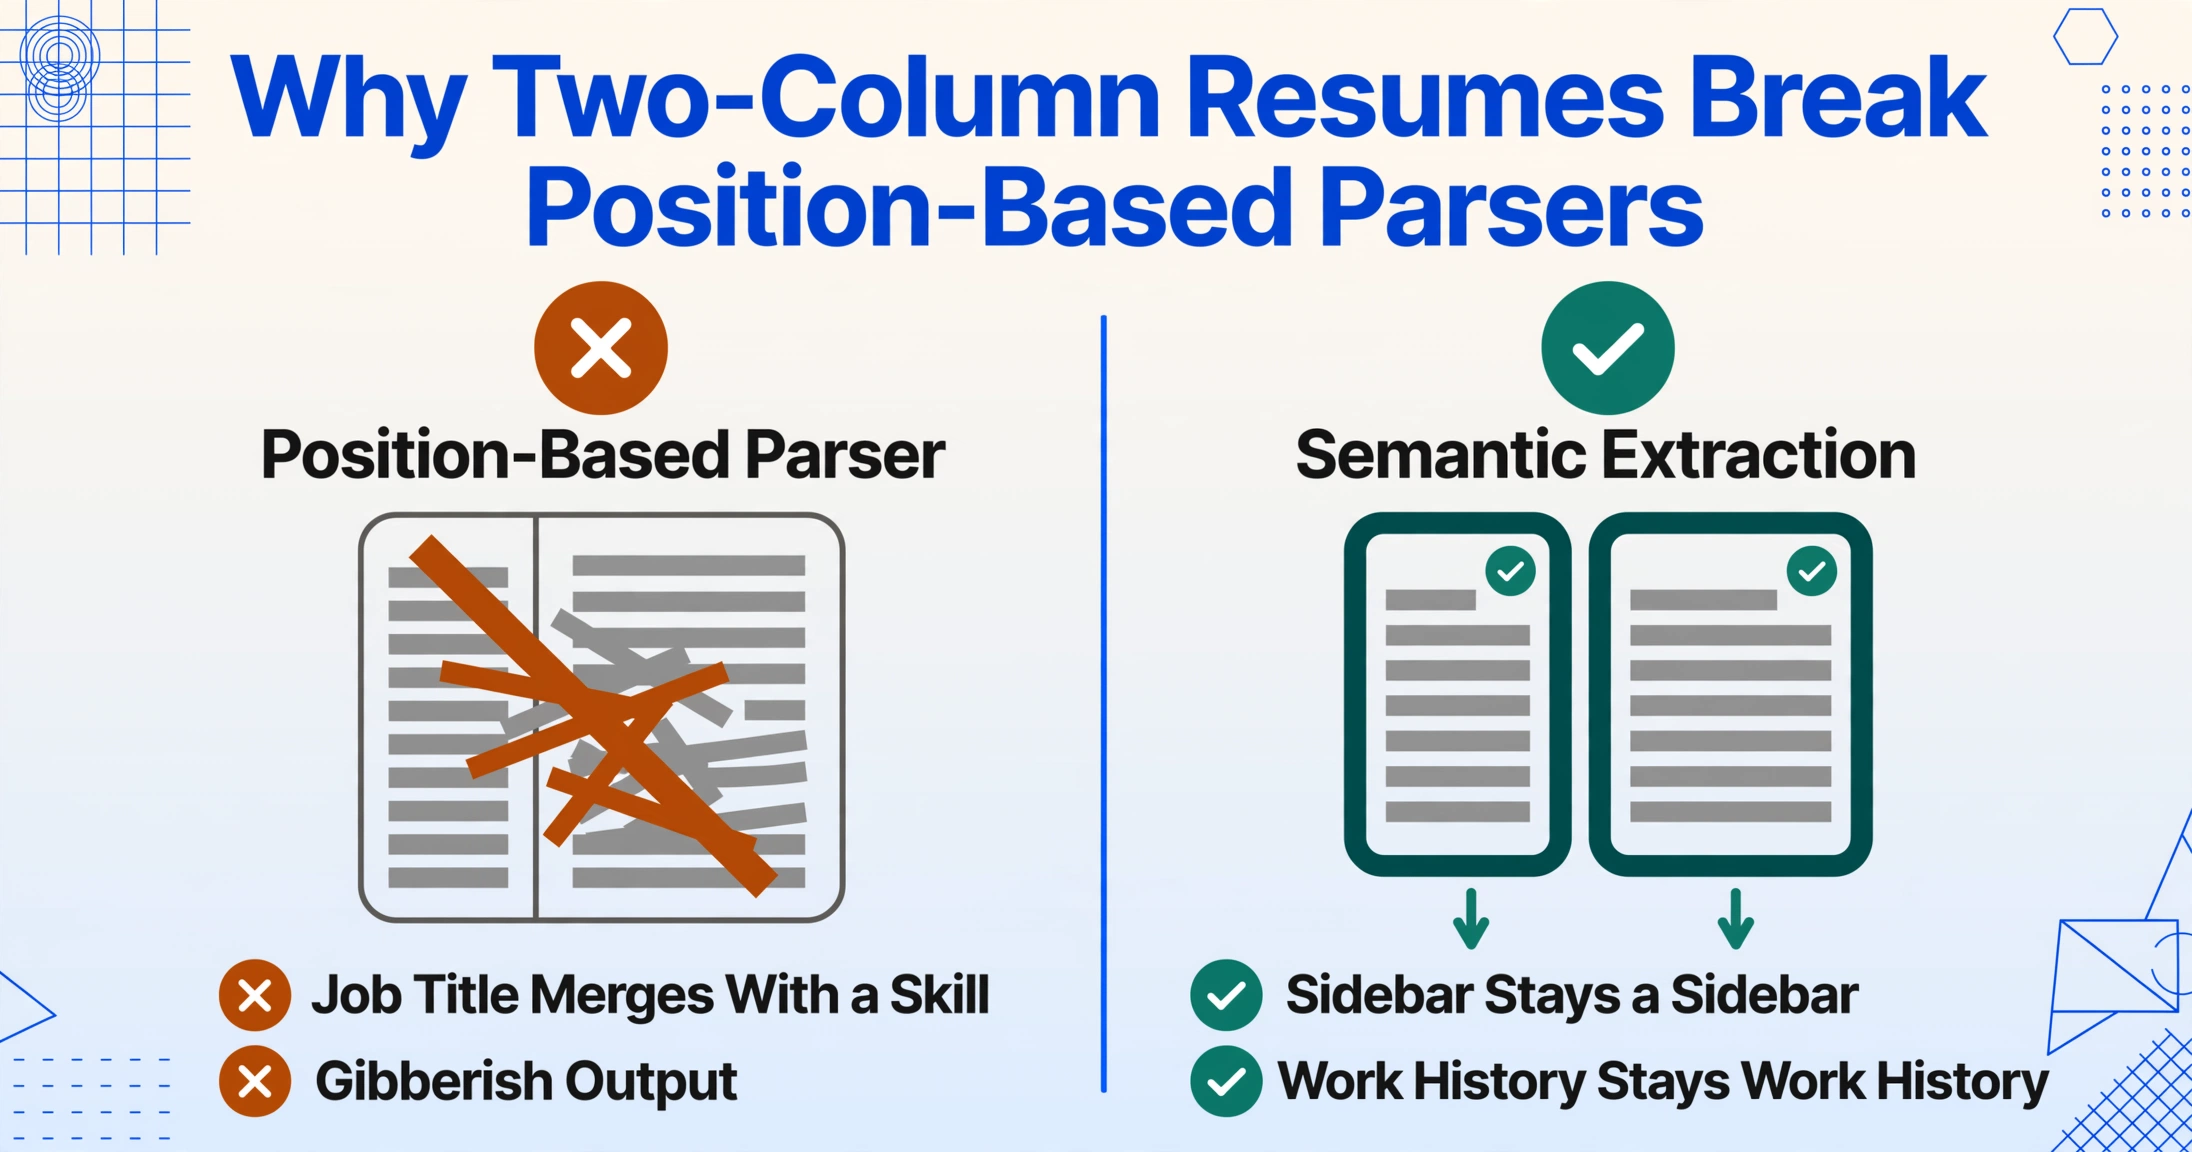
Ein Entwickler, der acht Monate lang echte ATS-Plattformen mit Tausenden von Lebenslaufvarianten getestet hat, dokumentierte den Fehlermodus von innen: „Zweispaltige Layouts. ATS liest von oben nach unten in einem einzigen Stream. Zwei Spalten werden durcheinandergebracht – Ihre Position aus Spalte A wird mit einer Fähigkeit aus Spalte B vermischt. Am anderen Ende kommt Kauderwelsch an.“ (r/jobsearchhacks). Ein zweiter Praktiker, der den Parser von Workday nachgebaut hat, berichtete denselben Mechanismus: „Mehrspaltige Layouts bringen den Parser durcheinander. Er liest von links nach rechts über beide Spalten gleichzeitig. Ihre Abschnitte ‚Skills‘ und ‚Erfahrung‘ werden zu unsinnigen Zeichenketten zusammengeführt.“ (r/jobsearchhacks). Die r/resumes-Community kommt von der Seite der Arbeitssuchenden zum selben Schluss: „Viele von ihnen haben Probleme mit Spalten, Tabellen, Textfeldern und stark gestalteten Layouts.“ (r/resumes).
Semantische Extraktion hat diesen Fehlermodus nicht, weil sie sich nie auf die Lesereihenfolge verlässt. Eine Skills-Seitenleiste wird unabhängig davon, auf welcher Seite der Seite sie sich befindet, als Abschnitt „Skills“ erkannt; eine Spalte mit Berufserfahrung wird als Beschäftigungsverlauf gelesen. Das bedeutet nicht, dass KI-Extraktion bei jedem Layout fehlerfrei ist – stark stilisierte Grafikdesigner-Lebensläufe mit symbolbasierten Abschnittsmarkierungen können bei bestimmten Feldern weiterhin zu geringerer Konfidenz führen, und handschriftliche Randnotizen bleiben eine echte Herausforderung – aber der strukturelle Fehler, der zwei Spalten zu einem Textklumpen vermischt, ist beseitigt.
Die Einsätze sind nicht nur kosmetischer Natur. Ein Kandidat, dessen geparstes Profil den falschen Arbeitgeber zeigt oder dessen Fähigkeiten nie im durchsuchbaren Feld gelandet sind, ist ein Kandidat, der aus Ihrer Pipeline verschwindet, ohne dass jemand beschlossen hat, ihn abzulehnen. Recruiter auf r/recruiting beschreiben das als Norm, nicht als Ausnahme: „Sowohl Workday als auch Dayforce parsen Lebensläufe (und machen das furchtbar)... die Art, wie Greenhouse funktioniert, ist genau die, wie die meisten funktionieren.“ – eine Zusammenfassung eines Praktikers, der mehr als ein Dutzend ATS-Plattformen implementiert hat.
Kosten pro Lebenslauf: Preise pro Parse vs. Abonnement
Die zweite Dimension, die bei realen Einstellungsvolumina zählt, sind die Kosten – und die beiden Kategorien bepreisen sich völlig unterschiedlich.
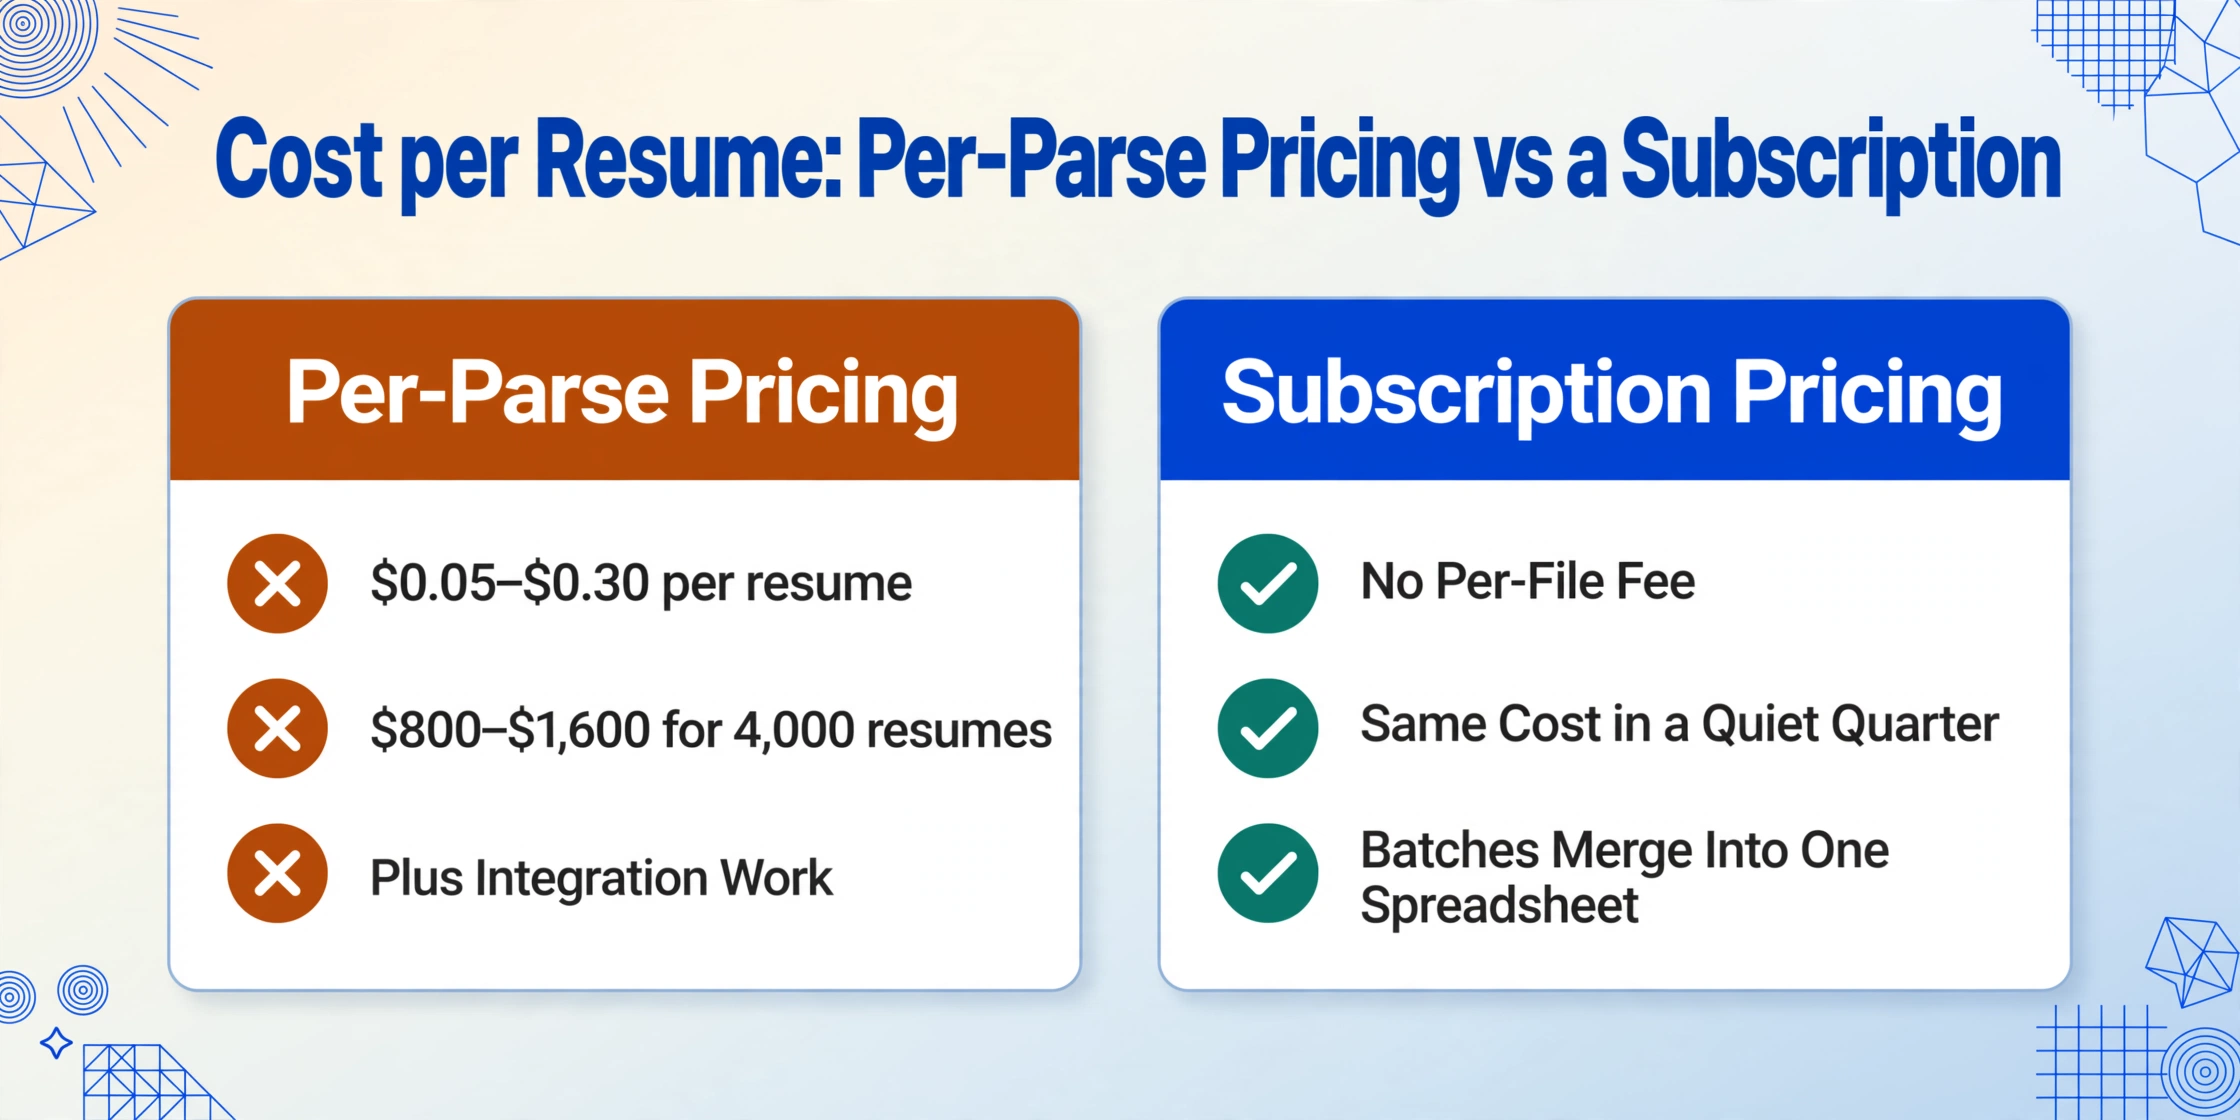
Parser-APIs berechnen pro Dokument. Branchenübliche Preise für dediziertes Lebenslauf-Parsing liegen typischerweise zwischen 0,05 und 0,30 US-Dollar pro Lebenslauf, abhängig von Volumen und Anbieter. Die veröffentlichten Preise von Affinda sind ein konkretes Beispiel: 0,20 US-Dollar pro Seite im Pay-as-you-go-Modell oder ein Jahresplan ab 3.600 US-Dollar für 66.000 Dokumente – etwa 0,055 US-Dollar pro Dokument auf dieser Stufe (Affinda Resume Parser Preise). Rechnen Sie für ein mittelgroßes Einstellungsteam, das 200 Lebensläufe pro Stelle und 20 Stellen pro Jahr verarbeitet – 4.000 Dokumente: Pay-as-you-go bei 0,20 US-Dollar pro Seite kostet 800 bis 1.600 US-Dollar, je nach Seitenzahl, und die Jahresstufe haben Sie noch nicht erreicht. Bei 66.000 Dokumenten sinkt der Preis pro Dokument, aber Sie haben sich auch auf ein Volumen festgelegt, das die meisten internen Recruiting-Teams nie erreichen werden.
KI-Extraktion auf ImageToTable.ai wird per Abonnement abgerechnet, nicht pro Datei. Sie verarbeiten so viele Lebensläufe, wie die Verarbeitungskapazität Ihres Plans zulässt – Stapel werden zu einer Tabellenkalkulation zusammengeführt, und es gibt keine Dokumentengebühr, die mit wachsendem Bewerberpool steigt. Für ein Team, das saisonal einstellt, bedeutet das: Ein ruhiges Quartal kostet genauso viel wie ein geschäftiges, statt dass Sie pro Lebenslauf abgerechnet werden, den Sie zufällig erhalten haben.
Es gibt auch versteckte Kosten, die die Preise pro Parse nicht enthalten: Integrationsaufwand. Eine Parser-API liefert strukturiertes JSON, das erst nützlich wird, wenn jemand Code schreibt, um es in Ihr ATS, Ihre Tabellenkalkulation oder Ihre Datenbank zu überführen. Für ein Recruiting-Team ohne Entwickler ist das ein unsichtbarer Posten, der die Parse-Gebühren selbst übersteigen kann.
Felder und Einrichtung: Festes Schema vs. selbst definierte Spalten
Parser-Anbieter werben mit Hunderten vorkonfigurierten Lebenslauf-Feldern, und das ist eine echte Stärke – für bestimmte Käufer. Das Schema eines Parsers ist auf Vollständigkeit ausgelegt: Es extrahiert alles, was ein Lebenslauf enthalten könnte, damit ein nachgelagertes System entscheiden kann, was wichtig ist. Wenn Sie Software entwickeln, die vielen Kunden mit unterschiedlichen Feldanforderungen dient, erspart Ihnen ein umfassendes festes Schema die eigene Felddefinition.
Für ein Einstellungsteam ist diese Vollständigkeit oft das Problem. Eine Kandidaten-Tabelle dient dem Filtern und Vergleichen, nicht der Archivierung – und 200 extrahierte Felder bedeuten 200 Spalten, die größtenteils leer sind. Semantische Extraktion kehrt den Arbeitsablauf um: Sie definieren die wenigen Spalten, die Ihre Einstellungsentscheidung tatsächlich nutzt – Name, E-Mail, Aktuelle Position, Berufsjahre, Top-Skills – und die Ausgabetabelle enthält genau diese. Sie können auch berechnete Spalten hinzufügen (die KI berechnet während der Extraktion einen Wert, z. B. „Berufsjahre", summiert aus mehreren Zeiträumen) und abgeleitete Spalten (die KI ergänzt Informationen, die nicht im Lebenslauf stehen, wie ein Quellen-Tag für die Herkunft des Kandidaten).
Der Einrichtungsaufwand folgt demselben Muster. Eine Parser-API erfordert in der Regel Kontoeinrichtung, API-Zugangsdaten, Schema-Zuordnung und Tests, bevor das erste saubere Ergebnis vorliegt. Semantische Extraktion benötigt keinen Trainings- oder Vorlagenschritt: Lebenslauf hochladen, Spalten benennen, und die erste verarbeitete Datei ist ein echtes Ergebnis. Wenn Ihr Workflow zur Lebenslauf-Datenextraktion zweispaltige PDFs, Handyfotos und gescannte Seiten im selben Stapel verarbeiten muss, ist Formatunabhängigkeit wichtiger als die Feldanzahl.
Wann eine Lebenslauf-Parser-API wirklich die richtige Wahl ist
Ein ehrlicher Vergleich muss benennen, wo die andere Seite gewinnt – und Parser-APIs gewinnen in drei konkreten Szenarien:
- Sie entwickeln ein Produkt, das Lebensläufe für viele Kunden verarbeitet. ATS-Anbieter, Jobbörsen, Personalvermittlungsplattformen und HR-Softwareunternehmen benötigen Parsing als Infrastruktur. Die Dokumentengebühr skaliert für sie in die Millionen, die JSON-Ausgabe speist ein echtes Produkt, und die Skill-Taxonomie (die „C++" und „C Plus Plus" zu einem Skill normalisiert) ist in dieser Größenordnung wirklich wertvoll. Dafür sind Affinda, Textkernel, RChilli und Daxtra gebaut – unser direkter Vergleich mit Affinda erläutert die Abgrenzung detaillierter.
- Sie benötigen 50+ Sprachen mit normalisierter Ausgabe. Anbieter von Lebenslauf-Parsern haben Jahre in mehrsprachige Normalisierung investiert. Wenn Sie über Märkte hinweg einstellen und die Skills der Kandidaten in mehreren Sprachen auf eine standardisierte Taxonomie abgebildet werden müssen, übertrifft die Sprachabdeckung einer Parser-API ein allgemeines Extraktionstool, das liest, aber nicht normalisiert.
- Sie haben Entwickler und bauen eine Pipeline. Wenn die Lebensläufe in einen automatisierten Workflow fließen – Deduplizierung, Kandidaten-Matching, Bewertung – lässt sich die JSON-Ausgabe einer Parser-API direkt einbinden. ImageToTable.ai hat für dieses Szenario ebenfalls eine v1-API, aber ein dedizierter Lebenslauf-Parser ist die ausgereifte Wahl für lebenslaufspezifische Pipelines.
Wenn keiner dieser Punkte auf Sie zutrifft, greifen die Vorteile der Parser-API meist nicht – und ihre Dokumentengebühr und der Integrationsaufwand sind reiner Overhead.
Was der integrierte Parser Ihres ATS leistet (und was nicht)
Im Vergleich gibt es eine dritte Option: den Parser, der bereits in Ihrem Greenhouse-, Workday-, Lever- oder iCIMS-Abonnement enthalten ist. Sie zahlen dafür ohnehin, die Frage ist also, ob er die Arbeit erledigt.
Der Konsens unter Praktikern besagt, dass es sich um dieselbe positionsbasierte Technologie handelt, meist in einer leichteren Version. Der oben zitierte r/recruiting-Thread bringt es auf den Punkt: "Die Funktionsweise von Greenhouse ist genau die, wie die meisten funktionieren" – der integrierte Parser füllt eine Profilseite aus einem textfreundlichen Lebenslauf, aber seine Genauigkeit bei kreativen Layouts ist nicht besser als die der eigenständigen Parser, auf denen er basiert. Einige ATS-Plattformen versuchen nicht einmal die schwierigen Fälle: Die Dokumentation zum Massenimport von Breezy HR besagt, dass hochgeladene Lebensläufe textbasierte Dokumente (DOCX, TXT, RTF, ODT oder PDF) sein müssen – "keine gescannten Kopien, Bilder oder bildbasierten PDFs" – die es rundweg ablehnt (Breezy-HR-Dokumentation). Ein Einstellungsteam, das fotografierte Lebensläufe von mobilen Bewerbern erhält – üblich bei Stunden- und Blue-Collar-Einstellungen – kann sich schlicht nicht auf diese Funktion verlassen.
Die Kosten, sich auf einen fehlerhaften ersten Schnitt zu verlassen, sind messbar und größer als ein einzelner verlorener Kandidat. Das Project on Managing the Future of Work der Harvard Business School befragte 8.720 "versteckte Arbeitskräfte" und 2.275 Führungskräfte in den USA, Großbritannien und Deutschland und fand heraus, dass mehr als 90 % der Arbeitgeber, die ein Bewerbermanagementsystem nutzen, sich darauf verließen, um den ersten Schnitt zu machen oder Bewerber zu ranken – 94 % für mittlere Qualifikationen und 92 % für hohe Qualifikationen. Doch nur jeder fünfte versteckte Arbeitskraft schaffte überhaupt den ersten Schnitt, und die durchschnittliche befragte Arbeitskraft bewarb sich über fünf Jahre auf 25 Stellen für ein einziges Angebot (HBS Working Knowledge). Wenn Parsing das Tor ist, werden Parsing-Fehler zu Einstellungsfehlern – und die HBS-Studie dokumentiert rund 27 Millionen Menschen allein in den USA, die qualifiziert, verfügbar und systematisch herausgefiltert werden.
Das ist das stärkste Argument dafür, Lebenslaufdaten außerhalb Ihres ATS zu extrahieren und saubere Zeilen zu importieren. Unsere Schritt-für-Schritt-Anleitung zur Extraktion von Lebenslaufdaten in Excel deckt die Feldliste und den vollständigen Workflow ab; die Kurzfassung ist, dass die meisten ATS-Plattformen Kandidaten-Tabellenkalkulationen über CSV importieren, sodass Sie einmal extrahieren, die Daten prüfen und eine verifizierte Datei importieren können, anstatt sich bei jeder Bewerbung auf den integrierten Parser zu verlassen.
Ein Entscheidungsrahmen für Ihren Einstellungs-Workflow
Hier ist der Vergleich, reduziert auf die Dimensionen, die Ihre Entscheidung leiten sollten – jeweils zugeordnet zu dem, was ein Einstellungsteam tatsächlich beobachtet, nicht was der Anbieter behauptet.
| Dimension | Resume-Parser-API | ATS-eingebauter Parser | KI-Extraktion (ImageToTable.ai) |
|---|---|---|---|
| Lesemethode | Positionsbasiert + NLP-Regeln | Positionsbasiert (einfacher) | Semantisch (Vision-Modell) |
| Zweispaltige / kreative Layouts | Wird durcheinandergebracht – Seitenleiste verschmilzt mit Berufserfahrung | Gleiche Einschränkung, zusätzlich werden gescannte Dateien oft abgelehnt | Liest nach Bedeutung, nicht nach Position; Seitenleiste bleibt Seitenleiste |
| Ausgabe | Strukturiertes JSON (erfordert Integrationscode) | Profilseite innerhalb des ATS | Excel / Google Sheets / CSV – eine Zeile pro Kandidat |
| Einrichtung | API-Schlüssel, Schema-Zuordnung, Entwicklerzeit | Bereits vorhanden (aber begrenzt) | Spalten benennen, hochladen, fertig |
| Kostenmodell | Pro Dokument (~$0,05–$0,30; Affinda $0,20/Seite) | Im ATS-Abonnement enthalten | Abonnement – keine Dokumentengebühr bei Volumen |
| Felder | 100–200 vorgefertigte + Skill-Taxonomie | Nur Kernprofilfelder | Genau die Spalten, die Sie definieren |
| Am besten geeignet für | Produktentwickler, mehrsprachige Pipelines | ATS-Nutzer mit Standard-Lebensläufen | Einstellungsteams, die eine filterbare Tabellenkalkulation möchten |
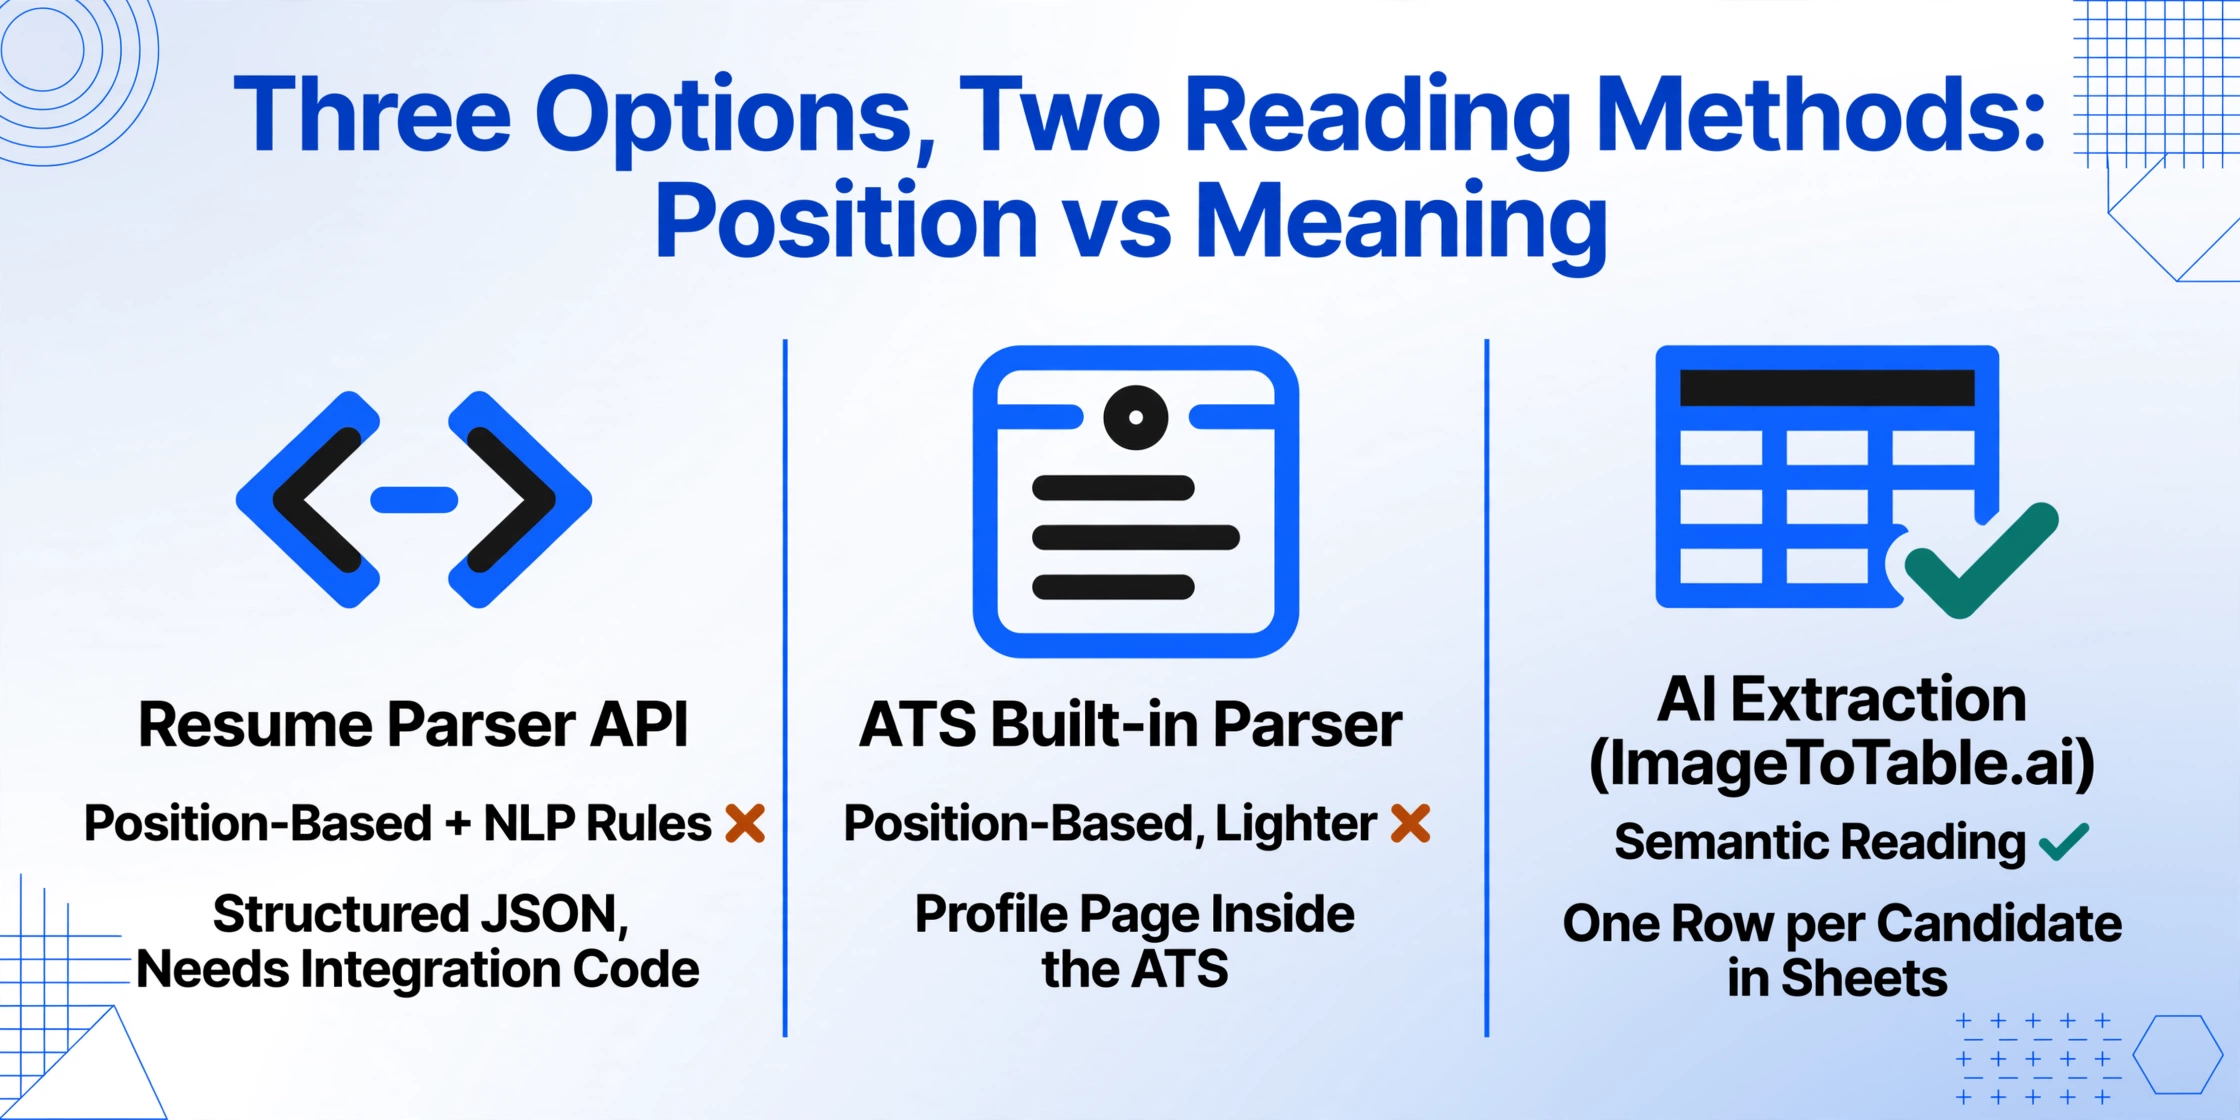
Die Entscheidungsregeln folgen direkt. Software bauen, die Lebensläufe verarbeitet → Parser-API kaufen. Standard-Lebensläufe mit einspaltigem Layout erhalten und mit Ihrer ATS-Profilseite zufrieden sein → Sie haben bereits, was Sie brauchen. Zweispaltige Layouts, Handyfotos, Scans erhalten oder einfach eine Tabellenkalkulation in Ihrer Kontrolle wollen → KI-Extraktion. Der dritte Fall trifft auf die meisten Teams zu; die Demo unten zeigt, wie der Workflow aussieht – ohne Voreinstellung, ohne Vorlage, nur Spalten, die Sie gegen die von Ihnen hochgeladenen Lebensläufe definieren.
Dateien werden sicher verarbeitet und nicht gespeichert.
So testen Sie vor dem Kauf
Anbieter auf beiden Seiten veröffentlichen Genauigkeitsangaben – „95%+" ist die gängige Zahl auf den Landingpages von Parsern, und sie wird fast immer an sauberen, einspaltigen Lebensläufen gemessen. Sie können beide Ansätze an einem Nachmittag mit zehn echten Lebensläufen überprüfen:
Sammeln Sie eine Stichprobe im schlechtesten Fall. Nehmen Sie zehn Lebensläufe aus Ihrem tatsächlichen Bewerberpool – und schließen Sie bewusst mindestens zwei zweispaltige Layouts, einen stark gestalteten oder ikonenbasierten Lebenslauf, eine gescannte Seite und ein mit dem Handy aufgenommenes Foto ein. Dies ist die Stichprobe, die den Fehlermodus bei mehrspaltigen Layouts aufdeckt. Normalisieren Sie sie also nicht.
Führen Sie sie durch das Tool. Definieren Sie für ein Extraktionstool die Spalten, nach denen Sie tatsächlich filtern würden – Name, E-Mail, Aktuelle Position, Aktuelles Unternehmen, Berufsjahre, Top-Skills – und verarbeiten Sie den Stapel. Verwenden Sie für eine Parser-API deren Teststufe und exportieren Sie das JSON.
Prüfen Sie Felder, nicht Bauchgefühl. Gehen Sie Zeile für Zeile vor und zählen Sie: Wie viele Namen, E-Mails, Positionen und Skills sind korrekt? Wie viele Kandidaten wären nicht auffindbar, weil ihre Skills im falschen Feld gelandet sind? Ein Tool, das bei zehn sauberen Lebensläufen zu 98 % genau ist und bei den zweispaltigen nur zu 60 %, besteht den einzigen Test, der für Ihre Pipeline zählt.
Berechnen Sie die tatsächlichen Kosten. Multiplizieren Sie den Preis pro Dokument mit Ihrem jährlichen Lebenslaufvolumen, addieren Sie die Einrichtungsstunden und vergleichen Sie das mit einem Abonnement. Bei einem Stapel von 200 Lebensläufen ist der Unterschied zwischen $0,20 pro Seite und einem Pauschalabonnement eine Position, die Sie tatsächlich sehen können.
Für Arbeitsabläufe mit hohem Volumen lesen Sie auch, wie die Stapelverarbeitung von Lebensläufen in eine Kandidatendatenbank Namenskollisionen, zusammengeführte Ergebnisse und die wenigen Dateien behandelt, die jedes Tool zum Scheitern bringen – diese Probleme sind unabhängig davon, welchen Parsing-Ansatz Sie wählen.
FAQ
Kann Lebenslauf-Parsing-Software zweispaltige PDF-Layouts verarbeiten?
Im Allgemeinen nein, und das ist die größte Genauigkeitslücke überhaupt. Positionsbasierte Parser lesen von oben nach unten in einem einzigen Stream, sodass ein zweispaltiges Layout mit einer Skills-Seitenleiste durcheinandergebracht wird – Seitenleisten-Skills vermischen sich mit der Berufserfahrung, was zu Geister-Arbeitgebern und falsch platzierten Feldern führt. Semantische KI-Extraktion liest nach Bedeutung statt nach Position und verarbeitet Seitenleisten- und mehrspaltige Layouts daher in den meisten Fällen korrekt, obwohl stark gestaltete, ikonenbasierte Designs bei bestimmten Feldern weiterhin zu geringerer Konfidenz führen können.
Ist KI-Extraktion so genau wie ein dedizierter Lebenslauf-Parser?
Bei standardmäßigen einspaltigen Lebensläufen sind beide Ansätze genau – Parser geben 95 %+ bei den Layouts an, für die sie gebaut wurden, und Vision-Modell-Extraktion erreicht bei gedruckten Tabellendaten bis zu 99 %. Der Unterschied zeigt sich bei kreativen Layouts: Die Parser-Genauigkeit sinkt bei mehrspaltigen und gestalteten Lebensläufen stark, während semantische Extraktion sie weiterhin korrekt liest. Der richtige Genauigkeitstest ist keine Herstellerangabe – es sind Ihre eigenen schlimmsten Lebensläufe, die durch beide laufen.
Brauche ich sowohl eine Parser-API als auch ein Extraktionstool?
Nur wenn Sie zwei verschiedene Probleme haben. Wenn Sie Software entwickeln, die Lebensläufe für viele Kunden aufnimmt, liefert Ihnen eine Parser-API das normalisierte Schema und die Sprachabdeckung, die das Produkt benötigt. Wenn Sie ein Einstellungsteam sind, das Kandidatendaten in einer Tabellenkalkulation möchte, deckt Extraktion das mit weniger Einrichtungsaufwand und ohne Dokumentengebühr ab. Die meisten internen Recruiting-Teams brauchen das Zweite, nicht das Erste.
Kann ich das ohne ATS verwenden?
Ja – die Tabellenkalkulation ist der Workflow. Extrahieren Sie Kandidatendaten in Excel mit den von Ihnen definierten Spalten, filtern und sortieren Sie in der Tabellenkalkulation und verfolgen Sie Pipeline-Phasen mit einer Statusspalte. Wenn Sie später ein ATS einführen, lässt sich dieselbe Tabellenkalkulation als CSV-Kandidatendatei importieren, sodass nichts, was Sie aufgebaut haben, verloren geht.
Was ist mit gescannten oder fotografierten Lebensläufen?
Semantische Extraktion behandelt sie als normale Eingaben, da sie Pixel und keine Textebenen liest – deshalb liest sie auch Handyfotos von Papierlebensläufen. Viele ATS-Massenimportfunktionen lehnen gescannte oder bildbasierte Dateien gänzlich ab (die Dokumentation von Breezy HR ist diesbezüglich eindeutig). Die Scanqualität ist weiterhin entscheidend: Ein klarer Scan wird sauber extrahiert, während stark unscharfe oder verzerrte Fotos Felder mit geringerer Konfidenz erzeugen, die zur Überprüfung markiert statt stillschweigend ausgefüllt werden.
Kann ich Ergebnisse in Greenhouse, Workday oder Lever importieren?
Ja. Greenhouse-Bulkimport akzeptiert bis zu 8.000 Zeilen pro Upload aus einer Tabellenkalkulation, Bullhorn nimmt 1.000 Datensätze pro Batch in CSV und Workdays EIB importiert Tabellendaten mit einem Limit von 30 MB. Da die extrahierte Datei bereits eine Zeile pro Kandidat mit einer verifizierten E-Mail-Spalte enthält, lässt sie sich sauber importieren – und Sie überspringen den integrierten Parser der jeweiligen Plattform vollständig.
Parser-APIs wurden für Unternehmen entwickelt, die Lebenslaufsoftware bauen. Wenn Sie ein Recruiting-Team sind, möchten Sie Kandidatendaten in einer Tabellenkalkulation – und der schnellste Weg herauszufinden, welcher Ansatz die tatsächlichen Layouts Ihrer Kandidaten übersteht, ist, Ihre eigenen Lebensläufe einzuspeisen.
Testen Sie es mit einem echten Lebenslauf