採用担当者向け履歴書解析とAI抽出の比較:
2カラムPDFに本当に耐えられるのはどちらか
「履歴書解析ソフトウェア」と「AI抽出」を並べて比較する場合、まず気づくのは、どちらも履歴書を読み取ると主張し、どちらも正確だと主張していることです。検索結果も役に立ちません。このクエリに関する記事のほとんどは、パーサーベンダーが書いたツールリストで、比較はたいてい「こちらは200フィールド、あちらは100フィールド」で終わっています。採用担当者が実際に知る必要があること、つまり、候補者が送り続ける2カラムPDFにどちらのアプローチが耐えられるのか、実際の採用ボリュームでどちらがコストが低いのかは、ほとんど取り上げられていません。
重要なポイント
- すべての履歴書パーサーとAI抽出ツールが約95%の精度を主張しています。数値が近すぎて、選択が際どい違いのように感じられます。
- その数値は、単一カラムでテキスト中心の履歴書で測定されています。候補者は2カラムレイアウトを送り続けており、位置ベースのパーサーはそれらを乱します。スキルサイドバーが職歴に統合され、幽霊の勤務先と失われた検索ヒットを生み出します。
- ノイズを断ち切る質問が1つあります:ツールは位置で読むのか、意味で読むのか? その答えが、Canvaテンプレートの候補者が検索可能なフィールドに表示されるかどうかを決定します。
すべてのパーサー検索の背後にある問い
「履歴書解析 vs AI抽出」を検索する場合、通常は2つのケースがあります。採用担当者や人事リーダーが解析技術を導入するかどうかを判断しようとしているか、製品に組み込むパーサーAPIを評価している開発者かです。この記事は前者のグループ向けに書かれており、最初に立場を明らかにします。これは解析インフラを販売するソフトウェア会社の視点ではなく、候補者データをスプレッドシートで欲しい採用チームの視点から書かれています。ATS、求人ボード、人事製品を構築している場合は、パーサーAPIが本当に勝るセクションにスキップしてください。それが購入する正直な理由です。
それ以外の皆さんにとって、意思決定の枠組みは3つの質問に集約されます。実際にどのような文書を入力するのか?必要な出力は何か?そして、そのボリュームでの各オプションのコストは? 残りは詳細です。
ほとんどの「履歴書解析 vs AI」比較は、何かを販売している側によって書かれています。これは採用チームが実際に必要とするものから始まります。正確で、ボリューム時に安価で、実際の候補者が使うレイアウトで崩れない候補者スプレッドシートです。
履歴書解析ソフトウェアが実際に行うこと
履歴書解析ソフトウェアは、履歴書文書を構造化された候補者データ(氏名、メールアドレス、電話番号、職歴、学歴、スキル)に変換します。文書の内容を固定の事前構築された履歴書スキーマにマッピングします。中核技術は、スキャンや画像からテキストを抽出するOCR(光学文字認識)、そしてそのテキストを「勤務先」や「職種」などのフィールドに分類するNLP(自然言語処理)ルールです。これはTextkernel(Sovren)、RChilli、Daxtra、Affinda、HireAbilityなどのベンダーからAPIとして購入でき、またはほとんどのATSプラットフォーム(Greenhouse、Workday、Lever、iCIMS)にアップロードされたファイルから候補者プロフィールを「自動入力」する機能としてバンドルされています。
ほとんどの履歴書パーサーの特徴は、位置ベースであることです。連絡先情報が上部、職歴が中央、学歴が下部にあることを想定し、テキストを固定順序(通常は上から下、左から右の単一ストリーム)で読み取ります。履歴書がその想定レイアウトに一致する場合、パーサーは高速でかなり正確です。一致しない場合、出力品質は急激に低下します。なぜなら、パーサーには左側のスキルサイドバーと右側の職歴カラムが異なる意味的領域であることを理解する仕組みがないからです。
AIデータ抽出が実際に行うこと
AIデータ抽出は、画像理解を支えるのと同じクラスのAIである視覚大規模モデルに基づく新しいカテゴリです。テキストを固定の履歴書スキーマに位置でマッピングする代わりに、人間と同じようにドキュメントを読み取ります。「Education」がセクションであること、「Skills」とラベル付けされたサイドバーにスキルが含まれていること、履歴書の写真も単なる別の形式であることを理解します。ImageToTable.aiはこの意味的読み取りのパラダイムに基づいて構築されており、これをカスタム列抽出と呼びます。「候補者名」「メールアドレス」「主要スキル」「経験年数」など、必要なフィールド名を入力すると、AIはフィールドが何を意味するかを理解して、ページ上のどこでも各値を特定します。入力した列名が出力スプレッドシートのヘッダーになります。
この設計からは、2つの実用的な違いが生まれます。第一に、出力はスプレッドシートネイティブです。候補者ごとに1行のExcelまたはGoogle スプレッドシートのテーブルが得られ、すぐにフィルタリングや並べ替えができます。統合コードなしでは使えないJSONオブジェクトではありません。第二に、更新すべき履歴書固有のスキーマがありません。抽出は定義した列によって駆動されるため、履歴書を抽出するのと同じツールで、再設定なしにオファーレター、入社フォーム、雇用契約書を抽出できます。
本当の違いは、マーケティング上のカテゴリとしての「パーサー vs AI」ではありません。位置ベースの読み取り(テキストがページ上のどこにあるかで分類される)と意味的読み取り(テキストが何を意味するかで分類される)の違いです。この記事の他のすべて—クリエイティブなレイアウトでの精度、セットアップの手間、コストモデル—は、この単一の違いから生じます。これはまた、評価するドキュメントパーサーで、仕様書のフィールド数を見る前に確認すべき最初の点でもあります。
マルチカラムPDFテスト
2つのアプローチをどのベンチマークよりも明確に分ける履歴書フォーマットが1つあります。それは、スキルサイドバー付きの2カラムレイアウトです。これはどこにでもあります—デザイナー、マーケター、プロダクトマネージャー、そして最新の履歴書テンプレートを使うほとんどの人がこの形式を生み出します—そして、これはまさに位置ベースのパーサーが最も苦手とするレイアウトです。
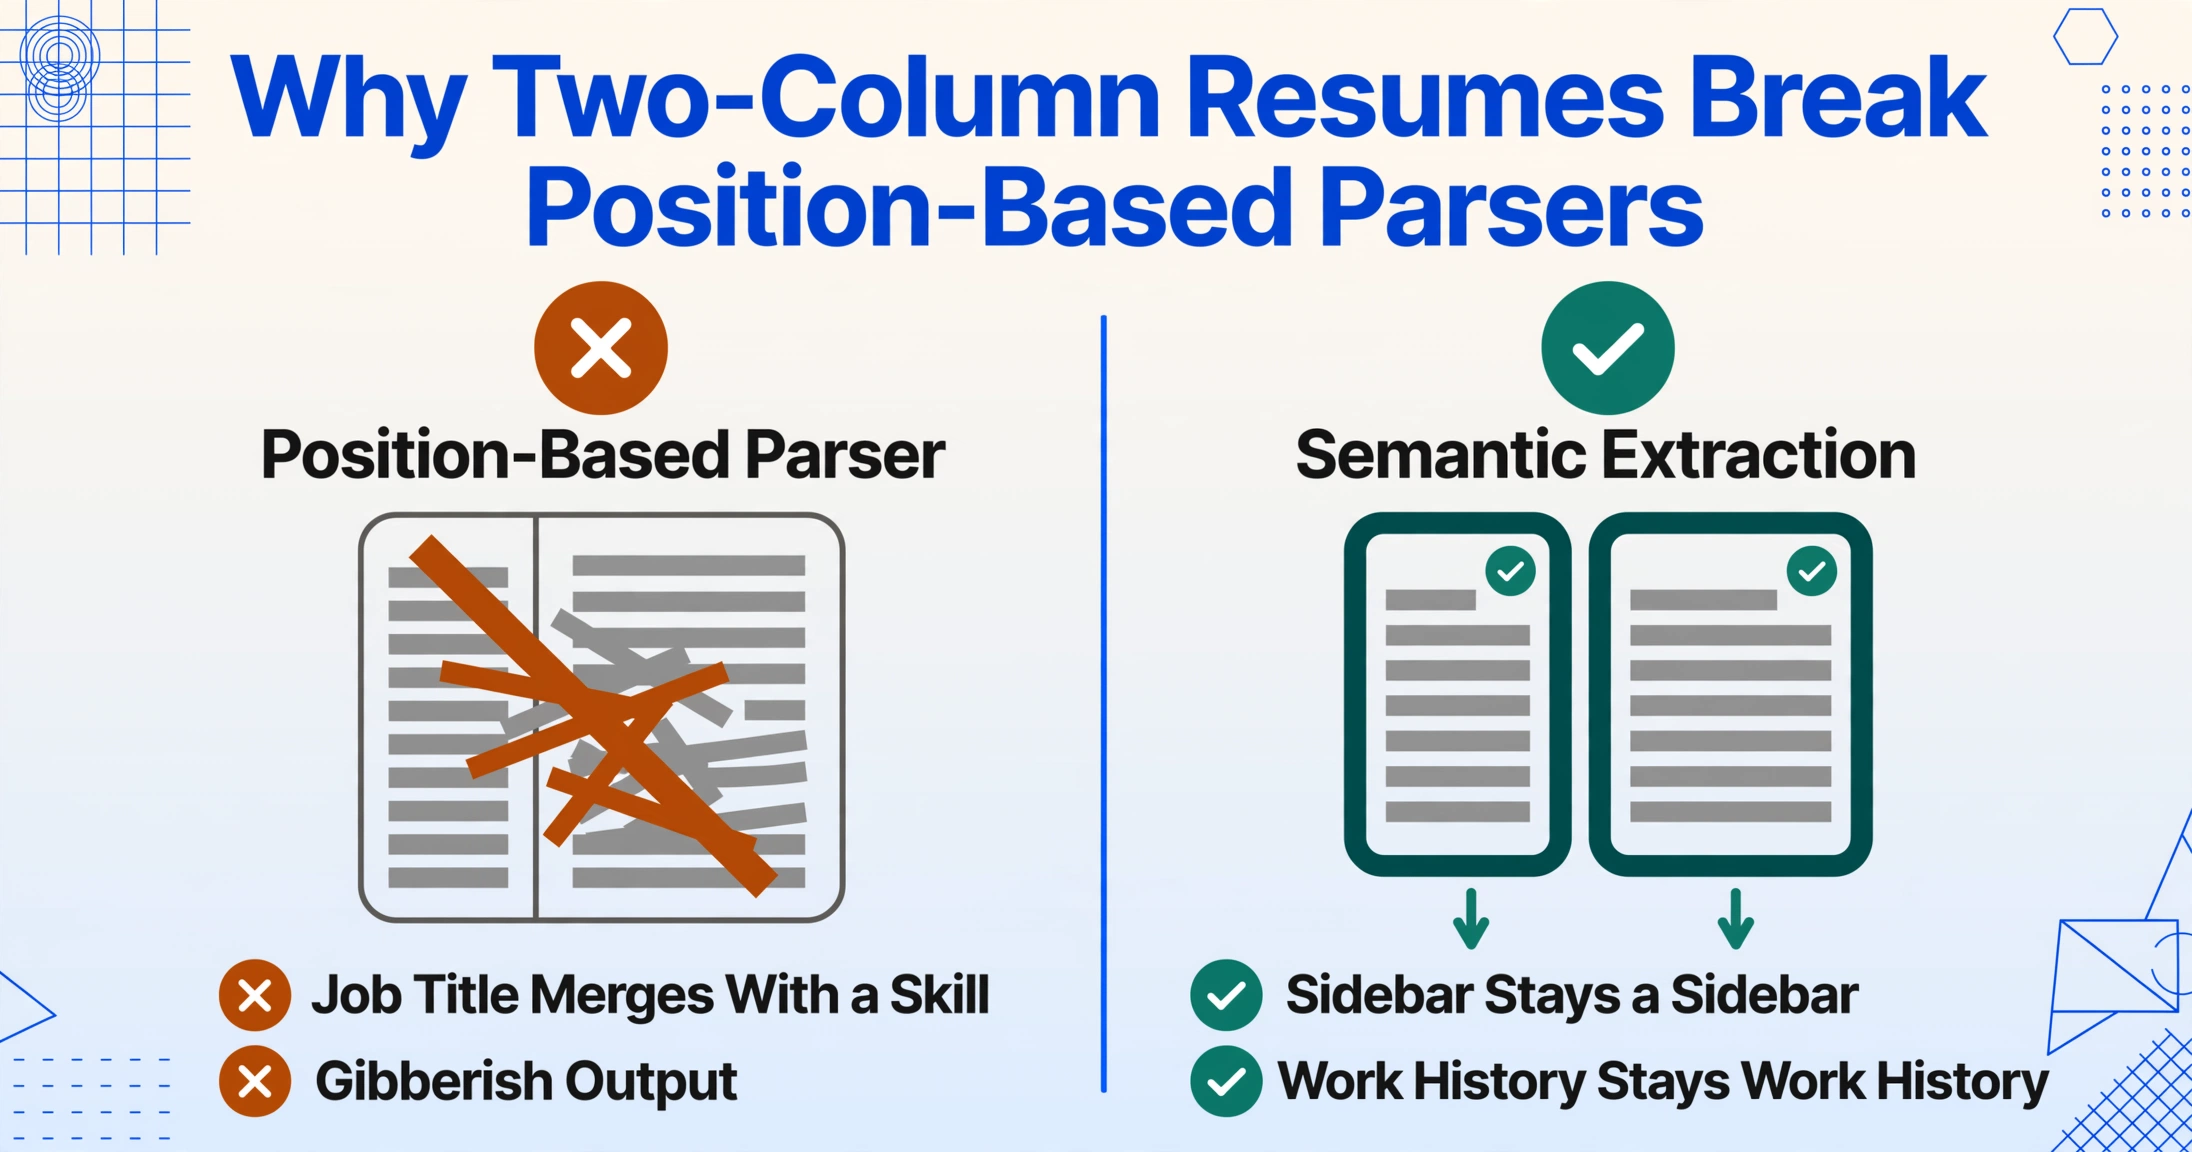
8か月にわたって実際のATSプラットフォームを数千種類の履歴書バリエーションでテストした開発者が、その障害モードを内部から記録しています:「2カラムレイアウト。ATSは上から下へ単一のストリームで読み取ります。2カラムは混ざってしまいます——カラムAの職種がカラムBのスキルと結合される。受け取り側では意味不明な文字列になります」(r/jobsearchhacks)。Workdayのパーサーをリバースエンジニアリングした別の実務者も同じメカニズムを報告しています:「マルチカラムレイアウトはパーサーを壊します。両方のカラムを同時に左から右へ読み取ります。『スキル』と『職歴』のセクションが意味不明な文字列に統合されてしまいます」(r/jobsearchhacks)。r/resumesコミュニティも求職者側から同じ結論に達しています:「多くのATSはカラム、表、テキストボックス、凝ったデザインのレイアウトを処理するのに苦労します」(r/resumes)。
意味的抽出にはこの障害モードがありません。なぜなら、読み取り順序に依存しないからです。スキルサイドバーは、ページのどちら側にあっても「スキル」セクションとして認識されます。職歴カラムは雇用履歴として読み取られます。これはAI抽出があらゆるレイアウトで完璧であることを意味するわけではありません——アイコンを使ったセクションマーカーを持つ凝ったデザインのグラフィックデザイナー向け履歴書では、特定のフィールドで信頼度が低くなることがあり、手書きの欄外メモは依然として大きな課題です——しかし、2カラムを1つのテキストブロックに混ぜてしまう構造的な障害は排除されます。
この問題は見た目だけの問題ではありません。解析されたプロフィールに誤った勤務先が表示された候補者、またはスキルが検索可能なフィールドに反映されなかった候補者は、誰も不採用を決定していないのにパイプラインから消えてしまう候補者です。r/recruitingの採用担当者はこれを例外ではなく標準として説明しています:「WorkdayもDayforceも履歴書を解析します(そしてひどい仕事をします)……Greenhouseの仕組みは、ほとんどのATSの仕組みとまったく同じです」——これは12以上のATSプラットフォームを実装した実務者による要約です。
履歴書1件あたりのコスト:解析ごとの料金とサブスクリプションの比較
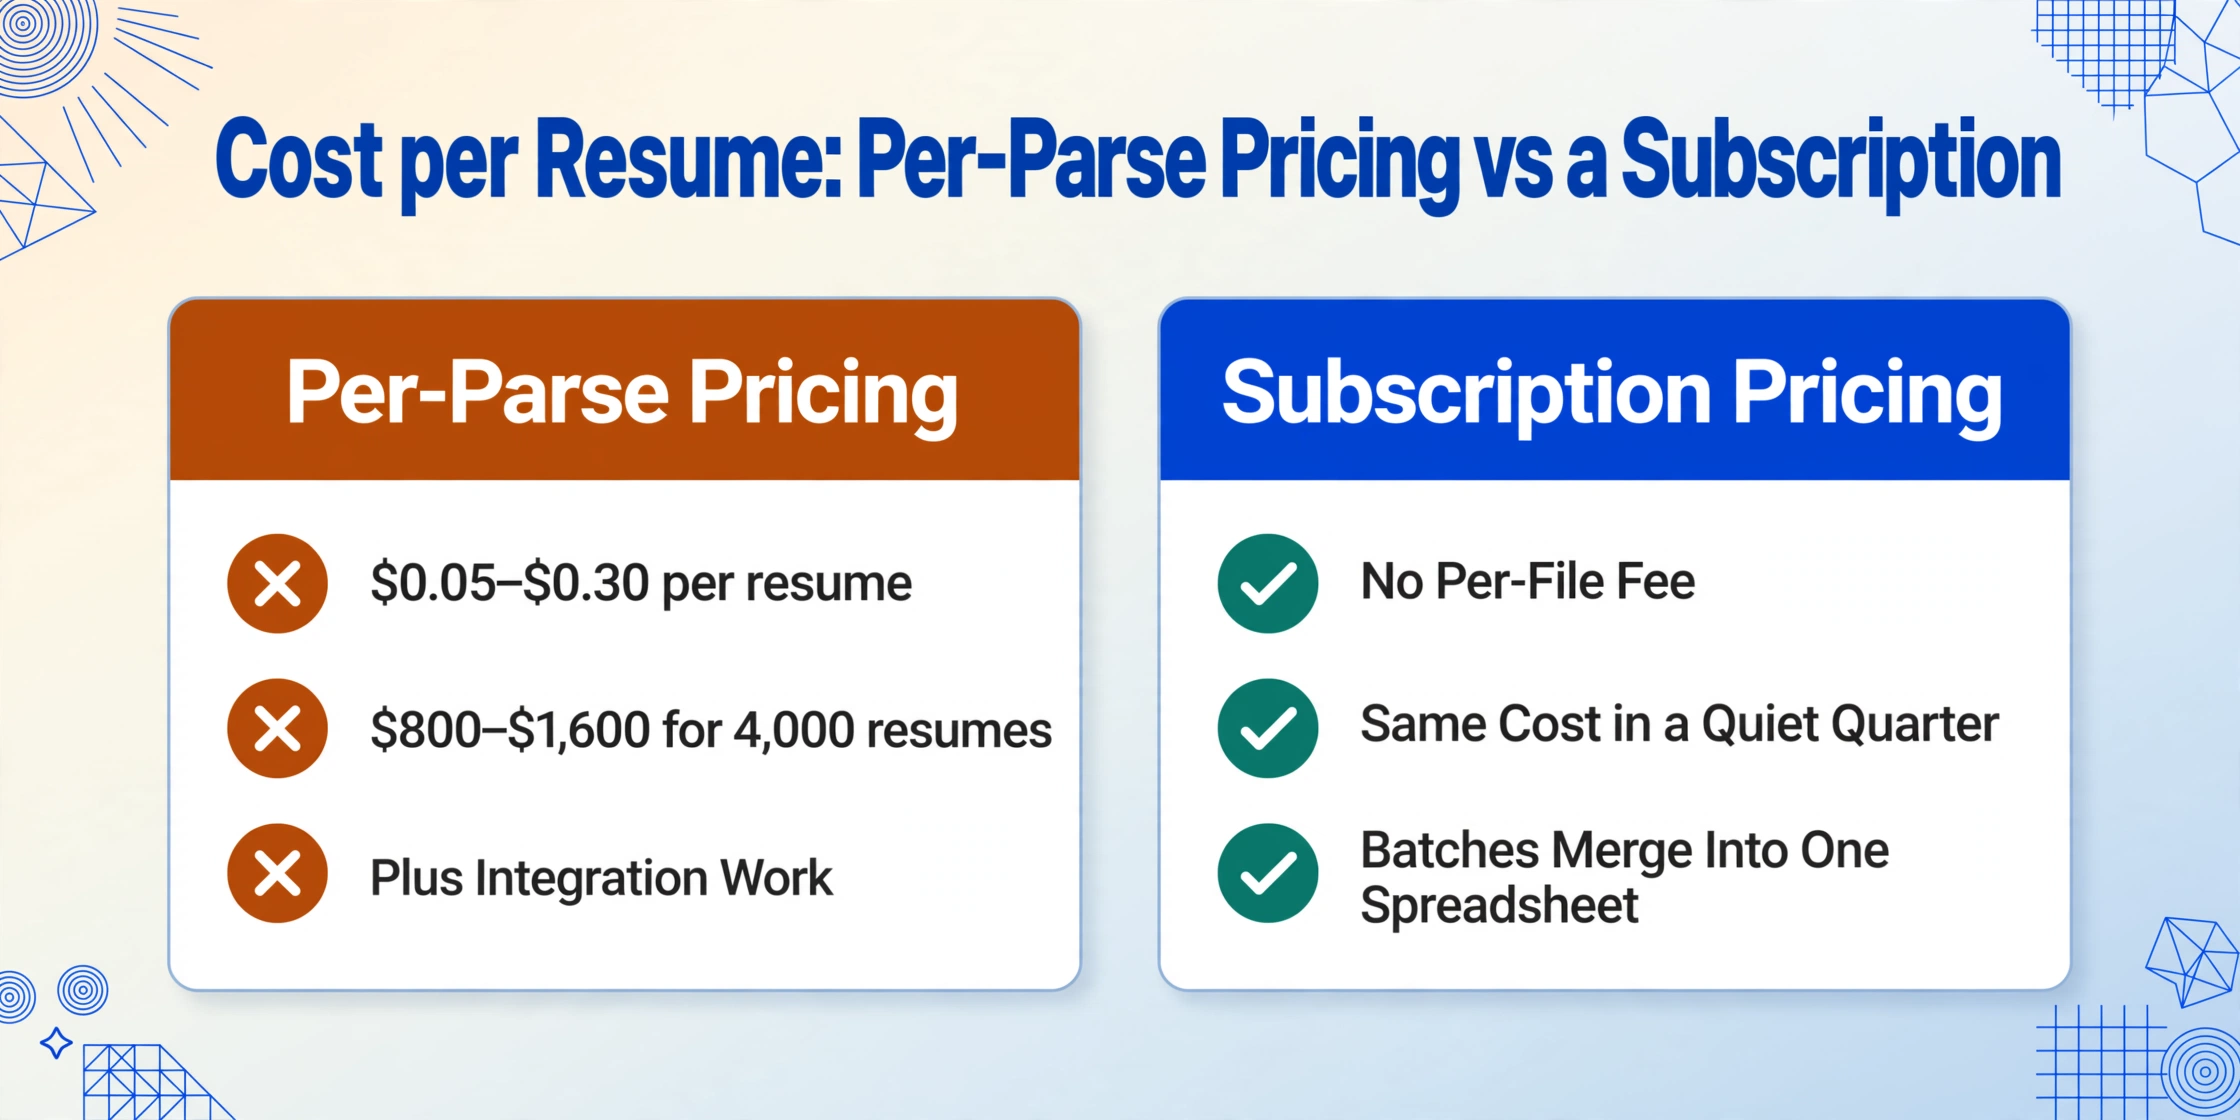
実際の採用規模で重要になる2つ目の要素はコストです。この2つのカテゴリは、価格設定の方法がまったく異なります。
パーサーAPIはドキュメント単位で課金されます。専用の履歴書解析の業界料金は、通常、ボリュームとベンダーに応じて履歴書1件あたり0.05〜0.30ドルです。Affindaの公開価格は具体的な例です。従量課金で1ページあたりUS$0.20、または66,000ドキュメントで年間US$3,600の年間プラン(そのティアでは1ドキュメントあたり約0.055ドル)です(Affinda Resume Parserの価格)。中規模の採用チームが年間20のポジションで各ポジションにつき200件の履歴書を処理する場合、つまり4,000ドキュメントの場合を計算してみましょう。従量課金で1ページあたり0.20ドルだと、ページ数に応じて800〜1,600ドルになりますが、まだ年間プランには手が届きません。66,000ドキュメントではドキュメントあたりの価格は下がりますが、社内の採用チームのほとんどが到達しないボリュームにコミットすることになります。
ImageToTable.aiのAI抽出は、ファイルごとではなくサブスクリプションで課金されます。プランの処理容量の範囲内で、履歴書を何件でも処理できます。バッチは1つのスプレッドシートに統合され、応募者プールが増えてもドキュメントごとの料金が上がることはありません。季節採用のチームにとっては、閑散期も繁忙期も同じコストで済み、受け取った履歴書ごとに請求されることはありません。
また、解析ごとの料金には含まれない隠れたコストもあります。統合作業です。パーサーAPIは構造化されたJSONを返しますが、それは誰かがコードを書いてATS、スプレッドシート、またはデータベースにマッピングして初めて役立ちます。開発者がいない採用チームにとって、これは目に見えない項目であり、解析料金自体を超える可能性があります。
フィールドとセットアップ: 固定スキーマと、自分で定義するカラム
パーサーベンダーは、何百ものプリマップ済みの履歴書フィールドを宣伝していますが、それは確かに強みです — 特定の購入者にとっては。パーサーのスキーマは完全性を目的に設計されています。履歴書に含まれる可能性のあるすべてを抽出し、下流のシステムが何が重要かを判断できるようにします。多くのクライアントに異なるフィールドニーズでソフトウェアを提供する場合、包括的な固定スキーマは、自分でフィールドを定義する手間を省きます。
採用チームにとっては、その完全性がしばしば問題となります。候補者スプレッドシートはフィルタリングと比較のためのものであり、アーカイブ用ではありません。200のフィールドを抽出することは、ほとんどが空の200カラムのスプレッドシートを意味します。意味的抽出はワークフローを逆転させます。採用判断に実際に使用する少数のカラム(氏名、メールアドレス、現職、経験年数、主要スキル)を定義すると、出力テーブルには正確にそれらだけが含まれます。計算列(AIが抽出中に値を計算、例:「経験年数」を複数の期間から合算)や推論列(AIが履歴書に印刷されていない情報を補完、例:候補者の出身元を示すソースタグ)を追加することもできます。
セットアップの労力も同様のパターンです。パーサーAPIは通常、アカウントのプロビジョニング、API認証情報、スキーママッピング、そして最初のクリーンな結果を得るまでのテストが必要です。意味的抽出にはトレーニングやテンプレートのステップはありません。履歴書をアップロードし、カラムに名前を付け、最初に処理するファイルがそのまま実際の結果です。履歴書データ抽出ワークフローで2カラムPDF、電話の写真、スキャン済みページを同じバッチで処理する必要がある場合、フォーマット非依存性はフィールド数よりも重要です。
履歴書パーサーAPIが本当に適切な選択となる場合
公正な比較には、相手側が勝つ状況も述べるべきです。パーサーAPIは、次の3つの具体的なシナリオで勝ります。
- 多くの顧客向けに履歴書を取り込むプロダクトを構築している場合。ATSベンダー、求人ボード、採用プラットフォーム、HRソフトウェア企業は、パースをインフラとして必要としています。彼らにとって文書単位のコストは数百万規模に拡大し、JSON出力は実際のプロダクトに供給され、スキルタクソノミー(「C++」と「C Plus Plus」を1つのスキルに正規化)はその規模で真に価値があります。これこそがAffinda、Textkernel、RChilli、Daxtraが構築されている目的です。当社のAffindaとの直接比較で、その境界線をより詳しく説明しています。
- 50以上の言語で正規化された出力が必要な場合。履歴書パースベンダーは、多言語正規化に長年投資してきました。候補者のスキルを複数言語の標準化されたタクソノミーにマッピングする必要がある市場で採用を行う場合、パーサーAPIの言語カバレッジは、読み取るだけで正規化しない一般的な抽出ツールよりも優れています。
- 開発者がいて、パイプラインを構築している場合。履歴書が自動化されたワークフロー(重複排除、候補者マッチング、スコアリング)に流れ込む場合、パーサーAPIのJSON出力は直接プラグインできます。ImageToTable.aiにもこのシナリオ向けのv1 APIがありますが、履歴書特化のパイプラインには専用の履歴書パーサーが成熟した選択肢です。
上記のいずれにも該当しない場合、パーサーAPIの利点はほとんど当てはまらず、文書単位のコストと統合の負担は純粋なオーバーヘッドになります。
ATS標準搭載パーサーが実際にやっていること・やっていないこと
比較の中に隠れた第三の選択肢があります。それは、Greenhouse、Workday、Lever、iCIMSのサブスクリプションにすでにバンドルされているパーサーです。どちらにせよ費用は支払っているので、問題はそれが仕事を果たすかどうかです。
実務者の間では、これも同じ位置ベースの技術であり、通常はその軽量版であるというのが一致した見解です。前述のr/recruitingスレッドは率直に述べています:「Greenhouseの仕組みは、ほとんどのATSが同じように動く方法だ」 — 標準搭載パーサーはテキスト対応の履歴書からプロフィールページを埋めますが、クリエイティブなレイアウトでの精度は、その基になっているスタンドアロンパーサーと変わりません。一部のATSプラットフォームは難しいケースにさえ挑戦しません:Breezy HRの一括インポートドキュメントには、アップロードされた履歴書はテキストベースのドキュメント(DOCX、TXT、RTF、ODT、PDF)でなければならず、「スキャンコピー、画像、画像ベースのPDFは不可」と明記されており、これらは即座に拒否されます(Breezy HRドキュメント)。モバイル応募者から写真撮影された履歴書を受け取る採用チーム — 時間給・ブルーカラー採用では一般的 — は、その機能に頼ることができません。
不完全な一次選考に依存するコストは測定可能で、一人の候補者を失うよりも大きいものです。ハーバード・ビジネス・スクールの「未来の仕事の管理プロジェクト」は、米国・英国・ドイツの8,720人の「隠れた労働者」と2,275人の経営幹部を調査し、採用管理システムを利用する雇用主の90%以上が、一次選考や候補者のランク付けにそれを依存していることを明らかにしました — 中スキル職では94%、高スキル職では92%です。しかし、隠れた労働者の5人に1人しか一次選考を通過せず、調査対象の労働者は平均して5年間で25件の求人に応募して1件のオファーを得ています(HBS Working Knowledge)。パーシングがゲートとなっている場合、パーシングエラーは採用エラーになります — そしてHBSの調査は、米国だけで約2,700万人が資格があり、利用可能でありながら、体系的に除外されていることを記録しています。
これが、ATSの外部で履歴書データを抽出し、クリーンな行をインポートする最も強い根拠です。当社の履歴書データをExcelに抽出するステップバイステップガイドでは、フィールドリストと完全なワークフローを説明しています。要約すると、ほとんどのATSプラットフォームはCSV経由で候補者スプレッドシートをインポートするため、一度抽出してデータを確認し、検証済みファイルをインポートできます。すべての応募で標準搭載パーサーを信頼する必要はありません。
採用ワークフローのための判断フレームワーク
ここでは、比較を意思決定を左右する観点に絞ってまとめました。各項目は、ベンダーの主張ではなく、採用チームが実際に目にする事象に対応しています。
| 観点 | 履歴書解析API | ATS内蔵パーサー | AI抽出 (ImageToTable.ai) |
|---|---|---|---|
| 読み取り方法 | 位置ベース + NLPルール | 位置ベース(軽量) | 意味的読み取り(視覚モデル) |
| 2カラム / クリエイティブなレイアウト | 崩れる — サイドバーが職歴に混ざる | 同様の制限に加え、スキャン文書は拒否されることが多い | 位置ではなく意味で読み取るため、サイドバーはサイドバーのまま |
| 出力 | 構造化JSON(統合コードが必要) | ATS内のプロフィールページ | Excel / Google スプレッドシート / CSV — 候補者1名につき1行 |
| セットアップ | APIキー、スキーママッピング、開発者の工数 | 既に利用可能(ただし制限あり) | カラムを定義してアップロードするだけ |
| コストモデル | 文書単位(約$0.05〜$0.30、Affindaは$0.20/ページ) | ATSサブスクリプションに含まれる | サブスクリプション — 大量利用時のファイル単位料金なし |
| フィールド | 100〜200のプリマッピング + スキル分類 | コアプロフィールフィールドのみ | 定義したカラムのみ |
| 最適な用途 | プロダクト開発者、多言語パイプライン | 標準的な履歴書を扱うATSユーザー | フィルタリング可能なスプレッドシートを求める採用チーム |
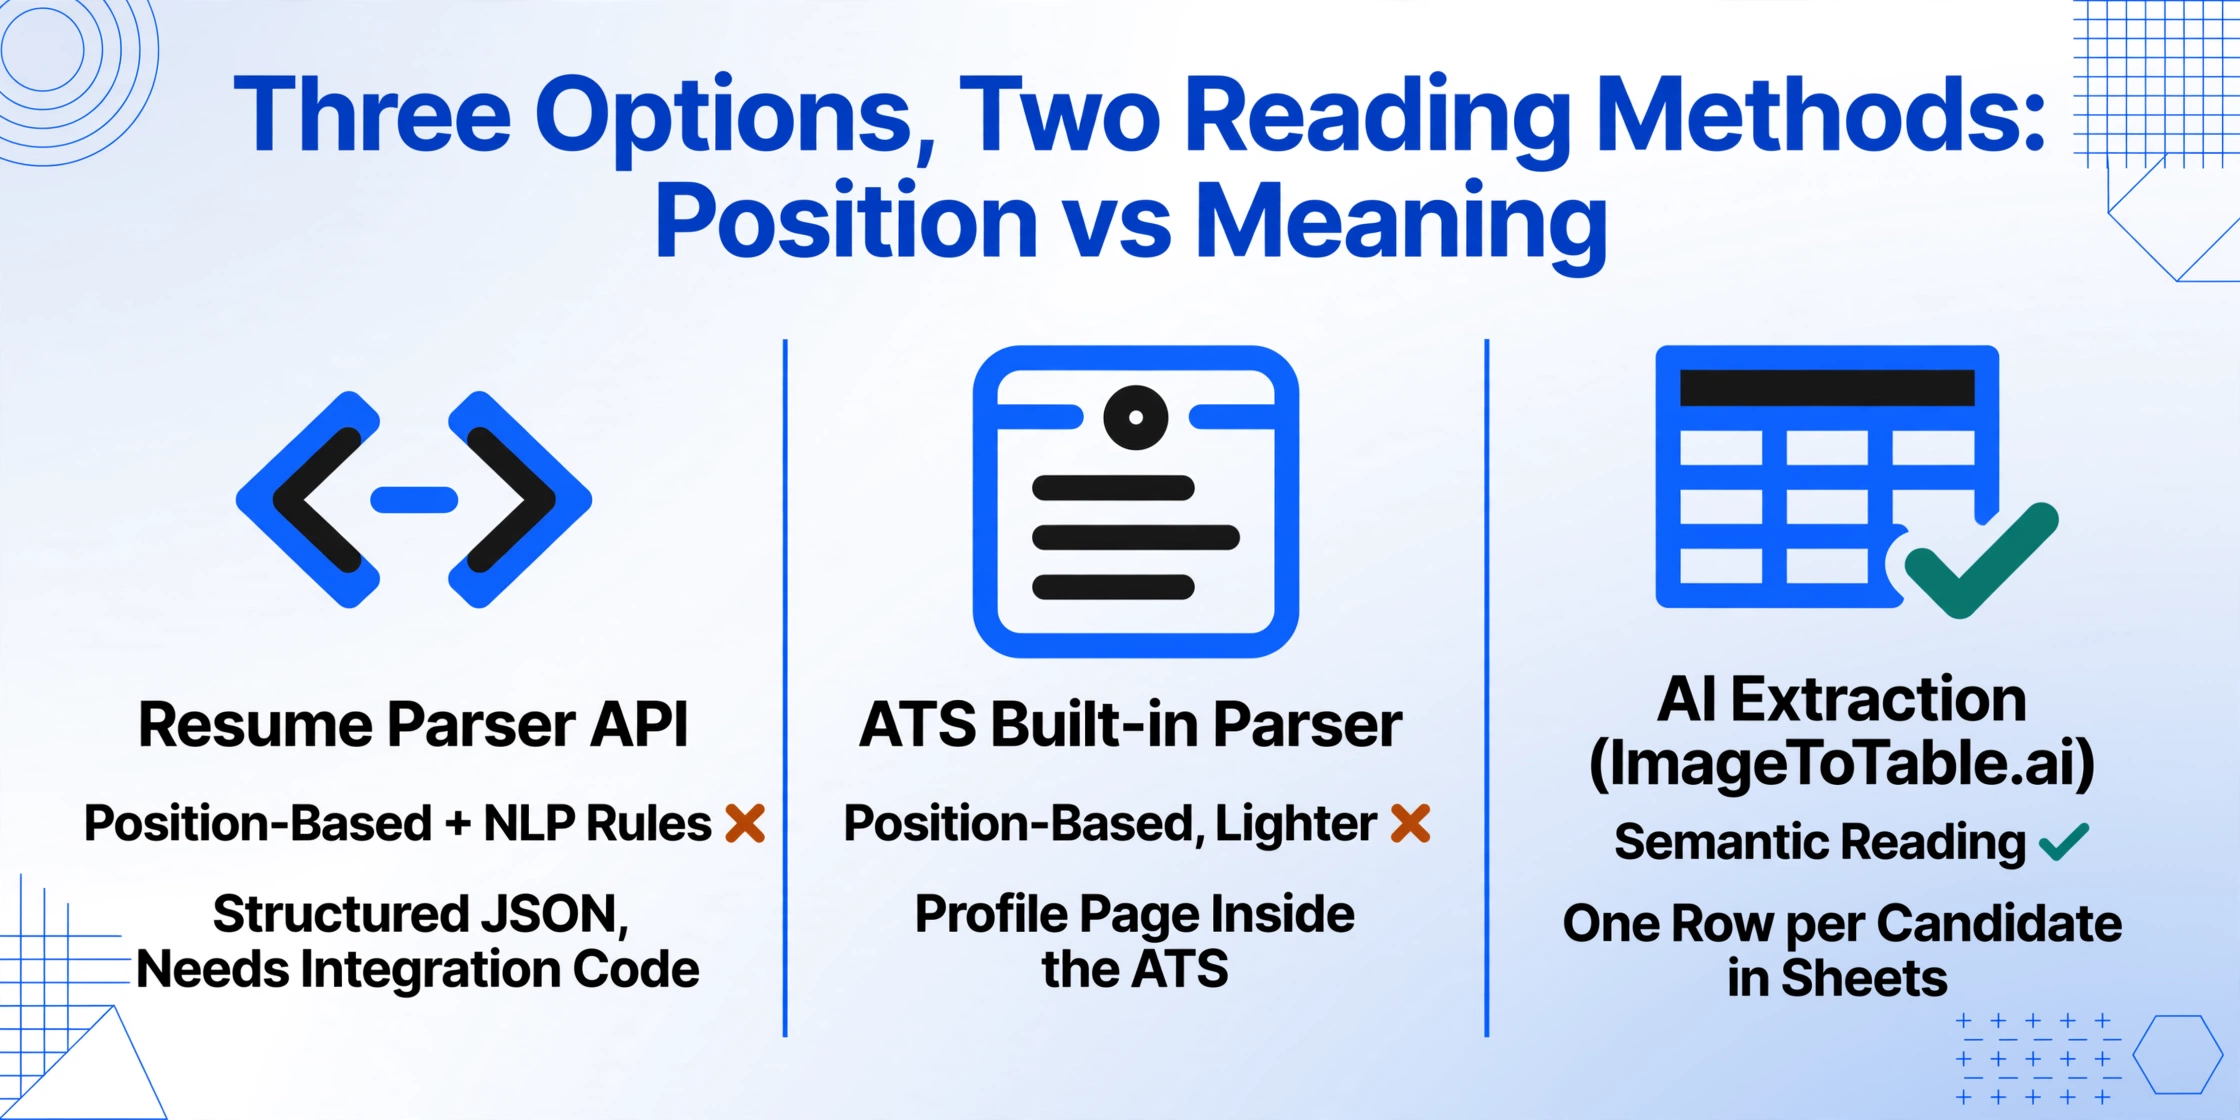
判断ルールは以下の通りです。 履歴書を取り込むソフトウェアを開発している場合 → パーサーAPIを購入。 標準的な単一カラムの履歴書を受け取っており、ATSのプロフィールページに満足している場合 → 既に必要なものは揃っています。 2カラムレイアウト、スマホ写真、スキャン文書を受け取る場合、または自分で管理できるスプレッドシートを単に希望する場合 → AI抽出。 3つ目のケースがほとんどのチームに当てはまります。以下のデモは、そのワークフローがどのようなものかを示しています。プリセットもテンプレートもなく、アップロードする履歴書に対して自分で定義したカラムだけです。
ファイルは安全に処理され、保存されることはありません。
購入前のテスト方法
どちらのベンダーも精度を公表しています。パーサーのランディングページでは「95%以上」が一般的な数字ですが、これはほぼ常にクリーンな単一カラムの履歴書で測定されたものです。実際の履歴書10枚を使えば、どちらのアプローチも半日で検証できます。
最悪ケースのサンプルを集める。 実際の応募者プールから履歴書を10枚用意し、2カラムレイアウトのものを少なくとも2枚、デザイン性が高いものやアイコンを使ったもの、スキャンしたページ、スマホで撮影した写真を各1枚は意図的に含めます。これこそがマルチカラムの失敗モードを露呈させるサンプルなので、正規化してはいけません。
ツールに通す。 抽出ツールの場合、実際にスクリーニングで使うカラム(氏名、メールアドレス、現職、現職企業、経験年数、主要スキル)を定義し、バッチを処理します。パーサーAPIの場合は、トライアル枠を使いJSONをエクスポートします。
フィールドを検証する(雰囲気ではなく)。 行ごとに、氏名・メールアドレス・職種・スキルのうち正しいものがいくつあるかを数えます。スキルが誤ったフィールドに入ってしまったために検索不可能になる候補者は何人いるでしょうか?クリーンな履歴書10枚では98%の精度でも、2カラムのものでは60%に落ちるツールは、パイプラインにとって重要な唯一のテストに不合格です。
実際のコストを合計する。 文書単位料金に年間の履歴書処理量を掛け、セットアップ時間を加え、サブスクリプションと比較します。履歴書200枚のバッチでは、1ページあたり$0.20と定額サブスクリプションの差は、実際に目に見える項目です。
大量処理のワークフローでは、候補者データベースへのバッチ履歴書処理がネーミングの衝突、マージ結果、どのツールでも壊れてしまう少数のファイルをどのように扱うかもご覧ください。これらの問題は、選択したパース手法にかかわらず同じです。
FAQ
履歴書解析ソフトウェアは2カラムのPDFレイアウトを処理できますか?
一般的にはできません。これが最大の精度ギャップです。位置ベースのパーサーは単一の流れで上から下へ読み取るため、スキルサイドバー付きの2カラムレイアウトは乱れます。サイドバーのスキルが職歴に混ざり、存在しない勤務先や誤ったフィールドが生じます。意味的読み取りによるAI抽出は位置ではなく意味で読み取るため、サイドバーやマルチカラムのレイアウトをほとんどの場合正しく処理します。ただし、アイコンを多用した凝ったデザインでは、特定のフィールドの信頼度が低くなることがあります。
AI抽出は専用の履歴書パーサーと同じくらい正確ですか?
標準的なシングルカラムの履歴書では、どちらのアプローチも正確です。パーサーは対応するレイアウトで95%以上の精度を謳い、視覚モデルによる抽出は印刷された表データで最大99%の精度を記録しています。差が出るのはクリエイティブなレイアウトです。パーサーの精度はマルチカラムやデザイン性の高い履歴書で急落しますが、意味的抽出は正しく読み取り続けます。正しい精度テストはベンダーの主張ではなく、両方で実行した自社の最悪のケースの履歴書です。
パーサーAPIと抽出ツールの両方が必要ですか?
異なる2つの問題がある場合のみです。多くの顧客の履歴書を取り込むソフトウェアを構築しているなら、パーサーAPIはその製品に必要な正規化されたスキーマと言語カバレッジを提供します。候補者データをスプレッドシートで欲しい採用チームなら、抽出で十分であり、セットアップも少なく、文書単位料金もかかりません。社内の採用チームのほとんどが必要なのは後者であり、前者ではありません。
ATSなしでこれを使用できますか?
はい。スプレッドシートがワークフローです。定義したカラムで候補者データをExcelに抽出し、スプレッドシートでフィルタリングと並べ替えを行い、ステータスカラムでパイプラインの段階を追跡します。ATSを導入する際も、同じスプレッドシートがCSV候補者ファイルとしてインポートされるため、構築したものが無駄になることはありません。
スキャンまたは写真撮影された履歴書はどうなりますか?
意味的抽出は、ピクセルを読み取るため、テキストレイヤーではなく、通常の入力として処理します。そのため、紙の履歴書のスマホ写真も読み取れます。多くのATSの一括インポート機能は、スキャンや画像ベースのファイルを完全に拒否します(Breezy HRのドキュメントにも明記されています)。スキャン品質は依然として重要です。鮮明なスキャンはきれいに抽出されますが、ぼやけたり傾いた写真は、信頼性の低いフィールドを生成し、静かに自動入力されるのではなく、レビュー用にフラグが立てられます。
Greenhouse、Workday、Leverに結果をインポートできますか?
はい。Greenhouseの一括インポートは、スプレッドシートからアップロードあたり最大8,000行を受け付け、BullhornはCSVでバッチあたり1,000レコードを受け付け、WorkdayのEIBは30MBの上限でスプレッドシートデータをインポートします。抽出されたファイルには、検証済みのメールアドレス列を持つ候補者ごとの行がすでに含まれているため、クリーンにインポートされ、各プラットフォームの組み込みパーサーを完全にスキップできます。
パーサーAPIは、履歴書ソフトウェアを構築する企業向けに設計されています。採用チームであれば、候補者データをスプレッドシートで欲しいはずです。そして、どのアプローチが候補者の実際のレイアウトに耐えられるかを知る最速の方法は、自分の履歴書をフィードすることです。
実際の履歴書でテストする