採用活動向けに履歴書データをExcelへ抽出する方法
(2026年版ガイド)
多くの採用担当者が抱える問題は、履歴書の解析ではなく、スプレッドシートの整理です。求人ボード、メール添付、社内紹介から数十件のPDFが受信ボックスに届いた後、誰かがそれらの履歴書を候補者追跡シートに変換しなければなりません。そして、その標準的な方法は今も手動のコピペです。もしその方法が、採用そのものよりもコストがかかっているとしたらどうでしょうか?
重要ポイント
- 履歴書40件の手動コピペには2〜4時間かかり、メールアドレスの入力ミス1つで候補者を完全に失います。
- ATSパーサーは履歴書を位置で読み取るため、2カラムレイアウトではサイドバーのスキルが職歴に直接混入します。
- 列を一度定義すれば、あらゆる履歴書形式に対応し、パーサーAPIに触れることなくフィルタリング可能な候補者スプレッドシートが得られます。
採用判断の裏にあるスプレッドシート
Fortune 500の採用チームであれ、5人規模のスタートアップであれ、あらゆる採用プロセスは最終的に1つの成果物に収束します。それは候補者スプレッドシートです。A列に氏名、B列に現在の役職、C列にソース(LinkedIn、紹介、求人ボード)、D列からH列にかけてスキルと経験年数が並びます。
エンタープライズ向けATS(応募者追跡システム)を導入できない中小企業にとって、このスプレッドシートが採用インフラのすべてです。候補者のランク付け、フォローアップ日程の管理、採用担当マネージャーへの説明はすべてここで行われます。問題は、これを1行ずつ、1件の履歴書ずつ構築することが、採用プロセス全体で最も時間のかかるステップだということです。紙やPDFの応募フォームも同じ山に加わり、求人応募フォームをExcelに変換すると、応募者名、職歴、学歴、推薦者が履歴書データと一緒に候補者スプレッドシートに取り込まれます。
SHRM(米国人材マネジメント協会)の推計によると、1件あたりの平均採用コストは約$4,700、業界全体の採用までの日数は平均33日です(SHRM Benchmarking)。これは広告費や人材紹介会社への手数料だけではありません。かなりの部分が採用担当者の人件費です。履歴書データを追跡用スプレッドシートにコピーするような、戦略的価値はないものの実際の給与を消費する作業に費やされる時間です。
重要なのは、スプレッドシート自体が悪いということではありません。構造化されていない文書から手作業でデータを入力することは、量に比例してコストがかかるという点が問題であり、ほとんどの採用チームには明確な代替手段がないのです。
手作業による入力が採用チームに実際にかけるコスト
バックログが発生するまで誰も計算しない算術があります。採用担当者が40人の候補者パイプラインを処理する場合、履歴書1件につき約3〜6分かけて氏名、メールアドレス、電話番号、現在の役職、会社名、経験年数、学歴、主要スキル、ソースを追跡シートに抽出します。40人分で、純粋なデータ入力に2〜4時間かかります。
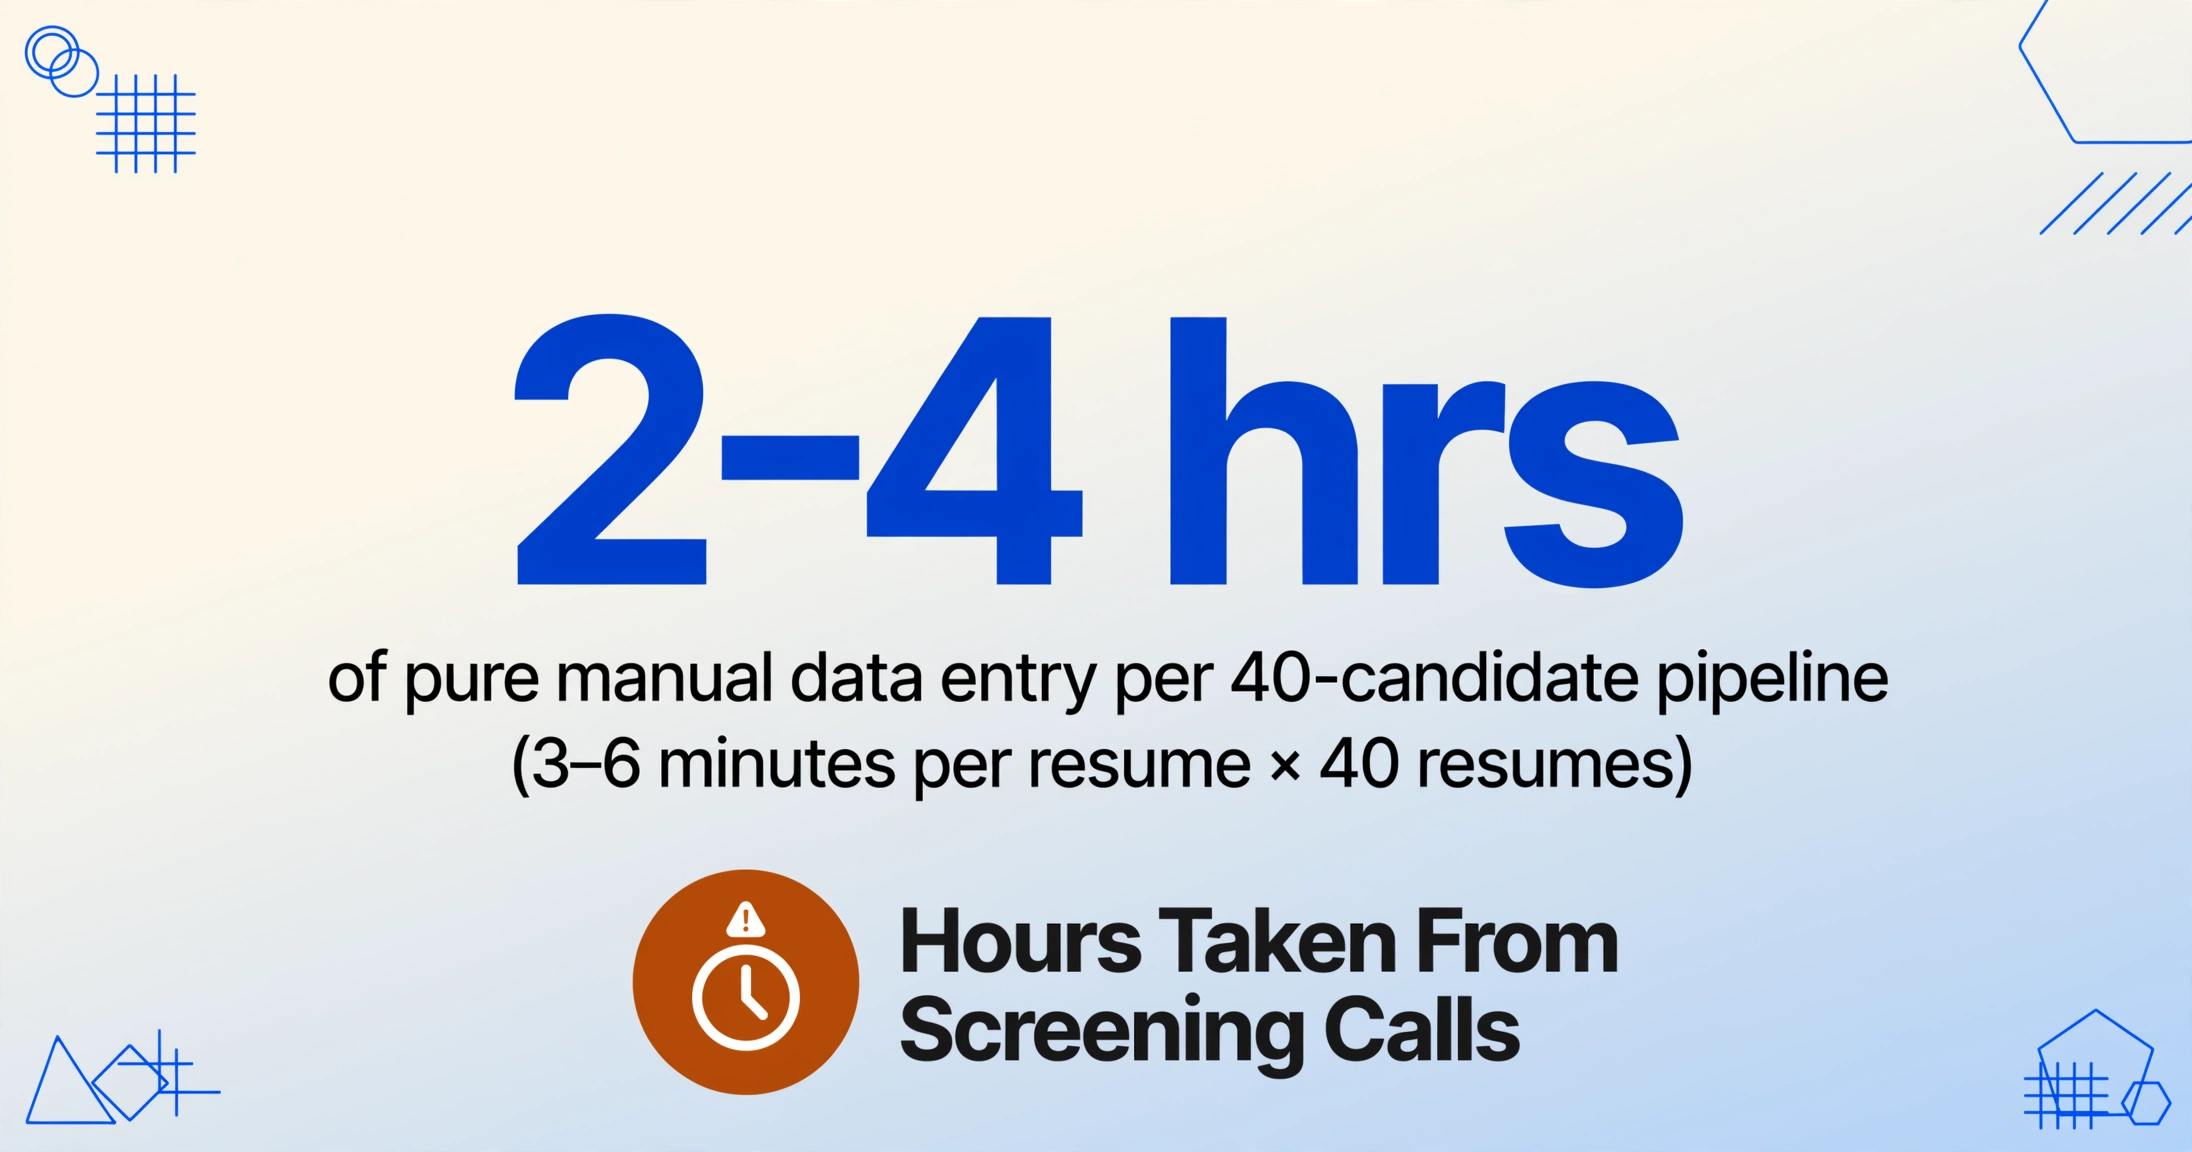
しかし、問題は時間だけではありません。その時間を本来何に使うべきだったかが問題です。スクリーニング電話、採用担当マネージャーとの連携、パッシブ候補者のリサーチ。採用を前進させるのはこうした活動です。データ入力はそれらすべてにかかる税金なのです。
エラー率も重要です。メールアドレスの入力ミスは、候補者が面接招待を受け取れないことを意味します。電話番号の桁違いは採用担当マネージャーの時間を無駄にします。サイドバーに記載されていたためにコピーされなかったスキルは、一次選考で見落とされます。スプレッドシートが採用判断の唯一の情報源となる場合、そのスプレッドシートの品質は判断の質に直接影響します。
参考までに、履歴書解析APIの業界標準価格は、Textkernel (Sovren)、RChilli、Daxtra、Affindaなどの専門ツールを通じて、履歴書1件あたり$0.05〜$0.30です。これは安く聞こえるかもしれませんが、ATSのサブスクリプションに加えて文書ごとの料金を支払い、さらに複数列レイアウトでのパーサーエラー修正に時間を費やすことになります。
候補者レコード:履歴書から抽出すべき項目
抽出を始める前に、採用プロセスにおいて「候補者レコード」が実際に何を意味するのかを定義する必要があります。多くのチームが陥る間違いは、すべてを抽出しようとすることです。つまり、雇用履歴全体をそのままコピーすることです。スプレッドシートの役割はフィルタリングと比較であって、アーカイブではありません。
実用的な候補者追跡シートのために抽出する価値のある主要フィールドは次のとおりです。(数十件から数百件の履歴書を扱う場合は、バッチ履歴書処理ガイドで、量の処理、ファイル名の混乱、マージ戦略についてご確認ください。)
| フィールド | シートに必要な理由 |
|---|---|
| 候補者名 | 主要な識別子。間違えることが許されない唯一のフィールドです。 |
| メールアドレス | 連絡手段。入力ミスをすると候補者を失うことになります。 |
| 電話番号 | スクリーニング電話やSMSでの日程調整に使用。国によって形式が異なります。 |
| 現在の役職 | 最も迅速な初期スクリーニング:直近の役割が募集職種と一致するかどうか。 |
| 現在の会社 | 業界の文脈。Googleの「ソフトウェアエンジニア」と10人規模のエージェンシーの「ソフトウェアエンジニア」では意味が異なります。 |
| 経験年数 | 推論列:AIが職歴を読み取り、履歴書に期間のみが記載されている場合でも、合計年数を計算します。 |
| 学歴/学位 | 最高学位と専攻分野。スキルベースの採用では重要性は低いですが、依然として一般的なフィルターです。 |
| 主要スキル | 技術スキルとソフトスキル。NACE(全米大学・雇用者協会)の報告によると、現在64.8%の雇用主がスキルベースの採用を導入しており、その3分の2がスクリーニング段階で適用しています(NACE Job Outlook 2025)。この列は、現代のパイプラインにおいて最も重要なフィルターです。 |
| 退職通知期間 | タイムライン計画に不可欠。「すぐに利用可能」と「退職通知3ヶ月」では、最終候補リストが変わります。 |
| 応募経路 | 履歴書の入手先:LinkedIn、紹介、求人ボード、エージェンシー。チャネルROIの測定に不可欠です。 |
| パイプラインステージ | 抽出後に手動で更新:応募済み、スクリーニング済み、面接、オファー、採用。スプレッドシートを軽量なATS(応募者追跡システム)に変えます。 |
重要な設計上の決定:抽出するのは比較に必要なものであって、抽出できるものではありません。候補者のフィルタリングやランク付けに役立たない列は、抽出時間と視覚的なノイズを増やすだけの列です。
特に注意が必要な列の1つが経験年数です。これは履歴書に単一の数字として記載されることはほとんどなく、職歴セクションの複数の期間に分散しています。計算列を使用すると、AIが各雇用期間を解析し、合計を計算して、単一の数字を出力します。「経験年数(全雇用期間の合計)」として列を定義すると、AIが抽出中に計算を処理するため、Excelでの後処理は不要です。
履歴書データをExcelに抽出する方法(ステップバイステップ)
履歴書抽出の核心的な課題はテクノロジーではなく、レイアウトの多様性です。グラフィックデザイナーの履歴書にはサイドバー、アイコン、2カラムレイアウトがあります。アカデミックのCVは4ページに及びます。LinkedInエクスポートのPDFはまったく異なる構造です。テンプレートベースのパーサーは固定レイアウトの想定で訓練されているため、これらに対応できません。セマンティック抽出(AIが位置ではなく意味で読み取る方式)こそが、このワークフローをフォーマット横断で機能させる鍵です。
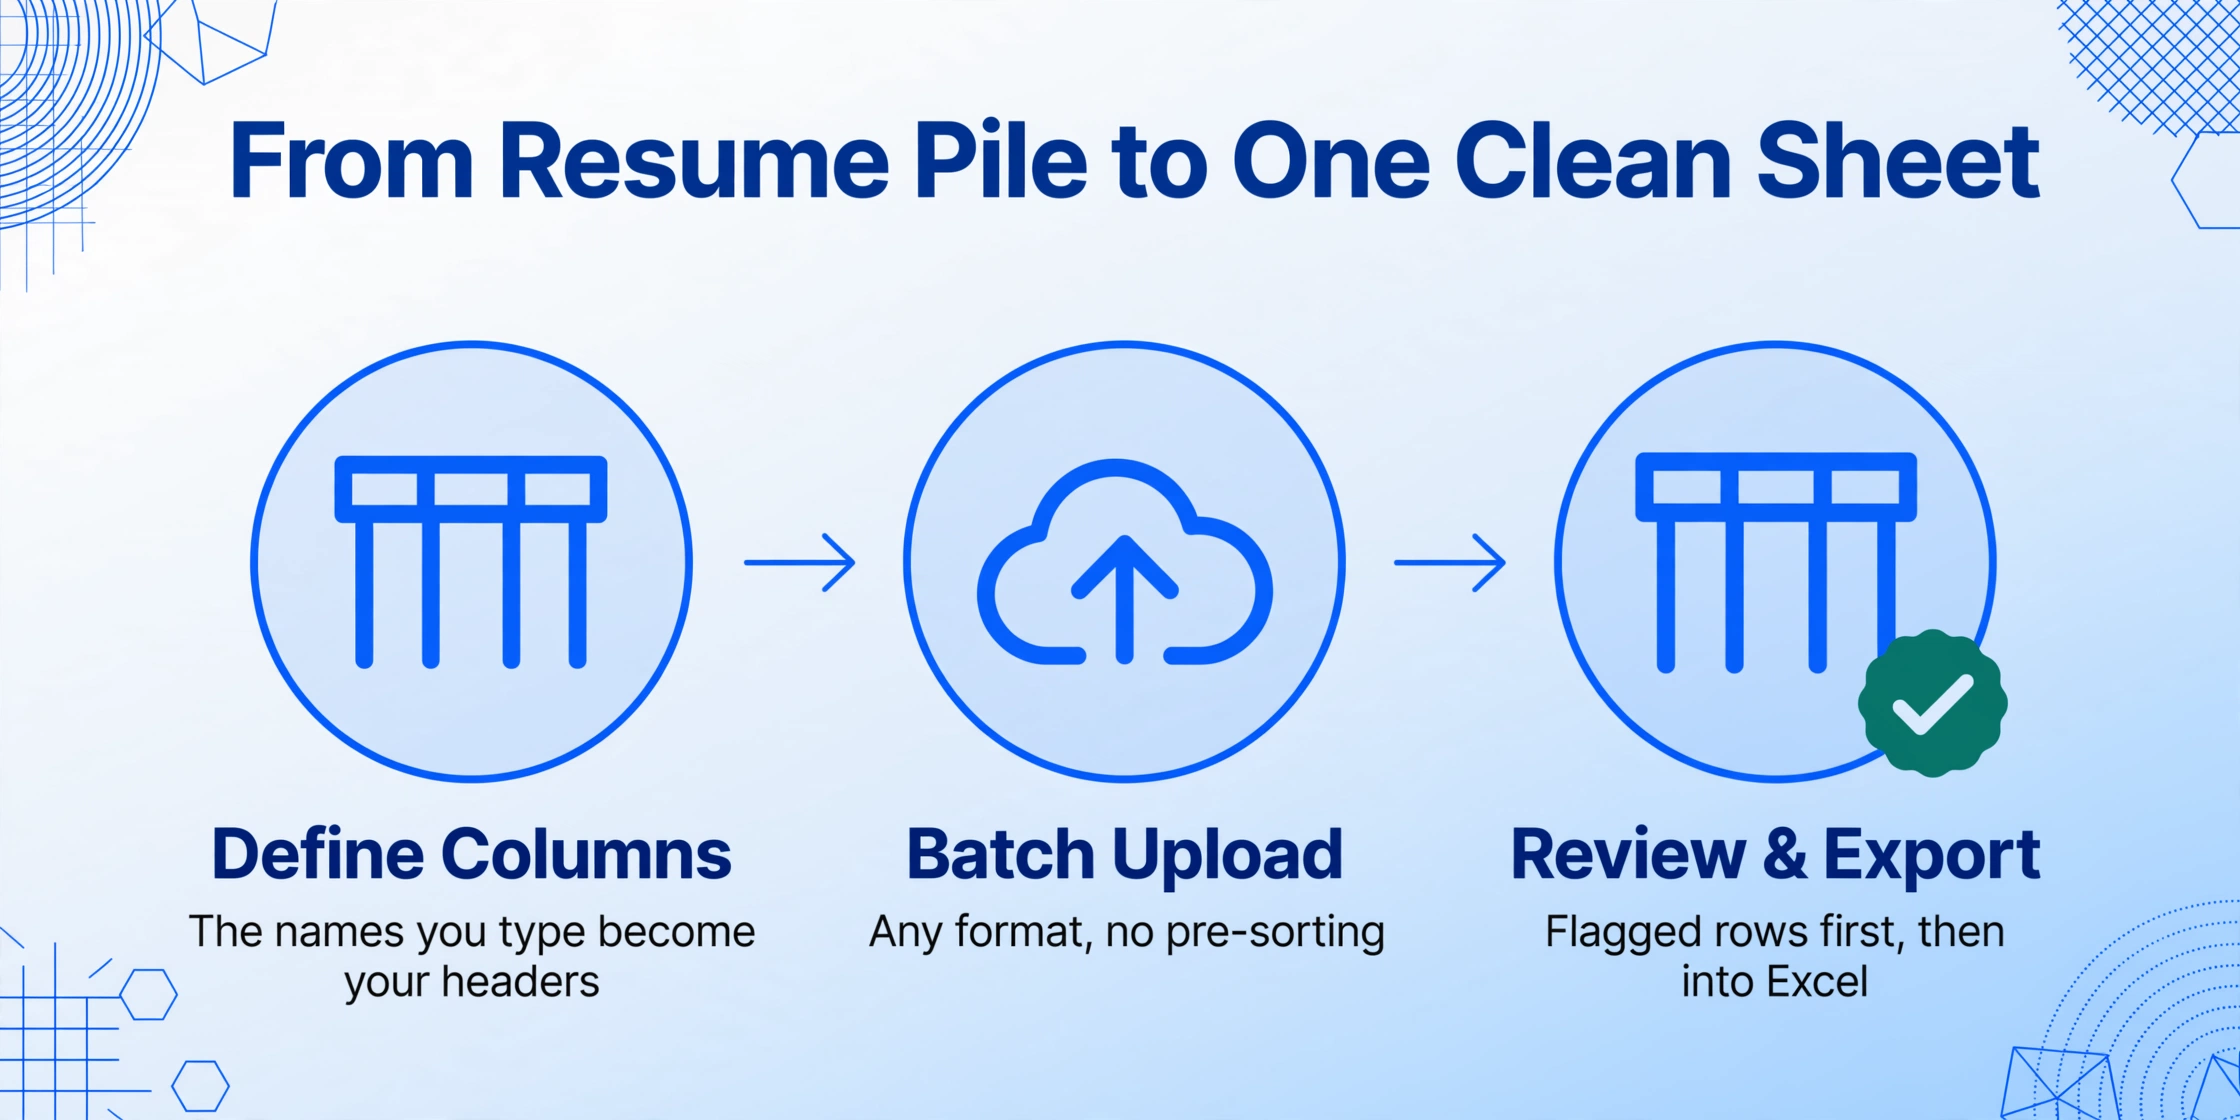
ImageToTable.aiはカスタム列抽出を使用します。抽出したいフィールド名(「候補者名」「メールアドレス」「主要スキル」「経験年数」など)を入力すると、AIが各履歴書のどこにあっても、フィールドの意味を理解して各値を特定します。入力した列名が出力スプレッドシートのヘッダーになります。
ステップ1:列を定義する
上記のセクションのフィールドリストから始め、役職の要件に合わせて調整します。技術系採用の場合はプログラミング言語と資格を追加します。営業職の場合はノルマ達成率と担当エリアを追加します。定義した列によって、候補者プール全体で並べ替え、フィルタリング、比較が可能になります。
ステップ2:すべての履歴書を一括アップロードする
すべての履歴書(PDF、Word文書、スクリーンショット、LinkedInエクスポート)をアップロードエリアにドロップします。フォーマットに制限はなく、レイアウトごとに事前分類する必要もありません。AIが各文書を個別に処理し、抽出した値を定義した列にマッピングします。
ステップ3:レビューとExcelへのエクスポート
処理が完了すると、候補者ごとに1行、フィールドごとに1列の単一のテーブルが作成されます。エクスポートする前に、抽出された任意のセルにホバーすると、元の履歴書のどこからその値が取得されたかを正確に確認できます。ソースドキュメント上のハイライトされたバウンディングボックスが、数秒で視覚的な確認を提供します。その後、Excel(XLSX)にエクスポートすれば、フィルタリング、並べ替え、採用チームとの共有が可能になります。
ファイルは安全に処理され、保存されることはありません。
パーサーが履歴書を誤読する場合:位置情報ツールを壊すレイアウト
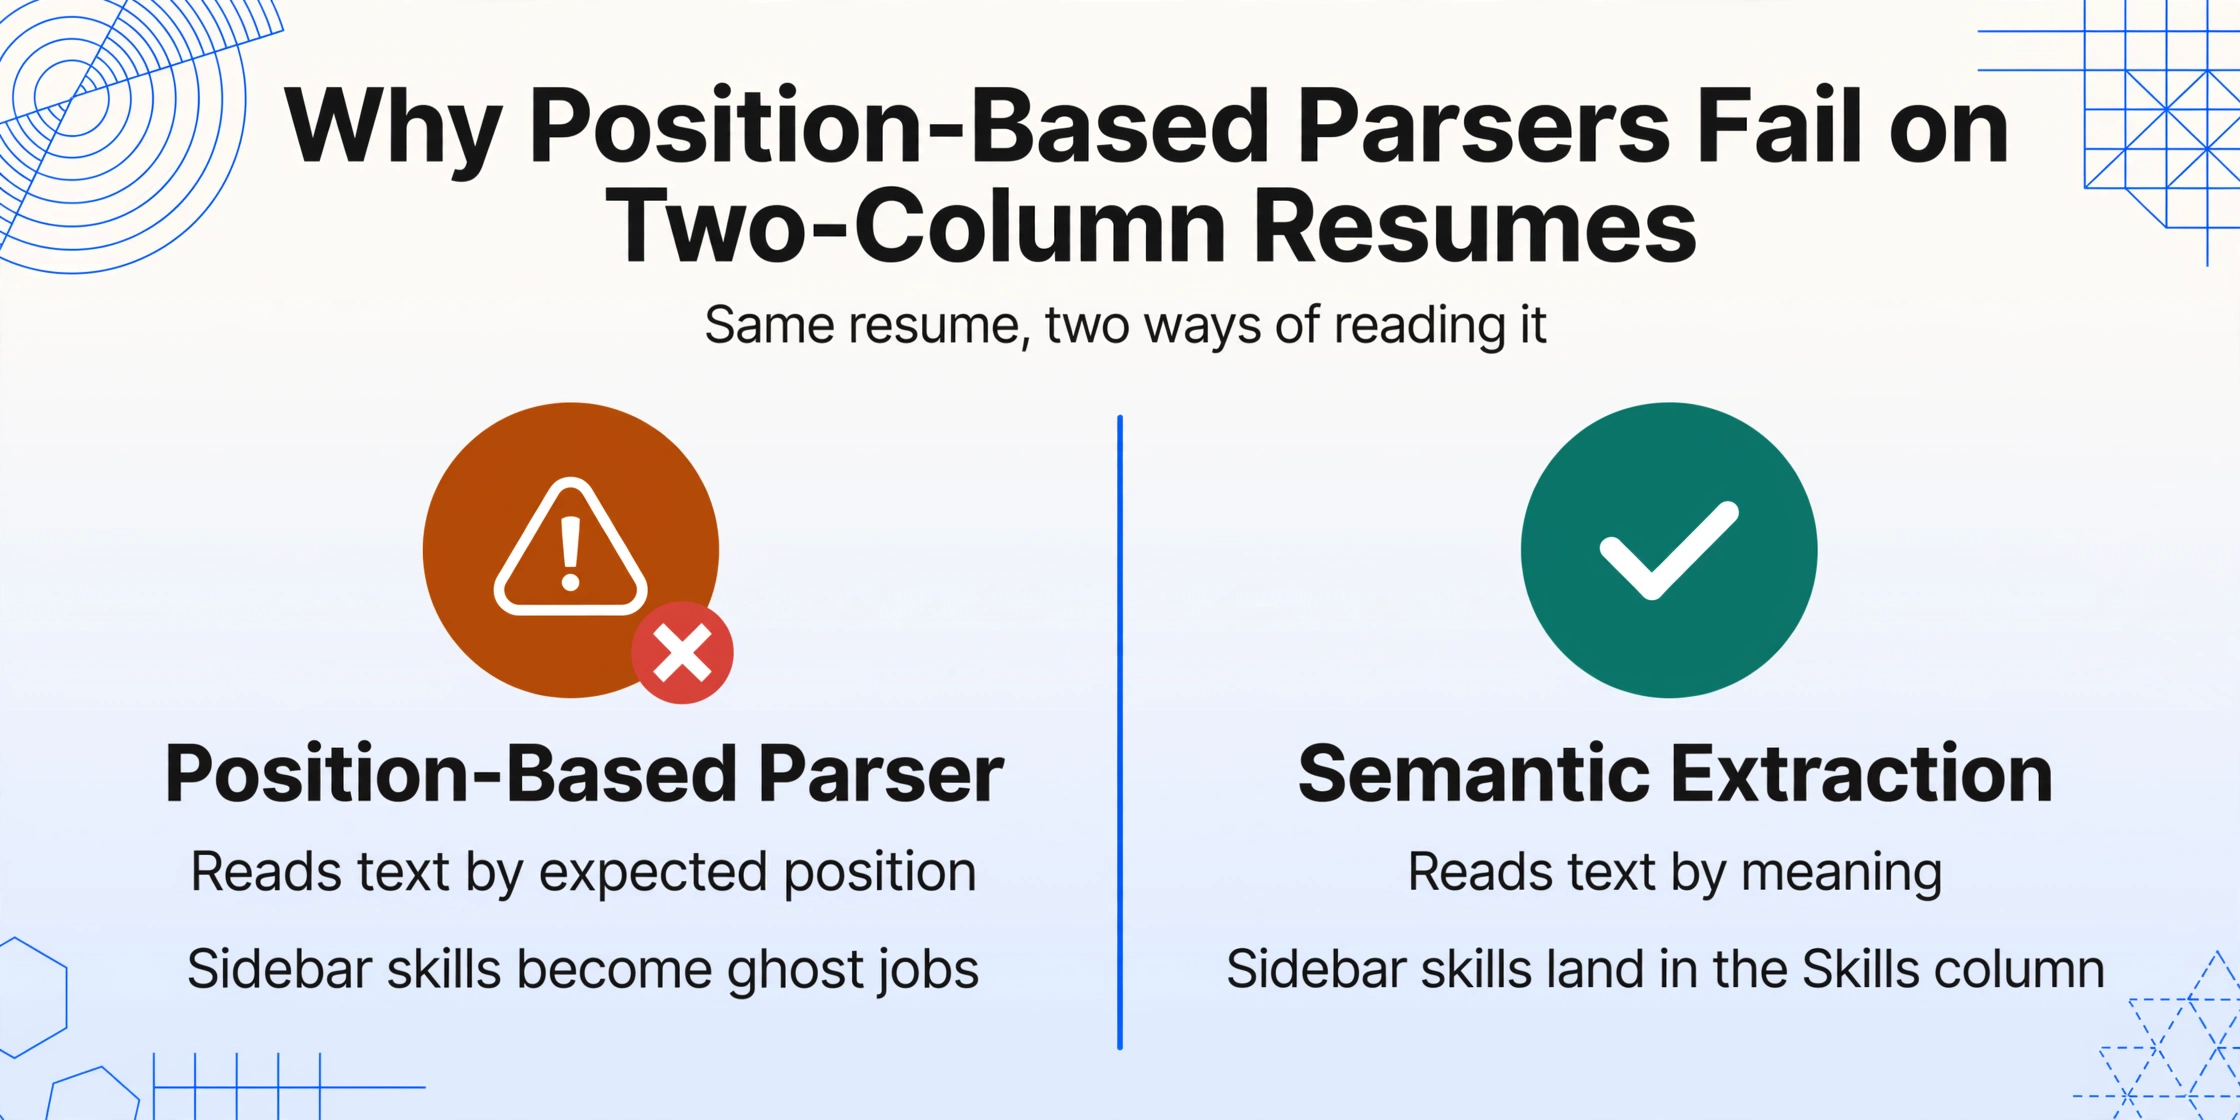
位置ベースの履歴書パーサー(ほとんどのATSプラットフォームに組み込まれている種類)は、予想される場所のテキストを探すことで機能します。上部に連絡先セクション。中央に職歴。下部に学歴。履歴書がそのテンプレートに従っている場合、パーサーは機能します。従っていない場合、出力は微妙に間違っているものから笑ってしまうほど使えないものまで様々です。
Redditのr/recruitingで、あるリクルーターがPhenomを搭載したシステムが2カラムの履歴書に遭遇した時のことを説明しています。「CRMプロフィールには、彼らがGM工場のバリスタだと表示されていた」— サイドバーのスキルセクションがメインの職歴に統合され、意味をなさないキャリアの経歴が生成されたのです(r/recruiting)。別のユーザーは、Workdayの応募フォームに機密情報を入力したところ、「あなたの名前がファーストネームの機密情報として表示された」と報告しました。フィールドの区切り文字が予期しない入力で壊れたのです。
「Greenhouseも他のすべてと同じだ」と、同じスレッドは結論づけています。「ATSは応募者追跡システムの略です。特別なものではありません。」組み込みのパーサーは壊れているわけではありません。非位置情報のドキュメントの世界における位置情報ツールに過ぎないのです。
位置ベースのパーサーに共通する失敗モード:
- 2カラムレイアウト: サイドバーのコンテンツ(スキル、言語、資格)が本文の職歴として読み取られ、存在しない職務や雇用主が生成されることがあります。
- クリエイティブな書式: アイコンを使ったセクションヘッダー、スキル評価バー、タイムラインのビジュアルを備えたグラフィックデザイナーの履歴書では、文字列が乱れることがあります。
- ヘッダー/フッターのコンテンツ: ヘッダーに配置されたLinkedIn URL、ポートフォリオリンク、ページ番号が、最も近いテキストブロックに統合されてしまいます。
- 複数ページのドキュメント: 4ページ以上にわたる学術的なCVでは、セクション区切りによってパーサーの位置情報の前提が文書の途中でリセットされることがよくあります。
セマンティック抽出は、位置情報に依存しないことでこれらの失敗を回避します。AIは人間と同じように文書を読み取ります。「Education」が座標ではなくセクションであること、サイドバーにリストされたスキルが本文にリストされた職歴とは根本的に異なることを理解します。これは、すべてのクリエイティブなレイアウトで100%の精度を意味するわけではありません。欄外の手書きメモや高度にスタイリングされたタイポグラフィは依然として課題ですが、位置ベースのパーサーを多様な履歴書形式で信頼性の低いものにする構造的な失敗モードを排除します。パーシングAPIとセマンティックAI抽出の詳細な比較(ドキュメントごとの価格、セットアップの手間、チームに適したアプローチなど)については、履歴書パーシングとAI抽出の比較をお読みください。
スプレッドシートを候補者パイプラインに変える
抽出されたデータがExcelに入ると、スプレッドシートは単なるデータの集まりではなく、軽量な採用ツールになります。(専用ツールのデモページをご希望の場合は、履歴書データのExcelへの抽出ツールをお試しください。)優れたチームは次のようにしてこれを運用しています:
ステータス列を追加する。「応募済み」「スクリーニング済み」「一次面接」「二次面接」「オファー」「採用」— 候補者がステージを進むにつれて手動で更新します。ステータスで並べ替えると、パイプライン全体を一目で確認できます。
ソースの帰属を追跡する。「ソース」列を使用すると、どのチャネルが最も優秀な候補者を生み出すかを計算できます。紹介採用は、定着率において求人ボード経由の採用を一貫して上回ります。ただし、各履歴書の出所を追跡していなければ、それを証明することはできません。
Excelのネイティブフィルターを使用する。「トップスキル」に「Python」が含まれ、「経験年数」が3より大きいものでフィルタリングします。「通知期間」に「即日」が含まれるものでフィルタリングすると、すぐに開始できる候補者を絞り込めます。これらは、専用のATSが有料で提供する機能とまったく同じ操作であり、スプレッドシート内でネイティブに実行されます。
複数のソースから履歴書を収集する。採用マネージャー、外部リクルーター、従業員紹介から候補者の履歴書がメールで送られてくる場合は、コレクションリンク(処理キューに直接送信される共有可能なアップロードページ)またはメール受信ボックス(履歴書を転送すると自動的にキューに追加されます)を使用してください。他の人はアカウントを持つ必要はなく、ファイルを送信するだけです。
ATSにインポートする。Greenhouse、Lever、Workday、iCIMS、BambooHR、およびその他のほとんどのプラットフォームは、候補者データのCSVインポートをサポートしています。まずExcelに抽出し、データを一度クリーンアップして正規化してからインポートします。各プラットフォームの組み込み履歴書パーサーに依存するよりも、高速で信頼性が高くなります。
候補者データの責任ある取り扱い:EEOC(米国雇用機会均等委員会)、GDPR(一般データ保護規則)、および保持期間
候補者データをスプレッドシートに抽出すると、雇用およびプライバシーに関する規制の対象となる個人情報のデータベースを作成することになります。これは人事関連の懸念事項ではなく、ワークフローの核となる部分です。
米国では、AIを活用した、または自動化された履歴書スクリーニングツールは、1964年公民権法第7編に基づく「採用手続き」とみなされます。EEOCの「従業員選定手続きに関する統一ガイドライン(UGESP)」は5分の4ルールを適用します。つまり、保護されたグループの選定率が最も高いグループの選定率の80%未満の場合、それは不利な影響の予備的所見となります(EEOC 第7編)。抽出したデータで候補者を絞り込む採用チームにとって、実際的な要点は次のとおりです。フィルタリング基準を文書化することです。「経験年数 > 3」や「学位 = 学士」でフィルタリングする場合は、その基準が職務に関連し、業務上の必要性と一致していることを示せるように準備してください。
EUまたは英国で採用活動を行うチームにとって、GDPR第22条は自動処理のみに基づく決定を制限し、第35条は個人データの高リスク処理(体系的な候補者スクリーニングがこれに該当)に対してデータ保護影響評価(DPIA)を義務付けています。英国のICOおよびEUのデータ保護当局は一般に、採用プロセス終了後、不合格となった候補者のデータを6〜12か月を超えて保持しないことを推奨しており、候補者がより長い保持に明示的に同意しない限り、この期間を超えてはなりません。
運用面では、データ最小化とは、採用判断に必要なフィールドのみを抽出することを意味します。雇用履歴のすべての行を抽出するのではありません。レビューモードによる視覚的なバウンディングボックス検証により、何がどこから抽出されたかを確認でき、監査可能な証跡を作成できます。また、候補者が削除を要求した場合、複雑なATSデータベースからレコードを解きほぐすのではなく、スプレッドシートから行を削除するだけです。
候補者レコードには、履歴書のフィールドだけでなく、スクリーニング結果も保持する必要があることがよくあります。身元調査をExcelに変換するワークフローでは、犯罪歴、照会、MVRの結果を上記の保持ルールに基づいてファイル化します。
スプレッドシートベースのパイプラインのコンプライアンス上の利点は、シンプルさです。データは一箇所に存在します。削除は行の操作です。フィルタリングロジックは明示的です(ブラックボックスのAIスコアリングではなく、Excelの数式)。EEOCおよびGDPRの義務の下で運営される中小規模のチームにとって、この透明性はエンタープライズATSの機能セット以上の価値があります。
よくある質問
手書きの履歴書も読み取れますか?
部分的に対応しています。手書き欄のある印刷フォームのように、明瞭で読みやすい手書き文字は精度よく抽出できます。無地の用紙に書かれた、つながった筆記体は信頼性の低い結果になります。印刷と手書きが混在する履歴書では、AIは印刷されたテキストをすべて確実に抽出し、信頼性の低い領域にフラグを立てます。手書きのみの履歴書は、追加の手動レビューが必要とお考えください。
2カラムの履歴書レイアウトでは精度はどうですか?
AIはレイアウト上の位置ではなく、意味的な内容を読み取るため、位置ベースのパーサーよりも大幅に優れています。左側にあるスキルサイドバーは、ページ上のどこにあっても「スキル」セクションとして認識されます。とはいえ、アイコンでセクションを示す、凝ったデザインのグラフィックデザイナー向け履歴書では、一部の項目で信頼性が低くなる可能性があります。AIは文脈の中でテキストを読むことは得意ですが、視覚的なメタファーを解読することは苦手です。
一度に何件の履歴書を処理できますか?
バッチアップロードでは、1回のセッションで数十件の履歴書を処理できます。すべてのファイルは並行処理され、1つの統合された出力テーブルにまとめられます。候補者ごとに1行で、ドキュメントごとの設定は不要です。
結果をGreenhouseやWorkdayにインポートできますか?
はい。Greenhouse、Lever、Workday、iCIMS、BambooHR、Bullhornなど、ほとんどのATSプラットフォームがCSVでの候補者インポートに対応しています。Excelに抽出し、データを一度クリーンアップして検証した後、クリーンなファイルをインポートしてください。このワークフローは、特にATS外部から集めた候補者の場合、各プラットフォームの内蔵履歴書パーサーに頼るよりも速く、信頼性が高いことが多いです。
抽出後、履歴書データはどうなりますか?
ファイルは処理後、設定可能な保持期間を経てサーバーから自動的に削除されます。お客様のアップロードからトレーニングデータが保持されることはありません。GDPR(一般データ保護規則)などの規制に基づき削除を求める候補者の場合、抽出されたスプレッドシートデータは、ベンダーのデータベースではなく、お客様が管理するファイルに保存されます。
これはレジュメパーサーAPIとどう違うのですか?
レジュメパーサーAPI(Textkernel、RChilli、Affinda、Daxtra)はレジュメ専用に作られており、多くの場合、使用可能な形式にするために統合コードが必要な構造化JSONを生成します。また、ドキュメントごとに料金がかかります(1回の解析につき$0.05〜$0.30)。AI抽出はより広いアプローチを取ります。事前トレーニングされたレジュメスキーマではなく、フィールドの意味によってあらゆるドキュメントタイプを読み取り、スプレッドシートに直接出力します。API統合は不要で、Excelファイルが得られます。レジュメ以外(オファーレター、入社フォーム、雇用契約書)も扱うチームにとって、1つの抽出ワークフローですべてのドキュメントタイプをカバーできます。