学生の成績証明書データをExcelに抽出する方法
— 入学審査のステップバイステップガイド
AACRAOの会員調査データは、すべての入学審査責任者が知っている事実を裏付けています。高校の成績証明書1枚を学生情報システムに手入力するのに20分以上かかります。 1サイクルあたり15,000件の出願を処理する中規模大学では、これは5,000時間の職員労働に相当します — およそフルタイム職員3人分が、PDFを読んでタイピングするだけに費やしている計算です。しかし、より深い難しさは量ではありません。各成績証明書が同じ情報 — コース、成績、単位、GPA — を、異なる視覚言語で、異なる学術システムから、しばしば自校と一致しない成績評価尺度を使って伝えていることです。ボトルネックはデータ入力の速さではありません。成績証明書が情報を提示する方法と、SISがそれを受け取る必要がある方法との間の意味的なギャップです。
重要ポイント
- 1サイクルあたり15,000件の出願は、すでにページ上に存在する成績を再入力するだけで5,000時間の職員労働を消費し、フルタイム職員3人分がそれ以外のことを一切しないのと同じです。
- OCRは成績証明書から「B+」という文字を読み取りますが、その成績がある高校では3.3を意味し、別の高校では87を意味することを教えてくれません。また、どの入学審査チームも2,000以上の送信元機関すべてに対応する解析テンプレートを構築・維持することはできません。
- 必要な出力列を一度定義すれば、セマンティックAIが各成績証明書の学術的な意味を理解し、2,000以上の学校のどれが文書を送ってきたかにかかわらず、スプレッドシートにデータを入力します。
成績証明書データが他の文書と異なる点
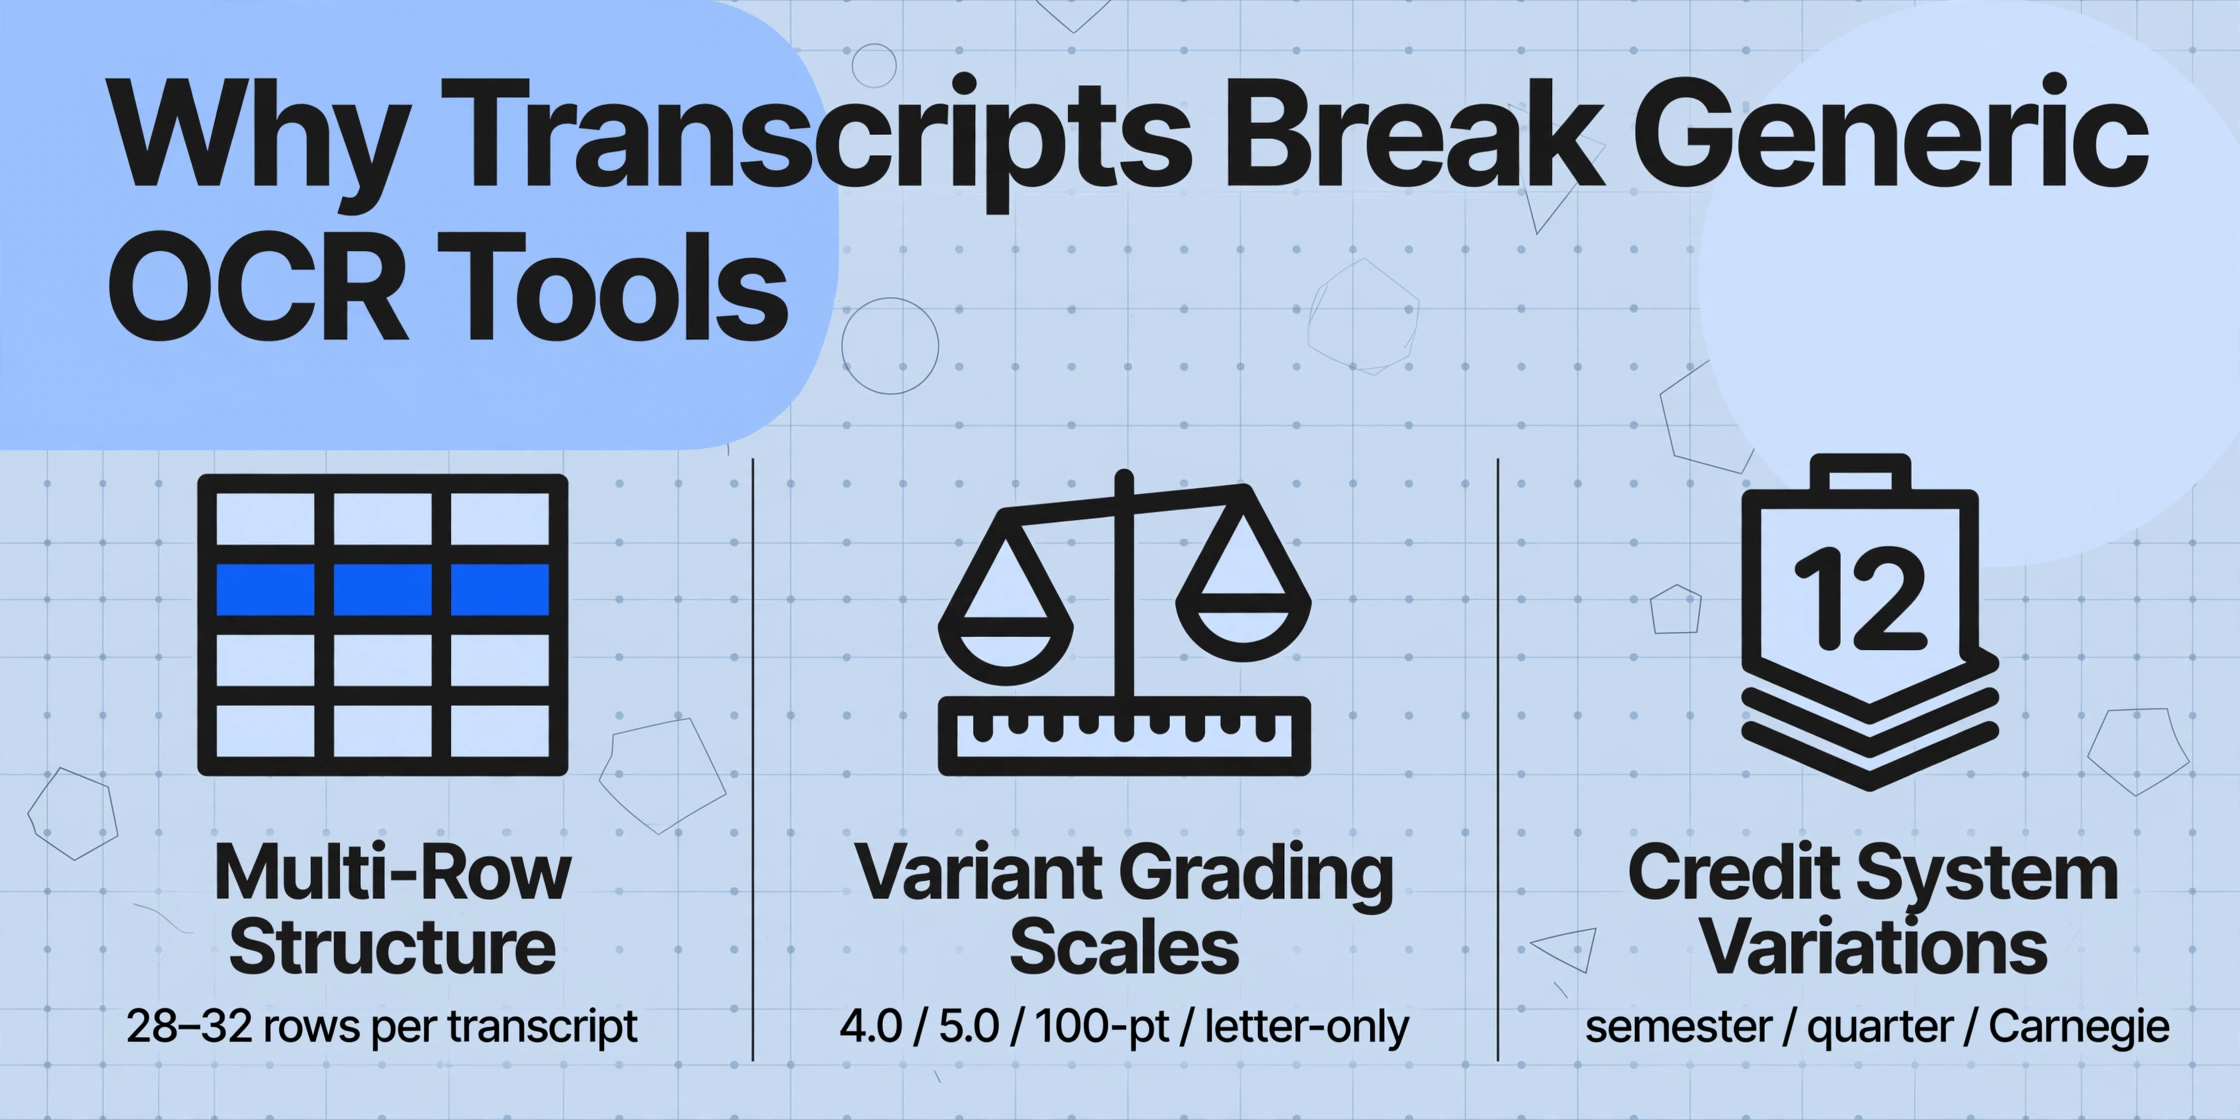
ほとんどの文書抽出の課題は共通の形をしています。請求書番号を見つける、日付を見つける、合計を見つける——ページに一度だけ現れるフィールドです。成績証明書はこのパターンを3つの点で破っており、それが一般的なOCRツールが苦戦し、テンプレート方式が形式の多様性で崩壊する理由を説明しています。
複数行の科目リスト。 成績証明書は単一インスタンスのフィールドを持つフォームではありません。テーブルです——複数ページにまたがることもあり、各行が科目名、成績、単位、学期を持つ1つの科目を表します。4年制高校の成績証明書には28〜32行の科目があります。編入生の統合成績証明書は、複数の以前の機関にわたって60行を超えることもあります。正しい行から正しいデータを抽出することは、ピクセルレベルのOCRがそもそも想定していなかった構造的な課題です。
成績評価スケールの多様性。 教育機関は少なくとも4つの一般的なスケールで成績を報告します:加重なし4.0、加重5.0(AP/IBは+1.0、Honorsは+0.5)、100点満点のパーセンテージ、数値換算のない文字のみ。ある高校では「B+」は4.0スケールで3.3を意味し、別の高校では87〜89%を意味し、スタンフォードなどが使用する4.3スケールではまったく異なる値になります。国際的な成績証明書には、パーセンテージ帯、順位ベースのシステム、米国のスケールにきれいにマッピングできない全国試験のスコアが追加されます。単に「B+」という文字をページから読み取るだけでは何の役にも立ちません——評価機関の枠組みの中でその成績が何を意味するかを知る必要があります。
単位制度の違いと科目指定。 セメスター単位、クォーター単位(標準の÷1.5換算で5クォーター時間=3.33セメスター時間)、ターム単位、カーネギー単位がすべて同じ志願者プールに共存しています。単位数に加えて、科目レベルの指定は入学審査上重要な意味を持ちます:Advanced Placement、International Baccalaureate、デュアル・エンロールメント、Honors、以前の機関からの編入単位、補習コース。各指定は、GPA計算で科目をどのように加重するか、前提条件を満たすかどうかに影響します。「4.0単位」とだけ伝え、「AP Calculusの4.0クォーター単位」と伝えない成績証明書抽出ツールは、誤解を招くデータを提供していることになります。
これが、American Association of Collegiate Registrars and Admissions Officers (AACRAO)——約2,300機関の18,000人以上の専門家を代表——が、Academic Record and Transcript Guideを通じて成績証明書の実務標準化に数十年を投資してきた理由です。また、National Student Clearinghouse Electronic Transcript Exchange (ETX)が現在、PDF、XML、EDI形式での無料で安全な成績証明書交換のために約2,000機関を結んでいる理由でもあります。電子成績証明書送信のインフラは存在します。残るギャップは、送信された文書を、スタッフがすべてのフィールドを手入力することなく、SISが消費できる構造化データに変換することです。
従来のOCRは文字を読み取ります。AIを活用した意味抽出(このガイドで扱うアプローチ)は、学術的な意味を読み取ります。ある成績証明書の「AP Calc BC」と別の成績証明書の「Calculus BC (Advanced Placement)」が同じ科目カテゴリであることを理解します。同じページ上の科目の成績と累積GPAの数値を区別できます。そして、送信元の各教育機関ごとに解析テンプレートを構築・維持する必要なく、これを実現できます。基盤となる技術の違いについて詳しくは、OCRが実際に理解できることとできないことに関するガイドをご覧ください。
ステップ1:抽出用に成績証明書を準備する
抽出ツールに入力する内容によって、出力結果が決まります。3つの準備に関する決定が、出力品質に測定可能な違いをもたらします。
スキャン解像度。郵送で届く紙の成績証明書を扱う場合は、最低300 DPIでスキャンしてください。年間31,000件以上の大学の成績証明書(82%がEDI、18%が紙からのOCR)を処理するサンディエゴ州立大学では、グレースケール出力で300 DPIを標準としています。白黒スキャンでは、密度の高い成績証明書レイアウトで科目名と成績欄を区別する微妙なコントラストが失われます。カラースキャンは最大限の情報を保持しますが、ほとんどの成績証明書形式では精度に有意な向上がないままファイルサイズが増加します。
ページの傾き補正と向き。成績証明書はほぼ常に縦向きですが、スキャンされたページはわずかに回転して届くことがよくあります。2度の傾きでも、従来のOCRが列の配置を誤読する原因になります。どの成績がどの科目に属するかが混乱するのです。スキャンソフトウェアに自動傾き補正機能がある場合は、有効にしてください。すでにデジタル化されたPDFの場合、ほとんどの抽出ツールが内部で回転を処理しますが、バッチで系統的なエラーに気付いた場合は、抽出ロジックのトラブルシューティングを行う前に、ソースPDFの回転を確認してください。
バッチ整理。アップロード前に、処理の優先順位ごとに成績証明書をグループ化してください。単位認定を評価する場合は、単位認定審査が必要な成績証明書を、単純な新入生の入学ファイルとは別にバッチ処理してください。レビューのワークフローが異なります。ファイル名は一貫した形式にしてください:[姓]_[名]_[機関名].pdf。この命名規則により、検証中に抽出データをソースファイルと照合する際に、各ファイルを開くことなく確認できます。
成績証明書を主にNational Student Clearinghouse ETXまたはParchmentを通じて受け取っている場合は、すでにデジタルPDFを受け取っていることになります。スキャンのステップを省略して、直接抽出に進んでください。抽出前の画像品質の最適化について詳しくは、OCR精度向上のための実践ガイドをご覧ください。
ステップ2:抽出する列を定義する
ここが、テンプレートベースのツールとは決定的に異なるポイントであり、使えるデータを得られるか、それとも混乱した結果になるかを左右するステップです。テンプレート方式では、各送付元機関のサンプル成績証明書にフィールドを矩形で囲む作業が必要です。米国だけでも2,000以上の高校と4,000以上の大学がある中で、この方法はスケールしません。
セマンティック抽出は異なるアプローチをとります。ツールに「どこを」見るかを指示する代わりに、「何を」欲しいかを指定します。つまり、出力スプレッドシートのヘッダーとなる列名を定義するのです。AIが各成績証明書を読み取り、テキストの学術的な意味を理解し、定義された列に値をマッピングします。これがImageToTable.aiのカスタム列抽出です。出力スキーマを一度定義すれば、フォーマットの違いに関係なく、バッチ内のすべての成績証明書にツールが適用されます。
以下は、多くの入学事務局が必要とするコアデータをカバーする列スキーマの例です。
| 列名 | 抽出内容 | 備考 |
|---|---|---|
学生名 | 成績証明書に記載されたフルネーム | 出願記録と照合して確認 |
機関名 | 発行元の高校または大学 | 出身校分析やGPAの文脈把握に使用 |
科目名 | 完全な科目タイトル | 例:「AP英文学と作文」 |
成績 | 表示されているアルファベットまたは数値の成績 | 生の値を抽出。換算はステップ3で実施 |
単位数 | 取得した単位時間または単位数 | 単位システムの種類(学期/クォーター/カーネギー)に注意 |
学期 | セメスター、トリメスター、または年度 | 例:「2024年秋学期」「2025年春学期」 |
GPA | 報告された累積GPA | スケールは様々。加重/非加重の別に注意 |
科目レベル | 通常、優等、AP、IB、ダブルエンロールメント、編入 | オプションリスト付きの推論列を使用 |
最後の列「科目レベル」は、ほとんどの成績証明書に明示的に表示されるフィールドではありません。AIが文脈から分類を推論する必要があります。科目名に「AP」とある、別の「優等」指定列がある、またはダブルエンロールメントの表記がある、といった情報から判断します。これは推論列です。AIが文書を読み、証拠に基づいて各科目がどのカテゴリに属するかを推論します。たとえ成績証明書に「AP」や「優等」という単語が独立したフィールドとして印刷されていなくても機能します。列定義にオプションを含めることで推論ロジックを指定します:科目レベル(オプション:通常、優等、AP、IB、ダブルエンロールメント、編入、補習)。
単位互換評価の場合は、以下の列を追加して詳細を取得します。
| 列名 | 目的 |
|---|---|
科目コード | 学科プレフィックス+番号(例:「MATH 2413」)。同等性検索に使用 |
単位タイプ | 学期 / クォーター / トリメスター / カーネギー — 換算式を決定 |
編入元機関 | 他機関で取得し編入された単位の場合、その元の機関名 |
入力した列名が、最終的なExcel出力の列ヘッダーになります。出力形式を定義しているのはあなたであり、AIはバッチに届いたどのトランスクリプトからでも、その形式にデータを入力する方法を自動で判断します。
ステップ3:GPAスケールと単位換算の処理
生の成績と単位の値を抽出することは、作業の半分に過ぎません。それらの値を志願者間で比較可能にするには換算が必要です。そして、ここでこそ、手作業のワークフローが入試パイプライン全体に静かに累積していくエラーを生み出すのです。
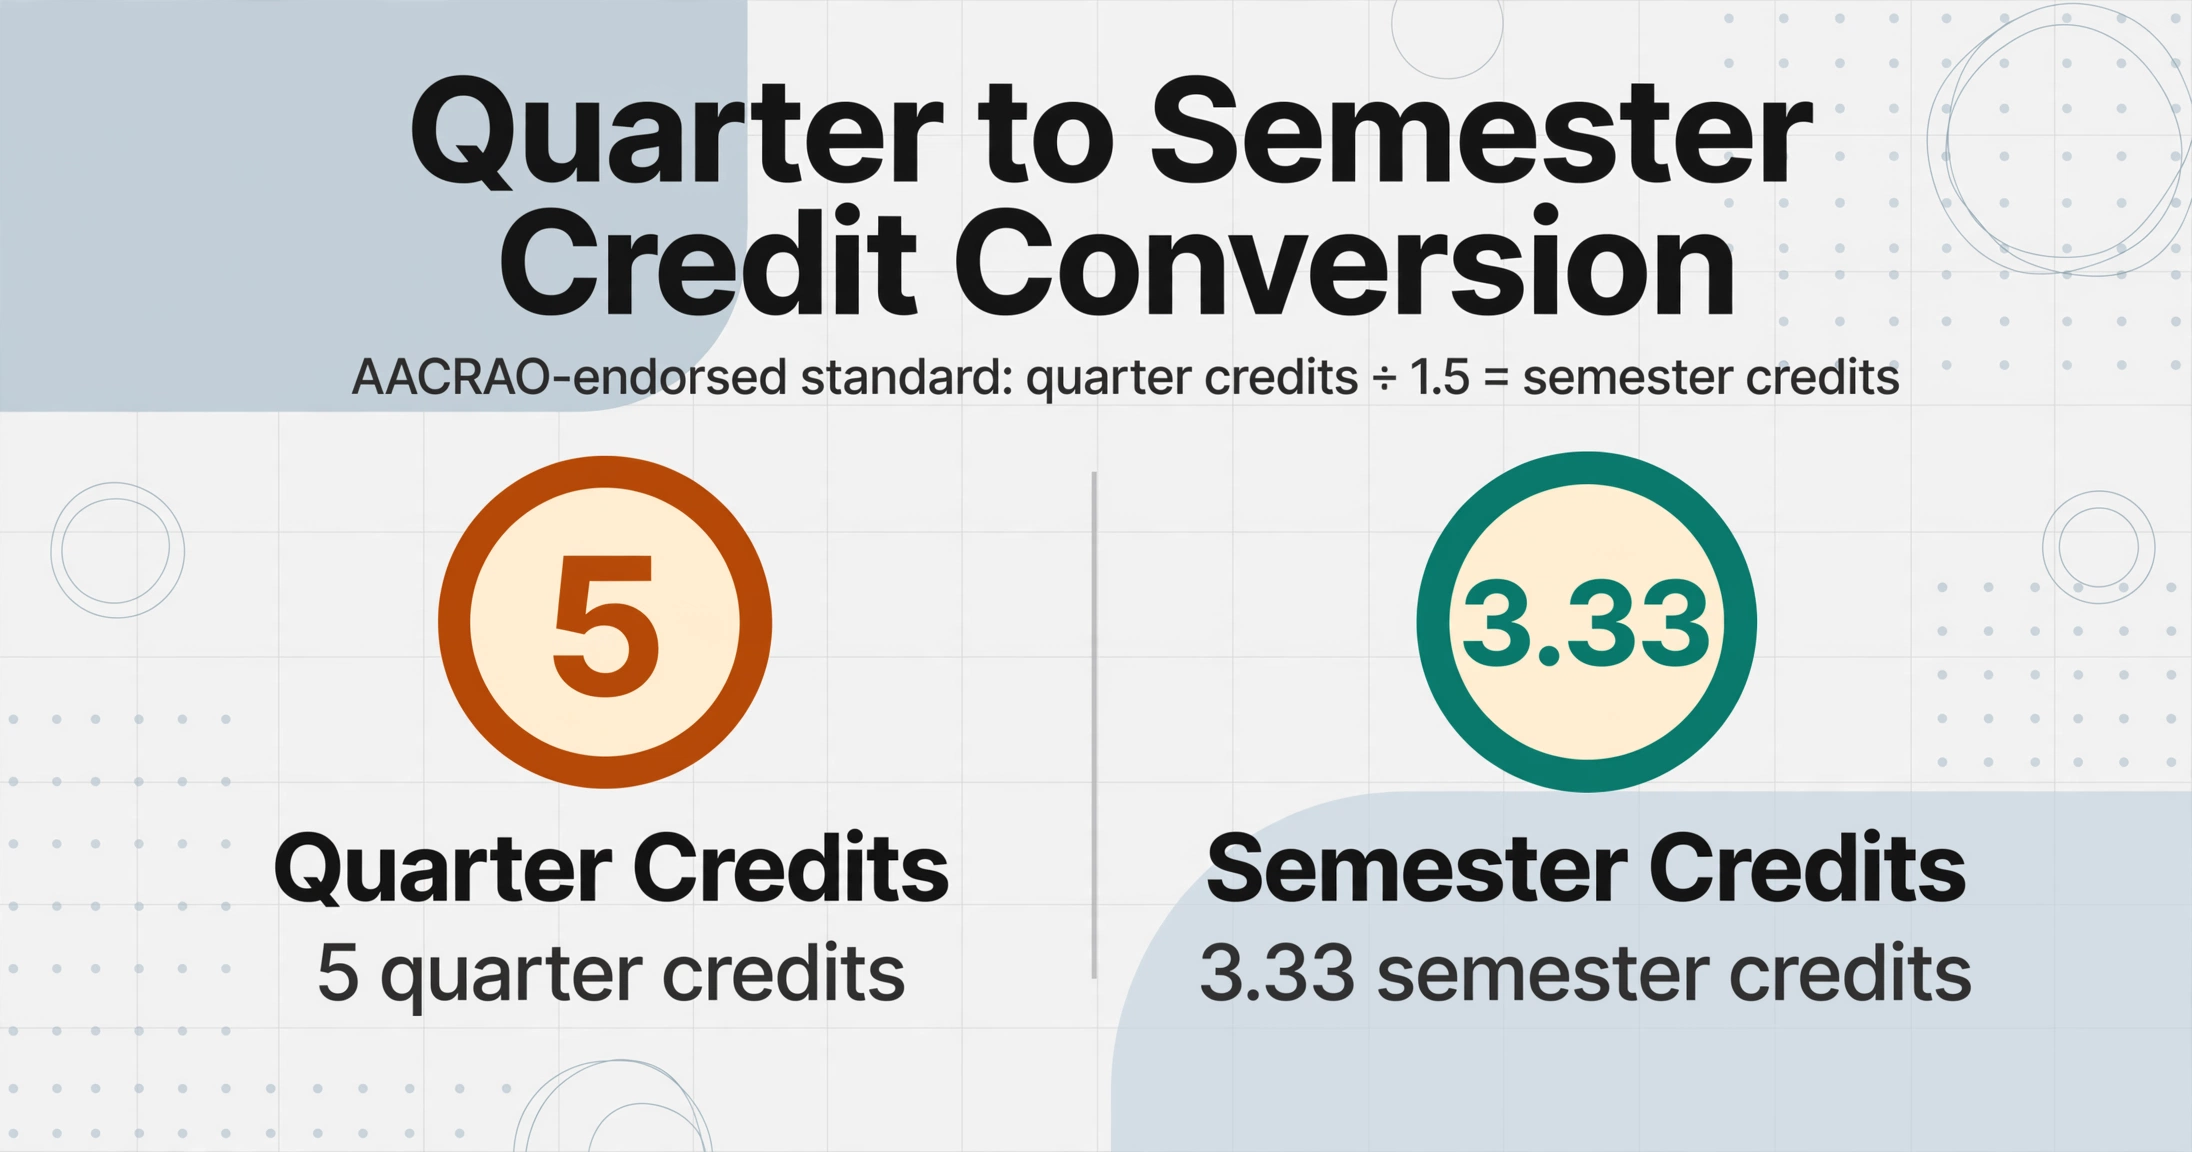
クォーター制からセメスター制への単位換算。 Norwich UniversityからExcelsior Universityまで、多くの大学が採用するAACRAO推奨の標準は、クォーター単位 ÷ 1.5 = セメスター単位です。5クォーター単位のコースは3.33セメスター単位に相当します。この換算が重要なのは、編入要件、前提科目の修了、奨学金の受給資格など、志願者が最低単位数の基準を満たしているかどうかに直接影響するからです。SISがセメスター単位を想定しているのに、換算せずにクォーター単位をインポートすると、システム内のその後のすべての単位数が誤ったものになります。
計算列を使用すると、抽出中にこの換算を自動化できます。Semester Credits (if Credit Type = Quarter then Credits ÷ 1.5 else Credits) という列を定義してください。AIが単位の種類を読み取り、計算式を適用し、換算された値をスプレッドシートに直接出力します。抽出後のExcel数式は不要です。この同じアプローチで、他の単位システムの換算(トリメスター単位 ÷ 1.17、Carnegie単位 × 大学の方針に応じた変動係数など)も処理できます。
GPAスケールの正規化。 課題となるのは、APコースに5.0を与える学校の加重GPA 3.8と、厳格な4.0スケールを使用する学校の非加重GPA 3.8が、同じ業績ではないということです。志願者を公平に比較するには、報告された生のGPAと、スケールに関する文脈情報の両方が必要です。
すべてのトランスクリプトについて、次の3つのフィールドを抽出してください:
GPA (as reported)— トランスクリプトに印刷されている数値GPA Scale— 推論列を使用:GPA Scale (options: 4.0 Unweighted, 5.0 Weighted, 4.3, 100-Point, Other)GPA Scale Max— そのスケールでの最大値(4.0、5.0、4.3、100)
これらの3つの値がスプレッドシートにあれば、入試チームはツールのブラックボックス換算に頼ることなく、大学独自の計算式でスケール間の正規化を行うことができます。一般的な方法としては、報告されたGPAをスケール最大値で割って最大値に対する割合を算出します(例:3.6/4.0 = 0.90、4.2/5.0 = 0.84)。これにより、元のデータを失うことなく、スケールをまたいだ比較が可能になります。
編入単位とダブルエンロールメントの処理。 トランスクリプトに複数の教育機関のコースが表示されている場合(編入生やダブルエンロールメントの志願者によく見られます)、どのコースがどこから来たのかを抽出で保持する必要があります。Institution (per course) という列を定義して、各行の出身校を取得します。トランスクリプトに一部のコースの横に「Columbus State Community College」と記載されている場合、AIはそれらの行をその教育機関に関連付けて列に入力できます。トランスクリプト間でレイアウトが異なる場合でも同様です。
AI抽出が入学フォーム、奨学金関連書類、標準化テストのスコアなど、より広い教育文書の領域にどのように適用されるかの概要については、教育分野におけるOCRとAI抽出の完全ガイドをご覧ください。
ステップ4:確認・検証・Excelへのエクスポート
AIを活用したツールであっても、100%の精度で全ての成績証明書を処理できる抽出ツールはありません。重要なのは、担当者がすべての行を読み直す必要がないようにしながら、人手による確認が必要なわずかな項目を検出するレビューワークフローを設計することです。これこそが、チームを強化する自動化と、新たな雑務を生み出す自動化の違いです。
信頼度に基づくレビュー。一部の抽出プラットフォームでは、AIが成績、科目名、単位数に確信を持てない低信頼度の項目にフラグを付け、人間による検証を促します。担当者は抽出されたすべての行をレビューするのではなく、フラグが付いた項目のみに集中します。フィールドレベルで95〜99%の精度であれば、成績証明書1件あたり約1〜5項目のレビューで済み、30項目以上を確認する必要はありません。15,000件の申請サイクルでは、手動検証が必要な45万項目が、フラグ付きの約22,500項目に減ります。それでも作業ではありますが、数週間ではなく数時間で完了する作業です。
クロスリファレンスによる検証。抽出データをSISにインポートする前に、2つの簡単なチェックを実行してください:
- 行数チェック:抽出された科目行の数は、成績証明書に表示されている科目数と一致していますか?4年分の成績証明書で32科目あるのに28行しか抽出されなかった場合、何かが見落とされています。典型的には、ページ区切りをまたぐ科目や、特殊なレイアウト要素が原因です。
- GPAの整合性チェック:抽出されたGPAが2.1なのに、すべての科目の成績がAまたはBである場合、GPAフィールドの読み取りミスか、考慮していないスケールが成績証明書で使用されている可能性があります。
Excelへの一括エクスポート。複数の成績証明書を1つのバッチで処理すると、ツールはすべての抽出データを1つのスプレッドシートに統合します。科目ごとに1行、ステップ2で定義したスキーマに一致する列が作成されます。出力はEllucian Banner、PeopleSoft Campus Solutions、Workday Student、またはCSVやExcelのアップロードを受け付ける任意のSISに直接インポートできる状態です。各行はファイル名列を通じて元の成績証明書にトレース可能なため、単位認定や成績評価中に疑問が生じた場合、担当者は数秒で元のPDFを取得できます。
この一括マージ機能こそが、成績証明書処理を文書単位のタスクからパイプラインへと変えるものです。1回のアップロードで50件の成績証明書を処理し、すべての科目が行として並んだ1つのスプレッドシートを取得し、登録課がすでに使用しているシステムに直接取り込むことができます。
成績証明書データ抽出におけるFERPAコンプライアンス
家庭教育権利プライバシー法(FERPA、20 U.S.C. § 1232g;34 CFR Part 99)は、教育機関に対し、学生の教育記録にアクセスできる者を管理し、情報開示先の本人確認を行うための「合理的な方法」の使用を義務付けています。成績証明書は教育記録です。処理中にこれに触れるすべての人がアクセスポイントとなり、管理と記録が必要です。
手動入力がFERPAのリスクを生む箇所。 手動ワークフローで1つの成績がSISに届くまでに、成績証明書PDFは通常、共有ネットワークドライブ(部門フォルダの権限がある誰でもアクセス可能)、メール受信箱(転送、自動保存、複数端末へのキャッシュの可能性あり)、職員のデスクトップやダウンロードフォルダを経由します。それぞれの受け渡しの時点で、文書は誰がいつアクセスしたかを記録するシステムの外に存在します。FERPAの苦情により監査が発生した場合、機関は管理の連鎖を示す必要がありますが、スプレッドシートの修正ログはアクセスログにはなりません。連邦政府によるFERPAの執行が強化され、教育省が機関にコンプライアンスの認証と積極的なデータ保護の実証を求めるようになるにつれ、「これまではこうしてきた」という慣行と実証可能なガバナンスの間のギャップは狭まっています。
自動抽出がリスク表面を減らす方法。 成績証明書データが、共有ドライブへの保存、メール添付、個別デスクトップへのダウンロードといった中間工程を経ずにファイルを直接処理する抽出ツールを通過する場合、管理されていないアクセスポイントの数は減少します。成績証明書はアップロードから構造化出力へと直接進みます。職員は学生記録の完全なPDFを扱うのではなく、抽出されたデータフィールドを確認します。また、抽出処理は暗号化されたデータ処理によるサーバーサイドで行われるため、FERPA関連のアクセスイベントは、アップロード者の認証、抽出処理、レビュー担当者のアクセスに限定され、これらはすべて記録可能です。
これはFERPAの義務をなくすものではなく、コンプライアンスワークフローの形を「すべての人的受け渡しを追跡する」から「システムアクセスポイントを管理・記録する」へと変えるものです。ほとんどの入学課にとって、後者の方が文書化、監査が容易で、偶発的な違反も起こりにくいと言えます。
よくある質問
AI抽出は手書きの成績証明書や評価にも対応しますか?
部分的に対応しています。印刷された成績データ(科目名、単位数、機関名、GPA数値)は高い精度(通常95%以上)で抽出できます。一方、手書きの注釈(カウンセラーの余白メモ、手書きで丸で囲まれた成績修正など)は困難です。最新の視覚言語モデルは、鮮明で照明の良いスキャンであれば手書き文字をある程度正確に読み取れますが、筆記体、薄い鉛筆書き、印刷文字に重なる注釈などは信頼性の低い結果になります。手書き部分が多い成績証明書の場合は、フラグが立った項目の確認時間を多めに見積もってください。
非ラテン文字を使用した国際的な成績証明書はどうですか?
ラテン文字を使用する言語(英語、スペイン語、フランス語、ドイツ語、ポルトガル語)の成績証明書は問題なく処理できます。非ラテン文字(中国語、日本語、韓国語、アラビア語、キリル文字)の成績証明書は、それらの文字セットに対応した視覚言語モデルで読み取れますが、精度は文字の複雑さや文書の品質によって異なります。米国以外の教育機関の成績評価尺度や単位システムは別の複雑さをもたらします。例えば、フランスの20点満点評価システム(16/20が優秀)は、単純な割り算で米国の4.0スケールに変換できません。このような場合は、生の値を抽出し、貴機関の国際資格評価プロセスを通じて変換を処理してください。
非公式の成績証明書や学生ポータルのスクリーンショットからデータを抽出できますか?
はい — AIは公式の印鑑の有無にかかわらず、存在する視覚コンテンツを読み取ります。ただし、入学審査の決定には、最終的に検証用の公式成績証明書が必要になります。実用的なワークフローとしては、非公式の成績証明書やスクリーンショットを予備評価(選別、初期GPA推定、迅速審査対象者の特定)に使用し、その後、同じ抽出パイプラインで公式成績証明書を処理してSISに最終データを入力します。非公式バッチと公式バッチは分けて管理し、抽出データが混在しないようにしてください。
これはParchment Data AutomationやSoftdocs ITPとどう違うのですか?
Parchment Receive Premium + Data AutomationやSoftdocs Intelligent Transcript Processingは、大量の成績証明書処理に特化し、SIS/CRMと直接統合できるように設計されています。これらは、1サイクルあたり10,000件以上の出願を処理し、専任のITサポートとエンタープライズ契約の予算がある大学に適した選択肢です。このガイドで説明するアプローチ(軽量でテンプレート不要のAI抽出ツールを使用)は、異なるユースケース、すなわち小規模な入学事務局、コミュニティカレッジの単位認定、学部の大学院入試、またはエンタープライズプラットフォームがボリュームや予算に対して過剰であるあらゆるシナリオに対応します。どちらのアプローチも手動データ入力という同じ問題を解決しますが、規模、統合の深さ、コスト構造が異なります。
セキュリティ制限やパスワード保護のあるPDFでも動作しますか?
いいえ。パスワード保護やDRM制限のあるPDFは、抽出前にロックを解除する必要があります。ParchmentやNational Student Clearinghouseなどのサービスからのほとんどの公式電子成績証明書は、標準的な保護されていないPDFとして届きます。ロックされたPDFに遭遇した場合は、発行元の機関の教務課に連絡してください。制限のないバージョンや代替の配信方法を提供してもらえます。
成績証明書抽出の実際の精度はどのくらいですか?
印刷された成績証明書データ(科目名、成績、単位、機関名、日付、GPA)のフィールドレベルの精度は、スキャン品質、レイアウトの複雑さ、および成績証明書に異常な書式要素(複数列の科目一覧、分割ページデザイン、テキスト上の透かし)が含まれているかどうかに応じて、通常95%から99%の範囲です。テキサス大学オースティン校は、自動成績証明書データ抽出を採用した後、95%以上の精度とスタッフの処理時間の70%削減を報告しています。残りの1〜5%のフィールド(通常、異常な略語、高度に圧縮されたレイアウト、または文書の端近くに印刷されたテキストを含む)は、信頼度ベースのレビューワークフローが捕捉するように設計されています。これは人間の判断を置き換えるツールではなく、人間の判断が必要な領域を減らすツールです。