Como Extrair Dados de Histórico Escolar
para Excel — Um Guia Passo a Passo para Admissões
Os dados da pesquisa de membros da AACRAO confirmam o que todo diretor de admissões sabe: digitar manualmente um único histórico escolar do ensino médio em um sistema de informações de estudantes leva 20 minutos ou mais. Em uma universidade de médio porte que processa 15.000 inscrições por ciclo, isso representa 5.000 horas de equipe — aproximadamente três funcionários em tempo integral fazendo nada além de ler PDFs e digitar. No entanto, a dificuldade mais profunda não é o volume. É que cada histórico conta a mesma história — disciplinas, notas, créditos, GPA — em uma linguagem visual diferente, de um sistema acadêmico diferente, muitas vezes usando uma escala de notas que não corresponde à sua. O gargalo não é a velocidade de entrada de dados. É a lacuna semântica entre como um histórico apresenta as informações e como seu SIS precisa recebê-las.
Principais Conclusões
- Quinze mil inscrições por ciclo consomem 5.000 horas de tempo de equipe redigitando notas que já existem na página, o equivalente a três funcionários em tempo integral fazendo nada além disso.
- O OCR lê os caracteres "B+" de um histórico, mas não pode dizer que essa nota significa 3,3 em uma escola e 87 em outra, e nenhuma equipe de admissões pode criar e manter modelos de análise para todas as 2.000+ instituições remetentes.
- Defina suas colunas de saída desejadas uma vez e deixe a IA semântica entender o significado acadêmico de cada histórico, preenchendo sua planilha independentemente de qual das 2.000+ escolas enviou o documento.
O Que Torna os Dados de Histórico Escolar Diferentes de Qualquer Outro Documento
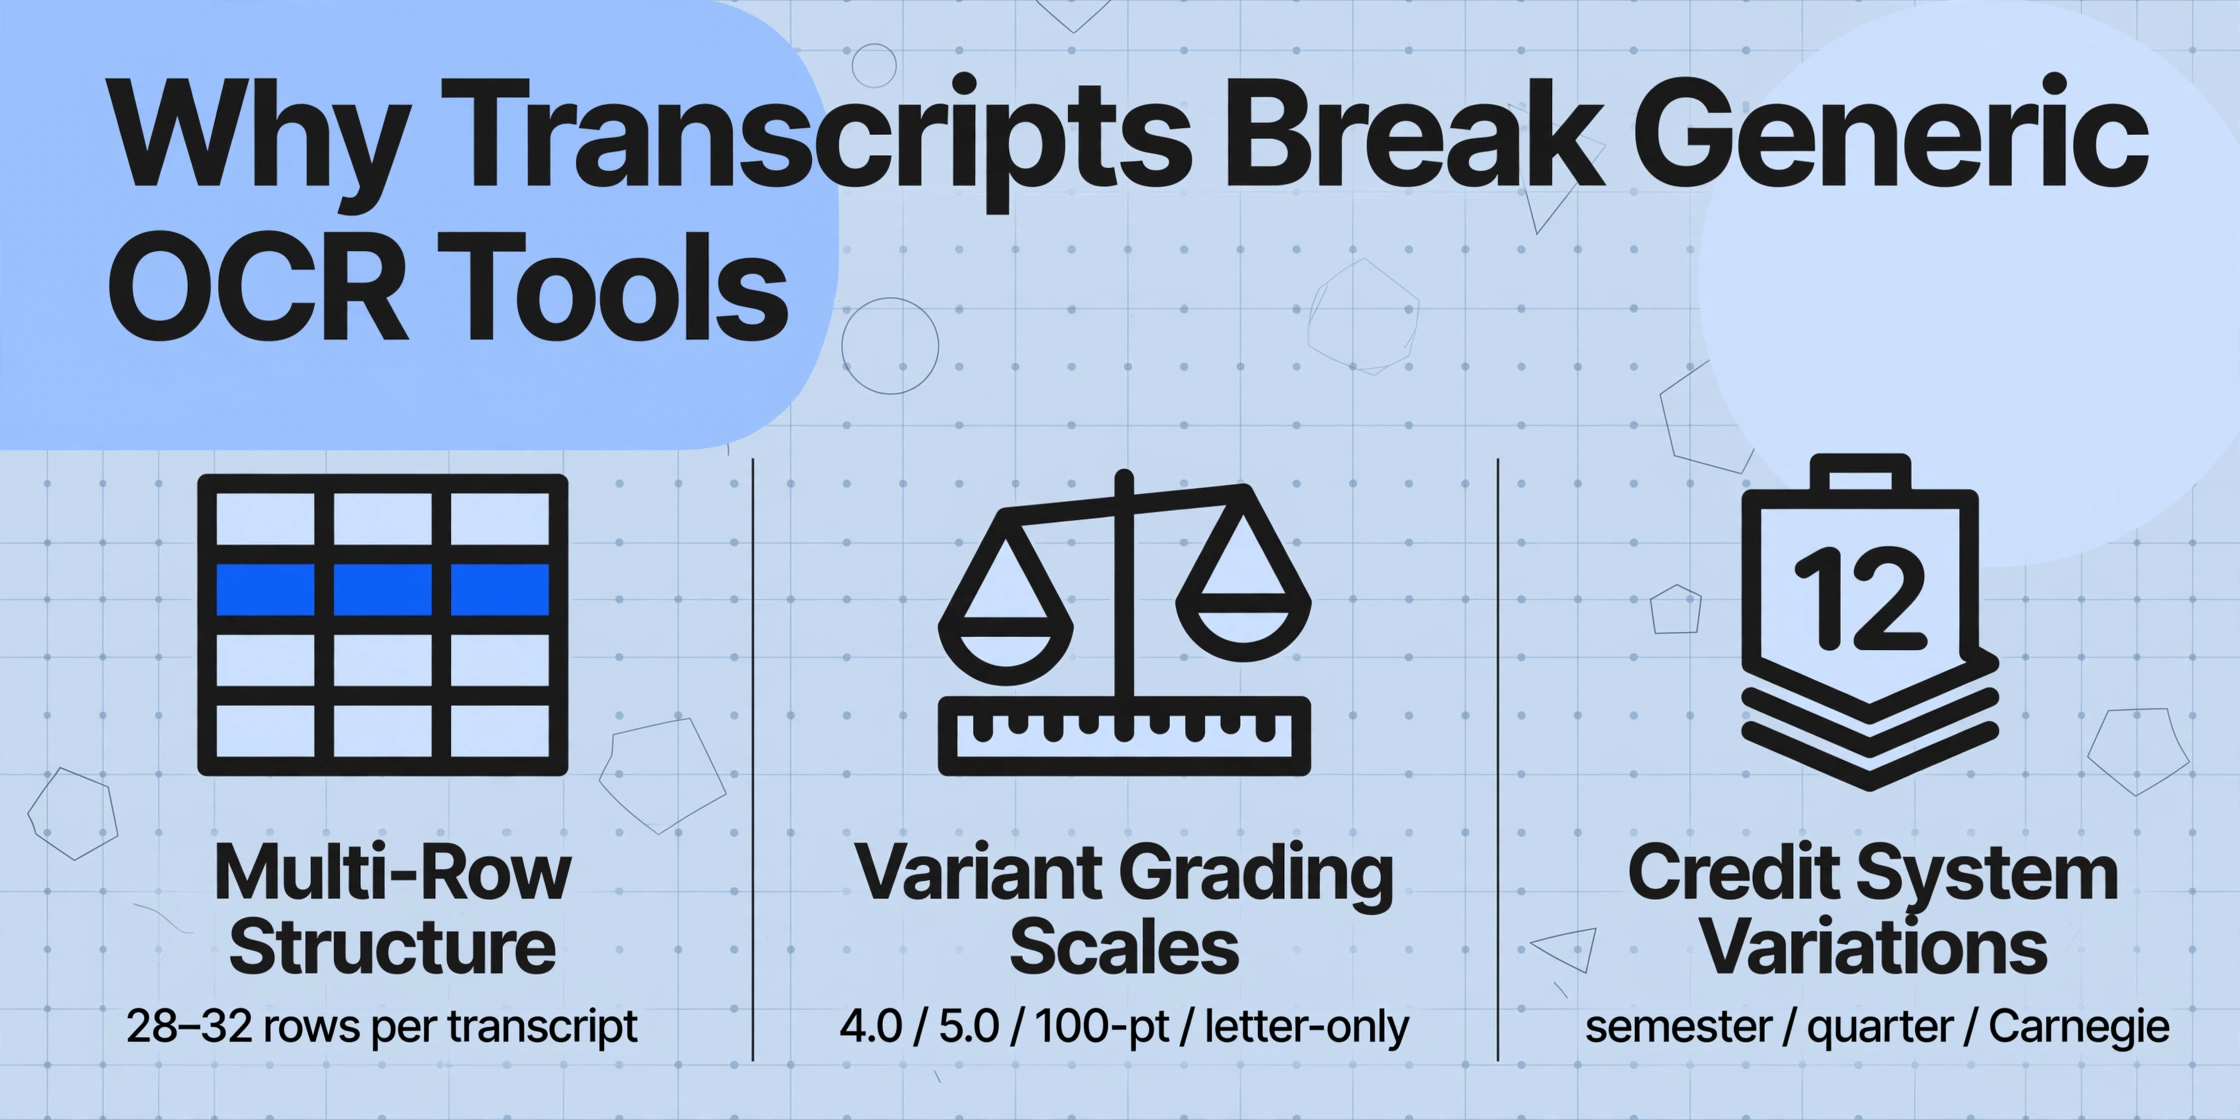
A maioria dos desafios de extração de documentos compartilha um formato comum: encontrar o número da fatura, encontrar a data, encontrar o total — campos que aparecem uma vez na página. Históricos escolares quebram esse padrão de três maneiras que explicam por que ferramentas genéricas de OCR têm dificuldade e por que abordagens baseadas em modelos colapsam diante da variedade de formatos.
Listagens de cursos multilinha. Um histórico escolar não é um formulário com campos de instância única. É uma tabela — às vezes abrangendo várias páginas — onde cada linha representa um curso com seu próprio nome, nota, créditos e período. Um histórico escolar de ensino médio de quatro anos contém de 28 a 32 linhas de cursos. O histórico combinado de um aluno transferido pode exceder 60 linhas em múltiplas instituições anteriores. Extrair os dados certos da linha certa é um desafio estrutural para o qual o OCR em nível de pixel nunca foi projetado.
Escalas de notas variadas. As instituições relatam desempenho em pelo menos quatro escalas comuns: 4.0 sem ponderação, 5.0 ponderado (AP/IB recebe +1.0, Honors recebe +0.5), porcentagem de 100 pontos e somente letras sem equivalentes numéricos. Um "B+" significa 3.3 em uma escala 4.0 em uma escola, 87–89% em outra, e um valor completamente diferente em uma escala 4.3 (usada por Stanford e várias outras). Históricos internacionais adicionam faixas percentuais, sistemas baseados em classificação e pontuações de exames nacionais que não mapeiam claramente para nenhuma escala dos EUA. Simplesmente ler os caracteres "B+" de uma página não lhe dá nada útil — você precisa saber o que essa nota significa no contexto da instituição avaliadora.
Variações de sistema de créditos e designações de cursos. Créditos semestrais, créditos trimestrais (onde 5 horas trimestrais = 3.33 horas semestrais conforme a conversão padrão ÷1.5), unidades trimestrais e unidades Carnegie coexistem no mesmo grupo de candidatos. Além da contagem de créditos, as designações em nível de curso carregam significado relevante para admissões: Advanced Placement, International Baccalaureate, matrícula dupla, honras, créditos de transferência de instituição anterior, cursos remediais. Cada designação afeta como o curso deve ser ponderado no cálculo do GPA e se ele satisfaz requisitos de pré-requisitos. Uma ferramenta de extração de históricos que lhe dá "4.0 créditos" sem informar que são "4.0 créditos trimestrais de AP Calculus" forneceu dados enganosos.
É por isso que a American Association of Collegiate Registrars and Admissions Officers (AACRAO) — representando mais de 18.000 profissionais em aproximadamente 2.300 instituições — investiu décadas na padronização de práticas de históricos escolares por meio do seu Academic Record and Transcript Guide. E é por isso que o National Student Clearinghouse Electronic Transcript Exchange (ETX) agora conecta quase 2.000 instituições para troca gratuita e segura de históricos em formatos PDF, XML e EDI. A infraestrutura para transmissão eletrônica de históricos existe. A lacuna restante é transformar o documento transmitido em dados estruturados que seu SIS possa consumir — sem que um funcionário digite cada campo.
A OCR tradicional lê caracteres. A extração semântica com IA — a abordagem que abordamos neste guia — lê o significado acadêmico. Ela entende que "AP Calc BC" em um histórico e "Calculus BC (Advanced Placement)" em outro são a mesma categoria de curso. Ela consegue distinguir uma nota de curso de uma média geral acumulada na mesma página. E pode fazer isso sem exigir que você crie e mantenha um modelo de análise para cada instituição de envio. Para mais detalhes sobre a distinção tecnológica subjacente, consulte nosso guia sobre o que a OCR realmente entende — e o que não entende.
Etapa 1: Prepare seus históricos para extração
O que você insere na ferramenta de extração determina o que você obtém. Três decisões de preparação fazem uma diferença mensurável na qualidade da saída.
Resolução de digitalização. Se você trabalha com históricos em papel que chegam pelo correio, digitalize com resolução mínima de 300 DPI. A San Diego State University, que processa mais de 31.000 históricos universitários por ano (82% via EDI, 18% via OCR de papel), padroniza 300 DPI com saída em tons de cinza. A digitalização em preto e branco perde o contraste sutil que distingue o título de um curso da coluna de notas em layouts de históricos compactos. A digitalização colorida preserva o máximo de informações, mas aumenta o tamanho do arquivo sem ganho significativo de precisão para a maioria dos formatos de histórico.
Alinhamento e orientação da página. Os históricos quase sempre estão em orientação retrato, mas páginas digitalizadas costumam chegar levemente rotacionadas. Mesmo uma inclinação de 2 graus pode fazer a OCR tradicional errar o alinhamento das colunas — ela confunde qual nota pertence a qual curso. Se o seu software de digitalização oferecer correção automática de inclinação, ative-a. Para PDFs já digitalizados, a maioria das ferramentas de extração lida com a rotação internamente, mas se você notar erros sistemáticos em um lote, verifique a rotação dos PDFs de origem antes de investigar a lógica de extração.
Organização em lotes. Agrupe os históricos por prioridade de processamento antes do upload. Se você está avaliando créditos de transferência, separe os históricos que exigem revisão de articulação dos arquivos simples de admissão de calouros — o fluxo de revisão difere. Nomeie seus arquivos de forma consistente: [Sobrenome]_[Nome]_[Instituição].pdf. Essa convenção de nomenclatura permite cruzar os dados extraídos com o arquivo de origem durante a validação, sem abrir cada um.
Se o seu escritório recebe históricos principalmente pelo National Student Clearinghouse ETX ou Parchment, você já está recebendo PDFs digitais — pule a etapa de digitalização e prossiga diretamente para a extração. Para mais informações sobre como otimizar a qualidade da imagem antes da extração, consulte nosso guia prático para melhorar a precisão da OCR.
Etapa 2: Defina Suas Colunas de Extração
É aqui que a abordagem de extração se diferencia de tudo que uma ferramenta baseada em modelos faz — e é a etapa que determina se você obtém dados utilizáveis ou uma bagunça. Em um fluxo baseado em modelos, você desenharia retângulos ao redor de campos em uma amostra de histórico escolar de cada instituição remetente. Com mais de 2.000 escolas de ensino médio e 4.000 faculdades só nos EUA, essa abordagem não escala.
A extração semântica funciona de forma diferente. Em vez de dizer à ferramenta onde procurar, você diz o que deseja — nomeando as colunas que se tornarão os cabeçalhos da sua planilha de saída. A IA lê cada histórico escolar, entende o significado acadêmico do texto que encontra e mapeia os valores para as colunas que você definiu. É isso que o ImageToTable.ai chama de Extração Personalizada de Colunas: você define o esquema de saída uma vez, e a ferramenta o aplica a todos os históricos do seu lote, independentemente das diferenças de formatação.
Aqui está um esquema de colunas que cobre os dados essenciais que a maioria das admissões precisa:
| Nome da Coluna | O Que Extrai | Observações |
|---|---|---|
Nome do Aluno | Nome completo conforme impresso no histórico | Conferir com o registro da candidatura para verificação |
Nome da Instituição | Escola de ensino médio ou faculdade emissora | Usar para análise de escolas de origem e contexto do GPA |
Nome do Curso | Título completo do curso | Ex.: "AP English Literature & Composition" |
Nota | Nota em letra ou numérica conforme exibida | Extrair valor bruto; conversão tratada na Etapa 3 |
Créditos | Horas de crédito ou unidades obtidas | Observar o tipo de sistema de crédito (semestre/trimestre/Carnegie) |
Período | Semestre, trimestre ou ano | Ex.: "Fall 2024", "Spring 2025" |
GPA | GPA acumulado conforme informado | Escala varia; observar se é ponderado ou não ponderado |
Nível do Curso | Regular, Honors, AP, IB, Dupla Matrícula, Transferência | Usar uma coluna inferida com lista de opções |
A última coluna — Nível do Curso — não é um campo que aparece explicitamente na maioria dos históricos. Ela exige que a IA infira a classificação a partir do contexto: "AP" no nome do curso, uma coluna separada de designação "Honors" ou uma notação de dupla matrícula. Esta é uma coluna inferida — a IA lê o documento e raciocina sobre a categoria de cada curso com base nas evidências presentes, mesmo que o histórico nunca imprima as palavras "AP" ou "Honors" em um campo isolado. Você especifica a lógica de inferência incluindo opções na definição da coluna: Nível do Curso (opções: Regular, Honors, AP, IB, Dupla Matrícula, Transferência, Remediação).
Para avaliação de transferência de créditos, adicione estas colunas para capturar detalhes relevantes à articulação:
| Nome da Coluna | Finalidade |
|---|---|
Código do Curso | Prefixo do departamento + número (ex.: "MATH 2413") para consulta de equivalência |
Tipo de Crédito | Semestre / Trimestre / Quadrimestre / Carnegie — determina a fórmula de conversão |
Instituição de Origem | Se o crédito foi obtido em outra instituição e transferido, o nome da instituição original |
Os nomes de colunas que você digita são os cabeçalhos de coluna na sua saída final do Excel. Você está definindo o formato de saída — a IA descobre como preenchê-lo a partir do que quer que chegue no lote.
Etapa 3: Lidar com Escalas de GPA e Conversão de Créditos
Extrair os valores brutos de notas e créditos é metade do trabalho. Tornar esses valores comparáveis entre candidatos exige conversão — e é aqui que a maioria dos fluxos de trabalho manuais introduz erros que se acumulam silenciosamente pelo pipeline de admissões.
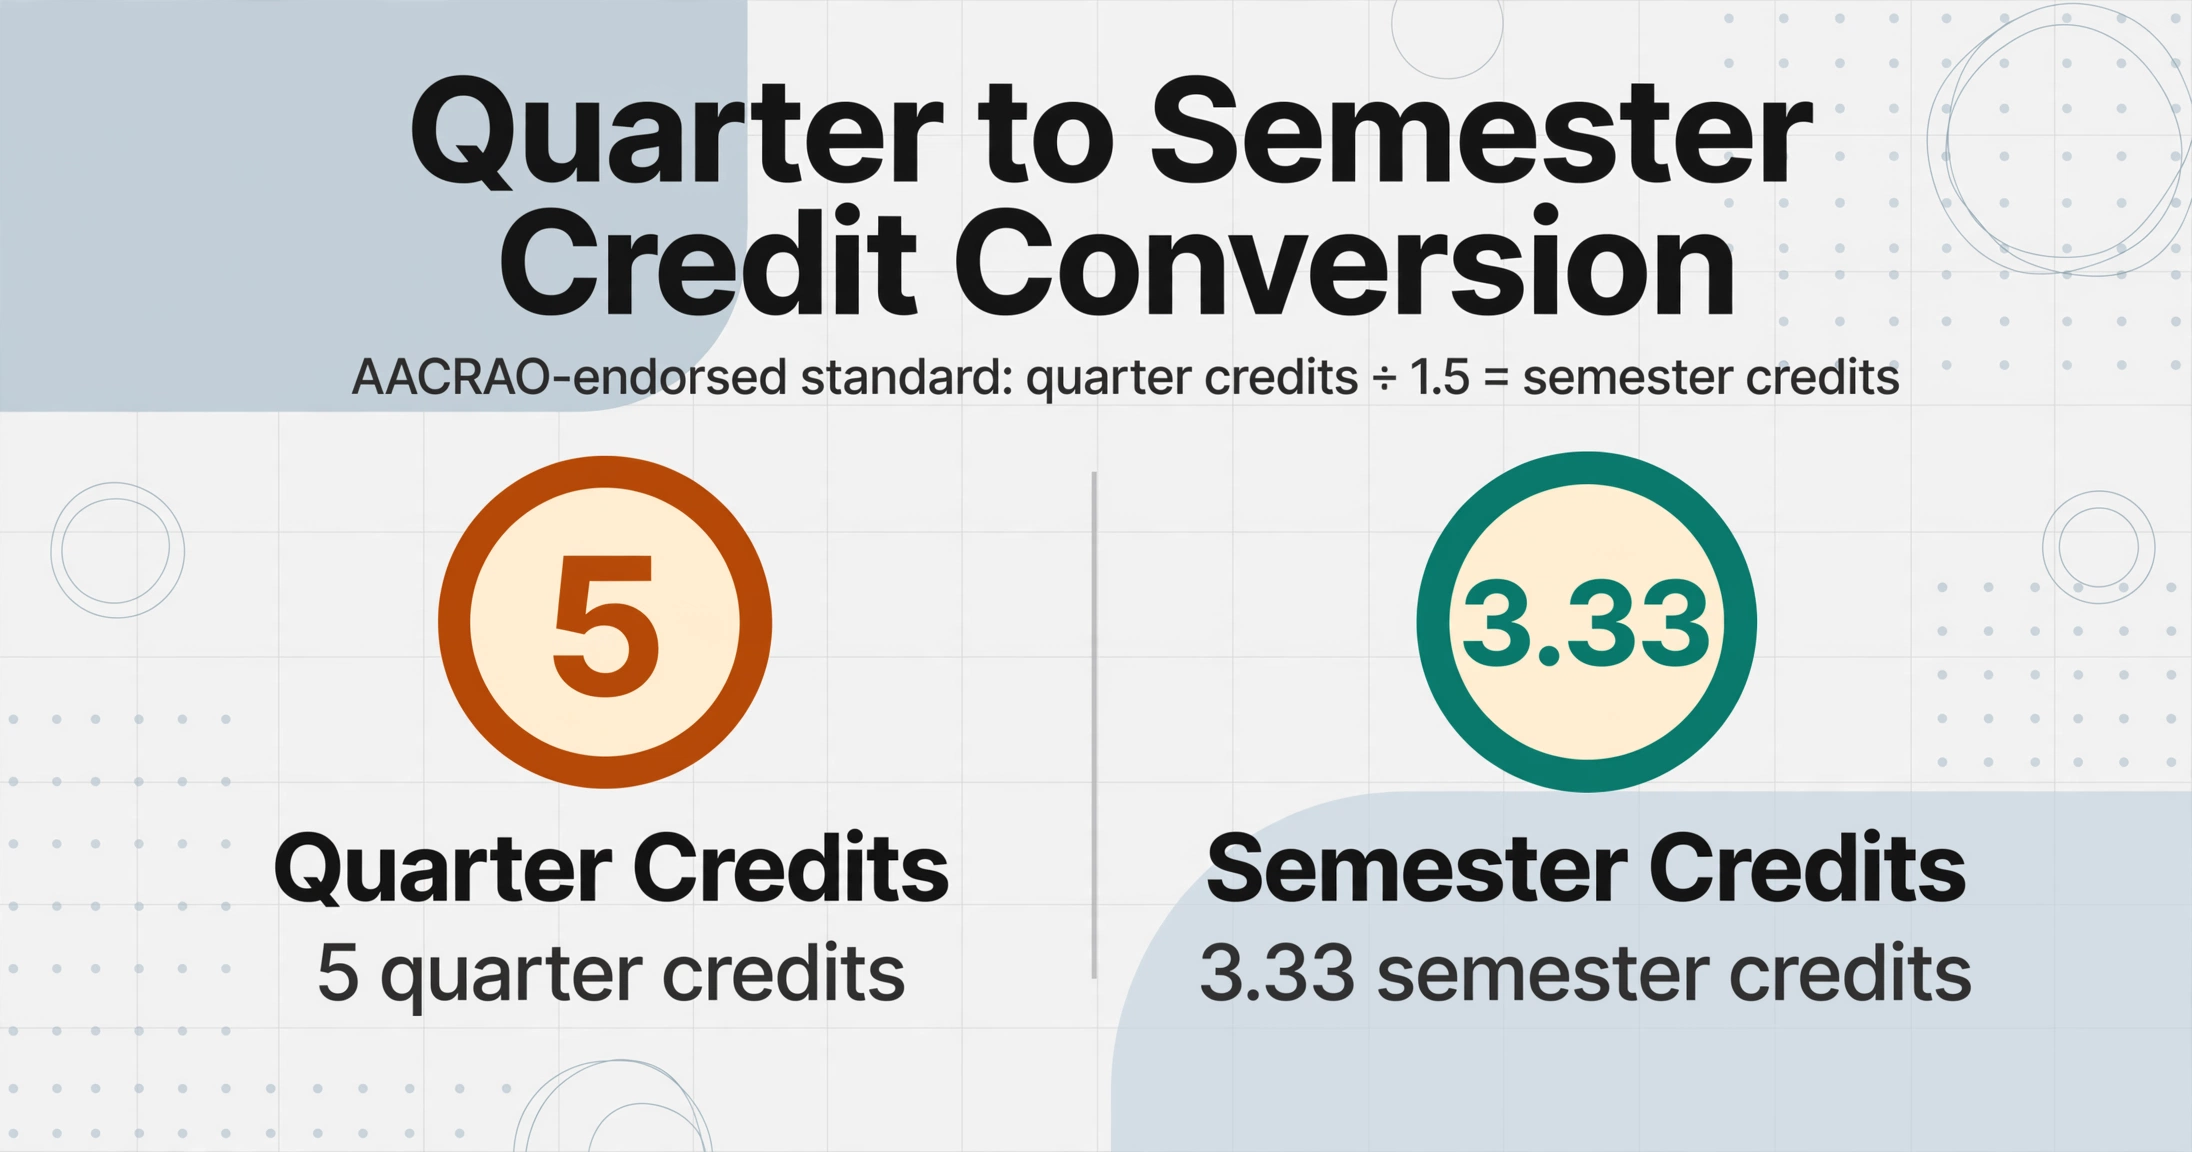
Conversão de créditos de trimestre para semestre. O padrão endossado pela AACRAO, adotado por instituições da Norwich University à Excelsior University, é: créditos de trimestre ÷ 1,5 = créditos de semestre. Um curso que vale 5 créditos de trimestre equivale a 3,33 créditos de semestre. Essa conversão importa porque afeta diretamente se um candidato atende aos limites mínimos de créditos para admissão por transferência, conclusão de pré-requisitos e elegibilidade para auxílio financeiro. Se o seu SIS espera créditos de semestre e você importa créditos de trimestre sem conversão, todo total de créditos subsequente no sistema estará errado.
Com uma coluna calculada, você pode automatizar essa conversão durante a extração. Defina uma coluna chamada Créditos de Semestre (se Tipo de Crédito = Trimestre, então Créditos ÷ 1,5, senão Créditos) — a IA lê o tipo de crédito, aplica a fórmula e gera o valor convertido diretamente na sua planilha. Sem necessidade de fórmula Excel pós-extração. Essa mesma abordagem lida com outras conversões de sistemas de crédito: créditos de trimestre ÷ 1,17, unidades Carnegie × multiplicadores variáveis dependendo da política da sua instituição.
Normalização da escala de GPA. O desafio é que um GPA ponderado de 3,8 de uma escola que atribui 5,0 para cursos AP não é a mesma conquista que um GPA não ponderado de 3,8 de uma escola que usa uma escala estrita de 4,0. Para comparar candidatos de forma justa, você precisa tanto do GPA bruto conforme relatado quanto de informações contextuais sobre a escala.
Extraia estes três campos de cada histórico:
GPA (conforme relatado)— o número impresso no históricoEscala de GPA— use uma coluna inferida:Escala de GPA (opções: 4,0 Não Ponderado, 5,0 Ponderado, 4,3, 100 Pontos, Outro)Máximo da Escala de GPA— o máximo possível nessa escala (4,0, 5,0, 4,3, 100)
Com esses três valores na sua planilha, sua equipe de admissões pode normalizar entre escalas usando a fórmula da própria instituição, em vez de confiar na conversão de caixa-preta de uma ferramenta. Uma abordagem comum: dividir o GPA relatado pelo máximo da escala para obter uma pontuação de porcentagem do máximo (ex.: 3,6/4,0 = 0,90, 4,2/5,0 = 0,84), o que permite comparação entre escalas sem perder os dados originais.
Lidando com créditos de transferência e matrícula dupla. Quando um histórico mostra cursos de múltiplas instituições — comum para alunos transferidos e candidatos com matrícula dupla — a extração precisa preservar quais cursos vieram de onde. Defina uma coluna para Instituição (por curso) para capturar a escola de origem de cada linha. Se o histórico listar "Columbus State Community College" ao lado de um subconjunto de cursos, a IA pode associar essas linhas àquela instituição e preencher a coluna de acordo, mesmo quando o layout varia entre históricos.
Para uma visão geral de como a extração por IA se aplica ao panorama mais amplo de documentos educacionais — incluindo formulários de inscrição, cartas de ajuda financeira e resultados de testes padronizados — consulte nosso guía completo de OCR e extração por IA para educação.
Etapa 4: Revisar, Validar e Exportar para Excel
Nenhuna ferramenta de extração — com IA ou não — alcanza 100% de precisão em 100% dos transcriptos. A chave está em desenhar um fluxo de revisão que capture a pequena fração de campos que precisan atenção humana, sem obrigar a equipe a reler cada linha. Essa é a diferença entre automação que amplia sua equipe e automação que cria um novo tipo de trabalho mecánico.
Revisão baseada em confianza. Algumas plataformas de extração marcan campos de baixa confianza — valores onde a IA não está segura sobre uma nota, um nome de curso ou uma contagem de créditos — para verificação humana. Em vez de revisar cada linha extraída, a equipe se concentra apenas nos itens marcados. Com 95–99% de precisão a nível de campo, isso significa revisar aproximadamente 1 a 5 campos por transcripto, em vez de 30+. Um ciclo de 15.000 solicitudes passa de 450.000 campos a verificar manualmente a tal vez 22.500 campos marcados — ainda é trabalho, mas trabalho medido em horas, não em semanas.
Validação por referência cruzada. Antes de importar os dados extraídos ao seu SIS, execute duas verificações rápidas:
- Verificación de contagem de filas: O número de filas de cursos extraídas coincide com o número de cursos visibles no transcripto? Se um transcripto de quatro anos com 32 cursos produjo apenas 28 filas, algo foi omitido — geralmente um curso que atraviesa um salto de página ou um elemento de layout pouco comum.
- Verificación de coherencia do GPA: Se o GPA extraído é 2,1, mas cada nota de curso é A ou B, ou o campo de GPA foi mal lido ou o transcripto usa uma escala que você não considerou.
Exportación em lote para Excel. Quando você processa vários transcriptos em um único lote, a ferramenta combina todos os dados extraídos em uma única planilha — uma fila por curso, com colunas que coinciden com o esquema definido na Etapa 2. A saída está pronta para importação direta em Ellucian Banner, PeopleSoft Campus Solutions, Workday Student ou qualquer SIS que aceite uploads CSV ou Excel. Cada fila é rastreable até seu transcripto de origem através da columna de nome de arquivo, de modo que, se surgir uma pregunta durante a auditoría de títulos ou a avaliação de créditos, a equipe pode recuperar o PDF original em segundos.
Essa capacidade de combinar em lote é o que transforma o processamento de transcriptos de uma tarefa por documento em um pipeline. Processe 50 transcriptos em um único upload, obtenha uma planilha com cada curso em uma fila e alimente diretamente o sistema que seu registrador já usa.
Conformidade com a FERPA na Extração de Dados de Histórico Escolar
A Lei de Direitos Educacionais e Privacidade da Família (FERPA, 20 U.S.C. § 1232g; 34 CFR Part 99) exige que instituições de ensino utilizem "métodos razoáveis" para controlar quem pode acessar registros educacionais dos alunos e autenticar a identidade das partes que recebem essas informações. Um histórico escolar é um registro educacional. Cada pessoa que o manipula durante o processamento é um ponto de acesso que deve ser controlado e documentado.
Onde a entrada manual cria exposição à FERPA. Antes que uma única nota chegue ao seu SIS por meio de um fluxo manual, o PDF do histórico escolar geralmente passa por: uma unidade de rede compartilhada (acessível a qualquer pessoa com permissões de pasta do departamento), uma caixa de entrada de e-mail (potencialmente encaminhada, salva automaticamente ou armazenada em cache em vários dispositivos) e a área de trabalho ou pasta de downloads de um funcionário. Em cada transferência, o documento existe fora de um sistema que registra quem o acessou e quando. Se uma reclamação da FERPA desencadear uma auditoria, a instituição deve demonstrar uma cadeia de custódia — e um registro de correções em uma planilha não constitui um registro de acesso. Com o aumento da fiscalização federal da FERPA, o Departamento de Educação exigindo que as instituições certifiquem a conformidade e demonstrem proteções proativas de dados, a lacuna entre "sempre fizemos assim" e uma governança demonstrável se estreitou.
Como a extração automatizada reduz a superfície de exposição. Quando os dados do histórico escolar fluem por uma ferramenta de extração que processa arquivos diretamente — sem salvamentos intermediários em unidades compartilhadas, sem anexos de e-mail, sem download para computadores individuais — o número de pontos de acesso não controlados diminui. O histórico escolar vai do upload ao resultado estruturado. A equipe revisa campos de dados extraídos em vez de manusear o PDF completo do registro do aluno. E como o processo de extração é feito no servidor com tratamento criptografado de dados, os eventos de acesso relevantes para a FERPA se tornam: autenticação do uploader, processamento da extração e acesso do revisor — todos os quais podem ser registrados.
Isso não elimina as obrigações da FERPA — muda a forma do fluxo de conformidade de "rastrear cada transferência humana" para "controlar e registrar pontos de acesso do sistema". Para a maioria dos escritórios de admissão, a última opção é mais fácil de documentar, mais fácil de auditar e mais difícil de violar acidentalmente.
Perguntas Frequentes
A extração por IA funciona em transcrições ou notas manuscritas?
Parcialmente. Dados de transcrições impressas — nomes de cursos, horas de crédito, nomes de instituições, notas de GPA — são extraídos com alta precisão (normalmente acima de 95%). Anotações manuscritas — um comentário de um conselheiro na margem, uma correção de nota circulada à mão — são mais difíceis. Modelos modernos de visão e linguagem conseguem ler manuscritos com precisão razoável em digitalizações claras e bem iluminadas, mas letra cursiva, marcas de lápis leves ou anotações que se misturam ao texto impresso geram resultados de menor confiança. Para transcrições com conteúdo manuscrito significativo, reserve tempo extra para revisão dos campos sinalizados.
E quanto a transcrições internacionais com alfabetos não latinos?
Transcrições em idiomas que usam o alfabeto latino (inglês, espanhol, francês, alemão, português) são processadas de forma confiável. Transcrições em alfabetos não latinos (chinês, japonês, coreano, árabe, cirílico) podem ser lidas por modelos de visão e linguagem que suportam esses conjuntos de caracteres, mas a precisão varia conforme a complexidade do alfabeto e a qualidade do documento. Escalas de notas e sistemas de crédito de instituições não americanas adicionam uma camada extra de complexidade — um sistema de notas francês de 20 pontos (onde 16/20 é excelente) não se traduz para uma escala americana de 4,0 por simples divisão. Nesses casos, extraia os valores brutos e realize a conversão por meio do processo de avaliação de credenciais internacionais da sua instituição.
Posso extrair dados de transcrições não oficiais ou capturas de tela do portal do aluno?
Sim — a IA lê qualquer conteúdo visual presente, independentemente de o documento ter um selo oficial. No entanto, para decisões de admissão, você precisará da transcrição oficial para verificação. Um fluxo de trabalho prático: use transcrições não oficiais ou capturas de tela para avaliação preliminar (classificação, estimativa inicial de GPA, identificação de candidatos para revisão acelerada) e, em seguida, processe as transcrições oficiais pelo mesmo pipeline de extração para a entrada final de dados no SIS. Apenas mantenha os lotes oficiais e não oficiais separados para que os dados extraídos nunca sejam confundidos entre os dois.
Como isso se compara ao Parchment Data Automation ou Softdocs ITP?
O Parchment Receive Premium + Data Automation e o Softdocs Intelligent Transcript Processing são soluções desenvolvidas para processamento institucional de histórico escolar em alto volume, com integração direta a SIS/CRM. São a escolha certa para universidades que processam mais de 10.000 inscrições por ciclo, com suporte de TI dedicado e orçamento para contratos empresariais. A abordagem descrita neste guia — usando uma ferramenta de extração por IA leve e sem modelo — atende a um caso de uso diferente: escritórios de admissão menores, avaliação de transferência de faculdades comunitárias, admissão departamental de pós-graduação ou qualquer cenário onde uma plataforma empresarial seja exagerada para o volume e orçamento. Ambas as abordagens resolvem o mesmo problema de entrada manual de dados; diferem em escala, profundidade de integração e estrutura de custos.
Isso funciona com PDFs que têm restrições de segurança ou proteção por senha?
Não. PDFs protegidos por senha ou com restrições DRM devem ser desbloqueados antes da extração. A maioria dos históricos escolares eletrônicos oficiais de serviços como Parchment e National Student Clearinghouse chegam como PDFs padrão, sem proteção. Se você encontrar um PDF bloqueado, entre em contato com o escritório do registrador da instituição emissora — eles podem fornecer uma versão sem restrições ou um método de entrega alternativo.
Qual é a taxa de precisão real para extração de histórico escolar?
A precisão em nível de campo para dados de histórico escolar impresso — nomes de cursos, notas, créditos, nomes de instituições, datas, GPA — geralmente varia de 95% a 99%, dependendo da qualidade da digitalização, complexidade do layout e se o histórico contém elementos de formatação incomuns (listagens de cursos em várias colunas, designs de página dividida, marcas d'água sobre o texto). A Universidade do Texas em Austin, após adotar a extração automatizada de dados de histórico escolar, relatou precisão acima de 95% com uma redução de 70% no tempo de processamento da equipe. Os 1–5% restantes dos campos — geralmente envolvendo abreviações incomuns, layouts fortemente compactados ou texto impresso próximo às bordas do documento — são o que o fluxo de revisão baseado em confiança foi projetado para capturar. Esta não é uma ferramenta que substitui o julgamento humano; é uma ferramenta que reduz a área onde o julgamento humano é necessário.