So extrahieren Sie Studententranskriptdaten
in Excel – Eine Schritt-für-Schritt-Anleitung für die Zulassung
Die Mitgliederbefragung von AACRAO bestätigt, was jeder Zulassungsleiter weiß: Das manuelle Erfassen eines einzelnen Highschool-Transkripts in ein Studenteninformationssystem dauert 20 Minuten oder mehr. Bei einer mittelgroßen Universität, die 15.000 Bewerbungen pro Zyklus verarbeitet, sind das 5.000 Mitarbeiterstunden – etwa drei Vollzeitkräfte, die nichts anderes tun, als PDFs zu lesen und zu tippen. Doch die eigentliche Schwierigkeit ist nicht das Volumen. Es ist die Tatsache, dass jedes Transkript dieselbe Geschichte – Kurse, Noten, Credits, GPA – in einer anderen visuellen Sprache erzählt, aus einem anderen akademischen System, oft mit einer Notenskala, die nicht der eigenen entspricht. Der Engpass ist nicht die Geschwindigkeit der Dateneingabe. Es ist die semantische Lücke zwischen der Darstellung der Informationen im Transkript und dem Format, das Ihr SIS benötigt.
Wichtigste Erkenntnisse
- Fünfzehntausend Bewerbungen pro Zyklus verbrauchen 5.000 Stunden Personalzeit für das erneute Abtippen von Noten, die bereits auf der Seite stehen – das entspricht drei Vollzeitkräften, die nichts anderes tun.
- OCR liest die Zeichen „B+“ von einem Transkript, kann Ihnen aber nicht sagen, dass diese Note an einer Highschool 3,3 und an einer anderen 87 bedeutet, und kein Zulassungsteam kann Parsing-Vorlagen für alle 2.000+ sendenden Institutionen erstellen und pflegen.
- Definieren Sie Ihre gewünschten Ausgabespalten einmal und lassen Sie semantische KI die akademische Bedeutung jedes Transkripts verstehen und Ihre Tabelle befüllen – unabhängig davon, welche der 2.000+ Schulen das Dokument gesendet hat.
Was Transkriptdaten von anderen Dokumenten unterscheidet
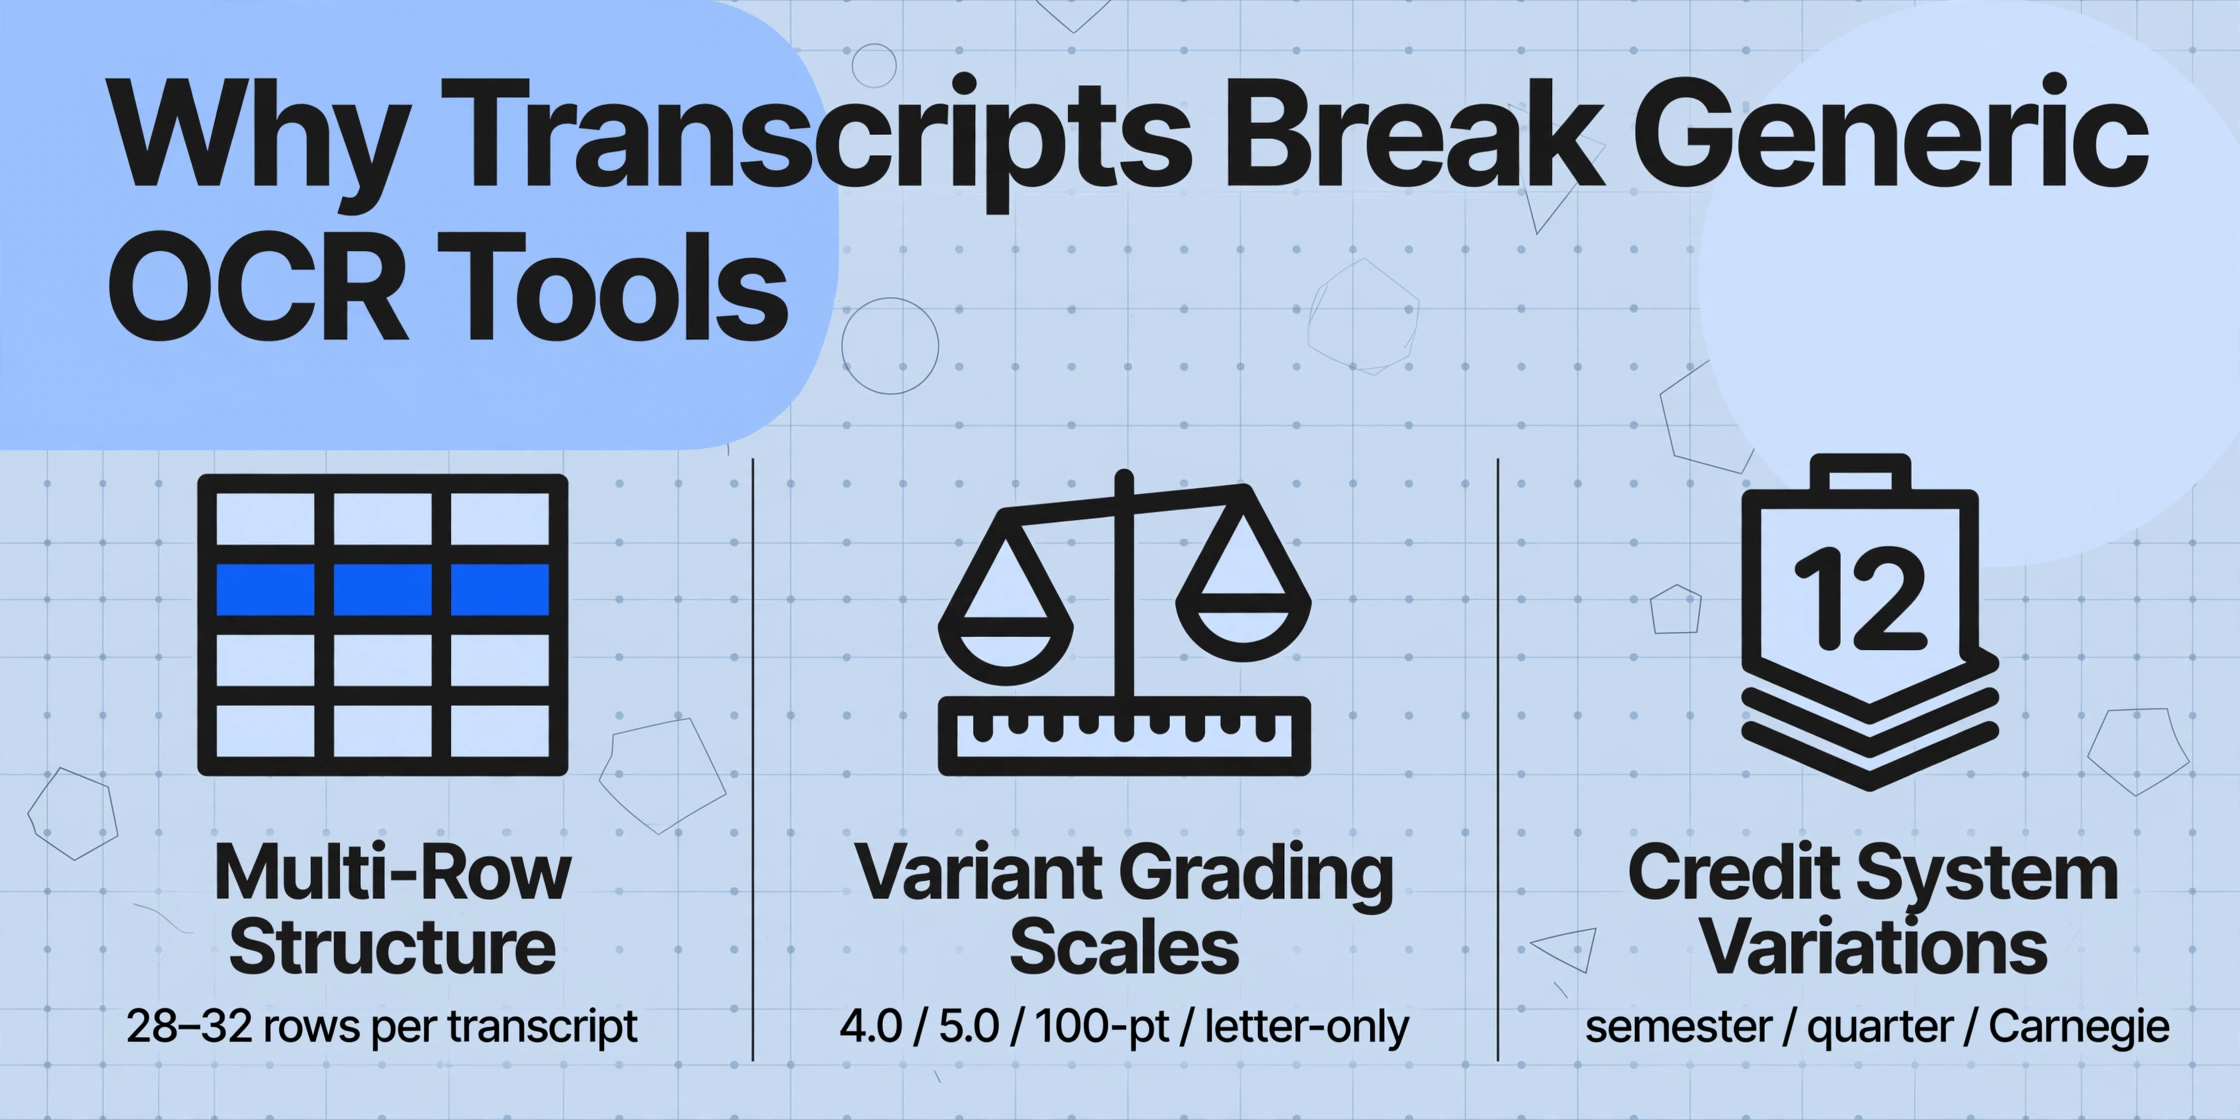
Die meisten Dokumentextraktions-Herausforderungen folgen einem gemeinsamen Muster: Rechnungsnummer finden, Datum finden, Summe finden – Felder, die einmal auf einer Seite vorkommen. Transkripte brechen mit diesem Muster auf drei Arten, was erklärt, warum generische OCR-Tools scheitern und warum vorlagenbasierte Ansätze an der Formatvielfalt zerbrechen.
Mehrzeilige Kursauflistungen. Ein Transkript ist kein Formular mit Einzelfeldern. Es ist eine Tabelle – manchmal über mehrere Seiten –, in der jede Zeile einen Kurs mit eigenem Namen, Note, Credits und Semester darstellt. Ein vierjähriges Highschool-Transkript enthält 28 bis 32 Kurszeilen. Das kombinierte Transkript eines Wechselstudenten kann über 60 Zeilen über mehrere frühere Bildungseinrichtungen umfassen. Die richtigen Daten aus der richtigen Zeile zu extrahieren, ist eine strukturelle Herausforderung, für die Pixel-basierte OCR nie entwickelt wurde.
Unterschiedliche Bewertungsskalen. Bildungseinrichtungen berichten Leistungen auf mindestens vier gängigen Skalen: ungewichtete 4.0, gewichtete 5.0 (AP/IB erhält +1.0, Honors +0.5), 100-Punkte-Prozentsatz und nur Noten ohne numerische Entsprechung. Ein „B+“ bedeutet 3.3 auf einer 4.0-Skala an einer Highschool, 87–89 % an einer anderen und einen völlig anderen Wert auf einer 4.3-Skala (verwendet von Stanford und einigen anderen). Internationale Transkripte fügen Prozentbänder, rangbasierte Systeme und nationale Prüfungsergebnisse hinzu, die sich nicht sauber auf eine US-Skala abbilden lassen. Allein das Lesen der Zeichen „B+“ von einer Seite liefert nichts Nützliches – Sie müssen wissen, was diese Note im Rahmen der bewertenden Einrichtung bedeutet.
Kreditpunktesystem-Varianten und Kursbezeichnungen. Semester-Credits, Quarter-Credits (wobei 5 Quarter-Stunden = 3.33 Semester-Stunden gemäß der Standard-Umrechnung ÷1.5), Trimester-Einheiten und Carnegie-Einheiten koexistieren im selben Bewerberpool. Über die Kreditpunktzahl hinaus tragen Kursbezeichnungen zulassungsrelevante Bedeutung: Advanced Placement, International Baccalaureate, Dual Enrollment, Honors, Übertragungs-Credits von einer früheren Einrichtung, Förderkurse. Jede Bezeichnung beeinflusst, wie der Kurs bei der GPA-Berechnung gewichtet werden sollte und ob er Voraussetzungen erfüllt. Ein Transkriptextraktionstool, das Ihnen „4.0 Credits“ liefert, ohne zu sagen, dass es „4.0 Quarter-Credits in AP Calculus“ sind, hat Ihnen irreführende Daten gegeben.
Deshalb hat die American Association of Collegiate Registrars and Admissions Officers (AACRAO) – die über 18.000 Fachleute an etwa 2.300 Einrichtungen vertritt – Jahrzehnte in die Standardisierung der Transkriptpraxis durch ihren Academic Record and Transcript Guide investiert. Und deshalb verbindet der National Student Clearinghouse Electronic Transcript Exchange (ETX) heute fast 2.000 Einrichtungen für kostenlosen, sicheren Transkriptaustausch in PDF-, XML- und EDI-Formaten. Die Infrastruktur für elektronische Transkriptübertragung existiert. Die verbleibende Lücke besteht darin, das übertragene Dokument in strukturierte Daten umzuwandeln, die Ihr SIS verarbeiten kann – ohne dass ein Mitarbeiter jedes Feld manuell eingibt.
Herkömmliche OCR liest Zeichen. KI-gestützte semantische Extraktion – der Ansatz, den wir in diesem Leitfaden behandeln – liest akademische Bedeutung. Sie versteht, dass „AP Calc BC" auf einem Zeugnis und „Calculus BC (Advanced Placement)" auf einem anderen dieselbe Kurskategorie sind. Sie kann eine Kursnote von einer kumulativen GPA-Zahl auf derselben Seite unterscheiden. Und sie kann dies tun, ohne dass Sie für jede sendende Einrichtung eine Parsing-Vorlage erstellen und pflegen müssen. Weitere Informationen zum zugrunde liegenden Technologieunterschied finden Sie in unserem Leitfaden zu was OCR tatsächlich versteht – und was nicht.
Schritt 1: Bereiten Sie Ihre Zeugnisse für die Extraktion vor
Was Sie in das Extraktionstool eingeben, bestimmt, was Sie herausbekommen. Drei Vorbereitungsentscheidungen machen einen messbaren Unterschied in der Ausgabequalität.
Scanauflösung. Wenn Sie mit Papierzeugnissen arbeiten, die per Post eintreffen, scannen Sie mit mindestens 300 DPI. Die San Diego State University, die mehr als 31.000 College-Zeugnisse pro Jahr verarbeitet (82 % über EDI, 18 % über OCR aus Papier), standardisiert auf 300 DPI mit Graustufenausgabe. Schwarz-Weiß-Scans verlieren den subtilen Kontrast, der einen Kurstitel von einer Notenspalte in eng gepackten Zeugnislayouts unterscheidet. Farbscans bewahren maximale Informationen, erhöhen jedoch die Dateigröße ohne nennenswerten Genauigkeitsgewinn für die meisten Zeugnisformate.
Seitenausrichtung und -orientierung. Zeugnisse sind fast immer im Hochformat, aber gescannte Seiten kommen oft leicht gedreht an. Selbst eine Neigung von 2 Grad kann dazu führen, dass herkömmliche OCR Spaltenausrichtungen falsch liest – sie verwechselt, welche Note zu welchem Kurs gehört. Wenn Ihre Scan-Software automatisches Deskew anbietet, aktivieren Sie es. Bei bereits digitalisierten PDFs übernehmen die meisten Extraktionstools die Rotation intern. Wenn Sie jedoch systematische Fehler in einem Batch bemerken, überprüfen Sie die Quell-PDFs auf Rotation, bevor Sie die Extraktionslogik untersuchen.
Batch-Organisation. Gruppieren Sie Zeugnisse nach Verarbeitungspriorität, bevor Sie sie hochladen. Wenn Sie Übertragungsgutschriften bewerten, trennen Sie Zeugnisse, die eine Articulation-Prüfung erfordern, von unkomplizierten Erstsemester-Zulassungsdateien – der Prüfworkflow unterscheidet sich. Benennen Sie Ihre Dateien konsistent: [Nachname]_[Vorname]_[Einrichtung].pdf. Diese Namenskonvention ermöglicht es Ihnen, extrahierte Daten während der Validierung mit der Quelldatei abzugleichen, ohne jede einzelne öffnen zu müssen.
Wenn Ihr Büro Zeugnisse hauptsächlich über National Student Clearinghouse ETX oder Parchment erhält, erhalten Sie bereits digitale PDFs – überspringen Sie den Scanschritt und fahren Sie direkt mit der Extraktion fort. Weitere Informationen zur Optimierung der Bildqualität vor der Extraktion finden Sie in unserem praktischen Leitfaden zur Verbesserung der OCR-Genauigkeit.
Schritt 2: Extraktionsspalten definieren
Hier unterscheidet sich die Extraktionsmethode grundlegend von allem, was ein vorlagenbasiertes Tool bietet – und dieser Schritt entscheidet, ob Sie brauchbare Daten oder ein Durcheinander erhalten. In einem vorlagenbasierten Workflow würden Sie auf einer Beispielabschrift jeder sendenden Einrichtung Rechtecke um Felder ziehen. Bei über 2.000 High Schools und 4.000 Colleges allein in den USA ist dieser Ansatz nicht skalierbar.
Semantische Extraktion funktioniert anders. Statt dem Tool zu sagen, wo es suchen soll, sagen Sie ihm, was Sie möchten – indem Sie die Spalten benennen, die zu Ihren Ausgabe-Tabellenköpfen werden. Die KI liest jede Abschrift, versteht die akademische Bedeutung des gefundenen Textes und ordnet Werte den von Ihnen definierten Spalten zu. ImageToTable.ai nennt dies Benutzerdefinierte Spaltenextraktion: Sie definieren das Ausgabeschema einmal, und das Tool wendet es auf jede Abschrift in Ihrem Batch an, unabhängig von Formatierungsunterschieden.
Hier ist ein Spaltenschema, das die Kerndaten abdeckt, die die meisten Zulassungsstellen benötigen:
| Spaltenname | Extrahiert | Hinweise |
|---|---|---|
Studentenname | Vollständiger Name wie auf der Abschrift | Zum Abgleich mit dem Bewerbungsdatensatz zur Verifizierung |
Institutionsname | Ausstellende High School oder College | Für Analyse der Zubringerschulen und GPA-Kontext |
Kursname | Vollständiger Kurstitel | z. B. „AP English Literature & Composition" |
Note | Buchstaben- oder Zahlennote wie angegeben | Rohwert extrahieren; Umrechnung erfolgt in Schritt 3 |
Credits | Erworbene Kreditstunden oder -einheiten | Art des Kreditsystems notieren (Semester/Trimester/Carnegie) |
Semester | Semester, Trimester oder Jahr | z. B. „Herbst 2024", „Frühjahr 2025" |
GPA | Kumulativer GPA wie angegeben | Skala variiert; gewichtet oder ungewichtet notieren |
Kursniveau | Regulär, Honors, AP, IB, Dual Enrollment, Transfer | Inferierte Spalte mit Optionsliste verwenden |
Die letzte Spalte – Kursniveau – ist ein Feld, das auf den meisten Abschriften nicht explizit erscheint. Die KI muss die Klassifizierung aus dem Kontext ableiten: „AP" im Kursnamen, eine separate Spalte für „Honors" oder eine Dual-Enrollment-Notation. Dies ist eine inferierte Spalte – die KI liest das Dokument und erschließt anhand der vorhandenen Hinweise, zu welcher Kategorie jeder Kurs gehört, selbst wenn die Abschrift die Wörter „AP" oder „Honors" nie in einem eigenständigen Feld ausweist. Sie geben die Inferenzlogik an, indem Sie Optionen in die Spaltendefinition aufnehmen: Kursniveau (Optionen: Regulär, Honors, AP, IB, Dual Enrollment, Transfer, Förderkurs).
Für die Bewertung von Leistungsübertragungen fügen Sie diese Spalten hinzu, um anrechnungsrelevante Details zu erfassen:
| Spaltenname | Zweck |
|---|---|
Kurscode | Fachbereichskürzel + Nummer (z. B. „MATH 2413") für Äquivalenzsuche |
Kredittyp | Semester / Trimester / Carnegie – bestimmt Umrechnungsformel |
Übertragungsinstitution | Wenn Credits extern erworben und übertragen wurden, der Name der ursprünglichen Einrichtung |
Die von Ihnen eingegebenen Spaltennamen sind die Spaltenüberschriften in Ihrer finalen Excel-Ausgabe. Sie definieren das Ausgabeformat – die KI ermittelt, wie sie es aus jedem Transkript, das in den Batch gelangt, befüllt.
Schritt 3: GPA-Skalen und Kreditumrechnung handhaben
Das Extrahieren der rohen Noten- und Kreditwerte ist nur die halbe Arbeit. Diese Werte über Bewerber hinweg vergleichbar zu machen, erfordert eine Umrechnung – und genau hier entstehen in manuellen Arbeitsabläufen die meisten Fehler, die sich stillschweigend durch die Zulassungspipeline summieren.
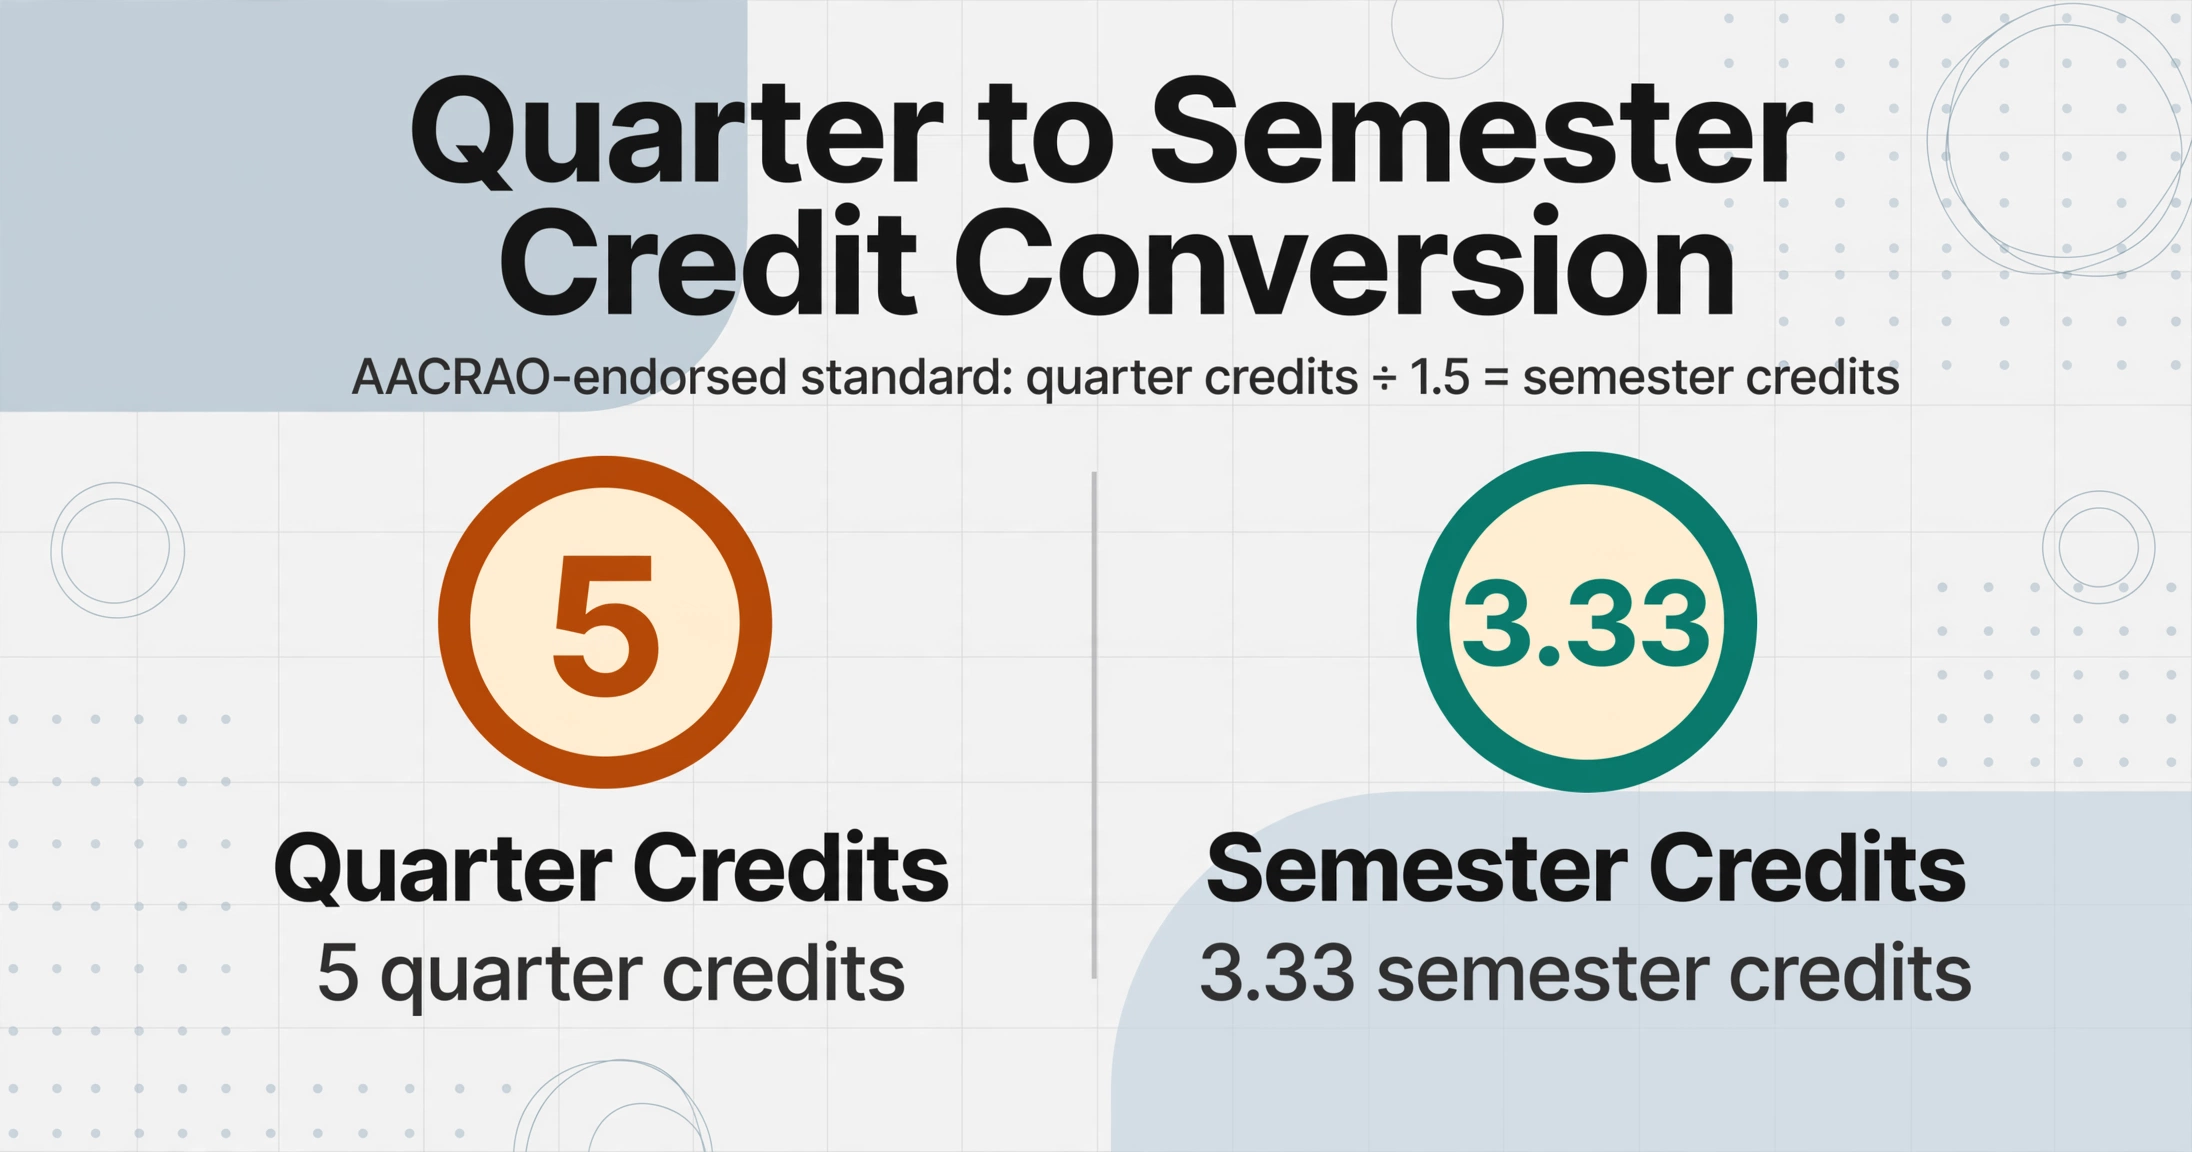
Umrechnung von Quarter- in Semester-Credits. Der von AACRAO unterstützte Standard, der von Institutionen wie der Norwich University bis zur Excelsior University übernommen wurde, lautet: Quarter-Credits ÷ 1,5 = Semester-Credits. Ein Kurs im Wert von 5 Quarter-Credits entspricht 3,33 Semester-Credits. Diese Umrechnung ist wichtig, da sie sich direkt darauf auswirkt, ob ein Bewerber die Mindestkreditgrenzen für die Transferzulassung, den Abschluss von Voraussetzungen und die Berechtigung für Finanzhilfen erfüllt. Wenn Ihr SIS Semester-Credits erwartet und Sie Quarter-Credits ohne Umrechnung importieren, ist jede nachfolgende Kreditsumme im System falsch.
Mit einer berechneten Spalte können Sie diese Umrechnung während der Extraktion automatisieren. Definieren Sie eine Spalte namens Semester Credits (wenn Credit-Typ = Quarter, dann Credits ÷ 1,5, sonst Credits) – die KI liest den Credit-Typ, wendet die Formel an und gibt den umgerechneten Wert direkt in Ihre Tabelle aus. Keine Excel-Formel nach der Extraktion nötig. Derselbe Ansatz handhabt andere Kreditsystem-Umrechnungen: Trimester-Credits ÷ 1,17, Carnegie-Einheiten × variable Multiplikatoren, abhängig von der Richtlinie Ihrer Institution.
Normalisierung der GPA-Skala. Die Herausforderung besteht darin, dass ein gewichteter GPA von 3,8 von einer Schule, die für AP-Kurse 5,0 vergibt, nicht dieselbe Leistung ist wie ein ungewichteter GPA von 3,8 von einer Schule mit einer strengen 4,0-Skala. Um Bewerber fair zu vergleichen, benötigen Sie sowohl den rohen GPA, wie er angegeben ist, als auch Kontextinformationen zur Skala.
Extrahieren Sie diese drei Felder für jedes Transkript:
GPA (wie angegeben)– die auf dem Transkript gedruckte ZahlGPA-Skala– verwenden Sie eine abgeleitete Spalte:GPA-Skala (Optionen: 4,0 ungewichtet, 5,0 gewichtet, 4,3, 100-Punkte, Sonstiges)GPA-Skala Maximum– das Maximum auf dieser Skala (4,0, 5,0, 4,3, 100)
Mit diesen drei Werten in Ihrer Tabelle kann Ihr Zulassungsteam mithilfe der eigenen Formel Ihrer Institution über Skalen hinweg normalisieren, anstatt einer Black-Box-Umrechnung eines Tools zu vertrauen. Ein gängiger Ansatz: Teilen Sie den angegebenen GPA durch das Skalenmaximum, um einen Prozentsatz-vom-Maximum-Wert zu erhalten (z. B. 3,6/4,0 = 0,90, 4,2/5,0 = 0,84), was einen Vergleich über Skalen hinweg ermöglicht, ohne die ursprünglichen Daten zu verlieren.
Umgang mit Transfer-Credits und Dual Enrollment. Wenn ein Transkript Kurse von mehreren Institutionen zeigt – üblich bei Transferstudenten und Dual-Enrollment-Bewerbern – muss die Extraktion bewahren, welche Kurse von wo stammen. Definieren Sie eine Spalte für Institution (pro Kurs), um die Herkunftsschule für jede Zeile zu erfassen. Wenn das Transkript „Columbus State Community College" neben einer Teilmenge von Kursen auflistet, kann die KI diese Zeilen dieser Institution zuordnen und die Spalte entsprechend befüllen, selbst wenn das Layout zwischen Transkripten variiert.
Eine Übersicht darüber, wie KI-Extraktion in der breiteren Bildungsdokumentlandschaft Anwendung findet – einschließlich Einschreibungsformularen, Finanzhilfebescheiden und standardisierten Testergebnissen – finden Sie in unserem vollständigen Leitfaden zu OCR und KI-Extraktion für Bildungseinrichtungen.
Schritt 4: Prüfen, validieren und nach Excel exportieren
Kein Extraktionstool – ob KI-gestützt oder nicht – erreicht 100 % Genauigkeit bei 100 % der Zeugnisse. Entscheidend ist die Gestaltung eines Prüfworkflows, der den kleinen Anteil an Feldern erfasst, die menschliche Aufmerksamkeit benötigen, ohne dass Mitarbeiter jede Zeile erneut lesen müssen. Das ist der Unterschied zwischen Automatisierung, die Ihr Team unterstützt, und Automatisierung, die eine neue Art von Beschäftigungstherapie schafft.
Konfidenzbasierte Prüfung. Einige Extraktionsplattformen kennzeichnen Felder mit niedriger Konfidenz – Werte, bei denen die KI sich bei einer Note, einem Kursnamen oder einer Kreditpunktzahl unsicher ist – zur menschlichen Überprüfung. Statt jede extrahierte Zeile zu prüfen, konzentrieren sich Mitarbeiter nur auf die gekennzeichneten Einträge. Bei einer Feldgenauigkeit von 95–99 % bedeutet das, etwa 1 bis 5 Felder pro Zeugnis zu prüfen statt 30+. Ein Zyklus mit 15.000 Bewerbungen geht von 450.000 manuell zu prüfenden Feldern auf vielleicht 22.500 gekennzeichnete Felder zurück – immer noch Arbeit, aber Arbeit, die in Stunden statt Wochen gemessen wird.
Kreuzreferenz-Validierung. Bevor Sie extrahierte Daten in Ihr SIS importieren, führen Sie zwei schnelle Prüfungen durch:
- Zeilenanzahl-Prüfung: Entspricht die Anzahl der extrahierten Kurszeilen der Anzahl der auf dem Zeugnis sichtbaren Kurse? Wenn ein Vierjahreszeugnis mit 32 Kursen nur 28 Zeilen ergab, wurde etwas übersehen – typischerweise ein Kurs, der sich über einen Seitenumbruch erstreckt, oder ein ungewöhnliches Layoutelement.
- GPA-Plausibilitätsprüfung: Wenn der extrahierte GPA 2,1 beträgt, aber jede Kursnote A oder B ist, wurde entweder das GPA-Feld falsch gelesen oder das Zeugnis verwendet eine Skala, die Sie nicht berücksichtigt haben.
Stapel-Export nach Excel. Wenn Sie mehrere Zeugnisse in einem einzigen Stapel verarbeiten, führt das Tool alle extrahierten Daten in einer Tabelle zusammen – eine Zeile pro Kurs, mit Spalten, die dem in Schritt 2 definierten Schema entsprechen. Die Ausgabe ist bereit für den direkten Import in Ellucian Banner, PeopleSoft Campus Solutions, Workday Student oder jedes SIS, das CSV- oder Excel-Uploads akzeptiert. Jede Zeile ist über die Dateinamensspalte auf ihr Quellzeugnis zurückführbar, sodass Mitarbeiter bei Fragen während der Studienabschlussprüfung oder Kreditbewertung das Original-PDF in Sekunden abrufen können.
Diese Stapel-Zusammenführungsfunktion ist es, die die Zeugnisverarbeitung von einer Aufgabe pro Dokument in eine Pipeline verwandelt. Verarbeiten Sie 50 Zeugnisse in einem Upload, erhalten Sie eine Tabelle mit jedem Kurs als Zeile und speisen Sie sie direkt in das System ein, das Ihr Registrar bereits verwendet.
FERPA-Konformität bei der Extraktion von Zeugnisdaten
Der Family Educational Rights and Privacy Act (FERPA, 20 U.S.C. § 1232g; 34 CFR Part 99) verlangt von Bildungseinrichtungen, „angemessene Methoden" anzuwenden, um den Zugriff auf studentische Bildungsunterlagen zu kontrollieren und die Identität der Empfänger offengelegter Informationen zu authentifizieren. Ein Zeugnis ist eine Bildungsunterlage. Jede Person, die es während der Verarbeitung berührt, ist ein Zugriffspunkt, der kontrolliert und dokumentiert werden muss.
Wo manuelle Eingabe FERPA-Risiken schafft. Bevor eine einzige Note durch einen manuellen Workflow Ihr SIS erreicht, durchläuft das Zeugnis-PDF typischerweise: ein gemeinsames Netzwerklaufwerk (zugänglich für alle mit Ordnerberechtigungen der Abteilung), ein E-Mail-Postfach (möglicherweise weitergeleitet, automatisch gespeichert oder auf mehreren Geräten zwischengespeichert) sowie den Desktop oder Download-Ordner eines Mitarbeiters. Bei jeder Übergabe existiert das Dokument außerhalb eines Systems, das protokolliert, wer wann darauf zugegriffen hat. Löst eine FERPA-Beschwerde eine Prüfung aus, muss die Einrichtung eine Verwahrungskette nachweisen – und ein Korrekturprotokoll in einer Tabellenkalkulation ist kein Zugriffsprotokoll. Da die bundesstaatliche Durchsetzung von FERPA verschärft wurde und das Bildungsministerium von Einrichtungen verlangt, die Einhaltung zu zertifizieren und proaktiven Datenschutz nachzuweisen, hat sich die Lücke zwischen „das haben wir schon immer so gemacht" und nachweisbarer Governance verkleinert.
Wie automatisierte Extraktion die Angriffsfläche reduziert. Fließen Zeugnisdaten durch ein Extraktionstool, das Dateien direkt verarbeitet – ohne Zwischenspeicherung auf gemeinsamen Laufwerken, ohne E-Mail-Anhänge, ohne Herunterladen auf einzelne Desktops – sinkt die Zahl unkontrollierter Zugriffspunkte. Das Zeugnis gelangt vom Upload zur strukturierten Ausgabe. Mitarbeiter prüfen extrahierte Datenfelder, anstatt das gesamte studentische PDF zu handhaben. Und da der Extraktionsprozess serverseitig mit verschlüsselter Datenverarbeitung erfolgt, reduzieren sich die FERPA-relevanten Zugriffsereignisse auf: Uploader-Authentifizierung, Extraktionsverarbeitung und Prüferzugriff – alles protokollierbar.
Dies hebt FERPA-Pflichten nicht auf – es verlagert den Compliance-Workflow von „jede menschliche Übergabe verfolgen" hin zu „Systemzugriffspunkte kontrollieren und protokollieren". Für die meisten Zulassungsstellen ist Letzteres einfacher zu dokumentieren, einfacher zu prüfen und schwieriger versehentlich zu verletzen.
Häufig gestellte Fragen
Funktioniert die KI-Extraktion auch bei handschriftlichen Zeugnissen oder Noten?
Teilweise. Gedruckte Zeugnisdaten – Kursnamen, Kreditstunden, Institutionen, Notendurchschnitte – werden mit hoher Genauigkeit extrahiert (typischerweise über 95 %). Handschriftliche Anmerkungen – eine Randnotiz des Beraters, eine handschriftlich korrigierte Note – sind schwieriger. Moderne Vision-Language-Modelle können Handschrift bei klaren, gut beleuchteten Scans mit angemessener Genauigkeit lesen, aber Schreibschrift, helle Bleistiftmarkierungen oder Anmerkungen, die in den gedruckten Text übergehen, liefern weniger zuverlässige Ergebnisse. Bei Zeugnissen mit umfangreichen handschriftlichen Inhalten sollten Sie zusätzliche Prüfzeit für markierte Felder einplanen.
Was ist mit internationalen Zeugnissen in nicht-lateinischen Schriften?
Zeugnisse in Sprachen mit lateinischer Schrift (Englisch, Spanisch, Französisch, Deutsch, Portugiesisch) werden zuverlässig verarbeitet. Zeugnisse in nicht-lateinischen Schriften (Chinesisch, Japanisch, Koreanisch, Arabisch, Kyrillisch) können von Vision-Language-Modellen gelesen werden, die diese Zeichensätze unterstützen, aber die Genauigkeit variiert je nach Schriftkomplexität und Dokumentqualität. Notenskalen und Kreditsysteme von Nicht-US-Institutionen stellen eine zusätzliche Komplexitätsebene dar – ein 20-Punkte-Notensystem in Frankreich (wo 16/20 ausgezeichnet ist) lässt sich nicht durch einfache Division auf eine US-4.0-Skala übertragen. Extrahieren Sie in diesen Fällen die Rohwerte und überlassen Sie die Umrechnung dem internationalen Bewertungsprozess Ihrer Institution.
Kann ich Daten aus inoffiziellen Zeugnissen oder Screenshots von Studentenportalen extrahieren?
Ja – die KI liest alle vorhandenen visuellen Inhalte, unabhängig davon, ob das Dokument ein offizielles Siegel trägt. Für Zulassungsentscheidungen benötigen Sie jedoch letztendlich das offizielle Zeugnis zur Überprüfung. Ein praktischer Workflow: Verwenden Sie inoffizielle Zeugnisse oder Screenshots für die vorläufige Bewertung (Sortierung, erste GPA-Schätzung, Identifizierung von Kandidaten für eine beschleunigte Prüfung) und verarbeiten Sie dann offizielle Zeugnisse über dieselbe Extraktionspipeline für die endgültige Dateneingabe in das SIS. Achten Sie nur darauf, inoffizielle und offizielle Chargen getrennt zu halten, damit extrahierte Daten niemals verwechselt werden.
Wie schneidet das im Vergleich zu Parchment Data Automation oder Softdocs ITP ab?
Parchment Receive Premium + Data Automation und Softdocs Intelligent Transcript Processing sind speziell für die hochvolumige, institutionelle Zeugnisverarbeitung mit direkter SIS/CRM-Integration konzipiert. Sie sind die richtige Wahl für Universitäten, die pro Zyklus über 10.000 Bewerbungen verarbeiten, über dedizierten IT-Support verfügen und das Budget für Unternehmensverträge haben. Der in diesem Leitfaden beschriebene Ansatz – die Verwendung eines leichten KI-Extraktionstools ohne Vorlagen – bedient einen anderen Anwendungsfall: kleinere Zulassungsstellen, die Anrechnungsprüfung an Community Colleges, die Zulassung zu Graduiertenprogrammen in Fachbereichen oder jedes Szenario, in dem eine Unternehmensplattform für das Volumen und Budget übertrieben ist. Beide Ansätze lösen das gleiche Problem der manuellen Dateneingabe; sie unterscheiden sich im Umfang, der Integrationstiefe und der Kostenstruktur.
Funktioniert das mit PDFs, die Sicherheitseinschränkungen oder einen Passwortschutz haben?
Nein. Passwortgeschützte oder DRM-geschützte PDFs müssen vor der Extraktion entsperrt werden. Die meisten offiziellen elektronischen Zeugnisse von Diensten wie Parchment und National Student Clearinghouse kommen als standardmäßige, ungeschützte PDFs an. Wenn Sie auf ein gesperrtes PDF stoßen, wenden Sie sich an das Prüfungsamt der ausstellenden Einrichtung – diese können eine uneingeschränkte Version oder eine alternative Zustellungsmethode bereitstellen.
Wie hoch ist die tatsächliche Genauigkeitsrate bei der Zeugnisextraktion?
Die feldgenaue Genauigkeit für gedruckte Zeugnisdaten – Kursnamen, Noten, Credits, Institutionennamen, Daten, Notendurchschnitt – liegt typischerweise zwischen 95 % und 99 %, abhängig von der Scanqualität, der Layoutkomplexität und davon, ob das Zeugnis ungewöhnliche Formatierungselemente enthält (mehrspaltige Kurslisten, geteilte Seitengestaltung, Wasserzeichen über Text). Die University of Texas at Austin berichtete nach der Einführung der automatisierten Zeugnisdatenextraktion von einer Genauigkeit von über 95 % bei einer 70%igen Reduzierung der Bearbeitungszeit für das Personal. Die verbleibenden 1–5 % der Felder – typischerweise mit ungewöhnlichen Abkürzungen, stark komprimierten Layouts oder Text in der Nähe von Dokumenträndern – sind das, was der konfidenzbasierte Überprüfungs-Workflow abfangen soll. Dies ist kein Werkzeug, das menschliches Urteilsvermögen ersetzt; es ist ein Werkzeug, das die Bereiche reduziert, in denen menschliches Urteilsvermögen erforderlich ist.