Comment extraire les données de CV dans Excel
pour le recrutement (guide 2026)
La plupart des recruteurs n'ont pas un problème d'analyse de CV. Ils ont un problème de feuille de calcul. Après que les sites d'emploi, les pièces jointes par e-mail et les recommandations internes déversent des dizaines de PDF dans leur boîte de réception, quelqu'un doit transformer ces CV en feuille de suivi des candidats — et la réponse par défaut reste le copier-coller manuel. Et si cette réponse coûtait plus cher que l'embauche elle-même ?
Points clés à retenir
- 40 CV prennent 2 à 4 heures de copier-coller manuel — et une adresse e-mail mal saisie fait perdre le candidat entièrement.
- Les parsers ATS lisent les CV par position, donc une mise en page sur deux colonnes insère les compétences de votre barre latérale directement dans votre historique d'emploi.
- Définissez vos colonnes une fois, déposez n'importe quel format de CV, et obtenez une feuille de calcul de candidats filtrable sans toucher à une API de parser.
Le tableur derrière chaque décision d'embauche
Chaque processus de recrutement, qu'il soit mené par une équipe de talents du Fortune 500 ou une startup de cinq personnes, converge finalement vers un artefact unique : un tableur de candidats. Noms dans la colonne A. Titres actuels dans la colonne B. Source — LinkedIn, recommandation, site d'emploi — dans la colonne C. Compétences et années d'expérience réparties sur les colonnes D à H.
Pour les employeurs de petite et moyenne taille qui ne peuvent pas justifier un ATS d'entreprise (système de suivi des candidats), ce tableur constitue toute leur infrastructure de recrutement. C'est là que les candidats sont classés, que les dates de suivi sont notées et que les responsables du recrutement sont informés. Le problème est que sa construction — ligne par ligne, CV par CV — est l'étape la plus chronophage de tout l'entonnoir de recrutement. Les formulaires de candidature papier et PDF s'ajoutent à la même pile, et convertir un formulaire de candidature en Excel intègre le nom du candidat, son historique professionnel, sa formation et ses références dans le tableur de candidats aux côtés des données des CV.
SHRM estime le coût moyen par embauche à environ 4 700 $, avec un délai de pourvoi de 33 jours tous secteurs confondus (SHRM Benchmarking). Il ne s'agit pas seulement de frais de publicité et d'agence. Une part importante correspond aux heures des recruteurs — des heures consacrées à des tâches comme la copie de données de CV dans des tableurs de suivi, une étape qui n'apporte aucune valeur stratégique mais consomme de l'argent réel.
Le problème n'est pas que les tableurs soient mauvais. C'est que les remplir manuellement à partir de documents non structurés coûte cher, d'une manière qui augmente avec le volume — et la plupart des équipes de recrutement n'ont pas d'alternative claire.
Ce que la saisie manuelle coûte réellement à une équipe de recrutement
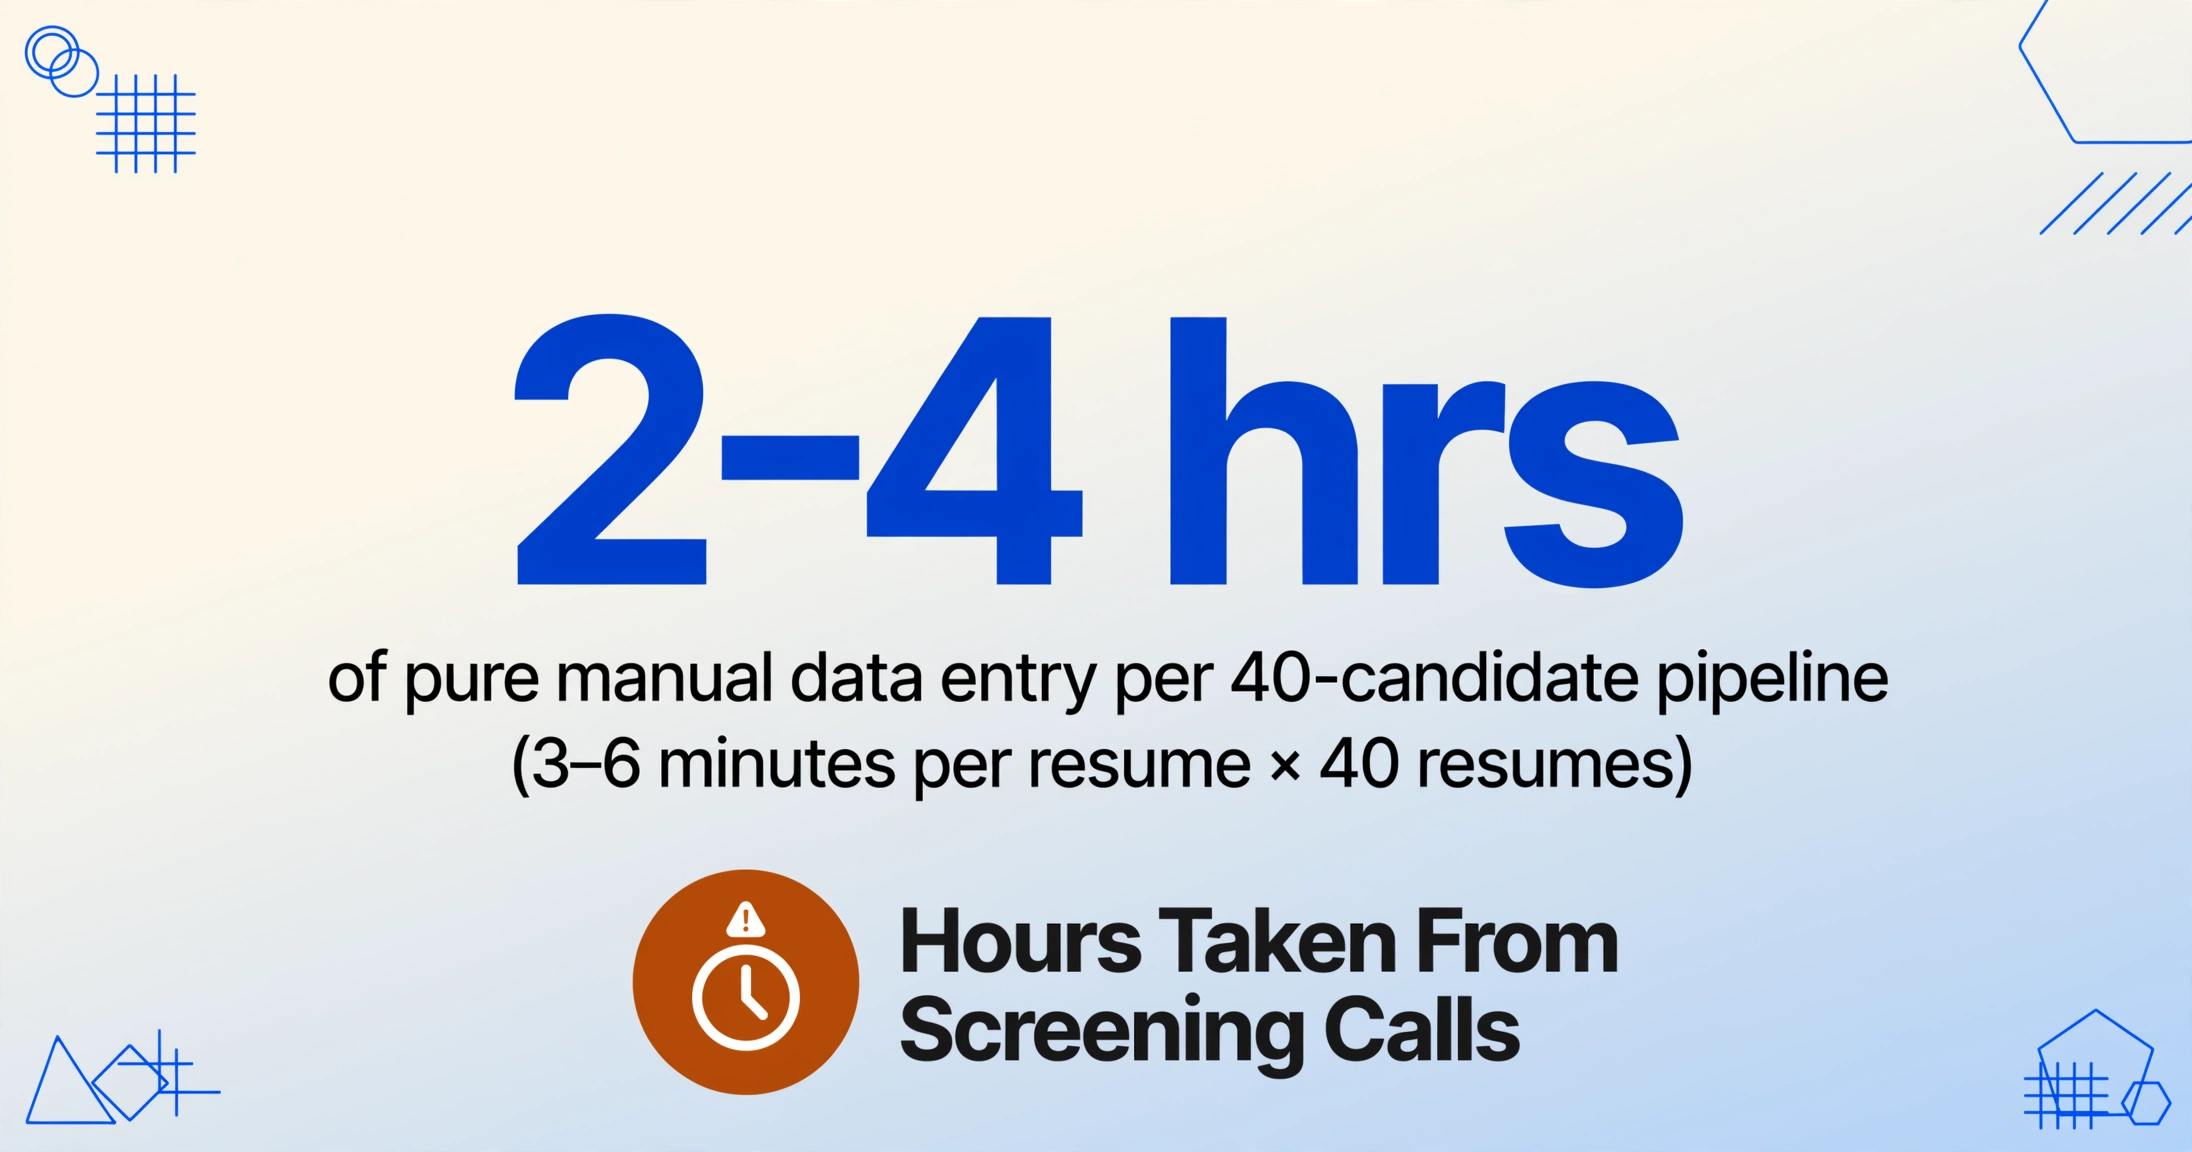
Voici l'arithmétique que personne ne fait jusqu'à ce qu'un arriéré l'y oblige. Un recruteur qui ouvre un pipeline de 40 candidats passe environ 3 à 6 minutes par CV à extraire les champs clés dans une feuille de suivi — nom, e-mail, téléphone, titre actuel, entreprise, années d'expérience, formation, compétences principales et source. Pour 40 candidats, cela représente 2 à 4 heures de pure saisie de données.
Mais il ne s'agit pas seulement de temps. C'est ce que ce temps aurait dû être utilisé : appels de sélection, synchronisation avec les responsables du recrutement, recherche de candidats passifs. Ce sont ces activités qui font réellement avancer une embauche. La saisie de données est un impôt sur toutes ces activités.
Le taux d'erreur compte aussi. Une adresse e-mail mal saisie signifie qu'un candidat ne reçoit jamais d'invitation à un entretien. Un numéro de téléphone inversé fait perdre du temps au responsable du recrutement. Une compétence qui n'a pas été copiée parce qu'elle figurait dans une barre latérale passe à la trappe lors du premier filtre. Lorsque le tableur devient la source unique de vérité pour les décisions d'embauche, la qualité de ce tableur impacte directement la qualité de ces décisions.
Pour contexte : la norme du secteur pour la tarification des API d'extraction de CV varie de $0.05 à $0.30 par CV via des outils spécialisés comme Textkernel (Sovren), RChilli, Daxtra et Affinda. Cela peut sembler bon marché — jusqu'à ce que vous payiez des frais par document en plus d'un abonnement ATS, et que vous passiez encore du temps à corriger les erreurs d'extraction sur des mises en page multi-colonnes.
Le dossier candidat : que faut-il extraire d'un CV
Avant d'extraire quoi que ce soit, vous devez définir ce que « dossier candidat » signifie réellement pour votre processus de recrutement. L'erreur que commettent la plupart des équipes est de tout extraire — copier l'intégralité des parcours professionnels mot pour mot — alors que le rôle du tableur est de filtrer et comparer, pas d'archiver.
Voici l'ensemble de champs essentiels à extraire pour un tableau de suivi des candidats pratique. (Si vous traitez des dizaines ou des centaines de CV, consultez notre guide de traitement des CV par lots pour gérer le volume, le désordre des noms de fichiers et les stratégies de fusion.)
| Champ | Pourquoi il figure dans le tableau |
|---|---|
| Nom du candidat | Identifiant principal. Le champ que vous ne pouvez pas vous permettre de vous tromper. |
| Canal de prospection. Une faute de frappe et vous perdez le candidat. | |
| Téléphone | Entretiens de présélection et planification par SMS. Le format varie selon le pays. |
| Poste actuel | Le premier filtre le plus rapide : le poste le plus récent correspond-il à l'offre ? |
| Entreprise actuelle | Contexte sectoriel. Un « ingénieur logiciel » chez Google vs. dans une agence de 10 personnes signifie des choses différentes. |
| Années d'expérience | Une colonne inférée : l'IA lit l'historique professionnel et calcule le total des années, même si le CV ne liste que des plages de dates. |
| Formation / Diplôme | Diplôme le plus élevé + domaine. Moins pertinent dans le recrutement par compétences, mais reste un filtre courant. |
| Compétences clés | Compétences techniques et comportementales. Le NACE rapporte que 64,8 % des employeurs utilisent désormais des pratiques de recrutement par compétences, dont les deux tiers au stade de la présélection (NACE Job Outlook 2025). Cette colonne est le filtre le plus important du pipeline moderne. |
| Préavis | Essentiel pour la planification du calendrier. « Disponible immédiatement » vs. « préavis de 3 mois » change la shortlist. |
| Source | D'où vient le CV : LinkedIn, recommandation, site d'emploi, agence. Indispensable pour mesurer le ROI des canaux. |
| Étape du pipeline | Mise à jour manuelle après extraction : Candidature, Présélection, Entretien, Offre, Embauche. Transforme le tableur en un ATS léger. |
La décision de conception clé : vous extrayez ce dont vous avez besoin pour comparer, pas ce que vous pourriez extraire. Chaque colonne qui ne vous aide pas à filtrer ou classer les candidats est une colonne qui ajoute du temps d'extraction et du bruit visuel.
Une colonne mérite une attention particulière : Années d'expérience. Elle est rarement indiquée comme un chiffre unique sur un CV — elle est répartie sur plusieurs plages de dates dans la section parcours professionnel. Avec une colonne calculée, l'IA analyse chaque période d'emploi, calcule le total et produit un chiffre unique. Vous définissez la colonne comme « Années d'expérience (somme de toutes les périodes d'emploi) » et l'IA gère le calcul lors de l'extraction — aucun post-traitement dans Excel requis.
Comment extraire les données des CV dans Excel, étape par étape
Le principal défi de l'extraction de CV n'est pas la technologie — c'est la diversité des mises en page. Un CV de graphiste comporte des barres latérales, des icônes et des mises en page sur deux colonnes. Un CV d'universitaire s'étend sur quatre pages. Un PDF exporté de LinkedIn a une structure complètement différente. Les analyseurs basés sur des modèles échouent ici car ils sont formés sur une attente de mise en page fixe. L'extraction sémantique — où l'IA lit par signification plutôt que par position — est ce qui rend ce flux de travail efficace sur tous les formats.
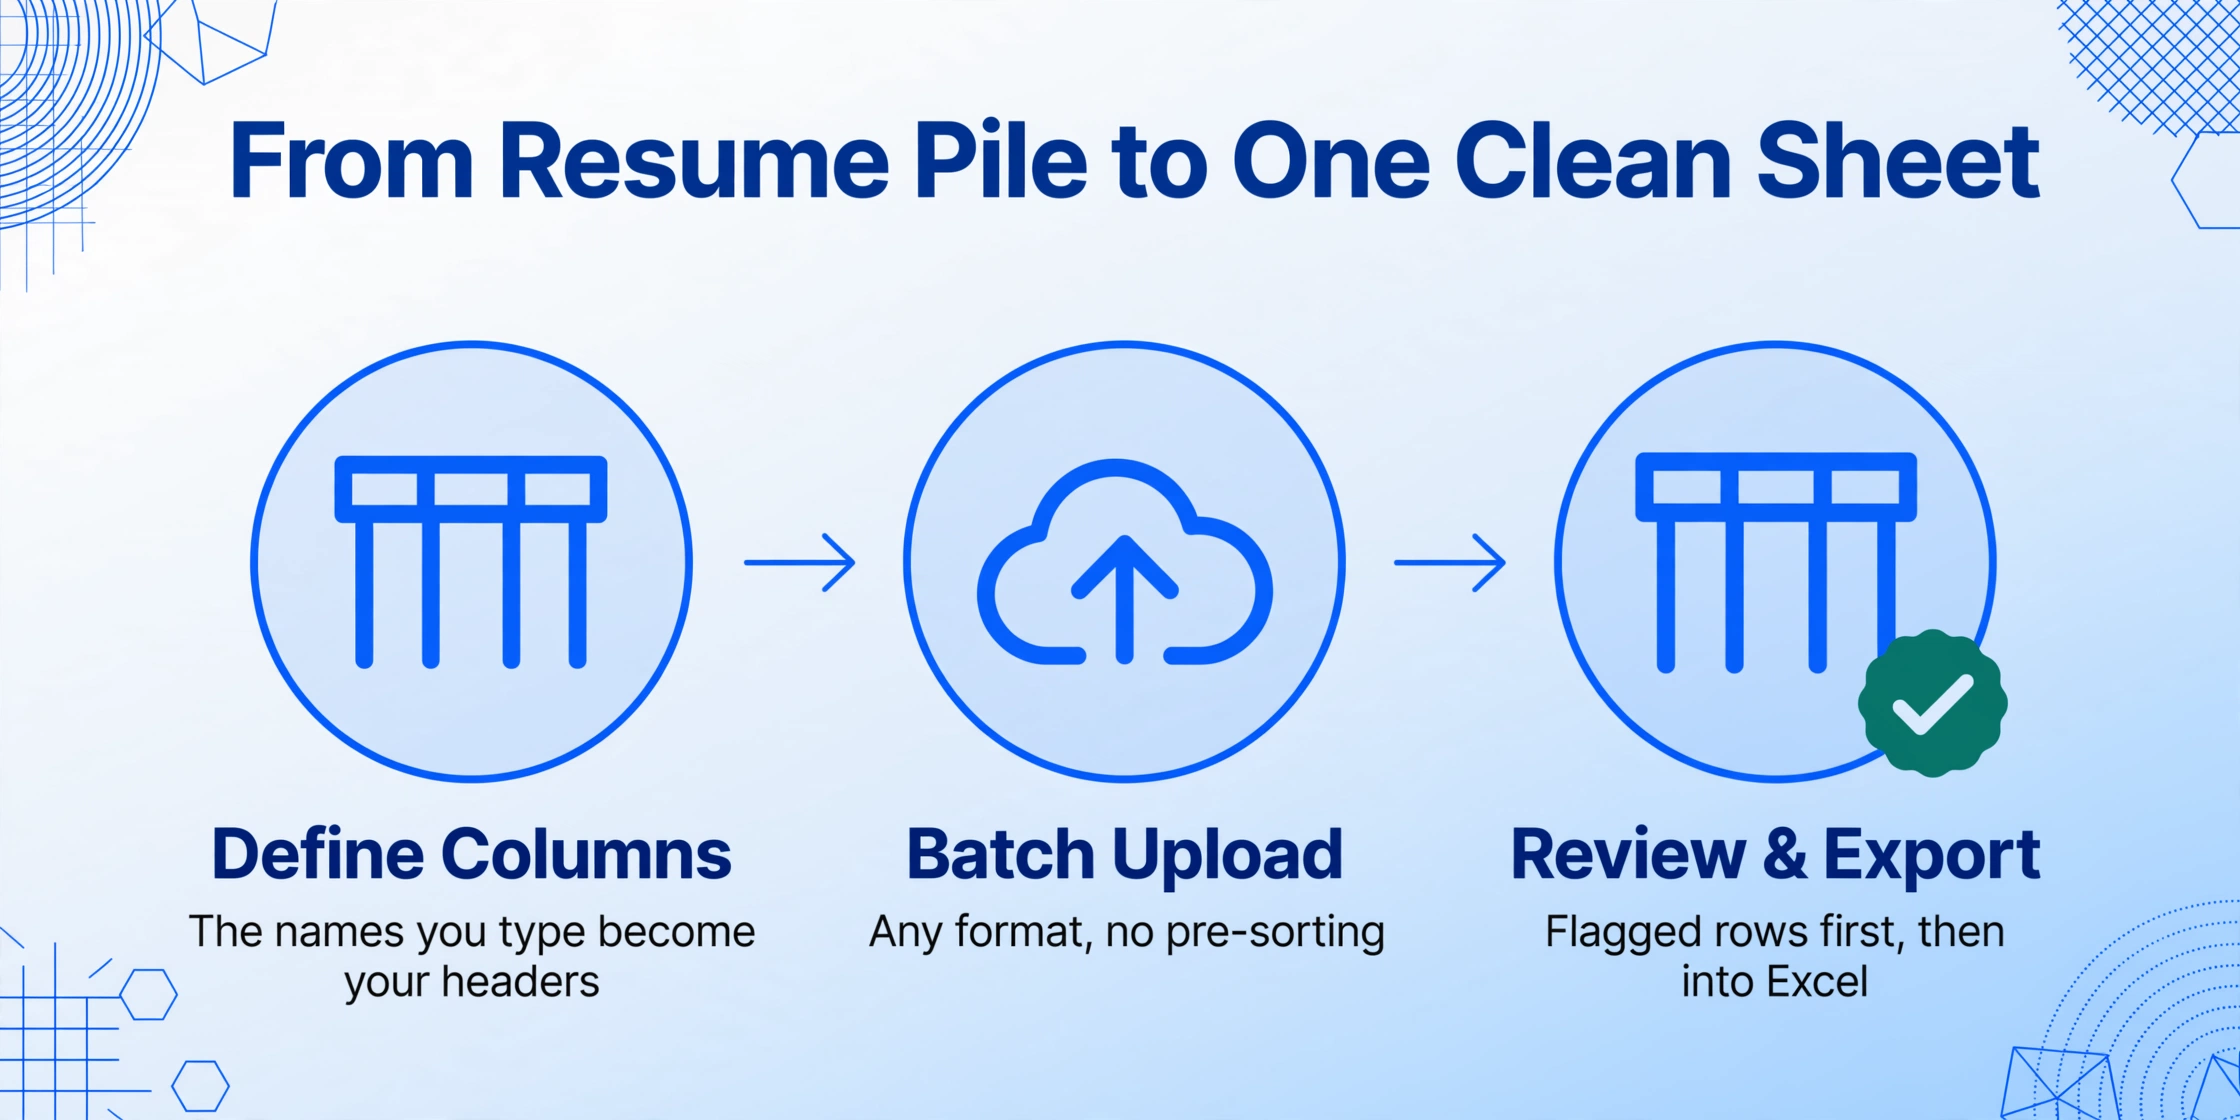
ImageToTable.ai utilise l'Extraction de colonnes personnalisées : vous saisissez les noms de champs souhaités — « Nom du candidat », « E-mail », « Compétences clés », « Années d'expérience » — et l'IA localise chaque valeur n'importe où sur chaque CV en comprenant ce que le champ signifie, et non où il se trouve. Les noms de colonnes que vous saisissez deviennent les en-têtes de votre feuille de calcul de sortie.
Étape 1 : Définissez vos colonnes
Commencez avec la liste de champs de la section ci-dessus, puis ajustez-la selon les exigences de votre poste. Pour un recrutement technique, ajoutez les langages de programmation et les certifications. Pour un poste commercial, ajoutez l'atteinte des quotas et le territoire. Les colonnes que vous définissez déterminent ce que vous pourrez trier, filtrer et comparer dans l'ensemble de votre vivier de candidats.
Étape 2 : Téléchargez tous les CV par lots
Déposez chaque CV — PDF, documents Word, captures d'écran, exports LinkedIn — dans la zone de téléchargement. Il n'y a aucune limite de formats et aucun besoin de pré-trier par mise en page. L'IA traite chaque document indépendamment et fait correspondre les valeurs extraites à vos colonnes définies.
Étape 3 : Vérifier et exporter vers Excel
Une fois le traitement terminé, vous obtenez un tableau unique avec une ligne par candidat et une colonne par champ. Avant l'export, survolez n'importe quelle cellule extraite pour voir exactement d'où provient cette valeur sur le CV d'origine — un cadre de délimitation surligné sur le document source vous offre une confirmation visuelle en quelques secondes. Exportez ensuite vers Excel (XLSX) et le fichier est prêt à être filtré, trié et partagé avec l'équipe de recrutement.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Quand les parseurs lisent mal le CV : les mises en page qui cassent les outils positionnels
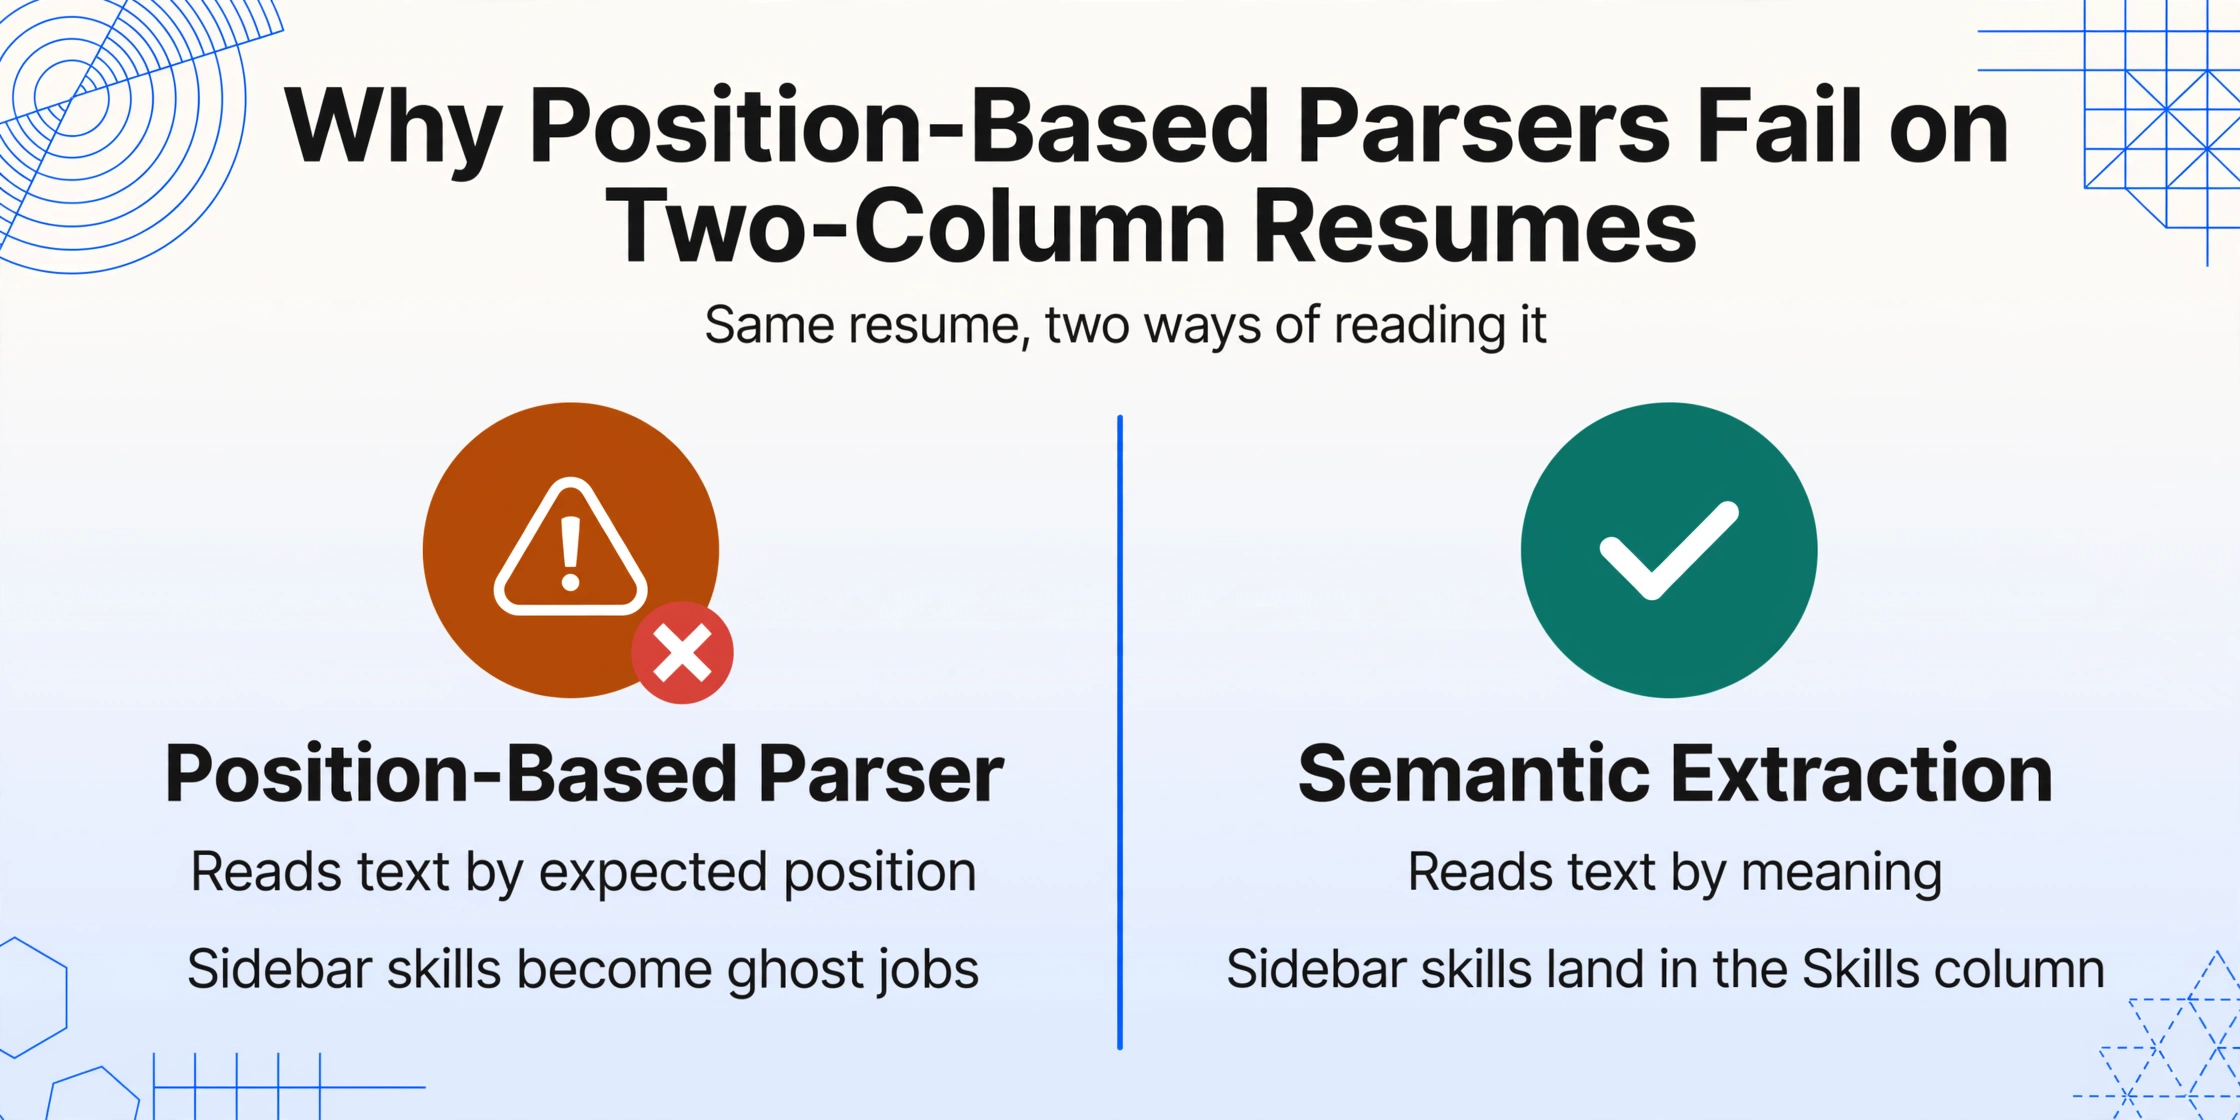
Les parseurs de CV positionnels — le type intégré à la plupart des plateformes ATS — fonctionnent en recherchant du texte à des emplacements attendus. Une section contact en haut. L'historique professionnel au milieu. La formation en bas. Lorsqu'un CV suit ce modèle, le parseur fonctionne. Lorsqu'il ne le suit pas, le résultat va de subtilement erroné à comiquement inutilisable.
Sur le subreddit r/recruiting, un recruteur a décrit ce qui se passe quand un système Phenom rencontre un CV à deux colonnes : « Le profil CRM m'a dit qu'ils étaient barista dans une usine GM » — la section des compétences de la barre latérale a été fusionnée avec l'historique professionnel principal, produisant un parcours professionnel absurde (r/recruiting). Un autre a rapporté que la saisie d'informations d'habilitation dans le formulaire de candidature de Workday faisait « apparaître votre nom comme prénom habilitation » — le délimiteur de champ a cédé face à une entrée inattendue.
« Greenhouse fonctionne comme tous les autres », concluait le même fil. « ATS signifie Applicant Tracking System. Rien de sophistiqué. » Les parseurs intégrés ne sont pas cassés — ils sont simplement positionnels dans un monde de documents non positionnels.
Modes de défaillance courants des parseurs positionnels :
- Mises en page sur deux colonnes : Le contenu de la barre latérale (compétences, langues, certifications) est lu comme un historique de travail en ligne, créant des emplois fantômes et des employeurs fictifs.
- Formatage créatif : Les CV de graphistes avec des en-têtes de section basés sur des icônes, des barres d'évaluation des compétences et des visualisations chronologiques produisent des chaînes de texte brouillées.
- Contenu d'en-tête/pied de page : Les URL LinkedIn, les liens de portfolio et les numéros de page placés dans les en-têtes sont fusionnés dans le bloc de texte le plus proche.
- Documents multipages : Les CV académiques de plus de 4 pages ont souvent des sauts de section qui réinitialisent les hypothèses positionnelles de l'analyseur en cours de document.
L'extraction sémantique contourne ces échecs en ne s'appuyant pas du tout sur la position. L'IA lit le document comme le ferait un humain — comprenant que « Formation » est une section, pas une coordonnée, et que les compétences listées dans une barre latérale sont catégoriquement différentes de l'historique d'emploi dans le corps principal. Cela ne signifie pas une précision de 100 % sur chaque mise en page créative — les notes manuscrites dans les marges ou la typographie fortement stylisée présentent encore des défis — mais cela élimine le mode de défaillance structurelle qui rend les analyseurs basés sur la position peu fiables sur divers formats de CV. Pour une comparaison détaillée des API d'analyse par rapport à l'extraction sémantique par IA — y compris les prix par document, l'effort de configuration et l'approche adaptée à votre équipe — lisez notre comparaison entre l'analyse de CV et l'extraction par IA.
Transformer la feuille de calcul en pipeline de candidats
Une fois les données extraites dans Excel, la feuille de calcul cesse d'être un dépôt de données et devient un outil de recrutement léger. (Si vous préférez une page d'outil dédiée avec démo, essayez notre outil d'extraction de données de CV vers Excel.) Voici comment les meilleures équipes l'utilisent :
Ajoutez une colonne de statut. « Candidature envoyée », « Présélectionné », « Premier entretien », « Deuxième entretien », « Offre », « Embauche » — mettez-la à jour manuellement à mesure que les candidats progressent. Triez par statut pour voir tout votre pipeline d'un coup d'œil.
Suivez l'attribution des sources. La colonne « Source » vous permet de calculer quels canaux produisent les meilleurs candidats. Les embauches par recommandation surpassent constamment les embauches via les sites d'emploi en termes de rétention — mais vous ne pouvez pas le prouver sans suivre l'origine de chaque CV.
Utilisez les filtres natifs d'Excel. Filtrez par « Compétences clés » contenant « Python » et « Années d'expérience » > 3. Filtrez par « Préavis » contenant « immédiatement » pour présélectionner les candidats disponibles rapidement. Ce sont exactement les opérations pour lesquelles un ATS dédié facture — exécutées nativement dans une feuille de calcul.
Collectez des CV de plusieurs sources. Si les responsables du recrutement, les recruteurs externes ou les recommandations d'employés vous envoient des CV par e-mail, utilisez un Lien de collecte (une page de téléchargement partageable qui alimente directement votre file de traitement) ou une Boîte de réception e-mail (transférez les CV et ils arrivent automatiquement dans la file). Personne d'autre n'a besoin de compte — ils envoient simplement des fichiers.
Importez dans votre ATS. Greenhouse, Lever, Workday, iCIMS, BambooHR et la plupart des autres plateformes prennent en charge les importations CSV de données de candidats. Extrayez d'abord dans Excel, nettoyez et normalisez les données une fois, puis importez — plus rapide et plus fiable que de compter sur l'analyseur de CV intégré de chaque plateforme.
Gestion responsable des données des candidats : EEOC, GDPR et conservation
Lorsque vous extrayez les données des candidats dans une feuille de calcul, vous créez une base de données d'informations personnelles couvertes par les réglementations sur l'emploi et la confidentialité. Ce n'est pas une préoccupation connexe aux RH — c'est un élément central du flux de travail.
Aux États-Unis, les outils de criblage de CV automatisés ou basés sur l'IA relèvent des « procédures de sélection » en vertu de Title VII du Civil Rights Act de 1964. Les Uniform Guidelines on Employee Selection Procedures (UGESP) de l'EEOC appliquent la règle des quatre cinquièmes : si le taux de sélection d'un groupe protégé est inférieur à 80 % du taux du groupe le plus élevé, cela constitue un constat préliminaire d'impact défavorable (EEOC Title VII). Pour les équipes de recrutement qui utilisent des données extraites pour filtrer les candidats, la conclusion pratique est la suivante : documentez vos critères de filtrage. Si vous filtrez par « Années d'expérience > 3 » ou « Diplôme = Bachelor », soyez prêt à démontrer que ce critère est lié à l'emploi et conforme à la nécessité commerciale.
Pour les équipes qui recrutent dans l'UE ou au Royaume-Uni, l'article 22 du GDPR restreint les décisions fondées uniquement sur un traitement automatisé, et l'article 35 exige une évaluation d'impact sur la protection des données (DPIA) pour les traitements à haut risque de données personnelles — ce qui est le cas du criblage systématique des candidats. L'ICO du Royaume-Uni et les autorités européennes de protection des données recommandent généralement de conserver les données des candidats non retenus pendant 6 à 12 mois maximum après la fin du processus de recrutement, sauf consentement explicite du candidat pour une conservation plus longue.
Côté opérationnel : la minimisation des données consiste à extraire uniquement les champs nécessaires à la décision d'embauche — et non chaque ligne de chaque historique d'emploi. Le mode de révision avec vérification visuelle des boîtes englobantes permet de confirmer ce qui a été extrait et d'où, créant ainsi une piste auditable. Et lorsqu'un candidat demande la suppression, vous supprimez des lignes d'une feuille de calcul, au lieu de démêler des enregistrements dans une base de données ATS complexe.
Le dossier du candidat doit souvent contenir les résultats de sélection, pas seulement les champs du CV — un workflow de vérification des antécédents vers Excel archive les résultats des vérifications pénales, de références et MVR conformément aux règles de conservation ci-dessus.
L'avantage d'un pipeline basé sur une feuille de calcul en matière de conformité est la simplicité. Les données vivent à un seul endroit. La suppression est une opération au niveau de la ligne. La logique de filtrage est explicite (formules Excel, et non un scoring IA en boîte noire). Pour les petites et moyennes équipes soumises aux obligations de l'EEOC et du GDPR, cette transparence vaut plus que l'ensemble des fonctionnalités d'un ATS d'entreprise.
FAQ
Peut-il lire des CV manuscrits ?
Partiellement. Une écriture claire et lisible — comme un formulaire imprimé avec des champs manuscrits — est bien extraite. Une écriture cursive dense sur du papier non structuré produit des résultats de moindre confiance. Pour les CV mixtes imprimés/manuscrits, l'IA extrait de manière fiable tout le texte imprimé et signale les zones de faible confiance. Les CV entièrement manuscrits doivent être traités comme nécessitant une relecture manuelle supplémentaire.
Quelle est la précision sur les CV à deux colonnes ?
Nettement meilleure que les analyseurs basés sur la position, car l'IA lit par sens sémantique, et non par position dans la mise en page. Une barre latérale de compétences à gauche est comprise comme une section « Compétences », quelle que soit sa position sur la page. Cela dit, les CV très stylisés de graphistes avec des marqueurs de section basés sur des icônes peuvent encore produire une confiance plus faible sur certains champs — l'IA est douée pour lire le texte en contexte, pas pour décoder des métaphores visuelles.
Combien de CV puis-je traiter à la fois ?
Les téléchargements par lots gèrent des dizaines de CV en une seule session. Tous les fichiers sont traités en parallèle et fusionnés en un seul tableau de sortie unifié — une ligne par candidat, sans configuration par document.
Puis-je importer les résultats dans Greenhouse ou Workday ?
Oui. La plupart des plateformes ATS — Greenhouse, Lever, Workday, iCIMS, BambooHR et Bullhorn, entre autres — prennent en charge l'import de candidats par CSV. Extrayez vers Excel, nettoyez et validez les données une fois, puis importez un fichier propre. Ce flux de travail est souvent plus rapide et plus fiable que de s'appuyer sur l'analyseur de CV intégré de chaque plateforme, en particulier pour les candidats sourcés en dehors de l'ATS.
Que deviennent les données des CV après l'extraction ?
Les fichiers sont traités puis automatiquement supprimés du serveur après une période de conservation configurable. Aucune donnée d'entraînement n'est conservée à partir des téléchargements des clients. Pour les candidats demandant la suppression en vertu du RGPD ou de réglementations similaires, les données du tableur extrait vivent dans un fichier que vous contrôlez — pas dans la base de données d'un fournisseur.
En quoi cela diffère-t-il d'une API de parsing de CV ?
Les API de parsing de CV (Textkernel, RChilli, Affinda, Daxtra) sont conçues spécifiquement pour les CV et produisent souvent du JSON structuré qui nécessite du code d'intégration pour obtenir un format utilisable. Elles facturent par document (0,05 $–0,30 $ par parsing). L'extraction par IA adopte une approche plus large : elle lit tout type de document selon le sens des champs, et non selon un schéma de CV pré-entraîné, et génère directement un tableur. Elle ne nécessite pas d'intégration API — vous obtenez un fichier Excel. Pour les équipes qui gèrent plus que des CV (lettres d'offre, formulaires d'intégration, contrats de travail), un seul flux d'extraction couvre tous les types de documents.