Comment extraire les données d'un connaissement
vers Excel
Un transitaire de taille moyenne absorbe 140 000 à 280 000 $ par an en coûts directement liés aux erreurs documentaires — retenues douanières à 200–500 $ par jour, frais de modification du transporteur à 50–150 $ par correction de B/L, et pénalités de droits de douane dues à des erreurs de classification des codes SH.[1] Mais le vrai coût de la saisie manuelle des données de connaissement n'est pas la main-d'œuvre — c'est les dégâts opérationnels en cascade lorsqu'un seul numéro de BOL mal saisi atteint la douane, déclenche une retenue, accumule des surestaries et oblige à accorder un avoir à un client qui voulait simplement que son fret soit livré à temps. La ligne de défense n'est pas un dactylographe plus rapide. C'est une extraction qui ne fait pas de fautes de frappe.
Le coût de conformité que personne ne budgète
Lorsque les équipes de fret évoquent les difficultés liées au traitement des connaissements, elles commencent généralement par le volume — « nous traitons 500 connaissements par semaine ». Le calcul du temps est simple : 10 à 15 minutes par document pour la saisie manuelle, et jusqu'à une heure pour les connaissements multimodaux complexes comportant de nombreuses lignes de marchandises.[2] Mais le temps n'est que la partie émergée du problème.
Une étude IARJSET de 2025 auprès d'entreprises de transit international a révélé que 46,7 % des sociétés subissent des pénalités directement causées par des erreurs documentaires — et que 63,4 % ont dû corriger des documents sur 1 à 10 expéditions au cours des six derniers mois seulement.[3]
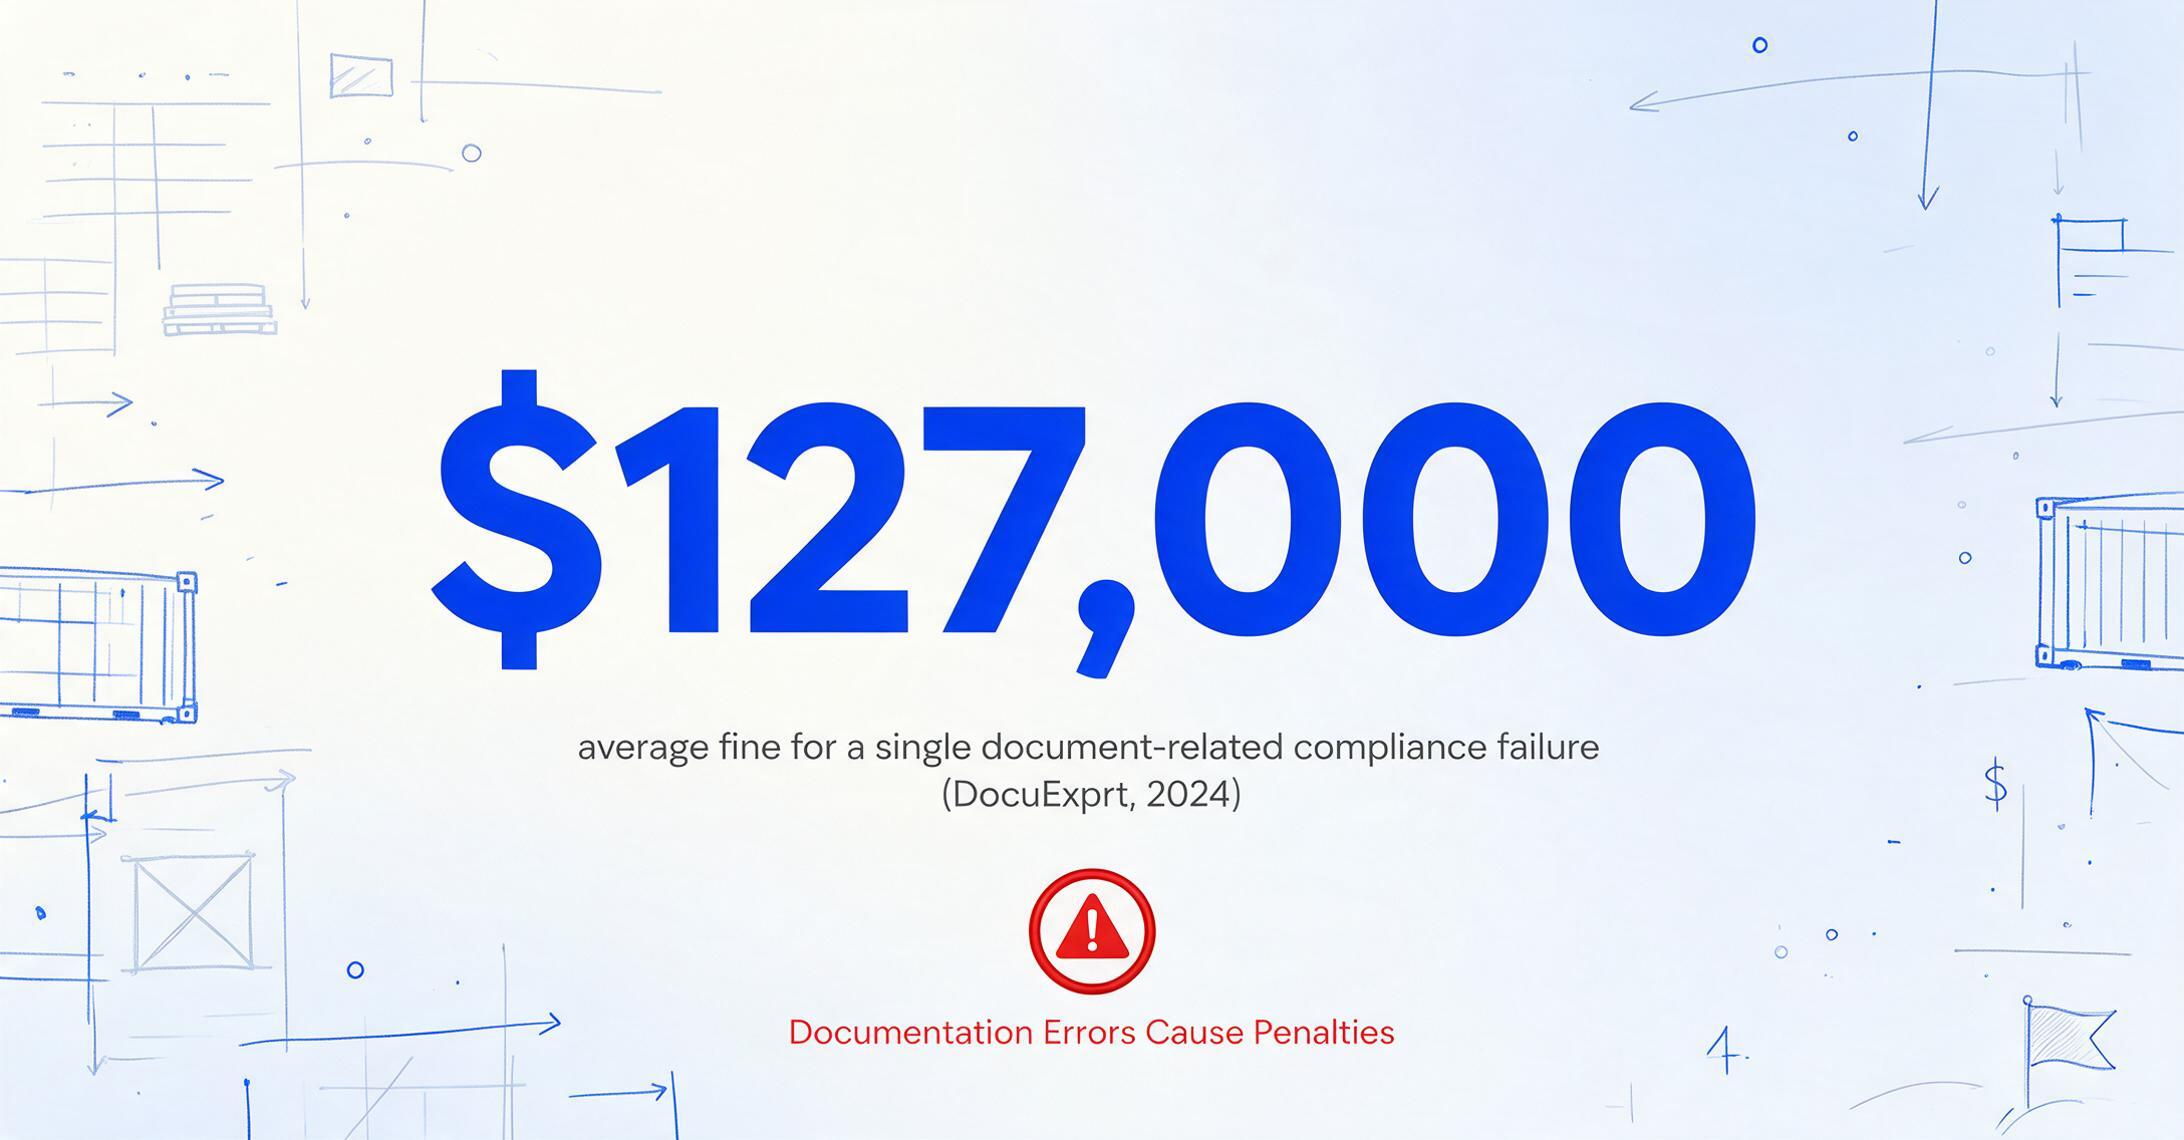
Le chemin vers la pénalité est bien documenté. Les ajustements 2025 des pénalités pécuniaires civiles du Federal Register américain fixent les amendes pour violations de déclaration ISF à 6 000 $ ou plus, avec des pénalités pour non-conformité du manifeste comprises entre 1 740 $ et 4 730 $ par occurrence.[4] Une enquête DocuExprt 2024 a constaté que l'amende moyenne pour un seul manquement à la conformité documentaire s'élève à 127 000 $, la préparation des audits consommant à elle seule 120 à 200 heures de personnel par an.[5]
C'est la ligne budgétaire que crée la saisie manuelle des données de connaissement — et celle que l'extraction automatisée élimine. Une faute de frappe dans un numéro de conteneur ou un code SH mal saisi n'est pas une simple erreur de secrétariat ; c'est une porte d'entrée vers une cascade de retenues douanières, de frais de stockage, de retards de reclassement et d'avoirs clients. Lorsqu'un professionnel de la logistique sur Reddit fait remarquer que les répartiteurs passent leur journée à « copier l'e-mail → TMS, recopier → bourse de fret, répéter 20× par jour », la perte de productivité est visible. Le risque de conformité derrière chacune de ces opérations de copier-coller, lui, ne l'est pas.
Pourquoi l'OCR standard échoue sur les connaissements
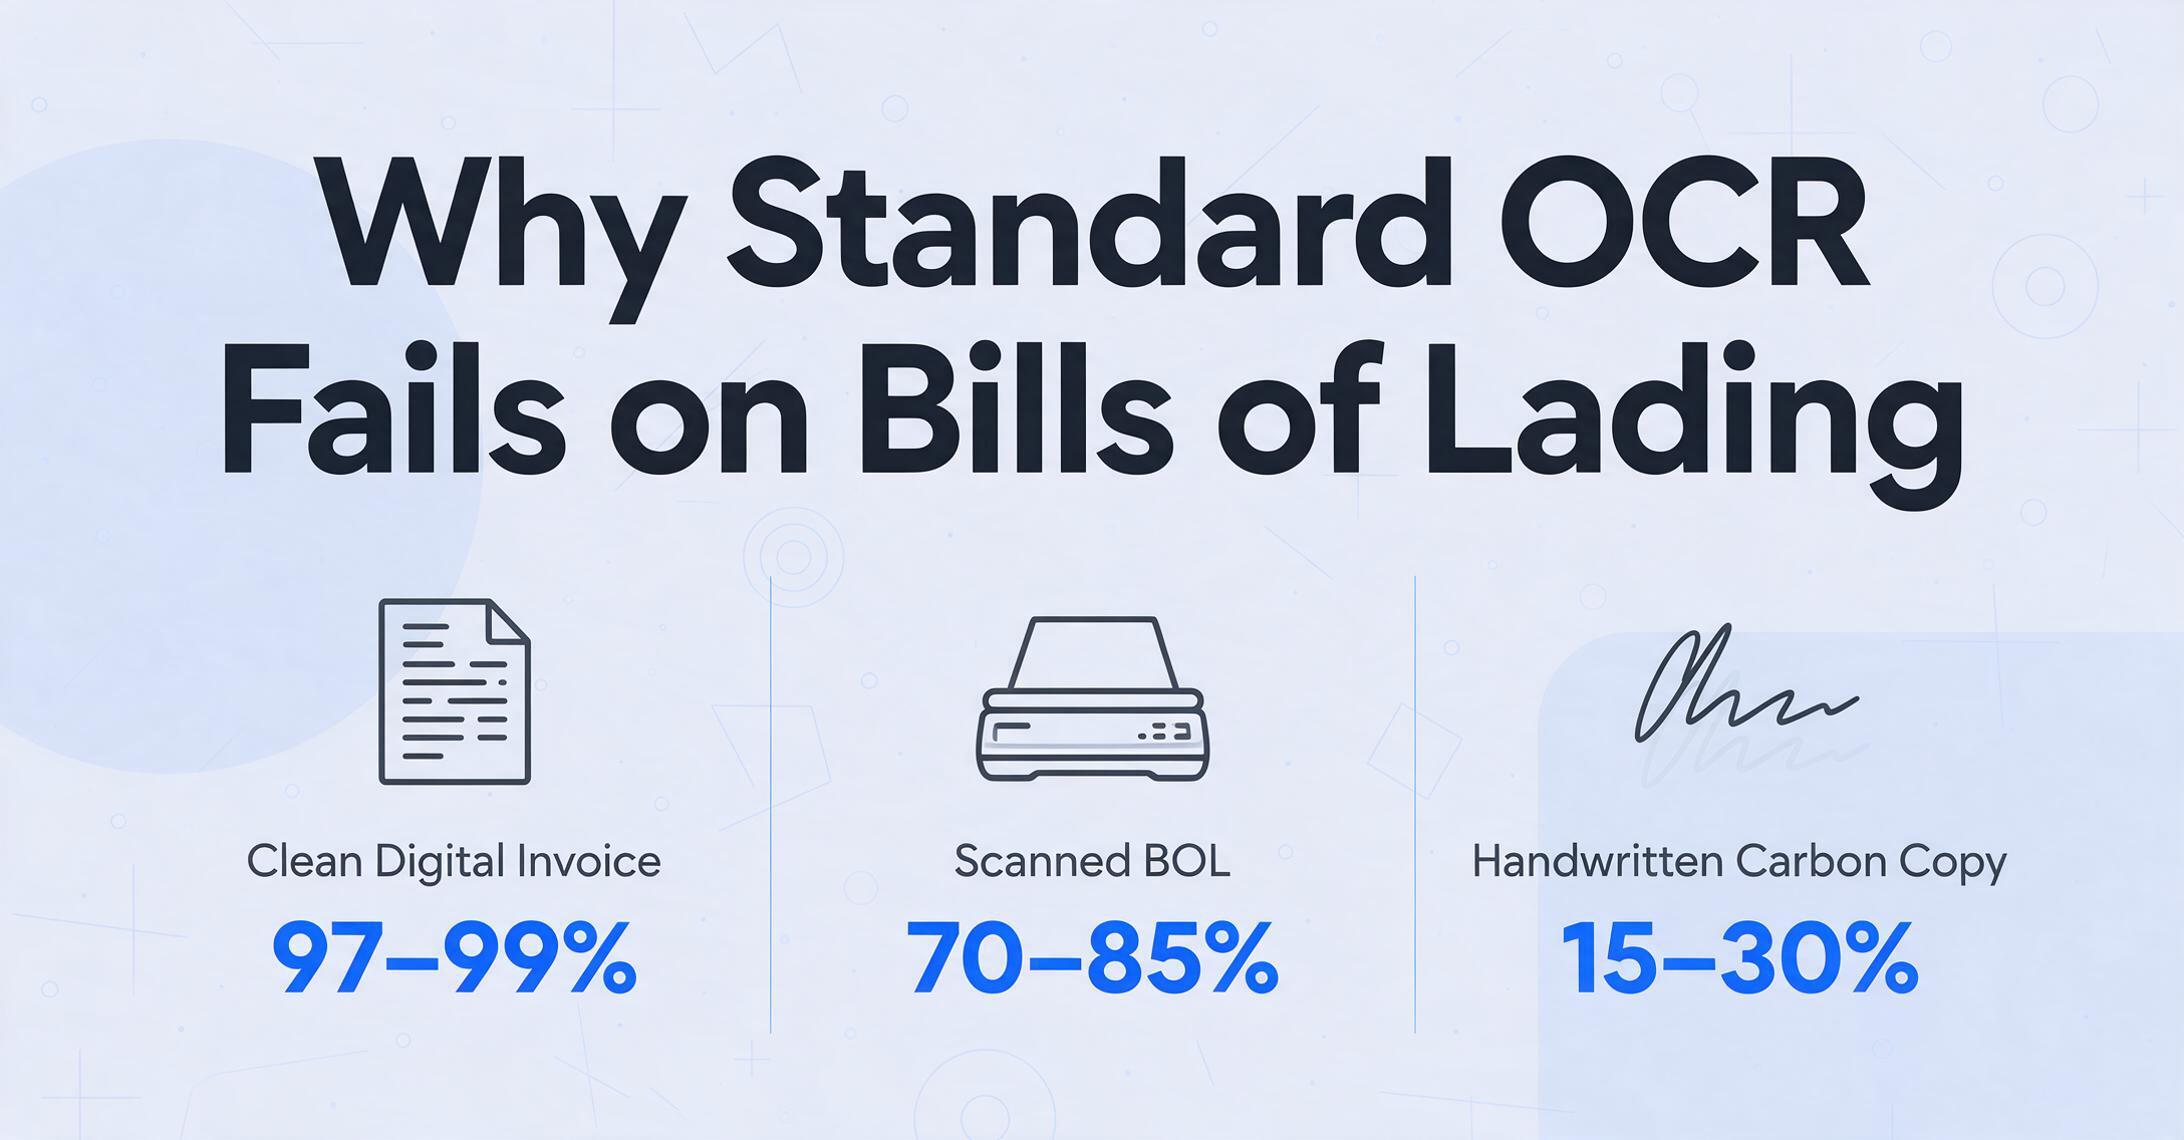
L'argument standard pour automatiser l'extraction des données BOL est le suivant : exécuter l'OCR sur le PDF scanné, obtenir le texte, le mapper aux colonnes du tableur. Cela fonctionne sur une facture numérique propre provenant d'un seul fournisseur dont vous connaissez le format. Cela échoue sur les connaissements pour trois raisons qui se cumulent.
Chaque transporteur utilise sa propre mise en page. Un connaissement maritime de Maersk place le bloc expéditeur en haut à gauche, les détails du navire dans un tableau central et la description de la cargaison dans une grille multi-lignes en dessous. Un connaissement direct d'Old Dominion utilise la mise en page standardisée NMFTA avec des descriptions de marchandises dans une grille très serrée. Un connaissement FedEx Freight utilise encore un autre agencement. L'OCR basé sur des modèles — où vous dessinez des zones autour de chaque champ et entraînez le système par mise en page — nécessite un modèle par transporteur. Un courtier gérant 50 transporteurs a besoin de 50 modèles, et chaque fois qu'un transporteur met à jour son formulaire, ce modèle échoue silencieusement.
L'écriture manuscrite, les tampons et les copies carbone sont la norme — pas des cas particuliers. Les connaissements sont souvent remplis à la main sur du papier carbone au quai de chargement. Le nom du destinataire est griffonné au stylo, le nombre de pièces est tamponné à l'encre rouge, et la troisième copie carbone est délavée jusqu'à être presque illisible. L'OCR traditionnel traite cela comme du bruit. Un outil qui ne peut lire que des polices numériques nettes manquera le numéro BOL manuscrit, la mention tamponnée « Freight Prepaid » et le champ de poids sur copie carbone — les trois points de données les plus susceptibles de déclencher un litige sur la facture du transporteur.
La classe de fret NMFC exige une compréhension sémantique, pas une reconnaissance de caractères. Le système National Motor Freight Classification définit 13 classes de fret (50 à 500) basées sur la densité, la capacité de stockage, la manutention et la responsabilité. Un connaissement peut indiquer « Classe 70 » à côté de la description de la marchandise, ou peut indiquer la marchandise sans la classe, en s'attendant à ce que le transporteur l'applique. L'OCR standard lit « Classe 70 » comme des caractères texte. Mais l'extraction sémantique — celle qu'un modèle de vision IA effectue — comprend que « Classe 70 » modifie « Meubles en bois » et appartient à la colonne Classe de fret, pas à la colonne Description de la marchandise. Cette distinction fait la différence entre une facture de fret précise et des frais de reclassification de 300 $ trois semaines plus tard.
Quelles données figurent sur un connaissement — et pourquoi chaque champ compte
Un connaissement remplit simultanément trois fonctions juridiques : récépissé des marchandises (le transporteur reconnaît avoir reçu la cargaison telle que décrite), contrat de transport (conditions et modalités du transport) et titre de propriété (propriété des marchandises, dans les connaissements négociables). Chaque champ du document soutient une ou plusieurs de ces fonctions — et une erreur dans un champ quelconque se répercute dans l'un de ces domaines juridiques.[6] Un connaissement voyage rarement seul — découvrez comment il se recoupe avec le reste du dossier d'expédition dans notre guide sur l'extraction de documents d'expédition et de fret.
| Groupe de champs | Champs | Conséquence d'une erreur |
|---|---|---|
| Parties | Nom et adresse de l'expéditeur, destinataire, partie à notifier, transporteur/code SCAC | Livraison mal acheminée, échec du dédouanement, facturation d'une mauvaise partie |
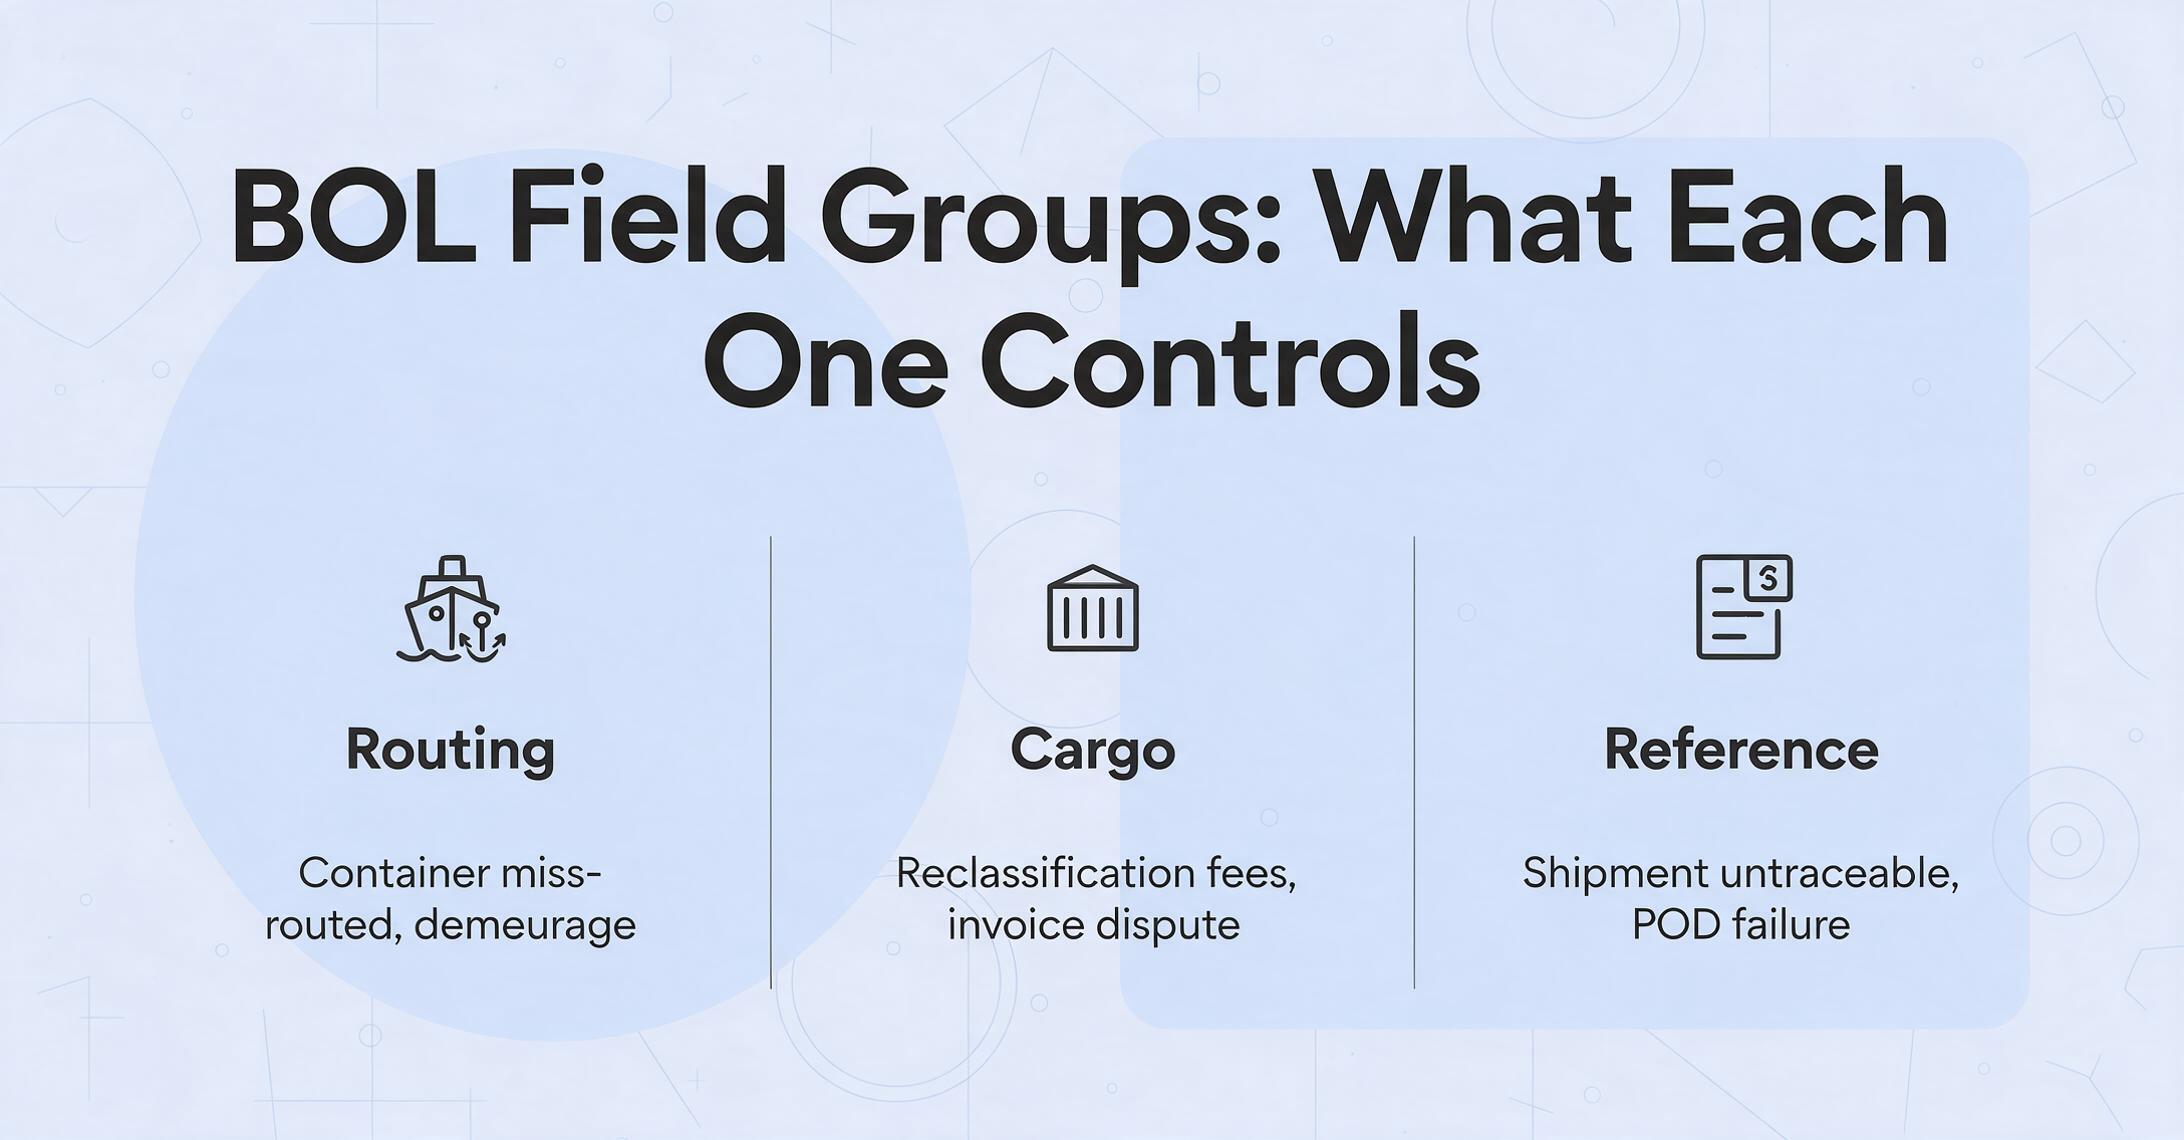
| Acheminement | Port de chargement, port de déchargement, navire/traversée, numéros de conteneur et de scellé | Conteneur mal acheminé, surestaries au mauvais terminal, écart de déclaration ISF |
| Marchandise | Description de la marchandise, nombre de colis, type d'emballage, poids (brut/net), dimensions, classe de fret, code NMFC, code SH | Frais de reclassification, recalcul des droits, litige de facture transporteur, non-conformité aux matières dangereuses |
| Frais et conditions | Conditions de fret (prépayé/à percevoir), frais de fret, frais accessoires | Mauvaise partie facturée, double paiement, accessoires non recouvrés |
| Référence | Numéro de connaissement, numéro PRO, références de bon de commande, dates d'enlèvement/livraison | Envoi introuvable, fenêtres de livraison manquées, échec de la vérification de la preuve de livraison |
Remarquez que le groupe Marchandise — descriptions de marchandises, poids, nombre de colis, classe de fret — est la section la plus dense en données et la plus sujette aux erreurs. C'est aussi la section qui varie le plus d'un transporteur à l'autre. Un transporteur utilise cinq lignes de marchandises avec des poids individuels ; un autre utilise une seule ligne consolidée avec un poids global. Un troisième appose « NMFC 156600 Sub 3 » dans la marge. L'outil d'extraction n'a pas besoin de connaître la mise en page. Il doit savoir ce que chacun de ces éléments signifie.
Du PDF à la feuille de calcul : comment fonctionne réellement l'extraction par IA
Le flux de travail qui remplace la saisie manuelle des données de connaissement est d'une simplicité trompeuse. Vous définissez les colonnes de sortie souhaitées — pas l'emplacement des données sur le document. Cette inversion est au cœur de l'approche : au lieu d'indiquer à l'outil « le numéro de connaissement se trouve dans le coin supérieur droit du formulaire de ce transporteur », vous lui dites « extraire le numéro de connaissement » et laissez l'IA le localiser en comprenant à quoi ressemble un numéro de connaissement dans son contexte.
Pour une opération logistique traitant les connaissements de plusieurs transporteurs, la configuration des colonnes pourrait ressembler à ceci : Numéro de connaissement, Nom de l'expéditeur, Nom du destinataire, SCAC du transporteur, Numéro de conteneur, Port de chargement, Port de déchargement, Description de la marchandise, Nombre de colis, Poids (lbs), Classe de fret, Conditions de fret, Frais de transport. Ces noms de colonnes deviennent les en-têtes Excel. L'IA lit chaque connaissement téléchargé, trouve les valeurs et remplit les lignes — quel que soit le transporteur d'origine du connaissement : Maersk, Old Dominion ou une copie carbone manuscrite d'un transporteur local.
C'est ce qu'on appelle l'Extraction de colonnes personnalisées : vous saisissez les noms des champs souhaités, et l'IA localise chaque valeur en comprenant ce qu'elle signifie — et non où elle se trouve sur la page. Contrairement à l'OCR basé sur des modèles qui dessine des zones autour de positions fixes, cette approche s'adapte à la mise en page de n'importe quel transporteur sans configuration. Un courtier en fret avec 50 transporteurs charge les 50 dans le même lot et obtient une seule feuille de calcul unifiée.
Les fichiers sont traités en toute sécurité et ne sont pas stockés. Essayez avec un connaissement d'exemple.
Après l'extraction, les données arrivent dans une feuille de calcul Excel structurée — chaque ligne correspond à un connaissement, chaque colonne à un champ extrait. Cette sortie est native pour les feuilles de calcul : elle s'intègre directement dans Excel, Google Sheets ou CSV, prête à être téléchargée dans votre TMS ou traitée par un audit de fret. Il n'y a aucune étape de conversion JSON vers CSV, aucun assistant de mappage de champs entre le moteur d'extraction et votre feuille de calcul. Pour les équipes utilisant Google Sheets, il existe même un module complémentaire de barre latérale qui exécute l'extraction directement dans une feuille de calcul sans quitter l'onglet.
Le piège des modèles : pourquoi les configurations par transporteur ne passent pas à l'échelle
Le secteur de la logistique a un problème structurel qui rend l'extraction par modèles fondamentalement inadéquate : la rotation des transporteurs et la variabilité des formats sont des caractéristiques du marché, pas des bugs. Un courtier ne contrôle pas quels transporteurs ses expéditeurs utilisent. Un transitaire qui réserve du fret sur différentes lignes peut utiliser 8 transporteurs maritimes différents et 15 sociétés de camionnage différentes en un seul mois. Chacun émet des connaissements dans son propre format.
La reconnaissance optique de caractères basée sur des modèles nécessite une étape de configuration par format de transporteur : tracer un cadre autour du « Nom de l'expéditeur », l'étiqueter, répéter pour chaque champ nécessaire. Multipliez par 50 transporteurs. Multipliez à nouveau chaque fois qu'un transporteur met à jour son modèle de formulaire. La charge de maintenance augmente linéairement avec le nombre de transporteurs — ce qui signifie que le scénario exact où l'extraction devrait apporter le plus de valeur (grande diversité de transporteurs) est le scénario où la maintenance des modèles devient insoutenable.
C'est pourquoi une approche sans modèle et indépendante du format est cruciale spécifiquement pour l'extraction des connaissements. L'IA n'a pas besoin qu'on lui dise que Maersk place l'expéditeur en haut à gauche et qu'Old Dominion le met dans une case intitulée « Expéditeur/Exportateur ». Elle lit le document comme le ferait un professionnel de la logistique — en recherchant l'entité qui correspond au modèle sémantique d'un expéditeur, peu importe où elle apparaît physiquement sur la page. Ce n'est pas seulement une configuration plus rapide. C'est la différence entre un pipeline d'extraction qui fonctionne dès le premier jour pour tous vos transporteurs et un qui nécessite une maintenance continue des modèles pour chaque nouveau transporteur que vous intégrez.
Choisir entre les outils en libre-service, l'intégration API et les plateformes d'entreprise
Le marché de l'extraction de données des connaissements se divise en trois profils opérationnels. Le bon choix dépend de votre volume, de vos ressources techniques et du fait que l'extraction soit une amélioration autonome ou une partie d'une stratégie d'automatisation plus large.
Outils de téléversement en libre-service
Pour : Courtiers de fret, petits transitaires, équipes opérationnelles traitant 50 à 500 connaissements/mois
Approche : Téléverser les connaissements → saisir les noms de colonnes → télécharger Excel. Aucune configuration d'API, aucun développeur requis.
Exigence clé : Extraction sans modèle pour tous les transporteurs. Si vous devez créer un modèle par transporteur, cette approche échoue à votre échelle.
Intégration API
Pour : Plateformes TMS, systèmes de courtage, outils internes traitant 500 à 5 000 connaissements/mois
Approche : L'API REST reçoit les fichiers de connaissements, renvoie du JSON/CSV structuré avec des scores de confiance au niveau des champs.
Exigence clé : Score de confiance pour que votre système puisse router automatiquement les extractions à faible confiance vers une revue humaine.
Plateformes d'entreprise
Pour : Grands 3PL, transitaires mondiaux traitant plus de 5 000 connaissements/mois avec des besoins d'automatisation de conformité
Approche : IDP de bout en bout avec ingestion par e-mail, extraction, règles de validation, routage des exceptions et envoi vers TMS/ERP.
Exigence clé : Gestion des exceptions et piste d'audit — pas seulement la précision de l'extraction.
Pour la plupart des brokers de fret et des transitaires de taille moyenne, le niveau libre-service est idéal : aucun coût d'intégration, valeur immédiate dès le premier jour, et une tarification à la page qui évolue avec l'utilisation réelle plutôt qu'un abonnement fixe à la plateforme. L'outil traite une page de connaissement en 5 à 10 secondes — contre 10 à 15 minutes de saisie manuelle — et exporte directement vers Excel. À cette vitesse, une équipe traitant 100 connaissements par jour récupère environ 20 heures de travail quotidiennement. Si vous comparez les outils en libre-service aux plateformes d'entreprise pour l'ensemble de vos documents — pas seulement les connaissements — notre guide d'achat pour l'extraction de documents logistiques couvre les critères d'évaluation plus larges.
Une nuance à noter : aucun outil d'extraction n'atteint 100 % de traitement direct sur les connaissements. Les copies carbone manuscrites avec des tampons sur du texte délavé produiront des scores de confiance plus faibles. L'attente correcte est une extraction automatisée de 85 à 95 % avec une file de revue pour les champs signalés — pas un traitement sans intervention. Mais même à 85 % d'automatisation, les 15 % restants qui arrivent dans la file de revue sont encore plus rapides à vérifier que de saisir chaque champ à partir de zéro.
Questions fréquentes
L'extraction par IA peut-elle traiter les connaissements manuscrits ?
Oui, dans une certaine mesure. Les modèles de vision modernes lisent l'écriture manuscrite imprimée, les lettres majuscules et la plupart des cursives sur les connaissements, en particulier les champs standardisés comme les numéros de B/L, les nombres de colis et les poids, généralement écrits en caractères lisibles. La précision diminue sur les copies carbone très pâles avec des tampons superposés à l'écriture manuscrite, ou sur les documents où la pression du stylo était trop légère pour produire un scan clair. Dans ces cas, le moteur d'extraction signale le champ avec un faible score de confiance pour un examen humain, plutôt que de deviner.
L'extraction de B/L fonctionne-t-elle avec des documents de plusieurs pages ?
Oui. De nombreux connaissements maritimes s'étendent sur plusieurs pages : la première contient les informations sur les parties et l'acheminement, la deuxième détaille la cargaison et les conditions, et une troisième peut contenir les conditions générales. Les outils d'extraction par lots traitent toutes les pages comme un seul document et fusionnent les champs extraits en une seule ligne dans le tableau de sortie. L'essentiel est que l'outil reconnaît les pages de continuation plutôt que de traiter chaque page comme un document distinct.
Que se passe-t-il si deux transporteurs utilisent des noms différents pour le même champ ?
C'est là que l'extraction sémantique l'emporte sur les approches basées sur des modèles. Lorsque le transporteur A nomme le champ « Expéditeur », le transporteur B « Expéditeur/Exportateur » et le transporteur C « Consignateur », l'IA comprend que les trois désignent la même entité : la partie qui envoie les marchandises. Vous définissez votre colonne de sortie une fois comme « Nom de l'expéditeur », et l'IA fait correspondre automatiquement chaque variante de transporteur à cette colonne. Aucun mappage de champ par transporteur n'est nécessaire.
Les données extraites des B/L peuvent-elles alimenter directement mon TMS ?
La plupart des outils d'extraction en libre-service exportent vers Excel ou CSV, qui peuvent ensuite être importés dans votre TMS via sa fonction d'importation standard. Certaines plateformes TMS (comme Turvo, Descartes et McLeod) prennent en charge les modèles d'importation CSV : vous exportez les résultats d'extraction, formatez les colonnes pour qu'elles correspondent au modèle d'importation de votre TMS, puis téléchargez. Pour une intégration au niveau API qui envoie les données extraites directement dans le TMS sans transfert de fichier, vous avez besoin d'un outil avec une API REST et d'un certain travail de développement côté intégration.
L'extraction de B/L remplace-t-elle un courtier en douane ?
Non. L'extraction de données automatise l'étape de saisie — convertir les champs du connaissement en un format structuré. Elle ne remplace pas le jugement réglementaire d'un courtier en douane agréé : décisions de classement des codes SH, évaluations de la valeur, déterminations d'éligibilité aux accords de libre-échange et stratégie de déclaration en douane. Considérez l'extraction comme un moyen de supprimer le travail de frappe afin que votre courtier consacre son temps aux décisions de classement et de conformité qui nécessitent réellement une expertise.
Quelle est la précision de l'extraction IA sur les connaissements par rapport à la saisie manuelle des données ?
Une IA de documents de fret bien entraînée atteint une précision de 97 à 99 % au niveau des champs sur les connaissements numériques standard. La saisie manuelle par du personnel expérimenté atteint 96 à 99 % dans des conditions normales — et moins en période de pointe, lorsque la pression du volume augmente les taux d'erreur. La différence essentielle : les erreurs de l'IA se concentrent dans des exceptions signalées à faible confiance qui sont orientées vers une vérification humaine. Les erreurs manuelles sont aléatoires et plus difficiles à détecter avant qu'elles n'atteignent les systèmes en aval. À 500 connaissements par jour, même un taux d'erreur manuel de 1 % signifie 5 expéditions par jour avec au moins un champ incorrect — et ces erreurs passent inaperçues jusqu'à ce que quelque chose casse.
Le connaissement n'a pas beaucoup changé en un siècle — une feuille de papier qui suit la cargaison, contenant les détails qui déterminent qui paie quoi et quand les marchandises changent de mains. Ce qui a changé, c'est le coût de la saisie de ces détails dans les systèmes qui acheminent le fret, dédouanent et règlent les factures. La saisie manuelle n'a jamais été une bonne solution ; c'était simplement la seule. L'OCR basé sur des modèles l'a améliorée, puis a atteint un plafond là où la diversité des transporteurs dépasse la capacité de maintenance des modèles. L'étape suivante — l'extraction sémantique qui lit un connaissement comme le ferait un professionnel de la logistique — change l'équation économique. Essayez-la sur vos propres connaissements. Voyez si le goulot d'étranglement de la saisie de données se réduit à une file de vérification.