Como extrair dados de conhecimento de embarque
para Excel
Um transitário de tamanho médio absorbe $140.000 a $280.000 por ano em custos diretamente ligados a erros documentais — retenções alfandegárias a $200–500 por dia, taxas de emenda de transportadora a $50–150 por correção de B/L, e penalidades de direitos por classificações incorretas de código HS.[1] Mas o custo real da entrada manual de dados de conhecimento de embarque não é a mão de obra — é o dano operacional em cascada quando um único número de BOL mal digitado chega à alfândega, desencadena uma retenção, acumula sobrestadia e força um crédito a um cliente que só queria que sua carga fosse entregada a tempo. A linha de defesa não é um digitador mais rápido. É uma extração que não comete erros de digitação.
O Custo de Conformidade que Ninguém Orça
Quando as equipes de operações de frete falam sobre a dor do processamento de BOL, geralmente começam pelo volume — "processamos 500 conhecimentos de embarque por semana." A matemática do tempo é simples: 10–15 minutos por documento para entrada manual de dados, e até uma hora para BOLs multimodais complexos com muitas linhas de itens de mercadoria.[2] Mas o tempo é a parte rasa do problema.
Um estudo de 2025 da IARJSET com empresas de transporte de carga descobriu que 46,7% das empresas enfrentam penalidades diretamente causadas por erros de documentação — e 63,4% tiveram que corrigir documentação em 1–10 remessas apenas nos últimos seis meses.[3]
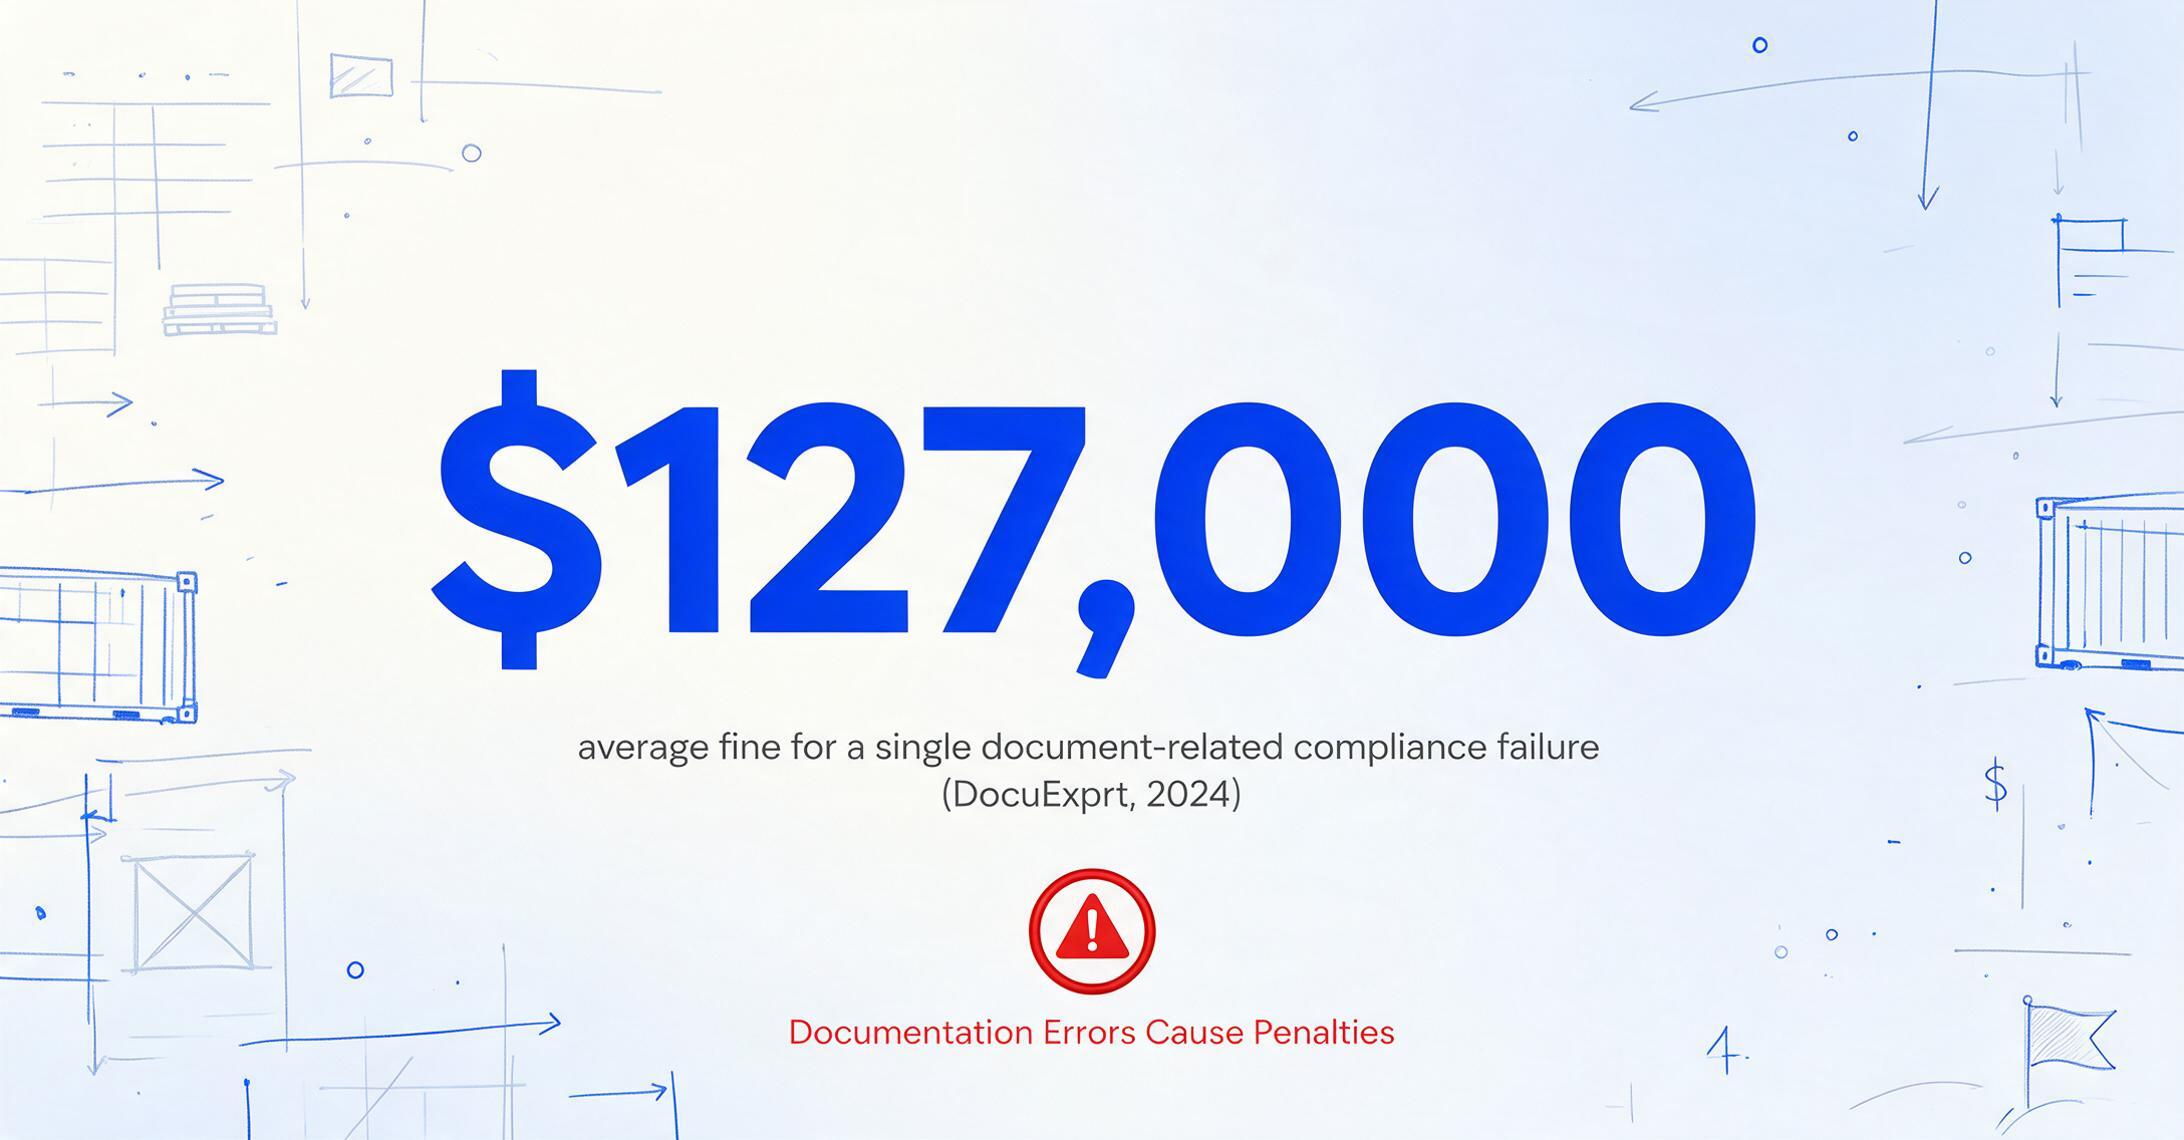
O caminho das penalidades é bem documentado. Os ajustes de penalidades monetárias civis de 2025 do Registro Federal dos EUA fixam violações de arquivamento ISF em multas que chegam a $6.000 ou mais, com penalidades por não conformidade de manifesto entre $1.740 e $4.730 por ocorrência.[4] Uma pesquisa da DocuExprt de 2024 descobriu que a multa média por uma única falha de conformidade relacionada a documentos é de $127.000, com a preparação para auditoria consumindo sozinha 120–200 horas de tempo da equipe por ano.[5]
Este é o item de orçamento que a entrada manual de dados de BOL cria — e que a extração automatizada elimina. Um erro de digitação em um número de contêiner ou um código HS digitado incorretamente não é um erro administrativo menor; é um ponto de entrada para uma cadeia de retenções alfandegárias, cobranças de armazenagem, atrasos de reclassificação e créditos ao cliente. Quando um profissional de logística no Reddit observa que os despachantes passam o dia "copiando e-mail → TMS, copiando de novo → bolsa de frete, repetindo 20× por dia," a perda de produtividade é visível. O risco de conformidade por trás de cada uma dessas operações de copiar e colar não é.
Por que o OCR padrão falha em conhecimentos de embarque
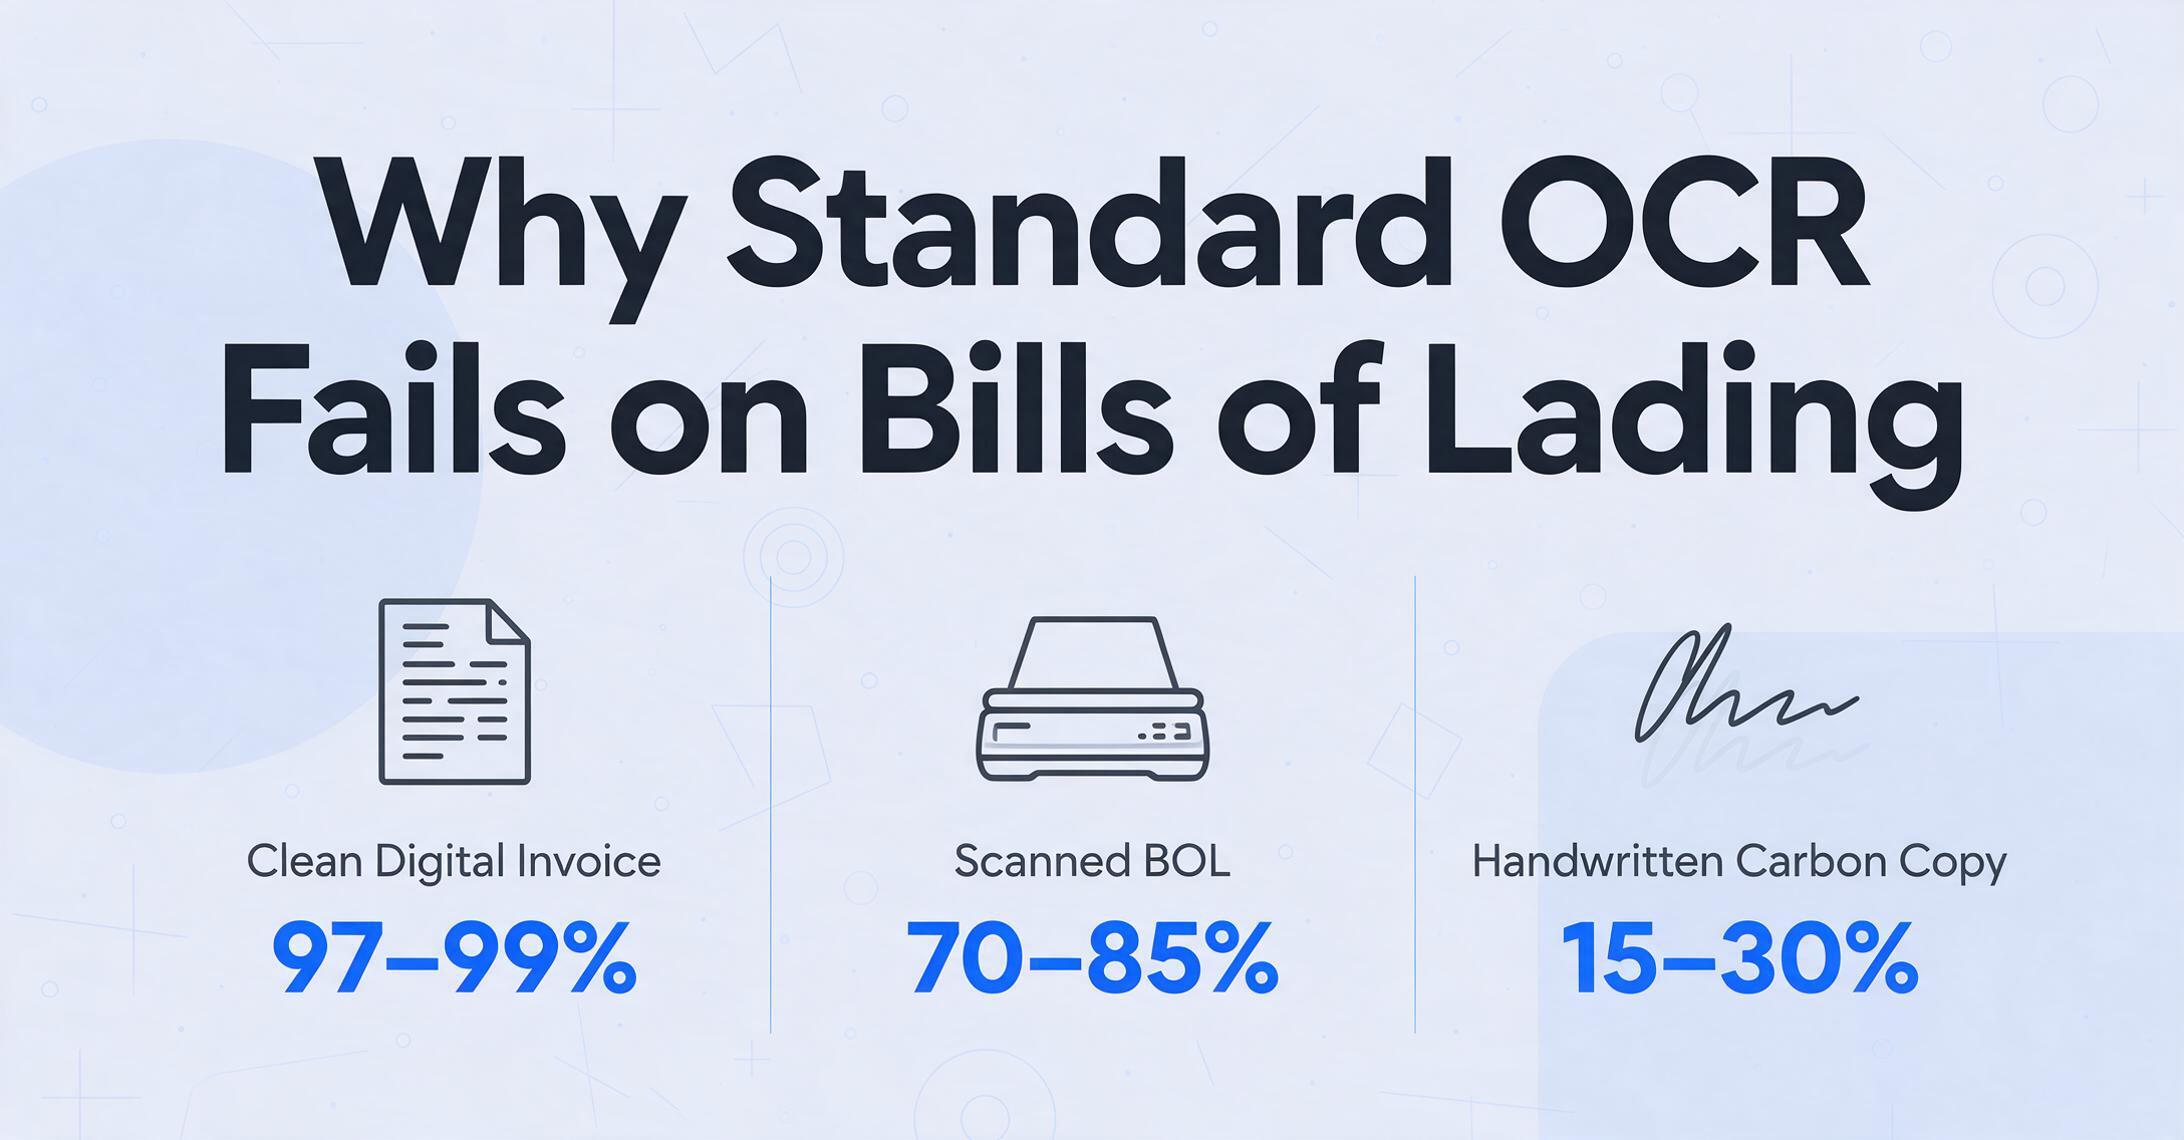
O argumento padrão para automatizar a extração de dados de BOL é este: execute o OCR no PDF digitalizado, obtenha o texto, mapeie-o para colunas de planilha. Isso funciona em uma fatura digital limpa de um único fornecedor cujo formato você conhece. Falha em conhecimentos de embarque por três motivos que se agravam mutuamente.
Cada transportadora usa seu próprio layout. Um conhecimento de embarque marítimo da Maersk coloca o bloco do embarcador no canto superior esquerdo, os detalhes da embarcação em uma tabela central e a descrição da carga em uma grade de várias linhas abaixo. Um conhecimento de embarque direto da Old Dominion usa o formato curto padronizado pela NMFTA, com descrições de mercadorias em uma grade compacta. Um BOL da FedEx Freight usa ainda outra disposição. O OCR baseado em modelo — em que você desenha zonas ao redor de cada campo e treina o sistema por layout — exige um modelo por transportadora. Um agente que lida com 50 transportadoras precisa de 50 modelos, e toda vez que uma transportadora atualiza seu formulário, esse modelo falha silenciosamente.
Manuscritos, carimbos e cópias carbono são padrão — não casos extremos. Os BOLs são frequentemente preenchidos à mão no cais de carga em papel carbono. O nome do consignatário é rabiscado à caneta, a contagem de peças é carimbada em tinta vermelha, e a terceira via carbono está desbotada a ponto de ficar quase ilegível. O OCR tradicional trata isso como ruído. Uma ferramenta que só consegue ler tipografias digitais nítidas perderá o número do BOL manuscrito, o marcador carimbado "Freight Prepaid" e o campo de peso na cópia carbono — os três dados mais propensos a gerar uma disputa de fatura com a transportadora.
A classe de frete NMFC exige compreensão semântica, não reconhecimento de caracteres. O sistema National Motor Freight Classification define 13 classes de frete (50 a 500) com base em densidade, estivagem, manuseio e responsabilidade. Um BOL pode listar "Class 70" ao lado da descrição da mercadoria, ou pode listar a mercadoria sem a classe, esperando que a transportadora a aplique. O OCR padrão lê "Class 70" como caracteres de texto. Mas a extração semântica — o tipo que um modelo de visão de IA realiza — entende que "Class 70" modifica "Wooden Furniture" e pertence à coluna de classe de frete, não à coluna de descrição da mercadoria. Essa distinção é a diferença entre uma fatura de frete precisa e uma cobrança de reclassificação de $300 três semanas depois.
Quais Dados Constan em um Conhecimento de Embarque — e Por Que Cada Campo Importa
Um conhecimento de embarque cumpre três funções legais simultaneamente: recibo de mercancías (o transportista reconoce haber recibido la carga según lo descrito), contrato de transporte (términos y condiciones del transporte) y documento de título (propiedad de la mercancía, en los BOL negociables). Cada campo del documento respalda una o más de estas funciones — y un error en cualquier campo se propaga a uno de estos dominios legales.[6] Un BOL rara vez viaja solo — vea cómo se concilia con el resto del paquete de envío en nuestra guía sobre extracción de documentos de envío y flete.
| Grupo de Campos | Campos | Consecuencia de Error |
|---|---|---|
| Partes | Nombre y dirección del embarcador, Consignatario, Parte notificada, Transportista/Código SCAC | Entrega mal dirigida, fallo en el despacho de aduanas, facturación a la parte equivocada |
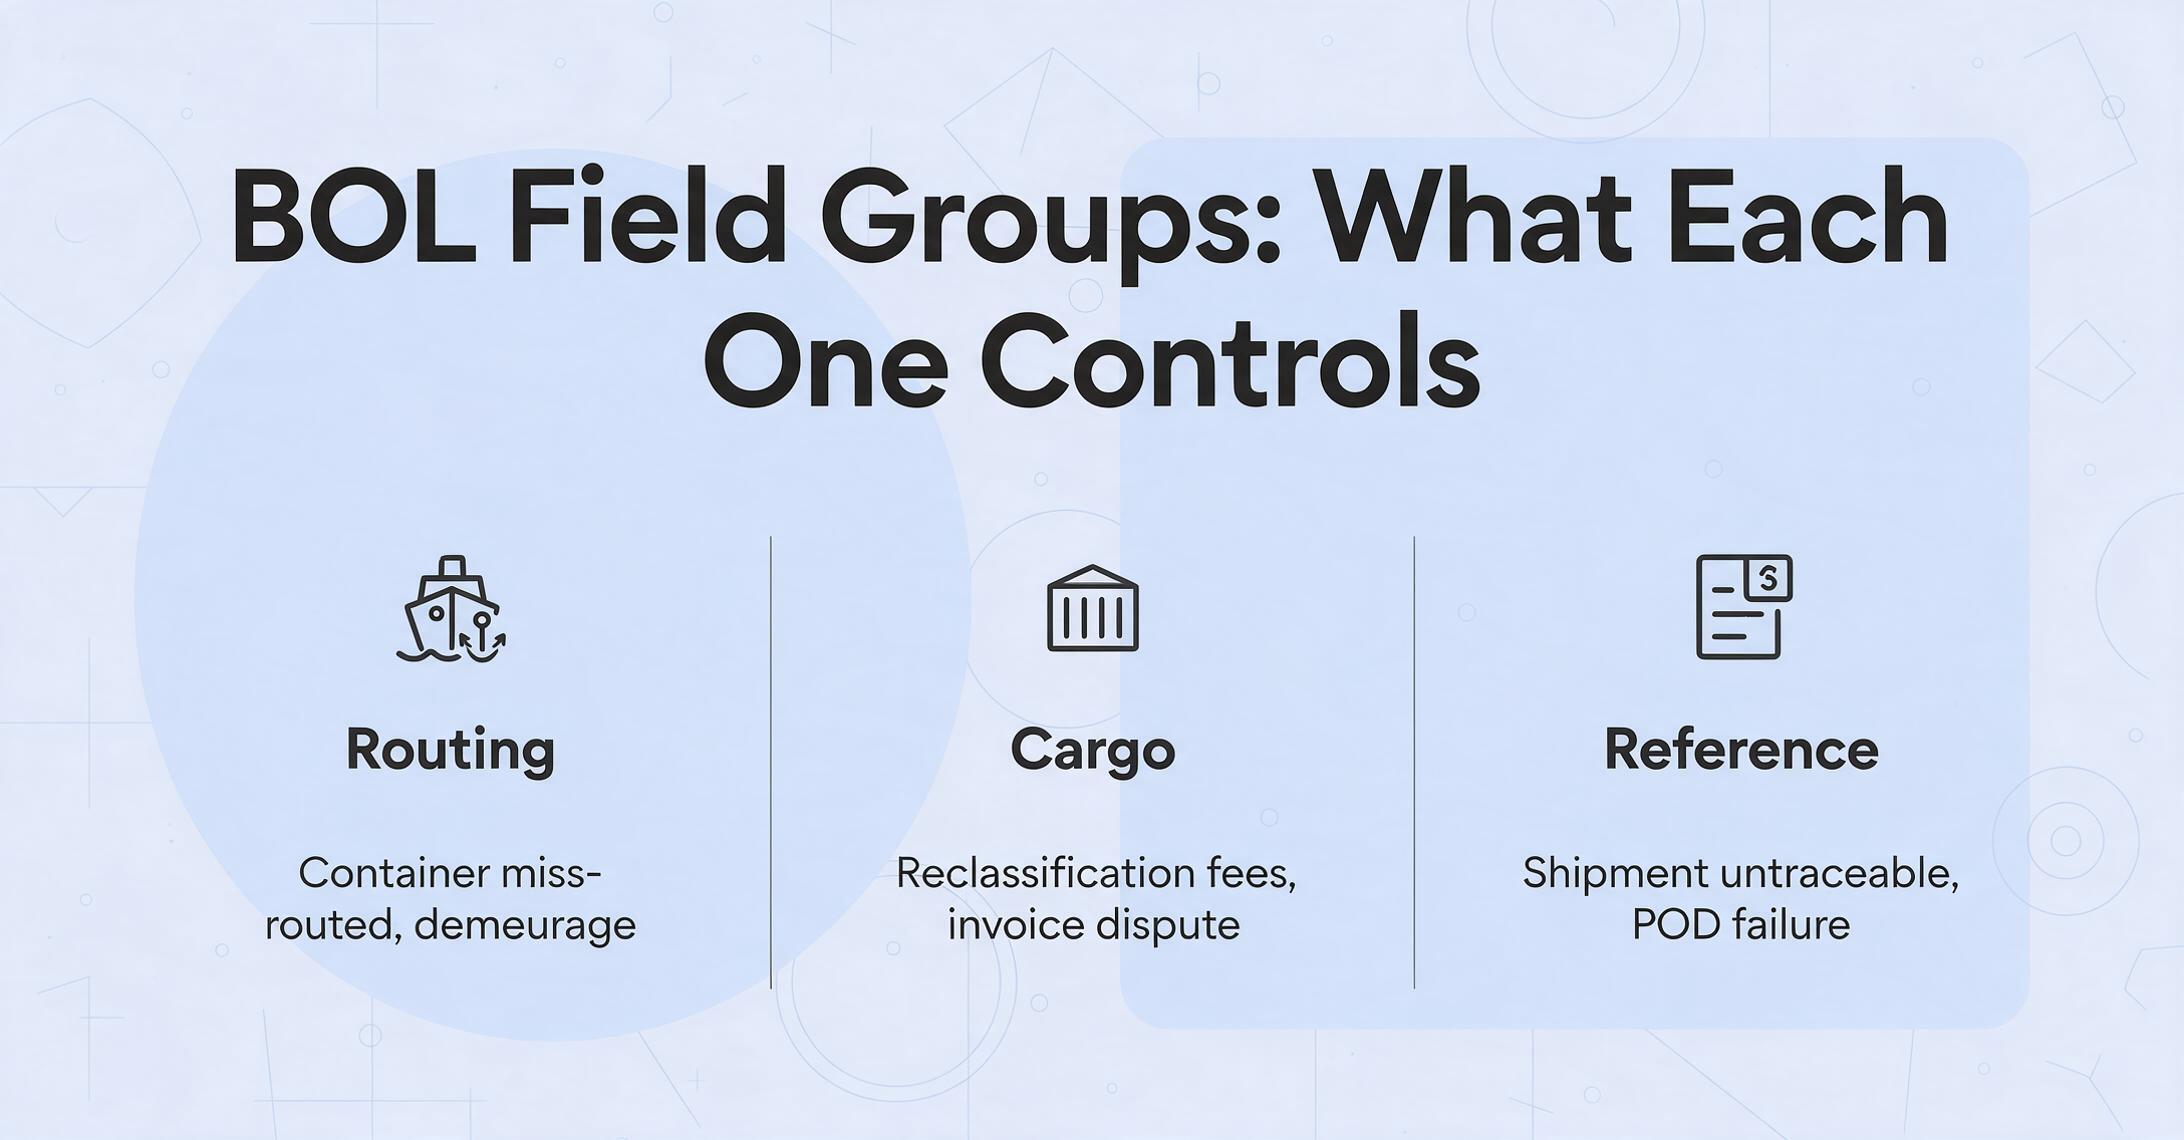
| Roteamento | Puerto de carga, Puerto de descarga, Buque/Viaje, Números de contenedor y precinto | Contenedor mal roteado, sobrestadia en terminal equivocada, discrepancia en la presentación ISF |
| Carga | Descripción de la mercancía, Número de piezas, Tipo de embalaje, Peso (bruto/neto), Dimensiones, Clase de flete, Código NMFC, Código HS | Tarifas de reclasificación, recálculo de aranceles, disputa de factura del transportista, incumplimiento de materiales peligrosos |
| Cargos y Términos | Términos de flete (prepagado/cobrar), Cargos de flete, Cargos accesorios | Parte facturada incorrecta, pago duplicado, accesorios no recuperados |
| Referencia | Número de BOL, Número PRO, Referencias de PO, Fechas de recogida/entrega | Envío no rastreable, ventanas de entrega perdidas, fallo en la verificación de POD |
Observe que el grupo de Carga — descripciones de mercancía, pesos, número de piezas, clase de flete — es la sección con más densidad de datos y la más propensa a errores. También es la sección que más varía entre transportistas. Un transportista usa cinco líneas de mercancía con pesos individuales; otro usa una sola línea consolidada con un peso global. Un tercero estampa "NMFC 156600 Sub 3" en el margen. La herramienta de extracción no necesita conocer el diseño. Necesita saber qué significa cada una de estas cosas.
Do PDF à Planilha: Como Funciona a Extração por IA
O fluxo de trabalho que substituye a entrada manual de dados de conhecimento de embarque é enganosamente simples. Você define as colunas de saída que deseja — não onde os dados estão no documento. Essa inversão é o núcleo da abordagem: em vez de dizer à ferramenta "o número de conhecimento de embarque está no canto superior direito do formulário desta transportadora", você diz "extraiga o número de conhecimento de embarque" e deixa que a IA o localize entendendo como é um número de conhecimento de embarque no contexto.
Para uma operação logística que processa conhecimentos de embarque de várias transportadoras, a configuração de colunas pode ser: Número de Conhecimento de Embarque, Nome do Remitente, Nome do Consignatário, SCAC da Transportadora, Número de Contêiner, Porto de Carga, Porto de Descarga, Descripção da Mercancía, Contagem de Peças, Peso (lbs), Classe de Frete, Termos de Frete, Tarifas de Frete. Estes nomes de colunas se tornam os cabeçalhos do Excel. A IA lê cada conhecimento de embarque enviado, encontra os valores e preenche as filas — independentemente de o conhecimento de embarque vir de Maersk, Old Dominion ou de uma cópia carbono manuscrita de uma transportadora local.
Isto é Extraction de Colunas Personalizadas: você digita os nomes dos campos que deseja, e a IA localiza cada valor entendendo o que significa — não onde está na página. Diferente do OCR baseado em modelos que desenha zonas ao redor de posições fixas, esta abordagem se adapta a qualquer layout de conhecimento de embarque de transportadora sem configuração. Um corredor de frete com 50 transportadoras carrega todas as 50 no mesmo lote e obtiene uma única planilha unificada.
Os arquivos são processados de forma segura e não são armazenados. Prove com um conhecimento de embarque de exemplo.
Após a extração, os dados chegam em uma planilha Excel estruturada — cada fila é um conhecimento de embarque, cada columna é um campo extraído. Esta saída é nativa de planilha: vai diretamente ao Excel, Google Sheets ou CSV, pronta para cargar no seu TMS ou passar por uma auditoría de frete. Não há etapa de conversão intermediária de JSON a CSV, nem assistente de mapeo de campos entre o motor de extração e sua planilha. Para equipes que usam Google Sheets, há até um complemento de barra lateral que executa a extração diretamente dentro de uma planilha sem sair da aba.
A Armadilha dos Modelos: Por Que Configurações por Transportadora Não Escalam
A logística tem um problema estrutural que torna a extração baseada em modelos fundamentalmente inadequada: a rotatividade de transportadoras e a variabilidade de formatos são características do mercado, não falhas. Um corretor não controla quais transportadoras seus embarcadores usam. Um agente de carga que reserva frete em diferentes rotas pode usar 8 transportadoras marítimas diferentes e 15 empresas de caminhão diferentes em um único mês. Cada uma emite seus BOLs em seu próprio formato.
O OCR baseado em modelos exige uma etapa de configuração por formato de transportadora: desenhe uma caixa delimitadora em torno de "Nome do Embarcador", rotule-a, repita para cada campo necessário. Multiplique por 50 transportadoras. Multiplique novamente sempre que uma transportadora atualizar seu modelo de formulário. O custo de manutenção escala linearmente com o número de transportadoras — o que significa que o cenário exato onde a extração deveria gerar mais valor (alta diversidade de transportadoras) é o cenário onde a manutenção de modelos se torna insustentável.
É por isso que uma abordagem sem modelo e independente de formato é importante especificamente para a extração de BOLs. A IA não precisa saber que a Maersk coloca o embarcador no canto superior esquerdo e a Old Dominion o coloca em uma caixa rotulada como "Embarcador/Exportador". Ela lê o documento como um profissional de logística lê — escaneando a entidade que corresponde ao padrão semântico de um embarcador, independentemente de onde ela aparece fisicamente na página. Isso não é apenas uma configuração mais rápida. É a diferença entre um pipeline de extração que funciona no primeiro dia para todas as suas transportadoras e um que exige manutenção contínua de modelos para cada nova transportadora integrada.
Escolhendo entre Ferramentas de Autoatendimento, Integração de API e Plataformas Empresariais
O mercado de extração de dados de BOL se divide em três perfis operacionais. A escolha certa depende do seu volume, seus recursos técnicos e se a extração é uma melhoria independente ou parte de uma estratégia de automação mais ampla.
Ferramentas de Upload Autônomas
Para: Corretores de frete, pequenos despachantes, equipes operacionais que processam 50–500 conhecimentos de embarque/mês
Abordagem: Envie os conhecimentos de embarque → digite os nomes das colunas → baixe o Excel. Sem configuração de API, sem necessidade de desenvolvedor.
Requisito principal: Extração sem modelo em todas as transportadoras. Se você precisar criar um modelo por transportadora, essa abordagem falha na sua escala.
Integração via API
Para: Plataformas TMS, sistemas de corretagem, ferramentas internas que processam 500 a 5.000 conhecimentos de embarque/mês
Abordagem: A API REST recebe os arquivos de conhecimento de embarque e retorna JSON/CSV estruturado com pontuações de confiança por campo.
Requisito principal: Pontuação de confiança para que seu sistema possa encaminhar automaticamente extrações de baixa confiança para revisão humana.
Plataformas Empresariais
Para: Grandes 3PLs, transportadores globais que processam mais de 5.000 conhecimentos de embarque/mês com necessidades de automação de conformidade
Abordagem: IDP de ponta a ponta com ingestão por e-mail, extração, regras de validação, roteamento de exceções e envio para TMS/ERP.
Requisito principal: Tratamento gerenciado de exceções e trilha de auditoria — não apenas precisão de extração.
Para a maioria dos corretores de frete e transportadores de médio porte, o nível autônomo é o ideal: sem custo de integração, valor imediato desde o primeiro dia e preço por página que acompanha o uso real, em vez de uma assinatura fixa de plataforma. A ferramenta processa uma página de conhecimento de embarque em 5 a 10 segundos — em comparação com os 10 a 15 minutos de entrada manual de dados — e exporta diretamente para o Excel. Nessa velocidade, uma equipe que processa 100 conhecimentos de embarque por dia recupera cerca de 20 horas de trabalho diariamente. Se você está avaliando ferramentas autônomas em comparação com plataformas empresariais em toda a sua variedade de documentos — não apenas conhecimentos de embarque — o nosso guia do comprador de extração de documentos logísticos cobre os critérios de avaliação mais amplos.
Uma nuance que vale destacar: nenhuma ferramenta de extração alcança 100% de processamento direto em conhecimentos de embarque. Cópias carbono manuscritas com carimbos sobre texto desbotado gerarão pontuações de confiança mais baixas. A expectativa correta de fluxo de trabalho é de 85 a 95% de extração automatizada com uma fila de revisão para campos sinalizados — não processamento sem supervisão. Mas mesmo com 85% de automação, os 15% restantes que caem na fila de revisão ainda são mais rápidos de verificar do que digitar cada campo do zero.
Perguntas Frequentes
A extração por IA consegue lidar com conhecimentos de embarque manuscritos?
Sim — dentro de certos limites. Modelos modernos de visão leem letra de forma, letras maiúsculas e a maioria das cursivas em BOLs, especialmente campos padronizados como números de BOL, contagens de peças e pesos, geralmente escritos em letra legível. A precisão cai em cópias carbono desbotadas com carimbos sobrepostos à caligrafia, ou em documentos com pressão da caneta muito leve para um escaneamento nítido. Nesses casos, o mecanismo de extração sinaliza o campo com baixa confiança para revisão humana, em vez de adivinhar.
A extração de BOL funciona com documentos de várias páginas?
Sim. Muitos BOLs marítimos têm várias páginas — a primeira traz informações das partes e rota, a segunda lista os detalhes da carga e termos, e uma terceira pode conter as cláusulas contratuais padrão. Ferramentas de extração em lote processam todas as páginas como um único documento e mesclam os campos extraídos em uma linha na planilha de saída. O segredo é que a ferramenta reconhece páginas de continuação, em vez de tratar cada página como um documento separado.
O que acontece se duas transportadoras usarem nomes diferentes para o mesmo campo?
É exatamente aí que a extração semântica supera as abordagens baseadas em modelos. Quando a Transportadora A nomeia o campo "Shipper", a Transportadora B o chama de "Shipper/Exporter" e a Transportadora C escreve "Consignor", a IA entende que todos se referem à mesma entidade — a parte que envia as mercadorias. Você define sua coluna de saída uma vez como "Nome do Remetente", e a IA mapeia automaticamente cada variante da transportadora para essa coluna. Sem necessidade de mapeamento de campo por transportadora.
Os dados extraídos do BOL podem alimentar diretamente meu TMS?
A maioria das ferramentas de extração self-service exporta para Excel ou CSV, que podem ser importados para seu TMS pela função de importação padrão. Alguns TMS (como Turvo, Descartes e McLeod) suportam modelos de importação CSV — você exporta os resultados, formata as colunas para corresponder ao modelo do seu TMS e faz o upload. Para integração via API que envie os dados extraídos diretamente ao TMS sem transferência de arquivos, você precisaria de uma ferramenta com API REST e algum trabalho de desenvolvimento na integração.
A extração de BOL substitui um despachante aduaneiro?
Não. A extração de dados automatiza a etapa de entrada de dados — transformar os campos do BOL em um formato estruturado. Ela não substitui o julgamento regulatório que um despachante aduaneiro licenciado oferece: decisões de classificação da NCM, avaliações de valor, determinações de elegibilidade para acordos de livre comércio e estratégia de registro de declarações de importação. Pense na extração como a eliminação do trabalho de digitação para que seu despachante dedique seu tempo às decisões de classificação e conformidade que realmente exigem expertise.
Qual é a precisão da extração por IA em conhecimentos de embarque em comparação com a entrada manual de dados?
Uma IA de documentos de frete bem treinada alcança 97–99% de precisão em nível de campo em conhecimentos de embarque digitais padrão. A entrada manual de dados por funcionários experientes fica entre 96–99% em condições normais — e menor durante períodos de pico, quando a pressão de volume aumenta as taxas de erro. A diferença crítica: os erros da IA se concentram em exceções sinalizadas de baixa confiança que são encaminhadas para revisão humana. Os erros manuais são aleatórios e mais difíceis de detectar antes de chegarem aos sistemas downstream. Com 500 conhecimentos de embarque por dia, mesmo uma taxa de erro manual de 1% significa 5 remessas por dia com pelo menos um campo errado — e esses erros passam despercebidos até que algo falhe.
O conhecimento de embarque não mudou muito em um século — um pedaço de papel que acompanha a carga, carregando os detalhes que determinam quem paga o quê e quando as mercadorias mudam de mãos. O que mudou é o custo de colocar esses detalhes nos sistemas que roteiam o frete, liberam na alfândega e liquidam faturas. A entrada manual nunca foi uma boa solução; era apenas a única solução. O OCR com modelo melhorou isso e depois atingiu um teto no ponto em que a diversidade de transportadoras excede a capacidade de manutenção de modelos. O próximo passo — extração semântica que lê um conhecimento de embarque da mesma forma que um profissional de logística o lê — muda a equação econômica. Experimente com seus próprios conhecimentos de embarque. Veja se o gargalo de entrada de dados se reduz a uma fila de revisão.