So extrahieren Sie Konnossement-
daten in Excel
Ein mittelgroßer Spediteur trägt 140.000 bis 280.000 $ pro Jahr an Kosten, die direkt auf Dokumentfehler zurückzuführen sind – Zollstopps mit 200–500 $ pro Tag, Änderungsgebühren der Carrier mit 50–150 $ pro BOL-Korrektur und Zollstrafen durch falsche HS-Codes.[1] Doch die eigentlichen Kosten der manuellen Konnossement-Dateneingabe liegen nicht in der Arbeit – sondern im kaskadenartigen operativen Schaden, wenn eine einzige falsch getippte BOL-Nummer den Zoll erreicht, einen Stopp auslöst, Liegegeld anhäuft und einen Kunden, der nur seine pünktlich gelieferte Fracht wollte, zu einer Gutschrift zwingt. Die Verteidigungslinie ist kein schnellerer Tippfehler. Es ist die Extraktion, die keine Tippfehler macht.
Die Compliance-Kosten, die niemand einplant
Wenn Teams in der Frachtabwicklung über die Schmerzen bei der BOL-Verarbeitung sprechen, beginnen sie meist mit dem Volumen – „wir bearbeiten 500 Konnossemente pro Woche." Die Zeitrechnung ist einfach: 10–15 Minuten pro Dokument für die manuelle Dateneingabe und bis zu einer Stunde für komplexe multimodale BOLs mit umfangreichen Warenpositionszeilen.[2] Aber Zeit ist nur das oberflächliche Ende des Problems.
Eine IARJSET-Studie aus dem Jahr 2025 über Speditionsunternehmen ergab, dass 46,7 % der Unternehmen Strafen erleiden, die direkt auf Dokumentationsfehler zurückzuführen sind – und 63,4 % mussten allein in den letzten sechs Monaten die Dokumentation für 1–10 Sendungen korrigieren.[3]
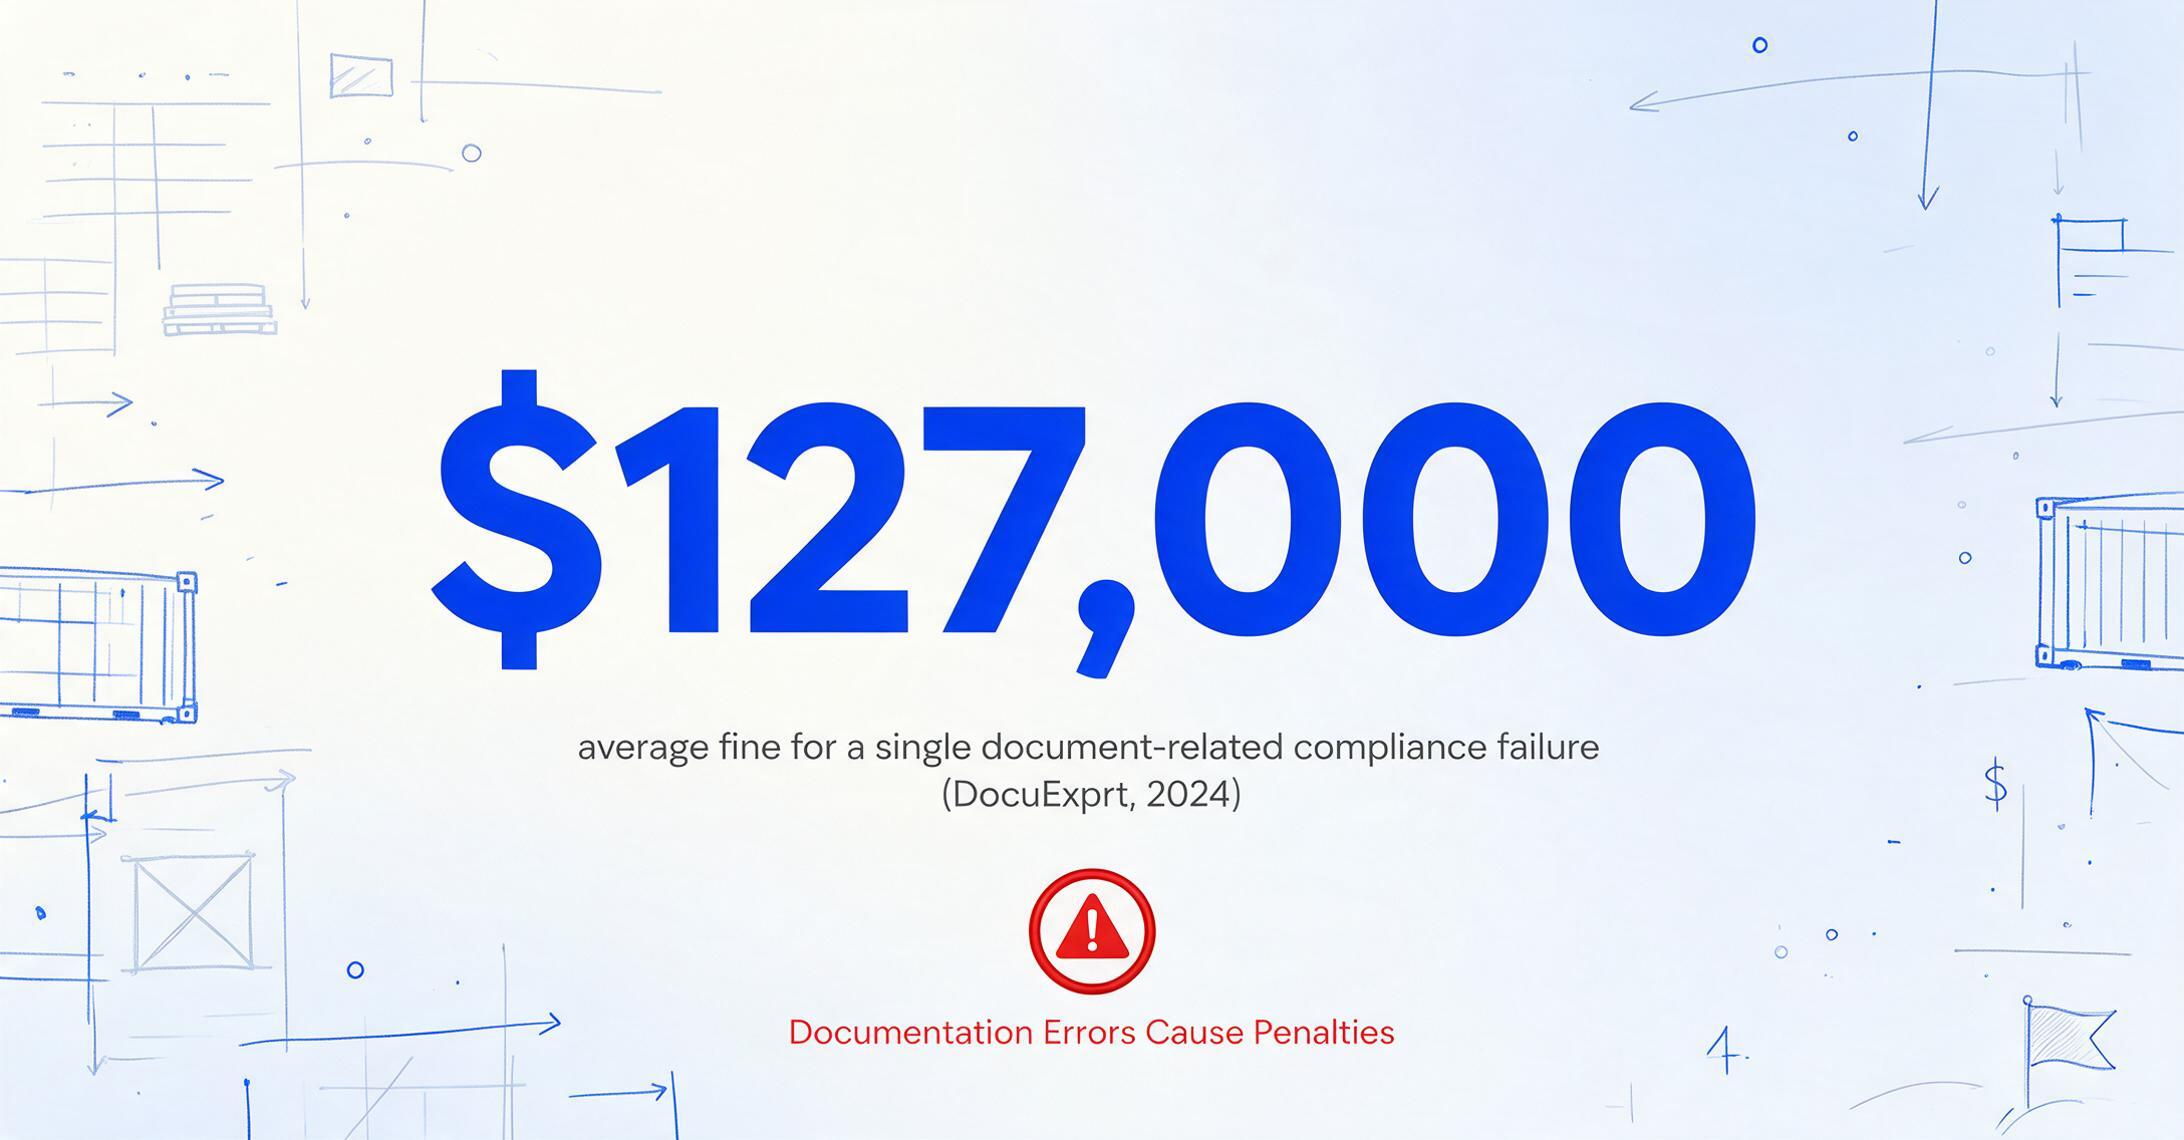
Der Weg zur Strafe ist gut dokumentiert. Die Anpassungen der zivilrechtlichen Geldstrafen des US-Bundesregisters für 2025 setzen Verstöße gegen die ISF-Meldung mit Geldstrafen von 6.000 $ oder mehr an, wobei Strafen für die Nichteinhaltung der Manifestvorschriften zwischen 1.740 $ und 4.730 $ pro Vorfall liegen.[4] Eine DocuExprt-Umfrage aus dem Jahr 2024 ergab, dass die durchschnittliche Geldstrafe für einen einzelnen dokumentbezogenen Compliance-Verstoß 127.000 $ beträgt, wobei allein die Vorbereitung auf Audits 120–200 Arbeitsstunden pro Jahr in Anspruch nimmt.[5]
Dies ist der Budgetposten, den die manuelle BOL-Dateneingabe schafft – und den die automatisierte Extraktion eliminiert. Ein Tippfehler bei einer Containernummer oder ein falsch eingegebener HS-Code ist kein geringfügiger Schreibfehler; er ist ein Einstiegspunkt in eine Kette aus Zollstopps, Lagerkosten, Neuklassifizierungsverzögerungen und Kundengutschriften. Wenn ein Logistikprofi auf Reddit bemerkt, dass Disponenten ihren Tag damit verbringen, „E-Mail → TMS zu kopieren, erneut → Frachtbörse zu kopieren, 20× am Tag zu wiederholen", ist der Produktivitätsverlust sichtbar. Das Compliance-Risiko hinter jedem dieser Kopier- und Einfügevorgänge ist es nicht.
Warum Standard-OCR bei Konnossementen versagt
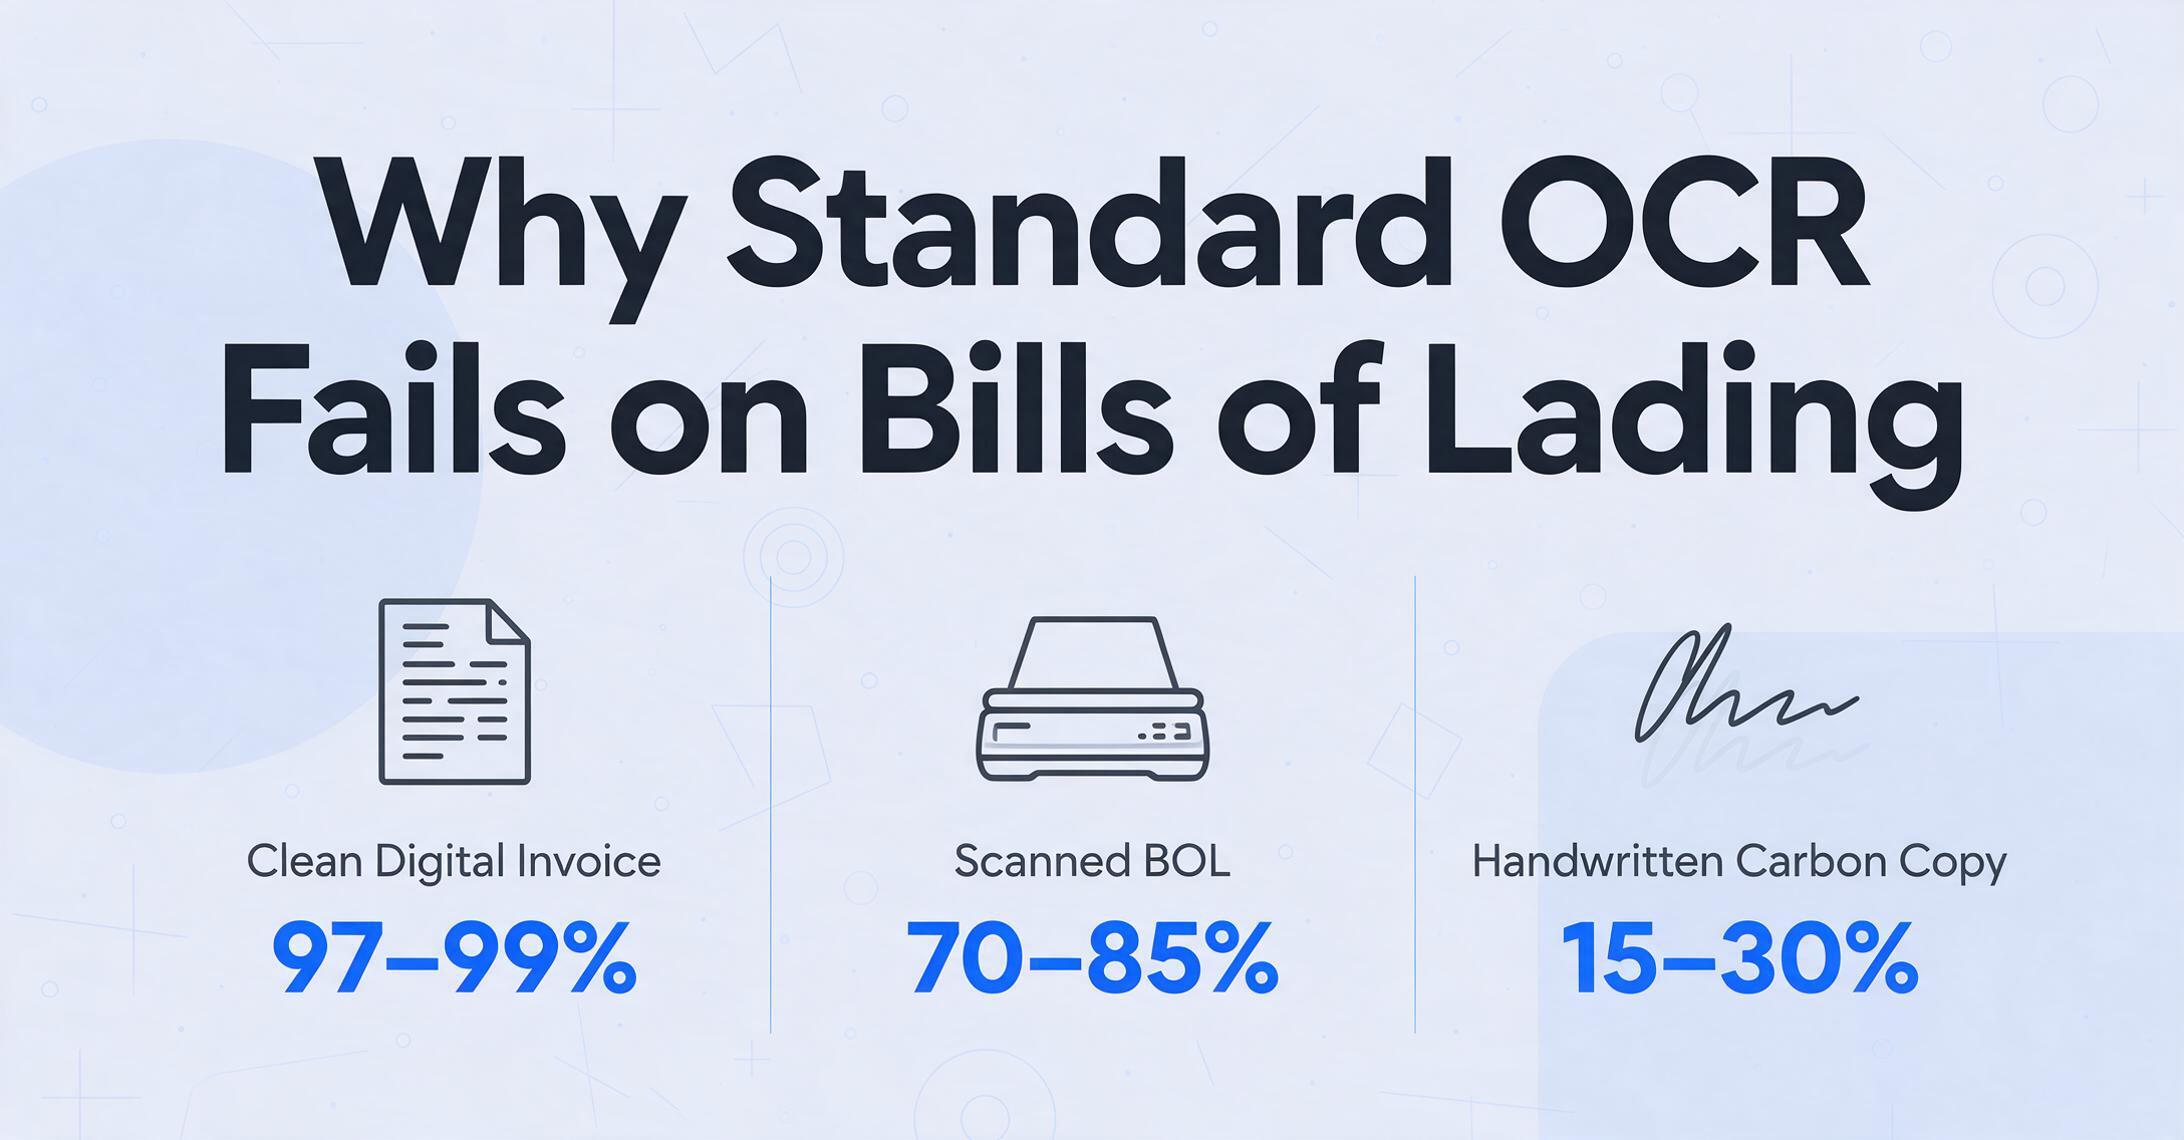
Das Standardargument für die Automatisierung der BOL-Datenextraktion lautet: OCR auf das gescannte PDF anwenden, den Text erhalten, in Tabellenspalten übertragen. Das funktioniert bei einer sauberen digitalen Rechnung eines einzelnen Anbieters, dessen Format Sie kennen. Bei Konnossementen scheitert es aus drei Gründen, die sich gegenseitig verstärken.
Jeder Frachtführer verwendet sein eigenes Layout. Ein See-Konnossement von Maersk platziert den Absenderblock oben links, die Schiffsdetails in einer mittleren Tabelle und die Frachtbeschreibung in einem mehrzeiligen Raster darunter. Ein gerades Konnossement von Old Dominion verwendet das NMFTA-standardisierte Kurzformat mit Frachtbeschreibungen in einem engmaschigen Raster. Ein FedEx-Freight-Konnossement verwendet wiederum ein anderes Arrangement. Template-basierte OCR – bei der Sie Zonen um jedes Feld ziehen und das System pro Layout trainieren – erfordert ein Template pro Frachtführer. Ein Spediteur, der 50 Frachtführer abwickelt, benötigt 50 Templates, und jedes Mal, wenn ein Frachtführer sein Formular aktualisiert, bricht dieses Template stillschweigend.
Handschrift, Stempel und Durchschriften sind Standard – keine Randfälle. Konnossemente werden häufig von Hand am Verladedock auf Durchschlagpapier ausgefüllt. Der Name des Empfängers ist mit Kugelschreiber gekritzelt, die Stückzahl ist mit roter Tinte überstempelt, und die dritte Durchschrift ist bis zur Unleserlichkeit verblasst. Traditionelle OCR behandelt dies als Rauschen. Ein Tool, das nur gestochen scharfe digitale Schriftarten lesen kann, übersieht die handschriftliche BOL-Nummer, den gestempelten Vermerk „Fracht bezahlt" und das Gewichtsfeld der Durchschrift – die drei Datenpunkte, die am wahrscheinlichsten einen Streit um die Frachtrechnung des Frachtführers auslösen.
Die NMFC-Frachtklasse erfordert semantisches Verständnis, nicht Zeichenerkennung. Das National Motor Freight Classification-System definiert 13 Frachtklassen (50 bis 500) basierend auf Dichte, Stauungsfähigkeit, Handhabung und Haftung. Ein BOL könnte „Klasse 70" neben der Frachtbeschreibung aufführen, oder es könnte die Fracht ohne die Klasse aufführen und erwarten, dass der Frachtführer sie anwendet. Standard-OCR liest „Klasse 70" als Textzeichen. Aber semantische Extraktion – die Art, die ein KI-Visionsmodell durchführt – versteht, dass „Klasse 70" „Holzmöbel" modifiziert und in die Spalte Frachtklasse gehört, nicht in die Spalte Frachtbeschreibung. Dieser Unterschied ist der Unterschied zwischen einer korrekten Frachtrechnung und einer Nachbelastung von 300 $ für eine Neuklassifizierung drei Wochen später.
Welche Daten enthält ein Konnossement – und warum jedes Feld wichtig ist
Ein Konnossement erfüllt gleichzeitig drei rechtliche Funktionen: Empfangsbestätigung der Ware (der Frachtführer bestätigt den Erhalt der beschriebenen Ladung), Beförderungsvertrag (Bedingungen der Beförderung) und Wertpapier (Eigentum an der Ware, bei begebbaren BOLs). Jedes Feld des Dokuments unterstützt eine oder mehrere dieser Funktionen – und ein Fehler in einem Feld wirkt sich auf einen dieser Rechtsbereiche aus.[6] Ein BOL reist selten allein – erfahren Sie, wie er mit den übrigen Versanddokumenten abgeglichen wird, in unserem Leitfaden zur Extraktion von Versand- und Frachtdokumenten.
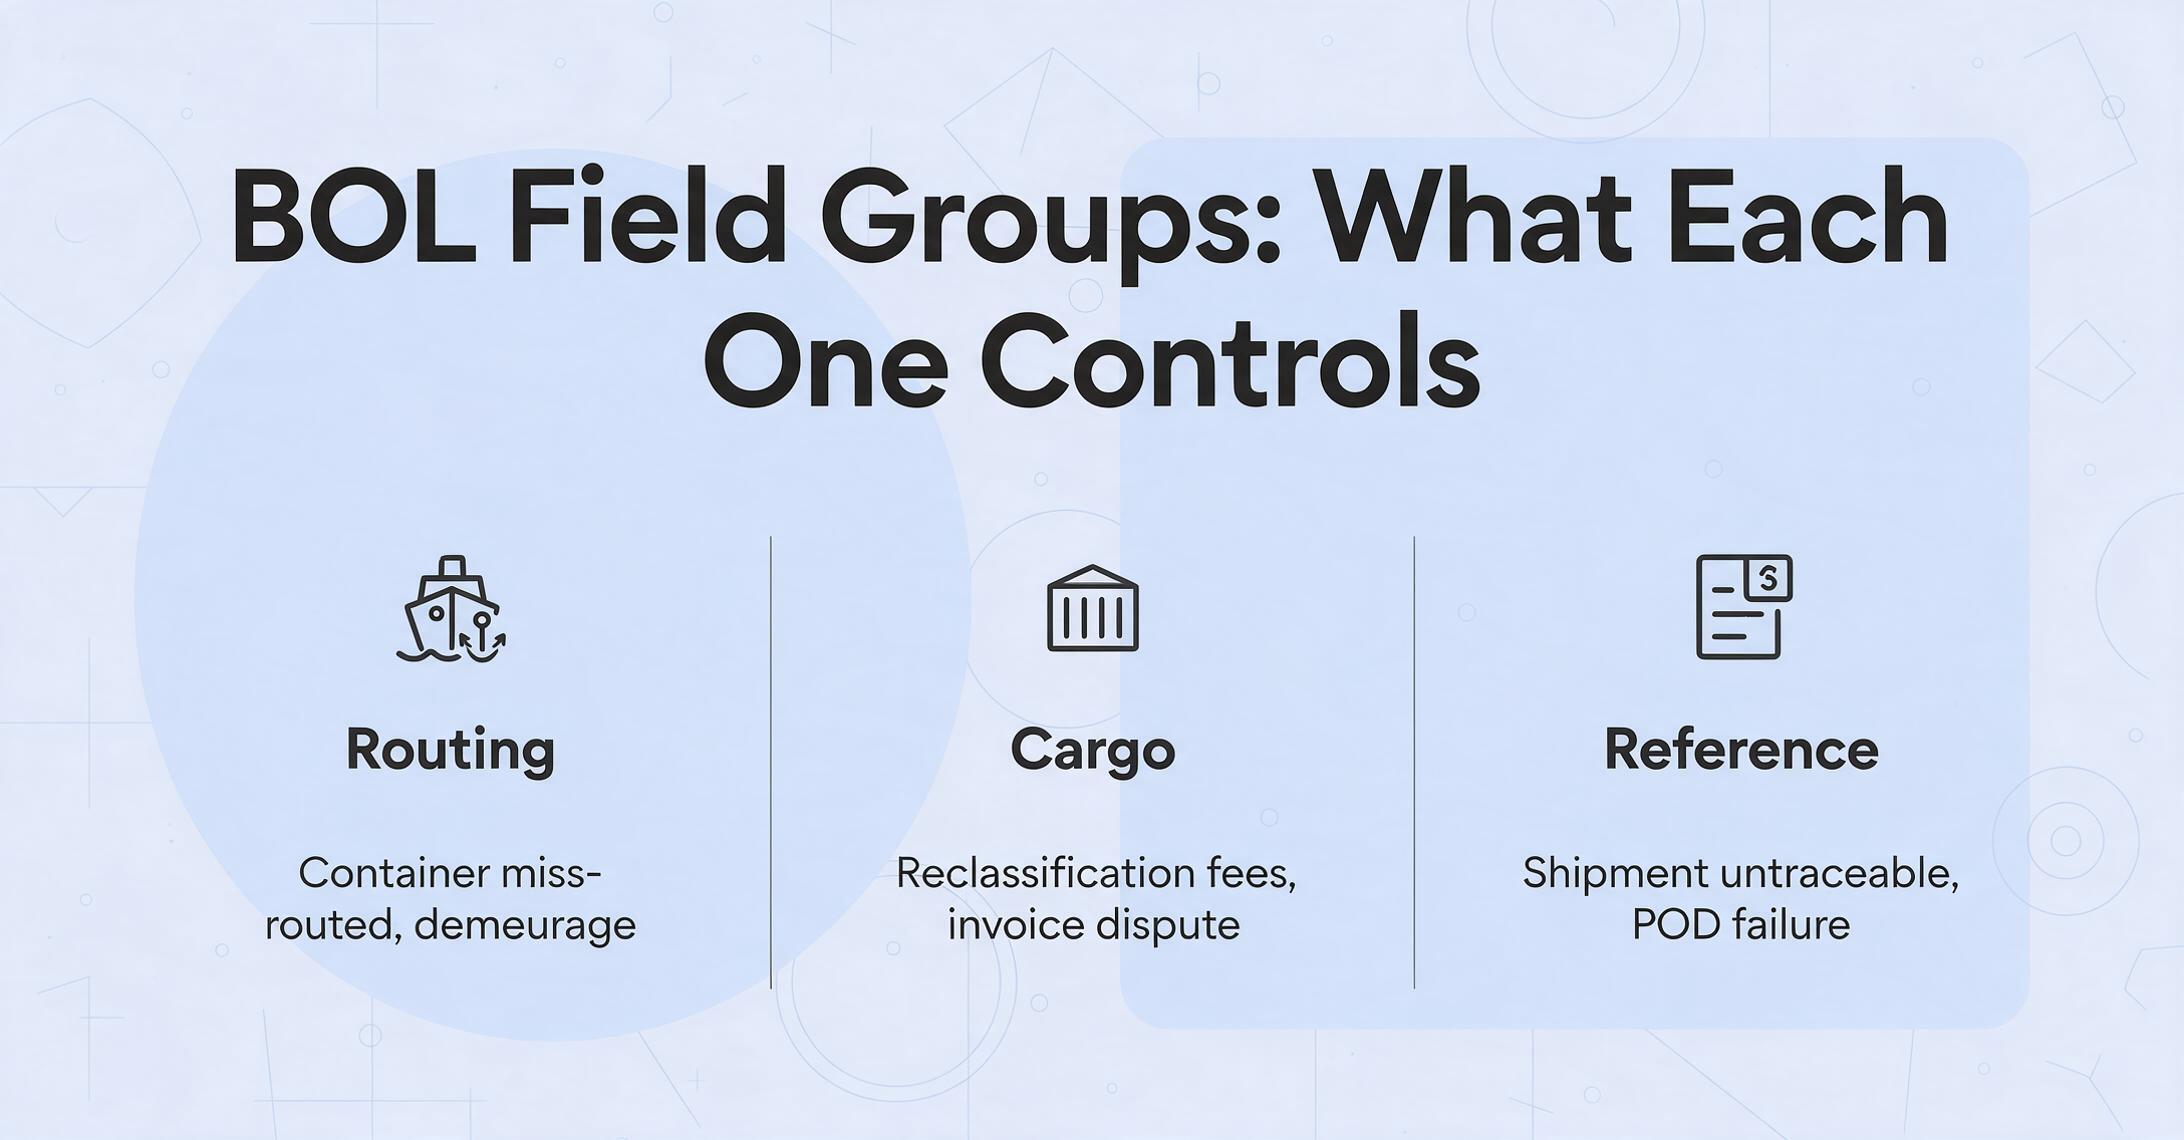
| Feldgruppe | Felder | Folge bei Fehlern |
|---|---|---|
| Parteien | Name und Adresse des Versenders, Empfänger, Benachrichtigungspartei, Frachtführer/SCAC-Code | Fehlgeleitete Lieferung, Zollabfertigungsfehler, falsche Partei wird belastet |
| Routing | Verladehafen, Löschhafen, Schiff/Reise, Container- und Plombennummern | Container falsch geleitet, Liegegeld am falschen Terminal, ISF-Angaben stimmen nicht überein |
| Fracht | Warenbeschreibung, Stückzahl, Verpackungsart, Gewicht (brutto/netto), Maße, Frachtklasse, NMFC-Code, HS-Code | Neuklassifizierungsgebühren, Neuberechnung von Zöllen, Rechnungsstreit mit Frachtführer, Nichteinhaltung von Gefahrgutvorschriften |
| Gebühren & Bedingungen | Frachtbedingungen (vorausbezahlt/nachzuzahlen), Frachtkosten, Nebengebühren | Falsche zahlungspflichtige Partei, doppelte Zahlung, nicht eingezogene Nebengebühren |
| Referenz | BOL-Nummer, PRO-Nummer, PO-Referenzen, Abhol-/Liefertermine | Sendung nicht nachverfolgbar, verpasste Lieferfenster, POD-Überprüfungsfehler |
Beachten Sie, dass die Frachtgruppe – Warenbeschreibungen, Gewichte, Stückzahlen, Frachtklasse – der datenintensivste und fehleranfälligste Abschnitt ist. Sie variiert auch am stärksten zwischen den Frachtführern. Ein Frachtführer verwendet fünf Warenpositionen mit Einzelgewichten; ein anderer eine einzige zusammengefasste Position mit einem Gesamtgewicht. Ein dritter stempelt „NMFC 156600 Sub 3" an den Rand. Das Extraktionstool muss das Layout nicht kennen. Es muss wissen, was jede dieser Angaben bedeutet.
Vom PDF zur Tabelle: So funktioniert KI-Extraktion wirklich
Der Arbeitsablauf, der die manuelle BOL-Dateneingabe ersetzt, ist täuschend einfach. Sie definieren die Ausgabespalten, die Sie möchten – nicht, wo die Daten auf dem Dokument stehen. Diese Umkehrung ist der Kern des Ansatzes: Statt dem Tool zu sagen „die BOL-Nummer steht in der oberen rechten Ecke des Formulars dieses Spediteurs", sagen Sie „extrahiere die BOL-Nummer" und lassen die KI sie lokalisieren, indem sie versteht, wie eine BOL-Nummer im Kontext aussieht.
Für einen Logistikbetrieb, der BOLs mehrerer Spediteure verarbeitet, könnte die Spalteneinrichtung so aussehen: BOL-Nummer, Name des Versenders, Name des Empfängers, SCAC des Spediteurs, Containernummer, Verladehafen, Löschhafen, Warenbeschreibung, Stückzahl, Gewicht (lbs), Frachtklasse, Frachtbedingungen, Frachtkosten. Diese Spaltennamen werden zu den Excel-Kopfzeilen. Die KI liest jedes hochgeladene BOL, findet die Werte und füllt die Zeilen – unabhängig davon, ob das BOL von Maersk, Old Dominion oder einer handschriftlichen Durchschrift eines lokalen Cartage-Spediteurs stammt.
Dies ist Benutzerdefinierte Spaltenextraktion: Sie geben die gewünschten Feldnamen ein, und die KI lokalisiert jeden Wert, indem sie versteht, was er bedeutet – nicht, wo er auf der Seite steht. Im Gegensatz zu template-basiertem OCR, das Zonen um feste Positionen zeichnet, passt sich dieser Ansatz ohne Konfiguration an jedes BOL-Layout eines Spediteurs an. Ein Frachtmakler mit 50 Spediteuren lädt alle 50 in denselben Batch und erhält eine einheitliche Tabelle.
Dateien werden sicher verarbeitet und nicht gespeichert. Probieren Sie es mit einem Beispiel-BOL aus.
Nach der Extraktion landen die Daten in einer strukturierten Excel-Tabelle – jede Zeile ist ein BOL, jede Spalte ein extrahiertes Feld. Diese Ausgabe ist tabellen-nativ: Sie geht direkt in Excel, Google Sheets oder CSV, bereit zum Hochladen in Ihr TMS oder zur Durchführung eines Frachtaudits. Es gibt keinen Zwischenschritt zur JSON-zu-CSV-Konvertierung, keinen Feldzuordnungs-Assistenten zwischen der Extraktionsengine und Ihrer Tabelle. Für Teams, die Google Sheets verwenden, gibt es sogar ein Sidebar-Add-on, das die Extraktion direkt in einer Tabelle ausführt, ohne den Tab zu verlassen.
Die Vorlagenfalle: Warum speditörspezifische Setups nicht skalieren
Die Logistikbranche hat ein strukturelles Problem, das vorlagenbasierte Extraktion grundsätzlich unzureichend macht: Speditionswechsel und Formatvielfalt sind Marktmerkmale, keine Fehler. Ein Makler hat keine Kontrolle darüber, welche Spediteure seine Verlader nutzen. Ein Spediteur, der Fracht über verschiedene Strecken bucht, kann in einem einzigen Monat 8 verschiedene Seefracht- und 15 verschiedene LKW-Spediteure einsetzen. Jeder stellt Frachtbriefe in seinem eigenen Format aus.
Vorlagenbasierte OCR erfordert einen Einrichtungsschritt pro Speditionsformat: Zeichnen Sie ein Begrenzungsfeld um „Absendername", beschriften Sie es, wiederholen Sie den Vorgang für jedes benötigte Feld. Multiplizieren Sie das mit 50 Spediteuren. Multiplizieren Sie es erneut, sobald ein Spediteur seine Formularvorlage aktualisiert. Der Wartungsaufwand skaliert linear mit der Anzahl der Spediteure – was bedeutet, dass genau das Szenario, in dem die Extraktion den größten Mehrwert bieten sollte (hohe Speditionsvielfalt), das Szenario ist, in dem die Vorlagenwartung untragbar wird.
Deshalb ist ein vorlagenfreier, formatunabhängiger Ansatz speziell für die Frachtbrief-Extraktion so wichtig. Der KI muss nicht gesagt werden, dass Maersk den Absender oben links platziert und Old Dominion ihn in ein Feld mit der Bezeichnung „Absender/Exporteur" setzt. Sie liest das Dokument so, wie ein Logistikexperte es liest – sie scannt nach der Entität, die dem semantischen Muster eines Absenders entspricht, unabhängig davon, wo sie physisch auf der Seite erscheint. Das ist nicht nur eine schnellere Einrichtung. Es ist der Unterschied zwischen einer Extraktions-Pipeline, die ab Tag 1 für alle Ihre Spediteure funktioniert, und einer, die fortlaufende Vorlagenwartung für jeden neuen Spediteur erfordert, den Sie anbinden.
Auswahl zwischen Self-Service-Tools, API-Integration und Enterprise-Plattformen
Der Markt für die Extraktion von Frachtbriefdaten teilt sich in drei operative Profile auf. Die richtige Wahl hängt von Ihrem Volumen, Ihren technischen Ressourcen und davon ab, ob die Extraktion eine eigenständige Verbesserung oder Teil einer umfassenderen Automatisierungsstrategie ist.
Self-Serve-Upload-Tools
Für: Frachtmakler, kleine Spediteure, Ops-Teams mit 50–500 Konnossementen/Monat
Ansatz: Konnossemente hochladen → Spaltennamen eingeben → Excel herunterladen. Kein API-Setup, kein Entwickler erforderlich.
Kernanforderung: Extraktion ohne Vorlage über alle Carrier hinweg. Wenn Sie pro Carrier eine Vorlage erstellen müssen, scheitert dieser Ansatz in Ihrem Umfang.
API-Integration
Für: TMS-Plattformen, Maklersysteme, interne Tools mit 500–5.000 Konnossementen/Monat
Ansatz: Die REST-API empfängt Konnossementdateien und liefert strukturierte JSON/CSV-Daten mit Konfidenzwerten auf Feldebene.
Kernanforderung: Konfidenzbewertung, damit Ihr System Extraktionen mit niedriger Konfidenz automatisch zur manuellen Prüfung weiterleiten kann.
Enterprise-Plattformen
Für: Große 3PLs, globale Speditionen mit 5.000+ Konnossementen/Monat und Compliance-Automatisierungsbedarf
Ansatz: End-to-End-IDP mit E-Mail-Erfassung, Extraktion, Validierungsregeln, Ausnahmerouting und TMS/ERP-Übertragung.
Kernanforderung: Verwaltete Ausnahmebehandlung und Prüfprotokoll – nicht nur Extraktionsgenauigkeit.
Für die meisten Frachtmakler und mittelgroßen Speditionen trifft die Self-Serve-Stufe den optimalen Punkt: keine Integrationskosten, sofortiger Mehrwert ab Tag eins und eine Preisgestaltung pro Seite, die mit der tatsächlichen Nutzung skaliert statt mit einem festen Plattform-Abo. Das Tool verarbeitet eine einzelne Konnossementseite in 5–10 Sekunden – verglichen mit 10–15 Minuten manueller Dateneingabe – und exportiert direkt nach Excel. Bei dieser Geschwindigkeit gewinnt ein Team, das 100 Konnossemente pro Tag verarbeitet, rund 20 Arbeitsstunden täglich zurück. Wenn Sie Self-Serve-Tools gegen Enterprise-Plattformen über Ihren gesamten Dokumentenmix abwägen – nicht nur Konnossemente –, deckt unser Käuferleitfaden zur Logistikdokument-Extraktion die breiteren Bewertungskriterien ab.
Eine erwähnenswerte Nuance: Kein Extraktionstool erreicht 100 % Straight-Through-Processing bei Konnossementen. Handschriftliche Durchschläge mit Stempeln über verblasstem Text erzeugen niedrigere Konfidenzwerte. Die richtige Workflow-Erwartung ist 85–95 % automatisierte Extraktion mit einer Prüfwarteschlange für markierte Felder – nicht vollautomatischer Betrieb. Aber selbst bei 85 % Automatisierung ist die verbleibende 15 % in der Prüfwarteschlange immer noch schneller zu verifizieren als jedes Feld von Grund auf zu tippen.
Häufig gestellte Fragen
Kann KI handschriftliche Konnossemente erfassen?
Ja – mit Einschränkungen. Moderne Bilderkennungsmodelle lesen Druckschrift, Blockschrift und die meisten Schreibschriften auf Konnossementen, insbesondere standardisierte Felder wie BOL-Nummern, Stückzahlen und Gewichte, die meist in lesbarer Blockschrift ausgefüllt sind. Die Genauigkeit sinkt bei stark verblassten Durchschlägen mit überlagernden Stempeln oder bei Dokumenten, bei denen der Schreibdruck zu gering für einen klaren Scan war. In diesen Fällen markiert die Extraktionssoftware das Feld mit einer niedrigen Konfidenz zur manuellen Prüfung, anstatt zu raten.
Funktioniert die BOL-Extraktion auch mit mehrseitigen Dokumenten?
Ja. Viele See-Konnossemente umfassen mehrere Seiten – die erste Seite enthält Parteien- und Routing-Informationen, die zweite Seite listet die Frachtdetails und -bedingungen auf, und eine dritte Seite kann die allgemeinen Geschäftsbedingungen enthalten. Batch-Extraktionstools verarbeiten alle Seiten als ein einziges Dokument und fassen die extrahierten Felder in einer Zeile der Ausgabetabelle zusammen. Entscheidend ist, dass das Tool Fortsetzungsseiten erkennt und nicht jede Seite als separates Dokument behandelt.
Was passiert, wenn zwei Spediteure unterschiedliche Namen für dasselbe Feld verwenden?
Genau hier liegt der Vorteil der semantischen Extraktion gegenüber vorlagenbasierten Ansätzen. Wenn Spediteur A das Feld „Shipper", Spediteur B es „Shipper/Exporter" und Spediteur C es „Consignor" nennt, erkennt die KI, dass alle drei dieselbe Entität bezeichnen – die Partei, die die Ware versendet. Sie definieren Ihre Ausgabespalte einmal als „Absender", und die KI ordnet die Varianten jedes Spediteurs automatisch dieser Spalte zu. Keine speditörspezifische Feldzuordnung erforderlich.
Können extrahierte BOL-Daten direkt in mein TMS eingespeist werden?
Die meisten Self-Service-Extraktionstools exportieren nach Excel oder CSV, die dann über die Standard-Importfunktion Ihres TMS importiert werden können. Einige TMS-Plattformen (wie Turvo, Descartes und McLeod) unterstützen CSV-Importvorlagen – Sie exportieren die Extraktionsergebnisse, formatieren die Spalten entsprechend Ihrer TMS-Importvorlage und laden sie hoch. Für eine API-Integration, die extrahierte Daten ohne Dateiübergabe direkt in das TMS überträgt, benötigen Sie ein Tool mit einer REST-API und etwas Entwicklungsarbeit auf der Integrationsseite.
Ersetzt die BOL-Extraktion einen Zollagenten?
Nein. Die Datenextraktion automatisiert den Dateneingabeschritt – die Überführung der BOL-Felder in ein strukturiertes Format. Sie ersetzt nicht die regulatorische Beurteilung durch einen lizenzierten Zollagenten: HS-Code-Klassifizierung, Bewertungsentscheidungen, Bestimmung der Anspruchsberechtigung für Freihandelsabkommen und die Strategie zur Zollanmeldung. Betrachten Sie die Extraktion als Wegfall der Schreibarbeit, damit Ihr Agent seine Zeit für die Klassifizierungs- und Compliance-Entscheidungen nutzen kann, die tatsächlich Fachwissen erfordern.
Wie genau ist die KI-Extraktion bei Konnossementen im Vergleich zur manuellen Dateneingabe?
Gut trainierte Frachtdokument-KI erreicht bei standardmäßigen digitalen Konnossementen eine Feldgenauigkeit von 97–99 %. Manuelle Dateneingabe durch erfahrene Mitarbeiter liegt unter normalen Bedingungen bei 96–99 % – und in Spitzenzeiten niedriger, wenn der Mengendruck die Fehlerquote erhöht. Der entscheidende Unterschied: KI-Fehler konzentrieren sich auf markierte Low-Confidence-Ausnahmen, die zur menschlichen Prüfung weitergeleitet werden. Manuelle Fehler sind zufällig und schwerer zu erkennen, bevor sie in nachgelagerte Systeme gelangen. Bei 500 Konnossementen pro Tag bedeutet selbst eine manuelle Fehlerquote von 1 % fünf Sendungen pro Tag mit mindestens einem falschen Feld – und diese Fehler bleiben unentdeckt, bis etwas schiefgeht.
Das Konnossement hat sich seit einem Jahrhundert kaum verändert – ein Stück Papier, das mit der Fracht reist und die Details enthält, die bestimmen, wer wann was zahlt und wann die Ware den Besitzer wechselt. Was sich geändert hat, sind die Kosten, diese Details in die Systeme zu bringen, die Fracht leiten, den Zoll abwickeln und Rechnungen begleichen. Manuelle Eingabe war nie eine gute Lösung; sie war nur die einzige Lösung. Template-OCR verbesserte sie und stieß dann an eine Grenze, wo die Vielfalt der Carrier die Wartungskapazität der Vorlagen übersteigt. Der nächste Schritt – semantische Extraktion, die ein Konnossement so liest, wie es ein Logistikprofi tut – verändert die wirtschaftliche Gleichung. Testen Sie es mit Ihren eigenen Konnossementen. Sehen Sie, ob sich der Dateneingabe-Engpass zu einer Prüfwarteschlange verkleinert.