Cómo extraer datos de conocimiento de embarque
a Excel
Un agente de carga de tamaño mediano absorbe $140,000 a $280,000 por año en costos directamente relacionados con errores documentales: retenciones aduaneras a $200–500 por día, tarifas de enmienda del transportista a $50–150 por corrección de B/L, y sanciones arancelarias por clasificaciones incorrectas de código SA.[1] Pero el costo real del ingreso manual de datos de conocimiento de embarque no es la mano de obra: es el daño operativo en cascada cuando un solo número de BOL mal escrito llega a la aduana, provoca una retención, acumula sobrestadía y obliga a un crédito a un cliente que solo quería que su carga llegara a tiempo. La línea de defensa no es un mecanógrafo más rápido. Es una extracción que no comete errores de tipeo.
El costo de cumplimiento que nadie presupuesta
Cuando los equipos de operaciones de carga hablan del dolor de procesar conocimientos de embarque, suelen empezar por el volumen: «manejamos 500 conocimientos de embarque a la semana». El cálculo de tiempo es sencillo: de 10 a 15 minutos por documento para la entrada manual de datos, y hasta una hora para conocimientos de embarque multimodales complejos con numerosas partidas de mercancías.[2] Pero el tiempo es la parte superficial del problema.
Un estudio de IARJSET de 2025 sobre empresas de transporte de carga encontró que el 46.7% de las compañías enfrentan sanciones causadas directamente por errores de documentación, y el 63.4% tuvo que corregir documentación en 1 a 10 envíos solo en los últimos seis meses.[3]
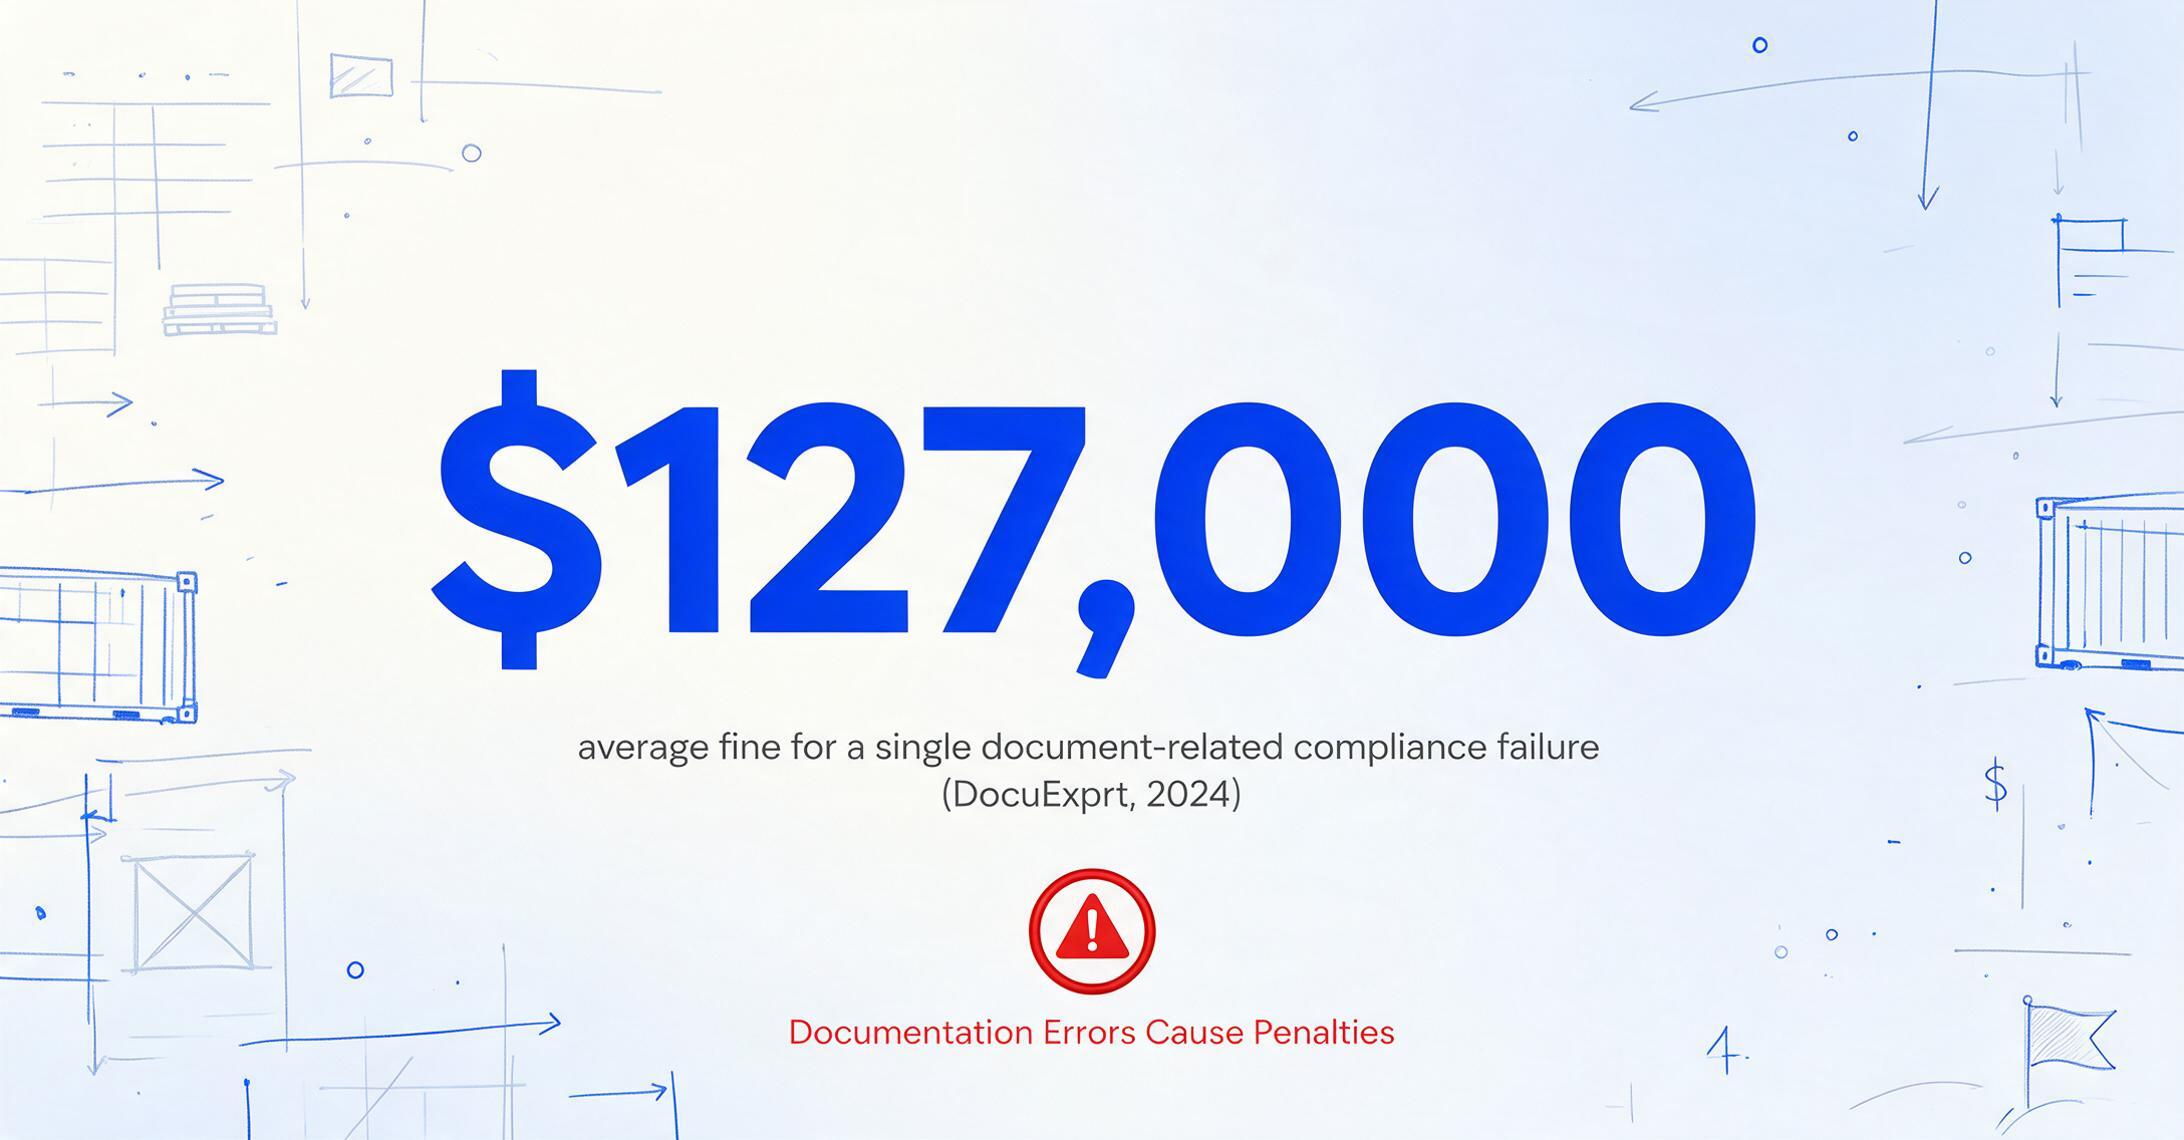
La vía de las sanciones está bien documentada. Los ajustes de sanciones monetarias civiles de 2025 del Registro Federal de EE. UU. fijan las multas por violaciones de presentación ISF en $6,000 o más, con sanciones por incumplimiento de manifiesto entre $1,740 y $4,730 por ocurrencia.[4] Una encuesta de DocuExprt de 2024 encontró que la multa promedio por un solo incumplimiento de cumplimiento relacionado con documentos es de $127,000, y la preparación para auditorías consume de 120 a 200 horas de tiempo del personal al año.[5]
Esta es la partida presupuestaria que crea la entrada manual de datos de conocimientos de embarque, y la que la extracción automatizada elimina. Un error tipográfico en un número de contenedor o un código SA mal escrito no es un error administrativo menor; es un punto de entrada a una cadena de retenciones aduaneras, cargos por almacenamiento, demoras por reclasificación y créditos al cliente. Cuando un profesional de logística en Reddit observa que los despachadores pasan el día «copiar correo → TMS, copiar de nuevo → bolsa de carga, repetir 20 veces al día», la pérdida de productividad es visible. El riesgo de cumplimiento detrás de cada una de esas operaciones de copiar y pegar no lo es.
Por qué el OCR estándar falla con los conocimientos de embarque
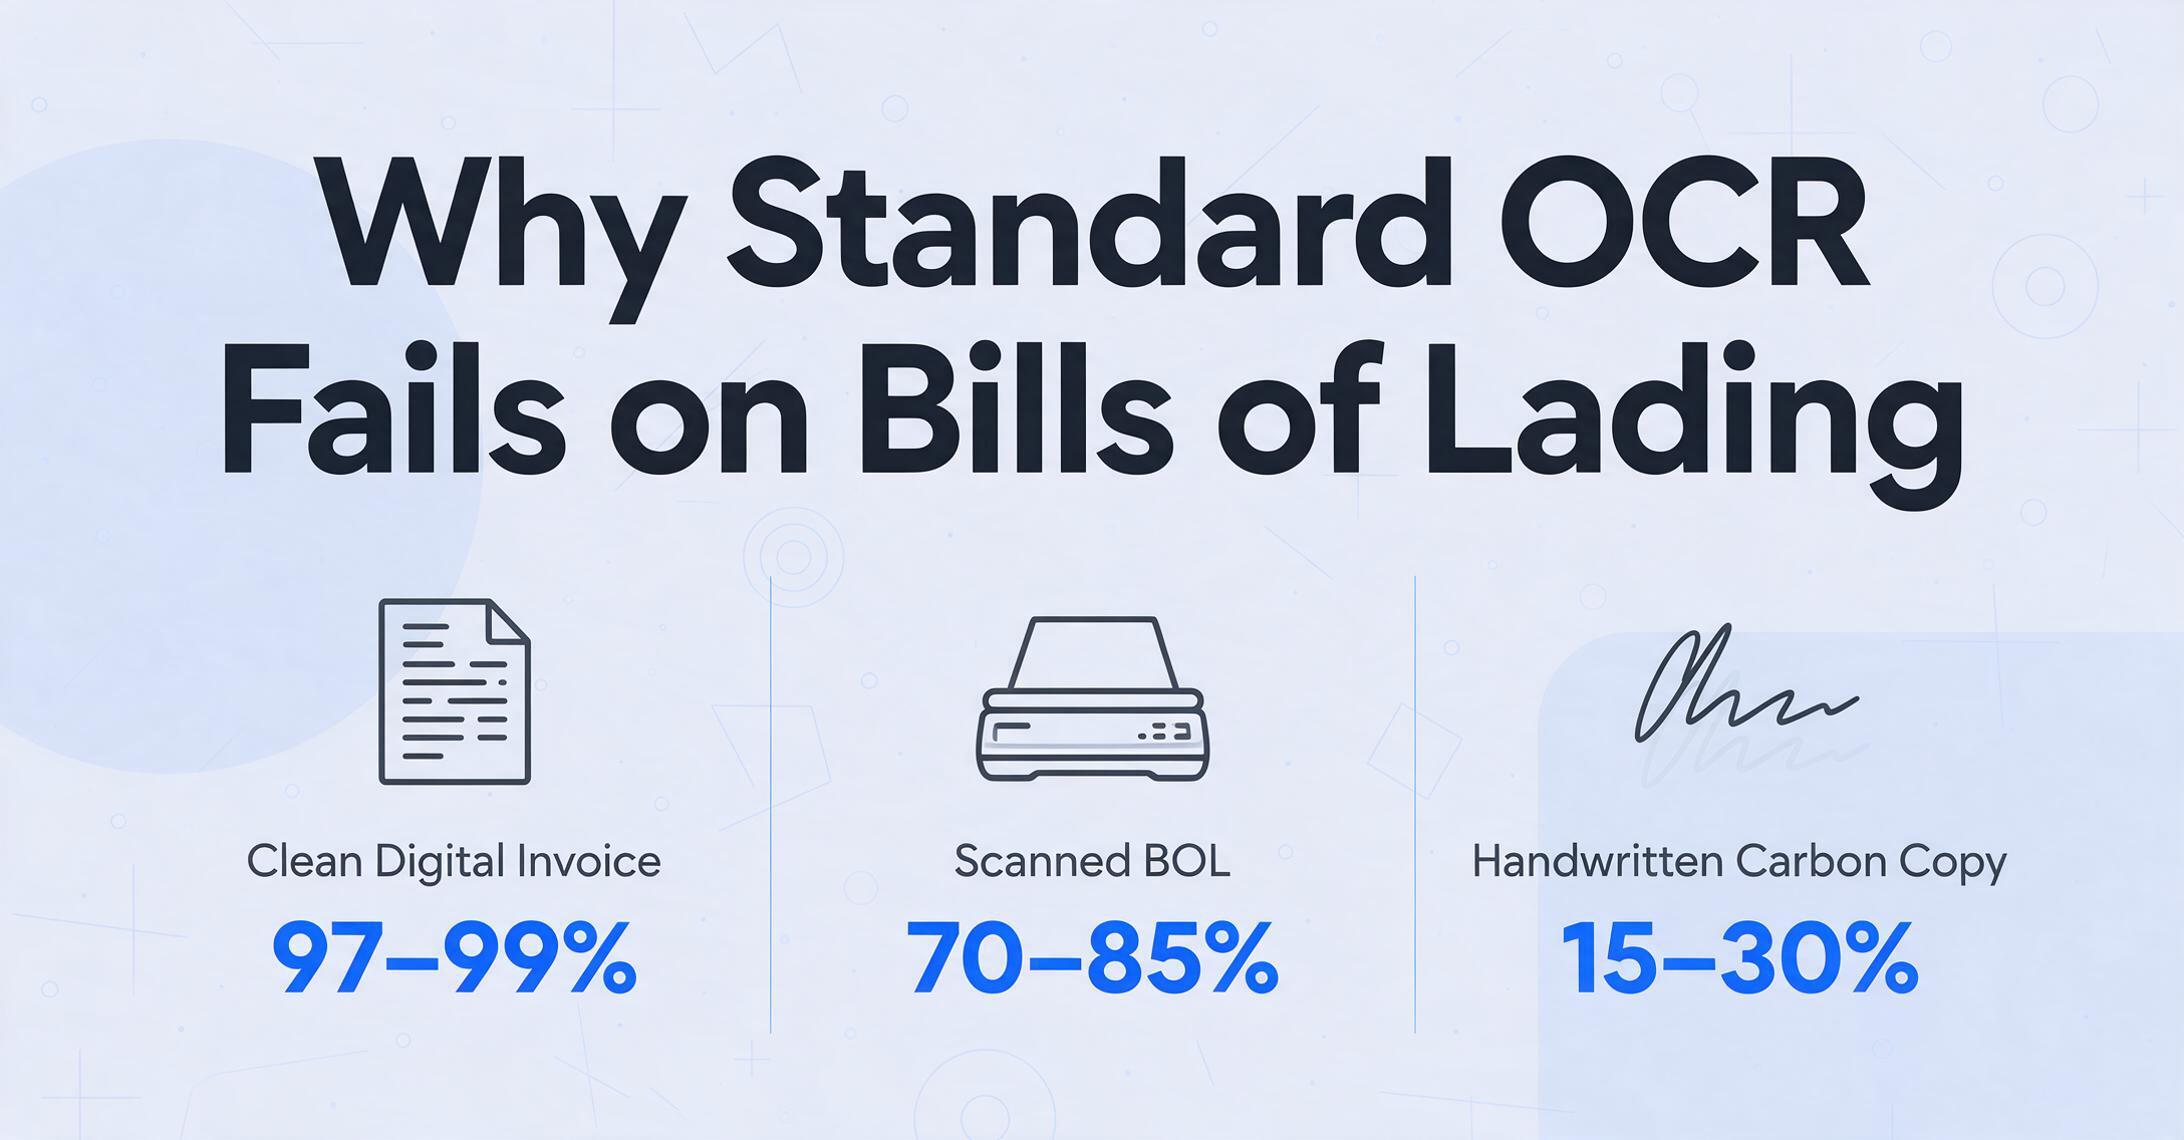
El argumento estándar para automatizar la extracción de datos de BOL es el siguiente: ejecutar OCR en el PDF escaneado, obtener el texto y asignarlo a las columnas de la hoja de cálculo. Esto funciona con una factura digital limpia de un solo proveedor cuyo formato se conoce. Falla con los conocimientos de embarque por tres razones que se agravan entre sí.
Cada transportista utiliza su propio diseño. Un BOL marítimo de Maersk coloca el bloque del remitente en la esquina superior izquierda, los detalles del buque en una tabla central y la descripción de la carga en una cuadrícula de varias filas debajo. Un BOL directo de Old Dominion utiliza el formato abreviado estandarizado por NMFTA con descripciones de mercancías en una cuadrícula de espacio reducido. Un BOL de FedEx Freight utiliza otra disposición más. El OCR basado en plantillas — donde se dibujan zonas alrededor de cada campo y se entrena el sistema por diseño — requiere una plantilla por transportista. Un agente que maneja 50 transportistas necesita 50 plantillas, y cada vez que un transportista actualiza su formulario, esa plantilla falla silenciosamente.
La escritura a mano, los sellos y las copias carbón son estándar, no casos excepcionales. Los BOL se llenan con frecuencia a mano en el muelle de carga en papel carbón. El nombre del destinatario está garabateado con bolígrafo, el recuento de piezas está sellado en tinta roja y la tercera copia carbón está desvanecida hasta casi ilegibilidad. El OCR tradicional trata esto como ruido. Una herramienta que solo puede leer tipografías digitales nítidas no detectará el número de BOL manuscrito, el marcador sellado "Freight Prepaid" ni el campo de peso en copia carbón — los tres datos con más probabilidades de provocar una disputa en la factura del transportista.
La clase de flete NMFC requiere comprensión semántica, no reconocimiento de caracteres. El sistema National Motor Freight Classification define 13 clases de flete (50 a 500) según densidad, estibabilidad, manejo y responsabilidad. Un BOL puede indicar "Class 70" junto a la descripción de la mercancía, o puede indicar la mercancía sin la clase, esperando que el transportista la aplique. El OCR estándar lee "Class 70" como caracteres de texto. Pero la extracción semántica — el tipo que realiza un modelo de visión de IA — entiende que "Class 70" modifica a "Wooden Furniture" y pertenece a la columna de clase de flete, no a la de descripción de la mercancía. Esa distinción es la diferencia entre una factura de flete precisa y un cargo de reclasificación de $300 tres semanas después.
Qué Datos Contiene un Conocimiento de Embarque — y por Qué Cada Campo Importa
Un conocimiento de embarque cumple tres funciones legales simultáneamente: recibo de mercancías (el transportista reconoce haber recibido la carga según lo descrito), contrato de transporte (términos y condiciones del transporte) y documento de título (propiedad de las mercancías, en BOL negociables). Cada campo del documento respalda una o más de estas funciones — y un error en cualquier campo se propaga a uno de estos dominios legales.[6] Un BOL rara vez viaja solo — vea cómo se concilia con el resto del paquete de envío en nuestra guía sobre extracción de documentos de envío y flete.
| Grupo de Campos | Campos | Consecuencia del Error |
|---|---|---|
| Partes | Nombre y dirección del embarcador, Consignatario, Parte notificada, Código del transportista/SCAC | Entrega mal dirigida, fallo en el despacho de aduanas, facturación a la parte equivocada |
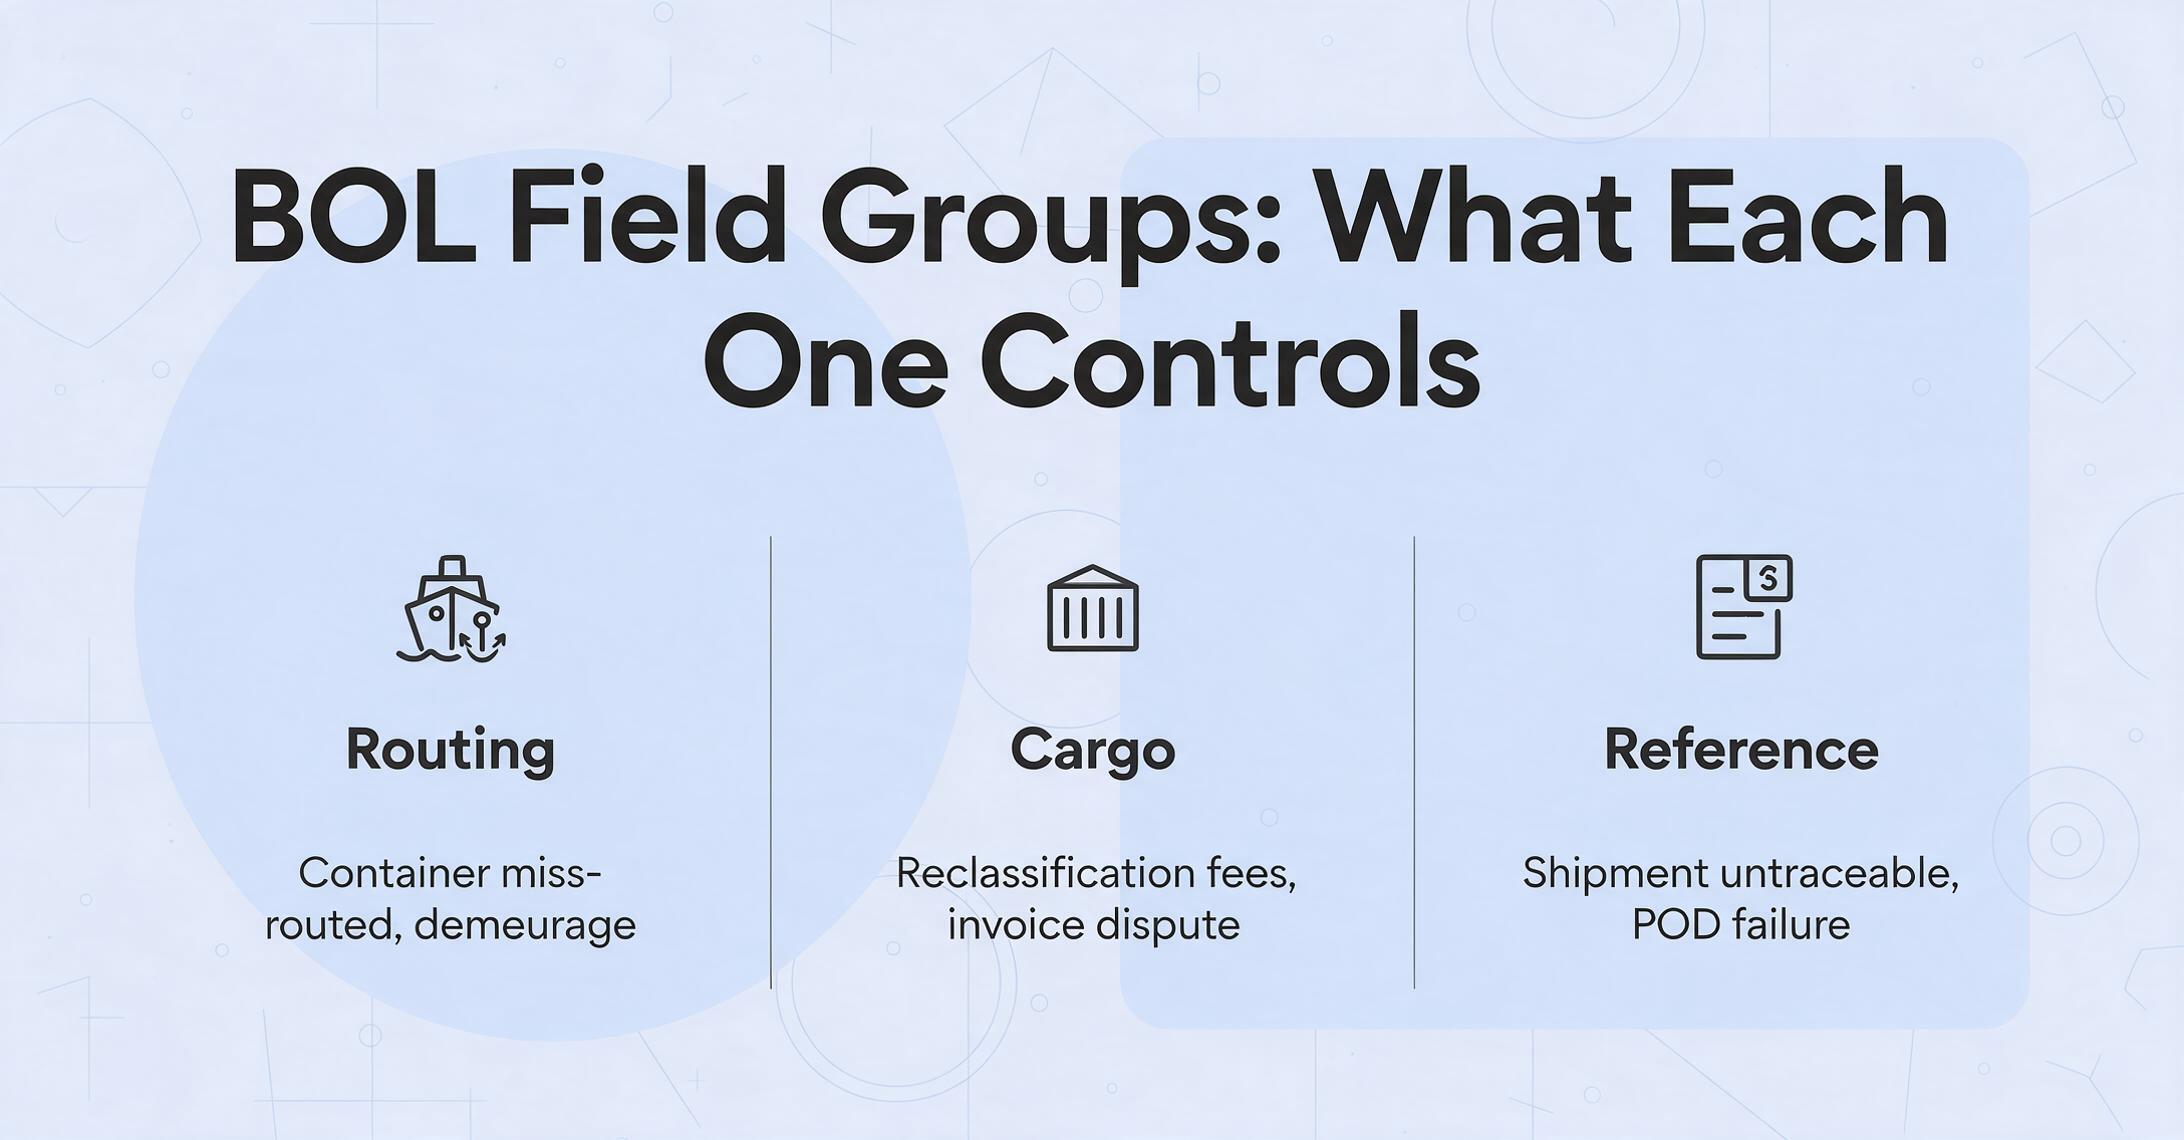
| Enrutamiento | Puerto de carga, Puerto de descarga, Buque/Viaje, Números de contenedor y precinto | Contenedor mal enrutado, sobrestadía en terminal equivocada, discrepancia en la declaración ISF |
| Carga | Descripción de la mercancía, Número de piezas, Tipo de embalaje, Peso (bruto/neto), Dimensiones, Clase de flete, Código NMFC, Código HS | Tarifas de reclasificación, recálculo de aranceles, disputa de factura del transportista, incumplimiento de materiales peligrosos |
| Cargos y Términos | Términos de flete (prepagado/cobrar), Cargos de flete, Cargos accesorios | Parte facturada incorrecta, pago duplicado, accesorios no recuperados |
| Referencia | Número de BOL, número PRO, referencias de orden de compra, Fechas de recogida/entrega | Envío no rastreable, ventanas de entrega incumplidas, fallo en la verificación del POD |
Observe que el grupo de Carga — descripciones de mercancía, pesos, número de piezas, clase de flete — es la sección con más datos y la más propensa a errores. También es la sección que más varía entre transportistas. Un transportista usa cinco líneas de mercancía con pesos individuales; otro usa una sola línea consolidada con un peso total. Un tercero estampa "NMFC 156600 Sub 3" en el margen. La herramienta de extracción no necesita conocer el diseño. Necesita saber qué significa cada una de estas cosas.
De PDF a hoja de cálculo: cómo funciona realmente la extracción con IA
El flujo de trabajo que reemplaza la captura manual de datos de conocimientos de embarque es engañosamente simple. Usted define las columnas de salida que desea, no dónde se encuentran los datos en el documento. Esta inversión es el núcleo del enfoque: en lugar de decirle a la herramienta "el número de conocimiento de embarque está en la esquina superior derecha del formulario de este transportista", usted le dice "extraiga el número de conocimiento de embarque" y deja que la IA lo localice al comprender cómo se ve un número de conocimiento de embarque en contexto.
Para una operación logística que procesa conocimientos de embarque de múltiples transportistas, la configuración de columnas podría verse así: BOL Number, Shipper Name, Consignee Name, Carrier SCAC, Container Number, Port of Loading, Port of Discharge, Commodity Description, Piece Count, Weight (lbs), Freight Class, Freight Terms, Freight Charges. Estos nombres de columna se convierten en los encabezados de Excel. La IA lee cada conocimiento de embarque cargado, encuentra los valores y completa las filas, sin importar si el conocimiento de embarque proviene de Maersk, Old Dominion o de una copia carbón escrita a mano de un transportista local.
Esto es Extracción de Columnas Personalizadas: usted escribe los nombres de los campos que desea y la IA localiza cada valor al comprender qué significa, no dónde se encuentra en la página. A diferencia del OCR basado en plantillas que dibuja zonas alrededor de posiciones fijas, este enfoque se adapta al diseño de cualquier transportista sin configuración. Un agente de carga con 50 transportistas carga los 50 en el mismo lote y obtiene una sola hoja de cálculo unificada.
Los archivos se procesan de forma segura y no se almacenan. Pruebe con un conocimiento de embarque de muestra.
Después de la extracción, los datos llegan a una hoja de cálculo de Excel estructurada: cada fila es un conocimiento de embarque y cada columna es un campo extraído. Esta salida es nativa de hojas de cálculo: va directamente a Excel, Google Sheets o CSV, lista para cargar en su TMS o ejecutar una auditoría de flete. No hay paso intermedio de conversión de JSON a CSV ni un asistente de mapeo de campos entre el motor de extracción y su hoja de cálculo. Para equipos que usan Google Sheets, incluso hay un complemento de barra lateral que ejecuta la extracción directamente dentro de una hoja de cálculo sin salir de la pestaña.
La trampa de las plantillas: por qué las configuraciones por transportista no escalan
La industria logística tiene un problema estructural que hace que la extracción basada en plantillas sea fundamentalmente inadecuada: la rotación de transportistas y la variabilidad de formatos son características del mercado, no fallos. Un broker no controla qué transportistas usan sus cargadores. Un transitario que reserva carga en diferentes rutas puede usar 8 navieras distintas y 15 empresas de camiones en un solo mes. Cada una emite sus conocimientos de embarque en su propio formato.
El OCR basado en plantillas requiere un paso de configuración por formato de transportista: dibujar un cuadro delimitador alrededor de "Nombre del cargador", etiquetarlo, repetir para cada campo necesario. Multiplícalo por 50 transportistas. Multiplícalo de nuevo cada vez que un transportista actualiza su plantilla. El costo de mantenimiento escala linealmente con el número de transportistas, lo que significa que el escenario exacto donde la extracción debería aportar más valor (alta diversidad de transportistas) es el escenario donde el mantenimiento de plantillas se vuelve insostenible.
Por eso un enfoque sin plantillas e independiente del formato es clave para la extracción de conocimientos de embarque. La IA no necesita que le digan que Maersk pone al cargador en la esquina superior izquierda y Old Dominion lo pone en un recuadro etiquetado como "Cargador/Exportador". Lee el documento como lo haría un profesional de logística: escanea en busca de la entidad que coincide con el patrón semántico de un cargador, sin importar dónde aparezca físicamente en la página. No es solo una configuración más rápida. Es la diferencia entre un pipeline de extracción que funciona desde el día 1 para todos tus transportistas y uno que requiere mantenimiento continuo de plantillas para cada nuevo transportista que incorpores.
Elegir entre herramientas autogestionadas, integración API y plataformas empresariales
El mercado de extracción de datos de conocimientos de embarque se divide en tres perfiles operativos. La elección correcta depende de tu volumen, tus recursos técnicos y si la extracción es una mejora independiente o parte de una estrategia de automatización más amplia.
Herramientas de carga autogestionadas
Para: Corredores de carga, pequeños transitarios, equipos de operaciones que procesan 50–500 conocimientos de embarque al mes
Enfoque: Subir conocimientos de embarque → escribir nombres de columnas → descargar Excel. Sin configuración de API, sin necesidad de desarrollador.
Requisito clave: Extracción sin plantilla en todas las navieras. Si necesita crear una plantilla por transportista, este enfoque falla a su escala.
Integración de API
Para: Plataformas TMS, sistemas de corretaje y herramientas internas que procesan 500–5,000 conocimientos de embarque al mes
Enfoque: La API REST recibe archivos de conocimientos de embarque y devuelve JSON/CSV estructurado con puntuaciones de confianza a nivel de campo.
Requisito clave: Puntuación de confianza para que su sistema pueda enrutar automáticamente las extracciones de baja confianza a revisión humana.
Plataformas empresariales
Para: Grandes 3PL y transitarios globales que procesan más de 5.000 conocimientos de embarque al mes con necesidades de automatización de cumplimiento
Enfoque: IDP de extremo a extremo con ingesta por correo electrónico, extracción, reglas de validación, enrutamiento de excepciones y envío a TMS/ERP.
Requisito clave: Gestión de excepciones supervisada y registro de auditoría, no solo precisión de extracción.
Para la mayoría de los corredores de carga y transitarios de tamaño mediano, el nivel autogestionado es el punto óptimo: sin costos de integración, valor inmediato desde el primer día y precios por página que escalan con el uso real en lugar de una suscripción fija a la plataforma. La herramienta procesa una página de conocimiento de embarque en 5–10 segundos — frente a los 10–15 minutos de ingreso manual de datos — y exporta directamente a Excel. A esa velocidad, un equipo que procesa 100 conocimientos de embarque al día recupera aproximadamente 20 horas de trabajo del personal diariamente. Si está comparando herramientas autogestionadas con plataformas empresariales en toda su combinación de documentos — no solo conocimientos de embarque — nuestra guía del comprador de extracción de documentos logísticos cubre los criterios de evaluación más amplios.
Un matiz que vale la pena señalar: ninguna herramienta de extracción logra un 100% de procesamiento directo en conocimientos de embarque. Las copias carbón escritas a mano con sellos sobre texto desvanecido producirán puntuaciones de confianza más bajas. La expectativa correcta del flujo de trabajo es una extracción automatizada del 85–95% con una cola de revisión para los campos marcados — no un procesamiento sin supervisión. Pero incluso con un 85% de automatización, el 15% restante que llega a la cola de revisión sigue siendo más rápido de verificar que escribir cada campo desde cero.
Preguntas Frecuentes
¿La extracción con IA puede procesar conocimientos de embarque manuscritos?
Sí, con límites. Los modelos de visión modernos leen letra de imprenta, mayúsculas y la mayoría de cursivas en BOLs, especialmente campos estandarizados como números de BOL, cantidad de bultos y pesos, que suelen escribirse en mayúscula legible. La precisión baja en copias al carbón muy desvaídas con sellos superpuestos a la escritura, o en documentos donde la presión del bolígrafo fue muy ligera para un escaneo claro. En esos casos, el motor de extracción marca el campo con baja confianza para revisión humana, sin adivinar.
¿La extracción de BOL funciona con documentos de varias páginas?
Sí. Muchos BOLs marítimos tienen varias páginas: la primera lleva información de partes y ruta, la segunda detalla la carga y términos, y una tercera puede contener los términos y condiciones estándar. Las herramientas de extracción por lotes procesan todas las páginas como un solo documento y fusionan los campos extraídos en una fila de la hoja de cálculo. La clave es que la herramienta reconoce páginas de continuación en lugar de tratar cada página como un documento separado.
¿Qué pasa si dos transportistas usan nombres distintos para el mismo campo?
Ahí es donde la extracción semántica supera a los enfoques basados en plantillas. Cuando el Transportista A etiqueta el campo "Shipper", el B lo llama "Shipper/Exporter" y el C lo escribe como "Consignor", la IA entiende que los tres se refieren a la misma entidad: la parte que envía la mercancía. Usted define su columna de salida una vez como "Nombre del Remitente" y la IA asigna automáticamente la variante de cada transportista a esa columna. Sin necesidad de mapeo por transportista.
¿Los datos extraídos de BOL pueden alimentar directamente mi TMS?
La mayoría de las herramientas de extracción autogestionadas exportan a Excel o CSV, que luego se importan a su TMS mediante la función de importación estándar. Algunas plataformas TMS (como Turvo, Descartes y McLeod) admiten plantillas de importación CSV: usted exporta los resultados, formatea las columnas para que coincidan con la plantilla de su TMS y las sube. Para una integración a nivel de API que envíe los datos extraídos directamente al TMS sin transferencia de archivos, necesitaría una herramienta con API REST y algo de trabajo de desarrollo en la integración.
¿La extracción de BOL reemplaza a un agente de aduanas?
No. La extracción de datos automatiza el paso de ingreso de datos: convertir los campos del BOL a un formato estructurado. No reemplaza el juicio regulatorio que brinda un agente de aduanas con licencia: decisiones de clasificación arancelaria, evaluaciones de valor, determinaciones de elegibilidad para acuerdos de libre comercio y estrategia de presentación de declaraciones aduaneras. Piense en la extracción como una forma de eliminar el trabajo de tipeo para que su agente dedique su tiempo a las decisiones de clasificación y cumplimiento que realmente requieren experiencia.
¿Qué tan precisa es la extracción con IA en conocimientos de embarque en comparación con la captura manual de datos?
La IA para documentos de flete bien entrenada alcanza una precisión a nivel de campo del 97–99% en conocimientos de embarque digitales estándar. La captura manual de datos realizada por personal experimentado alcanza el 96–99% en condiciones normales — y menos durante los períodos pico, cuando la presión por volumen aumenta las tasas de error. La diferencia crítica: los errores de la IA se concentran en excepciones de baja confianza marcadas que se envían a revisión humana. Los errores manuales son aleatorios y más difíciles de detectar antes de que lleguen a los sistemas posteriores. Con 500 conocimientos de embarque al día, incluso una tasa de error manual del 1% significa 5 envíos al día con al menos un campo incorrecto—y esos errores pasan desapercibidos hasta que algo falla.
El conocimiento de embarque no ha cambiado mucho en un siglo—un documento que viaja con la carga y contiene los detalles que determinan quién paga qué y cuándo cambian de manos las mercancías. Lo que sí ha cambiado es el costo de ingresar esos detalles en los sistemas que enrutan el flete, gestionan la aduana y liquidan las facturas. La captura manual nunca fue una buena solución; solo era la única. El OCR con plantillas la mejoró y luego llegó a un límite en el punto donde la diversidad de transportistas supera la capacidad de mantenimiento de plantillas. El siguiente paso—la extracción semántica que lee un conocimiento de embarque como lo haría un profesional de logística—cambia la ecuación económica. Pruébela con sus propios conocimientos de embarque. Vea si el cuello de botella de la captura de datos se reduce a una cola de revisión.