船荷証券データを
Excelに抽出する方法
中規模のフォワーダーは、書類エラーに直接起因するコストとして年間14万〜28万ドルを負担しています。税関保留は1日あたり200〜500ドル、キャリア修正手数料はB/L訂正1件あたり50〜150ドル、HSコード誤分類による関税ペナルティも発生します。[1] しかし、手動での船荷証券データ入力の本当のコストは人件費ではありません。BOL番号を1つ誤入力しただけで税関に引っかかり、保留が発生し、デマレージが積み上がり、納期通りに貨物を届けてほしかった顧客へのクレジット対応を余儀なくされる——そうした連鎖的な業務上の損害こそが本質です。防御線は、より速いタイピストではありません。タイプミスをしない抽出こそが防御なのです。
誰も予算化していないコンプライアンスコスト
貨物輸送オペレーションチームが船荷証券(BOL)処理の課題について話すとき、通常は量から始まります。「週に500件の船荷証券を処理しています」と。時間の計算は単純です。手動データ入力で文書1件あたり10〜15分、複雑な複合一貫輸送の船荷証券(BOL)で広範な品目明細がある場合は最大1時間かかります。[2] しかし、時間は問題の入り口に過ぎません。
2025年のIARJSETによるフォワーディング企業の調査では、企業の46.7%が文書エラーに直接起因する罰金に直面しており、63.4%が過去6か月間だけで1〜10件の出荷について文書修正を余儀なくされたことが判明しました。[3]
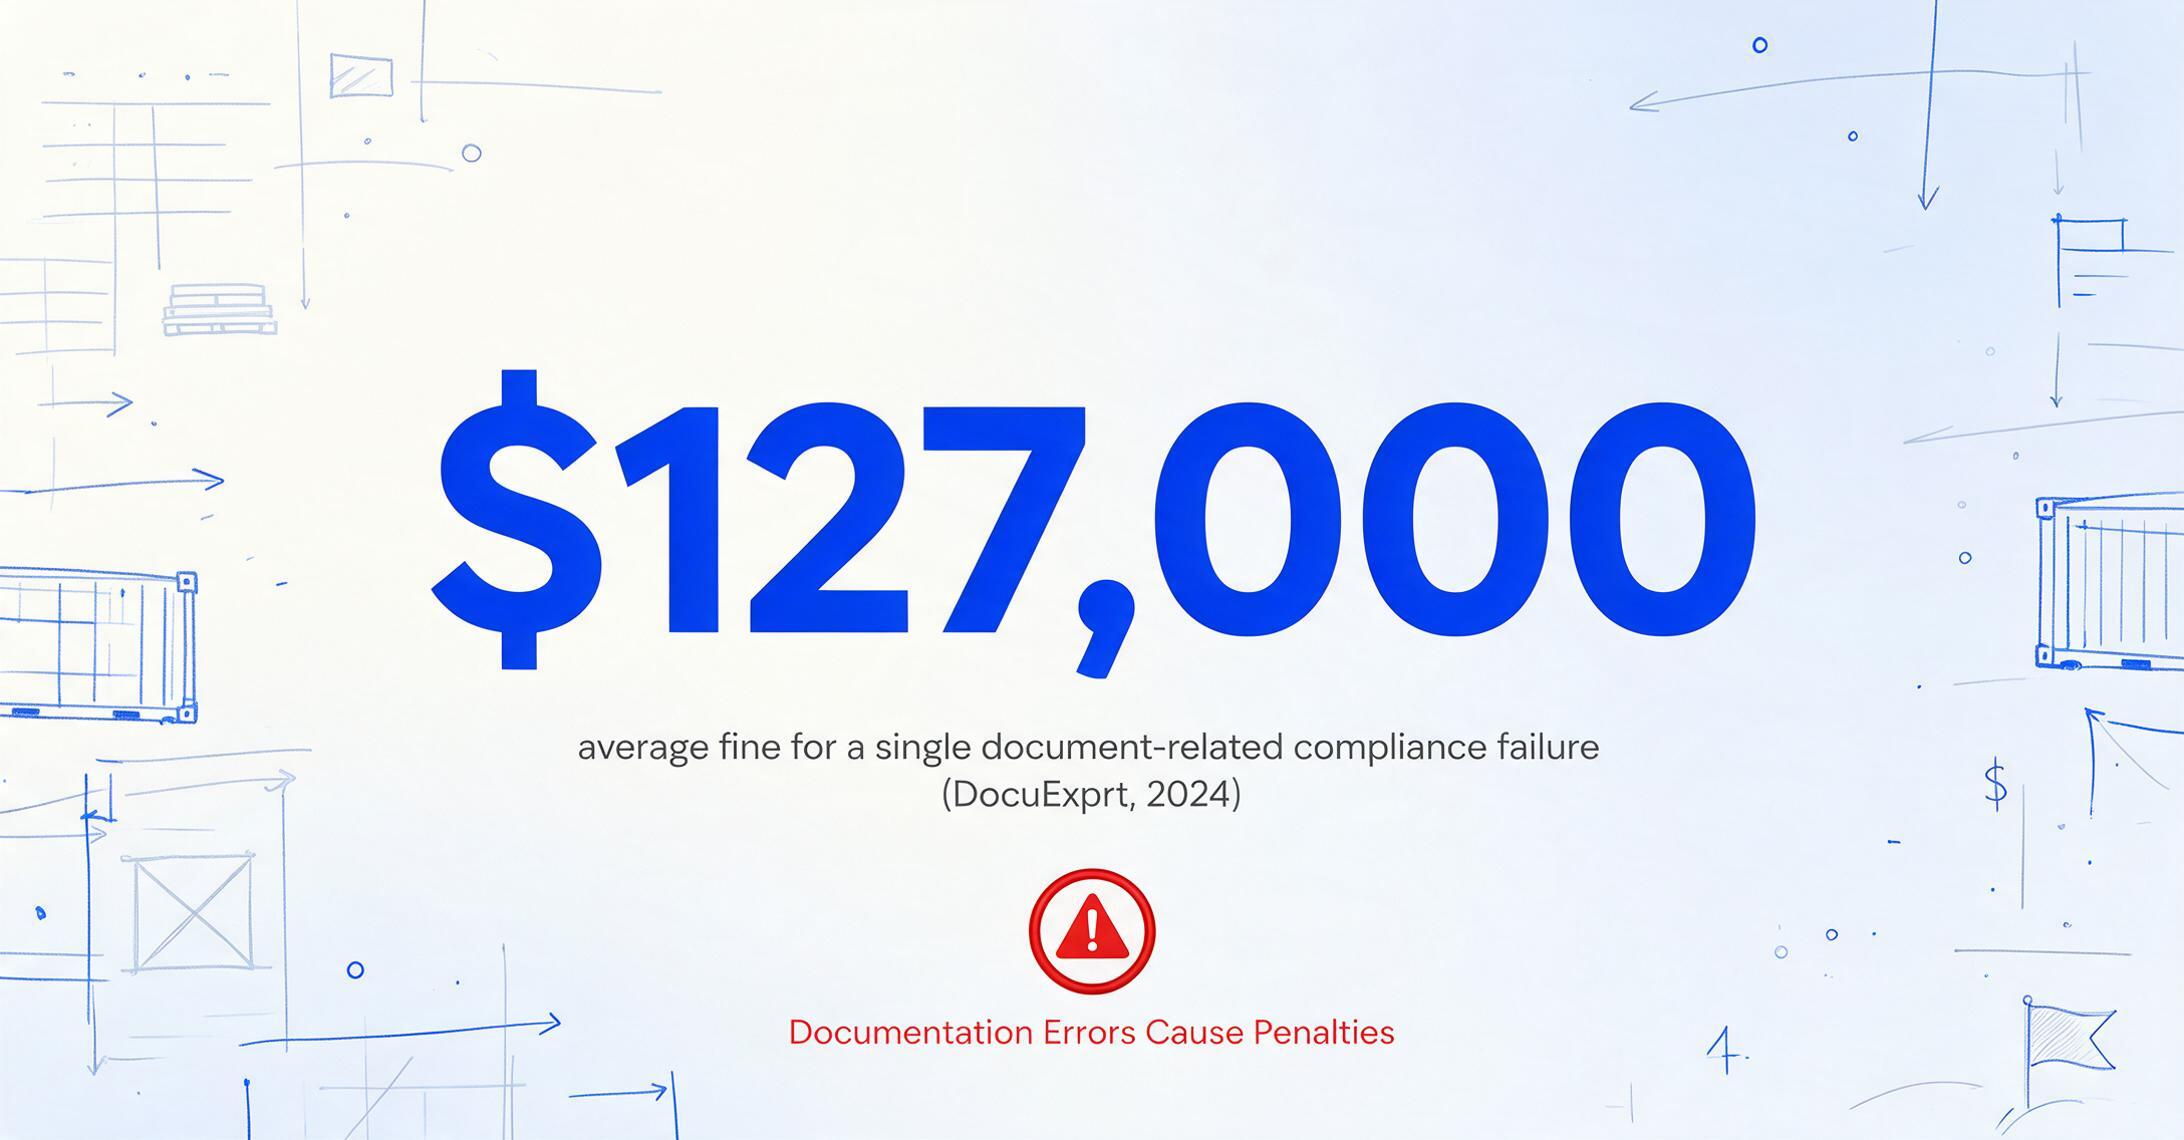
罰金に至る経路はよく知られています。米国連邦官報の2025年民事罰金物価調整では、ISF申告違反の罰金は$6,000以上に達し、マニフェスト不遵守の罰金は1件あたり$1,740〜$4,730とされています。[4] DocuExprtの2024年調査では、文書関連のコンプライアンス違反1件あたりの平均罰金は$127,000であり、監査準備だけで年間120〜200時間のスタッフ時間を消費することが判明しています。[5]
これが手動の船荷証券(BOL)データ入力が生み出す予算項目であり、自動抽出が排除するものです。コンテナ番号のタイプミスやHSコードの入力ミスは、単なる軽微な事務的エラーではありません。税関による保留、保管料、再分類の遅延、クライアントへのクレジットという連鎖への入り口なのです。Redditの物流専門家が指摘しているように、ディスパッチャーは「メールをコピー → TMS、またコピー → フレートエクスチェンジ、これを1日20回繰り返す」という一日を過ごしています。生産性の損失は目に見えます。しかし、そのコピー&ペースト操作の背後にあるコンプライアンスリスクは見えません。
船荷証券で標準OCRが失敗する理由
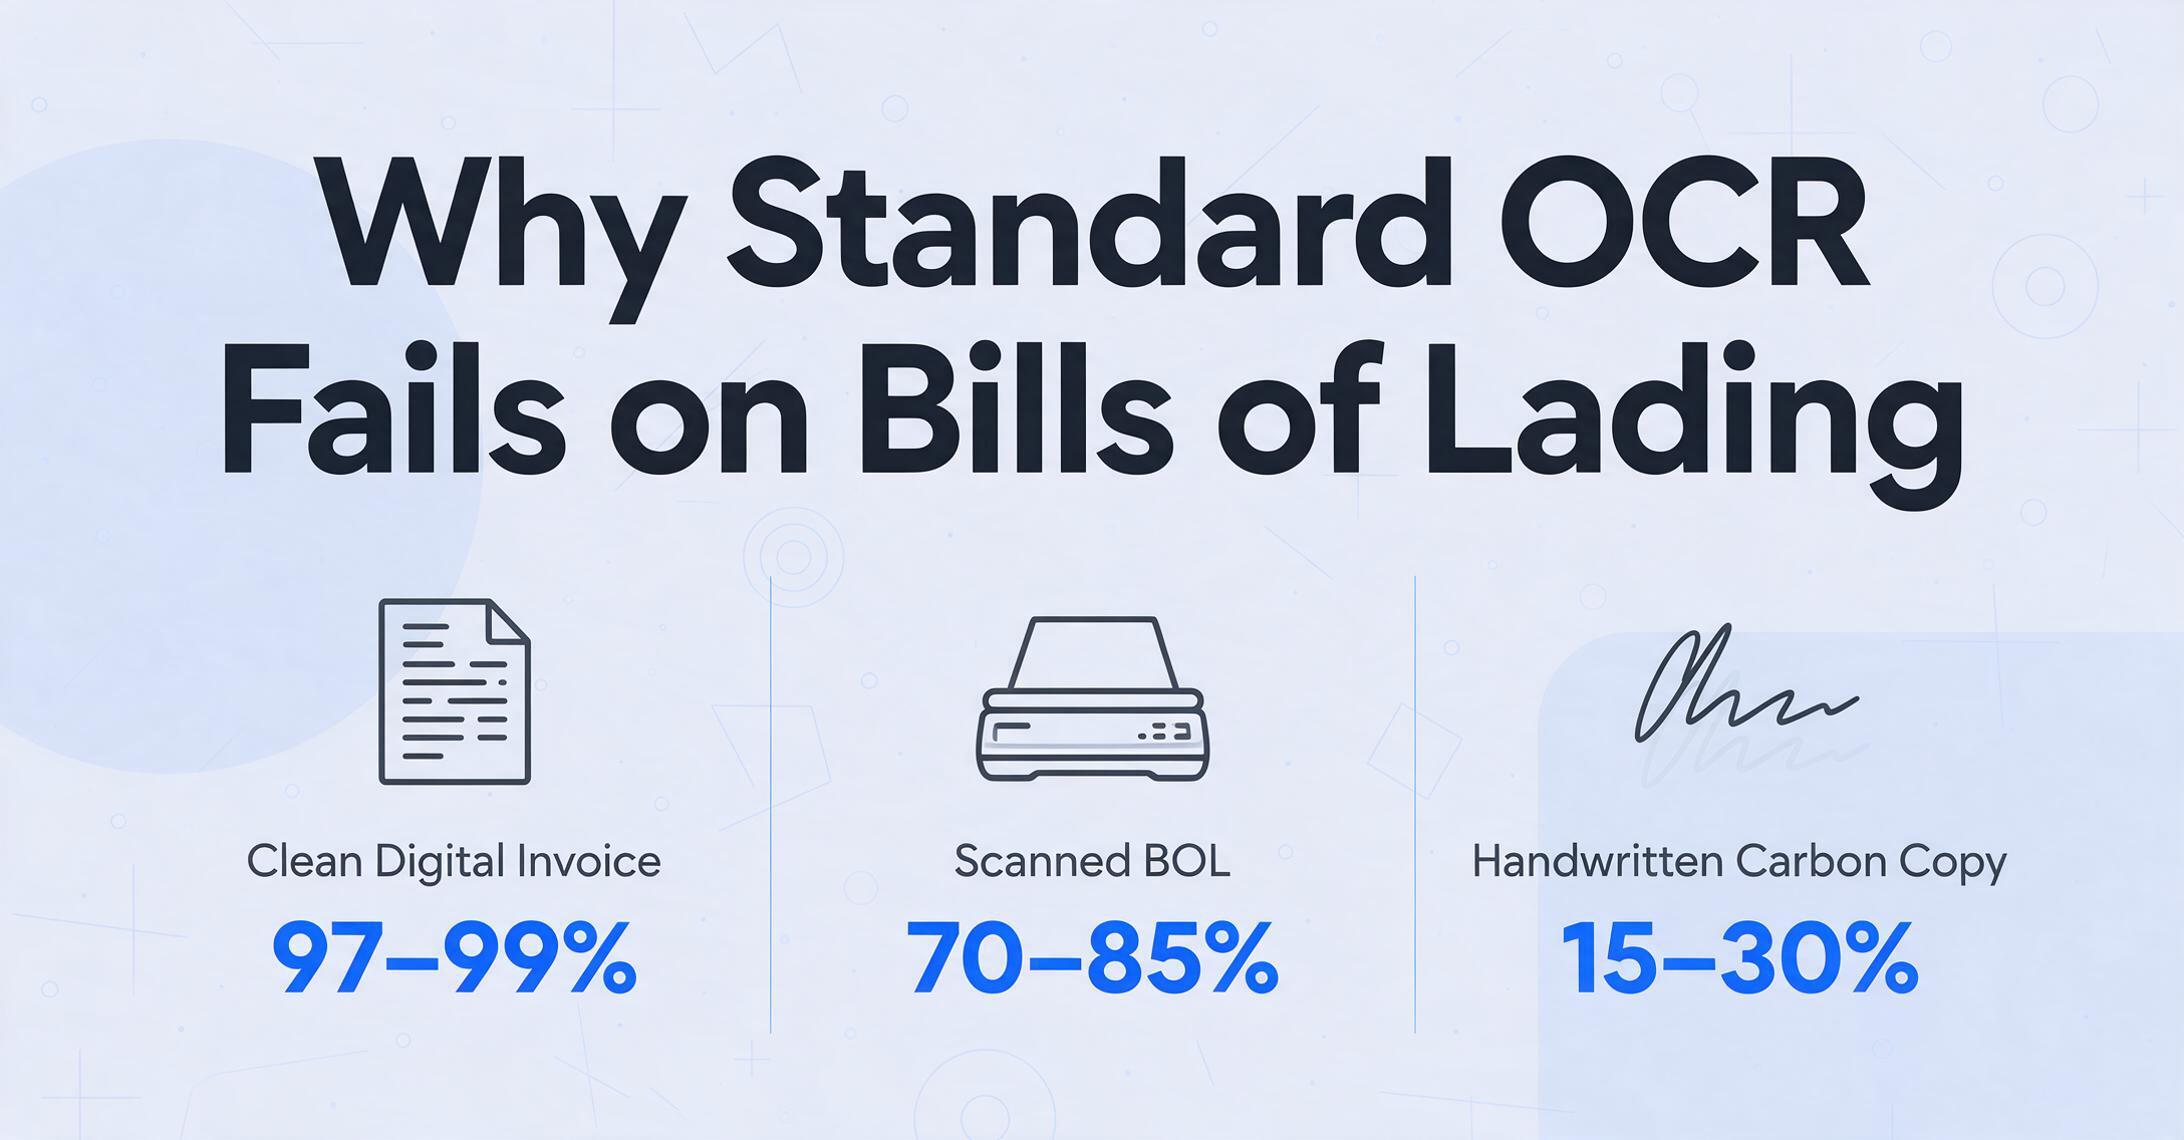
BOLデータ抽出を自動化する標準的な方法は次のようなものです。スキャンしたPDFにOCRを実行し、テキストを取得して、スプレッドシートの列にマッピングします。これは、フォーマットが既知の単一ベンダーからのクリーンなデジタル請求書では機能します。しかし、船荷証券では、相互に影響し合う3つの理由により機能しません。
各運送会社は独自のレイアウトを使用しています。 Maerskの海運BOLでは、荷主ブロックが左上に、船の詳細が中央の表に、貨物の説明が下の複数行グリッドに配置されています。Old DominionのストレートBOLは、NMFTA標準のショートフォームレイアウトを使用し、商品説明が狭い間隔のグリッドに配置されています。FedEx FreightのBOLもまた別の構成です。テンプレートベースのOCR(各フィールドの周囲にゾーンを描き、レイアウトごとにシステムをトレーニングする方法)では、運送会社ごとに1つのテンプレートが必要です。50社の運送会社を扱うブローカーは50のテンプレートを必要とし、運送会社がフォームを更新するたびに、そのテンプレートは静かに壊れます。
手書き、スタンプ、カーボンコピーは、例外ではなく標準です。 BOLは、荷降ろしドックでカーボンコピー紙に手書きで記入されることがよくあります。荷受人名はペンで走り書きされ、個数は赤インクのスタンプで上書きされ、3枚目のカーボンコピーはほぼ判読不能なほど色あせています。従来のOCRはこれらをノイズとして扱います。鮮明なデジタル書体のみを読み取れるツールは、手書きのBOL番号、スタンプされた「運賃前払い」マーカー、カーボンコピーの重量フィールドを見逃します。これらは、運送会社の請求書紛争を引き起こす可能性が最も高い3つのデータポイントです。
NMFC freight classには、文字認識ではなく意味的理解が必要です。 米国自動車貨物分類システムは、密度、積載性、取扱い、責任に基づいて13の貨物クラス(50〜500)を定義しています。BOLには、商品説明の横に「Class 70」と記載されている場合もあれば、商品のみが記載され、クラスの適用は運送会社に任されている場合もあります。標準OCRは「Class 70」をテキスト文字として読み取ります。しかし、意味的抽出(AIビジョンモデルが実行する種類)は、「Class 70」が「木製家具」を修飾し、商品説明列ではなく、貨物クラス列に属することを理解します。この違いが、正確な運送請求書と、3週間後に発生する300ドルの再分類料金の違いです。
船荷証券に記載されるデータと、各項目が重要な理由
船荷証券は同時に3つの法的機能を果たします:貨物の受領証(運送人が記載どおりの貨物を受け取ったことを確認)、運送契約書(輸送の条件)、そして権原証券(譲渡可能なBOLにおける貨物の所有権)です。書類の各項目はこれらの機能の1つ以上を支えており、いずれかの項目の誤りはこれらの法的領域に波及します。[6] BOLが単独で存在することはまれです。出荷書類一式との照合方法については、海運・貨物書類のデータ抽出に関するガイドをご覧ください。
| 項目グループ | 項目 | エラーによる影響 |
|---|---|---|
| 当事者 | 荷送人の名称・住所、荷受人、通知先、運送人/SCACコード | 誤った配送先、税関手続きの失敗、誤った当事者への請求 |
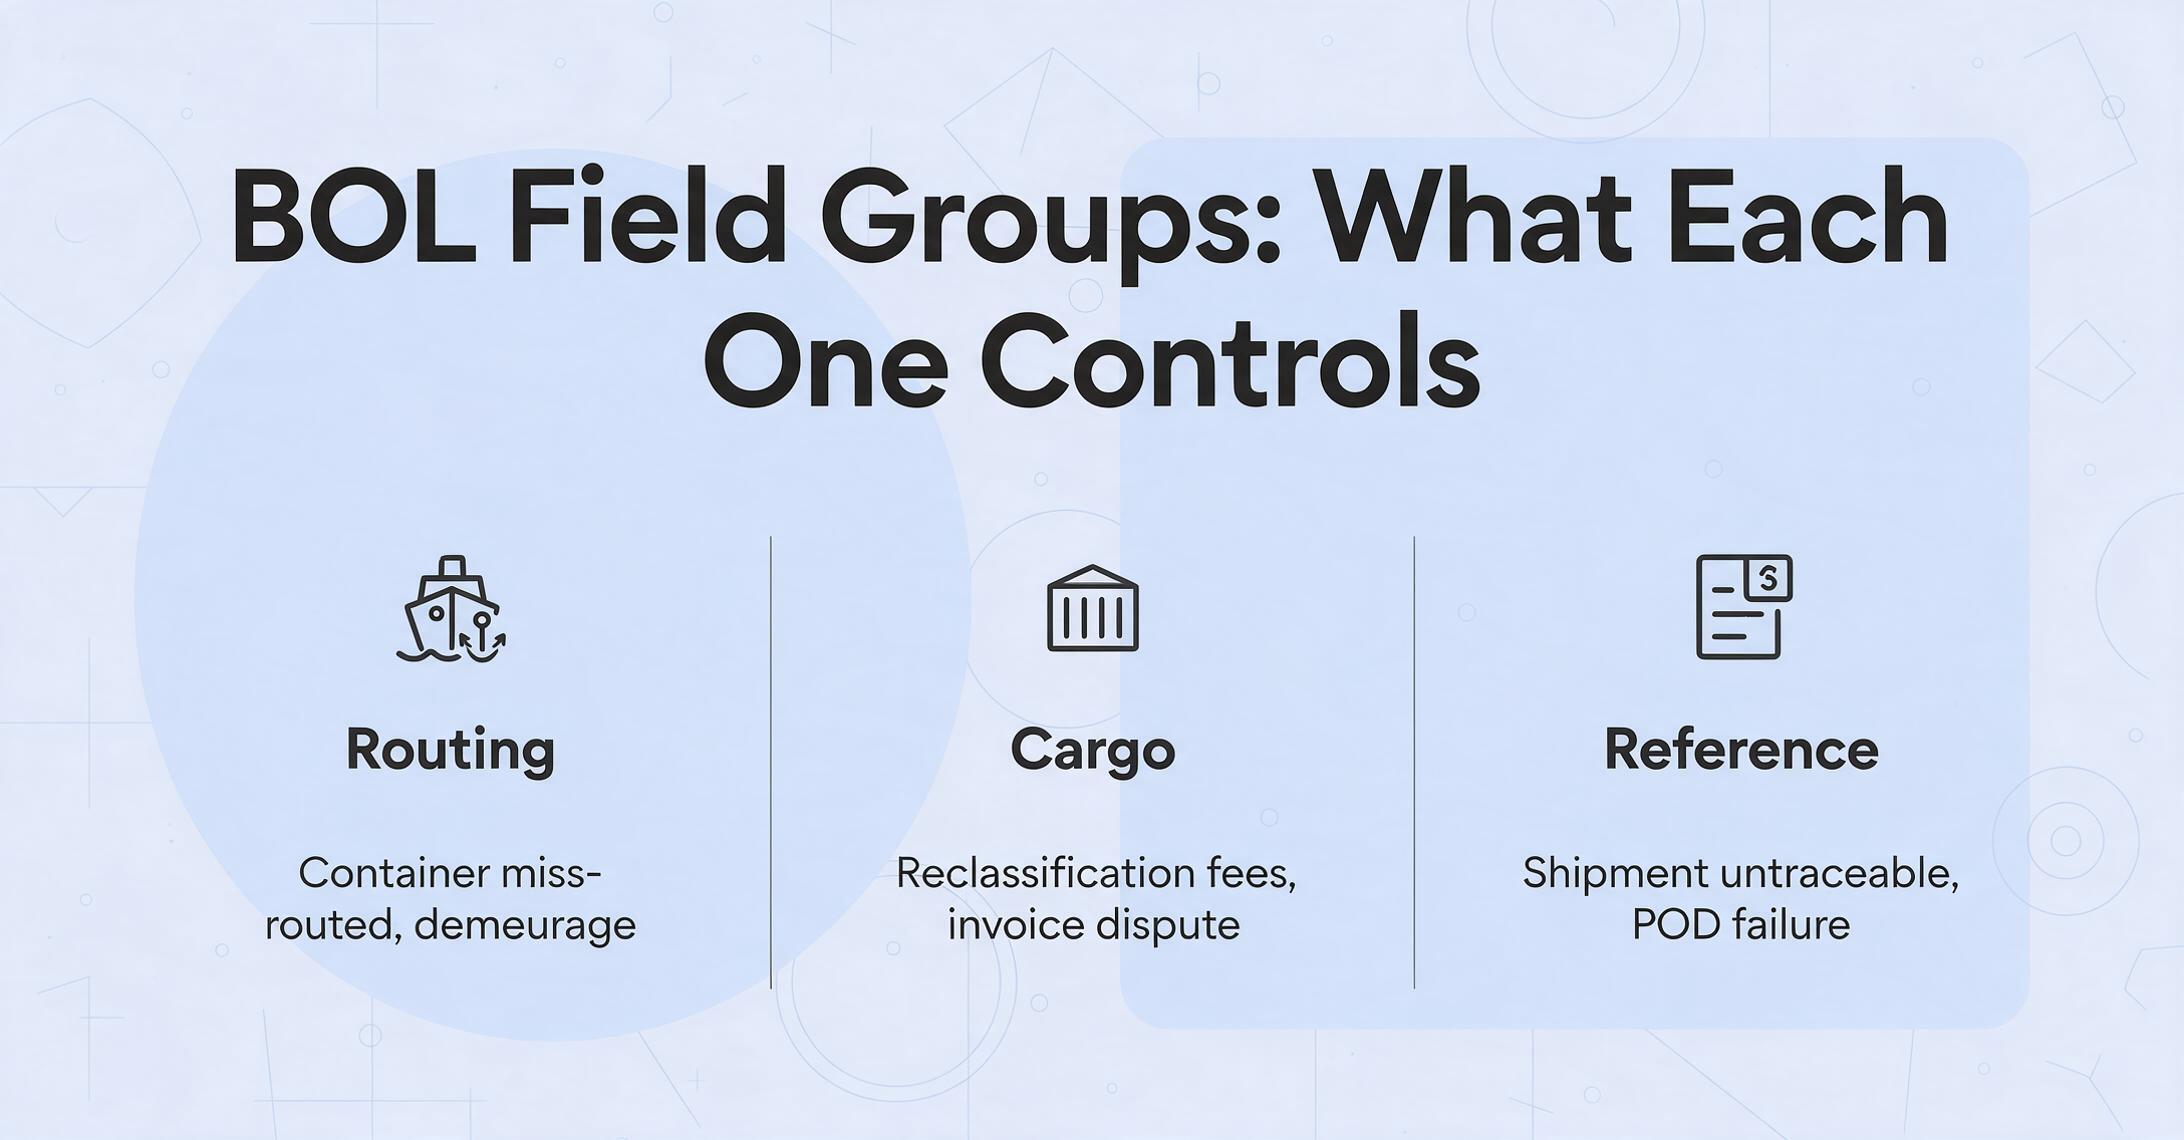
| ルーティング | 積込港、揚荷港、船名/航海番号、コンテナ番号・シール番号 | コンテナの誤配送、誤ったターミナルでのデマレージ、ISF申告の不一致 |
| カーゴ | 商品説明、個数、梱包タイプ、重量(総重量/正味重量)、寸法、Freight Class、NMFCコード、HSコード | 再分類手数料、関税の再計算、運送会社からの請求書紛争、危険物の不適合 |
| 料金・条件 | 運送条件(前払い/着払い)、運送料金、付帯料金 | 誤った請求先、二重支払い、回収不能な付帯料金 |
| 参照情報 | BOL番号、PRO番号、PO参照、集荷・配達日 | 貨物の追跡不能、配達時間枠の逸失、POD検証の失敗 |
カーゴグループ(商品説明、重量、個数、freight class)が最もデータ密度が高く、最もエラーが発生しやすいセクションであることに注目してください。また、このセクションは運送会社によって最も大きく異なります。ある運送会社は個別の重量を持つ5つの商品明細行を使用し、別の会社は合算重量の単一の集約行を使用します。さらに別の会社は欄外に「NMFC 156600 Sub 3」とスタンプを押します。抽出ツールはレイアウトを知る必要はありません。各項目の意味を知る必要があるのです。
PDFからスプレッドシートへ:AI抽出の実際の仕組み
手作業によるBOLデータ入力を置き換えるワークフローは、見た目以上にシンプルです。データが文書のどこにあるかではなく、出力したい列を定義します。この逆転がアプローチの核心です。ツールに「BOL番号はこの運送会社のフォームの右上にある」と指示する代わりに、「BOL番号を抽出する」と指示し、AIが文脈の中でBOL番号がどのようなものかを理解して位置を特定します。
複数の運送会社のBOLを処理する物流業務では、列の設定は次のようになります:BOL番号、荷主名、荷受人名、運送会社SCAC、コンテナ番号、積載港、揚陸港、商品説明、個数、重量(lbs)、Freight Class、運賃条件、運賃。これらの列名がExcelのヘッダーになります。AIはアップロードされた各BOLを読み取り、値を特定して行に入力します。BOLがMaersk、Old Dominion、または地元の運送会社の手書きカーボンコピーからのものであっても関係ありません。
これがカスタム列抽出です。必要なフィールド名を入力すると、AIがページ上の位置ではなく意味を理解して各値を特定します。固定位置にゾーンを描くテンプレートベースのOCRとは異なり、このアプローチは設定なしでどの運送会社のBOLレイアウトにも対応します。50社の運送会社を抱えるフレイトブローカーは、50社すべてを同じバッチに読み込み、1つの統合スプレッドシートを出力として得られます。
ファイルは安全に処理され、保存されません。サンプルBOLでお試しください。
抽出後、データは構造化されたExcelスプレッドシートに格納されます。各行が1つのBOL、各列が1つの抽出フィールドです。この出力はスプレッドシートネイティブです。Excel、Google Sheets、CSVに直接取り込め、TMSへのアップロードやフレイト監査にそのまま使用できます。抽出エンジンとスプレッドシートの間にJSONからCSVへの変換ステップやフィールドマッピングウィザードはありません。Google Sheetsを使用するチーム向けには、タブを離れずにスプレッドシート内で直接抽出を実行できるサイドバーアドオンもあります。
テンプレートの罠:キャリア別設定がスケールしない理由
物流業界には、テンプレートベースの抽出を根本的に非現実的にする構造的な問題があります。キャリアの入れ替わりとフォーマットの多様性は、市場の特徴であってバグではありません。ブローカーは、荷主がどのキャリアを使うかをコントロールできません。あるフォワーダーが複数のレーンで貨物を予約する場合、1ヶ月の間に8社の海運会社と15社のトラック運送会社を利用することもあります。各社は独自のフォーマットでBOLを発行します。
テンプレートベースのOCRでは、キャリアのフォーマットごとに設定作業が必要です。「荷主名」の周りにバウンディングボックスを描き、ラベルを付け、必要なフィールドすべてに対してこれを繰り返します。それを50キャリア分掛け合わせます。さらに、キャリアが帳票テンプレートを更新するたびに繰り返します。メンテナンスの負荷はキャリア数に比例して増大します。つまり、抽出が最も価値を発揮するはずのシナリオ(キャリアの多様性が高い状況)こそ、テンプレートのメンテナンスが持続不可能になるシナリオなのです。
これこそが、BOL抽出においてテンプレート不要でフォーマットに依存しないアプローチが重要である理由です。AIは、マースクが荷主を左上に配置し、オールド・ドミニオンが「荷主/輸出者」というラベルのボックスに配置することを教えられる必要はありません。物流のプロフェッショナルが書類を読むのと同じように、ページ上の物理的な位置に関係なく、荷主の意味パターンに一致するエンティティをスキャンして読み取ります。これは単にセットアップが速いというだけではありません。すべてのキャリアに対して初日から機能する抽出パイプラインと、新しくオンボーディングするキャリアごとに継続的なテンプレートメンテナンスが必要なパイプラインとの違いです。
セルフサービスツール、API連携、エンタープライズプラットフォームの選び方
BOLデータ抽出の市場は、3つの運用プロファイルに分かれます。適切な選択は、ボリューム、技術リソース、そして抽出が単独の改善策なのか、より広範な自動化戦略の一部なのかによって異なります。
セルフサービス型アップロードツール
対象: フレートブローカー、中小規模のフォワーダー、月50〜500件のBOLを処理するオペレーションチーム
方法: BOLをアップロード → 列名を入力 → Excelをダウンロード。API設定不要、開発者も不要です。
主な要件: 全キャリアに対応したテンプレート不要の抽出。キャリアごとにテンプレート作成が必要な場合、この方法はお客様の規模では機能しません。
API連携
対象: TMSプラットフォーム、ブローカレッジシステム、月500〜5,000件のBOLを処理する社内ツール
方法: REST APIがBOLファイルを受信し、フィールドレベルの信頼度スコア付きの構造化JSON/CSVを返します。
主な要件: 信頼度スコアリングにより、低信頼度の抽出結果を自動的に人間によるレビューへ振り分けられること。
エンタープライズプラットフォーム
対象: 大手3PL、グローバルフォワーダーで、月5,000件以上のBOLを処理し、コンプライアンス自動化のニーズがある企業
方法: メール取り込み、抽出、検証ルール、例外ルーティング、TMS/ERP連携を備えたエンドツーエンドのIDP。
主な要件: 管理された例外処理と監査証跡 — 抽出精度だけではありません。
ほとんどのフレートブローカーや中規模フォワーダーにとって、セルフサービス層が最適です。統合のオーバーヘッドがなく、初日からすぐに価値を得られ、固定のプラットフォーム契約ではなく実際の使用量に応じてスケールするページ単位の料金体系です。このツールはBOL1ページを5〜10秒で処理します — 手動データ入力の10〜15分と比較して — そしてExcelに直接出力します。この速度なら、1日100件のBOLを処理するチームは、毎日約20時間のスタッフ時間を取り戻せます。セルフサービスツールとエンタープライズプラットフォームをBOLだけでなく文書全体の構成で比較検討されている場合は、物流文書抽出バイヤーズガイドでより広範な評価基準をご確認いただけます。
1つ注意すべき点: BOLで100%のストレートスルー処理を達成する抽出ツールはありません。 手書きのカーボンコピーにスタンプが重なり文字が薄くなっている場合、信頼度スコアは低くなります。適切なワークフロー期待値は、フラグ付きフィールドのレビューキューを備えた85〜95%の自動抽出であり、完全無人処理ではありません。しかし85%の自動化でも、レビューキューに入る残り15%は、すべてのフィールドをゼロから入力するよりは速く確認できます。
よくある質問
AI抽出は手書きの船荷証券に対応できますか?
はい、ただし限定的です。最新のビジョンモデルは、活字体、ブロック体、およびほとんどの筆記体を読み取ることができます。特にBOL番号、個数、重量など、標準化されたフィールドは判読しやすいブロック体で書かれているため、精度は高いです。精度が低下するのは、スタンプが手書き文字に重なった薄いカーボンコピーや、筆圧が弱くスキャンが不鮮明な書類です。そのような場合、抽出エンジンは推測せずに、低い信頼度スコアを付けて人間による確認を促します。
BOL抽出は複数ページの書類でも機能しますか?
はい。海上BOLの多くは複数ページに及びます。1ページ目には当事者と運送経路の情報、2ページ目には貨物の詳細と条件、3ページ目には約款が記載されていることがあります。バッチ抽出ツールは全ページを1つの書類として処理し、抽出したフィールドを出力スプレッドシートの1行に統合します。重要なのは、ツールが各ページを個別の書類として扱うのではなく、継続ページとして認識することです。
2つの運送会社が同じフィールドに異なる名称を使用している場合はどうなりますか?
まさにここで、テンプレートベースのアプローチよりもセマンティック抽出が優れています。運送会社Aが「Shipper」、運送会社Bが「Shipper/Exporter」、運送会社Cが「Consignor」とフィールドをラベル付けしても、AIはこれらすべてが同一のエンティティ(貨物を送る当事者)を指していることを理解します。出力列を「荷主名」として一度定義すれば、AIが各運送会社のバリエーションを自動的にその列にマッピングします。運送会社ごとのフィールドマッピングは不要です。
抽出したBOLデータをTMSに直接取り込めますか?
ほとんどのセルフサービス型抽出ツールはExcelまたはCSVにエクスポートでき、それをTMSの標準インポート機能で取り込めます。一部のTMSプラットフォーム(Turvo、Descartes、McLeodなど)はCSVインポートテンプレートをサポートしています。抽出結果をエクスポートし、列をTMSのインポートテンプレートに合わせて整形し、アップロードします。ファイルを介さずに抽出データをTMSに直接プッシュするAPIレベルの統合には、REST APIを備えたツールと、統合側での開発作業が必要です。
BOL抽出は税関ブローカーの代わりになりますか?
いいえ。データ抽出はデータ入力のステップ(BOLフィールドを構造化形式に変換すること)を自動化します。これは、ライセンスを持つ税関ブローカーが提供する規制上の判断(HSコードの分類決定、評価評価、自由貿易協定の適格性判断、税関申告戦略)に取って代わるものではありません。抽出はタイピング作業を省き、ブローカーが専門知識を必要とする分類やコンプライアンスの判断に時間を費やせるようにするものと考えてください。
AI抽出は船荷証券(BOL)で手動データ入力と比べてどの程度正確ですか?
適切に訓練された貨物書類AIは、標準的なデジタルBOLで97〜99%のフィールドレベル精度を達成します。経験豊富なスタッフによる手動データ入力は、通常条件下で96〜99%の精度ですが、繁忙期にはボリュームのプレッシャーでエラー率が上がり低下します。重要な違いは、AIのエラーはフラグが立てられた低信頼度の例外に集中し、それが人間のレビューに回されることです。手動エラーはランダムで、下流システムに到達する前に検出するのが難しくなります。1日500件のBOLを処理する場合、1%の手動エラー率でも1日5件の出荷で少なくとも1つのフィールドが誤っていることになり、そのエラーは何かが壊れるまで検出されません。
船荷証券は一世紀にわたってほとんど変わっていません。貨物とともに移動する紙片で、誰がいつ何を支払うのか、商品の所有権がいつ移るのかを決定する詳細を運びます。変わったのは、その詳細を貨物をルーティングし、税関を通過させ、請求書を決済するシステムに取り込むコストです。手動入力は決して良い解決策ではありませんでした。ただ唯一の解決策だっただけです。テンプレートOCRはそれを改善しましたが、キャリアの多様性がテンプレートのメンテナンス能力を超える時点で限界に達しました。次のステップ——物流のプロフェッショナルが読むようにBOLを読むセマンティック抽出——は経済的方程式を変えます。 ご自身のBOLでお試しください。データ入力のボトルネックがレビューキューに縮小するかどうか、ご確認ください。