Analyse de CV vs extraction par IA pour recruteurs :
Ce qui survit réellement aux PDF multi-colonnes
Si vous comparez « logiciel d'analyse de CV » et « extraction par IA » côte à côte, la première chose que vous remarquerez, c'est que les deux disent lire les CV — et les deux disent être précis. Les résultats de recherche n'aident pas non plus : la plupart des articles sur cette requête sont des listes d'outils rédigées par des fournisseurs d'analyse, et la comparaison s'arrête généralement à « celui-ci a 200 champs, celui-là en a 100. » Ce que les recruteurs ont réellement besoin de savoir — quelle approche survit aux PDF à deux colonnes que les candidats continuent d'envoyer, et laquelle coûte moins cher à des volumes de recrutement réels — n'est presque jamais abordé.
Points clés
- Chaque logiciel d'analyse de CV et outil d'extraction par IA revendique une précision d'environ 95 % — les chiffres sont si proches que le choix semble être une question de détails.
- Ce chiffre est mesuré sur des CV à une seule colonne, adaptés au texte. Les candidats continuent d'envoyer des mises en page à deux colonnes, et les analyseurs basés sur la position les brouillent : la barre latérale de compétences fusionne avec le parcours professionnel, produisant des employeurs fantômes et des résultats de recherche perdus.
- Une question tranche la confusion : l'outil lit-il par position ou par sens ? La réponse détermine si vos candidats avec modèles Canva apparaissent dans vos champs recherchables.
La question derrière chaque recherche de parser
Rechercher « resume parsing vs AI extraction » signifie généralement l'une de deux choses. Soit vous êtes un recruteur ou un responsable RH qui cherche à décider s'il faut acheter une technologie d'analyse — soit vous êtes un développeur qui évalue une API d'analyse à intégrer dans un produit. Cet article est écrit pour le premier groupe, et il déclare son parti pris d'emblée : il est rédigé du point de vue d'une équipe de recrutement qui veut des données de candidats dans une feuille de calcul, et non du point de vue d'une entreprise de logiciels qui vend de l'infrastructure d'analyse. Si vous construisez un ATS, un site d'offres d'emploi ou un produit RH, passez directement à la section sur les cas où les API d'analyse sont réellement gagnantes — c'est l'argument honnête pour en acheter une.
Pour tous les autres, le cadre de décision se résume à trois questions : Quels documents lui fournissez-vous réellement ? Quel résultat vous faut-il ? Et quel est le coût de chaque option à votre volume ? Le reste n'est que du détail.
La plupart des comparaisons « parser de CV vs IA » sont écrites par un camp qui vend quelque chose. Celle-ci part de ce dont une équipe de recrutement a réellement besoin : une feuille de calcul de candidats qui soit correcte, économique à grande échelle, et qui ne s'effondre pas sur les mises en page que les candidats utilisent réellement.
Ce que fait réellement un logiciel d'analyse de CV
Le logiciel d'analyse de CV convertit un document de CV en données structurées de candidat — nom, e-mail, téléphone, parcours professionnel, formation, compétences — en mappant le contenu du document sur un schéma de CV fixe et préétabli. Les technologies de base sont l'OCR (reconnaissance optique de caractères) pour extraire le texte des scans et des images, puis des règles de TALN (traitement automatique du langage naturel) pour classer ce texte dans des champs comme « Employeur » ou « Intitulé de poste ». Vous pouvez acheter cela sous forme d'API auprès de fournisseurs comme Textkernel (Sovren), RChilli, Daxtra, Affinda et HireAbility, ou c'est inclus dans la plupart des plateformes ATS (Greenhouse, Workday, Lever, iCIMS) comme la fonctionnalité qui « remplit automatiquement » un profil de candidat à partir d'un fichier téléchargé.
La caractéristique déterminante de la plupart des parsers de CV est qu'ils sont basés sur la position : ils s'attendent à trouver les coordonnées en haut, l'historique d'emploi au milieu, la formation en bas, et ils lisent le texte dans un ordre fixe — généralement de haut en bas, de gauche à droite, comme un flux unique. Lorsqu'un CV correspond à cette mise en page attendue, les parsers sont rapides et raisonnablement précis. Lorsque ce n'est pas le cas, la qualité de la sortie chute fortement, car le parser n'a aucun mécanisme pour comprendre qu'une barre latérale de compétences à gauche et une colonne de parcours professionnel à droite sont des régions sémantiques différentes.
Ce que fait réellement l'extraction de données par IA
L'extraction de données par IA est une catégorie plus récente, construite sur de grands modèles de vision — la même classe d'IA qui alimente la compréhension d'images. Au lieu de mapper le texte sur un schéma de CV fixe en fonction de sa position, elle lit le document comme le ferait un humain : en comprenant que « Formation » est une section, qu'une barre latérale intitulée « Compétences » contient des compétences, et qu'une photo d'un CV n'est qu'un autre format. ImageToTable.ai est construit sur ce paradigme de lecture sémantique, qu'il appelle Extraction de colonnes personnalisées : vous saisissez les noms des champs que vous voulez — « Nom du candidat », « E-mail », « Compétences principales », « Années d'expérience » — et l'IA localise chaque valeur n'importe où sur la page en comprenant ce que le champ signifie, et non où il se trouve. Les noms de colonnes que vous saisissez deviennent les en-têtes de votre feuille de calcul de sortie.
Deux différences pratiques découlent de cette conception. Premièrement, la sortie est native pour les feuilles de calcul : vous obtenez un tableau Excel ou Google Sheets avec une ligne par candidat, prêt à filtrer et à trier, plutôt qu'un objet JSON nécessitant du code d'intégration pour devenir utilisable. Deuxièmement, il n'y a pas de schéma de CV spécifique à mettre à jour : comme l'extraction est pilotée par les colonnes que vous définissez, le même outil qui extrait des CV peut extraire des lettres d'offre, des formulaires d'intégration ou des contrats de travail sans reconfiguration.
La vraie différence n'est pas « analyseur vs IA » en tant que catégories marketing. C'est la lecture basée sur la position (le texte est classé selon l'endroit où il se trouve sur la page) par rapport à la lecture sémantique (le texte est classé selon ce qu'il signifie). Tout le reste dans cet article — précision sur les mises en page créatives, effort de configuration, modèle de coût — découle de cette seule distinction. C'est aussi la première chose à vérifier dans tout analyseur de documents que vous évaluez, avant de regarder le nombre de champs sur sa fiche technique.
Le test du PDF à plusieurs colonnes
Il existe un format de CV qui sépare les deux approches plus nettement que tout autre benchmark : la mise en page à deux colonnes avec une barre latérale de compétences. Elle est omniprésente — les designers, les spécialistes du marketing, les chefs de produit et la plupart des personnes utilisant des modèles de CV modernes la produisent — et c'est exactement la mise en page que les analyseurs basés sur la position gèrent le moins bien.
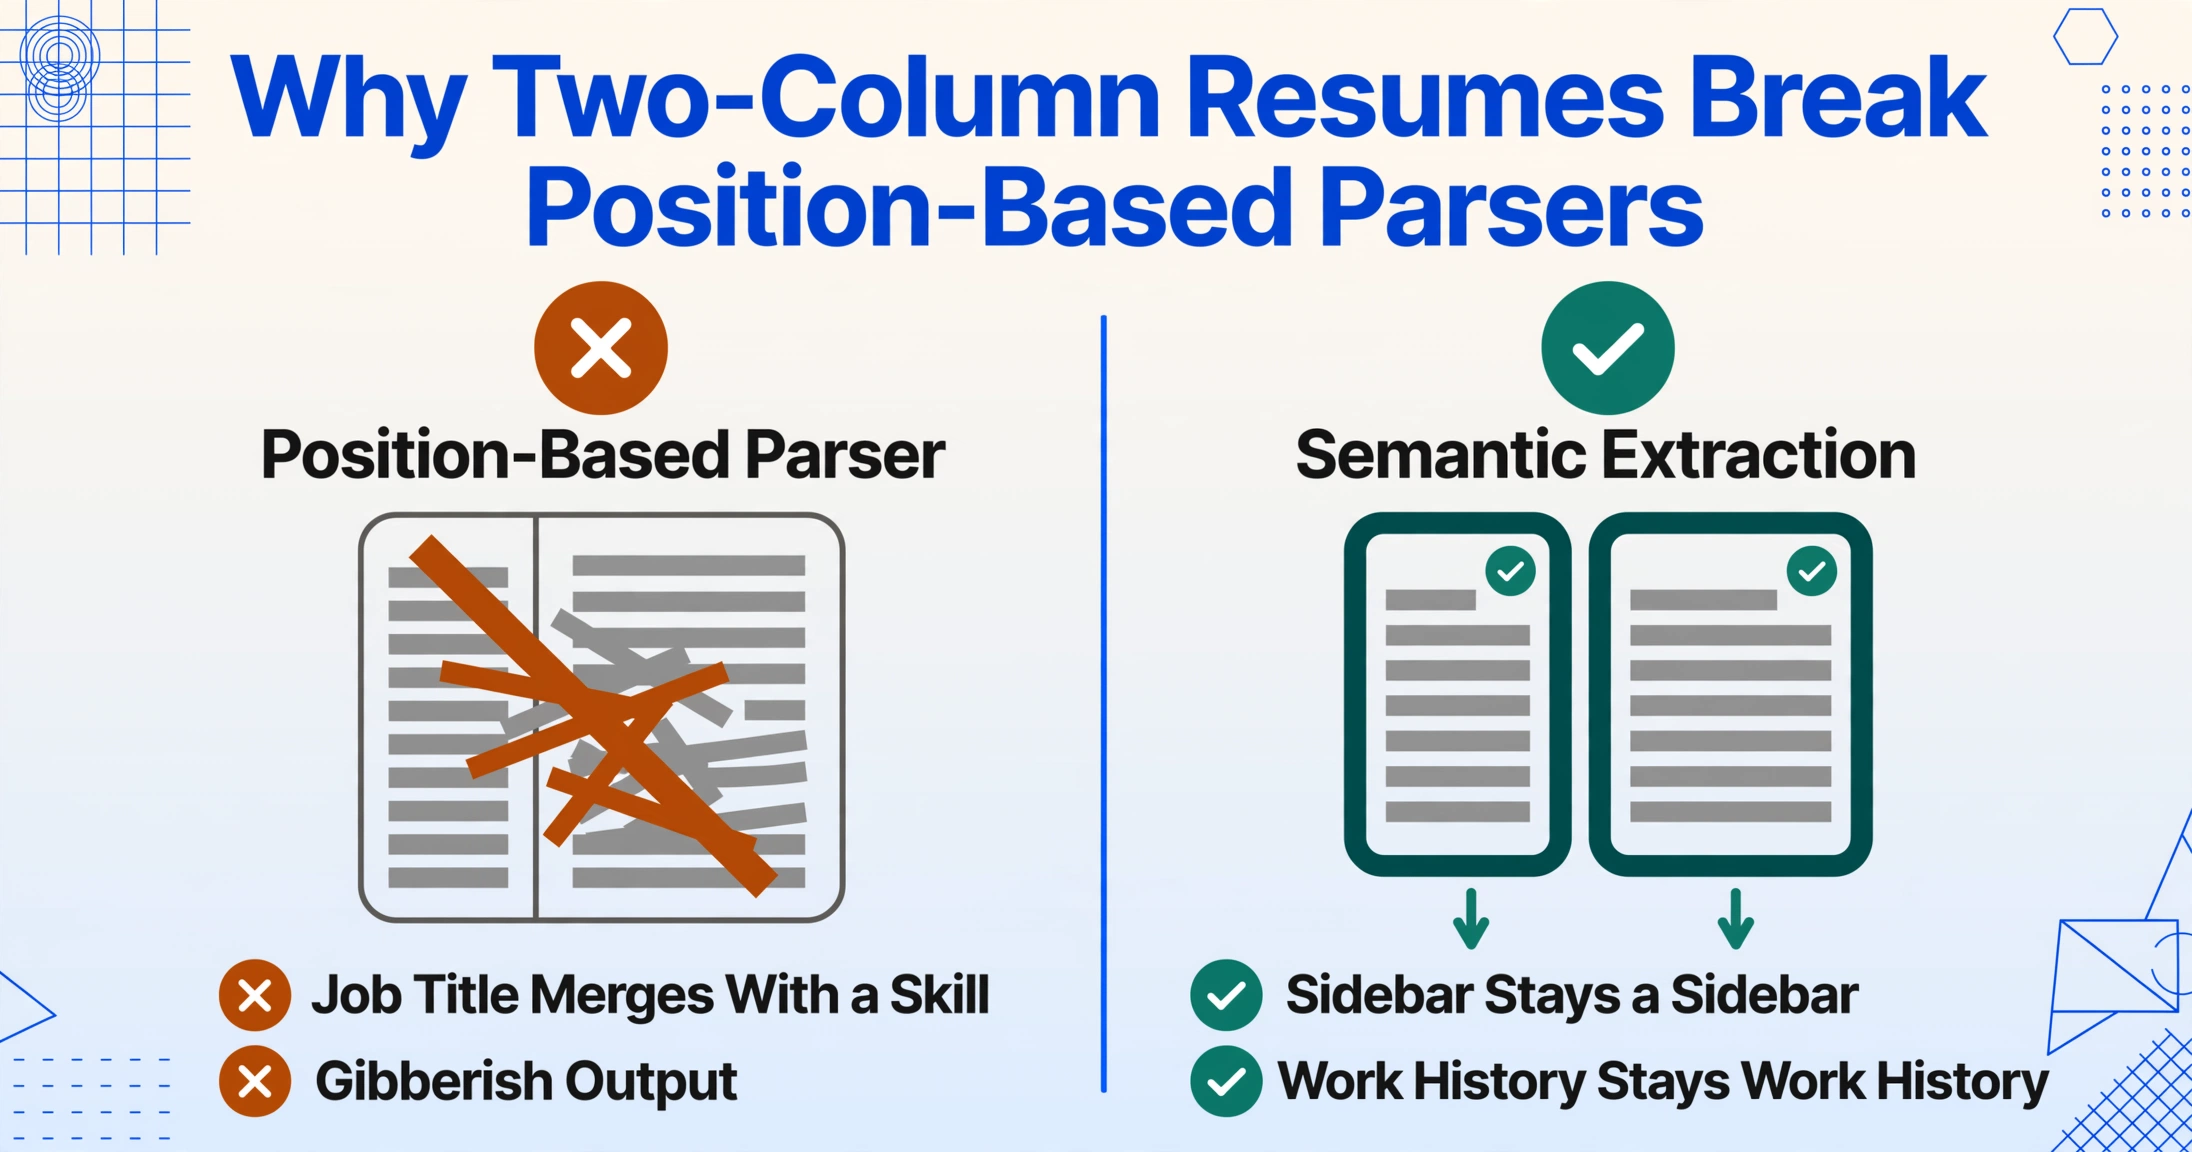
Un développeur qui a passé 8 mois à tester de vraies plateformes ATS avec des milliers de variantes de CV a documenté le mode de défaillance de l'intérieur : « Les mises en page à deux colonnes. L'ATS lit de haut en bas dans un flux unique. Les deux colonnes sont mélangées — votre intitulé de poste de la colonne A fusionne avec une compétence de la colonne B. C'est du charabia à l'autre bout » (r/jobsearchhacks). Un second praticien qui a rétro-ingénié l'analyseur de Workday a rapporté le même mécanisme : « Les mises en page multi-colonnes cassent l'analyseur. Il lit de gauche à droite sur les deux colonnes simultanément. Vos sections "Compétences" et "Expérience" sont fusionnées en chaînes de caractères absurdes » (r/jobsearchhacks). La communauté r/resumes arrive à la même conclusion du côté des chercheurs d'emploi : « beaucoup d'entre eux ont du mal avec les colonnes, les tableaux, les zones de texte et les mises en page très design » (r/resumes).
L'extraction sémantique n'a pas ce mode de défaillance, car elle ne repose jamais sur l'ordre de lecture. Une barre latérale de compétences est reconnue comme une section « Compétences », quel que soit le côté de la page où elle se trouve ; une colonne de parcours professionnel est lue comme un historique d'emploi. Cela ne signifie pas que l'extraction par IA est infaillible sur toutes les mises en page — les CV très stylisés de graphistes avec des marqueurs de section basés sur des icônes peuvent encore produire une confiance plus faible sur certains champs, et les annotations manuscrites en marge restent un vrai défi — mais la défaillance structurelle qui mélange deux colonnes en un seul bloc de texte est éliminée.
L'enjeu n'est pas seulement cosmétique. Un candidat dont le profil analysé montre le mauvais employeur, ou dont les compétences n'ont jamais atterri dans le champ recherchable, est un candidat qui disparaît de votre pipeline sans que personne n'ait décidé de le rejeter. Les recruteurs sur r/recruiting décrivent cela comme la norme, pas l'exception : « Workday et Dayforce analysent tous deux les CV (et font un travail épouvantable)... la façon dont Greenhouse fonctionne est exactement celle de la plupart d'entre eux » — un résumé d'un praticien qui avait implémenté plus d'une douzaine de plateformes ATS.
Coût par CV : tarification par analyse vs abonnement
La deuxième dimension qui compte à des volumes de recrutement réels est le coût — et les deux catégories se fixent des prix complètement différents.
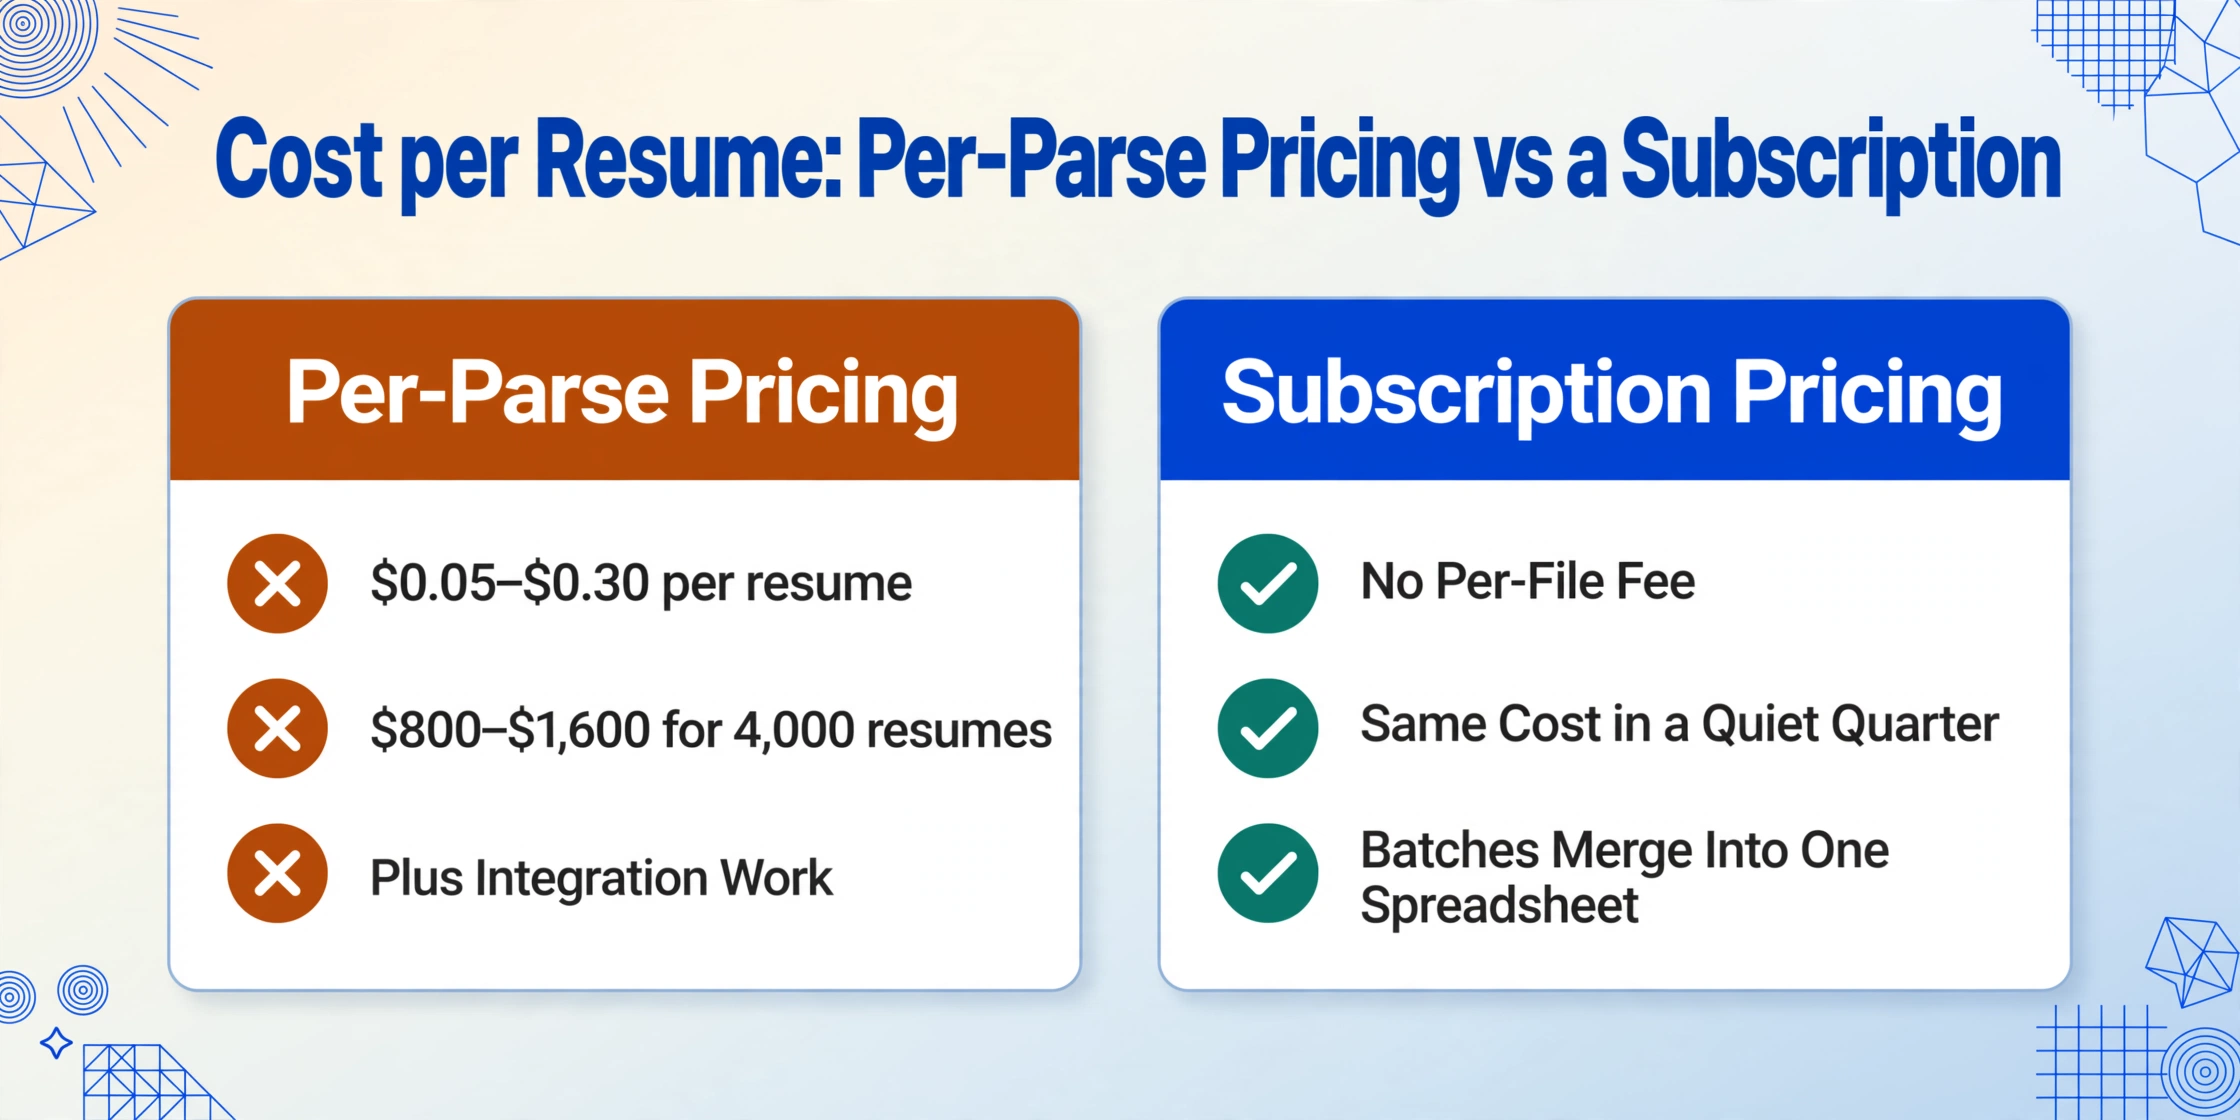
Les API d'analyse facturent par document. Les tarifs du secteur pour l'analyse dédiée de CV vont généralement de 0,05 $ à 0,30 $ par CV selon le volume et le fournisseur. La tarification publiée d'Affinda est un exemple concret : 0,20 $ US par page en paiement à l'utilisation, ou un plan annuel à partir de 3 600 $ US pour 66 000 documents — soit environ 0,055 $ par document à ce niveau (Tarification de l'analyse de CV Affinda). Faites le calcul pour une équipe de recrutement de taille moyenne qui traite 200 CV par poste sur 20 postes par an — 4 000 documents : le paiement à l'utilisation à 0,20 $ par page coûte de 800 $ à 1 600 $ selon le nombre de pages, et vous n'avez pas encore touché au niveau annuel. À 66 000 documents, le prix par document baisse, mais vous vous êtes aussi engagé sur un volume que la plupart des équipes de recrutement internes n'atteindront jamais.
L'extraction par IA sur ImageToTable.ai est facturée par abonnement, pas par fichier. Vous traitez autant de CV que la capacité de traitement de votre plan le permet — les lots sont fusionnés en une seule feuille de calcul, et il n'y a pas de frais par document qui augmentent à mesure que votre bassin de candidats grandit. Pour une équipe qui recrute de façon saisonnière, cela signifie qu'un trimestre calme coûte le même prix qu'un trimestre chargé, au lieu de vous facturer chaque CV que vous avez reçu.
Il y a aussi un coût caché que la tarification par analyse n'inclut pas : le travail d'intégration. Une API d'analyse renvoie du JSON structuré, qui n'est utile que lorsque quelqu'un écrit du code pour le mapper dans votre ATS, votre feuille de calcul ou votre base de données. Pour une équipe de recrutement sans développeurs en interne, c'est une ligne invisible qui peut dépasser les frais d'analyse eux-mêmes.
Champs et configuration : schéma fixe ou colonnes que vous définissez
Les fournisseurs de parsers annoncent des centaines de champs de CV prémappés, et c'est une vraie force — pour un certain acheteur. Le schéma d'un parser est conçu pour l'exhaustivité : il extrait tout ce qu'un CV peut contenir, afin qu'un système en aval puisse décider de ce qui compte. Si vous développez un logiciel qui sert de nombreux clients avec des besoins de champs différents, un schéma fixe complet vous évite de définir les champs vous-même.
Pour une équipe de recrutement, cette exhaustivité est souvent le problème. Une feuille de calcul de candidats sert au filtrage et à la comparaison, pas à l'archivage — et extraire 200 champs signifie 200 colonnes de feuille de calcul en grande partie vides. L'extraction sémantique inverse le flux de travail : vous définissez la poignée de colonnes que votre décision d'embauche utilise réellement — nom, e-mail, poste actuel, années d'expérience, compétences principales — et le tableau de sortie contient exactement celles-ci. Vous pouvez également ajouter des colonnes calculées (l'IA calcule une valeur pendant l'extraction, comme « Années d'expérience » additionnées à partir de plusieurs plages de dates) et des colonnes inférées (l'IA remplit des informations non imprimées sur le CV, comme une balise Source indiquant d'où vient le candidat).
L'effort de configuration suit le même schéma. Une API d'analyse nécessite généralement la mise en place d'un compte, des identifiants API, un mappage de schéma et des tests avant d'obtenir un premier résultat propre. L'extraction sémantique n'a pas d'étape d'entraînement ni de modèle : téléchargez un CV, nommez vos colonnes, et le premier fichier que vous traitez est un vrai résultat. Si votre flux de travail d'extraction de données de CV doit gérer des PDF à deux colonnes, des photos de téléphone et des pages scannées dans le même lot, l'indépendance du format importe plus que le nombre de champs.
Quand une API d'analyse de CV est réellement le bon choix
Une comparaison honnête doit reconnaître où l'autre camp gagne, et les API d'analyse gagnent dans trois scénarios spécifiques :
- Vous développez un produit qui ingère des CV pour de nombreux clients. Les fournisseurs d'ATS, les sites d'emploi, les plateformes de recrutement et les éditeurs de logiciels RH ont besoin de l'analyse comme infrastructure. Le coût par document atteint des millions pour eux, la sortie JSON alimente un vrai produit, et la taxonomie des compétences (normaliser « C++ » et « C Plus Plus » en une seule compétence) est réellement précieuse à cette échelle. C'est à cela que servent Affinda, Textkernel, RChilli et Daxtra — notre comparaison directe avec Affinda détaille la frontière plus en profondeur.
- Vous avez besoin de 50+ langues avec une sortie normalisée. Les fournisseurs d'analyse de CV ont investi des années dans la normalisation multilingue. Si vous recrutez sur des marchés où les compétences d'un candidat doivent correspondre à une taxonomie standardisée dans plusieurs langues, la couverture linguistique d'une API d'analyse dépasse un outil d'extraction général qui lit mais ne normalise pas.
- Vous avez des développeurs et vous construisez un pipeline. Si les CV arrivent dans un flux de travail automatisé — déduplication, correspondance de candidats, notation — la sortie JSON d'une API d'analyse s'intègre directement. ImageToTable.ai dispose également d'une API v1 pour ce scénario, mais un parser de CV dédié est le choix mature pour les pipelines spécifiques aux CV.
Si aucun de ces cas ne vous correspond, les avantages de l'API d'analyse ne s'appliquent probablement pas — et son coût par document et sa charge d'intégration sont de purs frais généraux.
Ce que fait (et ne fait pas) l'analyseur intégré de votre ATS
Il existe une troisième option cachée dans la comparaison : l'analyseur déjà inclus dans votre abonnement Greenhouse, Workday, Lever ou iCIMS. Vous le payez de toute façon, la question est donc de savoir s'il fait le travail.
Le consensus des praticiens indique qu'il s'agit de la même technologie basée sur la position, généralement une version allégée. Le fil r/recruiting cité plus haut le dit sans détour : "la façon dont Greenhouse fonctionne est exactement celle de la plupart d'entre eux" — l'analyseur intégré remplit une page de profil à partir d'un CV textuel, mais sa précision sur les mises en page créatives n'est pas meilleure que celle des analyseurs autonomes sur lesquels il repose. Certaines plateformes ATS ne tentent même pas les cas difficiles : la documentation d'import en masse de Breezy HR indique que les CV téléchargés doivent être des documents textuels (DOCX, TXT, RTF, ODT ou PDF) — "pas des copies scannées, des images ou des PDF basés sur des images" — qu'elle rejette d'emblée (documentation Breezy HR). Une équipe de recrutement qui reçoit des CV photographiés de candidats mobiles — courant dans les recrutements horaires et ouvriers — ne peut tout simplement pas compter sur cette fonctionnalité.
Le coût de s'appuyer sur un premier tri défaillant est mesurable, et il dépasse la perte d'un seul candidat. Le projet de la Harvard Business School sur la gestion de l'avenir du travail a interrogé 8 720 "travailleurs cachés" et 2 275 cadres aux États-Unis, au Royaume-Uni et en Allemagne, et a constaté que plus de 90 % des employeurs utilisant un système de gestion de recrutement s'appuyaient sur celui-ci pour effectuer le premier tri ou classer les candidats — 94 % pour les postes de compétences intermédiaires et 92 % pour les postes de compétences élevées. Pourtant, seul un travailleur caché sur cinq a franchi le premier tri, et le travailleur moyen interrogé a postulé à 25 emplois sur cinq ans pour une seule offre (HBS Working Knowledge). Lorsque l'analyse est la porte d'entrée, les erreurs d'analyse deviennent des erreurs de recrutement — et l'étude HBS documente environ 27 millions de personnes aux États-Unis seulement qui sont qualifiées, disponibles et systématiquement filtrées.
C'est l'argument le plus fort pour extraire les données des CV en dehors de votre ATS et importer des lignes propres. Notre guide étape par étape pour extraire les données des CV dans Excel couvre la liste des champs et le flux de travail complet ; en bref, la plupart des plateformes ATS importent les feuilles de calcul des candidats via CSV, vous pouvez donc extraire une fois, vérifier les données et importer un fichier validé au lieu de faire confiance à l'analyseur intégré pour chaque candidature.
Un cadre de décision pour votre processus de recrutement
Voici la comparaison condensée selon les dimensions qui devraient guider votre choix — chacune étant associée à ce qu'une équipe de recrutement observe réellement, et non à ce que le fournisseur prétend.
| Dimension | API d'analyse de CV | Analyseur intégré à l'ATS | Extraction par IA (ImageToTable.ai) |
|---|---|---|---|
| Méthode de lecture | Basée sur la position + règles TALN | Basée sur la position (plus légère) | Sémantique (modèle de vision) |
| Mise en page à deux colonnes / créative | Mélange — la barre latérale fusionne avec le parcours professionnel | Même limite, et les fichiers scannés sont souvent rejetés | Lit par le sens, pas par la position ; la barre latérale reste une barre latérale |
| Sortie | JSON structuré (nécessite du code d'intégration) | Page de profil dans l'ATS | Excel / Google Sheets / CSV — une ligne par candidat |
| Configuration | Clés API, mappage de schéma, temps de développement | Déjà en place (mais limité) | Nommez vos colonnes, importez, c'est terminé |
| Modèle de coût | Par document (~0,05 $–0,30 $ ; Affinda 0,20 $/page) | Inclus dans l'abonnement ATS | Abonnement — pas de frais par fichier en volume |
| Champs | 100–200 pré-mappés + taxonomie de compétences | Champs de profil de base uniquement | Exactement les colonnes que vous définissez |
| Idéal pour | Créateurs de produits, pipelines multilingues | Utilisateurs d'ATS avec des CV standard | Équipes de recrutement qui veulent une feuille de calcul filtrable |
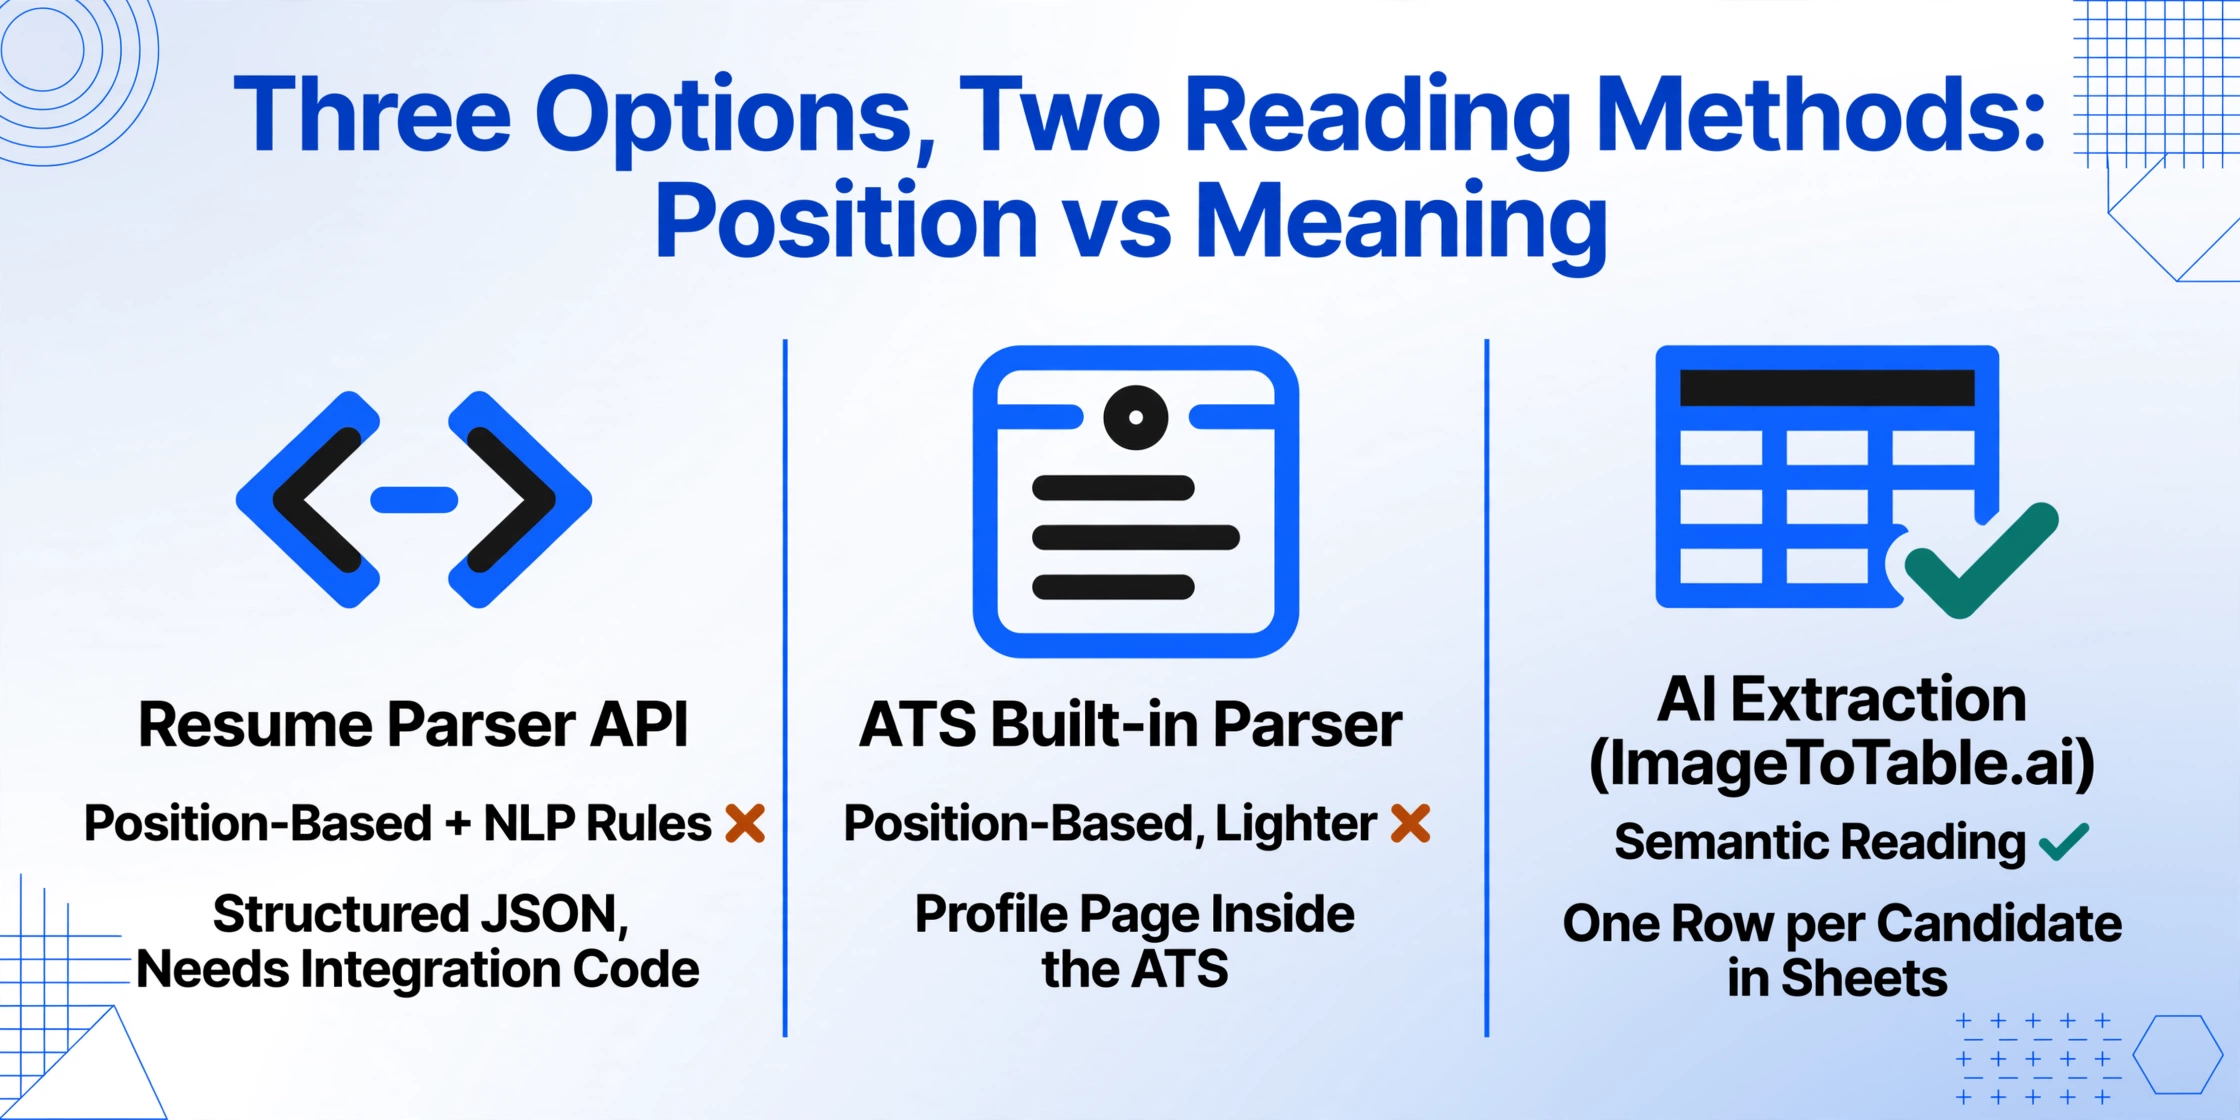
Les règles de décision découlent directement de ce qui précède. Vous développez un logiciel qui ingère des CV → achetez une API d'analyse. Vous recevez des CV standard à une colonne et êtes satisfait de la page de profil de votre ATS → vous avez déjà ce qu'il vous faut. Vous recevez des mises en page à deux colonnes, des photos de téléphone, des scans, ou vous voulez simplement une feuille de calcul que vous contrôlez → optez pour l'extraction par IA. Le troisième cas concerne la plupart des équipes ; la démo ci-dessous illustre le flux de travail — sans préréglage, sans modèle, juste des colonnes que vous définissez pour tous les CV que vous importez.
Les fichiers sont traités de manière sécurisée et ne sont pas stockés.
Comment tester avant d'acheter
Les fournisseurs des deux côtés publient des allégations de précision — « 95 %+ » est le chiffre courant sur les pages d'atterrissage des analyseurs, et il est presque toujours mesuré sur des CV propres et à une seule colonne. Vous pouvez vérifier l'une ou l'autre approche en un après-midi avec dix CV réels :
Collectez un échantillon représentatif du pire cas. Prenez dix CV de votre bassin de candidats réel — et incluez délibérément au moins deux CV à deux colonnes, un CV fortement designé ou basé sur des icônes, une page scannée et une photo prise sur un téléphone. C'est cet échantillon qui expose le mode de défaillance multi-colonnes, alors ne le normalisez pas.
Passez-les dans l'outil. Pour un outil d'extraction, définissez les colonnes sur lesquelles vous filtreriez réellement — Nom du candidat, E-mail, Poste actuel, Entreprise actuelle, Années d'expérience, Compétences principales — et traitez le lot. Pour une API d'analyse, utilisez son niveau d'essai et exportez le JSON.
Vérifiez les champs, pas les impressions. Passez en revue ligne par ligne et comptez : combien de noms, d'e-mails, de titres et de compétences sont corrects ? Combien de candidats seraient introuvables parce que leurs compétences ont atterri dans le mauvais champ ? Un outil précis à 98 % sur dix CV propres et à 60 % sur ceux à deux colonnes échoue au seul test qui compte pour votre pipeline.
Calculez le coût réel. Multipliez le prix par document par votre volume annuel de CV, ajoutez les heures de configuration et comparez à un abonnement. Pour un lot de 200 CV, la différence entre 0,20 $ par page et un abonnement forfaitaire est une ligne que vous pouvez réellement voir.
Pour les flux de travail à volume élevé, voyez aussi comment le traitement par lots de CV dans une base de données de candidats gère les collisions de noms, les résultats fusionnés et la poignée de fichiers qui cassent n'importe quel outil — ces problèmes sont les mêmes, quelle que soit l'approche d'analyse que vous choisissez.
FAQ
Un logiciel d'analyse de CV peut-il gérer les mises en page PDF à deux colonnes ?
Généralement non, et c'est la plus grande lacune en matière de précision. Les analyseurs basés sur la position lisent de haut en bas dans un flux unique, de sorte qu'une mise en page à deux colonnes avec une barre latérale de compétences est brouillée — les compétences de la barre latérale se fondent dans le parcours professionnel, créant des employeurs fantômes et des champs mal placés. L'extraction sémantique par IA lit par le sens plutôt que par la position, elle gère donc correctement les mises en page à barre latérale et à deux colonnes dans la plupart des cas, bien que les conceptions très stylisées à base d'icônes puissent encore produire une confiance moindre sur certains champs.
L'extraction par IA est-elle aussi précise qu'un analyseur de CV dédié ?
Sur les CV standard à une colonne, les deux approches sont précises — les analyseurs annoncent plus de 95 % sur les mises en page pour lesquelles ils sont conçus, et les modèles de vision atteignent jusqu'à 99 % sur les données de tableaux imprimés. L'écart apparaît sur les mises en page créatives : la précision des analyseurs chute fortement sur les CV à plusieurs colonnes et les CV design, tandis que l'extraction sémantique continue de les lire correctement. Le bon test de précision n'est pas une affirmation du fournisseur — c'est vos propres CV les plus difficiles, testés avec les deux.
Ai-je besoin à la fois d'une API d'analyse et d'un outil d'extraction ?
Seulement si vous avez deux problèmes différents. Si vous développez un logiciel qui ingère des CV pour de nombreux clients, une API d'analyse vous fournit le schéma normalisé et la couverture linguistique dont ce produit a besoin. Si vous êtes une équipe de recrutement qui souhaite des données de candidats dans une feuille de calcul, l'extraction couvre ce besoin avec moins de configuration et sans frais par document. La plupart des équipes de recrutement internes ont besoin de la deuxième option, pas de la première.
Puis-je utiliser cela sans ATS ?
Oui — la feuille de calcul est le flux de travail. Extrayez les données des candidats dans Excel avec les colonnes que vous définissez, filtrez et triez dans la feuille de calcul, et suivez les étapes du pipeline avec une colonne de statut. Lorsque vous adoptez un ATS, la même feuille de calcul s'importe comme fichier CSV de candidats, donc rien de ce que vous avez construit n'est perdu.
Qu'en est-il des CV scannés ou photographiés ?
L'extraction sémantique les traite comme des entrées normales, car elle lit les pixels, pas les couches de texte — c'est pourquoi elle lit aussi les photos prises au téléphone de CV papier. De nombreuses fonctions d'importation en masse des ATS rejettent d'emblée les fichiers scannés ou basés sur des images (la documentation de Breezy HR est explicite à ce sujet). La qualité du scan reste importante : un scan net s'extrait proprement, tandis que des photos fortement floues ou inclinées produisent des champs de moindre confiance qui sont signalés pour examen plutôt que remplis silencieusement.
Puis-je importer les résultats dans Greenhouse, Workday ou Lever ?
Oui. L'importation en masse de Greenhouse accepte jusqu'à 8 000 lignes par téléchargement à partir d'une feuille de calcul, Bullhorn prend 1 000 enregistrements par lot en CSV, et les importations EIB de Workday acceptent les données de feuille de calcul avec une limite de 30 Mo. Comme le fichier extrait contient déjà une ligne par candidat avec une colonne d'e-mail vérifiée, il s'importe proprement — et vous contournez entièrement l'analyseur intégré de chaque plateforme.
Les API d'analyse ont été conçues pour les entreprises qui développent des logiciels de CV. Si vous êtes une équipe de recrutement, vous voulez les données des candidats dans une feuille de calcul — et le moyen le plus rapide de savoir quelle approche résiste aux mises en page réelles de vos candidats est de lui fournir vos propres CV.
Testez-le sur un vrai CV