Cómo Extraer Datos de Currículums a Excel
para Reclutamiento (Guía 2026)
La mayoría de los reclutadores no tienen un problema de parsing de currículums. Tienen un problema de hojas de cálculo. Después de que bolsas de trabajo, archivos adjuntos por correo y referencias internas llenen su bandeja de entrada con decenas de PDF, alguien tiene que convertir esos currículums en una hoja de seguimiento de candidatos — y la respuesta por defecto sigue siendo copiar y pegar manualmente. ¿Y si esa respuesta cuesta más que la propia contratación?
Puntos Clave
- 40 currículums toman de 2 a 4 horas de copiar y pegar manualmente—y un correo mal escrito pierde al candidato por completo.
- Los parsers de ATS leen los currículums por posición, así que un formato de dos columnas inserta las habilidades de tu barra lateral directamente en tu historial laboral.
- Define tus columnas una vez, sube cualquier formato de currículum y obtén una hoja de cálculo de candidatos filtrable sin tocar una API de parser.
La hoja de cálculo detrás de cada decisión de contratación
Cada proceso de reclutamiento, ya sea gestionado por un equipo de talento de una Fortune 500 o por una startup de cinco personas, converge finalmente en un único artefacto: una hoja de cálculo de candidatos. Nombres en la columna A. Cargos actuales en la columna B. Fuente — LinkedIn, referencias, bolsa de trabajo — en la columna C. Habilidades y años de experiencia repartidos entre las columnas D y H.
Para los empleadores pequeños y medianos que no pueden justificar un ATS (Sistema de Seguimiento de Candidatos) empresarial, esta hoja de cálculo es toda su infraestructura de reclutamiento. Es donde se clasifican los candidatos, donde se realiza el seguimiento de las fechas de contacto y donde se informa a los gerentes de contratación. El problema es que crearla — fila por fila, currículum por currículum — es el paso que más tiempo consume en todo el embudo de contratación. Los formularios de solicitud en papel y PDF se suman a la misma pila, y convertir un formulario de solicitud de empleo a Excel incorpora el nombre del solicitante, el historial laboral, la educación y las referencias a la hoja de cálculo de candidatos junto con los datos del currículum.
SHRM estima que el costo promedio por contratación es de aproximadamente $4,700, con un tiempo de cobertura de 33 días en todas las industrias (SHRM Benchmarking). No se trata solo de honorarios de publicidad y agencias. Una parte significativa corresponde a horas de reclutadores — horas dedicadas a tareas como copiar datos de currículums en hojas de cálculo de seguimiento, un paso que no aporta valor estratégico pero consume dólares reales de nómina.
La cuestión no es que las hojas de cálculo sean malas. Es que poblarlas manualmente a partir de documentos no estructurados es costoso de una manera que escala con el volumen — y la mayoría de los equipos de reclutamiento no tienen una alternativa clara.
Lo que realmente cuesta la entrada manual a un equipo de reclutamiento
Aquí está la aritmética que nadie hace hasta que un atraso lo obliga. Un reclutador que abre un pipeline de 40 candidatos dedica aproximadamente de 3 a 6 minutos por currículum a extraer campos clave en una hoja de seguimiento — nombre, correo electrónico, teléfono, cargo actual, empresa, años de experiencia, educación, habilidades principales y fuente. Con 40 candidatos, eso son de 2 a 4 horas de pura entrada de datos.
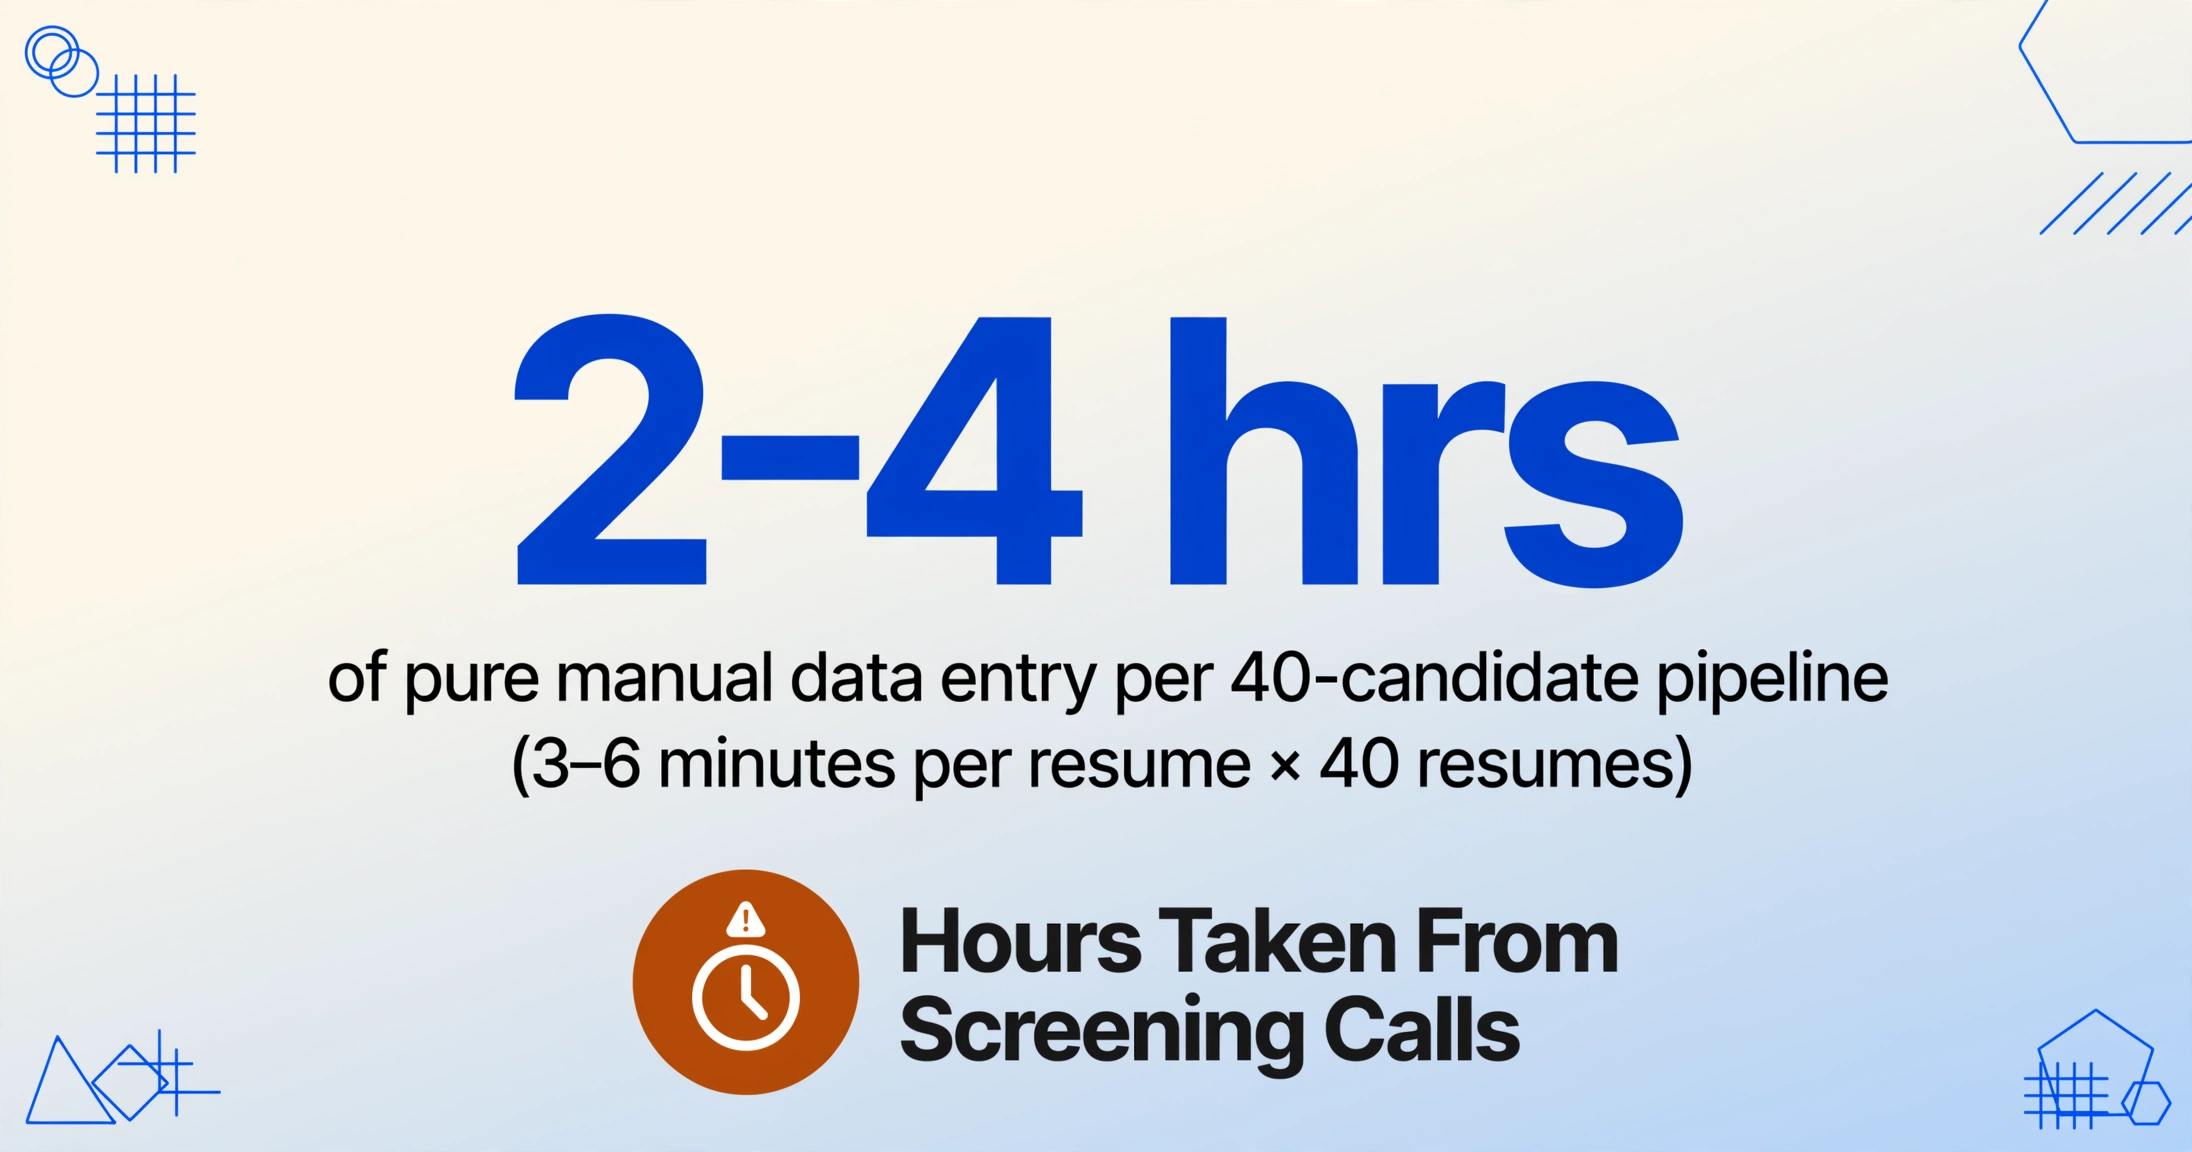
Pero no es solo tiempo. Es en qué debería haberse invertido ese tiempo: llamadas de selección, sincronizaciones con gerentes de contratación, búsqueda de candidatos pasivos. Esas son las actividades que realmente avanzan una contratación. La entrada de datos es un impuesto sobre todas ellas.
La tasa de error también importa. Una dirección de correo mal escrita significa que un candidato nunca recibe una invitación a entrevista. Un número de teléfono invertido hace perder el tiempo al gerente de contratación. Una habilidad que no se copió porque estaba en una barra lateral se pierde en el primer filtro. Cuando la hoja de cálculo se convierte en la única fuente de verdad para las decisiones de contratación, la calidad de esa hoja impacta directamente en la calidad de esas decisiones.
Para contexto: el estándar de la industria para el precio de las API de análisis de currículums oscila entre $0.05 y $0.30 por currículum a través de herramientas especializadas como Textkernel (Sovren), RChilli, Daxtra y Affinda. Puede sonar barato — hasta que pagas una tarifa por documento además de una suscripción ATS, y aún así dedicas tiempo a corregir errores del analizador en diseños de varias columnas.
El Registro del Candidato: Qué Extraer de un Currículum
Antes de extraer cualquier cosa, debes definir qué significa "registro del candidato" para tu proceso de contratación. El error más común de los equipos es extraerlo todo — copiar historiales laborales completos textualmente — cuando el trabajo de la hoja de cálculo es filtrar y comparar, no archivar.
Aquí está el conjunto básico de campos que vale la pena extraer para una hoja práctica de seguimiento de candidatos. (Si manejas docenas o cientos de currículos, consulta nuestra guía de procesamiento de currículos por lotes para gestionar el volumen, el caos de nombres de archivo y las estrategias de fusión).
| Campo | Por Qué Pertenece a la Hoja |
|---|---|
| Nombre del Candidato | Identificador principal. El único campo que no puedes permitirte equivocar. |
| Correo Electrónico | Canal de contacto. Si lo escribes mal, pierdes al candidato. |
| Teléfono | Llamadas de preselección y programación por SMS. El formato varía según el país. |
| Puesto Actual | La primera evaluación más rápida: ¿coincide el rol más reciente con la vacante? |
| Empresa Actual | Contexto de la industria. Un "Ingeniero de Software" en Google vs. una agencia de 10 personas significa cosas diferentes. |
| Años de Experiencia | Una columna inferida: la IA lee el historial laboral y calcula los años totales, incluso si el currículum solo enumera rangos de fechas. |
| Educación / Título | Título más alto + campo de estudio. Menos relevante en la contratación basada en habilidades, pero sigue siendo un filtro común. |
| Habilidades Principales | Habilidades técnicas y blandas. NACE informa que el 64.8% de los empleadores ahora usan prácticas de contratación basadas en habilidades, con dos tercios aplicándolas en la etapa de preselección (NACE Job Outlook 2025). Esta columna es el filtro más importante en el proceso moderno. |
| Período de Aviso | Crítico para la planificación del cronograma. "Disponible de inmediato" vs. "3 meses de aviso" cambia la lista corta. |
| Fuente | De dónde proviene el currículum: LinkedIn, referencia, bolsa de trabajo, agencia. Esencial para medir el ROI del canal. |
| Etapa del Proceso | Se actualiza manualmente después de la extracción: Aplicado, Preseleccionado, Entrevista, Oferta, Contratado. Convierte la hoja de cálculo en un ATS ligero. |
La decisión de diseño clave: extraes lo que necesitas comparar, no lo que podrías extraer. Cada columna que no te ayuda a filtrar o clasificar candidatos es una columna que añade tiempo de extracción y ruido visual.
Una columna que merece atención especial es Años de Experiencia. Rara vez aparece como un número único en un currículum — está incrustada en múltiples rangos de fechas en la sección del historial laboral. Con una columna calculada, la IA analiza cada período de empleo, calcula el total y genera un solo número. Defines la columna como "Años de Experiencia (suma de todos los períodos de empleo)" y la IA maneja la aritmética durante la extracción — sin post-procesamiento en Excel.
Cómo extraer datos de currículums a Excel, paso a paso
El principal desafío con la extracción de currículums no es la tecnología, sino la diversidad de formatos. Un currículum de un diseñador gráfico tiene barras laterales, iconos y diseños de dos columnas. Un CV de un académico llega a cuatro páginas. Un PDF exportado de LinkedIn tiene una estructura completamente diferente. Los analizadores basados en plantillas fallan aquí porque están entrenados con una expectativa de diseño fija. La extracción semántica — donde la IA lee por significado en lugar de por posición — es lo que hace que este flujo de trabajo funcione en todos los formatos.
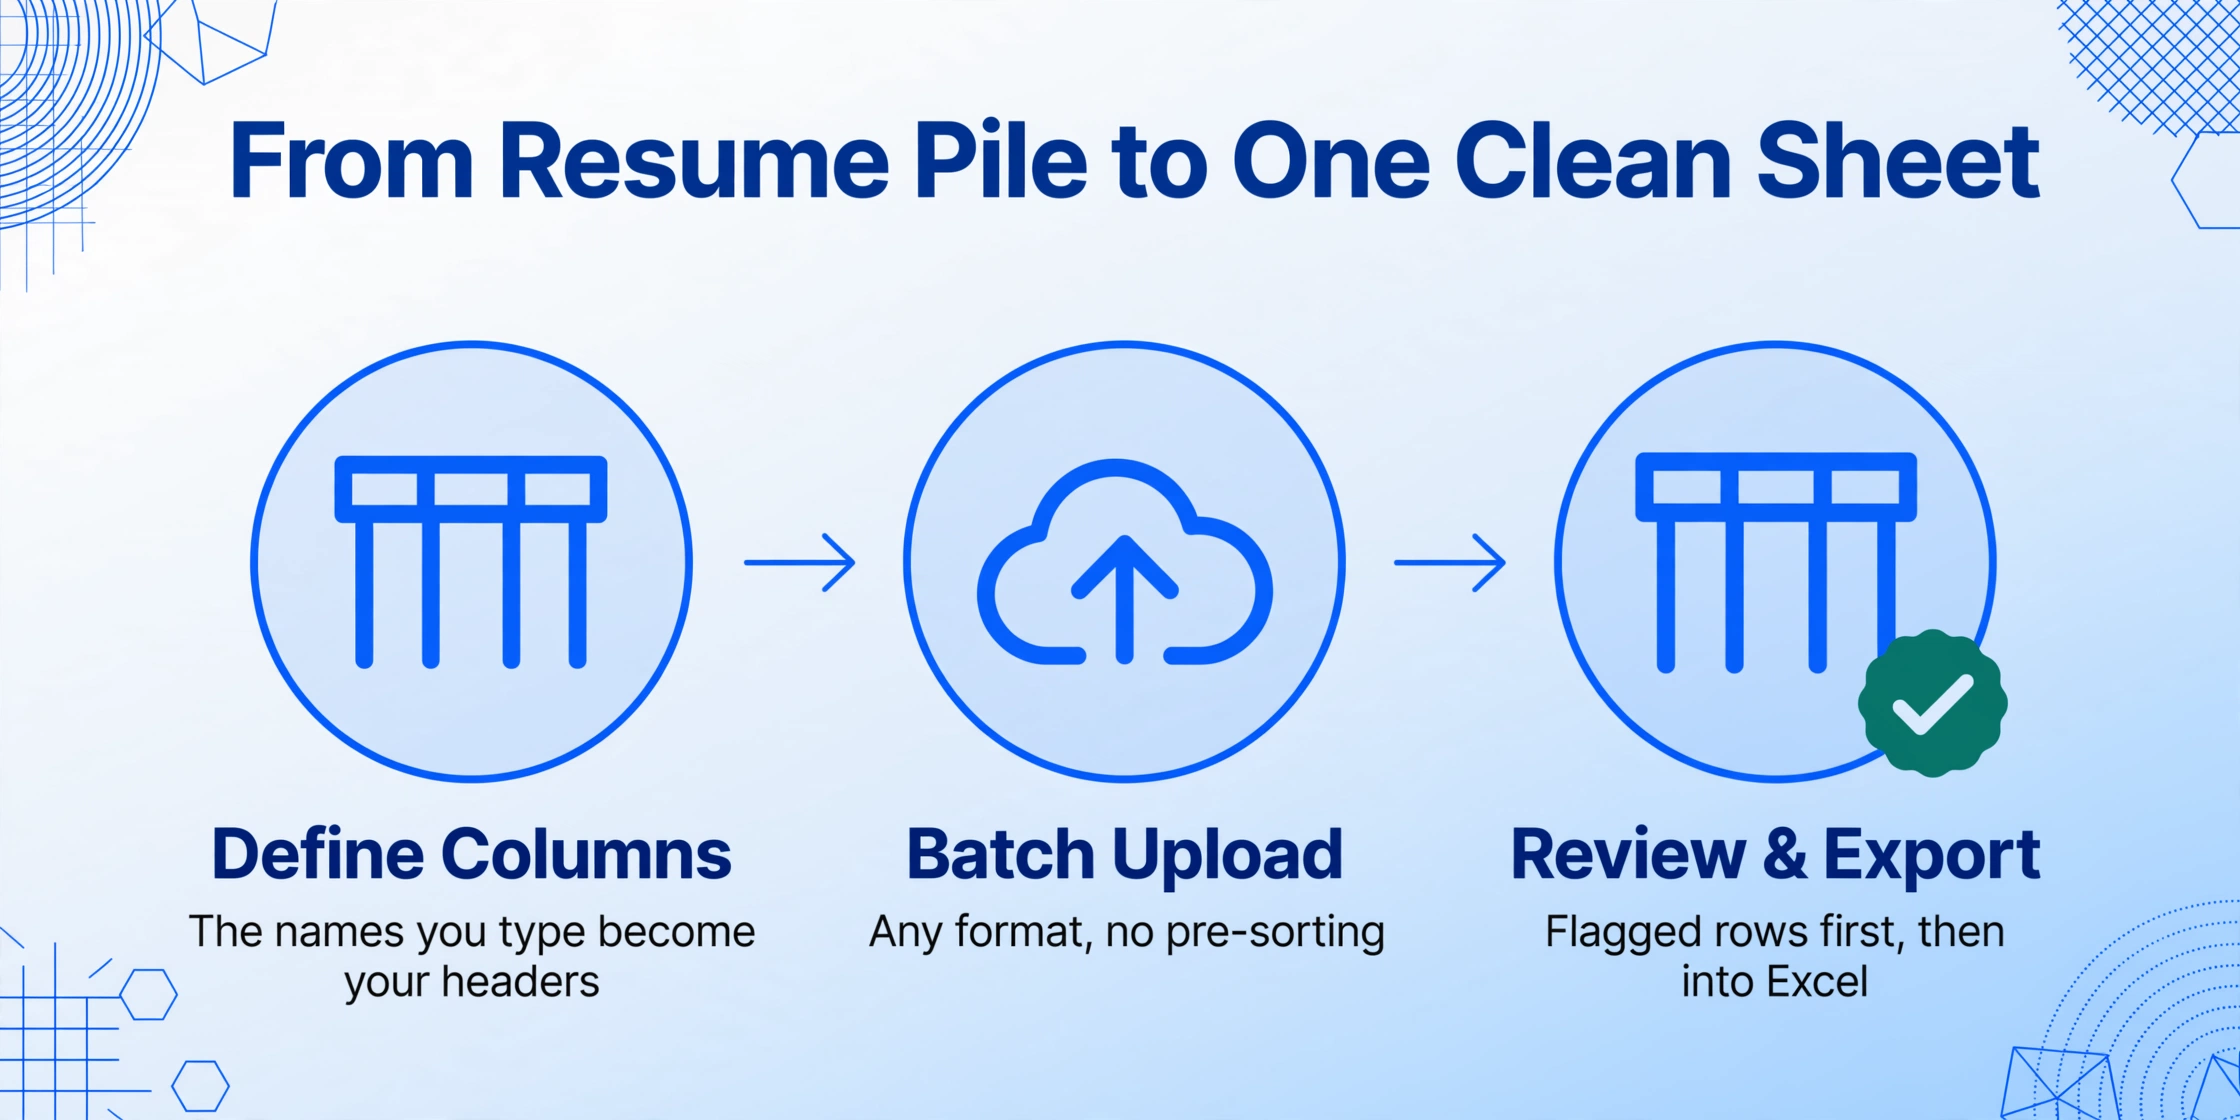
ImageToTable.ai utiliza Extracción de Columnas Personalizadas: escribes los nombres de los campos que deseas — "Nombre del Candidato", "Correo Electrónico", "Habilidades Principales", "Años de Experiencia" — y la IA localiza cada valor en cualquier parte de cada currículum al comprender qué significa el campo, no dónde se encuentra. Los nombres de las columnas que escribes se convierten en los encabezados de tu hoja de cálculo de salida.
Paso 1: Define tus columnas
Comienza con la lista de campos de la sección anterior y luego ajústala según los requisitos de tu puesto. Para una contratación técnica, añade lenguajes de programación y certificaciones. Para un puesto de ventas, añade cumplimiento de cuotas y territorio. Las columnas que definas determinan lo que podrás ordenar, filtrar y comparar en todo tu grupo de candidatos.
Paso 2: Carga todos los currículums por lotes
Coloca cada currículum — PDFs, documentos de Word, capturas de pantalla, exportaciones de LinkedIn — en el área de carga. No hay límite de formatos ni necesidad de preclasificar por diseño. La IA procesa cada documento de forma independiente y asigna los valores extraídos a tus columnas definidas.
Paso 3: Revisar y exportar a Excel
Una vez completado el procesamiento, obtienes una sola tabla con una fila por candidato y una columna por campo. Antes de exportar, pasa el cursor sobre cualquier celda extraída para ver exactamente de dónde proviene ese valor en el currículum original: un cuadro delimitador resaltado en el documento fuente te da confirmación visual en segundos. Luego exporta a Excel (XLSX) y queda listo para filtrar, ordenar y compartir con el equipo de contratación.
Los archivos se procesan de forma segura y no se almacenan.
Cuando los analizadores leen mal el currículum: diseños que rompen las herramientas posicionales
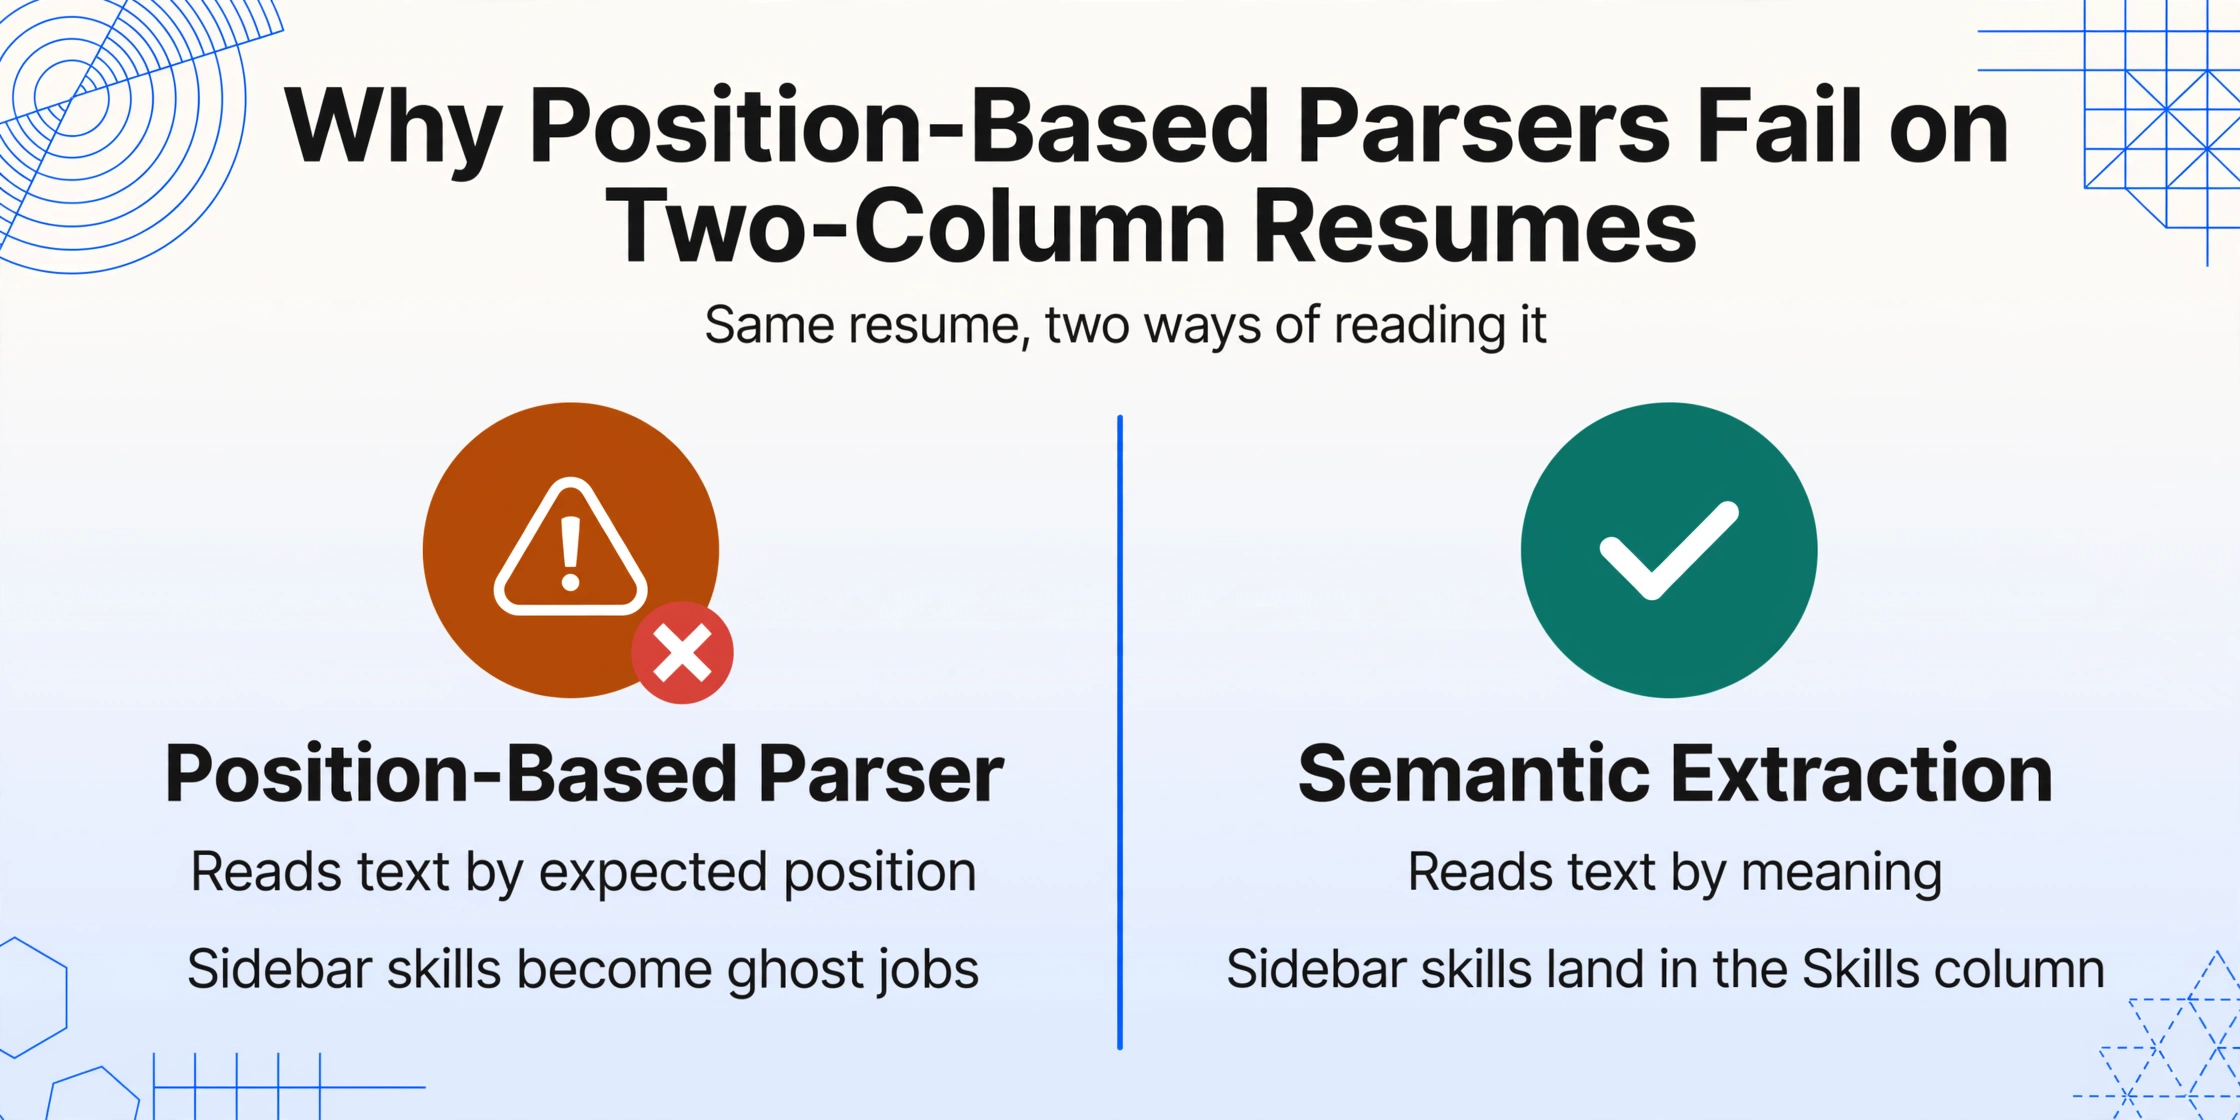
Los analizadores de currículums basados en posición — el tipo integrado en la mayoría de las plataformas ATS — funcionan buscando texto en ubicaciones esperadas. Una sección de contacto arriba. El historial laboral en el medio. La educación abajo. Cuando un currículum sigue esa plantilla, el analizador funciona. Cuando no la sigue, el resultado va de sutilmente incorrecto a cómicamente inutilizable.
En el subreddit r/recruiting, un reclutador describió lo que ocurre cuando un sistema con tecnología Phenom encuentra un currículum de dos columnas: "El perfil del CRM me decía que era barista en una planta de GM" — la sección de habilidades de la barra lateral se fusionó con el historial laboral principal, produciendo una narrativa profesional sin sentido (r/recruiting). Otro informó que ingresar información de autorización de seguridad en el formulario de solicitud de Workday hacía que "tu nombre apareciera como nombre de pila autorización" — el delimitador de campo fallaba con entradas inesperadas.
"Greenhouse funciona igual que todos los demás", concluyó el mismo hilo. "ATS significa Applicant Tracking System. Nada sofisticado al respecto." Los analizadores integrados no están rotos — simplemente son posicionales en un mundo de documentos no posicionales.
Modos de fallo comunes en los analizadores basados en posición:
- Diseños de dos columnas: El contenido de la barra lateral (habilidades, idiomas, certificaciones) se lee como historial laboral en línea, creando empleos fantasma y empleadores inexistentes.
- Formato creativo: Los currículums de diseñadores gráficos con encabezados de sección basados en iconos, barras de calificación de habilidades y visualizaciones de líneas de tiempo producen cadenas de texto confusas.
- Contenido de encabezados y pies de página: Las URL de LinkedIn, enlaces de portafolio y números de página colocados en encabezados se fusionan con el bloque de texto más cercano.
- Documentos de varias páginas: Los CV académicos que abarcan 4 o más páginas a menudo tienen saltos de sección que restablecen las suposiciones posicionales del analizador a mitad del documento.
La extracción semántica evita estos fallos al no depender de la posición en absoluto. La IA lee el documento como lo haría una persona: entiende que "Educación" es una sección, no una coordenada, y que las habilidades enumeradas en una barra lateral son categóricamente diferentes del historial laboral del cuerpo principal. Esto no significa una precisión del 100% en cada diseño creativo — las notas manuscritas en los márgenes o la tipografía muy estilizada aún presentan desafíos — pero elimina el modo de fallo estructural que hace que los analizadores basados en posición sean poco fiables en diversos formatos de currículum. Para una comparación detallada entre las API de análisis y la extracción semántica con IA — incluidos los precios por documento, el esfuerzo de configuración y qué enfoque se adapta a tu equipo — lee nuestra comparación de análisis de currículums vs extracción con IA.
Convirtiendo la Hoja de Cálculo en un Canal de Candidatos
Una vez que los datos extraídos están en Excel, la hoja de cálculo deja de ser un volcado de datos y se convierte en una herramienta ligera de reclutamiento. (Si prefieres una página de herramienta dedicada con demostración, prueba nuestra herramienta de extracción de datos de currículums a Excel). Así es como los mejores equipos la operan:
Añade una columna de estado. "Aplicado", "Evaluado", "Primera entrevista", "Segunda entrevista", "Oferta", "Contratado" — actualízala manualmente a medida que los candidatos avanzan por las etapas. Ordena por estado para ver todo tu canal de un vistazo.
Registra la atribución de fuentes. La columna "Fuente" te permite calcular qué canales producen los mejores candidatos. Las contrataciones por referencias superan consistentemente a las de bolsas de trabajo en retención — pero no puedes demostrarlo sin rastrear de dónde proviene cada currículum.
Usa los filtros nativos de Excel. Filtra por "Habilidades principales" que contengan "Python" y "Años de experiencia" > 3. Filtra por "Período de aviso" que contenga "inmediato" para preseleccionar candidatos que puedan comenzar rápido. Estas son exactamente las operaciones por las que un ATS dedicado cobra — ejecutándose nativamente dentro de una hoja de cálculo.
Recopila currículums de múltiples fuentes. Si los gerentes de contratación, reclutadores externos o referencias de empleados te envían currículums por correo electrónico, usa un Enlace de Recopilación (una página de carga compartible que alimenta directamente tu cola de procesamiento) o Bandeja de entrada de correo (reenvía los currículums y llegan a la cola automáticamente). Nadie más necesita una cuenta — solo envían archivos.
Importa a tu ATS. Greenhouse, Lever, Workday, iCIMS, BambooHR y la mayoría de las otras plataformas admiten importaciones CSV de datos de candidatos. Extrae a Excel primero, limpia y normaliza los datos una vez, luego importa — más rápido y confiable que depender del analizador de currículums integrado de cada plataforma.
Gestión responsable de los datos de candidatos: EEOC, GDPR y retención
Cuando extraes datos de candidatos a una hoja de cálculo, estás creando una base de datos de información personal sujeta a normativas de empleo y privacidad. Esto no es una preocupación secundaria de RR. HH. — es una parte central del flujo de trabajo.
En Estados Unidos, las herramientas automatizadas o basadas en IA para la selección de currículums se consideran "procedimientos de selección" según el Título VII de la Ley de Derechos Civiles de 1964. Las Pautas Uniformes sobre Procedimientos de Selección de Empleados (UGESP) de la EEOC aplican la regla de cuatro quintos: si la tasa de selección de cualquier grupo protegido es inferior al 80% de la tasa del grupo más alto, eso constituye un hallazgo preliminar de impacto adverso (EEOC Título VII). Para los equipos de reclutamiento que usan datos extraídos para filtrar candidatos, la conclusión práctica es: documenta tus criterios de filtrado. Si filtras por "Años de experiencia > 3" o "Titulación = Licenciatura", prepárate para demostrar que ese criterio está relacionado con el puesto y es coherente con la necesidad del negocio.
Para los equipos que reclutan en la UE o el Reino Unido, el Artículo 22 del GDPR restringe las decisiones basadas únicamente en el procesamiento automatizado, y el Artículo 35 exige una Evaluación de Impacto de Protección de Datos (DPIA) para el procesamiento de datos personales de alto riesgo — algo que la selección sistemática de candidatos cumple. La ICO del Reino Unido y las autoridades de protección de datos de la UE generalmente recomiendan retener los datos de candidatos no seleccionados durante no más de 6 a 12 meses después de que concluya el proceso de reclutamiento, salvo que el candidato dé su consentimiento explícito para una retención más prolongada.
En el aspecto operativo: la minimización de datos significa extraer solo los campos que necesitas para la decisión de contratación — no cada línea de cada historial laboral. El Modo de Revisión con verificación visual de cuadros delimitadores te permite confirmar qué se extrajo y de dónde, creando un rastro auditable. Y cuando un candidato solicita la eliminación, estás eliminando filas de una hoja de cálculo, no desenredando registros de una base de datos ATS compleja.
El registro del candidato a menudo debe contener resultados de selección, no solo campos del currículum — un flujo de trabajo de verificación de antecedentes a Excel archiva resultados penales, de referencias y de MVR bajo las reglas de retención anteriores.
La ventaja de cumplimiento de un flujo de trabajo basado en hojas de cálculo es la simplicidad. Los datos viven en un solo lugar. La eliminación es una operación de fila. La lógica de filtrado es explícita (fórmulas de Excel, no puntuación de IA de caja negra). Para equipos pequeños y medianos que operan bajo las obligaciones de la EEOC y el GDPR, esta transparencia vale más que el conjunto de funciones de un ATS empresarial.
Preguntas frecuentes
¿Puede leer currículums escritos a mano?
Parcialmente. La escritura clara y legible — como un formulario impreso con campos manuscritos — se extrae bien. La escritura cursiva densa en papel sin estructura produce resultados de menor confianza. Para currículums mixtos impresos/manuscritos, la IA extrae todo el texto impreso de forma fiable y marca las regiones de baja confianza. Los currículums solo manuscritos deben tratarse como que requieren revisión manual adicional.
¿Qué precisión tiene en diseños de currículum de dos columnas?
Significativamente mejor que los analizadores basados en posición porque la IA lee por significado semántico, no por posición en el diseño. Una barra lateral de habilidades a la izquierda se entiende como una sección de "Habilidades" independientemente de dónde esté en la página. Dicho esto, los currículums de diseñadores gráficos muy estilizados con marcadores de sección basados en iconos pueden seguir produciendo menor confianza en ciertos campos — la IA es buena leyendo texto en contexto, no decodificando metáforas visuales.
¿Cuántos currículums puedo procesar a la vez?
Las cargas por lotes manejan docenas de currículums en una sola sesión. Todos los archivos se procesan en paralelo y se fusionan en una única tabla de salida unificada — una fila por candidato, sin necesidad de configuración por documento.
¿Puedo importar los resultados a Greenhouse o Workday?
Sí. La mayoría de las plataformas ATS — Greenhouse, Lever, Workday, iCIMS, BambooHR y Bullhorn, entre otras — admiten importaciones de candidatos en CSV. Extraiga a Excel, limpie y valide los datos una vez, y luego importe un archivo limpio. Este flujo de trabajo suele ser más rápido y fiable que depender del analizador de currículums integrado de cada plataforma, especialmente para candidatos obtenidos fuera del ATS.
¿Qué ocurre con los datos del currículum después de la extracción?
Los archivos se procesan y luego se eliminan automáticamente del servidor tras un período de retención configurable. No se conservan datos de entrenamiento de las cargas de los clientes. Para candidatos que soliciten la eliminación según el GDPR o normativas similares, los datos de la hoja de cálculo extraída viven en un archivo que usted controla — no en la base de datos de un proveedor.
¿En qué se diferencia de una API de analizador de currículums?
Las API de analizador de currículums (Textkernel, RChilli, Affinda, Daxtra) están diseñadas específicamente para currículums y a menudo producen JSON estructurado que requiere código de integración para obtener un formato utilizable. Cobran por documento ($0.05–$0.30 por análisis). La extracción con IA adopta un enfoque más amplio: lee cualquier tipo de documento por el significado de los campos, no por un esquema de currículum preentrenado, y genera directamente una hoja de cálculo. No requiere integración de API: obtienes un archivo de Excel. Para equipos que manejan más que solo currículums (cartas de oferta, formularios de incorporación, contratos laborales), un flujo de extracción cubre todos los tipos de documentos.