Lebenslaufdaten für die Personalbeschaffung nach Excel extrahieren
(Leitfaden 2026)
Die meisten Recruiter haben kein Problem mit dem Parsen von Lebensläufen. Sie haben ein Tabellenproblem. Nachdem Jobbörsen, E-Mail-Anhänge und interne Empfehlungen Dutzende PDFs in ihr Postfach spülen, muss jemand diese Lebensläufe in eine Kandidaten-Tracking-Tabelle verwandeln – und die Standardlösung ist immer noch manuelles Kopieren und Einfügen. Was, wenn diese Lösung mehr kostet als die Einstellung selbst?
Wichtigste Erkenntnisse
- 40 Lebensläufe erfordern 2 bis 4 Stunden manuelles Kopieren und Einfügen – und eine falsch getippte E-Mail-Adresse verliert den Kandidaten vollständig.
- ATS-Parser lesen Lebensläufe nach Position, daher zerlegt ein zweispaltiges Layout Ihre Seitenleisten-Fähigkeiten direkt in Ihren Beschäftigungsverlauf.
- Definieren Sie Ihre Spalten einmal, fügen Sie jedes Lebenslaufformat ein und erhalten Sie eine filterbare Kandidaten-Tabelle, ohne eine Parser-API anzufassen.
Die Tabelle hinter jeder Einstellungsentscheidung
Jeder Recruiting-Prozess – ob von einem Talentteam eines Fortune-500-Unternehmens oder einem Start-up mit fünf Mitarbeitern – läuft letztlich auf ein einziges Artefakt hinaus: eine Kandidaten-Tabelle. Namen in Spalte A. Aktuelle Positionen in Spalte B. Quelle – LinkedIn, Empfehlung, Jobbörse – in Spalte C. Qualifikationen und Berufserfahrung verteilt über die Spalten D bis H.
Für kleine und mittlere Arbeitgeber, die sich kein Enterprise-ATS (Applicant Tracking System) leisten können, ist diese Tabelle ihre gesamte Recruiting-Infrastruktur. Hier werden Kandidaten eingestuft, Nachfasstermine verfolgt und Hiring Manager eingewiesen. Das Problem: Der Aufbau dieser Tabelle – Zeile für Zeile, Lebenslauf für Lebenslauf – ist der mit Abstand zeitaufwendigste Schritt im gesamten Einstellungstrichter. Papier- und PDF-Bewerbungsformulare landen im selben Stapel, und die Umwandlung eines Bewerbungsformulars in Excel übernimmt Bewerbername, Berufshistorie, Ausbildung und Referenzen in die Kandidaten-Tabelle – zusammen mit den Lebenslaufdaten.
SHRM schätzt die durchschnittlichen Kosten pro Einstellung auf etwa 4.700 $, mit einer Time-to-Fill von 33 Tagen über alle Branchen hinweg (SHRM Benchmarking). Das sind nicht nur Werbe- und Agenturkosten. Ein erheblicher Teil davon sind Stunden von Recruitern – Stunden für Aufgaben wie das Übertragen von Lebenslaufdaten in Tracking-Tabellen, ein Schritt, der keinen strategischen Mehrwert bringt, aber echtes Gehalt kostet.
Der Punkt ist nicht, dass Tabellen schlecht sind. Sondern dass das manuelle Befüllen aus unstrukturierten Dokumenten teuer ist – und zwar in einer Weise, die mit der Menge skaliert. Die meisten Recruiting-Teams haben keine klare Alternative.
Was manuelle Eingabe ein Recruiting-Team tatsächlich kostet
Hier ist die Rechnung, die niemand aufmacht, bis ein Rückstau es erzwingt. Ein Recruiter, der eine Pipeline mit 40 Kandidaten bearbeitet, braucht etwa 3 bis 6 Minuten pro Lebenslauf, um die wichtigsten Felder in eine Tracking-Tabelle zu übertragen – Name, E-Mail, Telefon, aktuelle Position, Unternehmen, Berufserfahrung, Ausbildung, wichtigste Qualifikationen und Quelle. Bei 40 Kandidaten sind das 2 bis 4 Stunden reine Dateneingabe.
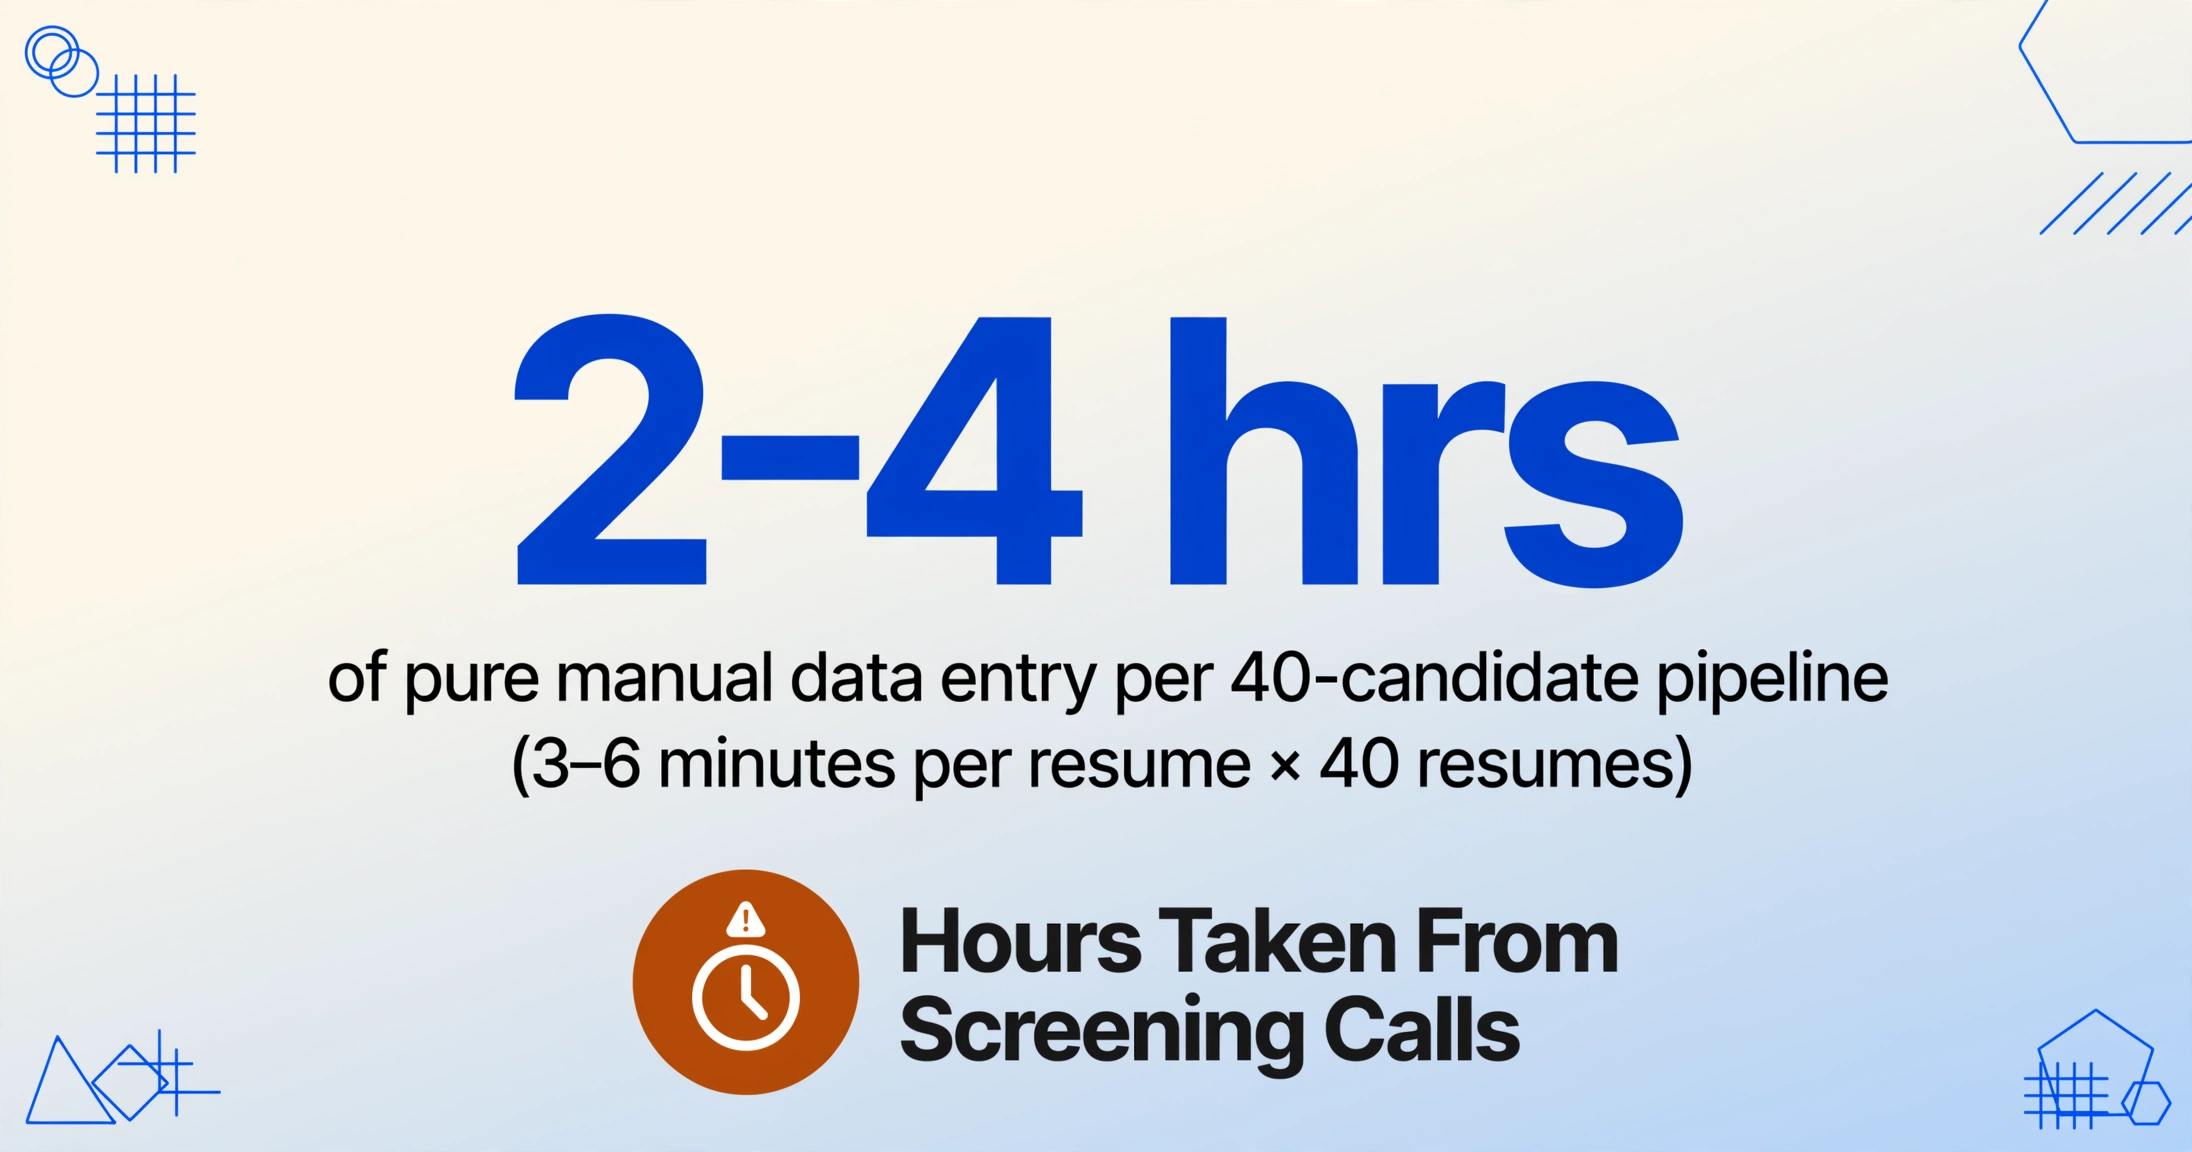
Aber es geht nicht nur um Zeit. Es geht darum, wofür diese Zeit hätte genutzt werden sollen: Screening-Gespräche, Syncs mit Hiring Managern, die Ansprache passiver Kandidaten. Das sind die Aktivitäten, die eine Einstellung tatsächlich voranbringen. Dateneingabe ist eine Steuer auf all diese Tätigkeiten.
Auch die Fehlerquote zählt. Eine falsch getippte E-Mail-Adresse bedeutet, dass ein Kandidat nie eine Einladung zum Vorstellungsgespräch erhält. Eine vertauschte Telefonnummer verschwendet die Zeit des Hiring Managers. Eine Qualifikation, die nicht übernommen wurde, weil sie in einer Seitenleiste stand, wird im Erstrunden-Filter übersehen. Wenn die Tabelle zur einzigen Wahrheitsquelle für Einstellungsentscheidungen wird, wirkt sich die Qualität dieser Tabelle direkt auf die Qualität dieser Entscheidungen aus.
Zur Einordnung: Die branchenüblichen Preise für Resume-Parsing-APIs liegen zwischen 0,05 $ und 0,30 $ pro Lebenslauf bei spezialisierten Tools wie Textkernel (Sovren), RChilli, Daxtra und Affinda. Das klingt vielleicht günstig – bis man zusätzlich zum ATS-Abonnement eine Gebühr pro Dokument zahlt und immer noch Zeit damit verbringt, Parsing-Fehler bei mehrspaltigen Layouts zu beheben.
Der Kandidatendatensatz: Was aus einem Lebenslauf extrahiert werden sollte
Bevor Sie etwas extrahieren, müssen Sie definieren, was „ein Kandidatendatensatz" für Ihren Einstellungsprozess tatsächlich bedeutet. Der Fehler, den die meisten Teams machen, ist, alles zu extrahieren – ganze Beschäftigungsverläufe wörtlich zu kopieren –, wenn die Aufgabe der Tabelle darin besteht, zu filtern und zu vergleichen, nicht zu archivieren.
Hier ist der Kern an Feldern, die es wert sind, für ein praktisches Kandidaten-Tracking-Blatt extrahiert zu werden. (Wenn Sie mit Dutzenden oder Hunderten von Lebensläufen zu tun haben, lesen Sie unseren Leitfaden zur Batch-Lebenslaufverarbeitung für den Umgang mit Volumen, Dateinamen-Chaos und Merge-Strategien.)
| Feld | Warum es in die Tabelle gehört |
|---|---|
| Name des Kandidaten | Primärer Identifikator. Das eine Feld, das Sie sich nicht leisten können, falsch zu haben. |
| Kommunikationskanal. Tippfehler und Sie haben den Kandidaten verloren. | |
| Telefon | Screeningsgespräche und SMS-Terminplanung. Format variiert je nach Land. |
| Aktuelle Position | Der schnellste erste Screen: Passt die letzte Rolle zur offenen Stelle? |
| Aktuelles Unternehmen | Branchenkontext. Ein „Software Engineer" bei Google vs. bei einer 10-Personen-Agentur bedeutet unterschiedliche Dinge. |
| Jahre Erfahrung | Eine abgeleitete Spalte: Die KI liest den Berufsverlauf und berechnet die Gesamtjahre, auch wenn der Lebenslauf nur Datumsbereiche auflistet. |
| Bildung / Abschluss | Höchster Abschluss + Fachrichtung. Weniger relevant bei kompetenzbasiertem Hiring, aber immer noch ein häufiger Filter. |
| Top-Fähigkeiten | Technische und soziale Fähigkeiten. NACE berichtet, dass 64,8 % der Arbeitgeber jetzt kompetenzbasierte Einstellungspraktiken anwenden, wobei zwei Drittel sie in der Screening-Phase einsetzen (NACE Job Outlook 2025). Diese Spalte ist der wichtigste Filter in der modernen Pipeline. |
| Kündigungsfrist | Entscheidend für die Zeitplanung. „Sofort verfügbar" vs. „3 Monate Kündigungsfrist" ändert die Shortlist. |
| Quelle | Woher der Lebenslauf kam: LinkedIn, Empfehlung, Jobbörse, Agentur. Unerlässlich zur Messung des Kanal-ROI. |
| Pipeline-Phase | Manuell nach der Extraktion aktualisiert: Beworben, Gescreent, Interview, Angebot, Eingestellt. Verwandelt die Tabelle in ein leichtgewichtiges ATS. |
Die wichtigste Designentscheidung: Sie extrahieren, was Sie vergleichen müssen, nicht was Sie extrahieren könnten. Jede Spalte, die Ihnen nicht hilft, Kandidaten zu filtern oder zu bewerten, ist eine Spalte, die Extraktionszeit und visuelles Rauschen hinzufügt.
Eine Spalte, die besondere Aufmerksamkeit verdient, ist Jahre Erfahrung. Sie wird selten als einzelne Zahl auf einem Lebenslauf aufgeführt – sie ist über mehrere Datumsbereiche im Berufsverlaufsabschnitt verteilt. Mit einer berechneten Spalte parst die KI jeden Beschäftigungszeitraum, berechnet die Summe und gibt eine einzelne Zahl aus. Sie definieren die Spalte als „Jahre Erfahrung (Summe aller Beschäftigungszeiträume)" und die KI übernimmt die Arithmetik während der Extraktion – keine Nachbearbeitung in Excel erforderlich.
So extrahieren Sie Lebenslaufdaten Schritt für Schritt in Excel
Die zentrale Herausforderung bei der Lebenslauf-Extraktion ist nicht die Technologie – sondern die Vielfalt der Layouts. Ein Lebenslauf eines Grafikdesigners hat Seitenleisten, Symbole und zweispaltige Layouts. Ein CV aus dem akademischen Bereich umfasst vier Seiten. Ein als PDF exportierter LinkedIn-Lebenslauf hat eine völlig andere Struktur. Template-basierte Parser scheitern daran, weil sie auf eine feste Layout-Erwartung trainiert sind. Semantische Extraktion – bei der die KI nach Bedeutung statt nach Position liest – ist das, was diesen Workflow über alle Formate hinweg funktionieren lässt.
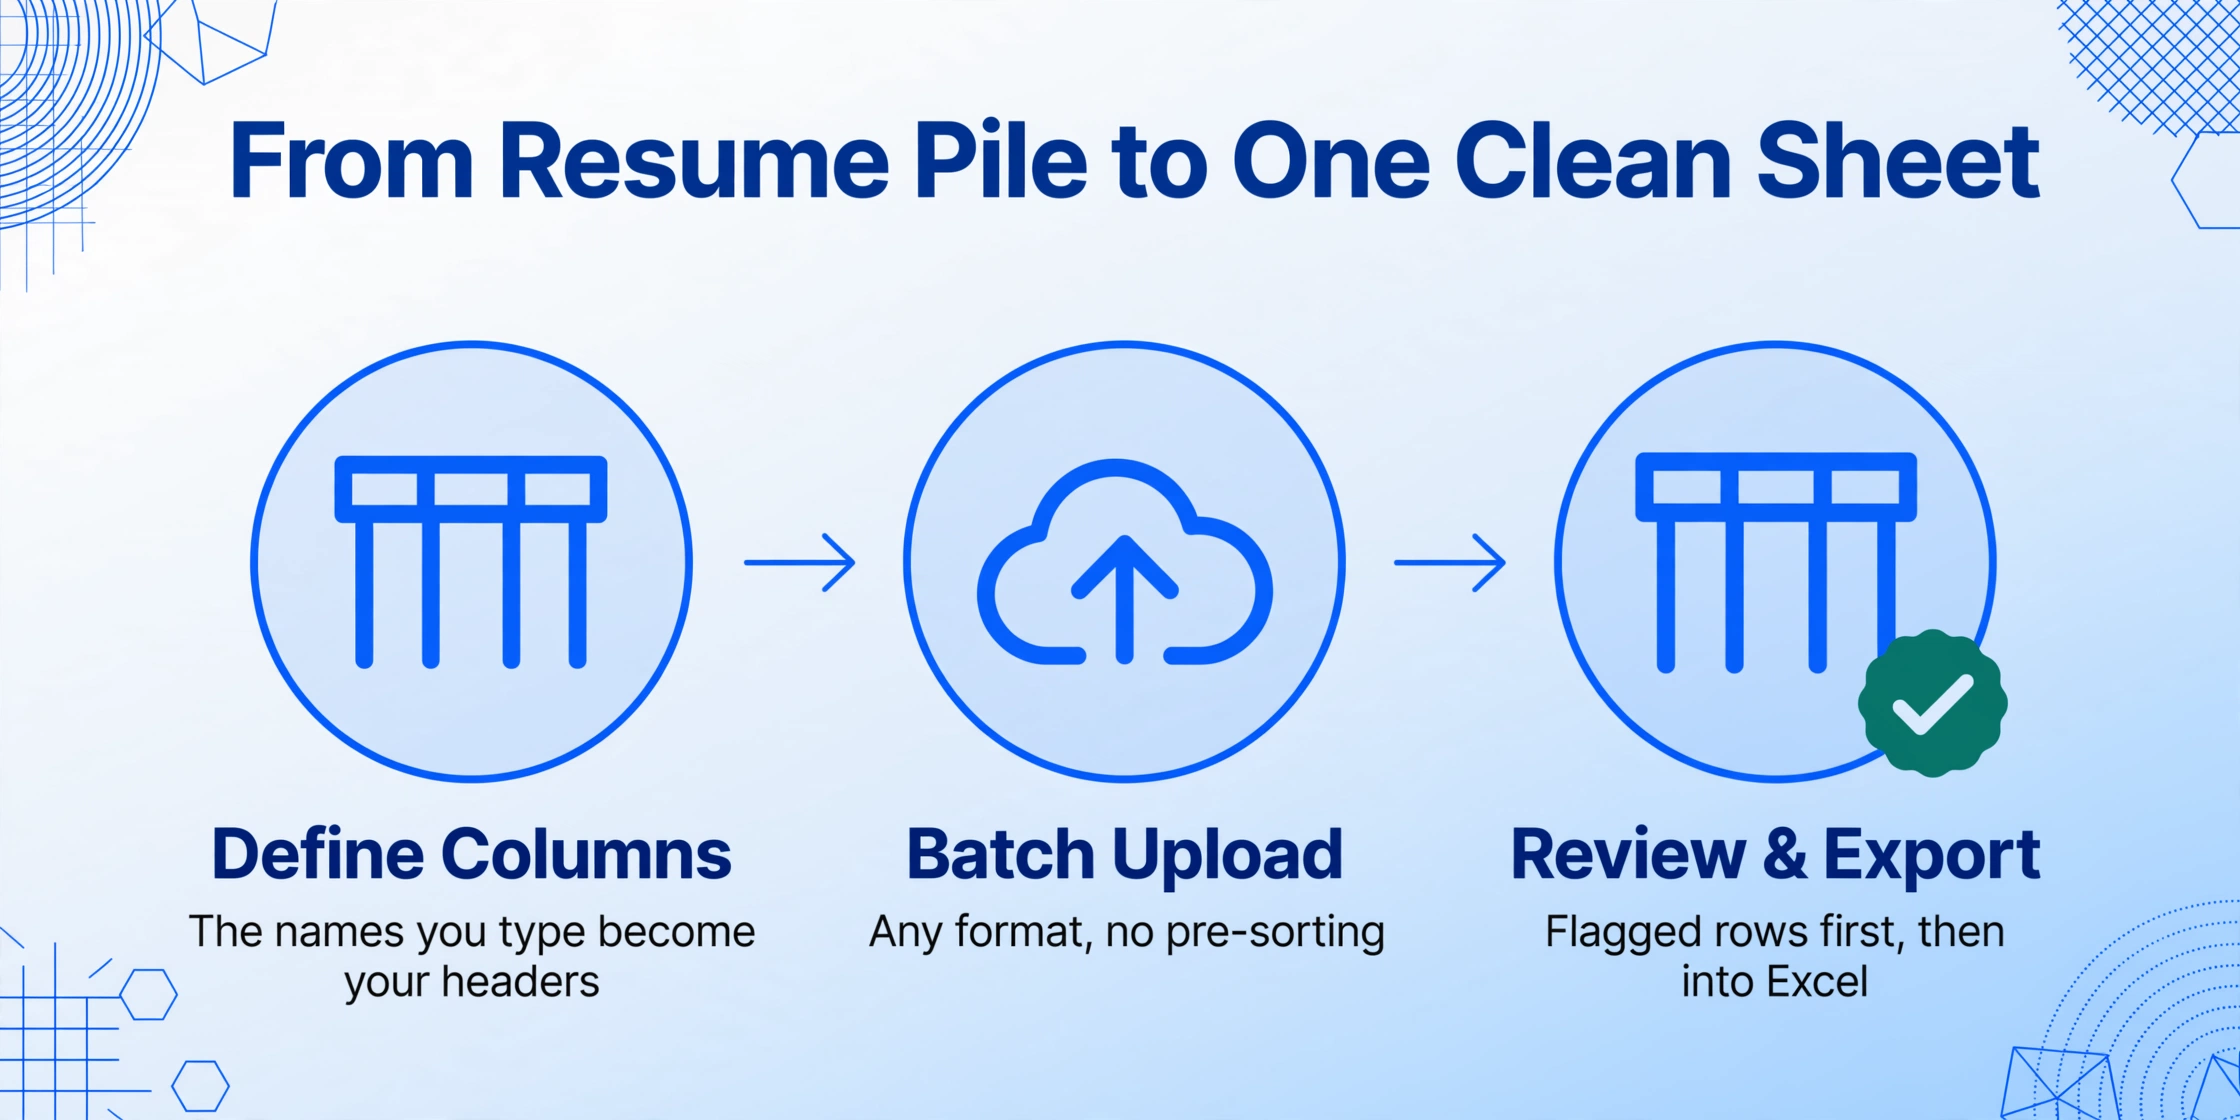
ImageToTable.ai verwendet die Benutzerdefinierte Spaltenextraktion: Sie geben die gewünschten Feldnamen ein – „Kandidatenname", „E-Mail", „Top-Qualifikationen", „Berufserfahrung in Jahren" – und die KI lokalisiert jeden Wert überall in jedem Lebenslauf, indem sie versteht, was das Feld bedeutet, nicht wo es steht. Die von Ihnen eingegebenen Spaltennamen werden zu den Kopfzeilen Ihrer Ausgabetabelle.
Schritt 1: Definieren Sie Ihre Spalten
Beginnen Sie mit der Feldliste aus dem obigen Abschnitt und passen Sie sie dann an die Anforderungen Ihrer Rolle an. Für eine technische Einstellung fügen Sie Programmiersprachen und Zertifizierungen hinzu. Für eine Vertriebsrolle fügen Sie Quotenerfüllung und Territorium hinzu. Die von Ihnen definierten Spalten bestimmen, was Sie über Ihren gesamten Kandidatenpool hinweg sortieren, filtern und vergleichen können.
Schritt 2: Laden Sie alle Lebensläufe im Stapel hoch
Legen Sie jeden Lebenslauf – PDFs, Word-Dokumente, Screenshots, LinkedIn-Exporte – in den Upload-Bereich. Es gibt kein Limit für Formate und keine Notwendigkeit, nach Layout vorzusortieren. Die KI verarbeitet jedes Dokument unabhängig und ordnet extrahierte Werte Ihren definierten Spalten zu.
Schritt 3: Prüfen und nach Excel exportieren
Nach Abschluss der Verarbeitung erhalten Sie eine einzige Tabelle mit einer Zeile pro Kandidat und einer Spalte pro Feld. Bevor Sie exportieren, fahren Sie mit der Maus über jede extrahierte Zelle, um genau zu sehen, woher dieser Wert im ursprünglichen Lebenslauf stammt – ein hervorgehobenes Begrenzungsfeld im Quelldokument gibt Ihnen in Sekunden eine visuelle Bestätigung. Anschließend exportieren Sie nach Excel (XLSX), und die Daten sind bereit zum Filtern, Sortieren und Teilen mit dem Einstellungsteam.
Dateien werden sicher verarbeitet und nicht gespeichert.
Wenn Parser den Lebenslauf falsch lesen: Layouts, die positionale Tools überfordern
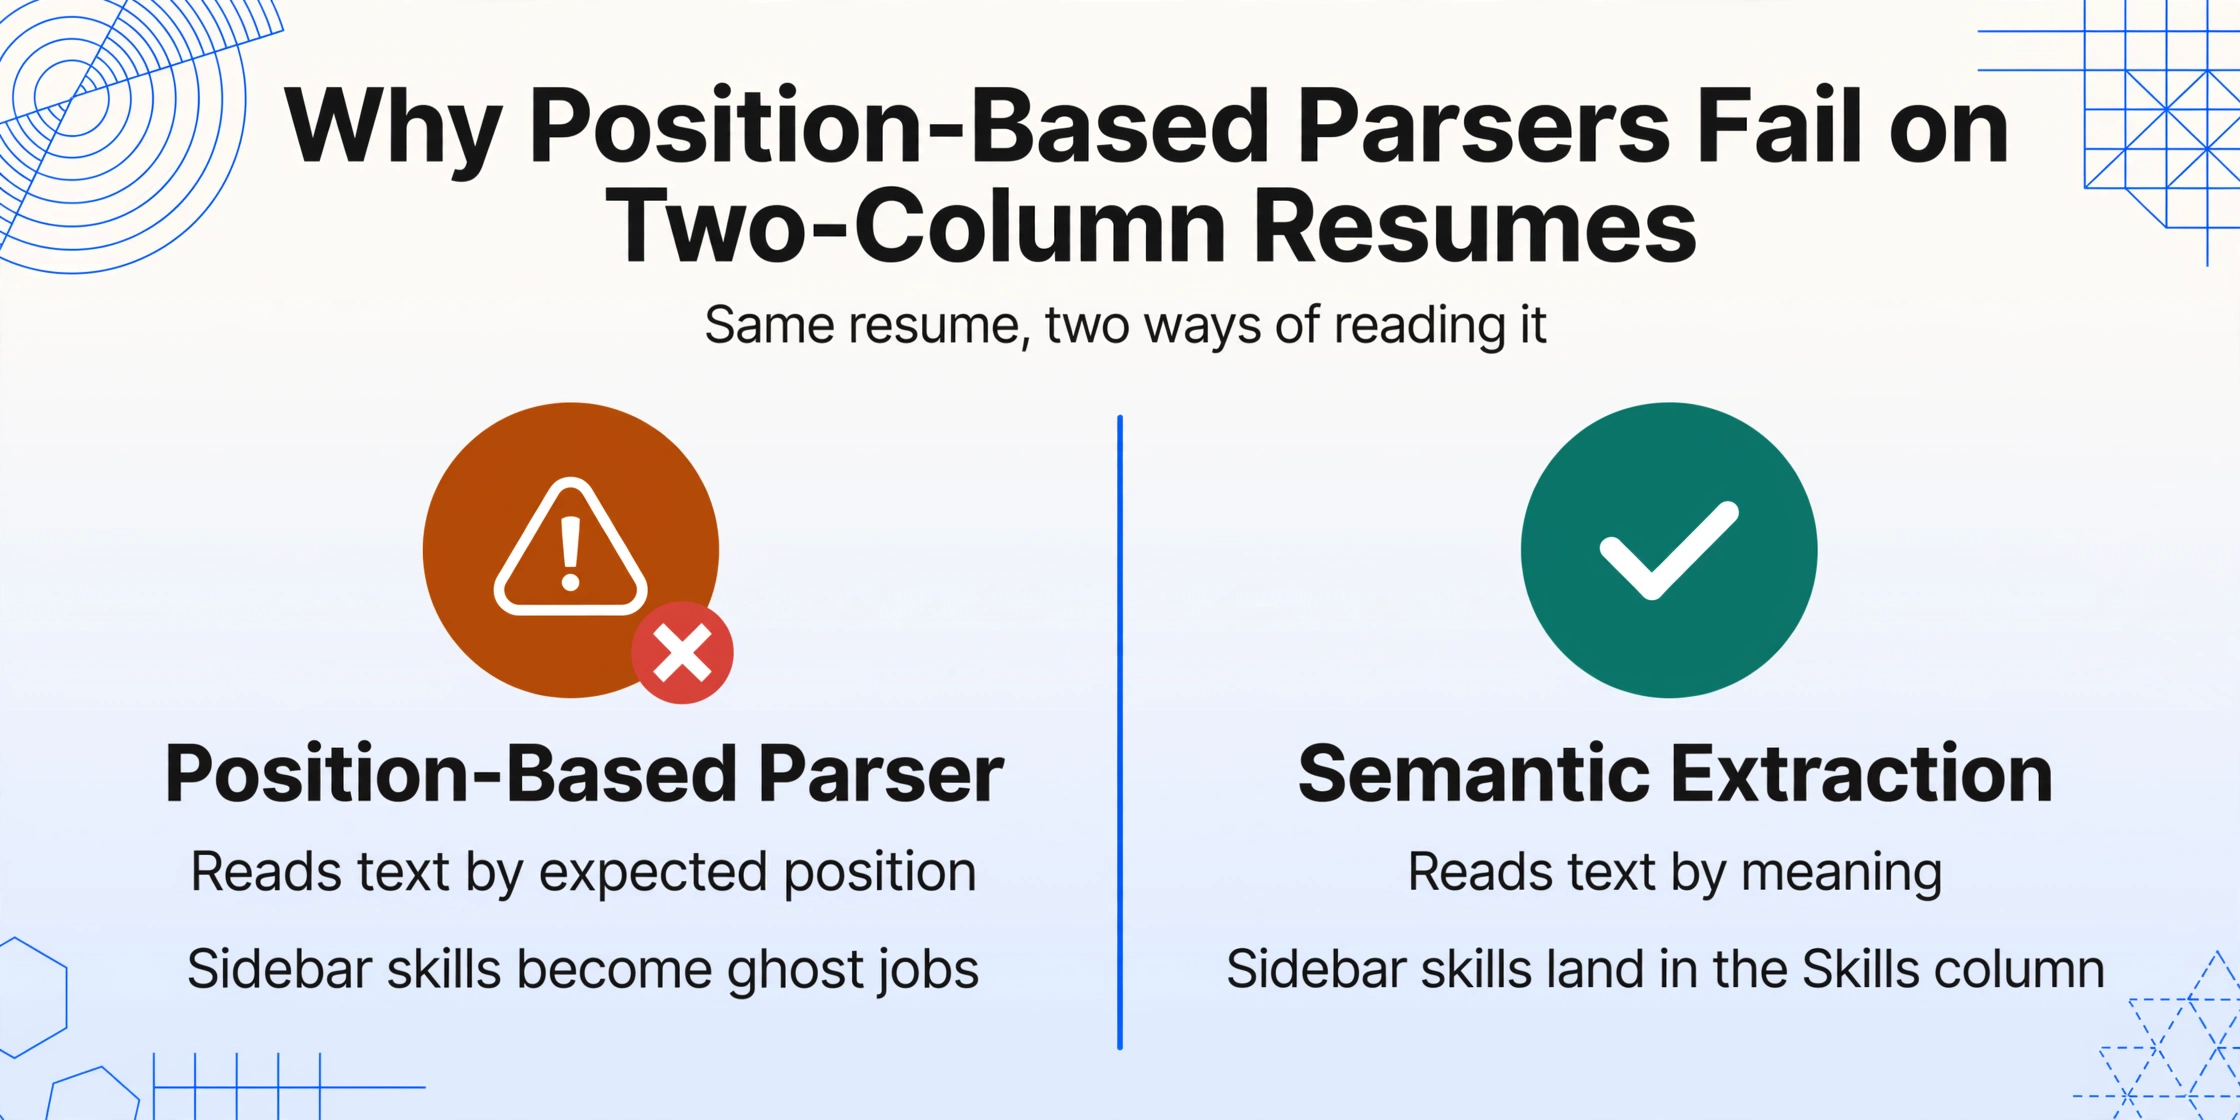
Positionsbasierte Lebenslauf-Parser – die Art, die in den meisten ATS-Plattformen integriert ist – funktionieren, indem sie nach Text an erwarteten Stellen suchen. Ein Kontaktbereich oben. Berufserfahrung in der Mitte. Ausbildung unten. Wenn ein Lebenslauf dieser Vorlage folgt, funktioniert der Parser. Wenn nicht, reicht die Ausgabe von subtil falsch bis komisch unbrauchbar.
Im Subreddit r/recruiting beschrieb ein Recruiter, was passiert, wenn ein Phenom-basiertes System auf einen zweispaltigen Lebenslauf stößt: „Das CRM-Profil sagte mir, sie seien Barista in einem GM-Werk gewesen" – die Sidebar-Fähigkeiten wurden in die Hauptberufserfahrung eingefügt, was eine unsinnige Karriereerzählung ergab (r/recruiting). Ein anderer berichtete, dass die Eingabe von Sicherheitsfreigabe-Informationen in Workdays Bewerbungsformular dazu führte, dass „Ihr Name als Vorname clearance angezeigt wurde" – das Feldtrennzeichen scheiterte an unerwarteter Eingabe.
„Greenhouse funktioniert wie alle anderen", lautete das Fazit desselben Threads. „ATS steht für Applicant Tracking System. Nichts Besonderes daran." Die integrierten Parser sind nicht defekt – sie sind nur positionell in einer Welt nicht-positionaler Dokumente.
Häufige Fehlerquellen bei positionsbasierten Parsern:
- Zweispaltige Layouts: Seitenleisten-Inhalte (Fähigkeiten, Sprachen, Zertifizierungen) werden als Inline-Berufshistorie gelesen, was zu Geisterjobs und Phantom-Arbeitgebern führt.
- Kreative Formatierung: Lebensläufe von Grafikdesignern mit ikonenbasierten Abschnittsüberschriften, Fähigkeitsbewertungsbalken und Zeitstrahl-Visualisierungen erzeugen verstümmelte Textzeichenfolgen.
- Kopf- und Fußzeileninhalte: LinkedIn-URLs, Portfolio-Links und Seitenzahlen in Kopfzeilen werden in den nächstgelegenen Textblock eingefügt.
- Mehrseitige Dokumente: Akademische Lebensläufe, die sich über 4+ Seiten erstrecken, haben oft Abschnittsumbrüche, die die Positionsannahmen des Parsers mitten im Dokument zurücksetzen.
Semantische Extraktion umgeht diese Fehler, indem sie sich überhaupt nicht auf Positionen verlässt. Die KI liest das Dokument so, wie es ein Mensch tun würde – sie versteht, dass „Bildung" ein Abschnitt ist, keine Koordinate, und dass Fähigkeiten in einer Seitenleiste sich grundlegend von Berufserfahrung im Hauptteil unterscheiden. Das bedeutet nicht 100% Genauigkeit bei jedem kreativen Layout – handschriftliche Notizen am Rand oder stark stilisierte Typografie stellen weiterhin Herausforderungen dar – aber es beseitigt die strukturelle Fehlerquelle, die positionsbasierte Parser über verschiedene Lebenslauf-Formate hinweg unzuverlässig macht. Für einen detaillierten Vergleich von Parsing-APIs versus semantischer KI-Extraktion – einschließlich Preis pro Dokument, Einrichtungsaufwand und welcher Ansatz für Ihr Team geeignet ist – lesen Sie unseren Vergleich von Lebenslauf-Parsing und KI-Extraktion.
Die Tabelle in eine Kandidaten-Pipeline verwandeln
Sobald die extrahierten Daten in Excel sind, ist die Tabelle kein Datenablageplatz mehr, sondern ein leichtgewichtiges Rekrutierungswerkzeug. (Wenn Sie eine spezielle Tool-Seite mit Demo bevorzugen, probieren Sie unser Tool zur Lebenslauf-Datenextraktion nach Excel.) So operationalisieren es die besten Teams:
Fügen Sie eine Statusspalte hinzu. „Beworben", „Geprüft", „Erstes Interview", „Zweites Interview", „Angebot", „Eingestellt" – aktualisieren Sie sie manuell, während Kandidaten die Phasen durchlaufen. Sortieren Sie nach Status, um Ihre gesamte Pipeline auf einen Blick zu sehen.
Verfolgen Sie die Quellenattribution. Die Spalte „Quelle" ermöglicht es Ihnen zu berechnen, welche Kanäle die besten Kandidaten hervorbringen. Empfehlungseinstellungen übertreffen konsequent Einstellungen über Jobbörsen bei der Bindung – aber das können Sie nicht beweisen, ohne zu verfolgen, woher jeder Lebenslauf stammt.
Nutzen Sie die nativen Filter von Excel. Filtern Sie nach „Top-Fähigkeiten" mit „Python" und „Jahre Erfahrung" > 3. Filtern Sie nach „Kündigungsfrist" mit „sofort", um Kandidaten zu shortlisten, die schnell starten können. Das sind genau die Operationen, für die ein dediziertes ATS Gebühren erhebt – sie laufen nativ in einer Tabelle.
Sammeln Sie Lebensläufe aus mehreren Quellen. Wenn Personalverantwortliche, externe Recruiter oder Mitarbeiterempfehlungen Ihnen Kandidatenlebensläufe per E-Mail senden, nutzen Sie einen Sammellink (eine teilbare Upload-Seite, die direkt in Ihre Verarbeitungswarteschlange speist) oder E-Mail-Postfach (leiten Sie Lebensläufe weiter und sie landen automatisch in der Warteschlange). Niemand sonst braucht ein Konto – sie senden einfach Dateien.
Importieren Sie in Ihr ATS. Greenhouse, Lever, Workday, iCIMS, BambooHR und die meisten anderen Plattformen unterstützen CSV-Importe von Kandidatendaten. Extrahieren Sie zuerst in Excel, bereinigen und normalisieren Sie die Daten einmal, dann importieren Sie – schneller und zuverlässiger, als sich auf den integrierten Lebenslauf-Parser jeder Plattform zu verlassen.
Verantwortungsvoller Umgang mit Kandidatendaten: EEOC, DSGVO und Aufbewahrung
Wenn Sie Kandidatendaten in eine Tabelle extrahieren, erstellen Sie eine Datenbank mit personenbezogenen Informationen, die unter Arbeits- und Datenschutzvorschriften fällt. Das ist kein HR-Randthema – es ist ein zentraler Bestandteil des Workflows.
In den USA gelten KI-gestützte oder automatisierte Lebenslauf-Screening-Tools als „Auswahlverfahren" gemäß Titel VII des Civil Rights Act von 1964. Die Uniform Guidelines on Employee Selection Procedures (UGESP) der EEOC wenden die Vier-Fünftel-Regel an: Wenn die Auswahlquote für eine geschützte Gruppe weniger als 80 % der Quote der höchsten Gruppe beträgt, liegt ein vorläufiger Befund negativer Auswirkungen vor (EEOC Title VII). Für Recruiting-Teams, die extrahierte Daten zum Filtern von Kandidaten verwenden, lautet die praktische Konsequenz: Dokumentieren Sie Ihre Filterkriterien. Wenn Sie nach „Berufserfahrung > 3" oder „Abschluss = Bachelor" filtern, müssen Sie nachweisen können, dass dieses Kriterium arbeitsbezogen und mit betrieblicher Notwendigkeit vereinbar ist.
Für Teams, die in der EU oder im Vereinigten Königreich rekrutieren, schränkt Artikel 22 der DSGVO Entscheidungen ein, die ausschließlich auf automatisierter Verarbeitung basieren, und Artikel 35 verlangt eine Datenschutz-Folgenabschätzung (DSFA) für risikoreiche Verarbeitung personenbezogener Daten – wozu systematisches Kandidaten-Screening zählt. Die britische ICO und die EU-Datenschutzbehörden empfehlen im Allgemeinen, Daten erfolgloser Kandidaten nicht länger als 6 bis 12 Monate nach Abschluss des Rekrutierungsprozesses aufzubewahren, es sei denn, der Kandidat stimmt einer längeren Aufbewahrung ausdrücklich zu.
Auf operativer Seite bedeutet Datenminimierung: Extrahieren Sie nur die Felder, die Sie für die Einstellungsentscheidung benötigen – nicht jede Zeile jedes Beschäftigungsverlaufs. Der Review-Modus mit visueller Bounding-Box-Verifizierung ermöglicht es Ihnen, zu bestätigen, was extrahiert wurde und woher es stammt, und schafft so eine prüfbare Spur. Und wenn ein Kandidat die Löschung verlangt, löschen Sie Zeilen aus einer Tabelle, statt Datensätze aus einer komplexen ATS-Datenbank zu entwirren.
Der Kandidatendatensatz muss oft Screening-Ergebnisse enthalten, nicht nur Lebenslauffelder – ein Background-Check-zu-Excel-Workflow speichert Strafregister-, Referenz- und MVR-Ergebnisse gemäß den oben genannten Aufbewahrungsregeln.
Der Compliance-Vorteil einer tabellenbasierten Pipeline ist Einfachheit. Daten leben an einem Ort. Löschung ist eine Zeilenoperation. Filterlogik ist explizit (Excel-Formeln, keine Black-Box-KI-Bewertung). Für kleine und mittlere Teams unter EEOC- und DSGVO-Pflichten ist diese Transparenz mehr wert als der Funktionsumfang eines Enterprise-ATS.
FAQ
Kann er handschriftliche Lebensläufe lesen?
Teilweise. Klare, leserliche Handschrift — wie ein gedrucktes Formular mit handschriftlichen Feldern — lässt sich gut extrahieren. Dichte Schreibschrift auf unstrukturiertem Papier führt zu Ergebnissen mit geringerer Konfidenz. Bei gemischten gedruckten/handschriftlichen Lebensläufen extrahiert die KI zuverlässig den gesamten gedruckten Text und markiert Bereiche mit geringer Konfidenz. Rein handschriftliche Lebensläufe sollten mit zusätzlicher manueller Prüfung behandelt werden.
Wie genau ist er bei zweispaltigen Lebenslauf-Layouts?
Deutlich besser als positionsbasierte Parser, da die KI nach semantischer Bedeutung liest und nicht nach Layout-Position. Eine Fähigkeiten-Seitenleiste links wird unabhängig von ihrer Position auf der Seite als „Fähigkeiten“-Abschnitt verstanden. Stark stilisierte Lebensläufe von Grafikdesignern mit ikonenbasierten Abschnittsmarkierungen können jedoch bei bestimmten Feldern zu geringerer Konfidenz führen — die KI ist gut darin, Text im Kontext zu lesen, nicht visuelle Metaphern zu entschlüsseln.
Wie viele Lebensläufe kann ich gleichzeitig verarbeiten?
Batch-Uploads verarbeiten Dutzende von Lebensläufen in einer einzigen Sitzung. Alle Dateien werden parallel verarbeitet und in einer einheitlichen Ausgabetabelle zusammengeführt — eine Zeile pro Kandidat, keine dokumentenspezifische Konfiguration erforderlich.
Kann ich die Ergebnisse in Greenhouse oder Workday importieren?
Ja. Die meisten ATS-Plattformen — darunter Greenhouse, Lever, Workday, iCIMS, BambooHR und Bullhorn — unterstützen CSV-Kandidatenimporte. Exportieren Sie nach Excel, bereinigen und validieren Sie die Daten einmal und importieren Sie dann eine saubere Datei. Dieser Workflow ist oft schneller und zuverlässiger als der eingebaute Lebenslauf-Parser jeder Plattform, insbesondere für Kandidaten, die außerhalb des ATS gewonnen wurden.
Was passiert mit den Lebenslaufdaten nach der Extraktion?
Dateien werden verarbeitet und nach einer konfigurierbaren Aufbewahrungsfrist automatisch vom Server gelöscht. Aus Kunden-Uploads werden keine Trainingsdaten gespeichert. Für Kandidaten, die eine Löschung gemäß DSGVO oder ähnlichen Vorschriften beantragen, liegen die extrahierten Tabellendaten in einer Datei, die Sie kontrollieren — nicht in der Datenbank eines Anbieters.
Wie unterscheidet sich das von einer Resume-Parser-API?
Resume-Parser-APIs (Textkernel, RChilli, Affinda, Daxtra) sind speziell für Lebensläufe entwickelt und liefern oft strukturiertes JSON, das Integrationscode erfordert, um in ein nutzbares Format zu gelangen. Sie berechnen pro Dokument ($0.05–$0.30 pro Parse). KI-Extraktion verfolgt einen breiteren Ansatz: Sie liest jeden Dokumenttyp anhand der Feldbedeutung, nicht anhand eines vorgefertigten Resume-Schemas, und gibt direkt in eine Tabellenkalkulation aus. Es ist keine API-Integration erforderlich – Sie erhalten eine Excel-Datei. Für Teams, die mehr als nur Lebensläufe verarbeiten (Angebotsschreiben, Onboarding-Formulare, Arbeitsverträge), deckt ein einziger Extraktions-Workflow alle Dokumenttypen ab.