200 Lebensläufe, eine Kandidaten-Datenbank:
Screening ohne Kopieren & Einfügen
Die Berichterstattung von CNBC über den Einstellungszyklus 2025 ergab, dass eine beliebte Stellenausschreibung in drei Tagen 300 bis 500 Bewerbungen anziehen kann – und über ein Wochenende mehr als tausend – während Recruiter 30 Sekunden bis 2 Minuten pro Lebenslauf aufwenden (CNBC). Niemand bestreitet das Sichtungsvolumen. Was niemand quantifiziert, ist der Schritt, der vor dem Screening kommt: diesen Stapel von PDFs in eine Tabelle zu verwandeln, die man tatsächlich sortieren kann.
Die wichtigsten Erkenntnisse
- 200 Lebensläufe sind kein größeres Problem als ein einzelner Lebenslauf – es ist eine andere Art von Arbeit, und die Screening-Geschwindigkeit ist nicht, woran es hakt.
- 10 bis 20 Stunden verschwinden in manueller Übertragung, bevor ein einziger Kandidat gesichtet wird – das verbraucht den Großteil der 8 bis 9 Tage, die SHRM für das Screening bei einer 39-Tage-Zeit bis zur Stellenbesetzung angibt.
- Definieren Sie Ihre Spalten einmal, verarbeiten Sie alle 200 Dateien in einem Batch und prüfen Sie nur die markierten Zeilen – ein Recruiter, der extrahiert, hört auf zu transkribieren und beginnt zu sichten.
Was sich ändert, wenn 200 Lebensläufe statt einem eintreffen
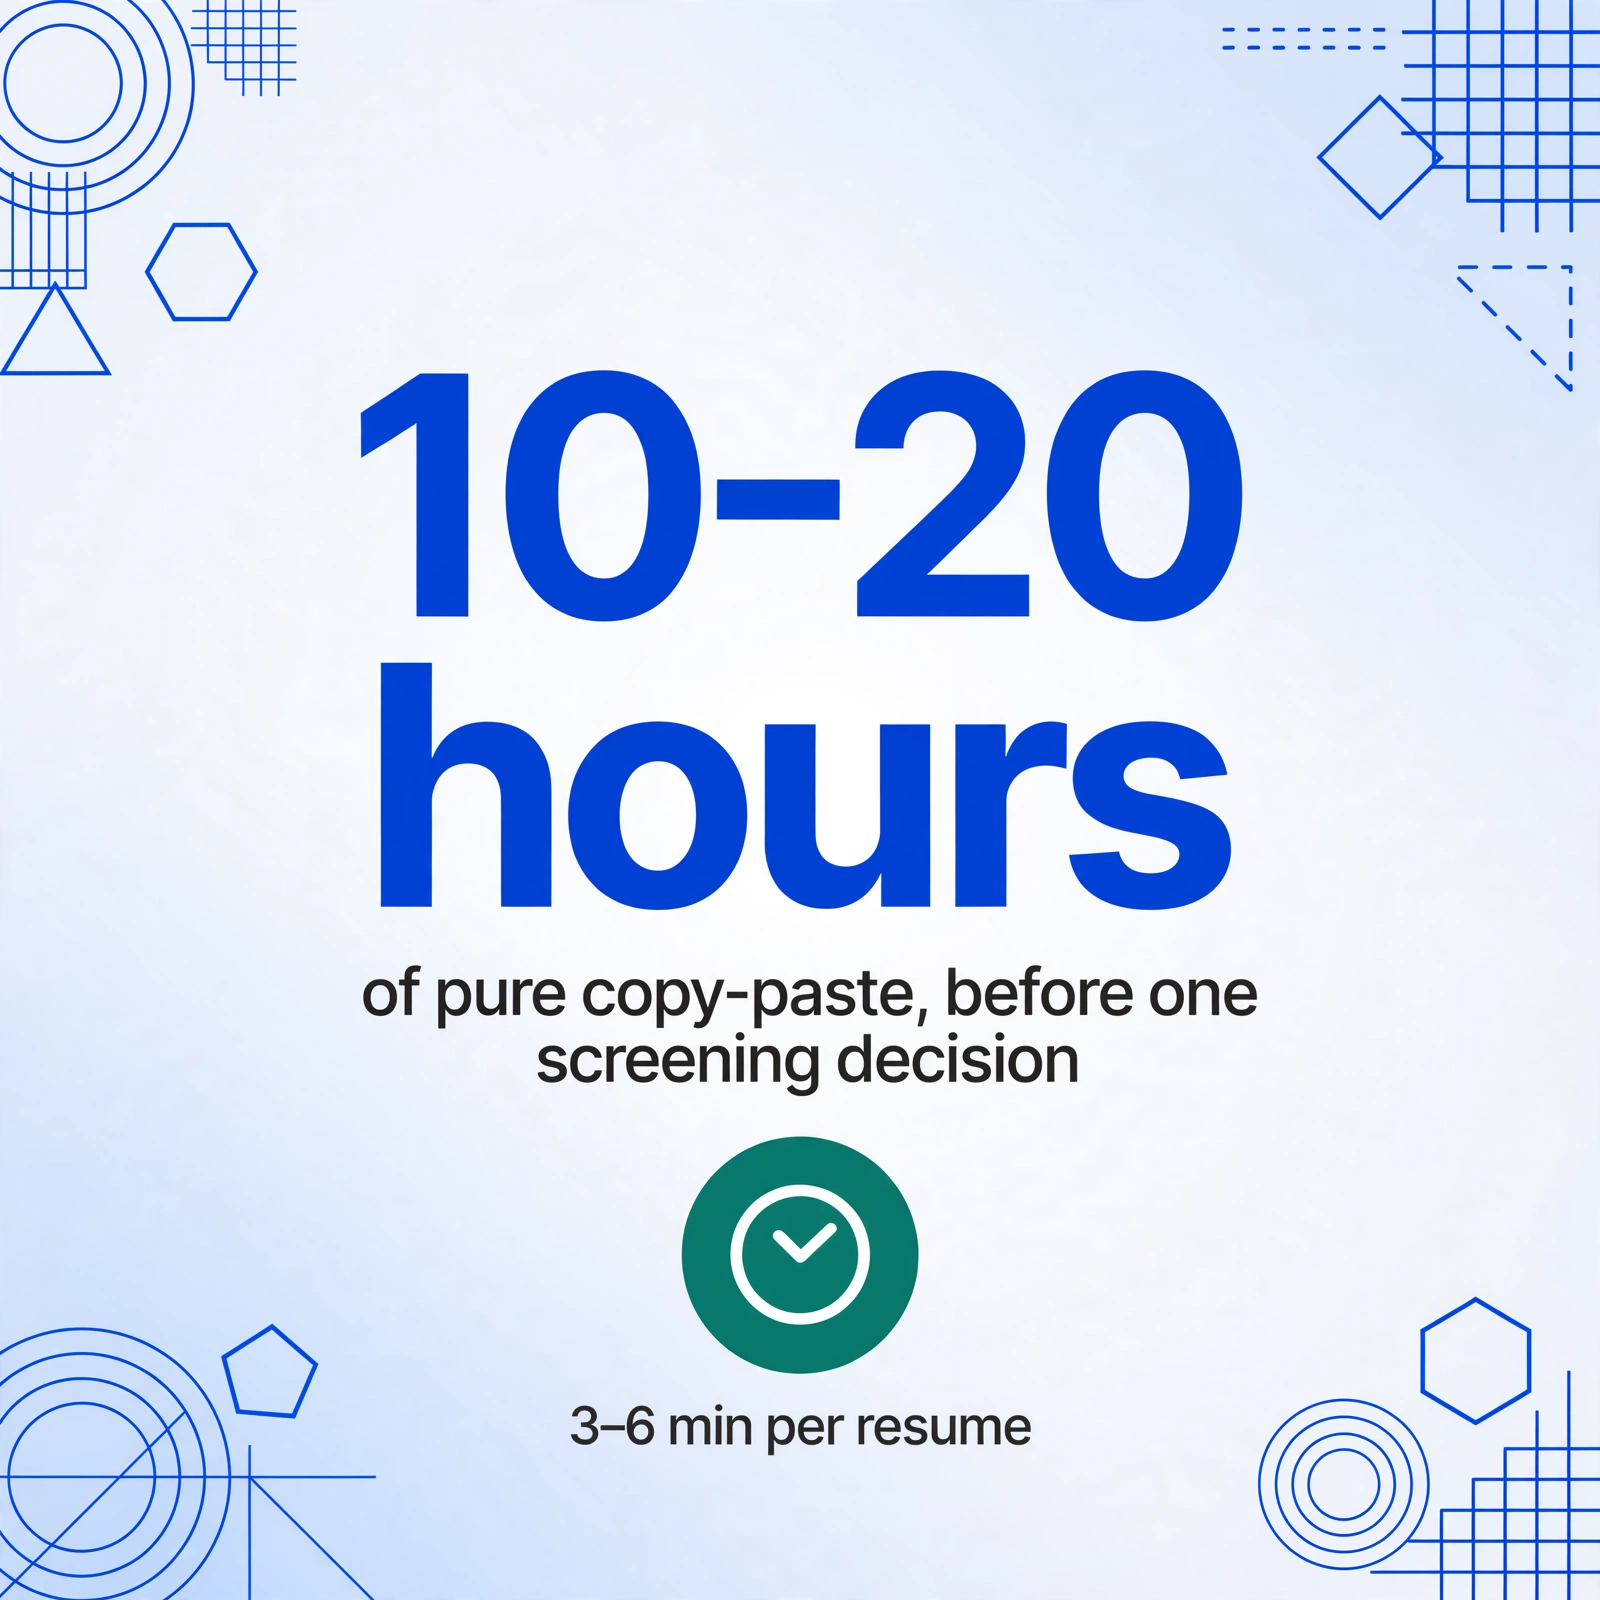
Zweihundert Lebensläufe sind nicht zweihundertmal so viel Arbeit wie ein Lebenslauf – es ist eine andere Kategorie von Arbeit. Bei den 3 bis 6 Minuten pro Lebenslauf, die manuelle Übertragung tatsächlich kostet, summiert sich eine Pipeline mit 200 Kandidaten auf 10 bis 20 Stunden reines Kopieren und Einfügen, bevor auch nur eine einzige Screening-Entscheidung getroffen wurde.
Diese Rechnung ist der Grund, warum ein r/ResumeExperts-Thread genau die Phase beschreibt, um die es in diesem Artikel geht: „Der Übergang von 50 auf 200 ist genau die Phase, in der Recruiting sich anfühlt wie Triage statt Strategie." Unter 50 behält man den Kontext jedes Kandidaten im Kopf. Bei 200 ist dieser Kontext weg – und drei Probleme, die bei kleinen Mengen unsichtbar waren, übernehmen: Dateien, die man nicht unterscheiden kann, Ergebnisse, die sich nicht zusammenführen lassen, und ein paar Lebensläufe, die jedes verwendete Tool zum Absturz bringen.
Das Screening-Volumen ist nicht der Engpass, auf den die meisten Teams stoßen. Der Engpass ist der Schritt vor dem Screening – das Erstellen einer strukturierten Kandidatentabelle aus 200 unstrukturierten Dokumenten – und dieser Schritt ist fast vollständig manuell.
Batch-Problem 1: Dateien namens „resume.pdf"
In einem Batch ist der Dateiname die einzige Identität, die ein Dokument hat, bis man es öffnet – und die meisten Lebenslauf-Dateien wurden von Personen benannt, die nie erwartet haben, einer von zweihundert zu sein.
Die Realität ist in Recruiting-Foren und Praktiker-Threads dieselbe: Dateien kommen als „My CV", „Updated CV", „Final final CV" und – bei allen – als „resume.pdf" an. Wenn zwei Kandidaten identisch benannte Dateien in denselben Ordner oder dieselbe ATS-Ablagezone hochladen, kann eine die andere stillschweigend überschreiben. Der Kandidat, dessen Datei überlebt hat, ist nun nicht mehr identifizierbar, denn „resume.pdf" sagt nichts darüber aus, wem sie gehört.
Die Lösung ist keine Namensdisziplin-Kampagne, die sich an Bewerber richtet – die verliert man. Die Lösung ist, die Zeilenidentität die Dateinamen-Identität ersetzen zu lassen. Wenn man einen Batch mit einem Tool verarbeitet, das eine Quelldatei-Spalte erfasst – eine automatische Spalte, die protokolliert, welches Dokument jede Zeile erzeugt hat – trägt jeder Kandidat einen Verweis auf seine Originaldatei, egal wie sie hieß. Die Verifizierung wird zu einem Filtervorgang: nach Quelle sortieren, statt ein Ratespiel darüber, welches „CV.pdf" zu wem gehört.
Für die Dateien, die man selbst kontrolliert, zahlt sich eine Namenskonvention trotzdem aus: nachname_vorname_quelle (z. B. chen_mei_linkedin) verwandelt den Quelldateinamen in eine sofortige Prüfspur und einen Hinweis zur Deduplizierung, wenn derselbe Kandidat über zwei Kanäle auftaucht.
Batch-Problem 2: 200 Dateien, eine Tabelle
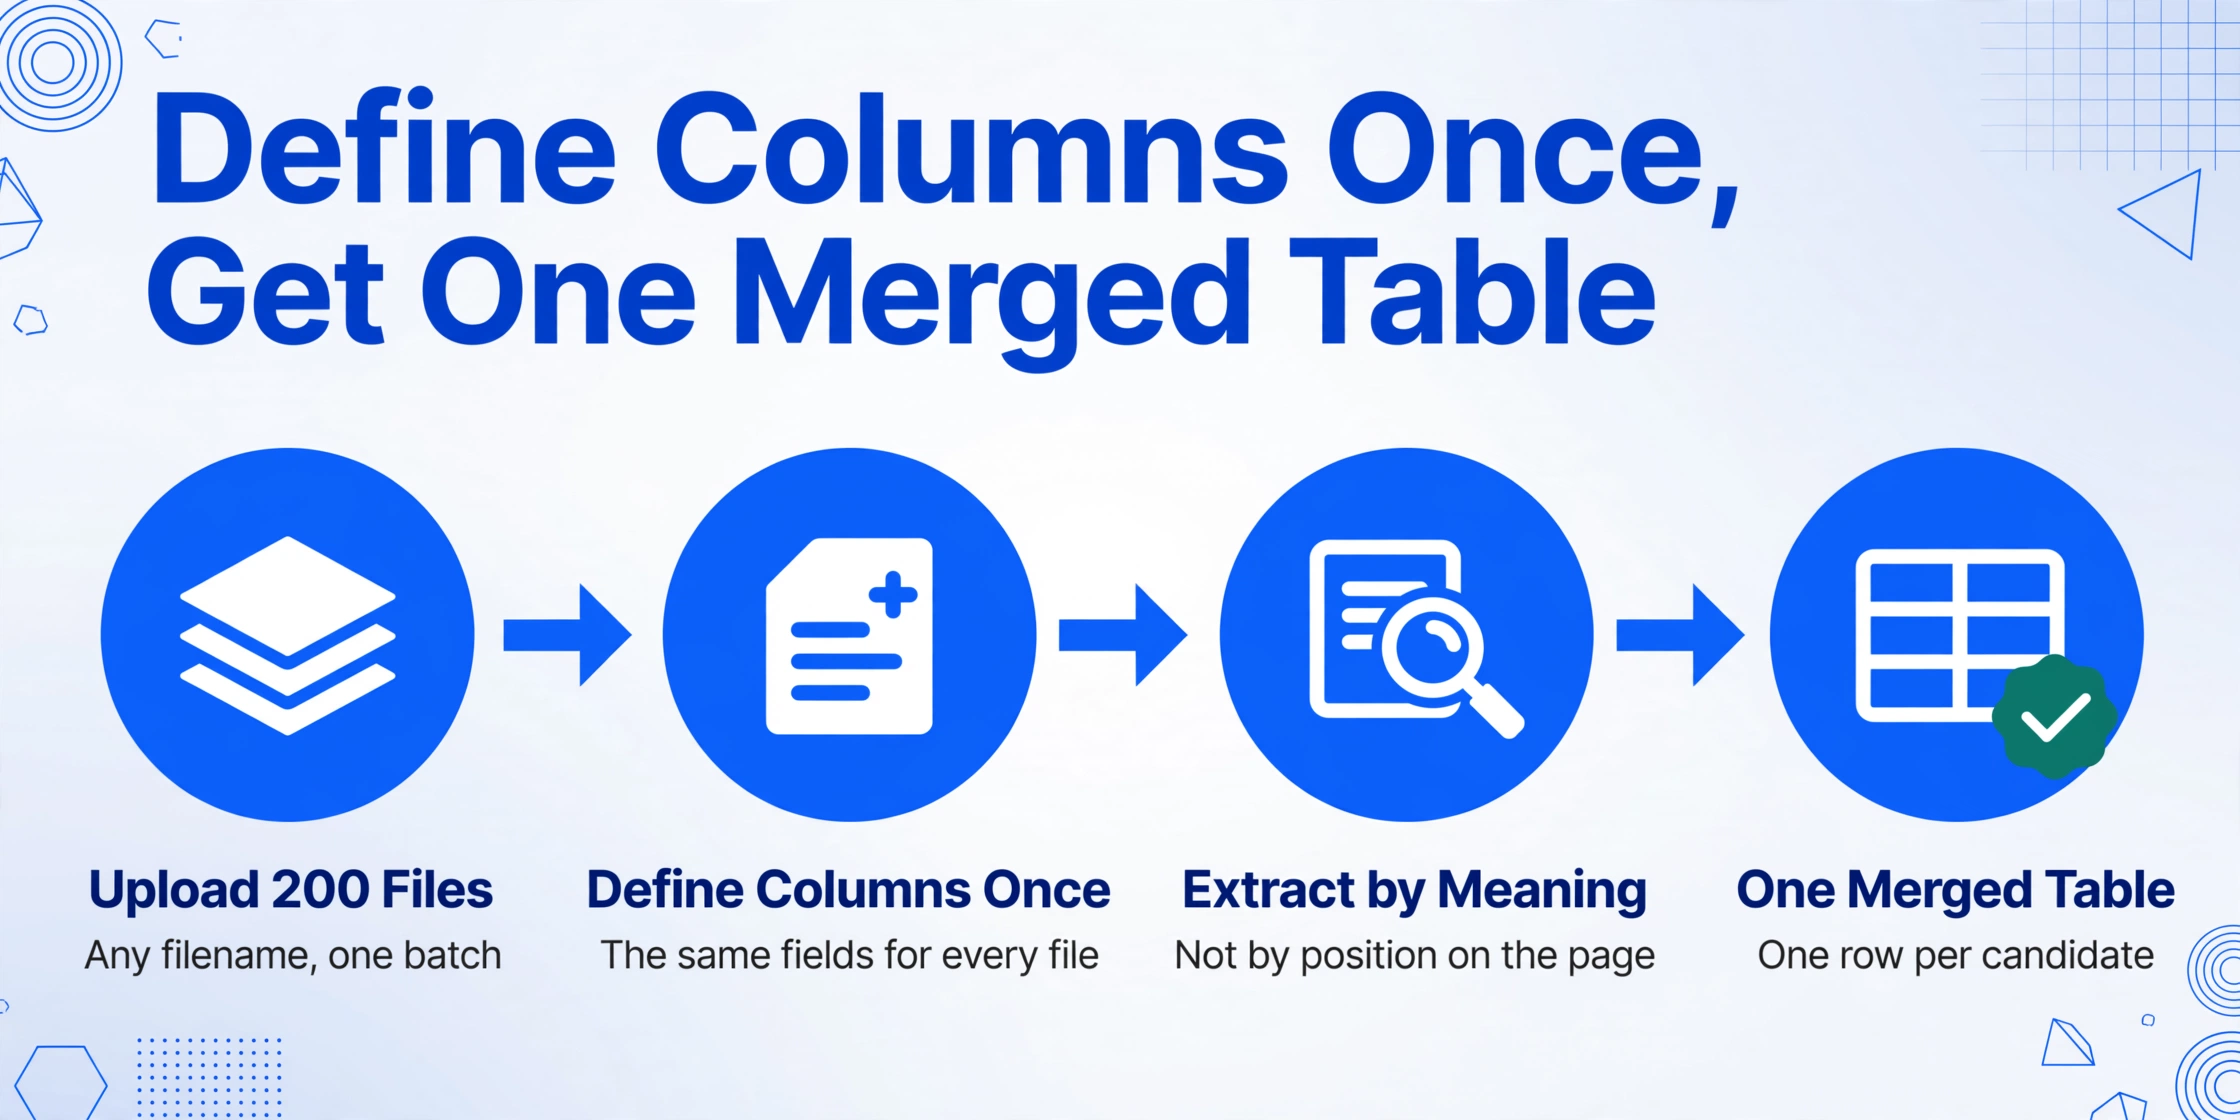
Wenn Sie 200 Lebensläufe einzeln extrahieren, erhalten Sie 200 separate Ausgaben — 200 Dateien, 200 Chat-Antworten, 200 Tabs — und das manuelle Zusammenführen erzeugt genau die Dateneingabelast, die Sie vermeiden wollten.
Der Ausweg ist ein Prozess, bei dem Ihre Spaltendefinitionen einmal festgelegt werden und für jede Datei gelten. Mit Benutzerdefinierte Spaltenextraktion — dem Mechanismus im Kern von ImageToTable.ai, bei dem Sie die gewünschten Feldnamen eingeben und die KI jeden Wert anhand seiner Bedeutung statt seiner Position auf der Seite lokalisiert — definieren Sie „Vollständiger Name, E-Mail, Aktuelle Position, Aktuelles Unternehmen, Berufserfahrung in Jahren, Top-Qualifikationen" einmal, laden alle 200 Dateien gemeinsam hoch und erhalten eine zusammengeführte Tabelle, in der jeder Lebenslauf eine Zeile beiträgt.
Zwei Spaltentypen machen eine Kandidatendatenbank nützlicher als eine reine Transkription. Abgeleitete Spalten ermöglichen es der KI, Daten auszufüllen, die nicht wörtlich auf dem Lebenslauf stehen: eine „Quelle"-Spalte, die jede Zeile basierend auf dem Ort, an dem Sie sie gesammelt haben, als LinkedIn, Empfehlung oder Jobbörse kennzeichnet, oder eine „Berufserfahrung in Jahren"-Spalte, die aus den Daten im Beschäftigungsverlauf abgeleitet wird. Berechnete Spalten gehen einen Schritt weiter und führen während der Extraktion Berechnungen durch — eine „Kündigungsfrist (Zieldatum − Verfügbar ab)"-Spalte, die die Datumsberechnung auflöst, bevor die Daten jemals Ihre Tabellenkalkulation erreichen.
Dies ist genau der Mechanismus, der von einem Lebenslauf auf zweihundert skaliert, weil sich die Spaltendefinitionen mit der Menge nicht ändern. Die Demo unten läuft ohne voreingestellte Vorlage — Lebensläufe haben kein gemeinsames Format, also definieren Sie die Spalten, die Sie benötigen, und die KI findet sie in jedem Lebenslauf, den Sie hochladen. Dieselben Spaltendefinitionen decken auch die Papierseite des Trichters ab — der Workflow zur Umwandlung von Bewerbungsformularen in Excel liest Berufserfahrung, Ausbildung und Referenzen aus gescannten Bewerbungen in dieselbe zusammengeführte Tabelle ein.
Dateien werden sicher verarbeitet und nicht gespeichert.
Wenn Sie mit den Details auf Feldebene noch nicht vertraut sind – welche Spalten wichtig sind, wie Sie Kandidatendaten verantwortungsvoll behandeln und wo parserbasierte Tools scheitern – finden Sie in unserer Schritt-für-Schritt-Anleitung zum Extrahieren von Lebenslaufdaten in Excel den Einzeldatei-Workflow, die Feldliste und die Compliance-Seite ausführlich beschrieben.
Batch-Problem 3: Die 5 %, die einen Parser zum Scheitern bringen
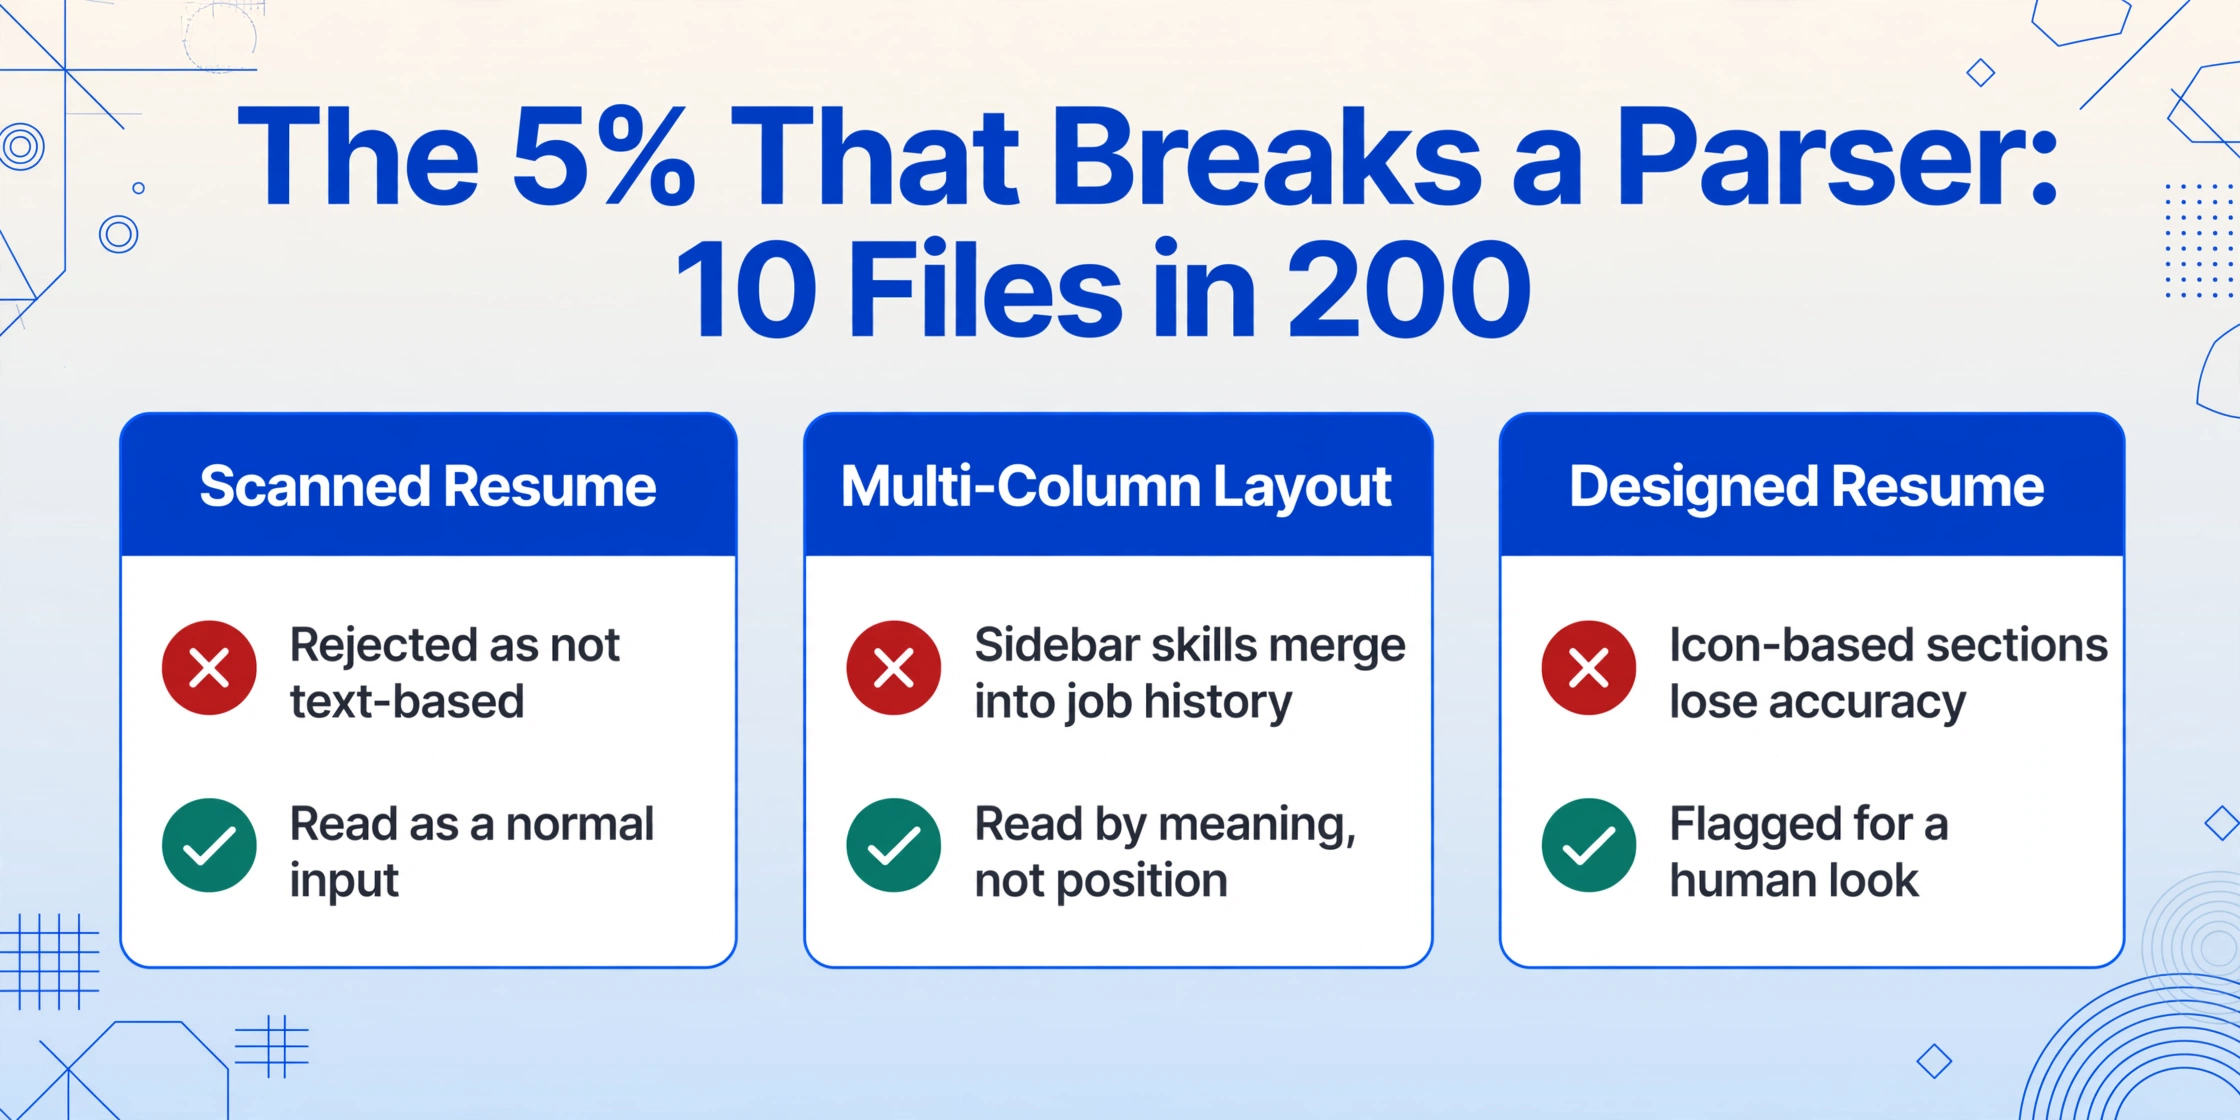
Selbst eine Ausnahmequote von 5 % bei einem Batch mit 200 Lebensläufen bedeutet 10 Dateien, die manuell bearbeitet werden müssen – und in einem Batch-Workflow sind genau diese 10 der Punkt, an dem der gesamte Prozess ins Stocken gerät.
Die häufigste Ausnahme ist der gescannte oder bildbasierte Lebenslauf. Die eigene Bulk-Import-Dokumentation von Breezy HR besagt, dass hochgeladene Lebensläufe textbasierte Dokumente (DOCX, TXT, RTF, ODT oder PDF) sein müssen – „keine gescannten Kopien, Bilder oder bildbasierten PDFs" –, die das Tool kategorisch ablehnt (Breezy-HR-Dokumentation). Ein ATS, das kein Foto eines Lebenslaufs verarbeiten kann, ist eine echte Einschränkung für Rollen, bei denen Kandidaten legitimerweise vom Telefon aus bewerben. Eine visionbasierte Extraktions-Engine liest die Pixel dagegen so, wie ein Mensch das Dokument liest – ein fotografierter oder gescannter Lebenslauf ist eine normale Eingabe, keine Ausnahme.
Zwei weitere Ausnahmeklassen treten in jedem großen Batch auf: verschlüsselte oder passwortgeschützte PDFs (häufig, wenn Kandidaten sich über sichere E-Mail-Kanäle bewerben) und mehrspaltige oder stark gestaltete Layouts, die positionsbasierte Parser durcheinanderbringen, indem sie Sidebar-Fähigkeiten in den beruflichen Werdegang einmischen. Semantische Extraktion umgeht beides, indem sie Bedeutung statt Koordinaten liest – allerdings können stark stilisierte Grafikdesigner-Lebensläufe mit ikonenbasierten Abschnitten bei bestimmten Feldern weiterhin eine geringere Konfidenz erzeugen, und diese brauchen tatsächlich einen menschlichen Blick.
Der batchsichere Weg, mit Ausnahmen umzugehen, ist Review-Modus mit Bbox-Verifizierung: Fahren Sie mit der Maus über eine extrahierte Zelle oder klicken Sie sie an, und das Tool hebt genau die Stelle hervor, aus der dieser Wert im Original-Lebenslauf stammt – und umgekehrt: Klicken Sie auf einen Bereich im Bild und springen Sie zur zugehörigen Tabellenzelle. Statt alle 200 Zeilen zu prüfen, sehen Sie sich die wenigen an, die die KI als unsicher markiert hat, und bestätigen Sie jede einzelne in Sekunden gegen die Originaldatei. Bei der 99-%-Genauigkeit für gedruckten Text, die unsere Extraktions-Engine als Benchmark erreicht, erzeugt ein Batch mit 200 Lebensläufen eine kleine Anzahl prüfenswerter Zeilen – keine 10-stündige Prüfung.
Das Prinzip der Ausnahmebehandlung, das skaliert: Stoppen Sie den Batch nicht bei einer fehlerhaften Datei, und überspringen Sie sie auch nicht stillschweigend. Verarbeiten Sie alles, markieren Sie die unsicheren Felder und leiten Sie nur diese Zeilen zur menschlichen Prüfung weiter. Das ist der Unterschied zwischen einer 10-stündigen Prüfung und einem 15-minütigen Check.
Was 10 Stunden Kopieren mit Ihrer Time-to-Fill machen
Die Time-to-Fill ist der Punkt, an dem manuelles Kandidatenaufbereiten aufhört, eine kleine Ineffizienz zu sein, und anfängt, eine Recruiting-Kennzahl zu sein, die Sie nicht erreichen können.
Der SHRM-Benchmarking-Report 2026 für Recruiting-Führungskräfte beziffert die mediane Time-to-Fill für nicht-führende Positionen auf 39 Tage — gegenüber 44 im Vorjahr — und führt einen Teil dieser Verbesserung auf die Nutzung von KI-Tools zurück; das Screening allein nimmt etwa 8 bis 9 dieser Tage in Anspruch (SHRM Recruiting Benchmarking). Die 10 bis 20 Stunden manueller Übertragung aus einem einzelnen Batch mit 200 Lebensläufen fallen genau in dieses Screening-Fenster und sind reiner Overhead: keine Bewertung erforderlich, nur das Verschieben von Text aus PDFs in Zellen.
Die CNBC-Berichterstattung fügt die zweite Dimension hinzu — mehr als einer von fünf US-HR-Fachleuten verbringt täglich 3 bis 5 Stunden nur mit der Prüfung von Bewerbungen. Wenn ein Recruiter bereits ein Drittel des Tages mit der Bewerbungsprüfung verbringt, sind die Stunden, die er zunächst mit dem Aufbau der Tabelle verbringt, kein Rundungsfehler. Sie sind der Unterschied zwischen einem Recruiter, der prüft, und einem Recruiter, der transkribiert.
Manuelles Kandidatenaufbereiten fühlt sich nicht nur langsam an — es bläht direkt die 8–9 Tage auf, die SHRM dem Screening zuschreibt, denn jede Stunde, die mit dem Kopieren von Lebensläufen in eine Tabelle verbracht wird, ist eine Stunde, die nicht damit verbracht wird, Kandidaten zum Vorstellungsgespräch zu bringen.
Ihr ATS kann importieren, was Sie aufgebaut haben
Die Tabelle, die Sie aufbauen, ist genau die Importdatei, die Ihr ATS erwartet — Sie brauchen nicht den eigenen Parser des ATS, um einen einzigen Lebenslauf anzufassen.
Greenhouses Bulk-Kandidatenimport akzeptiert bis zu 8.000 Zeilen pro Upload aus einer Tabelle, mit der Einschränkung, dass ein hochgeladenes Lebenslauf-ZIP nur an Zeilen angehängt wird, in denen eine passende E-Mail analysierbar ist (Greenhouse-Dokumentation). Bullhorns benutzerdefinierter Import nimmt 1.000 Datensätze pro Batch in CSV entgegen. Workdays EIB hat eine Upload-Grenze von 30 MB und gar keine Anhänge. All diese haben dieselbe Form: Sie importieren eine Kandidatentabelle und erwarten, dass Sie diese liefern — mit einer Zeile pro Kandidat und einer korrekten E-Mail in jeder Zeile.
Zuerst extrahieren, dann importieren. Wenn Sie mit den Spalten, die Ihr ATS erfordert — einschließlich einer korrekt befüllten E-Mail-Spalte, die die Extraktion verifizieren sollte — in Excel per Batch extrahieren, ist die exportierte Datei die Importdatei. Ein einziger Export bringt Ihre gesamte 200-Kandidaten-Datenbank in Greenhouse, Lever, Workday, iCIMS oder BambooHR, ohne dass deren integrierte Parser jemals ein PDF sehen. Dies ist auch der Ansatz, um den unser Workflow zur Lebenslauf-Datenextraktion nach Excel herum aufgebaut ist: eine saubere strukturierte Datei, bereit für sowohl Ihre Screening-Tabelle als auch Ihr ATS.
Das Screening endet nicht beim Lebenslauf: Ein Hintergrundcheck nach Excel-Durchlauf fügt die Ergebnisse der Vorstrafen-, Beschäftigungs- und Bildungsüberprüfung jedes Kandidaten als eigene Spalten in derselben Zeile hinzu.
Häufig gestellte Fragen
Kann ich gescannte oder bildbasierte Lebensläufe in Stapeln verarbeiten?
Ja — eine visionbasierte Extraktions-Engine liest fotografierte und gescannte Lebensläufe als normalen Eingabetyp, anders als viele ATS-Bulk-Upload-Funktionen, die bildbasierte Dokumente grundsätzlich ablehnen (die Dokumentation von Breezy HR besagt beispielsweise, dass Bulk-Uploads textbasiert sein müssen). Die Scan-Qualität ist dennoch entscheidend: Klare Scans werden sauber extrahiert, während stark unscharfe oder schräg aufgenommene Fotos Felder mit geringerer Konfidenz erzeugen, die zur Überprüfung markiert statt automatisch ausgefüllt werden.
Welche Spalten sollte ich für eine Kandidatendatenbank definieren?
Ein praktischer Kern für eine Screening-Tabelle: Vollständiger Name, E-Mail, Telefon, Aktuelle Position, Aktuelles Unternehmen, Berufserfahrung in Jahren, Top-Fähigkeiten, Standort, Ausbildung und Quelle (woher der Kandidat stammt). Fügen Sie eine Quellendatei-Spalte für die Rückverfolgbarkeit hinzu, plus abgeleitete oder berechnete Spalten wie Berufserfahrung in Jahren oder Kündigungsfrist, falls Ihre Einstellungsentscheidungen davon abhängen. Extrahieren Sie nur, was Ihr Prozess nutzt — eine Kandidatendatenbank dient dem Filtern und Vergleichen, nicht dem Archivieren jeder einzelnen Beschäftigungszeile.
Wie lange dauert ein Stapel mit 200 Lebensläufen tatsächlich?
Jeder Lebenslauf benötigt etwa 5 bis 10 Sekunden KI-Verarbeitungszeit, sodass ein Stapel mit 200 Dateien in etwa 20 bis 35 Minuten abgeschlossen ist — Zeit, die Sie nicht investieren müssen. Die Überprüfungszeit hängt davon ab, wie viele Felder markiert werden; bei der Genauigkeit, die Vision-Modelle bei sauberen gedruckten Lebensläufen erreichen, sollten Sie nur wenige Zeilen überprüfen, kein vollständiges Audit. Vergleichen Sie das mit 10 bis 20 Stunden manueller Übertragung für denselben Umfang.
Woher weiß ich, welche Zeile aus welchem Lebenslauf stammt?
Stapel-Exporte enthalten eine automatische Quellendatei-Spalte, die den Dateinamen jedes Ursprungsdokuments erfasst, sodass jede Zeile auf ihre Quelldatei verweist — selbst wenn die Datei "resume.pdf" hieß. Für zusätzliche Rückverfolgbarkeit benennen Sie Dateien, die Sie kontrollieren, vor dem Upload nach dem Muster Nachname_Vorname_Quelle um — der Dateiname wird Teil des Prüfpfads und hilft, doppelte Kandidaten aus mehreren Kanälen zu erkennen.
Kann ich die Ergebnisse in Greenhouse, Lever oder Workday importieren?
Ja. Exportieren Sie zuerst in eine saubere Tabelle und nutzen Sie dann den Standard-Kandidatenimport der jeweiligen Plattform: Greenhouse-Massenimport (bis zu 8.000 Zeilen pro Upload, erfordert eine passende E-Mail in jeder Zeile), Bullhorn-Custom-Import (1.000 Datensätze pro Batch, CSV) oder Workday EIB (30MB-Limit). Da die exportierte Datei bereits eine Zeile pro Kandidat mit einer verifizierten E-Mail-Spalte enthält, lässt sie sich sauber importieren – und Sie überspringen den integrierten Lebenslauf-Parser der Plattform komplett.
Wie unterscheidet sich die Batch-Extraktion von einer Resume-Parser-API?
Resume-Parser-APIs (Textkernel, RChilli, Affinda, Daxtra) sind auf ein festes Lebenslauf-Schema trainiert, berechnen pro Dokument und liefern strukturiertes JSON, das Sie anschließend integrieren müssen. Die Batch-Extraktion liest jedes Dokument anhand der von Ihnen definierten Spalten, hat keine dateibezogene Gebühr, die an ein Lebenslauf-Schema gekoppelt ist, und gibt direkt in eine Tabelle aus, die Sie öffnen, filtern und in ein ATS importieren können. Wenn Ihr Team mehr als nur Lebensläufe verarbeitet – Angebotsschreiben, Onboarding-Formulare, Verträge – deckt ein einziger Extraktions-Workflow alle ab. Deshalb lässt sich derselbe Batch-Ansatz ganz natürlich auf eine Mitarbeiterdokument-Datenbank erweitern.
Ein Stapel von 200 Lebensläufen ist keine größere Version eines Ein-Lebenslauf-Problems – es ist eine andere Problemkategorie, die mit Benennung, Zusammenführung und Ausnahmebehandlung gelöst wird, statt mit mehr Tipparbeit. Die Kandidatendatenbank, die Sie aufbauen, ist die Grundlage, auf der jede Screening-Entscheidung basiert; die Frage ist, ob Sie sie von Hand oder einmalig aufbauen.
Testen Sie es mit Ihrem eigenen Lebenslauf-Stapel