이력서 200장, 하나의 후보자 데이터베이스:
복사-붙여넣기 없이 서류 심사하는 방법
CNBC의 2025년 채용 주기 보도에 따르면 인기 있는 공고는 사흘 만에 300~500건의 지원서를 받을 수 있고, 주말 동안 1,000건이 넘게 쌓일 수 있으며, 채용 담당자는 이력서 한 장당 30초에서 2분을 씁니다(CNBC). 서류 심사 물량에 대해 이견을 다는 사람은 없습니다. 아무도 정량화하지 않는 것은 심사 바로 앞 단계입니다: PDF 더미를 실제로 정렬할 수 있는 스프레드시트로 바꾸는 일 말입니다.
핵심 요점
- 이력서 200장은 이력서 1장 문제의 더 큰 버전이 아닙니다 — 다른 범주의 작업이며, 문제가 되는 것은 심사 속도가 아닙니다.
- 단 한 명의 후보자를 심사하기 전에 수작업 전사에 10~20시간이 사라지며, SHRM이 39일의 채용 완료 기간 중 심사에 배정한 8~9일 중 대부분을 소모합니다.
- 열을 한 번 정의하고, 200개 파일을 한 번의 배치로 처리한 다음, 플래그가 지정된 행만 검토하세요 — 추출을 사용하는 채용 담당자는 전사를 멈추고 심사를 시작합니다.
이력서 200개가 한 개 대신 도착하면 달라지는 것
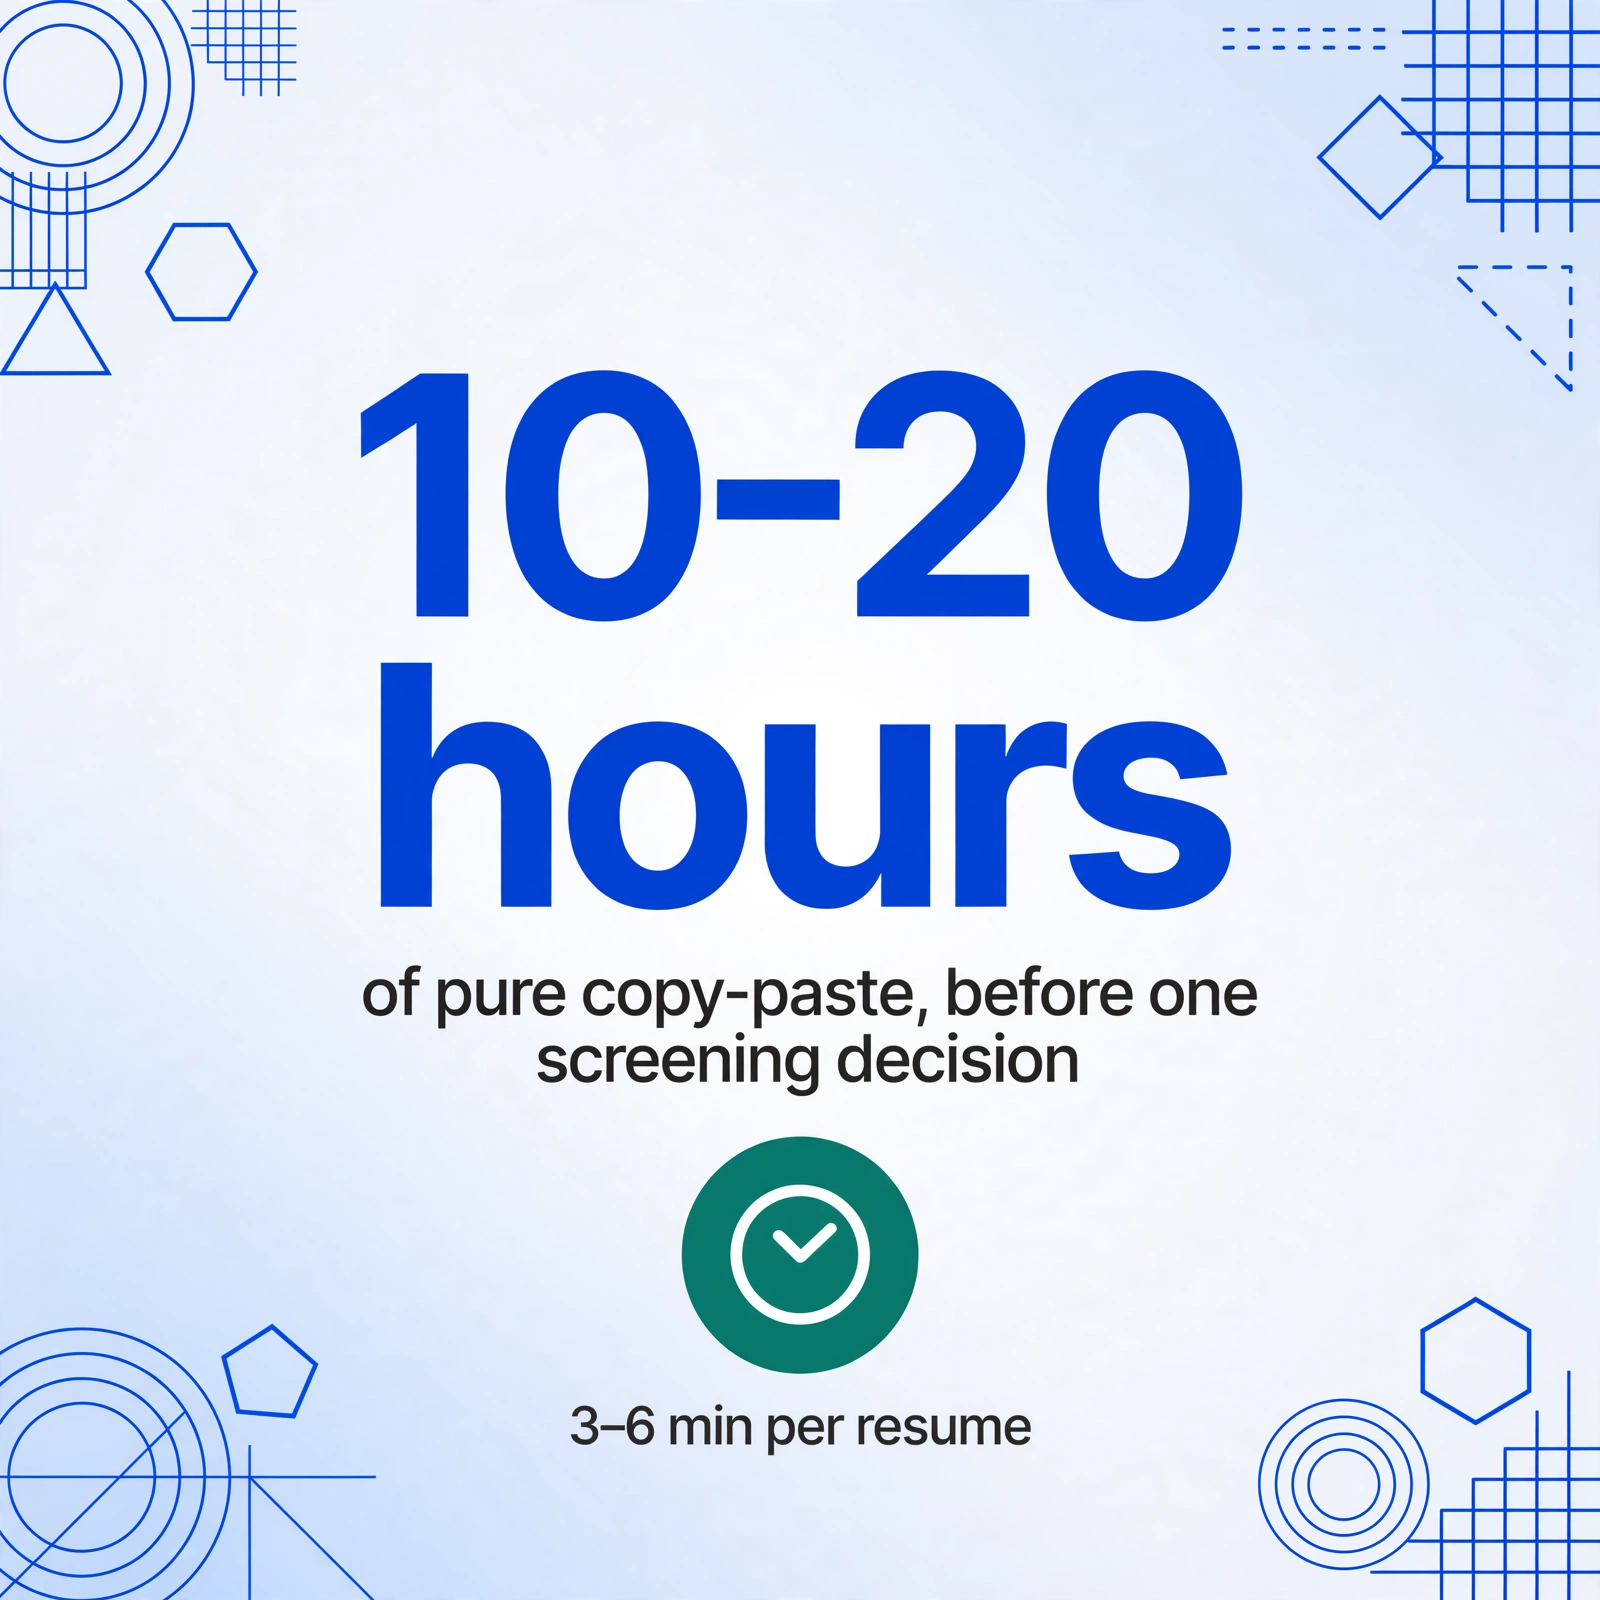
이력서 200개는 이력서 1개의 200배 작업량이 아니라, 완전히 다른 범주의 작업입니다. 수동 입력에 이력서당 실제로 3~6분이 소요된다면, 200명의 파이프라인은 단 한 번의 서류 심사 결정도 내리기 전에 순수 복사-붙여넣기만 10~20시간이 걸립니다.
이 계산이 바로 한 r/ResumeExperts 스레드가 이 글에서 다루는 정확한 단계를 설명하는 이유입니다: "50명에서 200명으로 확장하는 것은 채용이 전략이 아니라 분류 작업처럼 느껴지기 시작하는 바로 그 단계입니다." 50명 미만에서는 모든 지원자의 맥락을 머릿속에 담을 수 있습니다. 200명이 되면 그 맥락은 사라지고, 소규모에서는 보이지 않던 세 가지 문제가 지배하게 됩니다: 구분할 수 없는 파일, 병합되지 않는 결과물, 그리고 어떤 도구를 쓰든 망가뜨리는 소수의 이력서입니다.
대부분의 팀이 부딪히는 병목은 서류 심사 규모가 아닙니다. 병목은 심사 이전 단계 — 구조화되지 않은 문서 200개에서 구조화된 지원자 테이블을 만드는 단계 — 이며, 이 단계는 거의 전적으로 수동입니다.
일괄 처리 문제 1: "resume.pdf"라는 이름의 파일
일괄 처리에서 파일 이름은 문서를 열기 전까지 유일한 식별자입니다 — 그리고 대부분의 이력서 파일은 자신이 200개 중 하나가 될 줄 몰랐던 사람들이 이름을 지었습니다.
현실은 채용 포럼과 실무자 스레드에서 동일합니다: "My CV," "Updated CV," "Final final CV," 그리고 모든 사람에게 — "resume.pdf"라는 이름의 파일이 도착합니다. 두 명의 지원자가 같은 이름의 파일을 같은 폴더나 같은 ATS 드롭 영역에 업로드하면, 하나가 조용히 다른 하나를 덮어쓸 수 있습니다. 살아남은 파일의 지원자는 이제 식별이 불가능합니다. "resume.pdf"는 누구의 파일인지 아무것도 알려주지 않기 때문입니다.
해결책은 지원자에게 이름 규칙 캠페인을 하는 것이 아닙니다 — 그 싸움에서 질 것입니다. 해결책은 파일 이름 식별을 행 식별로 대체하는 것입니다. 각 행이 어떤 문서에서 생성되었는지 기록하는 원본 파일 열 — 자동 열 — 을 기록하는 도구로 일괄 처리를 하면, 모든 지원자는 원래 파일이 무엇이라고 불렸든 그 파일로 연결되는 참조를 갖게 됩니다. 검증은 필터 작업이 됩니다: 어떤 "CV.pdf"가 누구 것인지 추측하는 게임이 아니라, 원본별로 정렬하는 것입니다.
통제할 수 있는 파일의 경우, 이름 규칙은 여전히 그 가치가 있습니다: 성_이름_출처는 원본 파일 이름을 즉각적인 감사 추적이자, 같은 지원자가 두 채널에서 나타날 때 중복 제거 힌트로 바꿔줍니다.
배치 문제 2: 파일 200개, 테이블 하나
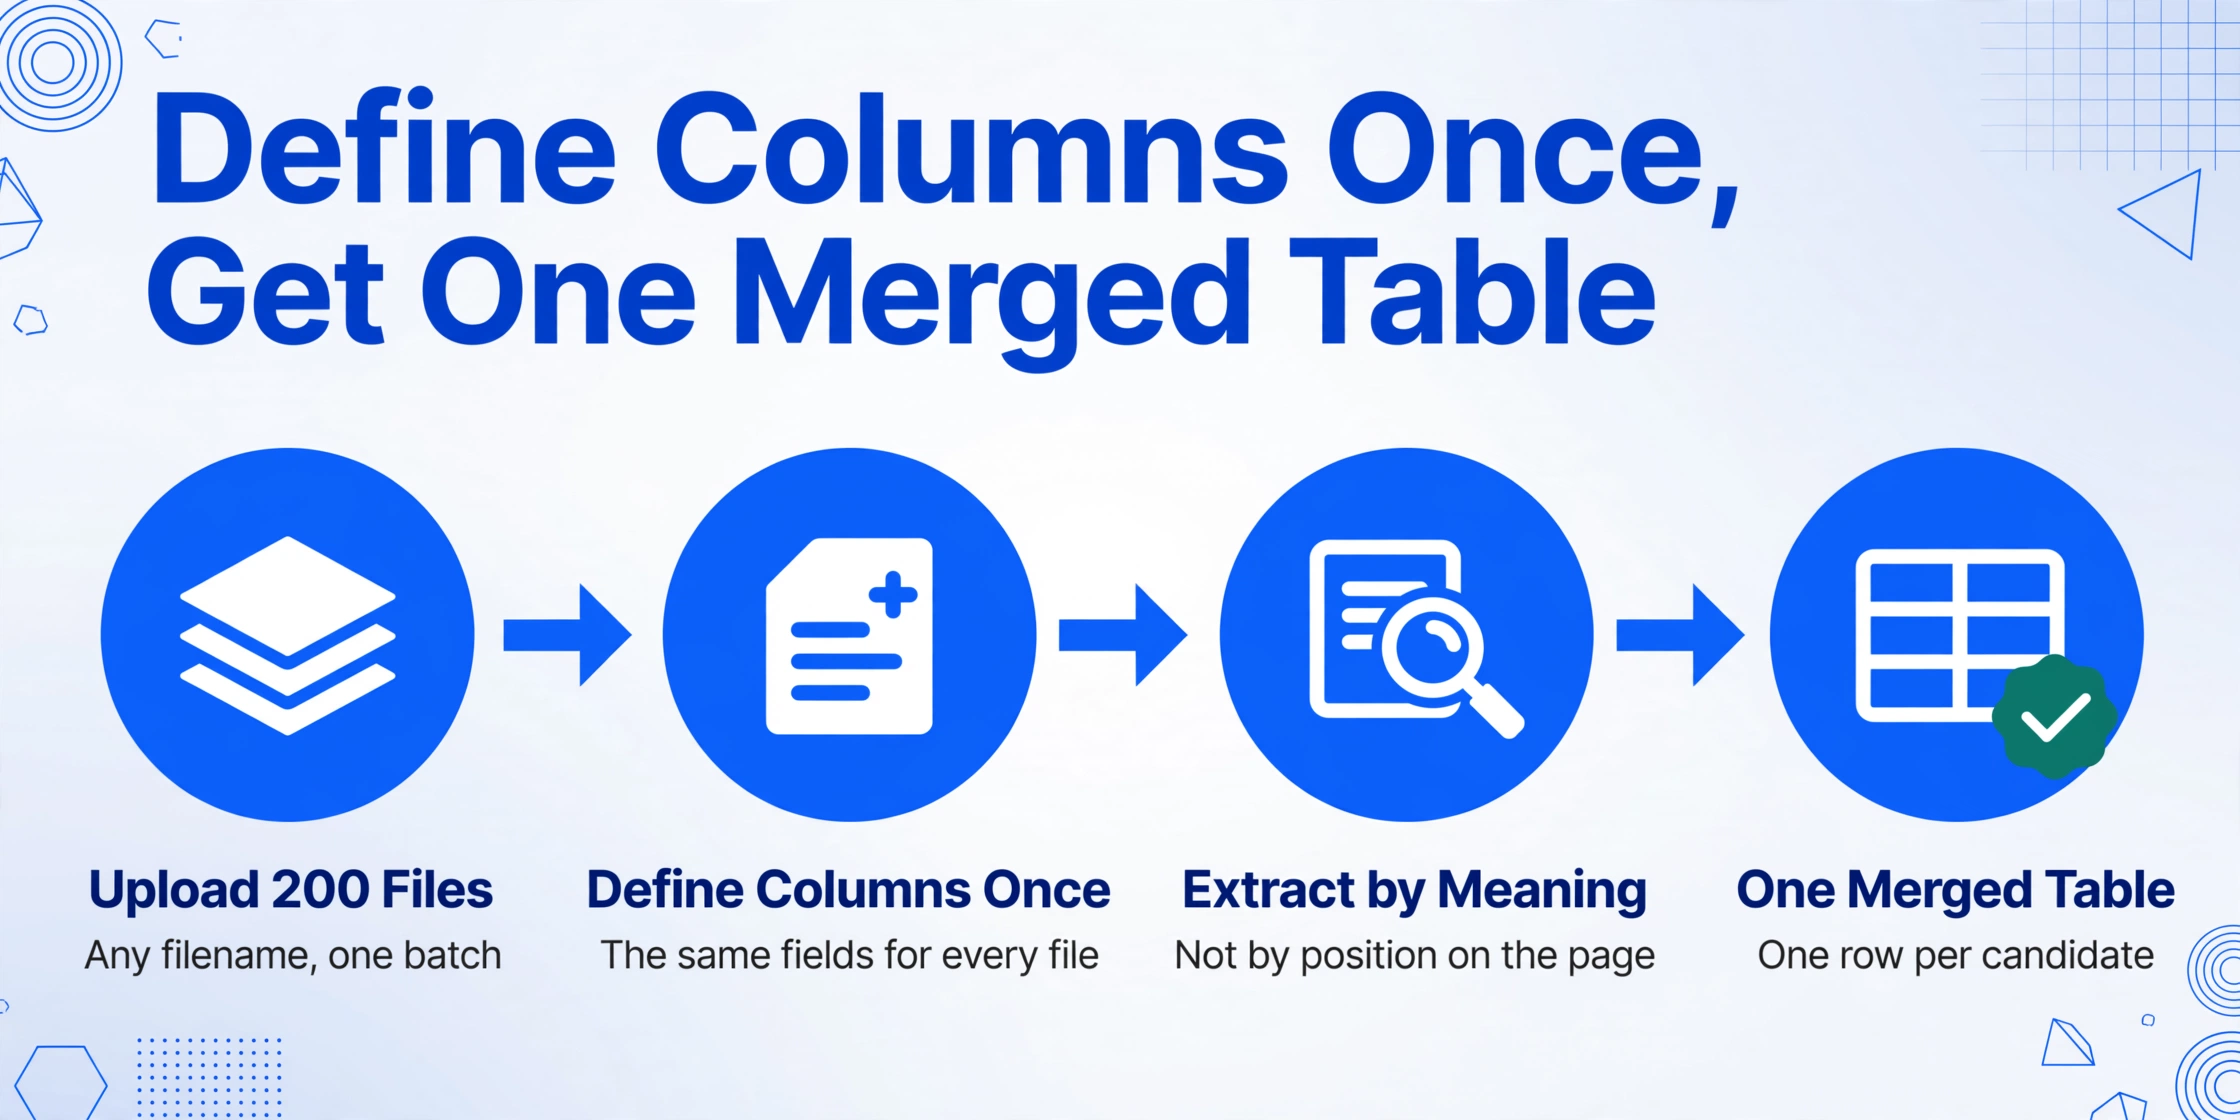
이력서 200개를 하나씩 추출하면 출력물도 200개가 됩니다. 파일 200개, 채팅 응답 200개, 탭 200개 — 그리고 이를 수작업으로 병합하는 일은 피하려던 데이터 입력 부담을 그대로 재현할 뿐입니다.
탈출구는 열 정의를 한 번만 하고 모든 파일에 적용하는 프로세스입니다. 맞춤 열 추출 — ImageToTable.ai의 핵심 메커니즘으로, 원하는 필드 이름을 입력하면 AI가 페이지에서의 위치가 아닌 의미를 이해해 각 값을 찾아냅니다 — 을 사용하면 "성명, 이메일, 현재 직함, 현재 회사, 경력 연수, 핵심 기술"을 한 번 정의하고 파일 200개를 함께 업로드한 뒤, 각 이력서가 한 행을 차지하는 병합된 테이블 하나를 받을 수 있습니다.
두 가지 열 유형이 후보자 데이터베이스를 단순 전사보다 훨씬 유용하게 만듭니다. 추론 열은 AI가 이력서에 문자 그대로 적히지 않은 데이터를 채우게 합니다. 수집 경로에 따라 각 행을 LinkedIn, 추천, 채용 게시판으로 태그하는 "출처" 열이나, 고용 이력의 날짜에서 도출하는 "경력 연수" 열이 그 예입니다. 계산 열은 한 단계 더 나아가 추출 중에 계산을 실행합니다. "통지 기간" 열이 데이터가 스프레드시트에 도달하기 전에 날짜 계산을 해결해 줍니다.
열 정의는 볼륨에 따라 변하지 않으므로, 이것이 바로 이력서 1개에서 200개로 확장되는 정확한 메커니즘입니다. 아래 데모는 사전 설정 템플릿 없이 실행됩니다. 이력서는 공통 형식이 없으므로 필요한 열을 직접 정의하면 AI가 업로드한 어떤 이력서에서든 해당 값을 찾아냅니다. 동일한 열 정의는 유입 경로의 종이 문서 쪽도 처리합니다. 채용 지원서를 Excel로 변환하는 워크플로는 스캔한 지원서에서 경력, 학력, 추천인 정보를 읽어 동일한 병합 테이블에 담습니다.
파일은 안전하게 처리되며 저장되지 않습니다.
필드별 세부 사항이 처음이라면, 이력서 데이터를 Excel로 추출하는 단계별 가이드에서 단일 파일 워크플로, 필드 목록, 규정 준수 측면을 자세히 다룹니다.
배치 문제 3: 파서를 무너뜨리는 5%
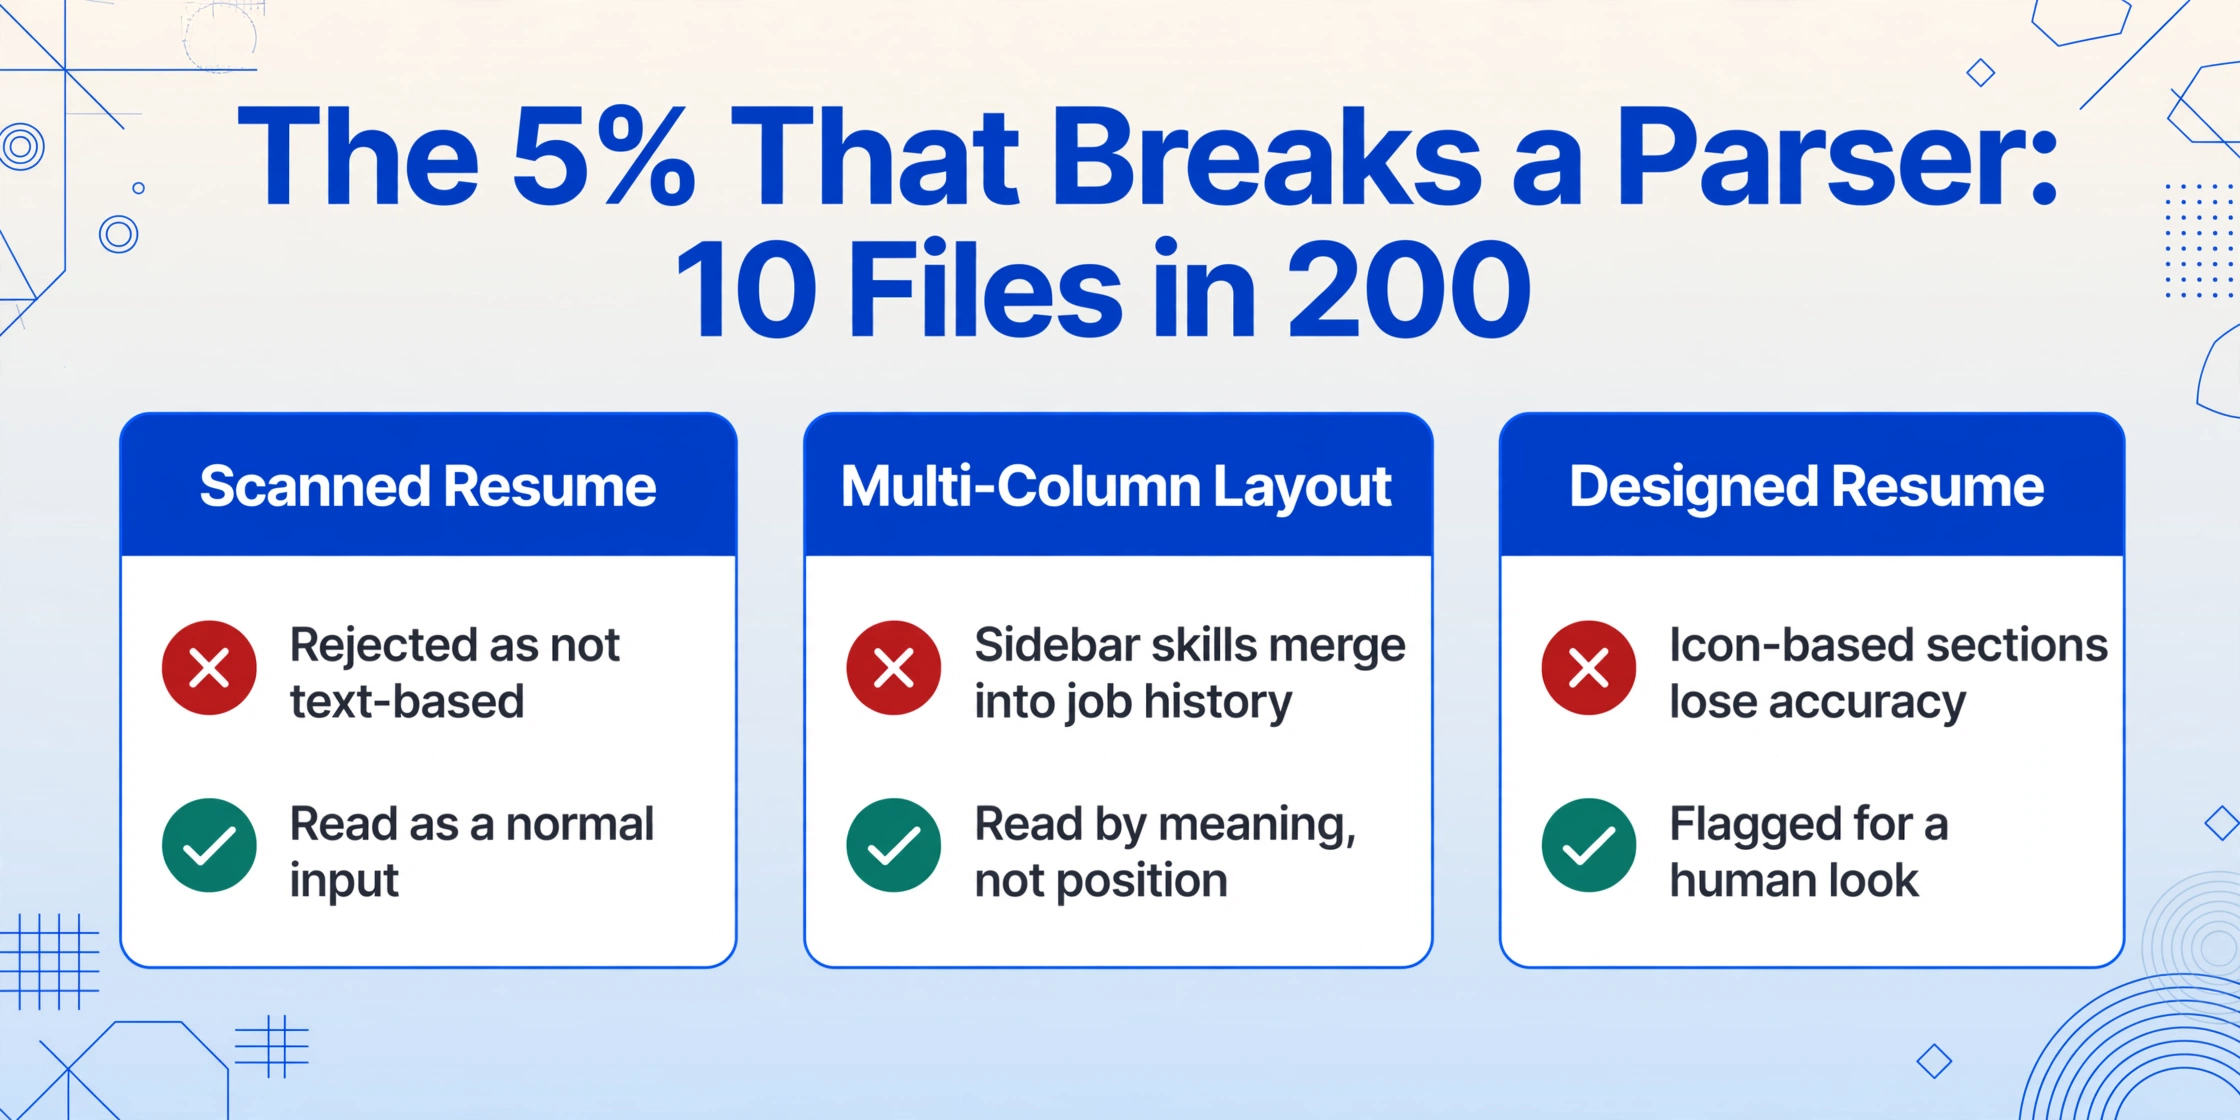
200개 이력서 배치에서 5%의 예외율도 수동 처리가 필요한 10개 파일을 의미하며, 배치 워크플로에서는 바로 그 10개가 전체 프로세스를 멈추게 하는 지점입니다.
가장 흔한 예외는 스캔 또는 이미지 기반 이력서입니다. Breezy HR의 자체 대량 가져오기 문서에 따르면 업로드된 이력서는 텍스트 기반 문서여야 하며 — "스캔본, 이미지, 또는 이미지 기반 PDF는 안 됩니다" — 이를 outright 거부합니다. 이력서 사진을 읽을 수 없는 ATS는 지원자가 실제로 휴대폰에서 지원하는 직무에서 실질적인 제약이 됩니다. 반면 비전 기반 추출 엔진은 사람이 문서를 읽는 것과 같은 방식으로 픽셀을 읽습니다. 사진이나 스캔한 이력서는 예외가 아니라 정상적인 입력입니다.
모든 대규모 배치에서 나타나는 두 가지 다른 예외 클래스가 있습니다: 암호화 또는 비밀번호로 보호된 PDF와 다중 열 또는 과도하게 디자인된 레이아웃. 의미론적 추출은 좌표가 아닌 의미를 읽어 두 가지를 모두 우회하지만, 아이콘 기반 섹션이 있는 과도하게 스타일링된 그래픽 디자이너 이력서는 특정 필드에서 여전히 낮은 신뢰도를 생성할 수 있으며, 이는 실제로 사람의 확인이 필요합니다.
예외를 처리하는 배치 안전 방식은 Bbox 검증이 포함된 검토 모드입니다. 추출된 셀 위에 마우스를 올리거나 클릭하면 도구가 원본 이력서에서 해당 값이 나온 위치를 정확히 강조 표시하며, 반대로 이미지의 영역을 클릭하면 해당 테이블 셀로 이동합니다. 200개 행 전체를 감사하는 대신 AI가 불확실하다고 표시한 몇 개만 검토하고 원본 파일과 대조하여 몇 초 만에 확인할 수 있습니다. 추출 엔진이 벤치마킹한 99% 인쇄 텍스트 정확도에서 200개 이력서 배치는 확인할 가치가 있는 소수의 행만 생성합니다 — 10시간 감사가 아니라요.
확장 가능한 예외 처리 원칙: 잘못된 파일에서 배치를 멈추지 말고, 조용히 건너뛰지도 마세요. 모든 것을 처리하고, 불확실한 필드를 표시한 다음, 해당 행만 인간 검토로 보내세요. 그것이 10시간 감사와 15분 확인의 차이입니다.
복사-붙여넣기 10시간이 채용 소요 기간(Time-to-Fill)에 미치는 영향
채용 소요 기간은 수동 후보자 데이터 작성이 단순한 비효율성을 넘어, 달성하기 어려운 채용 지표가 되는 지점입니다.
SHRM의 2026년 채용 임원 벤치마킹 보고서에 따르면 비임원급 직무의 채용 소요 기간 중앙값은 전년도 44일에서 39일로 단축되었으며, 그 개선 요인 중 하나로 AI 도구 도입을 꼽습니다. 서류 심사만 해도 그중 약 8~9일이 소요됩니다. 단일 200개 이력서 배치에서 수동으로 데이터를 옮기는 데 드는 10~20시간은 바로 이 서류 심사 기간에 속하며, 이는 순수한 오버헤드입니다. 판단이 필요 없고 PDF에서 셀로 텍스트를 옮기는 작업일 뿐입니다.
CNBC 보도는 두 번째 측면을 추가합니다. 미국 HR 전문가 5명 중 1명 이상이 하루 3~5시간을 지원서 검토에만 사용합니다. 채용 담당자가 이미 하루의 3분의 1을 지원서 검토에 쓰고 있는 상황에서, 먼저 표를 만드는 데 드는 시간은 단순한 오차가 아닙니다. 이는 서류를 심사하는 채용 담당자와 데이터를 옮기는 채용 담당자를 가르는 차이입니다.
수동 후보자 데이터 작성은 단순히 느릴 뿐만 아니라, SHRM이 서류 심사에 소요된다고 밝힌 8~9일을 직접적으로 늘립니다. 이력서를 스프레드시트에 복사하는 모든 시간은 후보자를 면접 단계로 진행시키지 못하는 시간이기 때문입니다.
구축한 데이터는 ATS로 가져올 수 있습니다
구축한 스프레드시트는 ATS가 기대하는 바로 그 가져오기 파일입니다. ATS 자체 파서가 이력서 하나를 처리할 필요가 없습니다.
Greenhouse의 대량 후보자 가져오기는 스프레드시트에서 업로드당 최대 8,000행을 허용하지만, 업로드된 이력서 ZIP 파일은 일치하는 이메일이 파싱 가능한 행에만 첨부된다는 제한이 있습니다. Bullhorn의 맞춤 가져오기는 CSV 형식으로 배치당 1,000개 레코드를 처리합니다. Workday의 EIB는 업로드 용량이 30MB로 제한되며 첨부 파일을 지원하지 않습니다. 이 모든 도구는 동일한 구조를 공유합니다. 즉, 후보자 테이블을 가져오며, 행당 한 명의 후보자와 모든 행의 올바른 이메일을 포함한 테이블을 제공해야 합니다.
먼저 추출한 다음 가져오세요. ATS가 요구하는 열로 Excel에 일괄 추출하면, 내보낸 파일이 곧 가져오기 파일입니다. 단일 내보내기로 200명의 후보자 데이터베이스 전체를 Greenhouse, Lever, Workday, iCIMS 또는 BambooHR로 옮길 수 있으며, 내장 파서가 PDF를 처리할 필요가 없습니다. 이것이 바로 당사의 이력서 데이터 추출 to Excel 워크플로우가 구축된 방식이기도 합니다. 하나의 깔끔한 구조화된 파일로, 서류 심사 스프레드시트와 ATS 모두에 바로 사용할 수 있습니다.
서류 심사는 이력서에서 끝나지 않습니다. 배경 조사 to Excel 패스를 통해 각 후보자의 범죄, 고용, 교육 검증 결과가 같은 행의 별도 열로 추가됩니다.
자주 묻는 질문
스캔본이나 이미지로만 된 이력서도 일괄 처리할 수 있나요?
네 — 비전 기반 추출 엔진이 촬영되거나 스캔된 이력서를 일반 입력으로 읽습니다. 많은 ATS 대량 업로드 기능이 이미지 기반 문서를 아예 거부하는 것과 대조적입니다. 스캔 품질은 여전히 중요합니다. 선명한 스캔은 깔끔하게 추출되지만, 심하게 흐릿하거나 기울어진 사진은 신뢰도가 낮은 필드로 표시되어 조용히 채워지지 않고 검토 대상으로 플래그가 지정됩니다.
지원자 데이터베이스에는 어떤 열을 정의해야 하나요?
스크리닝 스프레드시트에 실용적인 핵심 세트: 성명, 이메일, 전화번호, 현재 직함, 현재 회사, 경력 연수, 주요 기술, 위치, 학력, 출처. 추적성을 위해 출처 파일 열을 추가하고, 채용 결정에 의존하는 경우 경력 연수나 퇴사 통보 기간 같은 추론 열 또는 계산 열을 추가하세요. 프로세스에서 실제로 사용하는 것만 추출하세요 — 지원자 데이터베이스는 필터링과 비교를 위한 것이지, 모든 고용 이력을 보관하기 위한 것이 아닙니다.
200개 이력서 배치 처리에는 실제로 얼마나 걸리나요?
이력서 하나당 AI 처리 시간이 약 5~10초이므로, 200개 파일 배치는 약 20~35분 안에 완료됩니다 — 그 시간 동안 여러분이 할 일은 없습니다. 검토 시간은 플래그가 지정된 필드 수에 따라 달라집니다. 비전 모델이 깨끗한 인쇄 이력서에서 도달하는 정확도 수준에서는 전체 감사가 아니라 확인할 가치가 있는 몇 개의 행만 예상하면 됩니다. 같은 분량을 수동으로 입력하는 데 걸리는 10~20시간과 비교해 보세요.
어떤 행이 어떤 이력서에서 왔는지 어떻게 알 수 있나요?
배치 내보내기에는 각 원본 문서의 파일명을 기록하는 자동 출처 파일 열이 포함되므로, 파일 이름이 "resume.pdf"여도 모든 행이 출처 파일을 참조합니다. 추가 추적성을 위해 업로드 전에 제어 가능한 파일을 성_이름_출처 규칙으로 이름을 바꾸세요 — 파일명이 감사 추적의 일부가 되고 여러 채널에서 중복 지원자를 찾는 데 도움이 됩니다.
Greenhouse, Lever 또는 Workday로 결과를 가져올 수 있나요?
네. 먼저 깔끔한 스프레드시트로 추출한 다음 각 플랫폼의 표준 후보자 가져오기 기능을 사용하세요: Greenhouse 대량 가져오기, Bullhorn 맞춤 가져오기, 또는 Workday EIB. 추출된 파일에는 이미 검증된 이메일 열이 있는 후보자별 행이 하나씩 있으므로 깔끔하게 가져와지며, 각 플랫폼의 내장 이력서 파서를 완전히 건너뜁니다.
배치 추출은 이력서 파서 API와 어떻게 다른가요?
이력서 파서 API(Textkernel, RChilli, Affinda, Daxtra)는 고정된 이력서 스키마로 학습되고 문서당 비용이 청구되며, 통합해야 하는 구조화된 JSON을 반환합니다. 배치 추출은 사용자가 정의한 열로 모든 문서를 읽고, 이력서 스키마에 묶인 파일별 수수료가 없으며, 열고 필터링하고 ATS로 가져올 수 있는 스프레드시트로 직접 출력합니다. 팀이 이력서 외에도 제안서, 온보딩 양식, 계약서 등 더 많은 문서를 처리한다면 하나의 추출 워크플로우로 모두 처리할 수 있으며, 그래서 동일한 배치 접근 방식이 자연스럽게 직원 문서 데이터베이스로 확장됩니다.
이력서 200장은 이력서 1장 문제의 더 큰 버전이 아니라 다른 범주의 문제이며, 더 많이 입력하는 대신 명명, 병합, 예외 처리로 해결됩니다. 구축하는 후보자 데이터베이스는 모든 심사 결정의 기반이 됩니다. 문제는 손으로 만들지, 한 번에 만들지입니다.
직접 이력서 더미로 사용해 보기