200 currículos, um banco de candidatos:
Como fazer a triagem sem copiar e colar
A reportagem da CNBC sobre o ciclo de contratação de 2025 descobriu que uma vaga popular pode atrair de 300 a 500 candidaturas em três dias — e mais de mil em um fim de semana — enquanto os recrutadores gastam de 30 segundos a 2 minutos em cada currículo (CNBC). Ninguém contesta o volume da triagem. O que ninguém quantifica é a etapa que vem antes da triagem: transformar aquela pilha de PDFs em uma planilha que você realmente consiga classificar.
Principais conclusões
- 200 currículos não são uma versão maior de um problema de um currículo — é uma categoria diferente de trabalho, e a velocidade da triagem não é o que está quebrando.
- De 10 a 20 horas desaparecem em transcrição manual antes que um único candidato seja triado, consumindo a maior parte dos 8 a 9 dias que a SHRM atribui à triagem em um prazo de 39 dias para preencher a vaga.
- Defina suas colunas uma vez, processe todos os 200 arquivos em um único lote e revise apenas as linhas sinalizadas — um recrutador que extrai para de transcrever e começa a triar.
O Que Muda Quando Chegam 200 Currículos em Vez de Um
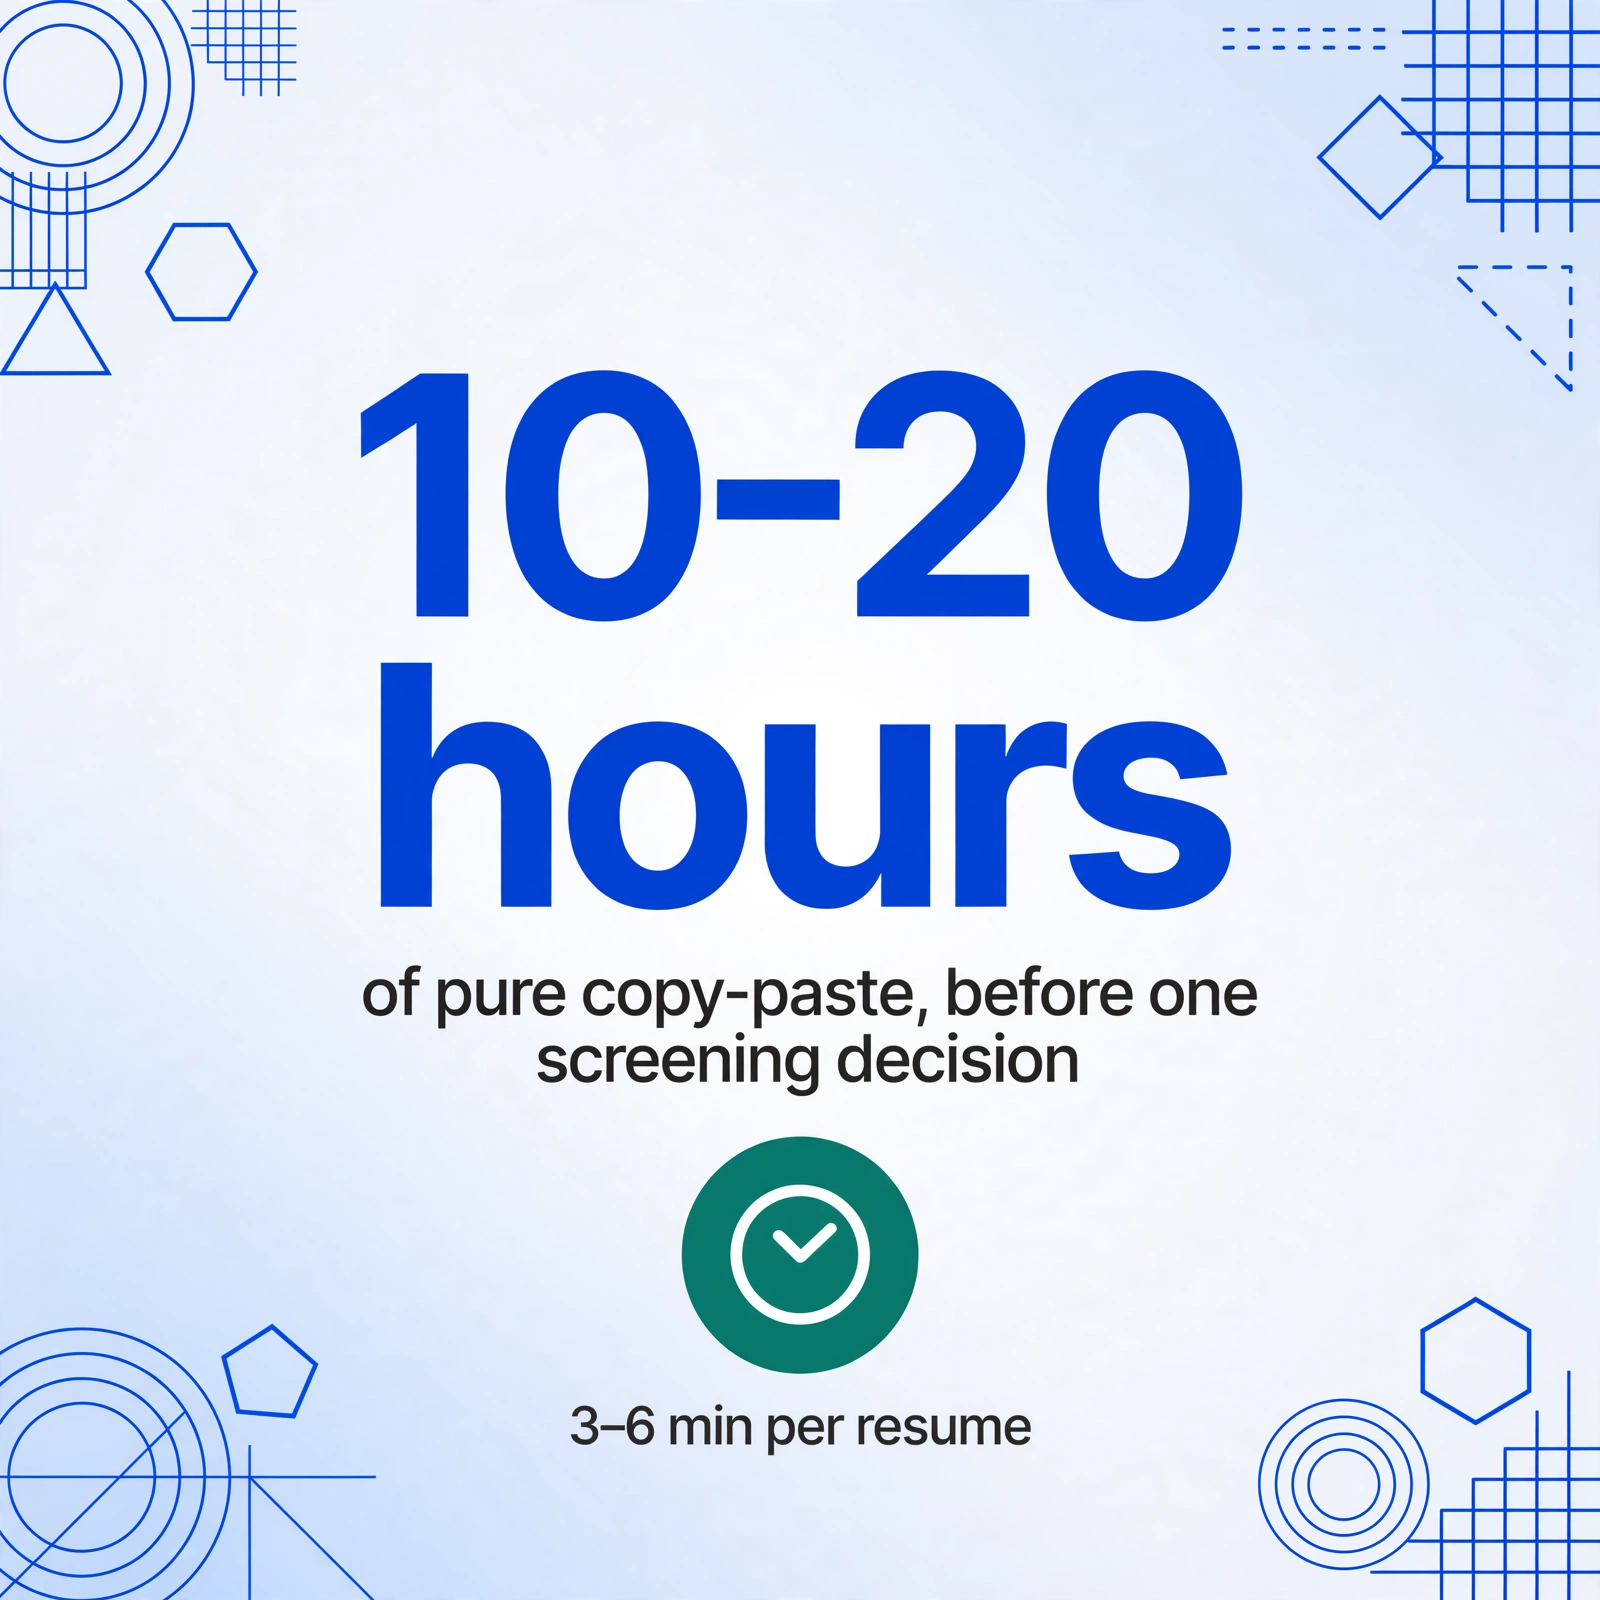
Duzentos currículos não são duzentas vezes o trabalho de um currículo — é uma categoria diferente de trabalho. Nos 3 a 6 minutos por currículo que a transcrição manual realmente custa, um pipeline de 200 candidatos soma de 10 a 20 horas de puro copiar e colar antes que alguém tenha tomado uma única decisão de triagem.
É por isso que um tópico do r/ResumeExperts descreve exatamente o estágio sobre o qual este artigo trata: "escalar de 50 para 200 é exatamente o estágio em que o recrutamento começa a parecer triagem em vez de estratégia." Abaixo de 50, você mantém o contexto de cada candidato na cabeça. Com 200, esse contexto se perde — e três problemas que eram invisíveis em pequenos volumes assumem o controle: arquivos que você não consegue distinguir, resultados que não se mesclam e um punhado de currículos que quebram qualquer ferramenta que você esteja usando.
O volume de triagem não é o gargalo que a maioria das equipes encontra. O gargalo é a etapa anterior à triagem — construir uma tabela estruturada de candidatos a partir de 200 documentos não estruturados — e essa etapa é quase inteiramente manual.
Problema de Lote 1: Arquivos Chamados "resume.pdf"
Em um lote, o nome do arquivo é a única identidade que um documento tem até você abri-lo — e a maioria dos arquivos de currículo foi nomeada por pessoas que nunca esperavam ser uma entre duzentas.
A realidade é a mesma em fóruns de recrutamento e tópicos de profissionais: arquivos chegando como "Meu CV", "CV Atualizado", "Final final CV" e — para todos — "resume.pdf". Quando dois candidatos enviam arquivos com nomes idênticos para a mesma pasta ou a mesma zona de upload do ATS, um pode sobrescrever o outro silenciosamente. O candidato cujo arquivo sobreviveu agora é inidentificável, porque "resume.pdf" não diz nada sobre quem ele pertence.
A solução não é uma campanha de disciplina de nomenclatura voltada aos candidatos — você vai perder essa guerra. A solução é fazer a identidade da linha substituir a identidade do nome do arquivo. Quando você processa um lote com uma ferramenta que registra uma coluna Source File — uma coluna automática que registra qual documento produziu cada linha — cada candidato carrega uma referência de volta ao seu arquivo original, qualquer que fosse o nome. A verificação se torna uma operação de filtro: ordene por origem, não um jogo de adivinhação sobre qual "CV.pdf" pertence a quem.
Para os arquivos que você controla, uma convenção de nomenclatura ainda se paga: lastName_firstName_source (por exemplo, chen_mei_linkedin) transforma o nome do arquivo de origem em uma trilha de auditoria instantânea e uma dica de deduplicação quando o mesmo candidato aparece de dois canais.
Problema de Lote 2: 200 Arquivos, Uma Tabela
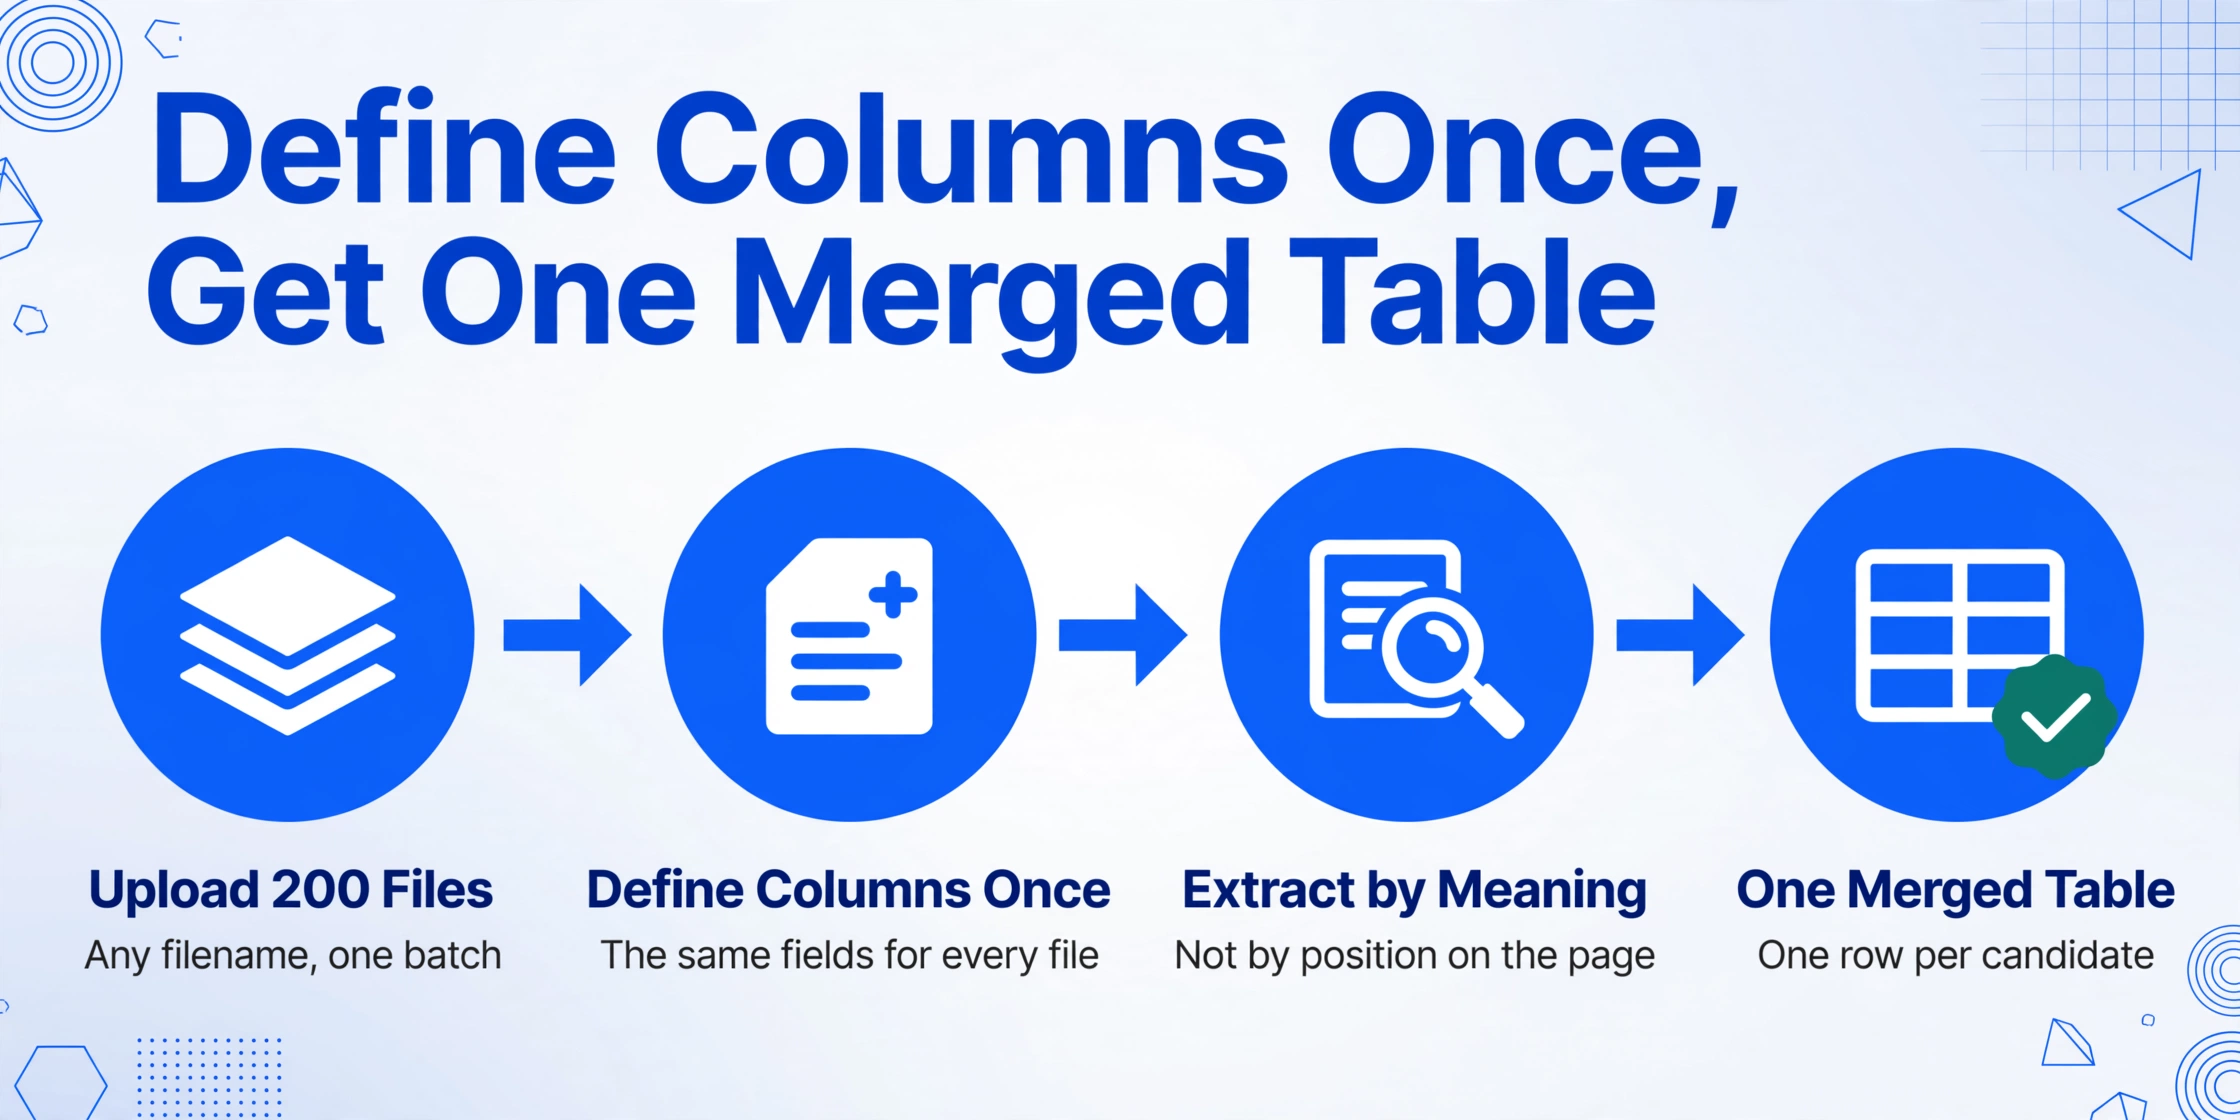
Extraia 200 currículos um de cada vez e você obtém 200 saídas separadas — 200 arquivos, 200 respostas de chat, 200 abas — e o trabalho de mesclá-los manualmente recria exatamente a carga de digitação de dados que você tentava evitar.
A saída é um processo em que suas definições de coluna são definidas uma vez e se aplicam a todos os arquivos. Com Extração de Colunas Personalizadas — o mecanismo central do ImageToTable.ai em que você digita os nomes dos campos desejados e a IA localiza cada valor entendendo seu significado em vez de sua posição na página — você define "Nome Completo, E-mail, Cargo Atual, Empresa Atual, Anos de Experiência, Principais Habilidades" uma vez, envia todos os 200 arquivos juntos e recebe uma tabela mesclada em que cada currículo contribui com uma linha.
Dois tipos de coluna tornam um banco de dados de candidatos mais útil do que uma transcrição bruta. As colunas inferidas permitem que a IA preencha dados que não estão literalmente escritos no currículo: uma coluna "Origem" que marca cada linha como LinkedIn, indicação ou site de vagas com base em onde você a coletou, ou uma coluna "Anos de Experiência" derivada das datas no histórico profissional. As colunas calculadas vão além e executam cálculos durante a extração — uma coluna "Aviso Prévio (Data Alvo − Disponível A Partir De)" que resolve a matemática de datas antes que os dados cheguem à sua planilha.
Este é exatamente o mecanismo que escala de um currículo para duzentos, porque as definições de coluna não mudam com o volume. A demonstração abaixo funciona sem modelo predefinido — os currículos não compartilham um formato comum, então você define as colunas necessárias, e a IA as encontra em qualquer currículo que você enviar. As mesmas definições de coluna cobrem o lado em papel do funil — o fluxo de trabalho formulário de candidatura para Excel lê histórico profissional, formação e referências de candidaturas digitalizadas para essa mesma tabela mesclada.
Os arquivos são processados com segurança e não são armazenados.
Se você é novo nos detalhes campo a campo — quais colunas importam, como lidar com dados de candidatos de forma responsável e onde ferramentas do tipo parser falham — nosso guia passo a passo para extrair dados de currículos para o Excel cobre o fluxo de arquivo único, a lista de campos e o lado da conformidade em profundidade.
Problema de lote 3: os 5% que quebram um parser
Mesmo uma taxa de exceção de 5% em um lote de 200 currículos significa 10 arquivos que precisam de tratamento manual — e em um fluxo de lote, esses 10 são exatamente onde todo o processo trava.
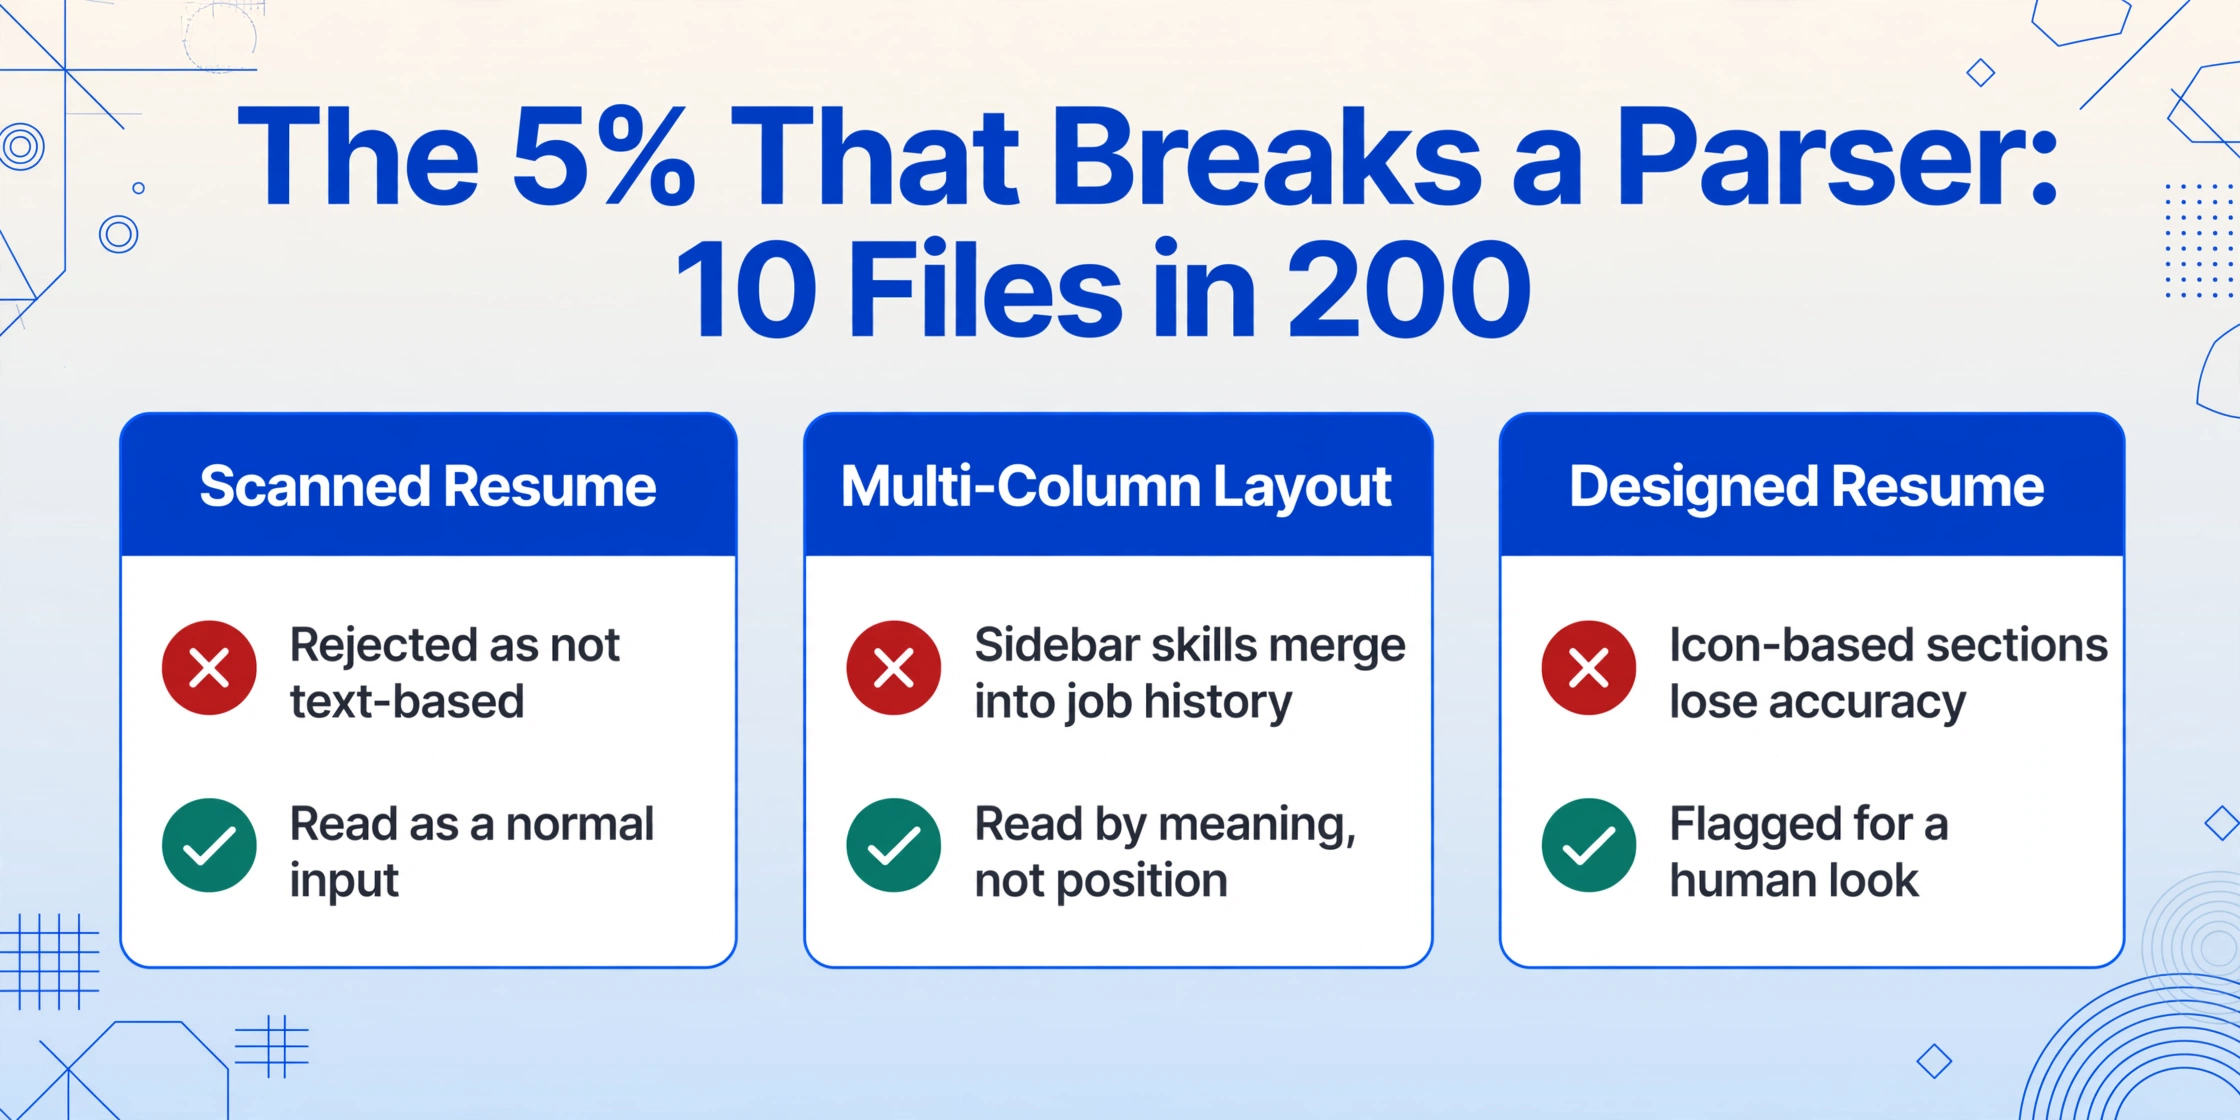
A exceção mais comum é o currículo escaneado ou baseado em imagem. A própria documentação de importação em massa do Breezy HR afirma que os currículos enviados devem ser documentos baseados em texto (DOCX, TXT, RTF, ODT ou PDF) — "não cópias escaneadas, imagens ou PDFs baseados em imagem" — que ele rejeita de imediato (documentação do Breezy HR). Um ATS que não consegue ingerir uma foto de currículo é uma restrição real para cargos em que os candidatos legitimamente se candidatam pelo celular. Um mecanismo de extração baseado em visão, por outro lado, lê os pixels da mesma forma que um humano lê o documento — um currículo fotografado ou escaneado é uma entrada normal, não uma exceção.
Outras duas classes de exceção aparecem em todo lote grande: PDFs criptografados ou protegidos por senha (comuns quando os candidatos se candidatam por canais de e-mail seguros) e layouts multicoluna ou muito elaborados que embaralham parsers baseados em posição ao mesclar habilidades da barra lateral no histórico profissional. A extração semântica contorna ambos ao ler o significado, não as coordenadas — embora currículos altamente estilizados de designers gráficos com seções baseadas em ícones ainda possam produzir menor confiança em campos específicos, e esses realmente precisam de uma olhada humana.
A forma segura para lotes de lidar com exceções é o Modo de Revisão com verificação por Bbox: passe o mouse ou clique em qualquer célula extraída e a ferramenta destaca exatamente de onde aquele valor veio no currículo original — e o inverso, clique em uma região da imagem e vá para a célula correspondente na tabela. Em vez de auditar todas as 200 linhas, você revisa o punhado que a IA sinalizou como incerto e confirma cada uma contra o arquivo original em segundos. Com a precisão de 99% em texto impresso que nosso mecanismo de extração alcança, um lote de 200 currículos produz um pequeno número de linhas que vale a pena verificar — não uma auditoria de 10 horas.
O princípio de tratamento de exceções que escala: não pare o lote por causa de um arquivo ruim, e também não o ignore silenciosamente. Processe tudo, sinalize os campos incertos e encaminhe apenas essas linhas para revisão humana. Essa é a diferença entre uma auditoria de 10 horas e uma verificação de 15 minutos.
O que 10 horas de copiar e colar fazem com seu tempo de preenchimento
O tempo de preenchimento é onde a construção manual de candidatos deixa de ser uma pequena ineficiência e passa a ser uma métrica de recrutamento que você não consegue atingir.
O relatório Recruiting Executives Benchmarking de 2026 da SHRM coloca o tempo mediano de preenchimento para cargos não executivos em 39 dias — abaixo dos 44 do ano anterior — e atribui parte dessa melhoria à adoção de ferramentas de IA; só a triagem consome cerca de 8 a 9 desses dias (SHRM Recruiting Benchmarking). As 10 a 20 horas de transcrição manual de um único lote de 200 currículos ficam bem dentro dessa janela de triagem, e são puro custo operacional: nenhum julgamento envolvido, apenas mover texto de PDFs para células.
A reportagem da CNBC acrescenta a segunda dimensão — mais de um em cada cinco profissionais de RH nos EUA passa de 3 a 5 horas por dia apenas revisando candidaturas. Quando um recrutador já consome um terço do dia revisando candidaturas, as horas gastas construindo a tabela primeiro não são um erro de arredondamento. São a diferença entre um recrutador que triagem e um recrutador que transcreve.
A construção manual de candidatos não apenas parece lenta — ela infla diretamente os 8-9 dias que a SHRM atribui à triagem, porque cada hora gasta copiando currículos para uma planilha é uma hora não gasta movendo candidatos para a entrevista.
Seu ATS pode importar o que você construiu
A planilha que você constrói é exatamente o arquivo de importação que seu ATS espera — você não precisa do parser próprio do ATS para tocar em um único currículo.
A importação em massa de candidatos do Greenhouse aceita até 8.000 linhas por upload de uma planilha, com a ressalva de que um zip de currículos enviado só se anexa a linhas onde um e-mail correspondente seja analisável (documentação do Greenhouse). A importação personalizada do Bullhorn aceita 1.000 registros por lote em CSV. O EIB do Workday tem um limite de upload de 30MB e nenhum anexo. Todos esses compartilham o mesmo formato: eles importam uma tabela de candidatos, e esperam que você a forneça — com uma linha por candidato e um e-mail correto em cada linha.
Extraia primeiro, depois importe. Quando você extrai em lote para o Excel com as colunas que seu ATS exige — incluindo uma coluna de e-mail corretamente preenchida, que a extração deve verificar — o arquivo exportado é o arquivo de importação. Uma única exportação leva todo o seu banco de 200 candidatos para o Greenhouse, Lever, Workday, iCIMS ou BambooHR sem que seus parsers integrados jamais vejam um PDF. Essa também é a abordagem em torno da qual nosso fluxo de trabalho de extração de dados de currículos para Excel foi construído: um arquivo estruturado limpo, pronto tanto para sua planilha de triagem quanto para seu ATS.
A triagem não para no currículo: uma passagem de verificação de antecedentes para Excel adiciona os resultados de verificação criminal, empregatícia e educacional de cada candidato como colunas próprias na mesma linha.
Perguntas Frequentes
Posso processar em lote currículos escaneados ou somente com imagem?
Sim — um mecanismo de extração baseado em visão lê currículos fotografados e escaneados como entrada normal, ao contrário de muitos recursos de upload em massa de ATS que rejeitam documentos baseados em imagem de imediato (a documentação do Breezy HR, por exemplo, afirma que uploads em massa devem ser baseados em texto). A qualidade do escaneamento ainda importa: escaneamentos nítidos são extraídos com clareza, enquanto fotos muito desfocadas ou inclinadas produzirão campos com menor confiança que são sinalizados para revisão em vez de preenchidos silenciosamente.
Quais colunas devo definir para um banco de dados de candidatos?
Um conjunto central prático para uma planilha de triagem: Nome Completo, E-mail, Telefone, Cargo Atual, Empresa Atual, Anos de Experiência, Principais Habilidades, Localização, Formação e Origem (de onde o candidato veio). Adicione uma coluna Arquivo de Origem para rastreabilidade, além de colunas inferidas ou calculadas como Anos de Experiência ou Período de Aviso, se suas decisões de contratação dependerem delas. Extraia apenas o que seu processo utiliza — um banco de dados de candidatos serve para filtrar e comparar, não para arquivar cada linha do histórico profissional.
Quanto tempo leva um lote de 200 currículos na prática?
Cada currículo leva cerca de 5 a 10 segundos de tempo de processamento de IA, então um lote de 200 arquivos é concluído em cerca de 20 a 35 minutos — tempo que você não gasta fazendo nada. O tempo de revisão depende de quantos campos são sinalizados; nas taxas de precisão que os modelos de visão alcançam em currículos impressos nítidos, espere um pequeno número de linhas para verificar, não uma auditoria completa. Compare isso com 10 a 20 horas de transcrição manual para o mesmo volume.
Como sei de qual currículo veio cada linha?
As exportações em lote incluem uma coluna automática Arquivo de Origem que registra o nome do arquivo de cada documento de origem, então cada linha referencia seu arquivo de origem mesmo quando o arquivo se chamava "resume.pdf". Para rastreabilidade extra, renomeie os arquivos que você controla com uma convenção lastName_firstName_source antes do upload — o nome do arquivo passa a fazer parte da trilha de auditoria e ajuda a identificar candidatos duplicados de vários canais.
Posso importar os resultados para o Greenhouse, Lever ou Workday?
Sim. Extraia primeiro para uma planilha limpa e depois use a importação padrão de candidatos de cada plataforma: importação em massa do Greenhouse (até 8.000 linhas por upload, exige um e-mail correspondente em cada linha), importação personalizada do Bullhorn (1.000 registros por lote, CSV) ou EIB do Workday (limite de 30MB). Como o arquivo extraído já tem uma linha por candidato com uma coluna de e-mail verificado, ele é importado sem problemas — e você pula completamente o analisador de currículos integrado de cada plataforma.
Qual é a diferença entre a extração em lote e uma API de analisador de currículos?
As APIs de analisador de currículos (Textkernel, RChilli, Affinda, Daxtra) são treinadas em um esquema fixo de currículo, cobram por documento e retornam JSON estruturado que você ainda precisa integrar. A extração em lote lê qualquer documento pelas colunas que você define, não tem taxa por arquivo vinculada a um esquema de currículo e gera a saída diretamente em uma planilha que você pode abrir, filtrar e importar para um ATS. Se sua equipe lida com mais do que currículos — cartas de oferta, formulários de integração, contratos — um único fluxo de extração cobre todos eles, e é por isso que a mesma abordagem em lote se estende naturalmente a um banco de dados de documentos de funcionários.
Uma pilha de 200 currículos não é uma versão maior de um problema de um currículo — é uma categoria diferente de problema, e é resolvida com nomeação, mesclagem e tratamento de exceções em vez de mais digitação. O banco de dados de candidatos que você cria é a base sobre a qual cada decisão de triagem se apoia; a questão é se você o constrói à mão ou de uma vez.
Experimente na sua própria pilha de currículos