履歴書200件を1つの候補者データベースに:
コピペなしでスクリーニングする方法
CNBCの2025年採用サイクルに関する報道によると、人気の求人には3日間で300〜500件の応募が集まり、週末には1,000件を超えることもあります。一方、リクルーターは1件の履歴書につき30秒〜2分しか費やしません(CNBC)。スクリーニングの量が膨大であることは誰も否定しません。しかし、誰も定量化していないのが、スクリーニングの前のステップ、つまりPDFの山を実際に並べ替え可能なスプレッドシートに変換する作業です。
重要ポイント
- 履歴書200件は、履歴書1件の問題の拡大版ではありません。これは別のカテゴリの作業であり、ボトルネックとなっているのはスクリーニングの速度ではありません。
- 1人の候補者をスクリーニングする前に、手作業での転記に10〜20時間が費やされています。これは、SHRMが採用所要日数39日のうちスクリーニングに要するとしている8〜9日の大半を占めます。
- 列を一度定義すれば、200件すべてのファイルを1つのバッチで処理し、フラグが付いた行だけをレビューできます。抽出を行うリクルーターは、転記をやめてスクリーニングを始められます。
200通の履歴書が届いたとき、何が変わるのか
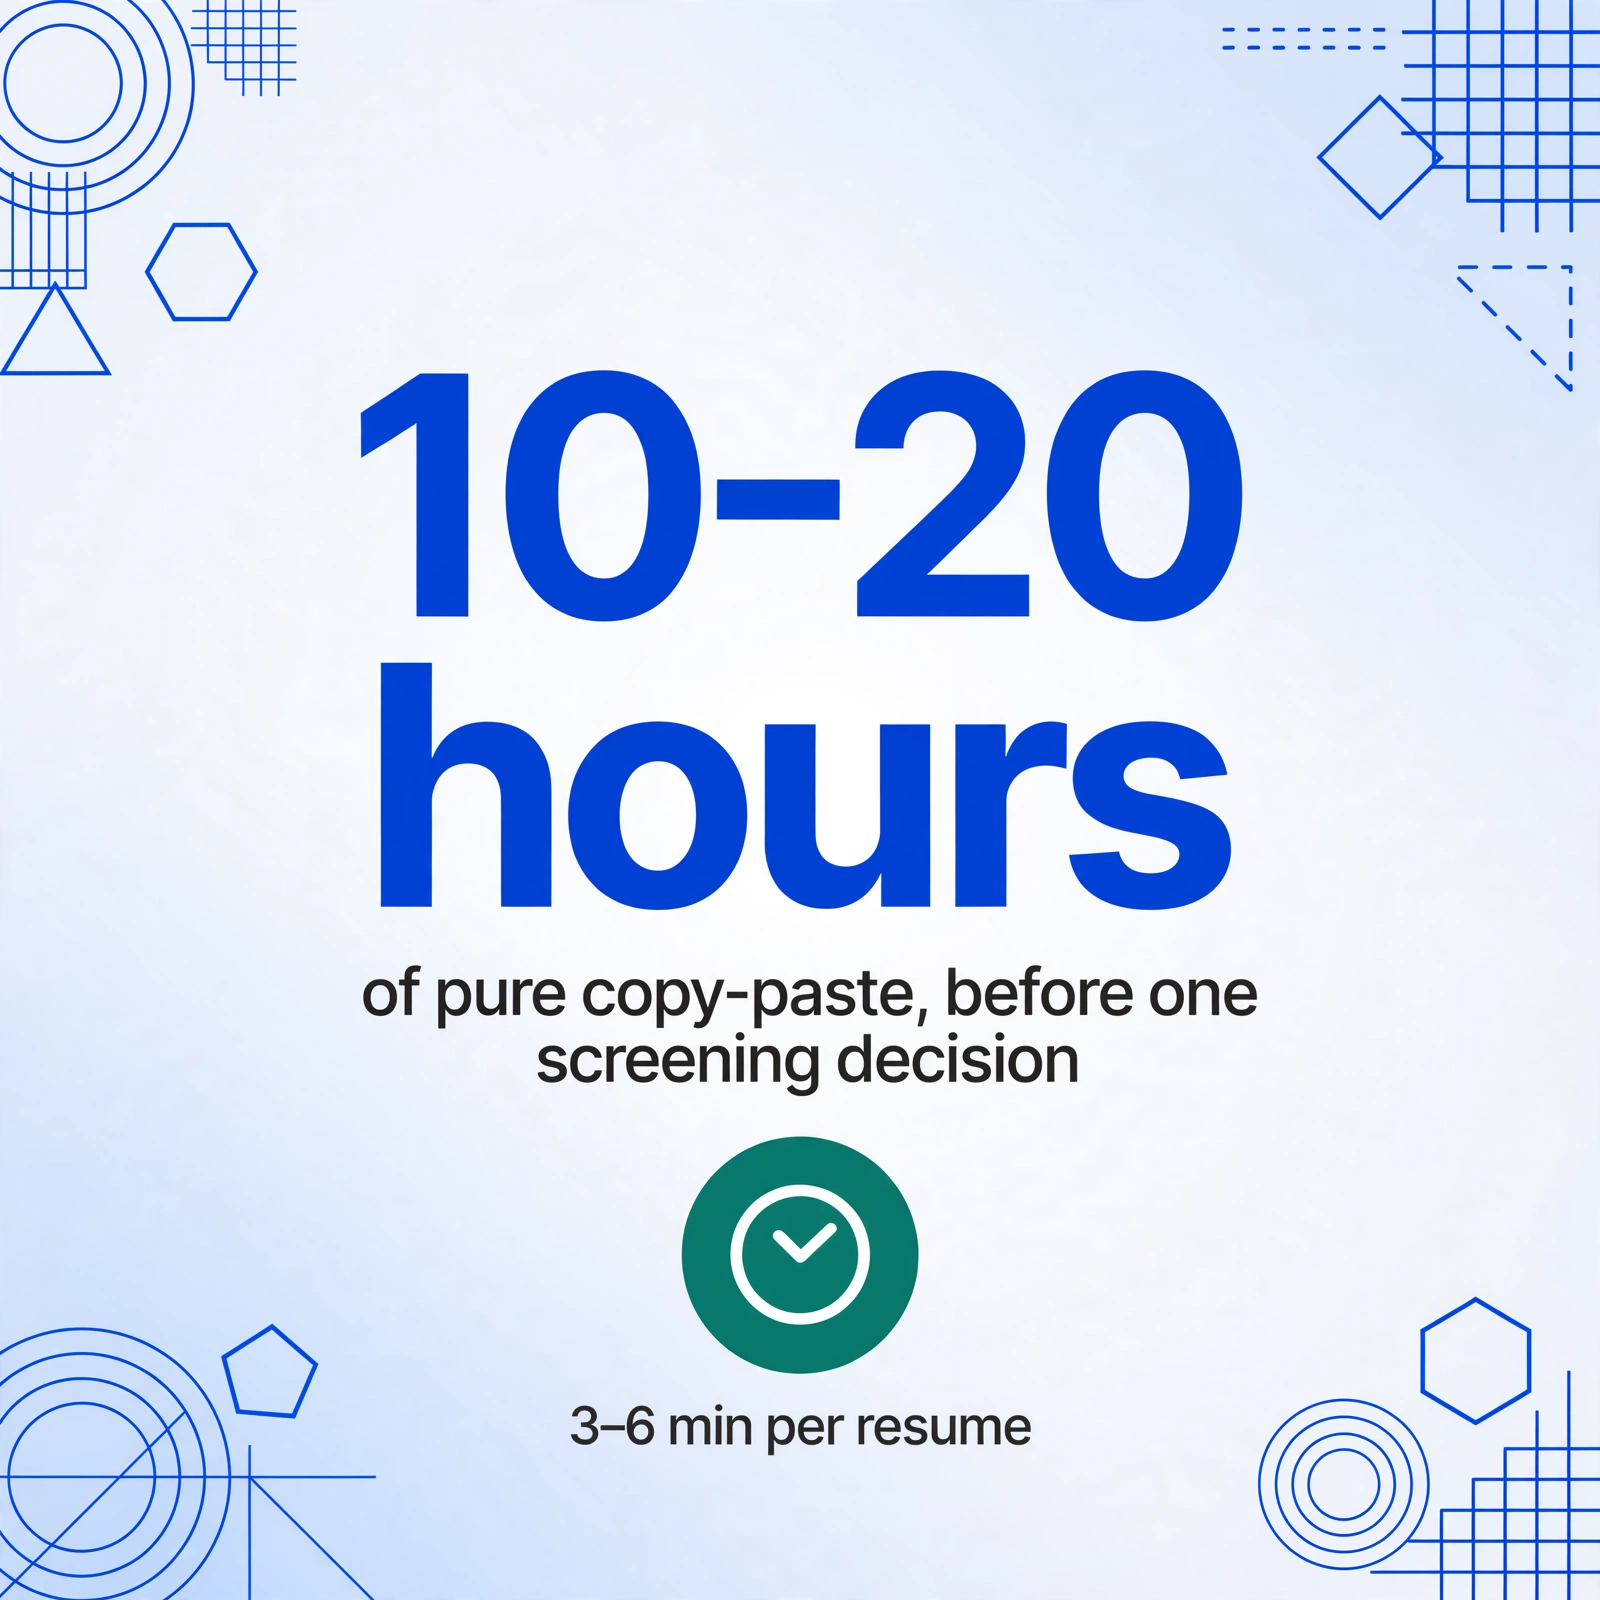
200通の履歴書は、1通の履歴書の200倍の作業ではありません。それは別の種類の作業です。手動での転記に実際にかかる1通あたり3〜6分を考えると、200人の候補者パイプラインでは、誰も1回のスクリーニング判断を下す前に、純粋なコピー&ペーストだけで10〜20時間が積み上がります。
その計算が、ある r/ResumeExperts のスレッドが、この記事が扱うまさにその段階を「50から200へのスケーリングは、採用が戦略ではなくトリアージのように感じられ始めるまさにその段階だ」と説明している理由です。50人未満なら、すべての候補者の文脈を頭の中に保持できます。200人になると、その文脈は消え去り、小規模なボリュームでは見えなかった3つの問題が支配的になります。区別できないファイル、統合できない結果、そして使用しているツールを壊す少数の履歴書です。
スクリーニングのボリュームが、ほとんどのチームが直面するボトルネックではありません。ボトルネックはスクリーニングの前のステップ、つまり200通の非構造化ドキュメントから構造化された候補者テーブルを構築するステップであり、そのステップはほぼ完全に手動です。
バッチ問題1:「resume.pdf」という名前のファイル
バッチ処理では、ファイル名は開くまでドキュメントが持つ唯一の識別情報です。そして、ほとんどの履歴書ファイルは、自分が200通のうちの1通になるとは思っていなかった人によって命名されています。
現実は、採用フォーラムや実務者のスレッドの間で同じです。「My CV」「Updated CV」「Final final CV」、そして誰にとっても「resume.pdf」として届くファイル。2人の候補者が同じ名前のファイルを同じフォルダまたは同じATSドロップゾーンにアップロードすると、一方が他方を静かに上書きする可能性があります。生き残ったファイルの候補者は、「resume.pdf」が誰のものか何も教えてくれないため、特定できなくなります。
修正策は、応募者を対象とした命名規則キャンペーンではありません。その戦争には負けるでしょう。修正策は、ファイル名の識別情報を行の識別情報で置き換えることです。どのドキュメントが各行を生成したかを記録する自動列であるソースファイル列を記録するツールでバッチを処理すると、各候補者は元のファイル(それが何と呼ばれていても)への参照を保持します。検証はフィルター操作になります。「CV.pdf」が誰のものかという推測ゲームではなく、ソースで並べ替えるだけです。
自分が管理するファイルについては、命名規則は依然として価値があります。lastName_firstName_source(例:chen_mei_linkedin)は、ソースファイル名を即時の監査証跡と、同じ候補者が2つのチャネルから現れた場合の重複排除のヒントに変えます。
バッチ問題2:200ファイルを1つのテーブルに
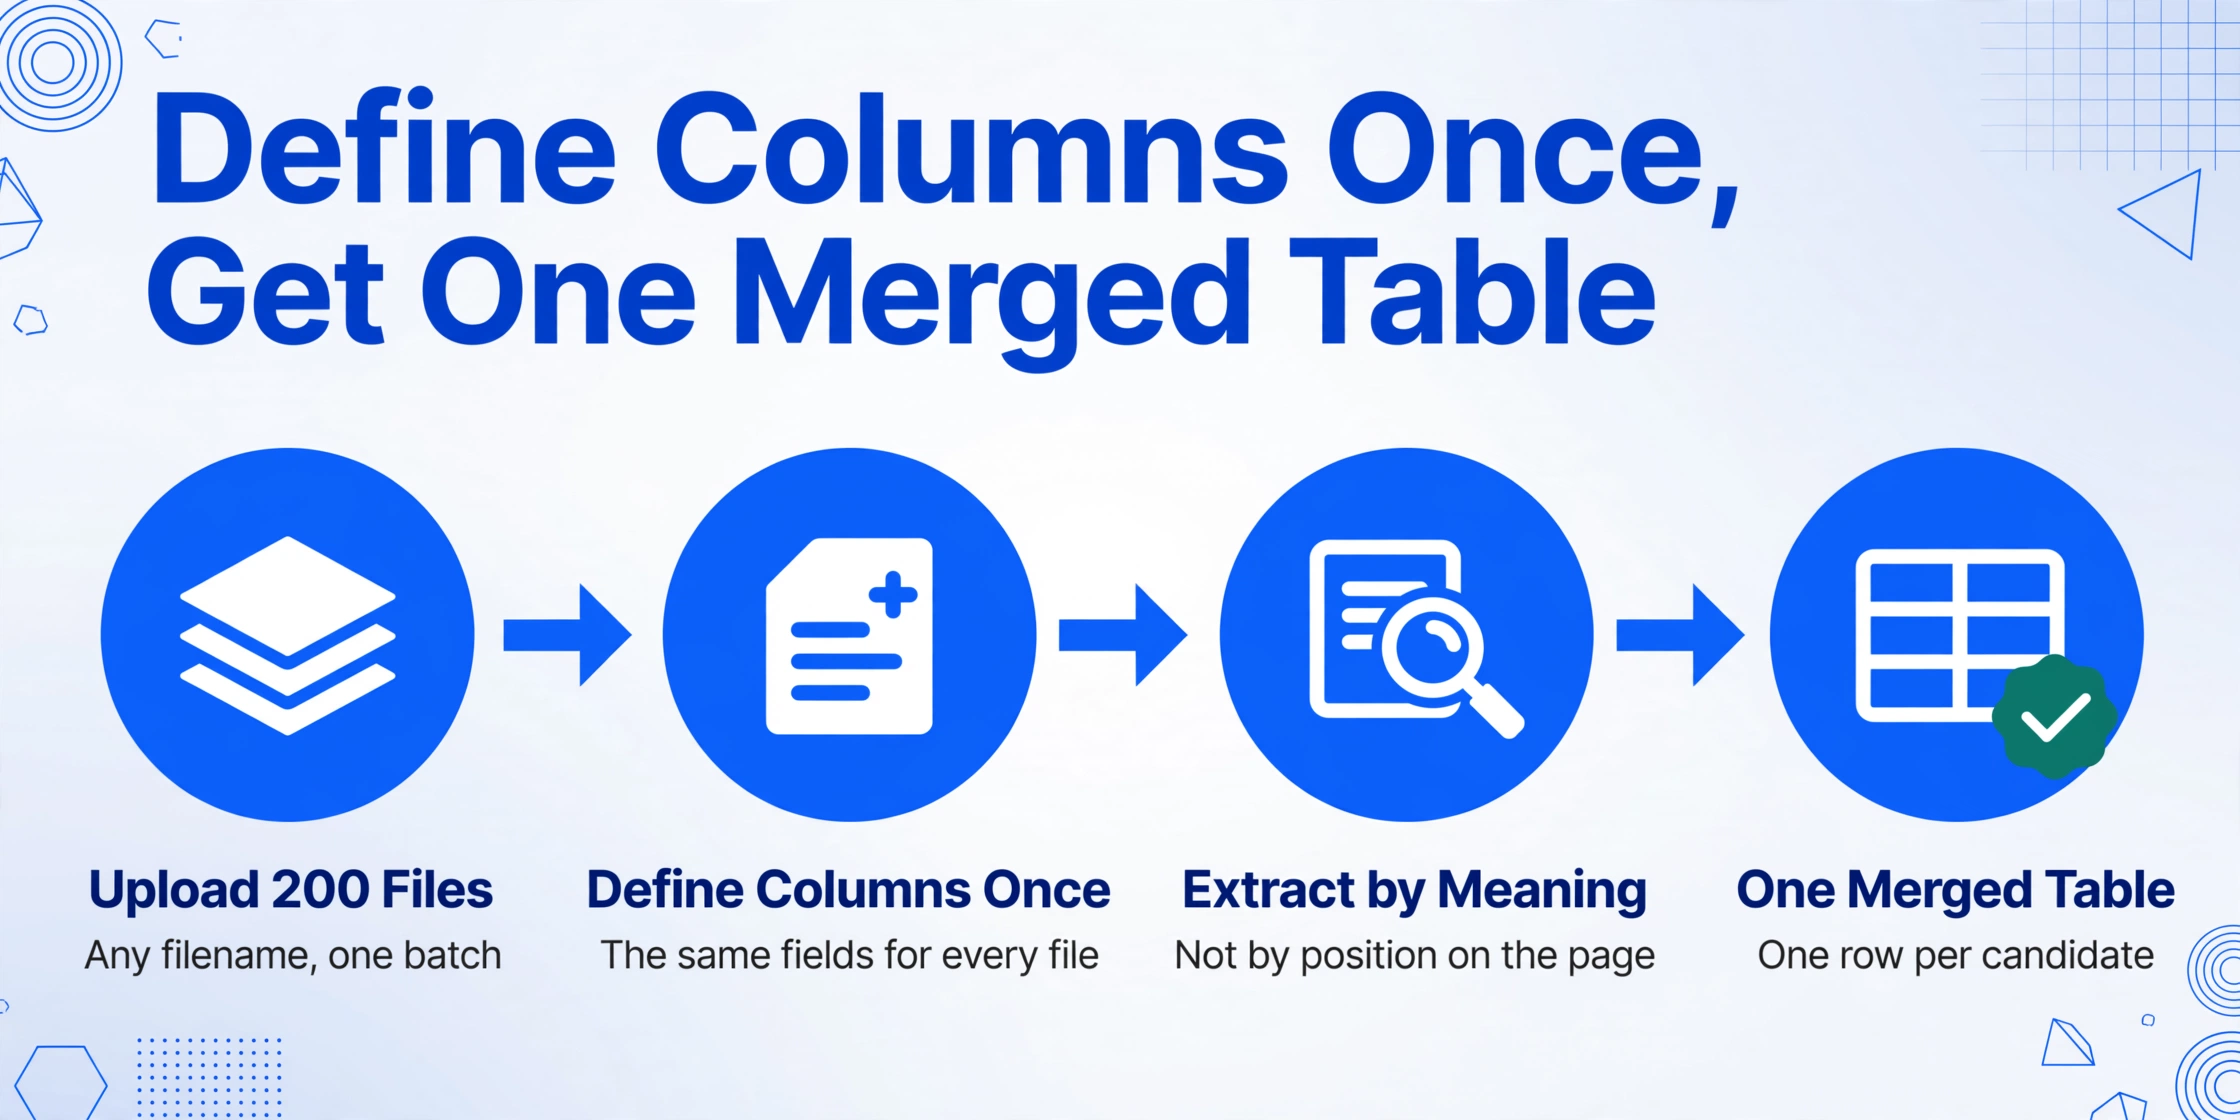
履歴書を1枚ずつ抽出すると、200件の別々の出力(200ファイル、200のチャット応答、200のタブ)が得られ、それらを手作業で結合する作業は、まさに避けたかったデータ入力を再現することになります。
解決策は、列定義を一度設定するだけで、すべてのファイルに適用されるプロセスです。カスタム列抽出(ImageToTable.aiの中核となる仕組みで、必要なフィールド名を入力すると、AIがページ上の位置ではなく意味を理解して各値を特定します)を使えば、「氏名、メールアドレス、現在の役職、現在の会社、実務経験年数、主要スキル」を一度定義し、200ファイルすべてをまとめてアップロードするだけで、各履歴書が1行として追加された1つの結合テーブルが得られます。
2種類の列タイプにより、候補者データベースは単なるテキスト変換よりも便利になります。推論列では、履歴書に明記されていないデータをAIが補完します。たとえば、収集元に基づいて各行をLinkedIn・紹介・求人ボードに分類する「ソース」列や、職歴の日付から算出する「実務経験年数」列などです。計算列はさらに一歩進んで、抽出中に計算を実行します。たとえば、「退職通知期間(目標日−開始可能日)」列では、データがスプレッドシートに届く前に日付の計算を解決します。
これは1枚の履歴書から200枚まで拡張できるまさにその仕組みです。列定義はボリュームに応じて変わらないからです。以下のデモはプリセットテンプレートなしで動作します。履歴書に共通の形式がないため、必要な列を定義すれば、アップロードするどの履歴書でもAIがそれらを見つけます。同じ列定義はファネルの紙側もカバーします。求人応募書類をExcelに変換ワークフローは、スキャンした応募書類から職歴・学歴・推薦状を読み取り、同じ結合テーブルに追加します。
ファイルは安全に処理され、保存されません。
フィールドごとの詳細(どの列が重要か、候補者データを責任を持って扱う方法、パーサー型ツールがどこで失敗するか)に初めて触れる方は、履歴書データをExcelに抽出するステップバイステップガイドで、単一ファイルのワークフロー、フィールド一覧、コンプライアンス面を詳しく解説しています。
バッチ問題3:パーサーを壊す5%
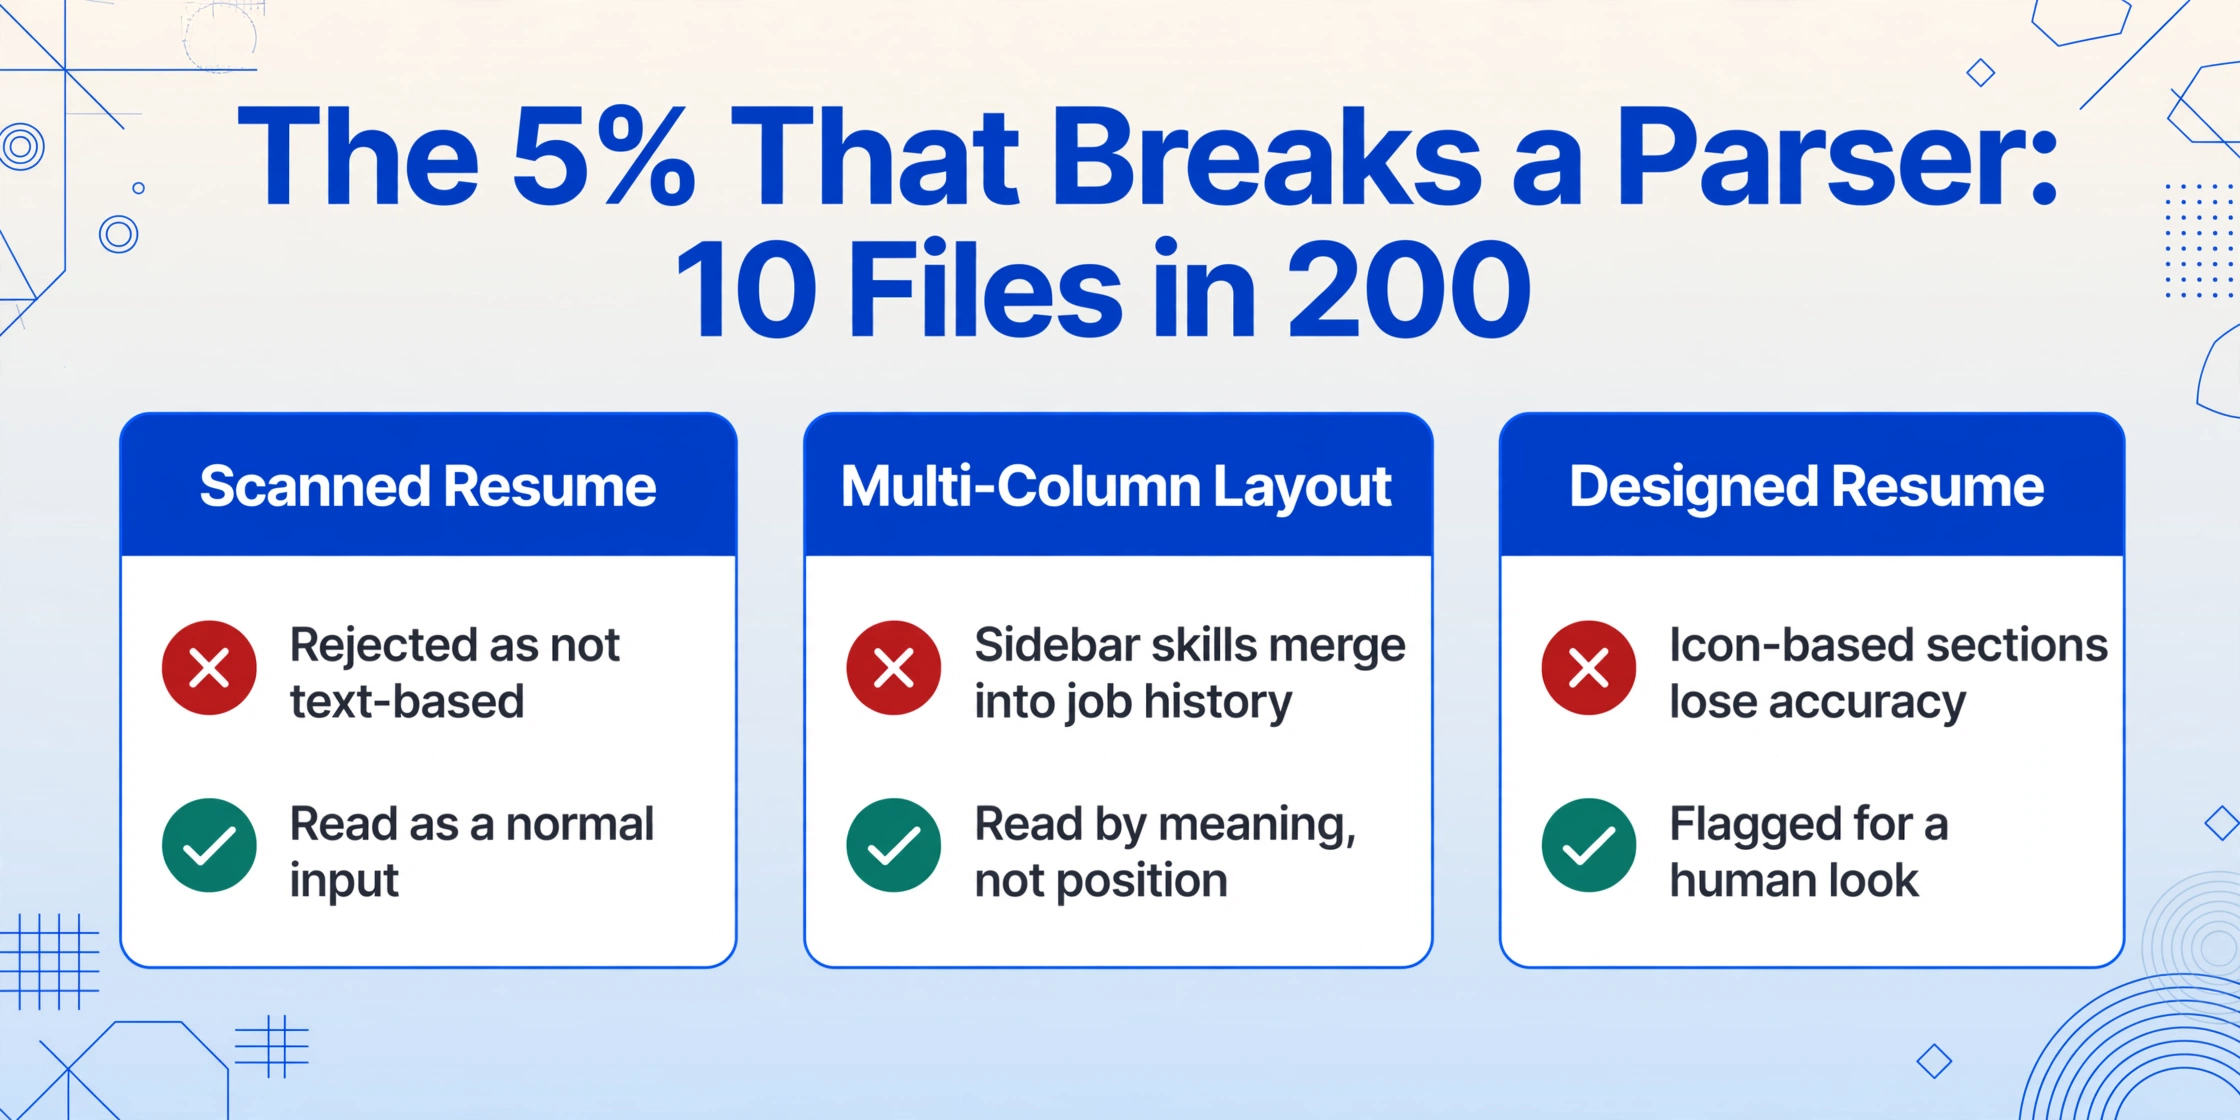
200件の履歴書バッチでわずか5%の例外率でも、手動対応が必要なファイルが10件発生します。そしてバッチワークフローでは、その10件こそがプロセス全体を停滞させるポイントです。
最も一般的な例外は、スキャン済みまたは画像ベースの履歴書です。Breezy HRの公式一括インポートドキュメントによると、アップロードされる履歴書はテキストベースのドキュメント(DOCX、TXT、RTF、ODT、PDF)である必要があり、「スキャンコピー、画像、画像ベースのPDFは不可」とされ、これらは即座に拒否されます(Breezy HRドキュメント)。履歴書の写真を取り込めないATSは、候補者がスマートフォンから正当に応募する職種にとっては大きな制約です。一方、ビジョンベースの抽出エンジンは、人間がドキュメントを読むのと同じようにピクセルを読み取ります。撮影された履歴書やスキャンされた履歴書は、例外ではなく通常の入力なのです。
もう2つの例外クラスは、どの大規模バッチでも発生します。暗号化またはパスワード保護されたPDF(セキュアなメールチャネルで応募する候補者に多い)と、マルチカラムまたは凝ったレイアウトです。後者はサイドバーのスキルを職歴に混ぜ込んでしまい、位置ベースのパーサーを混乱させます。セマンティック抽出は、座標ではなく意味を読み取ることで両方を回避します。ただし、アイコンベースのセクションを持つ凝ったグラフィックデザイナーの履歴書では、特定のフィールドで信頼度が低くなることがあり、そうしたものは実際に人間の目視確認が必要です。
例外をバッチセーフに処理する方法はBbox検証付きレビューモードです。抽出されたセルにホバーまたはクリックすると、その値が元の履歴書のどこから来たのかがツールによって正確にハイライトされます。逆に、画像上の領域をクリックすると、対応するテーブルセルにジャンプします。200行すべてを監査する代わりに、AIが不確実とフラグを付けた少数の行だけをレビューし、それぞれを元のファイルと照合して数秒で確認できます。当社の抽出エンジンがベンチマークする99%の印刷テキスト精度では、200件の履歴書バッチで確認すべき行はごくわずかです。10時間の監査にはなりません。
スケールする例外処理の原則:不良ファイルでバッチを止めず、黙ってスキップもしない。すべてを処理し、不確実なフィールドにフラグを付け、その行だけを人間のレビューに回す。それが10時間の監査と15分のチェックの違いです。
コピー&ペーストの10時間が採用所要日数に与える影響
採用所要日数において、手作業による候補者データの作成は、小さな非効率性ではなく、達成不可能な採用指標へと変わります。
SHRMの2026年採用幹部ベンチマーキングレポートによると、非管理職の採用所要日数の中央値は39日(前年の44日から減少)で、その改善の一部はAIツールの導入によるものとされています。スクリーニングだけで約8〜9日を要します(SHRM採用ベンチマーキング)。200件の履歴書からなる1バッチの手動転記に10〜20時間かかるのは、まさにこのスクリーニング期間内であり、判断を伴わない純粋なオーバーヘッドです。PDFからセルへのテキスト移動に過ぎません。
CNBCの報道は第二の側面を加えます。米国のHRプロフェッショナルの5人に1人以上が、応募書類のレビューだけで1日3〜5時間を費やしています。採用担当者がすでに1日の3分の1を応募書類のレビューに費やしている場合、先にテーブルを作成する時間は誤差範囲ではありません。それは、スクリーニングを行う採用担当者と、転記を行う採用担当者との違いです。
手動での候補者データ作成は単に遅いだけではありません。SHRMがスクリーニングに要するとする8〜9日を直接増加させます。履歴書をスプレッドシートにコピーするのに費やす1時間は、候補者を面接に進めるために使えない1時間だからです。
ATSは作成したデータをインポートできます
作成したスプレッドシートは、ATSが期待するインポートファイルそのものです。ATS独自のパーサーが履歴書に触れる必要はありません。
Greenhouseの一括候補者インポートは、スプレッドシートからのアップロードで最大8,000行を受け付けます。ただし、アップロードされた履歴書ZIPファイルは、一致するメールアドレスが解析可能な行にのみ添付されます(Greenhouseドキュメント)。Bullhornのカスタムインポートは、CSVで1バッチあたり1,000件のレコードを受け付けます。WorkdayのEIBは30MBのアップロード上限があり、添付ファイルは一切サポートしていません。これらすべてに共通するのは、候補者テーブルをインポートし、それを提供することを期待している点です。候補者ごとに1行、各行に正しいメールアドレスが必要です。
まず抽出し、その後インポートします。ATSが必要とする列(正しく入力されたメール列を含み、抽出時に検証されるべき)でExcelに一括抽出すると、エクスポートされたファイルはそのままインポートファイルになります。1回のエクスポートで、200人の候補者データベース全体をGreenhouse、Lever、Workday、iCIMS、またはBambooHRに取り込むことができ、組み込みのパーサーがPDFに触れることはありません。これは、当社の履歴書データのExcelへの抽出ワークフローが基づくアプローチでもあります。スクリーニング用スプレッドシートとATSの両方にそのまま使える、クリーンで構造化された1つのファイルです。
スクリーニングは履歴書で終わりません。身元調査のExcelへの抽出により、各候補者の犯罪歴、雇用歴、学歴の検証結果が、同じ行にそれぞれの列として追加されます。
よくある質問
スキャン済みや画像のみの履歴書をバッチ処理できますか?
はい — ビジョンベースの抽出エンジンが、写真やスキャンされた履歴書を通常の入力として読み取ります。これは、画像ベースの文書を完全に拒否する多くのATSの一括アップロード機能(例えばBreezy HRのドキュメントでは、一括アップロードはテキストベースでなければならないと記載されています)とは異なります。スキャンの品質は依然として重要です:鮮明なスキャンはきれいに抽出されますが、大きくぼやけたり傾いた写真は、信頼度の低いフィールドとしてフラグが付けられ、黙って入力されるのではなくレビュー対象になります。
候補者データベースにはどの列を定義すべきですか?
スクリーニング用スプレッドシートの実用的な基本セット:氏名、メール、電話、現在の役職、現在の会社、経験年数、主要スキル、勤務地、学歴、ソース(候補者の入手先)。トレーサビリティのためにソースファイル列を追加し、採用判断に依存する場合は経験年数や退職通知期間などの推論列や計算列も追加します。プロセスで使用するものだけを抽出してください — 候補者データベースはフィルタリングと比較のためのものであり、すべての職歴をアーカイブするためのものではありません。
200件の履歴書バッチは実際にどのくらい時間がかかりますか?
各履歴書のAI処理時間は約5〜10秒なので、200ファイルのバッチは約20〜35分で完了します — その間、あなたが何かをする必要はありません。レビュー時間はフラグが付けられたフィールドの数によって異なります。鮮明な印刷履歴書に対するビジョンモデルの精度率では、完全な監査ではなく、確認すべき行が少数ある程度と予想してください。同じ量の手動転記に10〜20時間かかるのと比較してください。
どの行がどの履歴書から来たのかをどうやって知るのですか?
バッチエクスポートには、各元文書のファイル名を記録する自動ソースファイル列が含まれているため、ファイルが「resume.pdf」と呼ばれていても、すべての行がそのソースファイルを参照します。さらにトレーサビリティを高めるには、アップロード前に管理しているファイルをlastName_firstName_sourceの命名規則で名前を変更してください — ファイル名が監査証跡の一部となり、複数のチャネルからの重複候補を特定するのに役立ちます。
結果をGreenhouse、Lever、Workdayにインポートできますか?
はい。まずクリーンなスプレッドシートに抽出し、各プラットフォームの標準的な候補者インポート機能を使用してください。Greenhouseの一括インポート(1回のアップロードで最大8,000行、各行に一致するメールアドレスが必要)、Bullhornのカスタムインポート(1バッチあたり1,000件、CSV)、またはWorkday EIB(30MB上限)です。抽出されたファイルには候補者ごとに1行、検証済みのメール列が含まれているため、クリーンにインポートできます。各プラットフォームの組み込みの履歴書パーサーを完全にスキップできます。
バッチ抽出は履歴書パーサーAPIとどう違うのですか?
履歴書パーサーAPI(Textkernel、RChilli、Affinda、Daxtra)は固定の履歴書スキーマでトレーニングされており、ドキュメントごとに料金がかかり、統合が必要な構造化JSONを返します。バッチ抽出は、定義した列に基づいてあらゆるドキュメントを読み取り、履歴書スキーマに関連するファイルごとの料金はなく、開いてフィルタリングしてATSにインポートできるスプレッドシートに直接出力します。チームが履歴書以外のもの(オファーレター、オンボーディングフォーム、契約書)も扱う場合、1つの抽出ワークフローですべてをカバーできるため、同じバッチアプローチが自然に従業員ドキュメントデータベースに拡張されます。
200件の履歴書の山は、1件の履歴書の問題を大きくしたものではありません。それは別のカテゴリーの問題であり、より多くの入力を増やすのではなく、命名、マージ、例外処理によって解決されます。構築する候補者データベースは、すべてのスクリーニング判断の基盤となります。問題は、それを手作業で構築するか、一度で構築するかです。
自分の履歴書の山で試す