新入生の成績証明書500件、
入試データベースは1つ
毎年夏、5月1日の入学申込締切が過ぎると、中規模大学の入試課は同じ数学の問題に直面します。約500人の新入生、それぞれに少なくとも1通の高校の成績証明書があり、各成績証明書の学生情報システムへの手入力には推定20分かかります。つまり、6月から8月の間に167時間のスタッフ作業が必要となり、これは1人あたり丸4週間分の労働時間に相当します。その間、オリエンテーションや履修登録の締切が常に迫っています。ボトルネックは量ではありません。500通の成績証明書が500の異なる高校から500の異なる形式で届き、それぞれの形式を解読するのに同じ人間の目が必要となることです。
重要ポイント
- 167時間 — 新入生の成績証明書500件を各20分で処理すると、これだけの時間になります。そして、それはすべて、オリエンテーションの締切が待ったなしの6月から8月の間に集中します。
- 成績証明書5件の処理は半日で済みますが、500件となると構造的な破綻をきたします。人間の注意力は直線的には拡大せず、120件目あたりで、13点満点のGPAスケールのB+を4.0スケールの3.3として入力してしまうミスに気づかなくなります。
- バッチ抽出はレビュー担当者を不要にするものではありません。それは、コース名を入力するという167時間を、コースの同等性を評価するという作業に変えるものです。それが、あなたの機関知識がそもそも期待されていた役割です。
単一の成績証明書からデータを抽出する基本事項(どの項目を取得するか、列定義の設定方法、完成した抽出結果のイメージ)については、学生の成績証明書データをExcelに抽出するガイドから始めてください。ここで説明するのはスケーリングの層です。1件の成績証明書の処理から500件の処理に変わるときに変わるすべてのこと、そして8月までに入学審査対応可能なデータベースを1つ納品するパイプラインの構築方法です。
夏の成績証明書ラッシュ:数字で見る処理量
入学事務のワークフローに関する議論の中心は、ほとんどの場合、出願シーズンです。11月の早期決定、1月から3月の通常決定。しかし、成績証明書処理のボトルネックはその後、入学金の納入後にやってきます。全米大学入学カウンセリング協会の報告によると、米国の大学には毎年約290万人の新入生が入学します。カーネギー分類で学部生5,000人から15,000人を抱える中規模大学の場合、1サイクルあたり約3,000件から10,000件の出願に相当します。
2,500人の合格者を出し、1,000人の入学者を確保する中規模大学は、夏の間に約500件から700件の高校の成績証明書を処理します。さらに、編入生やダブル・エンロールメント・プログラムからの成績証明書も追加されます。 各成績証明書について、コース名、成績、単位、GPA、卒業要件の充足確認を抽出してから、学生を適切なコースに配置する必要があります。Parchmentがスポンサーを務める2023年のAACRAO Connectの記事では、出願1件あたりの手動成績証明書データ入力は20分と見積もられています。500件の成績証明書では167時間。これを入学金納入期限とオリエンテーションの間の8〜10週間の期間に圧縮しなければなりません。
タイミングこそが増幅要因です。入学事務室に167時間の余裕があるわけではありません。いつもと同じ40時間労働週、同じスタッフ、同じ期間の中で処理するのです。そして、遅延の1日1日——学生が配置メールを待っている間に処理キューに積まれたままの成績証明書1件1件——が歩留まりを削っていきます。迅速な返答が得られない学生は他大学に入学先を決めるか、不完全な評価に基づいてコースを登録し、9月に追加・削除の混乱を引き起こします。
手動入力が500件で破綻する理由
1件の成績証明書を手動で処理するのは面倒だが、何とかこなせる。5件なら半日仕事。50件なら丸一週間。500件に達すると、問題は時間ではなく、人間の注意力が大規模運用で構造的に機能しなくなる点に移る。
各成績証明書には同じ認知プロセスが必要だ。学生名と出身高校を確認し、評価基準を解読する(この学校は4.0、5.0、それとも100点満点か?)。各科目名と成績を読み取り、学期の指定をマッピングし、卒業状況を確認し、すべてのフィールドをSISに入力する。最大の障壁は科目名だ。ある学校の「English 9 Honors」が別の学校では「ENGL 101H」、さらに別の学校では「Composition & Literature I (Advanced)」となる。しかし、これらすべてをあなたの科目データベースの同じエントリにマッピングする必要がある。
20件の成績証明書なら、スタッフはこうした差異に気づく。120件になると、脳のパターン認識中枢が似たようなエントリを混同し始める。13段階のGPAスケール(A+ = 4.33)の学校の「B+」が、午前中ずっと4.0スケールモードだったために、3.3として入力される。2020年春学期の科目に「合格/不合格」欄がある成績証明書——これはCOVID-19時代によく見られたバリエーションだ——が、80件目の時点で列見出しを読むのをやめたオペレーターによって、フラグも立てられずに入力される。LaserficheのInside Higher Edスポンサーコンテンツもこれを裏付けている。「成績証明書は人為的ミスが非常に発生しやすい」ため、同社の自動化ソリューションは、誤った形式のエントリが人間のレビュアーに届く前にフラグを立てるように設計されている——つまり、手動入力では検証レイヤーが必要になるほどのエラーが発生することを認めているのだ。
5件と500件の差は、単なる時間の問題ではない。まったく異なるカテゴリーの問題だ。5件なら検証できる。500件ならサンプリングするしかない——そして、残りの495件に、誤った科目配置、単位計算ミス、卒業監査の遅延につながるエラーが含まれていないことを願うしかない。
フォーマットの現状:電子、紙、そしてその中間
理想は、すべての成績証明書がParchmentやNational Student Clearinghouseを通じて統一された電子形式で届くことです。しかし、実際の入試オフィスでは、以下のようなハイブリッドな受信箱が現実です。
| チャネル | 一般的な割合 | 形式 | 抽出の課題 |
|---|---|---|---|
| Parchment / Clearinghouse ETX | 55~65% | EDI(SPEEDE TS130)、PDF、または構造化XML | EDIは一部のSIS設定で自動解析可能。PDFのバリエーションは学校のParchment設定により異なる |
| Common App連携 | 10~15% | 構造化データフィード | フィールドが限定的。通常はGPAと主要科目の概要のみで、完全な成績証明書の詳細はなし |
| 直接メール / アップロードポータル | 10~15% | PDF(スキャンまたはデジタル出力) | レイアウトが大きく異なる。紙からスキャンされたものもあれば、学校のSISからカスタム書式で出力されたものもある |
| 郵送(紙) | 5~10% | 紙 → 入試担当者がPDFにスキャン | スキャン品質、傾き、影、公式書類への手書き注釈 |
| 国際 / 非伝統的 | 3~5% | PDF、スキャン画像、翻訳文書 | 非標準の成績評価システム(IB、Aレベル、各国カリキュラム)、翻訳、資格評価 |
2018年のAACRAOによる成績証明書のコスト、種類、量に関する調査では、約15%が依然として紙で納品されていました。その後この数値は減少した可能性がありますが、小規模な学区や国際機関は今でも紙を郵送しており、それらの成績証明書はSISに取り込まれる前にスキャナトレイに置かれます。スキャンごとに、コントラスト、傾き、余白のトリミング、小さな文字の評価基準表の判読性など、さまざまな変数が生じます。
Parchment EDIのみを処理するバッチ処理パイプラインでは、問題の半分しか解決できません。最もスタッフの時間を消費する成績証明書は、まさに電子ネットワーク外から届くもの(スキャンされた紙、交換協定のない学校からのメールPDF、国際的な資格証明書)です。構築する価値のあるワークフローは、これらすべてを処理できるものです。
バッチ処理パイプラインの構築:受信トレイからデータベースまでの6つのステップ
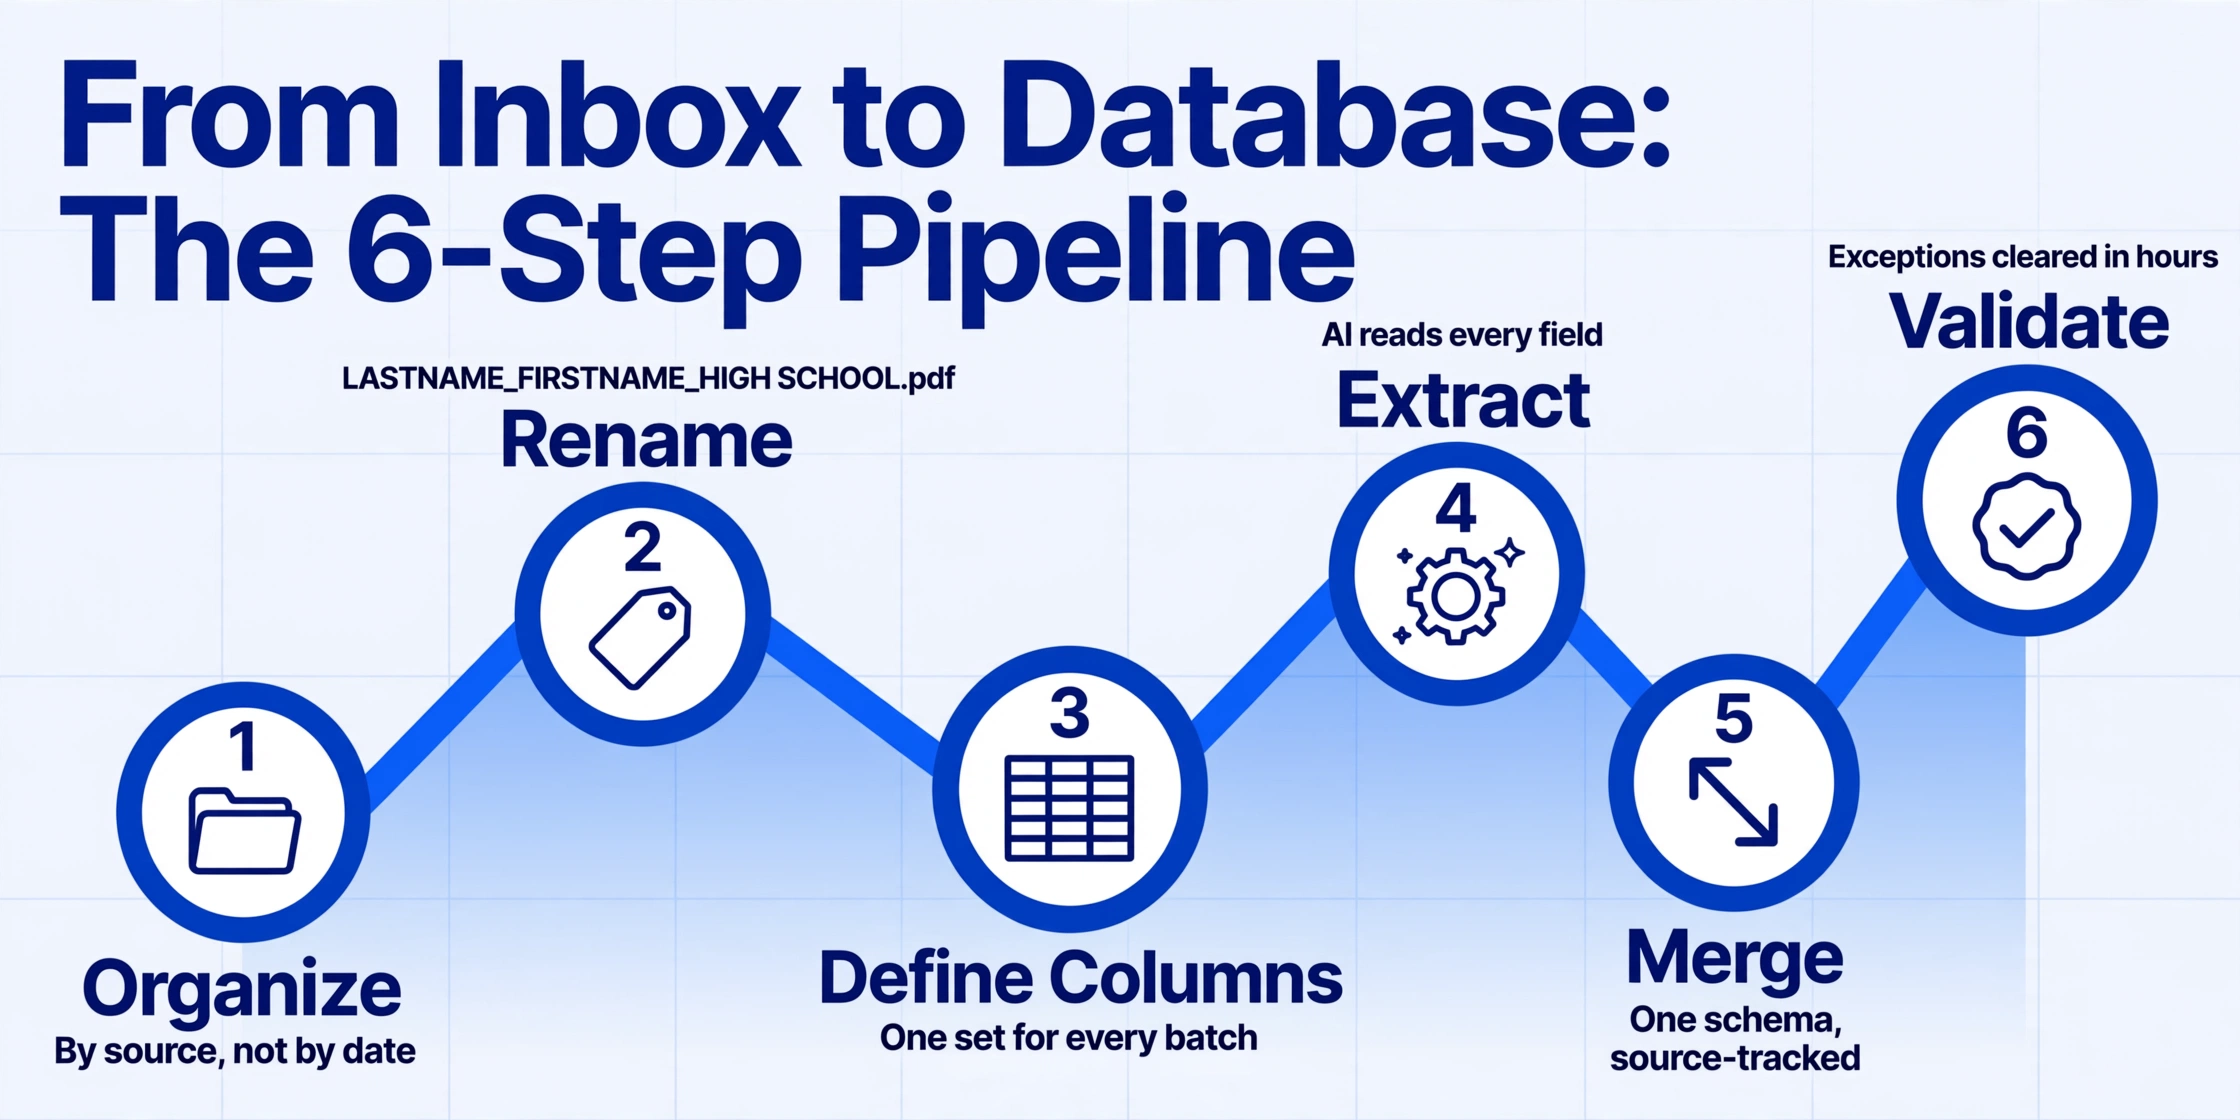
これはソフトウェアレビューのセクションではありません。使用する抽出ツールに関係なく、500件の不揃いな文書を1つのクリーンな入試データベースに変える実践的なワークフローです。バッチ文書処理のツール選定側面(どのような機能を求めるべきか、各ツール層がどこで不足するか)について詳しくは、バッチOCRワークフローガイドをご覧ください。その記事では、デスクトップOCR、クラウドAPI、AI抽出層について説明しています。ここでは、成績証明書に特化したパイプラインに焦点を当てます。
送信元の種類ごとにフォルダを作成します:parchment/、common-app/、scanned-paper/、international/。送信元はフォーマットの一貫性を最も強く予測する要素であり、送信元ごとにグループ化することで、ファイル単位ではなくフォルダ単位で抽出ルールを一括設定できます。ツールがサブバッチ処理に対応している場合は、各フォルダが独自の処理バッチになります。
処理前にすべてのファイルに名前を付けます:LASTNAME_FIRSTNAME_HIGHSCHOOL.pdf。この規則には3つの利点があります:人間が読めるキューとして機能し、すべての出力行に相互参照キーを埋め込み、例外処理を検索可能にします。最悪のケースは、transcript(1).pdfからtranscript(500).pdfまで500件のファイルがある場合です — 行の検証が失敗しても、元の文書に遡って追跡する方法がありません。
列セットは、すべての成績証明書のバリエーションを網羅できるほど包括的でありながら、AI抽出の精度を損なわない程度の粒度にします:Student Name、High School、Graduation Date、GPA、GPA Scale、Course Name、Course Code、Grade、Credits Earned、Term/Semester。GPA Scale列が最も重要です — 学校が4.0、5.0、または100点満点のいずれのスケールを使用しているかを示し、これにより単位認定の担当者は「3.8」と「95」が同等かどうかを判断できます。
500件すべてを1つの処理キューにまとめるのではなく、フォルダごとに独立したバッチとして処理します。Parchment由来の成績証明書は共通のPDF構造を持つため、まとめて処理することでAIが遭遇するフォーマットの不連続性が減り、抽出の一貫性が向上します。スキャンした紙の成績証明書は別バッチとして、最初の5〜10ファイルでスキャン品質をスポットチェックしてから処理するのが理想的です。AIベースの抽出が従来のOCRとどう異なるか、そして文書に一貫したレイアウトがない場合にそれがなぜ重要なのかについては、OCRとAI文書抽出の比較ガイドをご覧ください。
各バッチの完了後、主要フィールドが欠落している行(学生名が空白、GPAが空白、コースエントリ数が想定より少ないなど)にフラグを立てます。これらが例外キューになります。人間によるレビューが必要な成績証明書の5〜15%の候補リストです。バッチ処理とバッチ混乱の違いは、例外が即座に処理されるか、マージされた出力に埋もれてしまうかです。メインのデータベースと並行して「例外」シートを作成し、フラグが立てられた行をパイプライン途中でそこにルーティングします。マージ後のクリーンアップ手順としてではなく、です。
すべてのバッチ出力を1つのスプレッドシートまたはデータベーステーブルに統合し、Source Batch列を追加して、元のファイル名をSource File列に保持します。この2つの列が監査証跡です。学生がコース配置に異議を唱えた場合、データベースをそのまま信頼するのではなく、決定を正確な成績証明書と抽出バッチまで遡って追跡する必要があります。複数のソースグループにわたるバッチエクスポートワークフローでは、同じマージ・アンド・トラックの原則があらゆる文書タイプのバッチ検証にも適用されます。ソース列こそが、マージされたスプレッドシートの監査可能性を維持するものなのです。
500件の成績証明書から1つのデータベースへ:結合と検証のステップ
この時点で、バッチ出力(ソースフォルダごとに1つのスプレッドシート)はありますが、まだ統合された入試データベースはありません。結合ステップは、異なるソースから異なるタイミングで処理されたデータが単一のスキーマに準拠しなければならないため、ほとんどのバッチパイプラインが一貫性を失う場所です。
スキーマの強制は結合時に行われます。 統合する前に、すべてのバッチ出力を同じ列順序と命名規則に標準化してください。ParchmentのバッチでGPA列が「Cumulative GPA」と命名され、スキャンバッチで「GPA (Weighted)」と呼ばれていた場合、結合前にそれらを調整してください。そうしないと、それぞれに部分的なデータが入った2つの並列GPA列ができてしまいます。結合前の正規化パスは10分で完了し、後で何時間ものスプレッドシート調査を防ぎます。
ソーストラッキングは必須です。 結合されたすべての行に2つの列を追加してください:Source Batch(この行を生成した処理バッチ)とSource File(元のファイル名)。10月に学科長が単位互換の決定に疑問を呈した場合、これらの列があれば、どの成績証明書とどの抽出パスがデータを生成したかを30秒で特定でき、500ファイルを辿って1時間を費やす代わりになります。これは手動処理にはなかった監査レイヤーです。
GPAの正規化には数式ではなくルールが必要です。 データベースに4.0スケール、5.0スケール、100点スケール、IB 7点スケールの高校のGPAが同じ列に含まれている場合、自動的なGPA比較は無意味です。補助列(GPA Scale)を作成し、生のGPA値とともに元のスケールを保持してください。比較可能な指標への正規化は、データベースレベルではなく、下流の単位認定ステップで行われます。抽出中にすべてのGPAを単一の再計算値にまとめるのはよくある間違いです。学生や保護者が評価に疑問を呈したときに必要な証拠を破壊してしまいます。
コースエントリの場合、マージステップはアーティキュレーションマッピング(抽出したコース名を大学のコース等価データベースと照合する作業)を開始する場でもあります。これはバッチ抽出タスクではなく、マージ後の照合であり、抽出された各コース行を既知の等価情報とペアリングし、一致しない行には手動レビューのフラグを立てます。抽出ツールの役割は、コース名、コード、成績をラベル付きの列に格納することです。アーティキュレーションマッピングは入試チームの専門知識であり、個々のPDFではなくクリーンなデータベースに対して適用されます。
例外処理:成績証明書の8〜15%が人的レビューを要する場合の対応
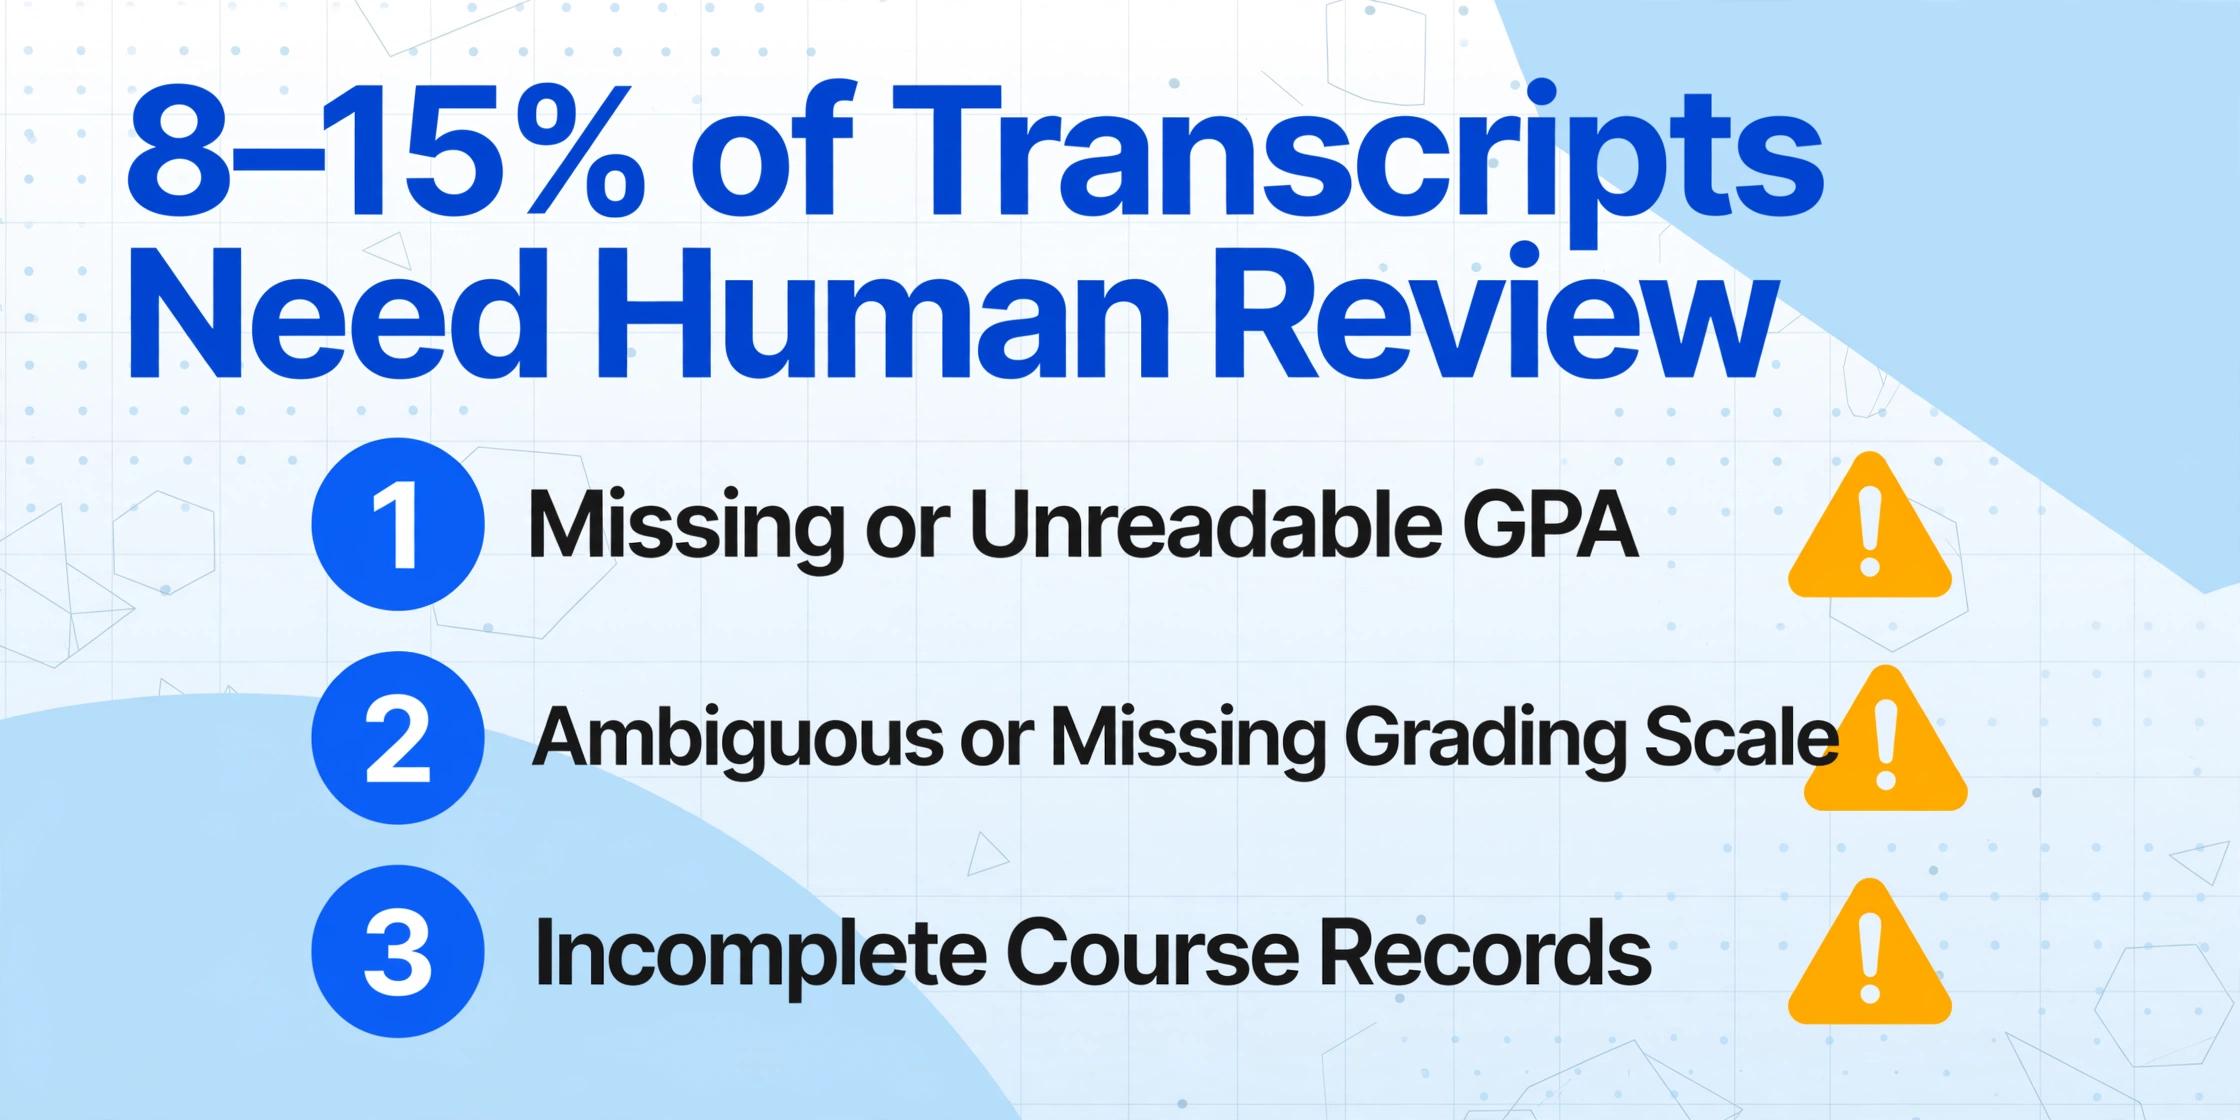
すべてのバッチパイプラインで例外は発生します。目標は例外ゼロではなく、1人のレビュー担当者が1時間以内に処理できる構造化された例外キューです。以下は、成績証明書のバッチ処理で一貫して発生する例外カテゴリと、パイプラインを中断させずに各例外を処理する方法です。
GPA欠落または判読不能
一部の高校の成績証明書(特に小規模な学区や海外の教育機関)では、累積GPAが単一の数値として表示されません。また、スキャンしたコピーで判読できないほど小さなフォントで印刷される場合もあります。抽出出力でGPAフィールドが空白の場合は、その行にフラグを立てますが、バッチは停止しないでください。これらの行は「GPA未抽出 — 原本で確認」というメモとともに例外キューに入ります。
曖昧または欠落した成績評価尺度
GPAが「3.8」と表示されているものの、その尺度が4.0、5.0、12.0のいずれであるかが示されていない成績証明書は、配置上のリスクとなります。抽出出力ではGPA尺度を「未指定」とし、その行を例外処理に回す必要があります。審査担当者は、成績証明書の凡例、フッター、または裏面に尺度の記載があるかどうか、あるいは高校のウェブサイトで成績評価方針が文書化されているかどうかを確認します。
不完全な科目記録
一部の成績証明書では、各科目の最終成績のみが表示され、学期別の内訳、単位数、科目コードが記載されていません。また、科目名が20文字に切り詰められているものもあります。これらの行は技術的には問題なく抽出されるかもしれませんが、単位認定の目的には不完全です。科目コード欄が空白の行、または各学年の科目エントリ数が予想よりも少ない行(標準的な米国の高校では通常、年間5〜8科目)にはフラグを立ててください。
学期データの不足または欠落
4年次の秋学期の科目は表示されているが、春学期の科目が表示されていない成績証明書は、よくあるシナリオを示しています。それは、学生が春学期の成績が公開される前に、年度途中で成績証明書を送付したというケースです。これらはエラーではなく、部分的な記録です。「最終成績証明書待ち」としてフラグを立て、例外として扱わないでください。バッチ処理パイプラインは、「存在するが取得されなかったデータ」と「まだ生成されていないデータ」を区別する必要があります。
例外キューのワークフロー
各バッチ完了後、必須フィールドの空白、想定外のGPA値(0〜5.0または0〜100の範囲外)、および科目数の閾値未満をチェックする検証パスを実行します。フラグが立てられた行は専用の例外シートに送られます。自動修正は決して試みないでください。過信した自動修正は、空白セルよりも発見が困難なエラーを生み出すからです。
下流の意思決定を妨げる例外を優先します。まず、学生名または卒業予定日の空白(本人確認や資格審査ができない)を最優先とし、次にGPAの欠落(奨学金や表彰の評価を妨げる)、その次に不完全な科目記録(配置は妨げるが入学は妨げない)とします。到着順の処理は、重要度の高い行を待たせたまま、影響の少ない例外に時間を浪費します。
1件の例外に2分以上費やしている場合は、エスカレーションしてください。上級審査担当者に回すか、学生または高校に更新された成績証明書を問い合わせる「照会依頼」キューに回します。バッチ処理の効率性は、例外処理が本来節約すべき時間を消費してしまうと失われます。
適切に構成された例外キューは、500人の入学者クラスに対して20〜45分で処理が完了します。重要なのは、「人間による審査が必要」なものと「原本の再確認が必要」なものを区別することです。これは、不適切なパイプラインが単一の「問題」山に混同してしまう、まったく異なる2つの作業カテゴリです。
よくある質問
バッチ処理は、非標準の成績評価システムを使用する国際的な成績証明書に対応できますか?
はい、ただし重要な注意点があります。バッチ抽出では、IB(1~7)、Aレベル(A*~E)、フランスのバカロレア(0~20)、インドのCBSEパーセント方式など、評価システムに関係なく、科目名、成績、GPAをラベル付きの列に取り込むことができます。しかし、できないのは単位認定評価、つまりIBの数学HLで5を取得したことが貴学のMATH 101に相当するかどうかを判断することです。その専門知識は、貴学の国際入学チームやWES、ECEなどの外部単位認定サービスに委ねられます。バッチパイプラインの役割は、評価者がPDFではなく行を比較できるよう、生データをデータベースに取り込むことです。
バッチ抽出後、手動レビューが必要な成績証明書の割合はどのくらいですか?
成績証明書処理のユースケースでは、全体の8~15%の行が人間によるレビューを必要とすると予想されます。これは、フォーマットのばらつきが大きいバッチ請求書処理よりは低く、ACORD 25フォームでレイアウトが標準化されているバッチCOI処理よりは高い割合です。手動レビューの最も一般的なトリガーは、画質に問題のあるスキャン紙の成績証明書、非標準の成績表記を使用する学校の成績証明書、科目名が米国の慣習に従っていない国際的な成績証明書です。例外率が20%を超える場合は、スキャン品質を見直してください。スキャン不良は、抽出漏れの最大の原因です。
バッチ抽出は、ParchmentやNational Student ClearinghouseのPDFでも機能しますか?
はい。Parchment ReceiveやNational Student Clearinghouseを通じて配信される成績証明書は標準的なPDFです。電子配信レイヤーは認証とルーティングを処理しますが、文書自体は依然として視覚的なレイアウトであり、バッチ抽出は他のPDFと同様に読み取ります。電子配信の成績証明書の利点は、一貫したデジタル品質です。スキャナーの傾き、手書きの余白メモ、感熱紙の色あせがありません。ただし、ParchmentのPDFであっても高校ごとに異なります。各学校がParchmentシステム内で独自の成績証明書テンプレートを設定するため、レイアウトは依然として異なりますが、ベースラインの品質は良好です。
正しいコースデータを正しい学生にマッピングするには、どうすれば確実ですか?
3つの安全策があります。第一に、ファイル名の規則(苗字_名前_高校名.pdf)により、すべてのソースファイルに学生の身元が埋め込まれます。第二に、各抽出行はソースファイル名を継承し、永続的な追跡が可能です。第三に、「学生名」と「高校名」を明示的な列として抽出し、入学希望者データベースと照合してから、最終的な入学データベースに統合します。抽出された名前が在籍学生と一致しない場合、または成績証明書に学生の出願に記載されていない高校が参照されている場合は、フラグを立ててください。システム入力エラーか、複数の教育機関から書類を提出した学生のいずれかです。
同じバッチパイプラインで、編入生の成績証明書と新入生の成績証明書を処理できますか?
技術的には可能ですが、運用上は分離する方が良いでしょう。編入生の成績証明書には、大学レベルのコースコード、単位時間、前提条件の連鎖が含まれており、高校の成績証明書とは異なる単位認定評価プロセスが必要です。同じ列定義で同じパイプラインで処理すると、一見きれいな行が生成されますが、単位認定マッピング中に再レビューが必要になり、バッチを統合して節約した時間が失われます。新入生と編入生の成績証明書は、それぞれの文書タイプに最適化された異なる列セットを持つ別々のバッチプロジェクトとして実行してください。
手入力から処理へ切り替えると何が変わるか
手動入力からバッチ処理への移行は、速度以上の変化をもたらします。夏の繁忙期に、入学チームが実際に時間をどのように使うかが変わります。
以前はSISにコース名を入力するのに167時間費やしていたスタッフが、今度はその時間を評価と単位認定に費やします。例外行のレビュー、コースの互換性マッピング、非標準スケールで抽出されたGPAが奨学金の基準に対して正しく重み付けされているかの検証です。これこそが、組織の知識と人間の判断を必要とする作業であり、手動入力ではオリエンテーション後の9月に先送りされ、修正が難しくなる作業です。
バッチ処理は人間によるレビューを排除するのではなく、パイプラインの適切な場所、つまりデータが構造化された後、永久記録に入力される前に移動させます。 出力は、すべての行がソースファイルにトレース可能で、すべての例外が解決策とともに記録され、すべてのGPAに元のスケールが注釈された1つのデータベースです。これは、手動入力では本質的に決して生成できなかった監査証跡です。
500件の新入生の成績証明書を処理する中規模大学にとって、その違いは、データ入力に費やした夏と、学生の準備態勢に費やした夏の差です。まずは1つのバッチ(1つのソースフォルダ、50件の成績証明書、上記ステップ3で定義した列セット)から始めてください。クリーンに処理される行数と、例外キューがクリアされるまでの時間を確認してください。その1回のパイロット実行は、どの機能比較表よりも、貴学のバッチ処理への準備態勢を物語っています。