500 Expedientes de Primer Año,
Una Base de Datos de Admisiones
Cada verano, después de que cierran los plazos de depósito del 1 de mayo, la oficina de admisiones de una universidad mediana enfrenta el mismo problema matemático: aproximadamente 500 estudiantes de primer año entrantes, cada uno con al menos un expediente de escuela secundaria — y cada expediente toma un estimado de 20 minutos para ingresarse manualmente en el Sistema de Información Estudiantil. Eso son 167 horas de personal — cuatro semanas laborales completas para una persona — entre junio y agosto, con los plazos de orientación e inscripción de cursos presionando todo el tiempo. El cuello de botella no es el volumen. Es que 500 expedientes llegan en 500 formatos diferentes de 500 escuelas secundarias diferentes, y cada formato requiere los mismos ojos humanos para decodificarlo.
Conclusiones Clave
- 167 horas de personal — eso es lo que suman 500 expedientes de primer año a 20 minutos cada uno, y todo cae entre junio y agosto cuando los plazos de orientación no esperan.
- Procesar 5 expedientes es una tarde, pero 500 es un colapso estructural — la atención humana no escala linealmente, y en el expediente 120 dejas de notar que una B+ de una escala de GPA de 13 puntos se ingresó como 3.3 en una escala de 4.0.
- La extracción por lotes no elimina al revisor — transforma esas 167 horas de escribir nombres de cursos en evaluar equivalencias de cursos, que es para lo que su conocimiento institucional fue contratado en primer lugar.
Para conocer los fundamentos de la extracción de datos de una sola transcripción (qué campos extraer, cómo configurar las definiciones de columnas y cómo se ve una extracción terminada), comience con nuestra guía para extraer datos de transcripciones estudiantiles a Excel. Lo que sigue aquí es la capa de escalamiento: todo lo que cambia cuando pasa de procesar una transcripción a procesar 500, y cómo construir un flujo de trabajo que entregue una base de datos lista para admisiones en agosto.
El Aumento de Transcripciones de Verano: Volumen en Cifras
La mayoría de las discusiones sobre flujos de trabajo de admisiones se centran en la temporada de solicitudes: decisión temprana en noviembre, decisión regular de enero a marzo. Pero el cuello de botella del procesamiento de transcripciones ocurre más tarde, después de que se pagan los depósitos. La Asociación Nacional de Consejería de Admisión Universitaria informa que aproximadamente 2.9 millones de estudiantes de primer ingreso se inscriben anualmente en universidades de EE. UU. Para una universidad de tamaño mediano — definida por la Clasificación Carnegie como aquella que inscribe entre 5,000 y 15,000 estudiantes de pregrado — eso se traduce en aproximadamente 3,000 a 10,000 solicitudes por ciclo.
Una universidad de tamaño mediano que admite a 2,500 estudiantes y logra la inscripción de 1,000 estudiantes de primer ingreso procesa aproximadamente 500 a 700 transcripciones de escuela secundaria durante los meses de verano, más transcripciones adicionales de estudiantes transferidos y programas de doble inscripción. Cada transcripción requiere que se extraigan nombres de cursos, calificaciones, créditos, GPA y verificación de graduación antes de que el estudiante pueda ser ubicado en los cursos correctos. Un artículo de 2023 de AACRAO Connect patrocinado por Parchment estimó la entrada manual de datos de transcripciones en 20 minutos por solicitud. Con 500 transcripciones, eso son 167 horas — comprimidas en una ventana de 8 a 10 semanas entre las fechas límite de depósito y la orientación.
El momento es el multiplicador. Las oficinas de admisiones no tienen 167 horas de margen. Tienen las mismas semanas laborales de 40 horas de siempre, con el mismo personal, durante la misma ventana. Y cada día de retraso — cada transcripción esperando en la cola de procesamiento mientras el estudiante espera un correo de ubicación — erosiona la tasa de inscripción. Los estudiantes que no reciben respuesta rápidamente se comprometen en otro lugar o se inscriben en cursos basados en una evaluación incompleta, creando caos de altas y bajas en septiembre.
Por qué la transcripción manual falla a partir de 500
Procesar un expediente manualmente es tedioso, pero manejable. Cinco expedientes: una tarde de trabajo. Cincuenta: una semana completa. A los 500, la cuenta deja de ser cuestión de tiempo y se convierte en un colapso estructural de la atención humana a gran escala.
Cada expediente exige la misma secuencia cognitiva: localizar el nombre del estudiante y la preparatoria, descifrar la escala de calificaciones (¿esta escuela usa escala 4.0, 5.0 o de 100 puntos?), leer cada materia y su nota, asignar los semestres, verificar el estado de graduación y escribir cada campo en el SIS. Los nombres de las materias son el mayor punto de fricción. "English 9 Honors" en una escuela es "ENGL 101H" en otra y "Composition & Literature I (Advanced)" en una tercera, pero las tres deben mapearse a la misma entrada en tu base de datos de convalidaciones.
Con 20 expedientes, un miembro del personal detecta estas variaciones. Con 120, los centros de reconocimiento de patrones del cerebro empiezan a colapsar entradas similares. Una "B+" de una escuela con escala GPA de 13 puntos (A+ = 4.33) se ingresa como 3.3 en una escala 4.0 porque el cursor ha estado en modo escala 4.0 toda la mañana. Un expediente con columna "Aprobado/Reprobado" para cursos de primavera 2020 —una variación común de la era COVID— se ingresa sin marcar, porque el operador dejó de leer los encabezados de columna en el expediente número 80. El contenido patrocinado de Inside Higher Ed por Laserfiche lo confirma: "los expedientes académicos son tan propensos al error humano" que su solución automatizada fue diseñada para marcar entradas con formato incorrecto antes de que lleguen a revisores humanos —una admisión de que la entrada manual genera suficientes errores como para requerir su propia capa de validación.
La diferencia entre 5 y 500 expedientes no es solo más tiempo: es una categoría de problema completamente distinta. Con 5, verificas. Con 500, tomas una muestra —y esperas que los otros 495 no contengan errores que deriven en colocaciones incorrectas de cursos, cálculos erróneos de créditos o auditorías de graduación retrasadas.
El panorama de formatos: electrónico, papel y todo lo que hay en medio
La fantasía es que todas las transcripciones lleguen a través de Parchment o del National Student Clearinghouse en un formato electrónico uniforme. La realidad dentro de la mayoría de las oficinas de admisiones es una bandeja de entrada híbrida que se parece más a esto:
| Canal | Participación típica | Formato | Desafío de extracción |
|---|---|---|---|
| Parchment / Clearinghouse ETX | 55–65% | EDI (SPEEDE TS130), PDF o XML estructurado | EDI se procesa automáticamente en algunos SIS; las variantes de PDF difieren según la configuración de Parchment de cada escuela |
| Integración con Common App | 10–15% | Fuente de datos estructurados | Campos limitados — solo GPA y resumen de cursos principales, sin detalle completo de la transcripción |
| Correo electrónico directo / Portal de carga | 10–15% | PDF (escaneado o exportación digital) | El diseño varía enormemente; algunos están escaneados de papel, otros exportados del SIS escolar con formato personalizado |
| Correo físico (Papel) | 5–10% | Papel → escaneado a PDF por admisiones | Calidad de escaneo, inclinación, sombras; anotaciones manuscritas en formularios oficiales |
| Internacional / No tradicional | 3–5% | PDF, imágenes escaneadas, documentos traducidos | Sistemas de calificación no estándar (IB, A-Levels, currículos nacionales), traducción de idiomas, evaluación de credenciales |
La encuesta AACRAO de 2018 sobre costo, tipo y volumen de transcripciones encontró que aproximadamente el 15% de las transcripciones aún se entregaban en papel. Es probable que ese número haya disminuido desde entonces, pero los distritos escolares más pequeños y las instituciones internacionales todavía envían papel, y esas transcripciones llegan a la bandeja del escáner antes de llegar al SIS. Cada escaneo introduce sus propias variables: contraste, inclinación, recorte de márgenes, legibilidad de las claves de escala de calificación en letra pequeña.
Un proceso de procesamiento por lotes que solo maneja Parchment EDI está resolviendo la mitad del problema. Las transcripciones que consumen más tiempo del personal son precisamente las que llegan fuera de las redes electrónicas: papel escaneado, PDF enviados por correo electrónico de escuelas sin acuerdos de intercambio y credenciales internacionales. Un flujo de trabajo que vale la pena construir los maneja a todos.
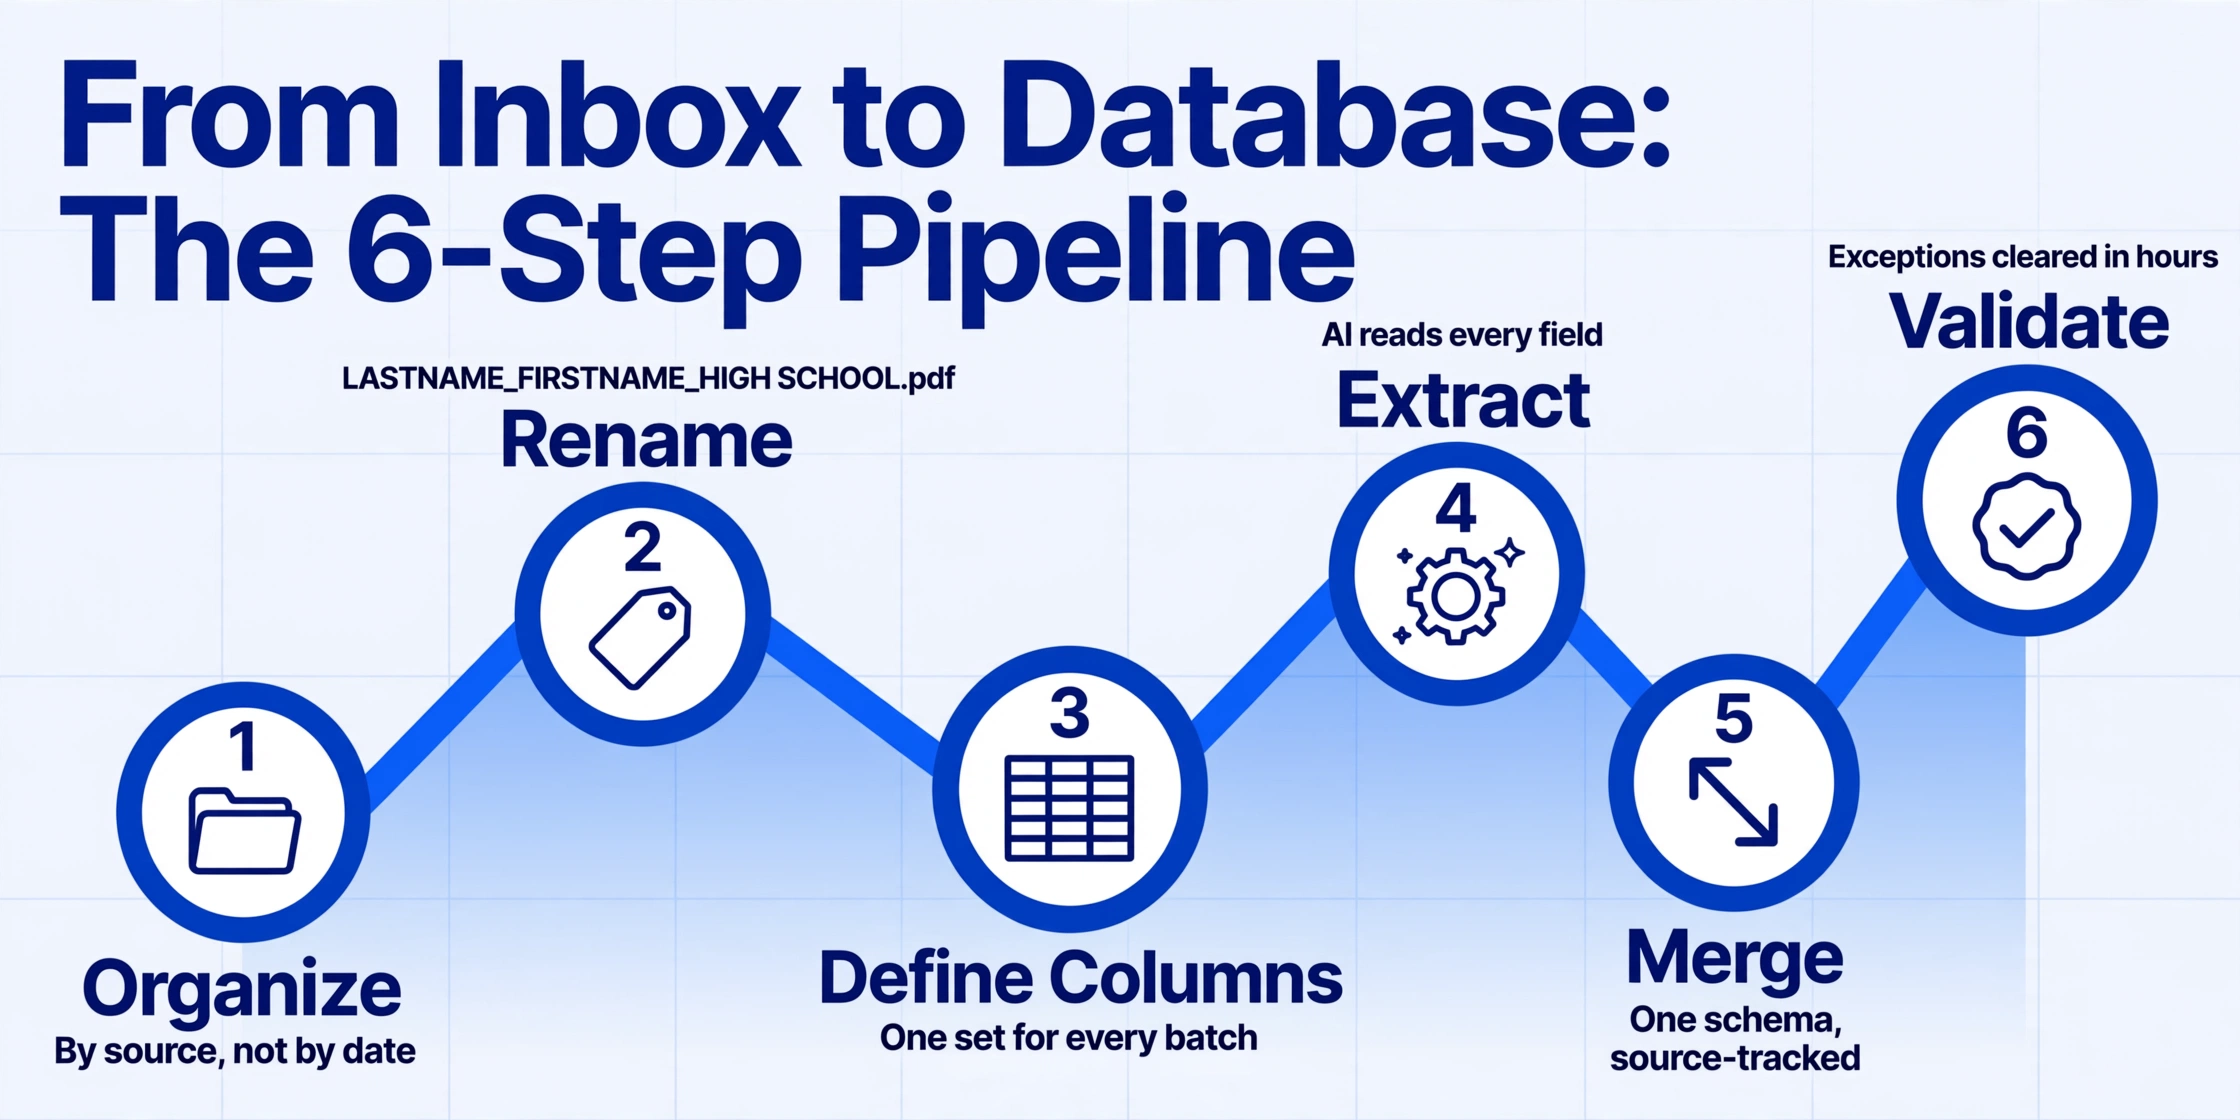
Cómo construir el pipeline de procesamiento por lotes: 6 pasos de la bandeja de entrada a la base de datos
Esta no es una sección de reseñas de software. Es el flujo de trabajo práctico que convierte 500 documentos dispares en una base de datos de admisiones limpia, independientemente de la herramienta de extracción que utilice. Para un análisis más profundo del lado de la selección de herramientas en el procesamiento de documentos por lotes — qué capacidades buscar y dónde se quedan cortos los diferentes niveles de herramientas — consulte nuestra guía de flujos de trabajo OCR por lotes. Ese artículo cubre OCR de escritorio, API en la nube y niveles de extracción con IA. Aquí, nos centramos en el pipeline específico de expedientes académicos.
Cree una carpeta por tipo de fuente: parchment/, common-app/, scanned-paper/, international/. La fuente es el predictor más fuerte de consistencia de formato, y agrupar por fuente le permite configurar reglas de extracción por lotes una vez por carpeta en lugar de por archivo. Si su herramienta admite procesamiento por sub-lotes, cada carpeta se convierte en su propio lote de procesamiento.
Nombre cada archivo antes de procesarlo: APELLIDO_NOMBRE_PREPARATORIA.pdf. Esta convención cumple una triple función: sirve como cola legible, incorpora una clave de referencia cruzada en cada fila de salida y hace que el manejo de excepciones sea rastreable. El peor escenario es tener 500 archivos llamados transcript(1).pdf hasta transcript(500).pdf — si una fila falla la validación, no hay forma de rastrear el documento de origen.
Su conjunto de columnas debe ser lo suficientemente exhaustivo para capturar cada variante de expediente, pero no tan granular que la extracción con IA se degrade: Student Name, High School, Graduation Date, GPA, GPA Scale, Course Name, Course Code, Grade, Credits Earned, Term/Semester. La columna GPA Scale es la más valiosa: captura si la escuela usa escala de 4.0, 5.0 o de 100 puntos, lo que le indica a su revisor de convalidación si un «3.8» y un «95» son equivalentes o no.
Procese cada carpeta como su propio lote en lugar de enviar los 500 documentos a una sola cola de procesamiento. Los expedientes de Parchment comparten una estructura de PDF común; procesarlos juntos mejora la consistencia de la extracción porque la IA encuentra menos discontinuidades de formato. Los expedientes escaneados en papel van en un lote separado, idealmente después de haber verificado la calidad del escaneo en los primeros 5 a 10 archivos. Para una descripción general de cómo la extracción basada en IA difiere del OCR tradicional — y por qué es importante cuando sus documentos no tienen un diseño consistente — consulte nuestra guía sobre OCR vs. extracción de documentos con IA.
Después de completar cada lote, marque cualquier fila donde falten campos clave — Nombre del Estudiante en blanco, GPA en blanco o menos entradas de cursos de las esperadas. Estas se convierten en su cola de excepciones: una lista corta del 5 al 15% de los expedientes que necesitan revisión humana. La diferencia entre procesamiento por lotes y caos por lotes es si las excepciones se manejan de inmediato o quedan enterradas en el resultado combinado. Cree una hoja de "Excepciones" junto a su base de datos principal y enrute las filas marcadas allí a mitad del proceso, no como un paso de limpieza posterior a la combinación.
Consolide todos los resultados de los lotes en una sola hoja de cálculo o tabla de base de datos, agregando una columna Source Batch y conservando el nombre de archivo original en una columna Source File. Estas dos columnas son su rastro de auditoría — cuando un estudiante disputa una colocación de curso, usted necesita rastrear la decisión hasta el expediente y el lote de extracción exactos, no solo confiar en la base de datos a simple vista. Para flujos de trabajo de exportación por lotes en múltiples grupos de origen, el mismo principio de combinar y rastrear se aplica a la verificación por lotes en cualquier tipo de documento — la columna de origen es lo que mantiene una hoja de cálculo combinada auditable.
De 500 expedientes a una base de datos: el paso de combinar y validar
En este punto, usted tiene resultados por lotes — una hoja de cálculo por carpeta de origen — pero aún no una base de datos de admisiones unificada. El paso de combinación es donde la mayoría de los pipelines por lotes pierden coherencia, porque es donde los datos de diferentes fuentes, procesados en diferentes momentos, deben ajustarse a un solo esquema.
La aplicación del esquema ocurre en el momento de la combinación. Antes de consolidar, estandarice cada salida por lotes al mismo orden de columnas y convención de nombres. Si su lote de Parchment nombró la columna GPA "Cumulative GPA" y su lote escaneado la llamó "GPA (Weighted)", concílie los antes de combinar; de lo contrario, obtendrá dos columnas GPA paralelas con datos parciales en cada una. Una pasada de normalización previa a la combinación toma 10 minutos y evita horas de análisis forense de hojas de cálculo más adelante.
El seguimiento de la fuente no es negociable. Agregue dos columnas a cada fila combinada: Source Batch (qué lote de procesamiento produjo esta fila) y Source File (el nombre de archivo original). Cuando un jefe de departamento cuestione una decisión de equivalencia de cursos en octubre, estas columnas le dirán en 30 segundos qué expediente y qué pasada de extracción generaron los datos — en lugar de perder una hora rastreando 500 archivos. Esta es la capa de auditoría que el procesamiento manual nunca tuvo.
La normalización del GPA necesita una regla, no una fórmula. Cuando su base de datos contenga GPAs de escuelas secundarias con escala de 4.0, escala de 5.0, escala de 100 puntos y escala IB de 7 puntos en la misma columna, cualquier comparación automática de GPA no tiene sentido. Cree una columna complementaria — GPA Scale — que conserve la escala original junto con el valor GPA bruto. La normalización a una métrica comparable ocurre aguas abajo, en el paso de evaluación de créditos, no a nivel de la base de datos. Colapsar todos los GPAs en un solo número recalculado durante la extracción es un error común: destruye la evidencia que necesita cuando un estudiante o padre cuestiona la evaluación.
Para las entradas de cursos, el paso de fusión también es donde puede comenzar el mapeo de articulación: comparar los nombres de cursos extraídos con la base de datos de equivalencias de cursos de su universidad. Esta no es una tarea de extracción por lotes; es una búsqueda posterior a la fusión que empareja cada fila de curso extraída con una equivalencia conocida cuando existe, y marca las filas sin coincidencia para revisión manual. El trabajo de la herramienta de extracción es colocar el nombre del curso, el código y la calificación en columnas etiquetadas. El mapeo de articulación es la experiencia de su equipo de admisiones, aplicada sobre una base de datos limpia en lugar de sobre PDFs individuales.
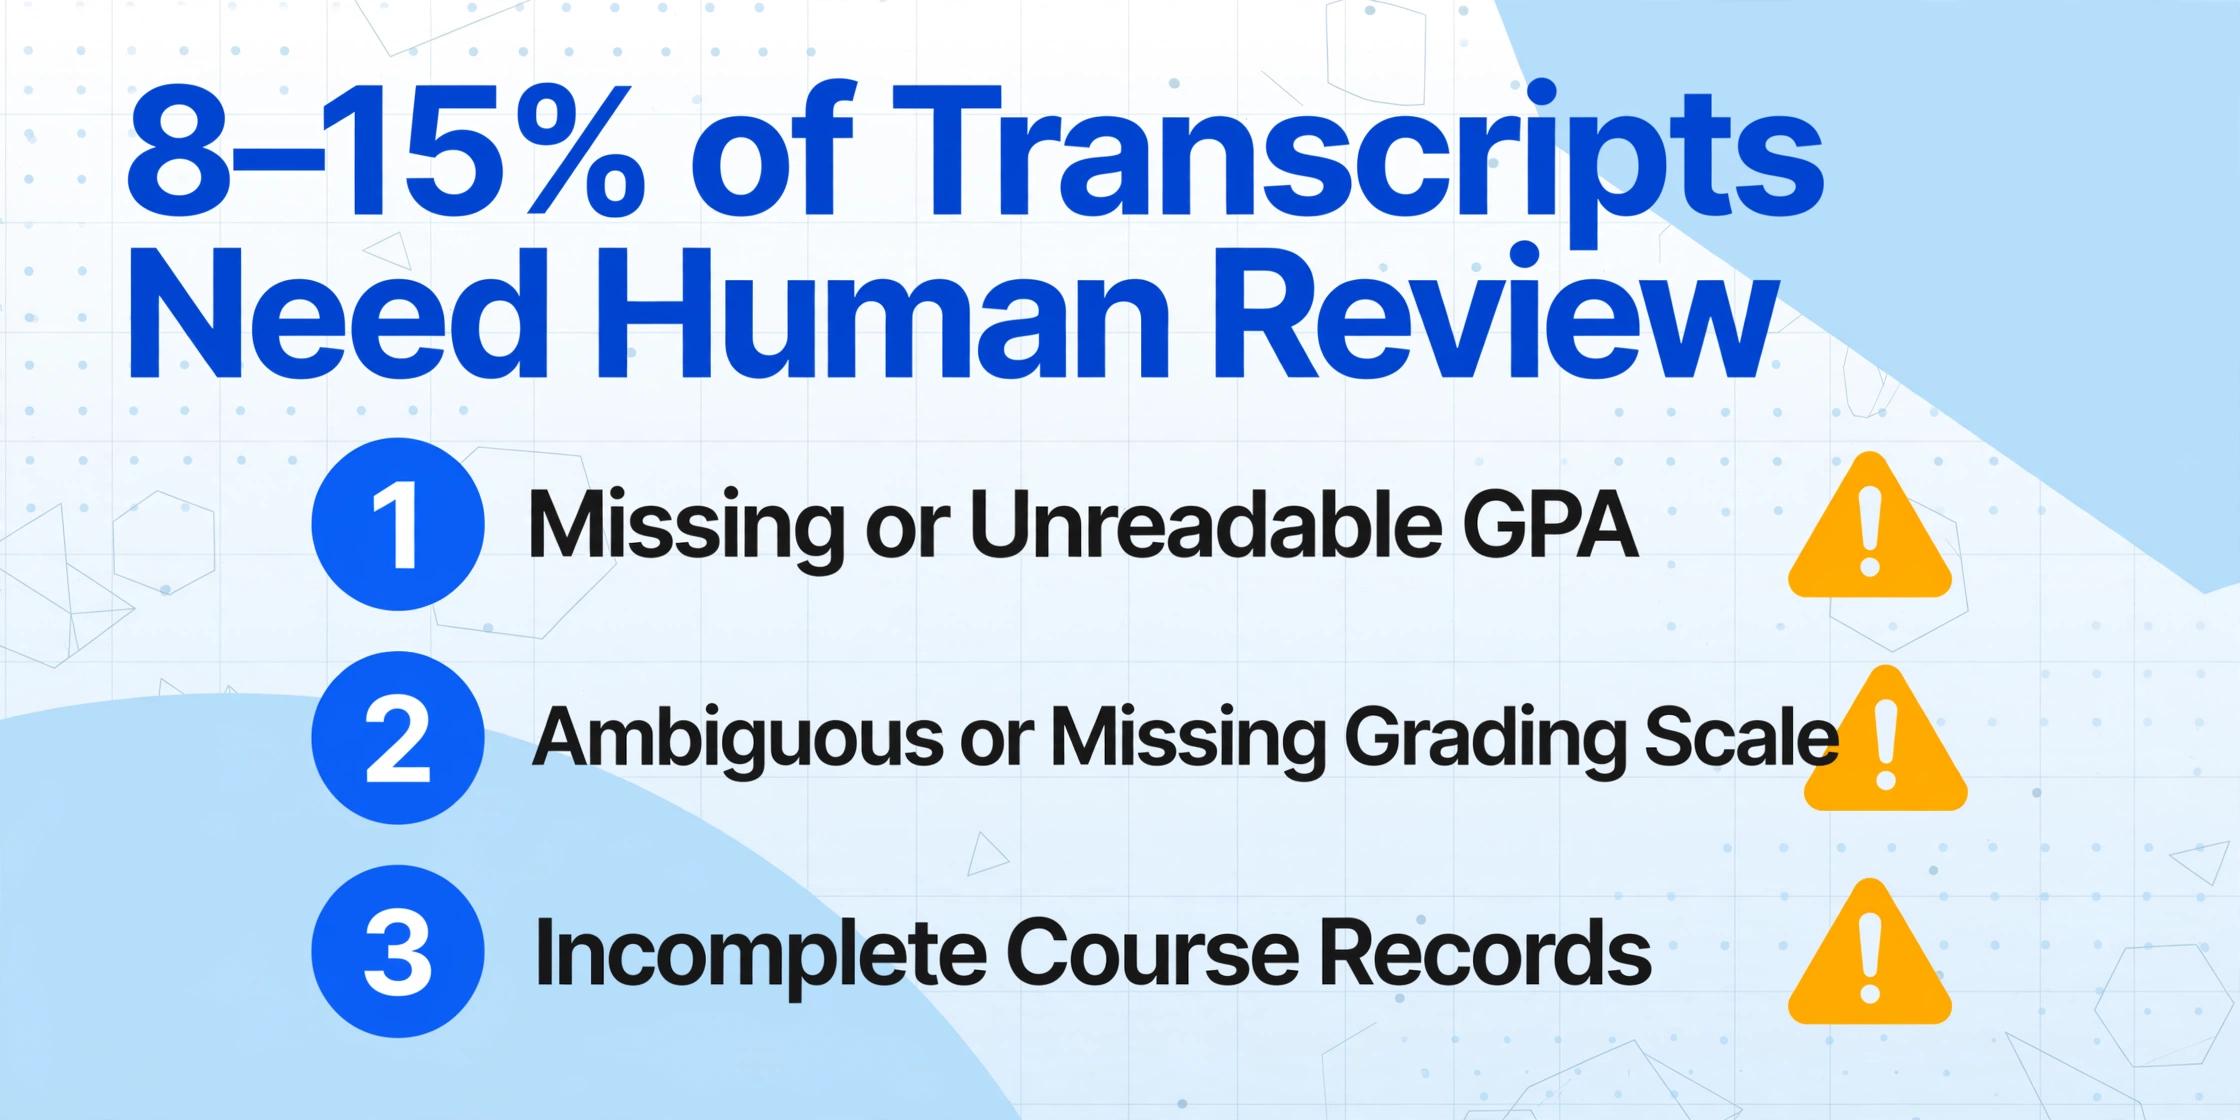
Manejo de Excepciones: Qué Hacer Cuando el 8–15% de los Expedientes Requiere Revisión Humana
Cada proceso por lotes genera excepciones. El objetivo no es cero excepciones, sino una cola de excepciones estructurada que un solo revisor pueda despejar en menos de una hora. Estas son las categorías de excepción que aparecen de manera consistente en el procesamiento por lotes de expedientes, y cómo manejar cada una sin descarrilar el proceso.
GPA Faltante o Ilegible
Algunos expedientes de secundaria — particularmente de distritos pequeños e instituciones internacionales — no muestran un GPA acumulativo como una cifra única. Otros lo imprimen en un tamaño de fuente tan pequeño que las copias escaneadas lo muestran como puntos borrosos. Cuando el campo de GPA esté vacío en su resultado de extracción, marque la fila, pero no detenga el lote. Estas filas van a la cola de excepciones con una nota: "GPA no extraído — verificar desde el original."
Escala de Calificación Ambigua o Ausente
Un transcript que muestra un GPA de "3.8" sin indicar si la escala es de 4.0, 5.0 o 12.0 representa un riesgo para la colocación. El resultado de la extracción debe completar el campo Escala de GPA como "No Especificada" y enviar la fila a excepciones. El revisor verifica si la leyenda del transcript, el pie de página o el reverso indican la escala — o si el sitio web de la escuela secundaria documenta su política de calificación.
Registros de Cursos Incompletos
Algunos transcripts muestran solo las calificaciones finales de cada curso sin desglose por semestre, horas de crédito o códigos de curso. Otros truncan los nombres de los cursos a 20 caracteres. Estas filas pueden extraerse técnicamente sin problemas, pero están incompletas para fines de articulación. Marque las filas donde el campo Código de Curso esté vacío o donde el número de entradas de cursos por año académico sea menor al esperado (normalmente de 5 a 8 cursos por año en una escuela secundaria estadounidense estándar).
Semestres Escasos o Ausentes
Un transcript que muestra cursos del otoño del último año pero nada de la primavera plantea un escenario común: el estudiante envió el transcript a mitad de año, antes de que se publicaran las calificaciones de primavera. Estos no son errores — son registros parciales. Márquelos como "En Espera del Transcript Final", no como excepciones. El proceso por lotes debe diferenciar entre "datos que existen pero no fueron capturados" y "datos que aún no se han generado".
El Flujo de Trabajo de la Cola de Excepciones
Después de que cada lote se complete, ejecute una pasada de validación que verifique campos obligatorios vacíos, valores de GPA inesperados (fuera de los rangos 0–5.0 o 0–100) y recuentos de cursos por debajo de un umbral. Las filas marcadas van a una hoja de Excepciones dedicada — nunca intente correcciones automáticas, porque una corrección automática demasiado confiada crea errores que son más difíciles de encontrar que las celdas vacías.
Priorice las excepciones que bloquean decisiones posteriores: primero el Nombre del Estudiante o la Fecha de Graduación en blanco (no se puede verificar la identidad ni la elegibilidad); segundo, el GPA faltante (bloquea la evaluación de becas y honores); tercero, los registros de cursos incompletos (bloquea la colocación pero no la admisión). Procesar por orden de llegada desperdicia tiempo en excepciones de bajo impacto mientras las filas de alto riesgo esperan.
Si está dedicando más de 2 minutos a una sola excepción, escálela — ya sea a un revisor senior o a una cola de "Solicitar Aclaración" donde se contacte al estudiante o a la escuela secundaria para obtener un transcript actualizado. La ganancia de eficiencia del procesamiento por lotes desaparece cuando las excepciones consumen el tiempo que se suponía que debían ahorrar.
Una cola de excepciones bien estructurada se procesa en 20 a 45 minutos para una clase entrante de 500 estudiantes. La clave está en separar "requiere revisión humana" de "requiere reexaminación del documento original" — dos categorías de trabajo completamente diferentes que los pipelines deficientes combinan en una sola pila de "problemas".
Preguntas Frecuentes
¿El procesamiento por lotes puede manejar expedientes internacionales con sistemas de calificación no estándar?
Sí, pero con una salvedad importante. La extracción por lotes puede obtener nombres de cursos, calificaciones y GPA en columnas etiquetadas independientemente del sistema de calificación — ya sea IB (1–7), A-Levels (A*–E), el Baccalauréat francés (0–20) o el sistema de porcentajes CBSE de India. Lo que no puede hacer es realizar la evaluación de credenciales — determinar si un 5 de IB en Matemáticas HL equivale a MATH 101 de tu universidad. Ese conocimiento especializado reside en tu equipo de admisiones internacionales y en servicios externos de evaluación de credenciales como WES o ECE. El trabajo del proceso por lotes es obtener los datos sin procesar en una base de datos para que los evaluadores comparen filas, no PDFs.
¿Qué porcentaje de expedientes suele requerir revisión manual tras la extracción por lotes?
En el caso de uso del procesamiento de expedientes, espera que entre el 8 y el 15% de las filas requieran revisión humana — menor que en el procesamiento por lotes de facturas (donde la variación de formato es mayor) pero mayor que en el procesamiento por lotes de COI (donde el formulario ACORD 25 estandariza el diseño). Los desencadenantes más comunes de revisión manual son expedientes escaneados en papel con problemas de calidad de imagen, expedientes de escuelas que usan notación de calificación no estándar y expedientes internacionales donde los nombres de los cursos no siguen las convenciones estadounidenses. Si tu tasa de excepción supera el 20%, revisa la calidad de tus escaneos — los escaneos deficientes son el mayor predictor de brechas en la extracción.
¿La extracción por lotes funciona con PDFs de Parchment y National Student Clearinghouse?
Sí. Los expedientes entregados a través de Parchment Receive y National Student Clearinghouse son PDFs estándar — la capa de entrega electrónica maneja la autenticación y el enrutamiento, pero el documento en sí sigue siendo un diseño visual que la extracción por lotes lee de la misma manera que cualquier otro PDF. La ventaja de los expedientes de entrega electrónica es la calidad digital consistente: sin inclinación del escáner, sin notas manuscritas en los márgenes, sin papel térmico descolorido. Dicho esto, incluso los PDFs de Parchment varían entre escuelas secundarias porque cada escuela configura su propia plantilla de expediente dentro del sistema Parchment — por lo que el diseño sigue variando, solo que con una mejor calidad base.
¿Cómo asegurarse de que los datos del curso correcto correspondan al estudiante correcto?
Tres salvaguardas. Primero, la convención del nombre del archivo (APELLIDO_NOMBRE_PREPARATORIA.pdf) incorpora la identidad del estudiante en cada archivo fuente. Segundo, cada fila de extracción hereda el nombre del archivo fuente, creando un rastro persistente. Tercero, extraiga Nombre del Estudiante y Preparatoria como columnas explícitas, luego coteje con su base de datos de solicitantes antes de fusionar en la base de datos final de admisiones. Si el nombre extraído de una fila no coincide con ningún estudiante inscrito, o si un expediente menciona una preparatoria no listada en la solicitud del estudiante, márquelo — es un error de ingreso al sistema o un estudiante que presentó credenciales de múltiples instituciones.
¿Puede el mismo proceso por lotes procesar expedientes de estudiantes transferidos junto con los de primer ingreso?
Técnicamente sí, pero logísticamente es mejor separarlos. Los expedientes de transferencia contienen cursos universitarios con códigos, horas crédito y cadenas de prerrequisitos que requieren un proceso de evaluación de convalidación diferente al de los expedientes de preparatoria. Procesarlos en el mismo proceso con las mismas definiciones de columna generará filas que parecen limpias pero requieren una revisión durante el mapeo de convalidación — momento en el cual se pierde el tiempo ahorrado al combinar lotes. Ejecute los expedientes de primer ingreso y transferencia como proyectos por lotes separados con diferentes conjuntos de columnas optimizados para cada tipo de documento.
Qué Cambia Cuando Dejas de Ingresar y Empiezas a Procesar
El cambio de ingreso manual a procesamiento por lotes cambia más que la velocidad. Cambia lo que su equipo de admisiones realmente hace con su tiempo durante el verano.
Un miembro del personal que antes dedicaba 167 horas escribiendo nombres de cursos en el SIS ahora dedica esas horas a evaluación y convalidación — revisando filas excepcionales, mapeando equivalencias de cursos y verificando que los GPA extraídos en escalas no estándar estén ponderados correctamente según los umbrales de becas. Ese es el trabajo que requiere conocimiento institucional y juicio humano, y es el trabajo que el ingreso manual posponía hasta septiembre, después de la orientación, cuando las correcciones son más difíciles de hacer.
El procesamiento por lotes no elimina la revisión humana — la mueve al lugar correcto en el proceso: después de que los datos están estructurados pero antes de que entren al registro permanente. El resultado es una base de datos donde cada fila es trazable hasta un archivo fuente, cada excepción está registrada con una resolución, y cada GPA está anotado con su escala original — el tipo de pista de auditoría que el ingreso manual, por su naturaleza, nunca podría producir.
Para una universidad mediana que procesa 500 expedientes de primer ingreso, esa diferencia es la distancia entre un verano dedicado a ingreso de datos y un verano dedicado a la preparación estudiantil. Comience con un solo lote — una carpeta fuente, 50 expedientes y el conjunto de columnas definido en el Paso 3 anterior. Vea cuántas filas pasan limpias y cuánto tarda en vaciarse su cola de excepciones. Esa prueba piloto le dice más sobre la preparación para lotes de su institución que cualquier tabla comparativa de funciones.
Procese Expedientes Estudiantiles por Lotes en una Base de Datos
Defina sus columnas una vez, cargue sus expedientes y obtenga una base de datos de admisiones fusionada — sin ingreso manual de datos.
Comenzar Procesamiento