500 Freshman-Zeugnisse,
eine Zulassungsdatenbank
Jeden Sommer, nach Ablauf der Zulassungsfristen am 1. Mai, steht die Zulassungsabteilung einer mittelgroßen Universität vor demselben Rechenproblem: rund 500 neue Freshmen, jeder mit mindestens einem High-School-Zeugnis – und jedes Zeugnis benötigt schätzungsweise 20 Minuten manuelle Eingabe in das Studenteninformationssystem. Das sind 167 Arbeitsstunden – vier volle Arbeitswochen für eine Person – zwischen Juni und August, während die Fristen für Orientierung und Kursanmeldung die ganze Zeit drängen. Der Engpass ist nicht die Menge. Es ist die Tatsache, dass 500 Zeugnisse in 500 verschiedenen Formaten von 500 verschiedenen High Schools eintreffen, und jedes Format erfordert dieselben menschlichen Augen, um es zu entschlüsseln.
Wichtigste Erkenntnisse
- 167 Arbeitsstunden – das ergibt sich aus 500 Freshman-Zeugnissen à 20 Minuten, und alles fällt in den Zeitraum zwischen Juni und August, wenn Orientierungsfristen nicht warten.
- 5 Zeugnisse zu verarbeiten ist ein Nachmittag, aber 500 sind ein struktureller Zusammenbruch – menschliche Aufmerksamkeit skaliert nicht linear, und ab Zeugnis 120 übersehen Sie, dass ein B+ von einer 13-Punkte-Skala als 3,3 auf einer 4,0-Skala eingegeben wurde.
- Batch-Extraktion eliminiert den Prüfer nicht – sie verwandelt diese 167 Stunden vom Tippen von Kursnamen in die Bewertung von Kursäquivalenzen, was genau das ist, wofür Ihr institutionelles Wissen ursprünglich eingestellt wurde.
Für die Grundlagen der Datenextraktion aus einem einzelnen Zeugnis – welche Felder erfasst werden, wie Sie Ihre Spaltendefinitionen einrichten und wie ein fertiger Extrakt aussieht – beginnen Sie mit unserem Leitfaden zur Extraktion von Studentenzeugnisdaten in Excel. Was hier folgt, ist die Skalierungsebene: alles, was sich ändert, wenn Sie von der Verarbeitung eines Zeugnisses zur Verarbeitung von 500 übergehen, und wie Sie eine Pipeline aufbauen, die bis August eine zulassungsfertige Datenbank liefert.
Der Sommeranstieg bei Zeugnissen: Zahlen und Volumen
Die meisten Diskussionen über Zulassungsabläufe konzentrieren sich auf die Bewerbungssaison – Early Decision im November, Regular Decision von Januar bis März. Doch der Engpass bei der Zeugnisverarbeitung tritt später auf, nachdem die Anzahlungen eingegangen sind. Die National Association for College Admission Counseling berichtet, dass jährlich etwa 2,9 Millionen Erstsemester an US-amerikanischen Hochschulen eingeschrieben werden. Für eine mittelgroße Universität – laut Carnegie Classification mit 5.000 bis 15.000 Studierenden – bedeutet das etwa 3.000 bis 10.000 Bewerbungen pro Zyklus.
Eine mittelgroße Universität, die 2.500 Studierende zulässt und 1.000 eingeschriebene Erstsemester verzeichnet, verarbeitet in den Sommermonaten etwa 500 bis 700 High-School-Zeugnisse, plus zusätzliche Zeugnisse von Transferstudierenden und Dual-Enrollment-Programmen. Jedes Zeugnis muss Kursnamen, Noten, Leistungspunkte, GPA und die Verifizierung des Abschlusses extrahieren, bevor der Studierende in die richtigen Kurse eingeteilt werden kann. Ein 2023 von Parchment gesponserter AACRAO-Connect-Artikel bezifferte die manuelle Zeugnisdatenerfassung auf 20 Minuten pro Bewerbung. Bei 500 Zeugnissen sind das 167 Stunden – komprimiert in ein 8- bis 10-Wochen-Fenster zwischen Einzahlungsfristen und Orientierungswoche.
Der Zeitpunkt ist der Multiplikator. Zulassungsbüros haben keine 167 Stunden Spielraum. Sie haben dieselben 40-Stunden-Wochen wie immer, mit demselben Personal, im selben Zeitfenster. Und jeder Tag Verzögerung – jedes Zeugnis, das in einer Verarbeitungswarteschlange liegt, während der Studierende auf eine Kurszuweisungs-E-Mail wartet – zehrt an der Einschreibequote. Studierende, die nicht schnell eine Rückmeldung erhalten, entscheiden sich anderweitig oder schreiben sich auf Grundlage unvollständiger Bewertungen in Kurse ein, was im September Chaos beim Hinzufügen/Abwählen verursacht.
Warum die manuelle Transkript-Erfassung bei 500 scheitert
Ein Transkript manuell zu verarbeiten ist mühsam, aber machbar. Fünf Transkripte – eine Nachmittagsarbeit. Fünfzig – eine ganze Woche. Bei 500 geht es nicht mehr um Zeit, sondern um einen strukturellen Zusammenbruch der menschlichen Aufmerksamkeit im großen Maßstab.
Jedes Transkript erfordert die gleiche kognitive Abfolge: Name und Highschool des Schülers finden, die Notenskala entschlüsseln (4.0, 5.0 oder 100-Punkte-Skala?), jeden Kursnamen und seine Note lesen, Semesterbezeichnungen zuordnen, den Abschlussstatus prüfen und jedes Feld in das SIS eingeben. Kursnamen sind der größte Reibungspunkt. „English 9 Honors“ an einer Schule heißt an einer anderen „ENGL 101H“ und an einer dritten „Composition & Literature I (Advanced)“ – aber alle drei müssen auf denselben Eintrag in Ihrer Anrechnungsdatenbank abgebildet werden.
Bei 20 Transkripten fallen einem Mitarbeiter diese Abweichungen auf. Bei 120 beginnen die Mustererkennungszentren des Gehirns, ähnlich aussehende Einträge zu vermischen. Ein „B+“ von einer Schule mit einer 13-Punkte-GPA-Skala (A+ = 4,33) wird als 3,3 auf einer 4,0-Skala eingegeben, weil der Cursor den ganzen Morgen im 4,0-Modus war. Ein Transkript mit einer Spalte „Bestanden/Nicht bestanden“ für Kurse im Frühjahr 2020 – eine häufige COVID-Variante – wird ohne Kennzeichnung eingegeben, weil der Bearbeiter bei Transkript Nummer 80 aufgehört hat, Spaltenüberschriften zu lesen. Der gesponserte Inhalt von Inside Higher Ed von Laserfiche bestätigt dies: „Studententranskripte sind so anfällig für menschliche Fehler“, dass ihre automatisierte Lösung entwickelt wurde, um falsch formatierte Einträge zu markieren, bevor sie menschliche Prüfer erreichen – ein Eingeständnis, dass die manuelle Eingabe genügend Fehler produziert, um eine eigene Validierungsebene zu erfordern.
Der Unterschied zwischen 5 und 500 Transkripten ist nicht nur mehr Zeit – es ist eine völlig andere Problemkategorie. Bei 5 prüft man nach. Bei 500 stichprobt man – und hofft, dass die anderen 495 keine Fehler enthalten, die zu falschen Kurszuweisungen, Fehlberechnungen von Credits oder verzögerten Abschlussprüfungen führen.
Die Formate: Elektronisch, Papier und alles dazwischen
Die Vorstellung: Alle Zeugnisse kommen über Parchment oder den National Student Clearinghouse in einem einheitlichen elektronischen Format. Die Realität in den meisten Zulassungsbüros sieht eher wie ein hybrider Posteingang aus:
| Kanal | Üblicher Anteil | Format | Herausforderung bei der Extraktion |
|---|---|---|---|
| Parchment / Clearinghouse ETX | 55–65 % | EDI (SPEEDE TS130), PDF oder strukturiertes XML | EDI wird automatisch in manche SIS-Systeme eingelesen; PDF-Varianten unterscheiden sich je nach Parchment-Konfiguration der Schule |
| Common App-Integration | 10–15 % | Strukturierter Datenfeed | Begrenzte Felder – meist nur GPA und Kernfachübersicht, keine vollständigen Zeugnisdetails |
| Direkt per E-Mail / Upload-Portal | 10–15 % | PDF (gescannt oder digitaler Export) | Layout variiert stark; manche sind eingescannt, andere aus dem SIS der Schule mit individuellem Format exportiert |
| Physische Post (Papier) | 5–10 % | Papier → von der Zulassungsstelle eingescannt | Scanqualität, Schräglage, Schatten; handschriftliche Notizen auf offiziellen Formularen |
| International / Nicht-traditionell | 3–5 % | PDF, gescannte Bilder, übersetzte Dokumente | Nicht standardisierte Notensysteme (IB, A-Levels, nationale Lehrpläne), Sprachübersetzung, Zeugnisbewertung |
Die AACRAO-Umfrage 2018 zu Zeugniskosten, -art und -volumen ergab, dass etwa 15 % der Zeugnisse noch auf Papier geliefert wurden. Diese Zahl ist seither wahrscheinlich gesunken, aber kleinere Schulbezirke und internationale Einrichtungen versenden weiterhin Papier – und diese Zeugnisse landen zuerst im Scanner, bevor sie ins SIS gelangen. Jeder Scan bringt eigene Variablen mit: Kontrast, Schräglage, Randbeschnitt, Lesbarkeit von Kleingedrucktem bei Notenschlüsseln.
Eine Batch-Verarbeitungspipeline, die nur Parchment-EDI verarbeitet, löst nur die Hälfte des Problems. Die Zeugnisse, die das meiste Personal binden, sind genau die, die außerhalb elektronischer Netzwerke eingehen – eingescanntes Papier, per E-Mail versendete PDFs von Schulen ohne Austauschvereinbarungen und internationale Zeugnisse. Ein Workflow, der sich lohnt, verarbeitet alle.
Aufbau der Batch-Verarbeitungspipeline: 6 Schritte vom Posteingang zur Datenbank
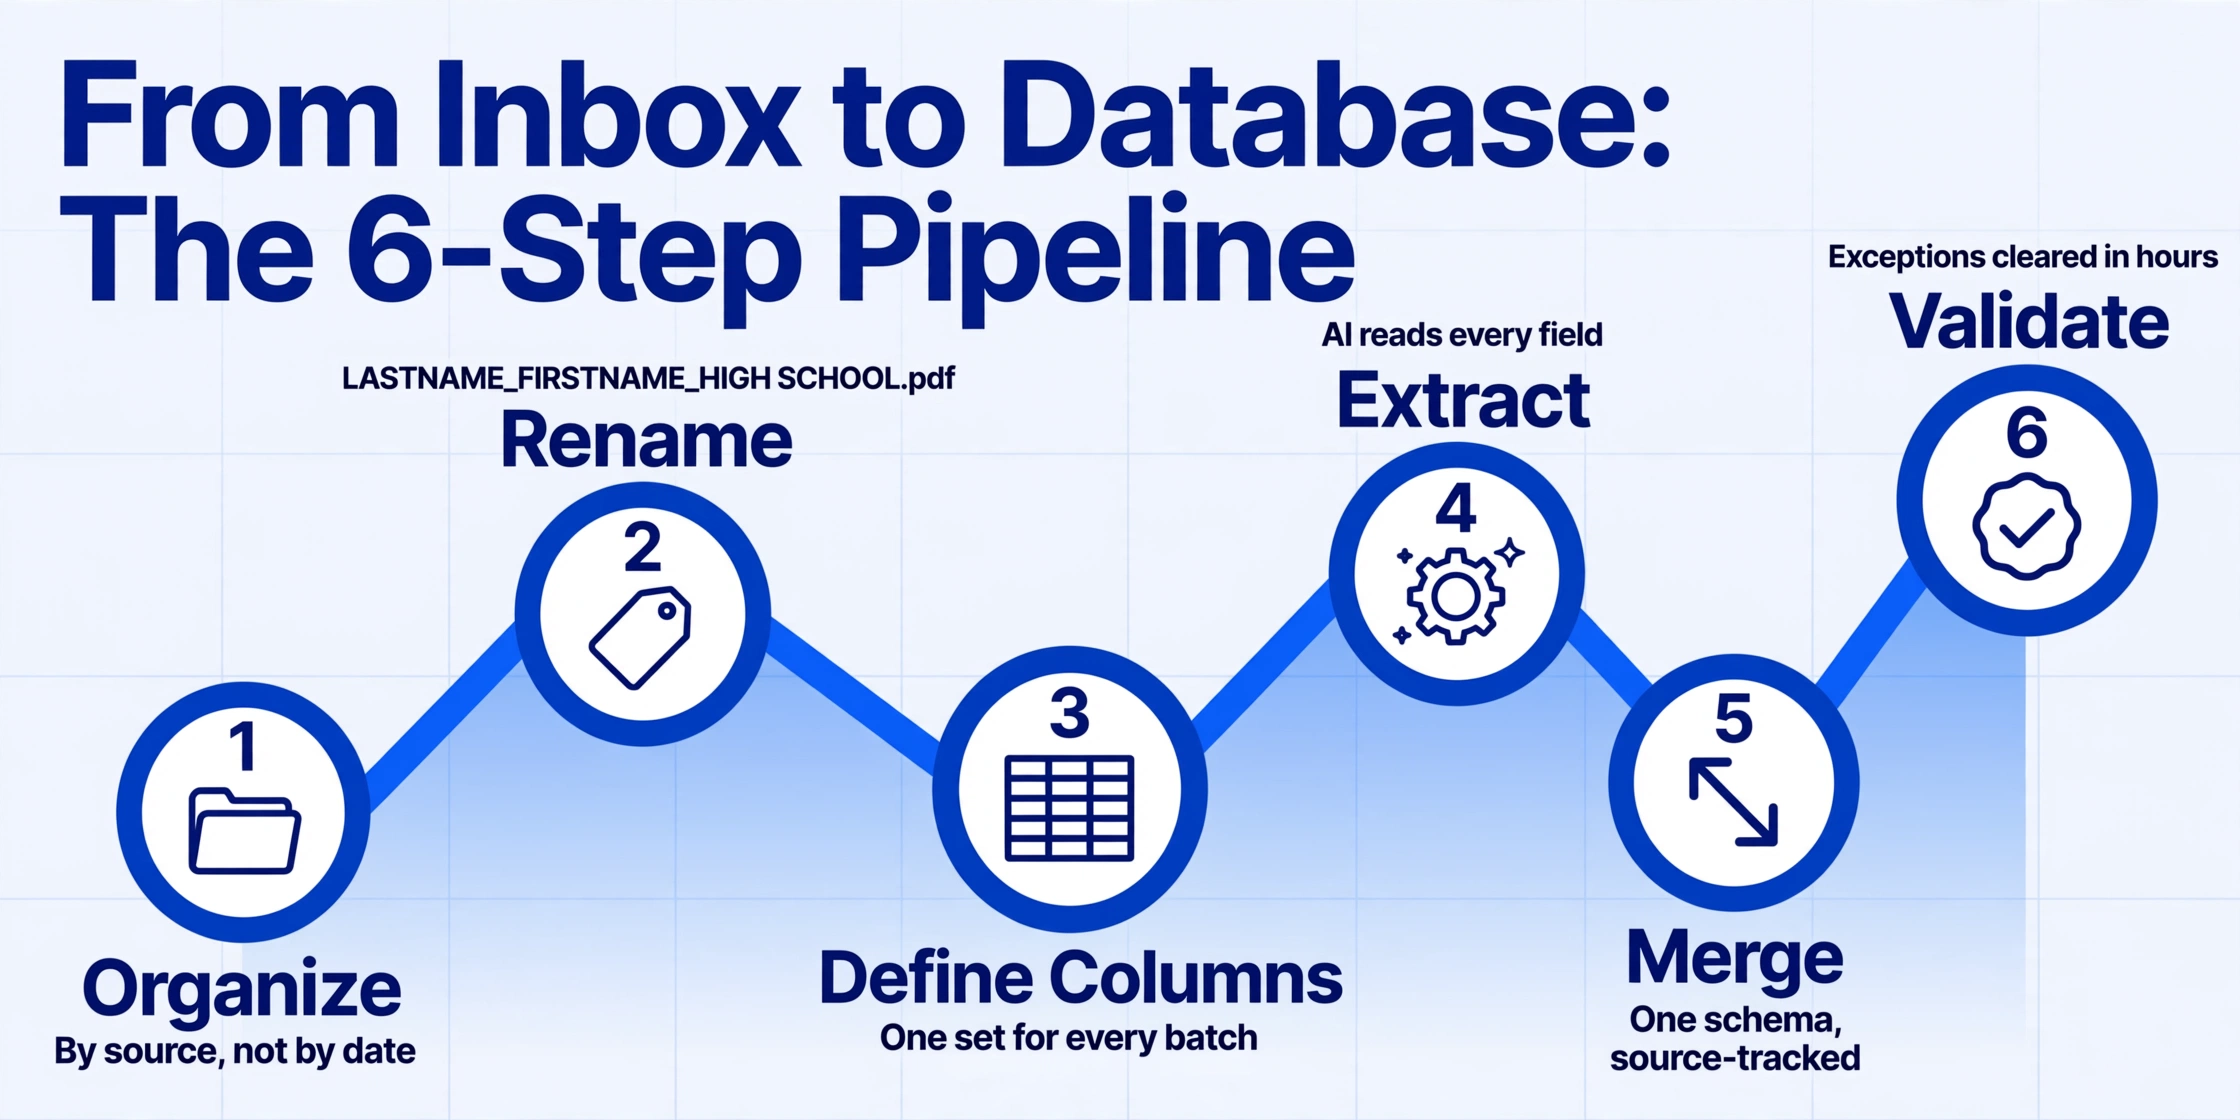
Dies ist kein Software-Review-Abschnitt. Es ist der praktische Workflow, der 500 unterschiedliche Dokumente in eine saubere Zulassungsdatenbank verwandelt – unabhängig davon, welches Extraktionstool Sie verwenden. Für einen tieferen Einblick in die Tool-Auswahl bei der Batch-Dokumentenverarbeitung – welche Funktionen wichtig sind und wo verschiedene Tool-Kategorien an ihre Grenzen stoßen – lesen Sie unseren Leitfaden zu Batch-OCR-Workflows. Dieser Artikel behandelt Desktop-OCR, Cloud-APIs und KI-Extraktionsstufen. Hier konzentrieren wir uns auf die transkriptspezifische Pipeline.
Erstellen Sie einen Ordner pro Quellentyp: parchment/, common-app/, scanned-paper/, international/. Die Quelle ist der stärkste Indikator für Formatkonsistenz, und die Gruppierung nach Quelle ermöglicht es Ihnen, Extraktionsregeln einmal pro Ordner statt pro Datei zu konfigurieren. Wenn Ihr Tool die Verarbeitung von Unter-Batches unterstützt, wird jeder Ordner zu einem eigenen Verarbeitungs-Batch.
Benennen Sie jede Datei vor der Verarbeitung: LASTNAME_FIRSTNAME_HIGHSCHOOL.pdf. Diese Konvention erfüllt drei Zwecke: Sie dient als menschenlesbare Warteschlange, sie bettet einen Querverweisschlüssel in jede Ausgabezeile ein und sie macht die Ausnahmebehandlung durchsuchbar. Der Worst Case sind 500 Dateien mit den Namen transcript(1).pdf bis transcript(500).pdf – wenn eine Zeile die Validierung nicht besteht, haben Sie keine Möglichkeit, zum Quelldokument zurückzuverfolgen.
Ihr Spaltensatz sollte umfassend genug sein, um jede Zeugnisvariante zu erfassen, aber nicht so granular, dass die KI-Extraktion darunter leidet: Student Name, High School, Graduation Date, GPA, GPA Scale, Course Name, Course Code, Grade, Credits Earned, Term/Semester. Die Spalte GPA Scale ist am wertvollsten – sie erfasst, ob die Schule eine 4.0-, 5.0- oder 100-Punkte-Skala verwendet, und zeigt Ihrem Anrechnungsprüfer, ob eine „3.8" und eine „95" gleichwertig sind oder nicht.
Verarbeiten Sie jeden Ordner als eigenen Stapel, anstatt alle 500 in eine einzige Verarbeitungswarteschlange zu laden. Von Parchment stammende Zeugnisse teilen eine gemeinsame PDF-Struktur – die gemeinsame Verarbeitung verbessert die Extraktionskonsistenz, da die KI auf weniger Formatdiskontinuitäten trifft. Gescannte Papierzeugnisse werden als separater Stapel verarbeitet, idealerweise nachdem Sie die Scanqualität an den ersten 5 bis 10 Dateien stichprobenartig geprüft haben. Für einen Überblick darüber, wie sich KI-basierte Extraktion von traditioneller OCR unterscheidet – und warum das wichtig ist, wenn Ihre Dokumente kein einheitliches Layout haben – lesen Sie unseren Leitfaden zu OCR vs. KI-Dokumentenextraktion.
Markieren Sie nach Abschluss jedes Stapels alle Zeilen, in denen wichtige Felder fehlen – leerer Studentenname, leere GPA oder weniger Kurseinträge als erwartet. Diese werden zu Ihrer Ausnahmewarteschlange: einer kurzen Liste von 5 bis 15 % der Zeugnisse, die einer manuellen Prüfung bedürfen. Der Unterschied zwischen Stapelverarbeitung und Stapelchaos liegt darin, ob Ausnahmen sofort behandelt oder in der zusammengeführten Ausgabe vergraben werden. Erstellen Sie ein Blatt „Ausnahmen" neben Ihrer Hauptdatenbank und leiten Sie markierte Zeilen dort mitten im Prozess hin, nicht als Aufräumschritt nach der Zusammenführung.
Konsolidieren Sie alle Stapelausgaben in einer einzigen Tabelle oder Datenbanktabelle und fügen Sie eine Spalte Source Batch hinzu, wobei der ursprüngliche Dateiname in einer Spalte Source File erhalten bleibt. Diese beiden Spalten sind Ihre Prüfpfad – wenn ein Student eine Kursplatzierung anficht, müssen Sie die Entscheidung bis zum genauen Zeugnis und Extraktionsstapel zurückverfolgen können, nicht nur der Datenbank auf den ersten Blick vertrauen. Für Stapelexport-Workflows über mehrere Quellengruppen hinweg gilt dasselbe Zusammenführungs- und Verfolgungsprinzip für Stapelverifizierung über jeden Dokumenttyp hinweg – die Quellenspalte ist es, die eine zusammengeführte Tabelle prüfbar macht.
Von 500 Transkripten zu einer Datenbank: Der Zusammenführungs- und Validierungsschritt
An diesem Punkt haben Sie Batch-Ausgaben – eine Tabelle pro Quellordner – aber noch keine einheitliche Zulassungsdatenbank. Der Zusammenführungsschritt ist der Punkt, an dem die meisten Batch-Pipelines an Kohärenz verlieren, weil hier Daten aus verschiedenen Quellen, die zu unterschiedlichen Zeiten verarbeitet wurden, einem einzigen Schema entsprechen müssen.
Die Schema-Durchsetzung erfolgt beim Zusammenführen. Vor der Konsolidierung müssen Sie jede Batch-Ausgabe auf dieselbe Spaltenreihenfolge und Namenskonvention standardisieren. Wenn Ihr Parchment-Batch die GPA-Spalte „Cumulative GPA" nannte und Ihr Scan-Batch sie „GPA (Weighted)" nannte, gleichen Sie diese vor dem Zusammenführen ab – andernfalls erhalten Sie zwei parallele GPA-Spalten mit jeweils teilweisen Daten. Ein Normalisierungslauf vor der Zusammenführung dauert 10 Minuten und erspart Ihnen später stundenlange Tabellenforensik.
Quellenverfolgung ist unverzichtbar. Fügen Sie jeder zusammengeführten Zeile zwei Spalten hinzu: Source Batch (welcher Verarbeitungslauf diese Zeile erzeugt hat) und Source File (der ursprüngliche Dateiname). Wenn eine Kursäquivalenz-Entscheidung im Oktober von einem Fachbereichsleiter in Frage gestellt wird, zeigen Ihnen diese Spalten in 30 Sekunden, welches Transkript und welcher Extraktionslauf die Daten erzeugt haben – statt eine Stunde damit zu verbringen, 500 Dateien zurückzuverfolgen. Dies ist die Audit-Ebene, die die manuelle Verarbeitung nie hatte.
GPA-Normalisierung braucht eine Regel, keine Formel. Wenn Ihre Datenbank GPAs von 4.0-Skalen, 5.0-Skalen, 100-Punkte-Skalen und IB-7-Punkte-Skalen von High Schools in derselben Spalte enthält, ist jeder automatische GPA-Vergleich bedeutungslos. Erstellen Sie eine Begleitspalte – GPA Scale – die die ursprüngliche Skala zusammen mit dem rohen GPA-Wert bewahrt. Die Normalisierung in eine vergleichbare Kennzahl erfolgt nachgelagert im Leistungsbewertungsschritt, nicht auf Datenbankebene. Alle GPAs während der Extraktion in eine einzige neu berechnete Zahl zu kollabieren, ist ein häufiger Fehler: Es zerstört die Nachweise, die Sie benötigen, wenn ein Student oder Elternteil die Bewertung in Frage stellt.
Bei Kursdatensätzen ist der Zusammenführungsschritt auch der Ort, an dem Sie mit der Artikulationszuordnung beginnen können – dem Abgleich extrahierter Kursnamen mit der Äquivalenzdatenbank Ihrer Hochschule. Dies ist keine Batch-Extraktionsaufgabe, sondern eine Nachschlageoperation nach der Zusammenführung, die jede extrahierte Kurszeile mit einer bekannten Äquivalenz abgleicht, sofern eine vorhanden ist, und Zeilen ohne Übereinstimmung zur manuellen Prüfung kennzeichnet. Die Aufgabe des Extraktionstools besteht darin, Kursname, Code und Note in beschriftete Spalten zu bringen. Die Artikulationszuordnung ist die Fachkompetenz Ihres Zulassungsteams, die gegen eine bereinigte Datenbank angewendet wird, statt gegen einzelne PDFs.
Ausnahmebehandlung: Was zu tun ist, wenn 8–15 % der Zeugnisse eine manuelle Prüfung benötigen
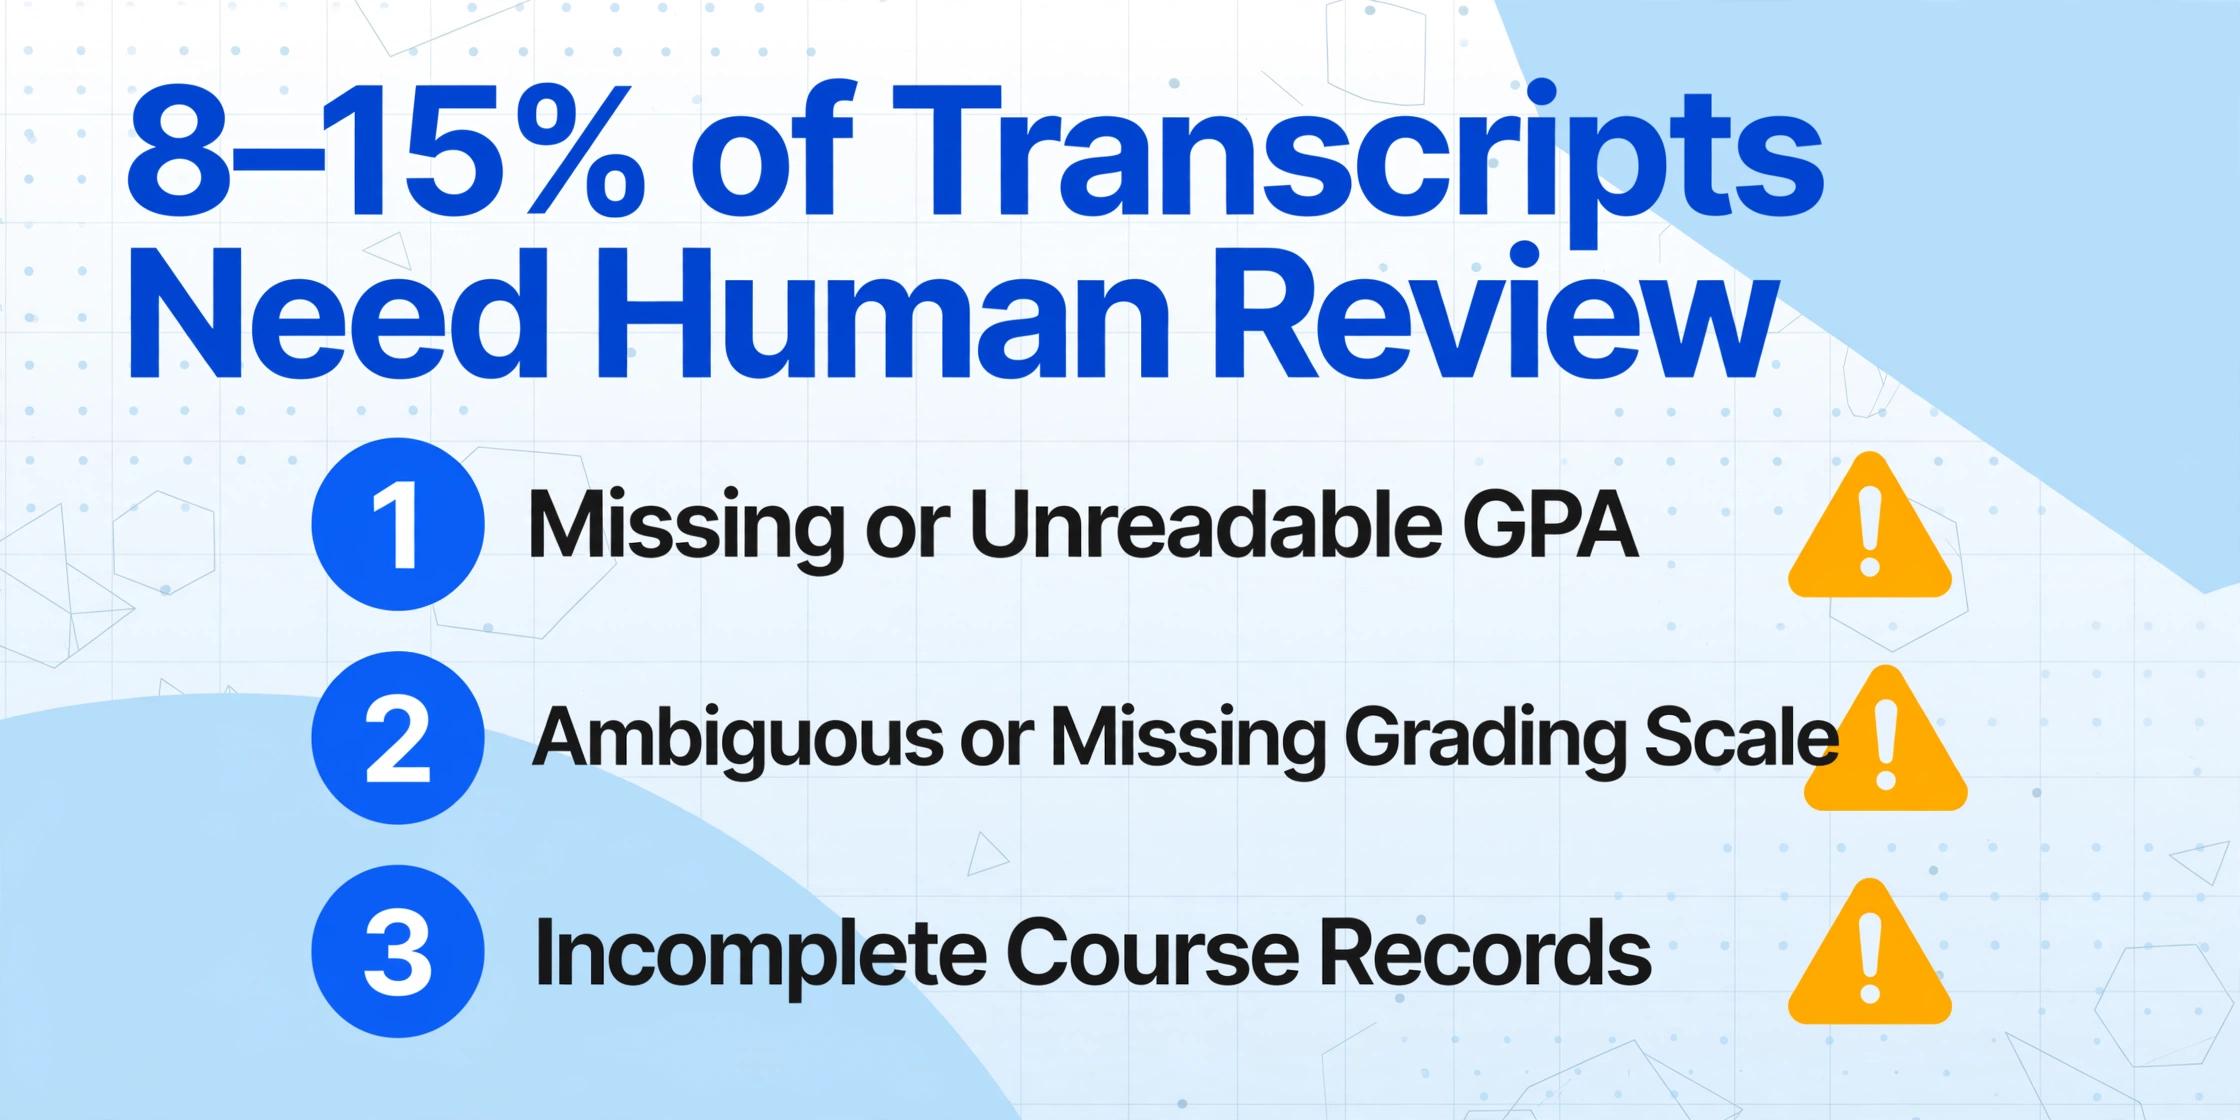
Jede Batch-Pipeline erzeugt Ausnahmen. Das Ziel ist nicht null Ausnahmen – sondern eine strukturierte Ausnahmewarteschlange, die ein einzelner Prüfer in unter einer Stunde abarbeiten kann. Hier sind die Ausnahmekategorien, die bei der Batch-Verarbeitung von Zeugnissen regelmäßig auftreten, und wie Sie jede einzelne behandeln, ohne die Pipeline zu unterbrechen.
Fehlender oder nicht lesbarer GPA
Einige High-School-Zeugnisse – insbesondere von kleineren Schulbezirken und internationalen Institutionen – weisen keinen kumulativen GPA als einzelne Zahl aus. Andere drucken ihn in einer Schriftgröße, die bei gescannten Kopien als verschmierte Punkte erscheint. Wenn das GPA-Feld in Ihrer Extraktionsausgabe leer ist, kennzeichnen Sie die Zeile, stoppen Sie jedoch nicht den Batch. Diese Zeilen gehen mit einem Hinweis in die Ausnahmewarteschlange: „GPA nicht extrahiert – anhand des Originals verifizieren.“
Fehlende oder unklare Notenskala
Ein Zeugnis, das den GPA als „3.8" angibt, ohne zu zeigen, ob die Skala 4.0, 5.0 oder 12.0 beträgt, stellt ein Platzierungsrisiko dar. Die Extraktionsausgabe sollte die GPA-Skala als „Nicht angegeben" ausweisen und die Zeile an die Ausnahmen weiterleiten. Der Prüfer kontrolliert, ob die Legende, Fußzeile oder Rückseite des Zeugnisses die Skala angibt – oder ob die Website der High School die Benotungsrichtlinien dokumentiert.
Unvollständige Kursdatensätze
Einige Zeugnisse zeigen nur Endnoten für jeden Kurs ohne Semesteraufschlüsselung, Leistungspunkte oder Kursnummern. Andere kürzen Kursnamen auf 20 Zeichen. Diese Zeilen lassen sich technisch sauber extrahieren, sind aber für Anrechnungszwecke unvollständig. Markieren Sie Zeilen, in denen das Feld Kursnummer leer ist oder die Anzahl der Kurseinträge pro Schuljahr unter der erwarteten Zahl liegt (in der Regel 5–8 Kurse pro Jahr an einer standardmäßigen US-Highschool).
Lückenhafte oder fehlende Semester
Ein Zeugnis, das Kurse für das Herbstsemester des Abschlussjahres zeigt, aber nichts für das Frühjahrssemester, wirft ein häufiges Szenario auf: Der Student hat das Zeugnis mitten im Jahr gesendet, bevor die Noten des Frühjahrssemesters veröffentlicht wurden. Das sind keine Fehler – es sind Teilaufzeichnungen. Markieren Sie sie als „Warten auf endgültiges Zeugnis", nicht als Ausnahmen. Die Batch-Pipeline sollte zwischen „Daten, die vorhanden, aber nicht erfasst wurden" und „Daten, die noch nicht erstellt wurden" unterscheiden.
Der Workflow der Ausnahmewarteschlange
Führen Sie nach jedem abgeschlossenen Batch einen Validierungslauf durch, der leere Pflichtfelder, unerwartete GPA-Werte (außerhalb der Bereiche 0–5.0 oder 0–100) und Kurszahlen unter einem Schwellenwert prüft. Markierte Zeilen gehen in ein eigenes Ausnahmenblatt – versuchen Sie niemals automatische Korrekturen, denn eine übermäßig selbstsichere Autokorrektur erzeugt Fehler, die schwerer zu finden sind als leere Zellen.
Priorisieren Sie Ausnahmen, die nachgelagerte Entscheidungen blockieren: zuerst leerer Studentenname oder leeres Abschlussdatum (Identität oder Berechtigung kann nicht verifiziert werden); an zweiter Stelle fehlender GPA (blockiert Stipendien- und Auszeichnungsbewertung); an dritter Stelle unvollständige Kursdatensätze (blockiert Platzierung, aber nicht Zulassung). Die Verarbeitung nach Eingangsreihenfolge verschwendet Zeit für Ausnahmen mit geringer Auswirkung, während kritische Zeilen warten.
Wenn Sie mehr als 2 Minuten für eine einzelne Ausnahme aufwenden, eskalieren Sie sie – entweder an einen leitenden Prüfer oder an eine Warteschlange „Klärung anfordern", in der der Student oder die Highschool um ein aktualisiertes Zeugnis gebeten wird. Der Effizienzgewinn der Batch-Verarbeitung verschwindet, wenn Ausnahmen die Zeit verbrauchen, die sie eigentlich einsparen sollten.
Eine gut strukturierte Ausnahmewarteschlange verarbeitet eine eingehende Klasse von 500 Studenten in 20 bis 45 Minuten. Der Schlüssel liegt darin, „erfordert menschliche Prüfung" von „erfordert erneute Prüfung des Originaldokuments" zu unterscheiden – zwei völlig verschiedene Arbeitskategorien, die schlechte Pipelines in einem einzigen „Probleme"-Stapel vermischen.
Häufig gestellte Fragen
Kann die Stapelverarbeitung internationale Zeugnisse mit nicht standardisierten Notensystemen verarbeiten?
Ja, aber mit einer wichtigen Einschränkung. Die Stapelverarbeitung kann Kursnamen, Noten und GPA unabhängig vom Notensystem in beschriftete Spalten extrahieren – egal ob IB (1–7), A-Levels (A*–E), französisches Baccalauréat (0–20) oder Indiens CBSE-Prozentsystem. Was sie nicht leisten kann, ist die eigentliche Zeugnisbewertung – also die Frage, ob eine IB 5 in Mathematik HL dem MATH 101 Ihrer Universität entspricht. Dieses Fachwissen liegt bei Ihrem internationalen Zulassungsteam und externen Zeugnisbewertungsdiensten wie WES oder ECE. Die Aufgabe der Stapelverarbeitung ist es, die Rohdaten in eine Datenbank zu überführen, damit Prüfer Zeilen vergleichen können – nicht PDFs.
Welcher Anteil der Zeugnisse erfordert nach der Stapelverarbeitung typischerweise eine manuelle Prüfung?
Im Bereich der Zeugnisverarbeitung ist bei 8 bis 15 % der Zeilen mit einer manuellen Prüfung zu rechnen – weniger als bei der Stapelverarbeitung von Rechnungen (wo die Formatvielfalt größer ist), aber mehr als bei der Stapelverarbeitung von COI-Dokumenten (wo das ACORD-25-Formular das Layout standardisiert). Die häufigsten Auslöser für eine manuelle Prüfung sind gescannte Papierzeugnisse mit Bildqualitätsproblemen, Zeugnisse von Schulen mit nicht standardisierten Notenangaben und internationale Zeugnisse, deren Kursnamen nicht den US-amerikanischen Konventionen folgen. Liegt Ihre Ausnahmerate über 20 %, überprüfen Sie Ihre Scanqualität – schlechte Scans sind der mit Abstand größte Prädiktor für Extraktionslücken.
Funktioniert die Stapelverarbeitung mit PDFs von Parchment und dem National Student Clearinghouse?
Ja. Zeugnisse, die über Parchment Receive und das National Student Clearinghouse zugestellt werden, sind Standard-PDFs – die elektronische Zustellungsebene kümmert sich um Authentifizierung und Weiterleitung, aber das Dokument selbst ist immer noch ein visuelles Layout, das die Stapelverarbeitung wie jedes andere PDF liest. Der Vorteil elektronisch zugestellter Zeugnisse ist die gleichbleibend digitale Qualität: kein Scannerversatz, keine handschriftlichen Randnotizen, kein verblasstes Thermopapier. Allerdings variieren selbst Parchment-PDFs zwischen verschiedenen High Schools, da jede Schule ihre eigene Zeugnisvorlage im Parchment-System konfiguriert – das Layout variiert also weiterhin, nur mit besserer Grundqualität.
Wie stellen Sie sicher, dass die richtigen Kursdaten dem richtigen Studierenden zugeordnet werden?
Drei Sicherheitsvorkehrungen. Erstens: Die Dateinamenskonvention (NACHNAME_VORNAME_SCHULE.pdf) verankert die Identität des Studierenden in jeder Quelldatei. Zweitens: Jede extrahierte Zeile übernimmt den Quelldateinamen und erzeugt so eine durchgängige Rückverfolgbarkeit. Drittens: Extrahieren Sie Studierendenname und Schule als eigene Spalten und gleichen Sie diese vor dem Zusammenführen in die endgültige Zulassungsdatenbank mit Ihrer Bewerberdatenbank ab. Stimmt der extrahierte Name einer Zeile mit keinem eingeschriebenen Studierenden überein oder verweist ein Zeugnis auf eine Schule, die nicht in der Bewerbung des Studierenden aufgeführt ist, markieren Sie den Eintrag – es handelt sich entweder um einen Systemeingabefehler oder um einen Studierenden, der Unterlagen von mehreren Einrichtungen eingereicht hat.
Kann dieselbe Batch-Pipeline auch Zeugnisse von Wechselstudierenden zusammen mit denen von Erstsemestern verarbeiten?
Technisch ja, aber organisatorisch ist es besser, sie zu trennen. Zeugnisse von Wechselstudierenden enthalten hochschulische Leistungen mit Kursnummern, Leistungspunkten und Voraussetzungsketten, die einen anderen Anrechnungsprozess erfordern als Abiturzeugnisse. Werden sie mit denselben Spaltendefinitionen durch dieselbe Pipeline verarbeitet, entstehen Zeilen, die sauber aussehen, aber bei der Anrechnungszuordnung erneut geprüft werden müssen – dann ist die durch die Zusammenlegung gewonnene Zeit wieder verloren. Führen Sie Erstsemester- und Wechselstudierendenzeugnisse als separate Batch-Projekte mit unterschiedlichen, auf den jeweiligen Dokumenttyp optimierten Spaltensätzen durch.
Was sich ändert, wenn Sie aufhören einzugeben und anfangen zu verarbeiten
Der Wechsel von manueller Eingabe zu Batch-Verarbeitung verändert mehr als nur die Geschwindigkeit. Er verändert, womit Ihr Zulassungsteam in der heißen Sommerphase tatsächlich seine Zeit verbringt.
Ein Mitarbeiter, der zuvor 167 Stunden damit verbracht hat, Kursnamen in das SIS zu tippen, nutzt diese Stunden nun für Bewertung und Anrechnung – Prüfung von Ausnahmezeilen, Zuordnung von Kursäquivalenzen und Verifizierung, ob extrahierte GPAs auf nicht standardisierten Skalen korrekt gegen Stipendien-Schwellenwerte gewichtet wurden. Das ist die Arbeit, die institutionelles Wissen und menschliches Urteilsvermögen erfordert – und die Arbeit, die die manuelle Eingabe in den September nach der Orientierungswoche verschoben hat, wenn Korrekturen schwieriger sind.
Batch-Verarbeitung eliminiert die menschliche Prüfung nicht – sie verlagert sie an die richtige Stelle in der Pipeline: nachdem die Daten strukturiert sind, aber bevor sie in den permanenten Datensatz eingehen. Das Ergebnis ist eine Datenbank, in der jede Zeile auf eine Quelldatei zurückverfolgbar ist, jede Ausnahme mit einer Lösung protokolliert wird und jede GPA mit ihrer ursprünglichen Skala versehen ist – eine Art Prüfpfad, den die manuelle Eingabe von Natur aus nie erzeugen könnte.
Für eine mittelgroße Universität, die 500 eingehende Abiturzeugnisse von Erstsemestern verarbeitet, ist dieser Unterschied die Distanz zwischen einem Sommer mit Dateneingabe und einem Sommer mit studentischer Bereitschaft. Starten Sie mit einem einzelnen Batch – einem Quellordner, 50 Zeugnissen und dem in Schritt 3 oben definierten Spaltensatz. Sehen Sie, wie viele Zeilen sauber durchlaufen und wie lange Ihre Ausnahmewarteschlange zum Abarbeiten braucht. Dieser eine Pilotdurchlauf verrät Ihnen mehr über die Batch-Bereitschaft Ihrer Einrichtung als jeder Funktionsvergleich.
Verarbeiten Sie Studierendenzeugnisse per Batch in eine Datenbank
Definieren Sie Ihre Spalten einmal, laden Sie Ihre Zeugnisse hoch und erhalten Sie eine zusammengeführte Zulassungsdatenbank – ganz ohne manuelle Dateneingabe.
Verarbeitung starten