500 relevés de notes de première année,
une base de données d'admission
Chaque été, après la clôture des dépôts du 1er mai, le bureau des admissions d'une université de taille moyenne est confronté au même problème mathématique : environ 500 étudiants de première année, chacun avec au moins un relevé de notes du secondaire — et chaque relevé nécessitant environ 20 minutes de saisie manuelle dans le Système d'information étudiant. Cela représente 167 heures de travail — soit quatre semaines complètes pour une personne — entre juin et août, avec les échéances d'orientation et d'inscription aux cours qui pèsent constamment. Le goulot d'étranglement n'est pas le volume. C'est que 500 relevés arrivent dans 500 formats différents provenant de 500 écoles secondaires différentes, et chaque format exige les mêmes yeux humains pour le déchiffrer.
Points clés à retenir
- 167 heures de travail — c'est ce que représentent 500 relevés de notes de première année à 20 minutes chacun, et tout cela se concentre entre juin et août, alors que les échéances d'orientation n'attendent pas.
- Traiter 5 relevés prend un après-midi, mais 500 constituent une rupture structurelle — l'attention humaine ne s'adapte pas linéairement, et au relevé 120, vous cessez de remarquer qu'un B+ sur une échelle de notes sur 13 points a été saisi comme un 3,3 sur une échelle de 4,0.
- L'extraction par lots n'élimine pas le réviseur — elle transforme ces 167 heures de saisie de noms de cours en évaluation d'équivalences de cours, ce qui est précisément la mission de votre connaissance institutionnelle.
Pour les bases de l'extraction de données à partir d'un relevé de notes unique — quels champs extraire, comment configurer vos définitions de colonnes et à quoi ressemble une extraction terminée — commencez par notre guide d'extraction des données de relevés de notes étudiants vers Excel. Ce qui suit ici est la couche de mise à l'échelle : tout ce qui change lorsque vous passez du traitement d'un relevé de notes à celui de 500, et comment construire un pipeline qui livre une base de données prête pour les admissions d'ici août.
L'afflux estival de relevés de notes : les chiffres
La plupart des discussions sur les flux de travail d'admission se concentrent sur la saison des candidatures — décision anticipée en novembre, décision régulière de janvier à mars. Mais le goulot d'étranglement du traitement des relevés de notes survient plus tard, après le dépôt des acomptes. La National Association for College Admission Counseling rapporte qu'environ 2,9 millions de nouveaux étudiants de première année s'inscrivent chaque année dans les collèges américains. Pour une université de taille moyenne — définie par la Carnegie Classification comme accueillant entre 5 000 et 15 000 étudiants de premier cycle — cela se traduit par environ 3 000 à 10 000 candidatures par cycle.
Une université de taille moyenne qui admet 2 500 étudiants et en accueille 1 000 inscrits en première année traite environ 500 à 700 relevés de notes du secondaire pendant les mois d'été, plus des relevés supplémentaires d'étudiants transférés et de programmes à double inscription. Chaque relevé de notes nécessite l'extraction des noms de cours, des notes, des crédits, de la moyenne générale et de la vérification de l'obtention du diplôme avant que l'étudiant puisse être placé dans les bons cours. Un article AACRAO Connect de 2023 parrainé par Parchment estimait la saisie manuelle des données de relevés de notes à 20 minutes par candidature. Pour 500 relevés de notes, cela représente 167 heures — compressées dans une fenêtre de 8 à 10 semaines entre les échéances de dépôt et l'orientation.
Le calendrier est le multiplicateur. Les bureaux d'admission ne disposent pas de 167 heures de marge. Ils ont les mêmes semaines de travail de 40 heures qu'ils ont toujours eues, avec le même personnel, pendant la même fenêtre. Et chaque jour de retard — chaque relevé de notes en attente dans une file de traitement pendant que l'étudiant attend un e-mail de placement — érode le taux d'inscription. Les étudiants qui n'obtiennent pas de réponse rapidement s'engagent ailleurs ou s'inscrivent à des cours sur la base d'une évaluation incomplète, créant un chaos d'ajouts/retraits en septembre.
Pourquoi la saisie manuelle des relevés de notes bloque à 500
Traiter un relevé de notes manuellement est fastidieux mais gérable. Cinq relevés — un après-midi de travail. Cinquante — une semaine complète. À 500, le calcul ne porte plus sur le temps, mais sur une rupture structurelle dans la façon dont l'attention humaine fonctionne à grande échelle.
Chaque relevé nécessite la même séquence cognitive : localiser le nom de l'élève et son lycée, déchiffrer l'échelle de notation (cet établissement utilise-t-il une échelle sur 4,0, 5,0 ou 100 points ?), lire chaque intitulé de cours et sa note, mapper les désignations de semestre, vérifier le statut d'obtention du diplôme, et saisir chaque champ dans le SIS. Les noms de cours sont le plus gros point de friction. « English 9 Honors » dans un établissement devient « ENGL 101H » dans un autre et « Composition & Literature I (Advanced) » dans un troisième — mais les trois doivent correspondre à la même entrée dans votre base de données d'articulation.
À 20 relevés, un membre du personnel repère ces variations. À 120, les centres de reconnaissance des formes du cerveau commencent à confondre des entrées similaires. Un « B+ » d'un établissement utilisant une échelle GPA sur 13 points (A+ = 4,33) est saisi comme 3,3 sur une échelle de 4,0 parce que le curseur est resté en mode échelle 4,0 toute la matinée. Un relevé avec une colonne « Réussi/Échoué » pour les cours du printemps 2020 — une variation courante de l'ère COVID — est saisi sans être signalé, car l'opérateur a cessé de lire les en-têtes de colonne au relevé numéro 80. Le contenu sponsorisé d'Inside Higher Ed par Laserfiche le confirme : « les relevés de notes des étudiants sont si sujets aux erreurs humaines » que leur solution automatisée a été conçue pour signaler les entrées au mauvais format avant qu'elles n'atteignent les réviseurs humains — un aveu que la saisie manuelle génère suffisamment d'erreurs pour nécessiter sa propre couche de validation.
L'écart entre 5 et 500 relevés n'est pas seulement une question de temps supplémentaire — c'est une catégorie de problème entièrement différente. À 5, vous vérifiez. À 500, vous échantillonnez — et espérez que les 495 autres ne contiennent pas d'erreurs qui se répercutent en placements de cours incorrects, erreurs de calcul de crédits ou audits de diplôme retardés.
Le paysage des formats : électronique, papier et entre-deux
L'idéal serait que tous les relevés de notes arrivent via Parchment ou le National Student Clearinghouse dans un format électronique uniforme. La réalité dans la plupart des services d'admission est une boîte de réception hybride qui ressemble plutôt à ceci :
| Canal | Part typique | Format | Défi d'extraction |
|---|---|---|---|
| Parchment / Clearinghouse ETX | 55–65 % | EDI (SPEEDE TS130), PDF ou XML structuré | L'EDI s'analyse automatiquement dans certains SIS ; les variantes PDF diffèrent selon la configuration Parchment de l'établissement |
| Intégration Common App | 10–15 % | Flux de données structurées | Champs limités — généralement seulement la moyenne et le résumé des cours principaux, pas le détail complet du relevé |
| Email direct / Portail de dépôt | 10–15 % | PDF (numérisé ou export numérique) | Mise en page très variable ; certains sont numérisés depuis le papier, d'autres exportés du SIS de l'établissement avec un formatage personnalisé |
| Courrier physique (Papier) | 5–10 % | Papier → numérisé en PDF par l'admission | Qualité de numérisation, inclinaison, ombres ; annotations manuscrites sur les formulaires officiels |
| International / Non traditionnel | 3–5 % | PDF, images numérisées, documents traduits | Systèmes de notation non standard (IB, A-Levels, programmes nationaux), traduction linguistique, évaluation des diplômes |
L'enquête AACRAO 2018 sur le coût, le type et le volume des relevés de notes a révélé qu'environ 15 % des relevés étaient encore livrés sur papier. Ce chiffre a probablement diminué depuis, mais les petits districts scolaires et les établissements internationaux envoient encore du papier — et ces relevés atterrissent dans votre scanner avant d'arriver dans votre SIS. Chaque numérisation introduit ses propres variables : contraste, inclinaison, recadrage des marges, lisibilité des clés d'échelle de notation en petits caractères.
Un pipeline de traitement par lots qui ne gère que Parchment EDI ne résout que la moitié du problème. Les relevés qui consomment le plus de temps au personnel sont précisément ceux qui arrivent en dehors des réseaux électroniques — papier numérisé, PDF envoyés par email depuis des établissements sans accord d'échange, et diplômes internationaux. Un flux de travail qui vaut la peine d'être construit les gère tous.
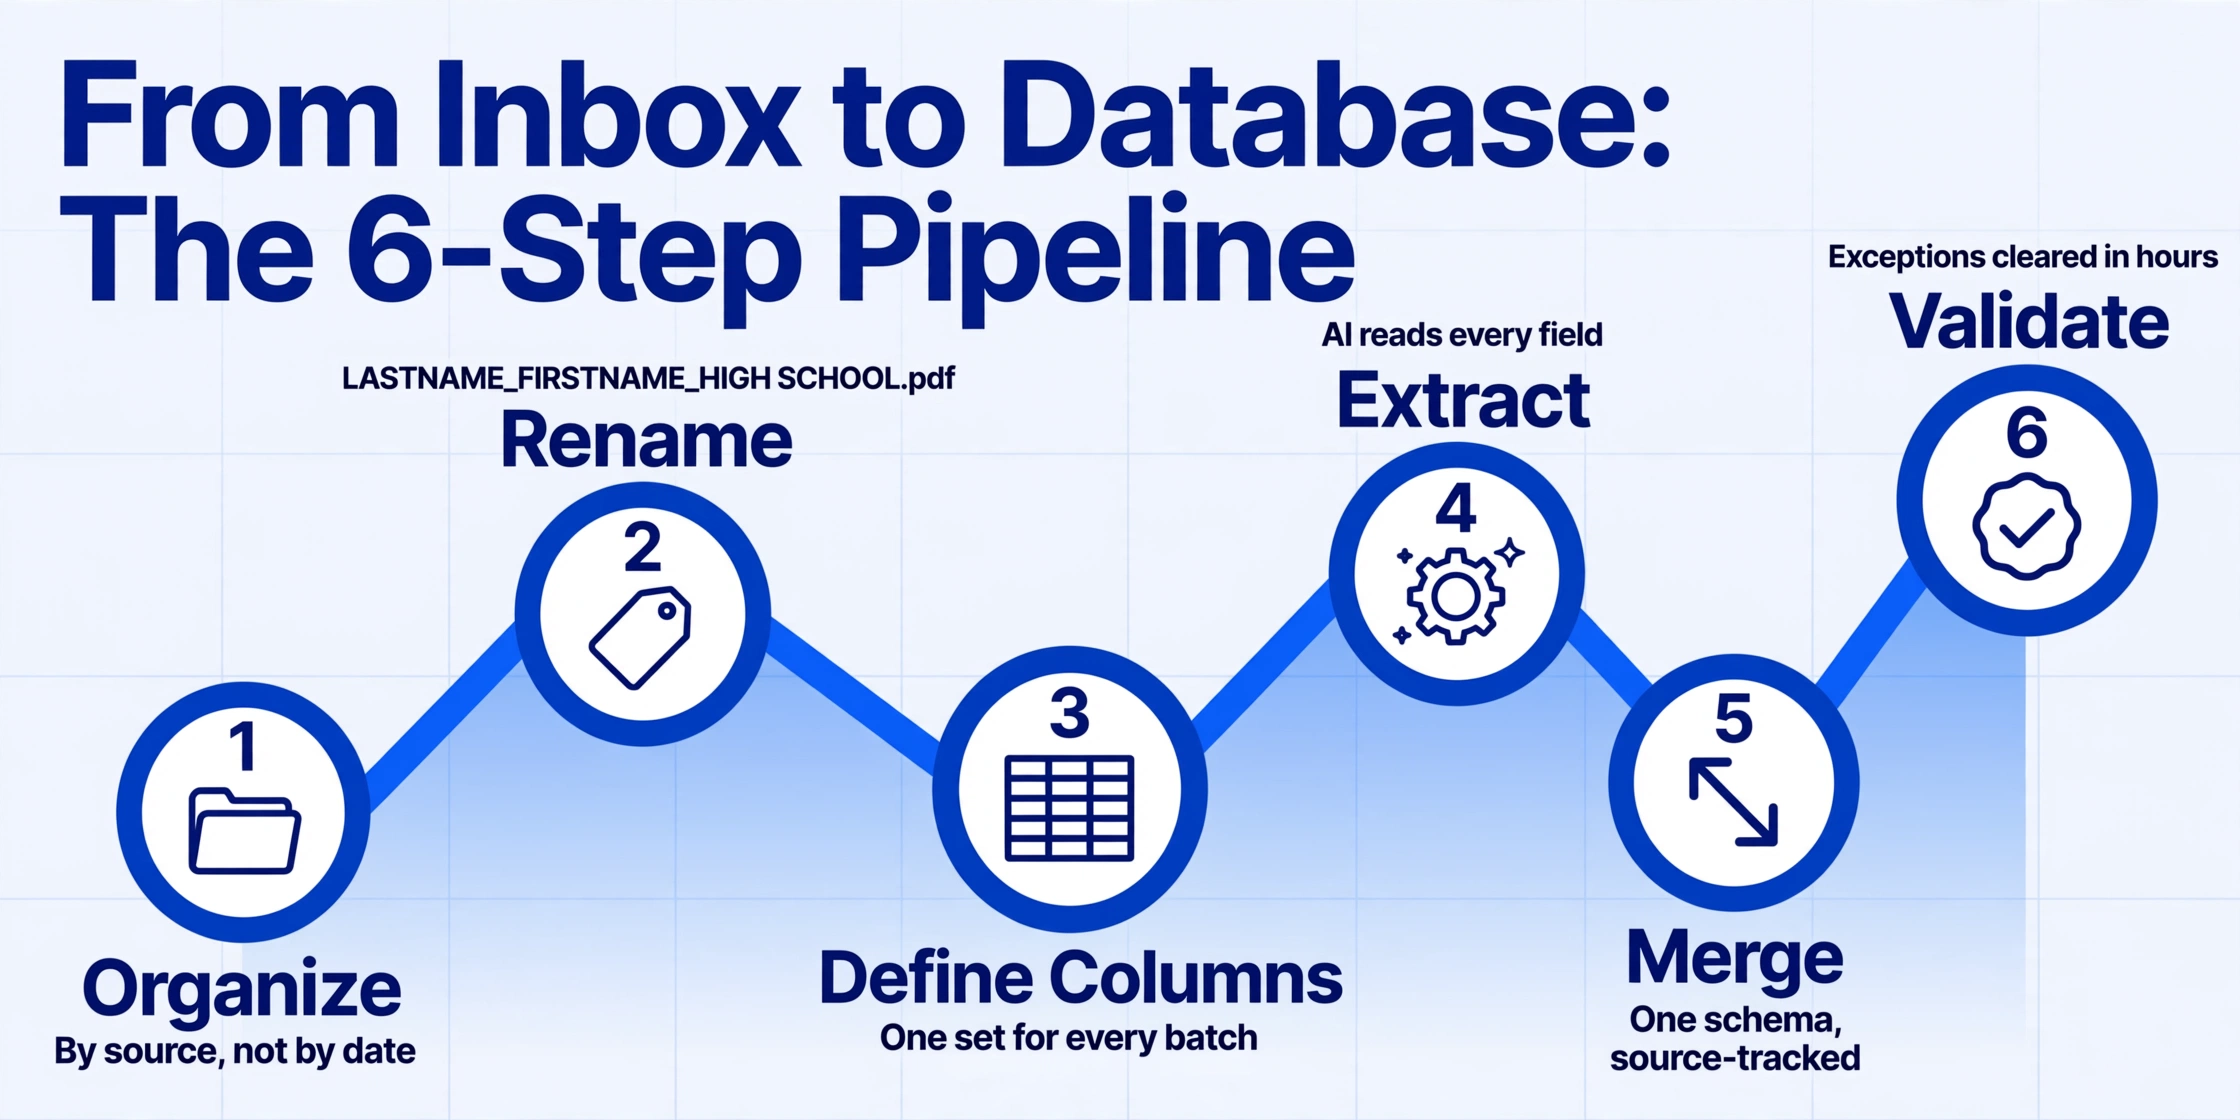
Construire le pipeline de traitement par lots : 6 étapes de la boîte de réception à la base de données
Ceci n'est pas une section de revue logicielle. C'est le flux de travail pratique qui transforme 500 documents hétérogènes en une base de données d'admission propre, quel que soit l'outil d'extraction utilisé. Pour un examen plus approfondi du côté sélection d'outils du traitement de documents par lots — les capacités à rechercher et les limites des différents niveaux d'outils — consultez notre guide des flux de travail OCR par lots. Cet article couvre l'OCR de bureau, les API cloud et les niveaux d'extraction IA. Ici, nous nous concentrons sur le pipeline spécifique aux relevés de notes.
Créez un dossier par type de source : parchment/, common-app/, scanned-paper/, international/. La source est le meilleur indicateur de cohérence du format, et le regroupement par source vous permet de configurer les règles d'extraction par lots une seule fois par dossier plutôt que par fichier. Si votre outil prend en charge le traitement par sous-lots, chaque dossier devient son propre lot de traitement.
Nommez chaque fichier avant le traitement : LASTNAME_FIRSTNAME_HIGHSCHOOL.pdf. Cette convention remplit trois fonctions : elle sert de file d'attente lisible, elle intègre une clé de référence croisée dans chaque ligne de sortie, et elle rend la gestion des exceptions consultable. Le pire scénario est 500 fichiers nommés transcript(1).pdf à transcript(500).pdf — si une ligne échoue à la validation, vous n'avez aucun moyen de remonter au document source.
Votre ensemble de colonnes doit être suffisamment exhaustif pour capturer chaque variante de relevé de notes, mais pas si granulaire que l'extraction par IA se dégrade : Student Name, High School, Graduation Date, GPA, GPA Scale, Course Name, Course Code, Grade, Credits Earned, Term/Semester. La colonne GPA Scale est la plus précieuse — elle indique si l'école utilise une échelle de 4,0, 5,0 ou sur 100 points, ce qui permet à votre examinateur d'équivalences de savoir si un « 3.8 » et un « 95 » sont équivalents ou non.
Traitez chaque dossier comme un lot distinct plutôt que d'envoyer les 500 fichiers dans une seule file de traitement. Les relevés de notes provenant de Parchment partagent une structure PDF commune — les traiter ensemble améliore la cohérence de l'extraction, car l'IA rencontre moins de discontinuités de format. Les relevés papier scannés constituent un lot séparé, idéalement après avoir vérifié la qualité de numérisation sur les 5 à 10 premiers fichiers. Pour un aperçu des différences entre l'extraction basée sur l'IA et l'OCR traditionnel — et pourquoi cela importe lorsque vos documents n'ont pas de mise en page cohérente — consultez notre guide sur l'OCR et l'extraction de documents par IA.
Après chaque lot, signalez toute ligne où des champs clés manquent — nom d'étudiant vide, GPA vide, ou moins de cours que prévu. Ces lignes constituent votre file d'exceptions : une liste restreinte de 5 à 15 % des relevés nécessitant une vérification humaine. La différence entre un traitement par lots efficace et le chaos réside dans la gestion immédiate des exceptions plutôt que leur enfouissement dans le résultat fusionné. Créez une feuille « Exceptions » à côté de votre base de données principale et acheminez-y les lignes signalées en cours de pipeline, et non lors d'une étape de nettoyage après fusion.
Consolidez tous les résultats de lots dans une seule feuille de calcul ou table de base de données, en ajoutant une colonne Source Batch et en conservant le nom de fichier d'origine dans une colonne Source File. Ces deux colonnes constituent votre piste d'audit — lorsqu'un étudiant conteste un placement de cours, vous devez pouvoir retracer la décision jusqu'au relevé exact et au lot d'extraction, et non vous fier aveuglément à la base de données. Pour les flux d'exportation par lots couvrant plusieurs groupes de sources, le même principe de fusion et de suivi s'applique à la vérification par lots pour tout type de document — la colonne source est ce qui rend une feuille fusionnée auditable.
De 500 relevés de notes à une seule base de données : l'étape de fusion et de validation
À ce stade, vous disposez de sorties par lots — un tableur par dossier source — mais pas encore d'une base de données d'admission unifiée. L'étape de fusion est celle où la plupart des pipelines par lots perdent leur cohérence, car c'est là que les données provenant de différentes sources, traitées à différents moments, doivent se conformer à un schéma unique.
L'application du schéma se fait au moment de la fusion. Avant de consolider, normalisez chaque sortie de lot selon le même ordre de colonnes et la même convention de nommage. Si votre lot Parchment a nommé la colonne GPA « Cumulative GPA » et que votre lot numérisé l'a appelée « GPA (Weighted) », réconciliez-les avant de fusionner — sinon vous obtenez deux colonnes GPA parallèles avec des données partielles dans chacune. Une passe de normalisation pré-fusion prend 10 minutes et évite des heures d'analyse de tableurs plus tard.
Le suivi des sources est non négociable. Ajoutez deux colonnes à chaque ligne fusionnée : Source Batch (quel lot de traitement a produit cette ligne) et Source File (le nom de fichier d'origine). Lorsqu'une décision d'équivalence de cours est contestée par un directeur de département en octobre, ces colonnes vous indiquent en 30 secondes quel relevé de notes et quelle passe d'extraction ont généré les données — au lieu de passer une heure à retracer les étapes à travers 500 fichiers. C'est la couche d'audit que le traitement manuel n'a jamais eue.
La normalisation GPA nécessite une règle, pas une formule. Lorsque votre base de données contient des GPA d'écoles secondaires sur échelle de 4,0, de 5,0, sur 100 points et sur l'échelle IB de 7 points dans la même colonne, toute comparaison automatique de GPA est dénuée de sens. Créez une colonne complémentaire — GPA Scale — qui préserve l'échelle d'origine aux côtés de la valeur GPA brute. La normalisation en une métrique comparable se fait en aval, à l'étape d'évaluation des crédits, et non au niveau de la base de données. Réduire toutes les GPA en un seul nombre recalculé pendant l'extraction est une erreur courante : cela détruit les preuves dont vous avez besoin lorsqu'un étudiant ou un parent conteste l'évaluation.
Pour les entrées de cours, l'étape de fusion est également l'endroit où vous pouvez commencer le mappage d'articulation — la correspondance des noms de cours extraits avec la base de données d'équivalences de cours de votre université. Il ne s'agit pas d'une tâche d'extraction par lots ; c'est une recherche post-fusion qui associe chaque ligne de cours extraite à une équivalence connue lorsqu'elle existe, et signale les lignes sans correspondance pour un examen manuel. Le rôle de l'outil d'extraction est de placer le nom du cours, le code et la note dans des colonnes étiquetées. Le mappage d'articulation relève de l'expertise de votre équipe des admissions, appliquée à une base de données propre plutôt qu'à des PDF individuels.
Gestion des exceptions : que faire lorsque 8 à 15 % des relevés de notes nécessitent un examen humain
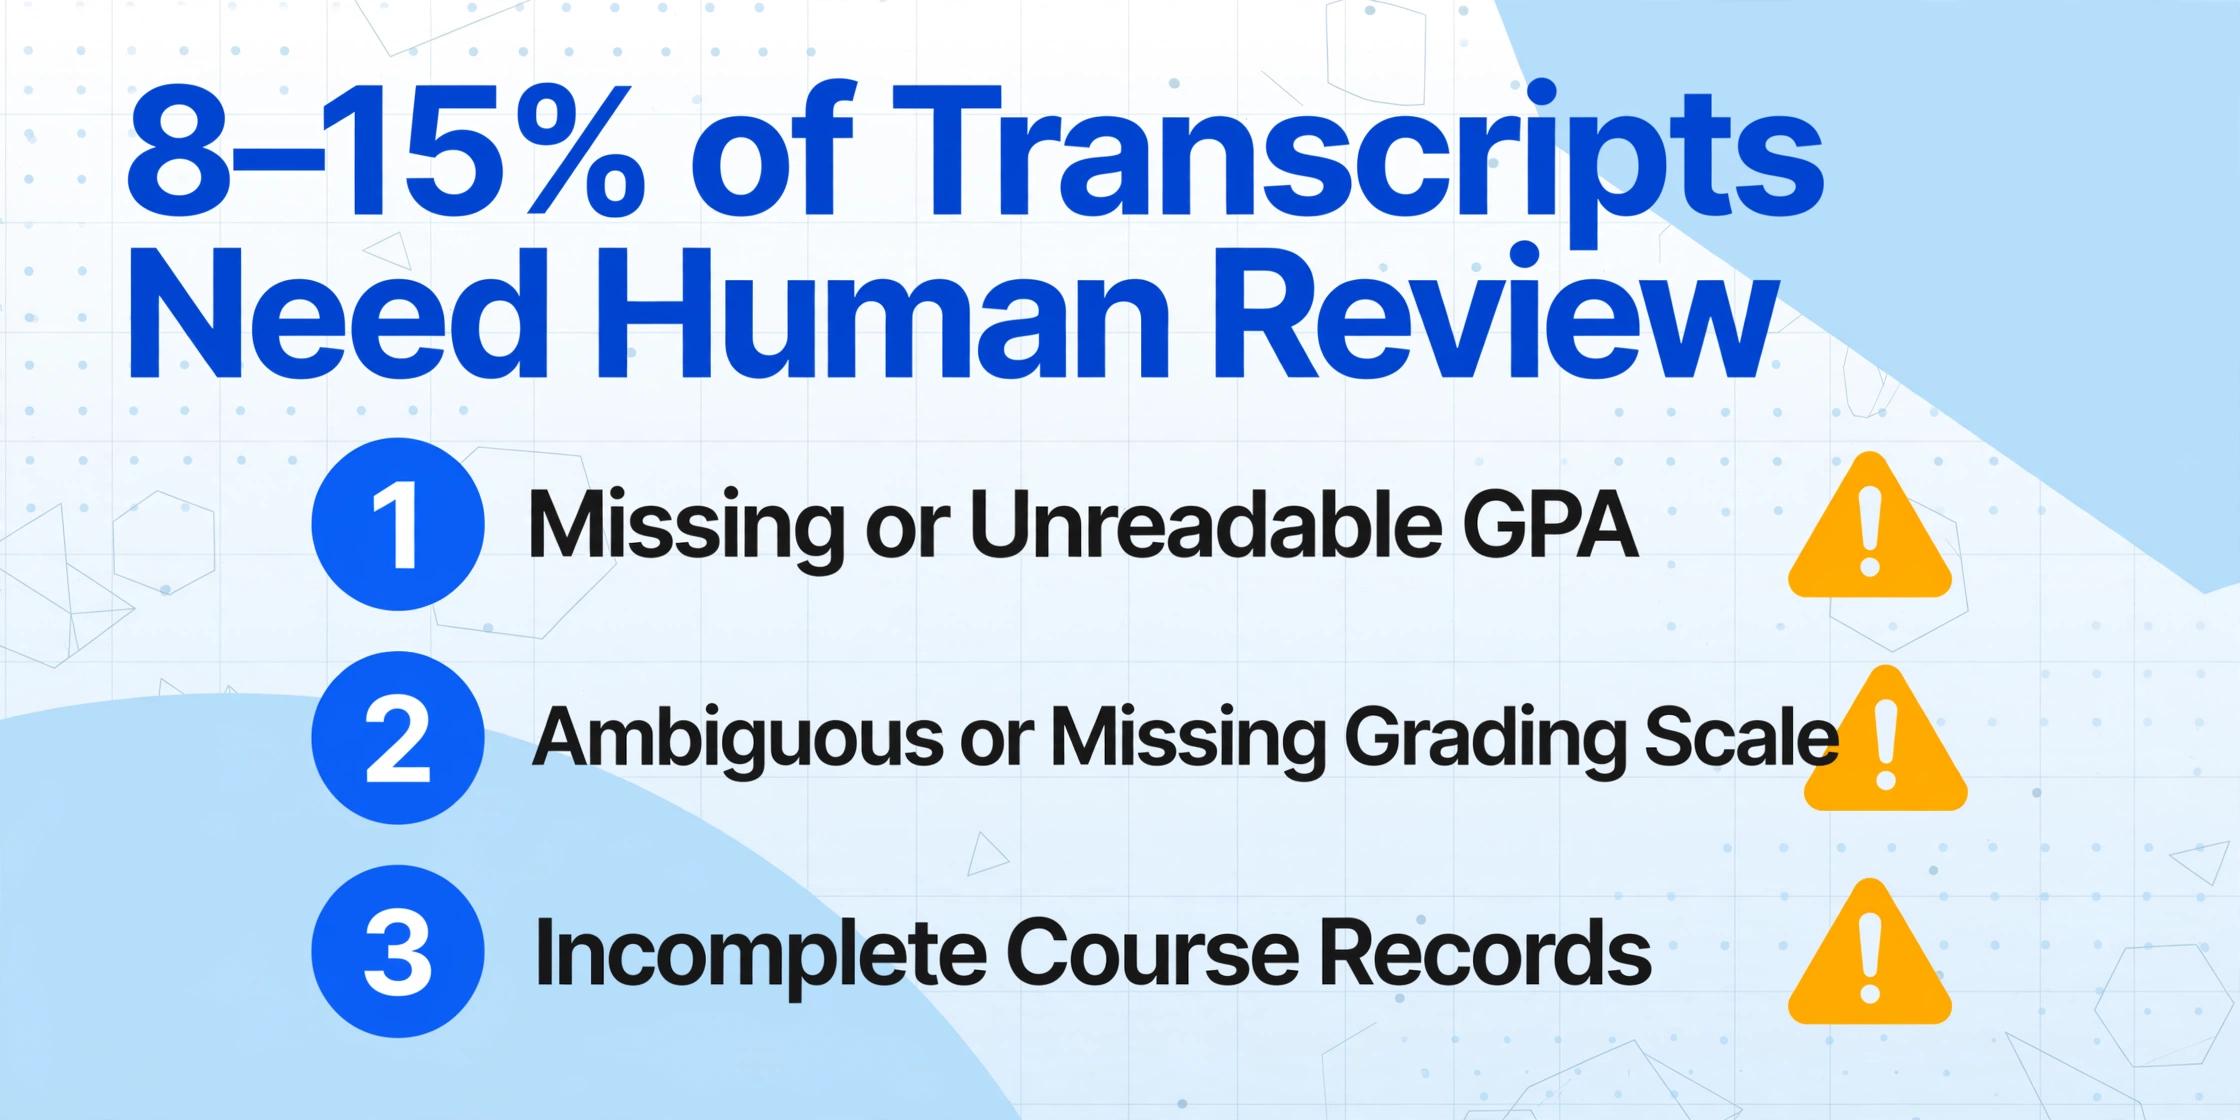
Chaque pipeline par lots produit des exceptions. L'objectif n'est pas zéro exception — c'est une file d'attente d'exceptions structurée qu'un seul examinateur peut traiter en moins d'une heure. Voici les catégories d'exceptions qui apparaissent régulièrement dans le traitement par lots des relevés de notes, et comment gérer chacune d'elles sans faire dérailler le pipeline.
GPA manquant ou illisible
Certains relevés de notes du secondaire — en particulier ceux des petits districts et des établissements internationaux — n'affichent pas de GPA cumulatif sous forme de chiffre unique. D'autres l'impriment dans une taille de police si petite que les copies numérisées le rendent sous forme de points flous. Lorsque le champ GPA est vide dans votre sortie d'extraction, signalez la ligne, mais n'arrêtez pas le lot. Ces lignes vont dans la file d'attente des exceptions avec une note : « GPA non extrait — vérifier à partir de l'original. »
Échelle de notation ambiguë ou manquante
Un relevé de notes qui affiche une GPA de « 3,8 » sans préciser si l'échelle est de 4,0, 5,0 ou 12,0 constitue un risque de classement. La sortie d'extraction doit renseigner le champ Échelle de GPA comme « Non spécifiée » et acheminer la ligne vers les exceptions. Le réviseur vérifie si la légende, le pied de page ou le verso du relevé indique l'échelle — ou si le site web du lycée documente sa politique de notation.
Dossiers de cours incomplets
Certains relevés ne présentent que les notes finales de chaque cours, sans ventilation par semestre, heures de crédit ou codes de cours. D'autres tronquent les noms de cours à 20 caractères. Ces lignes peuvent techniquement être extraites proprement, mais elles sont incomplètes aux fins d'articulation. Signalez les lignes où le champ Code de cours est vide ou lorsque le nombre d'entrées de cours par année scolaire est inférieur à la normale (généralement 5 à 8 cours par an pour un lycée américain standard).
Semestres incomplets ou manquants
Un relevé qui présente les cours de l'automne de la dernière année mais rien pour le printemps illustre un scénario courant : l'étudiant a envoyé son relevé en cours d'année, avant la publication des notes du printemps. Ce ne sont pas des erreurs — ce sont des dossiers partiels. Signalez-les comme « En attente du relevé final », et non comme des exceptions. Le pipeline par lots doit faire la distinction entre « des données qui existent mais n'ont pas été capturées » et « des données qui n'ont pas encore été produites ».
Le flux de travail de la file d'exceptions
Après chaque lot, exécutez une passe de validation qui vérifie les champs obligatoires vides, les valeurs de GPA inattendues (hors plages 0–5,0 ou 0–100) et les nombres de cours sous un seuil donné. Les lignes signalées vont dans une feuille Exceptions dédiée — ne tentez jamais de corrections automatiques, car une correction automatique trop confiante crée des erreurs plus difficiles à repérer que des cellules vides.
Priorisez les exceptions qui bloquent les décisions en aval : nom d'étudiant ou date d'obtention du diplôme vides (impossibilité de vérifier l'identité ou l'admissibilité) en premier ; GPA manquante en deuxième (bloque l'évaluation des bourses et des distinctions) ; dossiers de cours incomplets en troisième (bloque le classement mais pas l'admission). Le traitement par ordre d'arrivée fait perdre du temps sur des exceptions à faible impact pendant que des lignes à fort enjeu attendent.
Si vous passez plus de 2 minutes sur une seule exception, faites-la remonter — soit à un réviseur senior, soit vers une file « Demande de clarification » où l'étudiant ou le lycée est contacté pour obtenir un relevé mis à jour. Le gain d'efficacité du traitement par lots disparaît lorsque les exceptions consomment le temps qu'elles étaient censées faire économiser.
Une file d'exceptions bien structurée se traite en 20 à 45 minutes pour une promotion entrante de 500 étudiants. La clé est de distinguer « nécessite une révision humaine » de « nécessite un réexamen du document original » — deux catégories de travail entièrement différentes que les mauvais pipelines confondent en une seule pile de « problèmes ».
Questions fréquentes
Le traitement par lots peut-il gérer des relevés de notes internationaux avec des systèmes de notation non standard ?
Oui, mais avec une réserve importante. L'extraction par lots peut récupérer les noms des cours, les notes et la moyenne générale dans des colonnes étiquetées, quel que soit le système de notation — qu'il s'agisse du Baccalauréat International (1–7), des A-Levels (A*–E), du Baccalauréat français (0–20) ou du système de pourcentage CBSE indien. Ce qu'il ne peut pas faire, c'est effectuer l'évaluation des diplômes — déterminer si un 5 en Mathématiques HL du BI équivaut au MATH 101 de votre université. Cette expertise relève de votre équipe d'admissions internationales et de services d'évaluation externes comme WES ou ECE. Le rôle du pipeline par lots est d'insérer les données brutes dans une base de données afin que les évaluateurs comparent des lignes, et non des PDF.
Quel pourcentage de relevés de notes nécessite généralement une vérification manuelle après extraction par lots ?
Dans le cas du traitement des relevés de notes, attendez-vous à ce que 8 à 15 % des lignes nécessitent une vérification humaine — moins que pour le traitement par lots des factures (où la variation de format est plus grande) mais plus que pour le traitement par lots des certificats d'assurance (où le formulaire ACORD 25 standardise la mise en page). Les déclencheurs les plus courants de vérification manuelle sont les relevés de notes papier scannés avec des problèmes de qualité d'image, les relevés d'écoles utilisant une notation non standard, et les relevés internationaux où les noms de cours ne suivent pas les conventions américaines. Si votre taux d'exception dépasse 20 %, revoyez la qualité de vos scans — les mauvais scans sont le principal facteur prédictif de lacunes d'extraction.
L'extraction par lots fonctionne-t-elle avec les PDF de Parchment et du National Student Clearinghouse ?
Oui. Les relevés de notes transmis via Parchment Receive et le National Student Clearinghouse sont des PDF standard — la couche de livraison électronique gère l'authentification et le routage, mais le document lui-même reste une mise en page visuelle que l'extraction par lots lit de la même manière que tout autre PDF. L'avantage des relevés de notes par livraison électronique est une qualité numérique constante : pas d'inclinaison due au scanner, pas de notes manuscrites dans les marges, pas de papier thermique décoloré. Cela dit, même les PDF de Parchment varient d'un lycée à l'autre, car chaque école configure son propre modèle de relevé de notes dans le système Parchment — la mise en page varie donc toujours, mais avec une meilleure qualité de base.
Comment garantir que les bonnes données de cours correspondent au bon étudiant ?
Trois garde-fous. D'abord, la convention de nommage (NOM_PRÉNOM_LYCÉE.pdf) intègre l'identité de l'étudiant dans chaque fichier source. Ensuite, chaque ligne d'extraction hérite du nom du fichier source, créant une traçabilité persistante. Enfin, extrayez le Nom de l'étudiant et le Lycée comme colonnes explicites, puis recoupez-les avec votre base de données candidats avant d'intégrer la base d'admission finale. Si le nom extrait d'une ligne ne correspond à aucun étudiant inscrit, ou si un bulletin mentionne un lycée absent du dossier de l'étudiant, signalez-le — c'est soit une erreur de saisie, soit un étudiant ayant soumis des relevés de plusieurs établissements.
Un même pipeline par lots peut-il traiter les bulletins de transfert et ceux de première année ?
Techniquement oui, mais il est préférable de les séparer. Les bulletins de transfert contiennent des cours universitaires avec codes, crédits et prérequis qui nécessitent une évaluation différente de celle des bulletins de lycée. Les traiter dans le même pipeline avec les mêmes colonnes produira des lignes propres en apparence, mais qui devront être revues lors du mappage d'articulation — annulant ainsi le temps gagné. Traitez les bulletins de première année et de transfert comme des projets distincts avec des jeux de colonnes adaptés à chaque type de document.
Ce qui change quand on arrête de saisir et qu'on commence à traiter
Le passage de la saisie manuelle au traitement par lots change plus que la vitesse. Il change ce que votre équipe d'admission fait réellement de son temps pendant la période estivale.
Un membre du personnel qui passait auparavant 167 heures à taper des noms de cours dans le SIS consacre désormais ces heures à l'évaluation et à l'articulation — révision des lignes d'exception, mappage des équivalences de cours, vérification que les GPA extraites sur des échelles non standard sont correctement pondérées par rapport aux seuils de bourses. C'est le travail qui nécessite des connaissances institutionnelles et du jugement humain, et c'est celui que la saisie manuelle repoussait à septembre, après l'orientation, quand les corrections sont plus difficiles.
Le traitement par lots ne supprime pas la relecture humaine — il la place au bon endroit dans le pipeline : après la structuration des données mais avant leur entrée dans le dossier permanent. Le résultat est une base de données où chaque ligne est traçable jusqu'à un fichier source, chaque exception est enregistrée avec une résolution, et chaque GPA est annotée avec son échelle d'origine — le genre de piste d'audit que la saisie manuelle, par nature, ne pourrait jamais produire.
Pour une université de taille moyenne traitant 500 bulletins de première année entrants, cette différence est celle entre un été passé à saisir des données et un été passé à évaluer la préparation des étudiants. Commencez par un seul lot — un dossier source, 50 bulletins, et le jeu de colonnes défini à l'étape 3 ci-dessus. Voyez combien de lignes passent sans erreur et combien de temps prend votre file d'exceptions. Ce seul essai pilote vous en apprendra plus sur la préparation de votre établissement au traitement par lots que n'importe quel tableau comparatif.
Traitez par lots les bulletins étudiants en une seule base de données
Définissez vos colonnes une fois, chargez vos bulletins, et obtenez une base d'admission fusionnée — sans saisie manuelle.
Commencer le traitement