신입생 성적 증명서 500건,
입학 데이터베이스 하나로
매년 여름, 5월 1일 등록금 납부 마감이 지나면 중규모 대학의 입학 사무실은 똑같은 수학 문제에 직면합니다. 약 500명의 신입생, 각자 최소 한 장의 고등학교 성적 증명서를 보유하고 있으며, 각 증명서는 학생 정보 시스템에 수작업으로 입력하는 데 약 20분이 소요됩니다. 이는 167시간의 직원 노동력 — 한 사람 기준 4주 분량의 업무 — 이 6월부터 8월 사이에 집중되며, 그동안 오리엔테이션과 수강 신청 마감이 계속 다가옵니다. 병목 현상의 원인은 물량이 아닙니다. 500개의 성적 증명서가 500개 고등학교에서 500가지 다른 형식으로 도착하고, 각 형식을 해독하려면 동일한 사람의 눈이 필요하기 때문입니다.
핵심 요점
- 167시간 — 신입생 성적 증명서 500건을 각 20분씩 처리할 때의 총 시간이며, 오리엔테이션 마감이 기다려 주지 않는 6월부터 8월 사이에 모두 집중됩니다.
- 성적 증명서 5건 처리는 오후 하나면 충분하지만, 500건은 구조적 붕괴입니다 — 인간의 집중력은 선형적으로 확장되지 않으며, 120번째 증명서쯤 되면 13점 만점 GPA의 B+가 4.0 만점 기준 3.3으로 입력되는 실수를 더 이상 잡아내지 못합니다.
- 일괄 추출은 검토자의 역할을 없애지 않습니다 — 167시간을 과목명 입력에서 과목 학점 인정 평가로 전환할 뿐이며, 이것이 바로 기관의 전문 지식이 원래 담당해야 했던 업무입니다.
단일 성적 증명서에서 데이터를 추출하는 기본 사항은 학생 성적 증명서 데이터를 Excel로 추출하는 가이드에서 확인하세요. 아래에서 다루는 내용은 확장 단계입니다. 성적 증명서 1개를 처리하는 것에서 500개를 처리하는 것으로 전환할 때 달라지는 모든 것과 8월까지 입학 준비 완료 데이터베이스를 구축하는 파이프라인을 만드는 방법입니다.
여름 성적 증명서 폭증: 숫자로 보는 규모
대부분의 입학 업무 흐름 논의는 지원 시즌에 집중됩니다. 11월 조기 전형, 1월부터 3월까지의 정시 전형이 그것입니다. 하지만 성적 증명서 처리 병목 현상은 그 이후, 등록금 납부가 끝난 뒤에 발생합니다. 전미 대학 입학 상담 협회(National Association for College Admission Counseling)에 따르면 매년 약 290만 명의 신입생이 미국 대학에 등록합니다. Carnegie Classification 기준 재학생 5,000~15,000명 규모의 중형 대학의 경우, 이는 사이클당 약 3,000~10,000건의 지원서에 해당합니다.
2,500명을 합격시키고 1,000명의 신입생을 등록시키는 중형 대학은 여름철에 약 500~700건의 고등학교 성적 증명서를 처리하며, 여기에 편입생과 복수 학점 프로그램의 추가 성적 증명서가 더해집니다. 각 성적 증명서는 학생을 올바른 과목에 배정하기 전에 과목명, 성적, 학점, GPA, 졸업 확인 정보를 추출해야 합니다. Parchment가 후원한 2023년 AACRAO Connect 기사에 따르면 지원서 1건당 수작업 성적 증명서 데이터 입력에 20분이 소요됩니다. 성적 증명서 500건 기준으로 167시간이며, 이를 등록금 납부 마감과 오리엔테이션 사이의 8~10주 기간에 압축해야 합니다.
시기가 문제를 키웁니다. 입학 사무실에는 167시간의 여유가 없습니다. 평소와 동일한 40시간 근무제, 동일한 인력, 동일한 기간이 주어질 뿐입니다. 그리고 하루의 지연 — 학생이 배정 이메일을 기다리는 동안 처리 대기열에 쌓여 있는 모든 성적 증명서 — 은 등록률을 갉아먹습니다. 빠른 회신을 받지 못한 학생은 다른 학교에 등록하거나 불완전한 평가에 기반해 과목을 수강하게 되어 9월에 수강 변경 혼란이 발생합니다.
수동 성적 증명서 입력이 500건에서 막히는 이유
성적 증명서 한 건을 수동으로 처리하는 것은 지루하지만 감당할 수 있습니다. 다섯 건은 오후 내내, 쉰 건은 일주일 내내 걸립니다. 500건이 되면 문제는 시간이 아니라 인간의 주의력이 대규모로 작동할 때 발생하는 구조적 붕괴로 바뀝니다.
각 성적 증명서는 동일한 인지 과정을 필요로 합니다: 학생 이름과 고등학교 찾기, 성적 평가 척도 해독, 각 과목명과 성적 읽기, 학기 지정 매핑, 졸업 상태 확인, 그리고 모든 필드를 SIS에 입력하기. 과목명이 가장 큰 걸림돌입니다. 한 학교의 "English 9 Honors"는 다른 학교에서 "ENGL 101H"이고 또 다른 학교에서는 "Composition & Literature I (Advanced)"이지만, 세 가지 모두 동일한 학점 인정 데이터베이스 항목에 매핑되어야 합니다.
20건의 성적 증명서에서는 직원이 이러한 차이를 발견합니다. 120건에서는 뇌의 패턴 인식 중추가 비슷해 보이는 항목을 구분하지 못하기 시작합니다. 13점 GPA 척도(A+ = 4.33)를 사용하는 학교의 "B+"가 아침 내내 4.0 척도 모드로 작업하던 커서 때문에 4.0 척도에서 3.3으로 입력됩니다. 2020년 봄 과목에 "Pass/Fail" 열이 있는 성적 증명서는 작업자가 80번째 증명서에서 열 제목 읽기를 중단했기 때문에 플래그 없이 입력됩니다. Laserfiche의 Inside Higher Ed 스폰서 콘텐츠는 이를 확인합니다: "학생 성적 증명서는 인간의 오류에 너무 취약해서" 자동화 솔루션이 인간 검토자에게 도달하기 전에 잘못된 형식의 항목을 플래그하도록 설계되었습니다. 이는 수동 입력이 자체 검증 계층을 필요로 할 만큼 충분한 오류를 생성한다는 인정입니다.
5건과 500건의 성적 증명서 사이의 차이는 단순히 더 많은 시간이 아닙니다. 완전히 다른 범주의 문제입니다. 5건에서는 확인합니다. 500건에서는 표본을 추출하고 나머지 495건에 잘못된 과정 배치, 학점 계산 오류, 또는 지연된 졸업 감사로 이어질 수 있는 오류가 없기를 바랄 뿐입니다.
성적증명서 포맷의 현황: 전자, 종이, 그리고 그 사이의 모든 것
모든 성적증명서가 Parchment나 National Student Clearinghouse를 통해 균일한 전자 형식으로 도착한다면 이상적일 것입니다. 하지만 실제 입학사무실의 현실은 다음과 같은 혼합형 수신함입니다:
| 채널 | 일반적 비중 | 형식 | 데이터 추출 과제 |
|---|---|---|---|
| Parchment / Clearinghouse ETX | 55–65% | EDI (SPEEDE TS130), PDF, 또는 구조화된 XML | EDI는 일부 SIS 설정에서 자동 파싱됨; PDF 변형은 학교별 Parchment 설정에 따라 상이 |
| Common App 연동 | 10–15% | 구조화된 데이터 피드 | 제한된 필드 — 보통 GPA와 핵심 과목 요약만 제공, 전체 성적증명서 세부사항 없음 |
| 직접 이메일 / 업로드 포털 | 10–15% | 레이아웃이 매우 다양함; 일부는 종이에서 스캔, 다른 일부는 맞춤 서식으로 학교 SIS에서 내보냄 | |
| 우편 | 5–10% | 종이 → 입학처에서 PDF로 스캔 | 스캔 품질, 기울어짐, 그림자; 공식 서식 위 수기 메모 |
| 국제 / 비전통 | 3–5% | PDF, 스캔 이미지, 번역 문서 | 비표준 성적 체계, 언어 번역, 학력 평가 |
2018년 AACRAO 성적증명서 비용, 유형 및 물량 조사에 따르면 약 15%의 성적증명서가 여전히 종이로 전달되었습니다. 그 수치는 이후 감소했을 가능성이 높지만, 소규모 학군과 해외 기관은 여전히 종이를 우편으로 보내며 — 해당 성적증명서는 SIS에 입력되기 전에 스캐너 트레이에 먼저 도착합니다. 각 스캔은 대비, 기울어짐, 여백 잘림, 작은 글씨의 성적 척도 키 판독성 등 고유한 변수를 만들어냅니다.
Parchment EDI만 처리하는 일괄 처리 파이프라인은 문제의 절반만 해결하는 것입니다. 직원의 시간을 가장 많이 소모하는 성적증명서는 바로 전자 네트워크 외부에서 도착하는 것들 — 스캔된 종이, 교환 협정이 없는 학교에서 이메일로 보낸 PDF, 해외 학력 증명서입니다. 구축할 가치가 있는 워크플로는 이 모든 것을 처리합니다.
일괄 처리 파이프라인 구축: 받은 편지함에서 데이터베이스까지 6단계
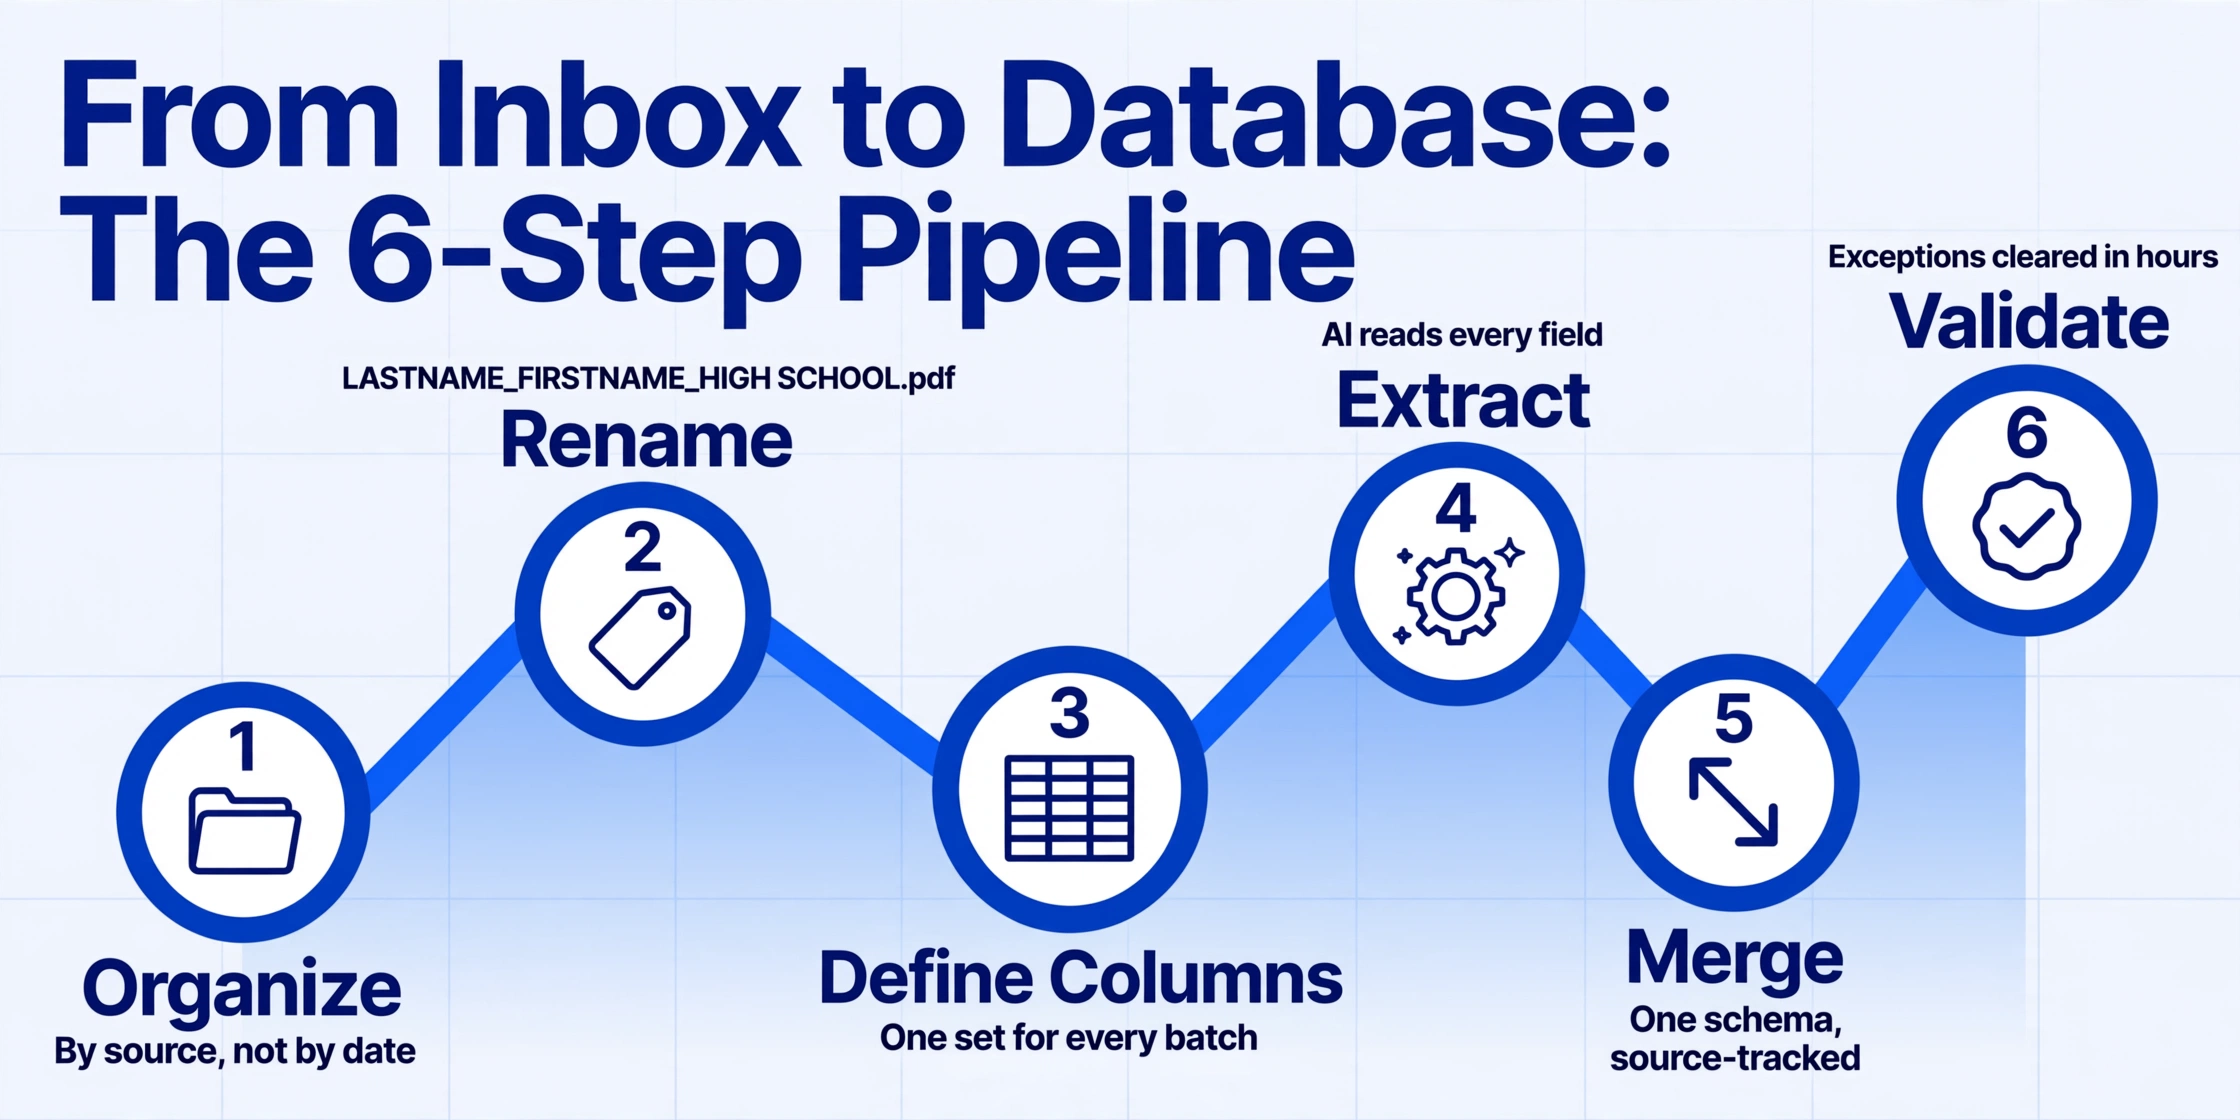
이 섹션은 소프트웨어 리뷰가 아닙니다. 어떤 추출 도구를 사용하든 500개의 서로 다른 형식의 문서를 하나의 깔끔한 입학 데이터베이스로 전환하는 실용적인 워크플로우입니다. 일괄 문서 처리의 도구 선택 측면에 대한 자세한 내용은 일괄 OCR 워크플로우 가이드를 참조하세요. 해당 문서에서는 데스크톱 OCR, 클라우드 API, AI 추출 계층을 다룹니다. 여기서는 성적 증명서 특화 파이프라인에 초점을 맞춥니다.
출처 유형별로 폴더를 하나씩 만드세요: parchment/, common-app/, scanned-paper/, international/. 출처는 형식 일관성을 가장 잘 예측하는 요소이며, 출처별로 그룹화하면 파일별이 아닌 폴더별로 추출 규칙을 한 번만 일괄 구성하면 됩니다. 도구가 하위 일괄 처리를 지원한다면 각 폴더가 자체 처리 배치가 됩니다.
처리 전에 모든 파일 이름을 지정하세요: LASTNAME_FIRSTNAME_HIGHSCHOOL.pdf. 이 규칙은 세 가지 역할을 합니다: 사람이 읽을 수 있는 대기열 역할, 모든 출력 행에 교차 참조 키를 내장, 예외 처리를 검색 가능하게 만듭니다. 최악의 시나리오는 transcript(1).pdf부터 transcript(500).pdf까지 500개의 파일이 있는 경우입니다 — 행 검증에 실패하면 원본 문서로 추적할 방법이 없습니다.
열 집합은 모든 성적표 변형을 포착할 만큼 포괄적이어야 하지만, AI 추출이 저하될 만큼 세분화되어서는 안 됩니다: Student Name, High School, Graduation Date, GPA, GPA Scale, Course Name, Course Code, Grade, Credits Earned, Term/Semester. GPA Scale 열이 가장 가치 있습니다 — 학교가 4.0, 5.0 또는 100점 척도를 사용하는지 포착하여, 학점 검토자가 "3.8"과 "95"가 동등한지 여부를 판단할 수 있게 해줍니다.
각 폴더를 하나의 배치로 처리하여 500개 전체를 하나의 처리 큐에 넣지 마세요. Parchment 출처 성적 증명서는 공통 PDF 구조를 공유하므로 함께 실행하면 AI가 접하는 형식 불연속성이 줄어들어 추출 일관성이 향상됩니다. 스캔된 종이 성적 증명서는 별도 배치로 처리하되, 처음 5~10개 파일에서 스캔 품질을 점검한 후 진행하는 것이 이상적입니다. AI 기반 추출이 기존 OCR과 어떻게 다른지, 그리고 문서에 일관된 레이아웃이 없을 때 이것이 왜 중요한지에 대한 개요는 OCR과 AI 문서 추출 비교 가이드를 참조하세요.
각 배치 완료 후 핵심 필드가 누락된 행을 플래그하세요. 이것이 예외 큐가 됩니다: 인간 검토가 필요한 성적 증명서의 5~15%에 해당하는 후보 목록입니다. 배치 처리와 배치 혼란의 차이는 예외가 즉시 처리되는지 아니면 병합된 출력에 묻혀버리는지에 달려 있습니다. 기본 데이터베이스 옆에 "예외" 시트를 만들고 플래그된 행을 파이프라인 중간에 라우팅하세요. 병합 후 정리 단계가 아니라요.
모든 배치 출력을 단일 스프레드시트 또는 데이터베이스 테이블로 통합하고, Source Batch 열을 추가하고 원본 파일 이름을 Source File 열에 보존하세요. 이 두 열은 감사 추적입니다. 학생이 과목 배치에 이의를 제기할 때 결정을 정확한 성적 증명서와 추출 배치로 추적할 수 있어야 하며, 데이터베이스를 표면적으로만 신뢰해서는 안 됩니다. 여러 소스 그룹에 걸친 배치 내보내기 워크플로우의 경우 동일한 병합 및 추적 원칙이 모든 문서 유형에 대한 배치 검증에 적용됩니다. 소스 열이 병합된 스프레드시트를 감사 가능하게 유지하는 핵심입니다.
성적 증명서 500장에서 하나의 데이터베이스로: 병합 및 검증 단계
이 시점에서 소스 폴더별로 하나의 스프레드시트라는 일괄 출력물은 있지만, 아직 통합된 입학 데이터베이스는 없습니다. 병합 단계는 서로 다른 소스에서 서로 다른 시점에 처리된 데이터가 단일 스키마를 따라야 하는 지점이기 때문에 대부분의 일괄 파이프라인이 일관성을 잃는 곳입니다.
스키마 강제는 병합 시점에 이루어집니다. 통합 전에 모든 일괄 출력물을 동일한 열 순서와 명명 규칙으로 표준화하세요. Parchment 일괄 처리에서 GPA 열을 "Cumulative GPA"로 명명하고 스캔 일괄 처리에서 "GPA (Weighted)"로 명명했다면 병합 전에 이를 조정하세요. 그렇지 않으면 각각 부분 데이터만 있는 두 개의 평행한 GPA 열이 생깁니다. 병합 전 정규화 작업은 10분이 걸리며 나중에 수시간의 스프레드시트 추적 작업을 방지합니다.
소스 추적은 필수입니다. 병합된 모든 행에 두 개의 열을 추가하세요: Source Batch 및 Source File. 10월에 학과장이 교과목 학점 인정 결정에 이의를 제기하면 이 열을 통해 30초 만에 어떤 성적 증명서와 어떤 추출 패스가 데이터를 생성했는지 확인할 수 있습니다. 500개 파일을 추적하는 데 한 시간을 소비할 필요가 없습니다. 이것이 수동 처리에는 없던 감사 계층입니다.
GPA 정규화에는 공식이 아닌 규칙이 필요합니다. 데이터베이스의 같은 열에 4.0점 만점, 5.0점 만점, 100점 만점, IB 7점 만점 고등학교의 GPA가 섞여 있으면 자동 GPA 비교는 의미가 없습니다. 원시 GPA 값 옆에 원래 척도를 보존하는 보조 열 — GPA Scale — 을 만드세요. 비교 가능한 지표로의 정규화는 데이터베이스 수준이 아닌 학점 평가 단계에서 이루어집니다. 추출 중에 모든 GPA를 단일 재계산 값으로 통합하는 것은 흔한 실수입니다. 학생이나 학부모가 평가에 이의를 제기할 때 필요한 증거를 파괴하기 때문입니다.
과정 항목의 경우, 병합 단계에서 추출된 과정 이름을 대학의 과정 등가성 데이터베이스와 대조하는 학점 인정 매핑(articulation mapping)을 시작할 수 있는 지점이기도 합니다. 이는 일괄 추출 작업이 아니라, 추출된 각 과정 행을 기존 등가성 정보와 짝지어 주고 일치 항목이 없는 행은 수동 검토를 위해 표시하는 병합 후 조회 작업입니다. 추출 도구의 역할은 과정 이름, 코드, 성적을 라벨이 지정된 열에 넣는 것입니다. 학점 인정 매핑은 입학 사무팀의 전문 영역으로, 개별 PDF가 아닌 정리된 데이터베이스를 대상으로 적용됩니다.
예외 처리: 8~15%의 성적 증명서에 수동 검토가 필요할 때 대처 방법
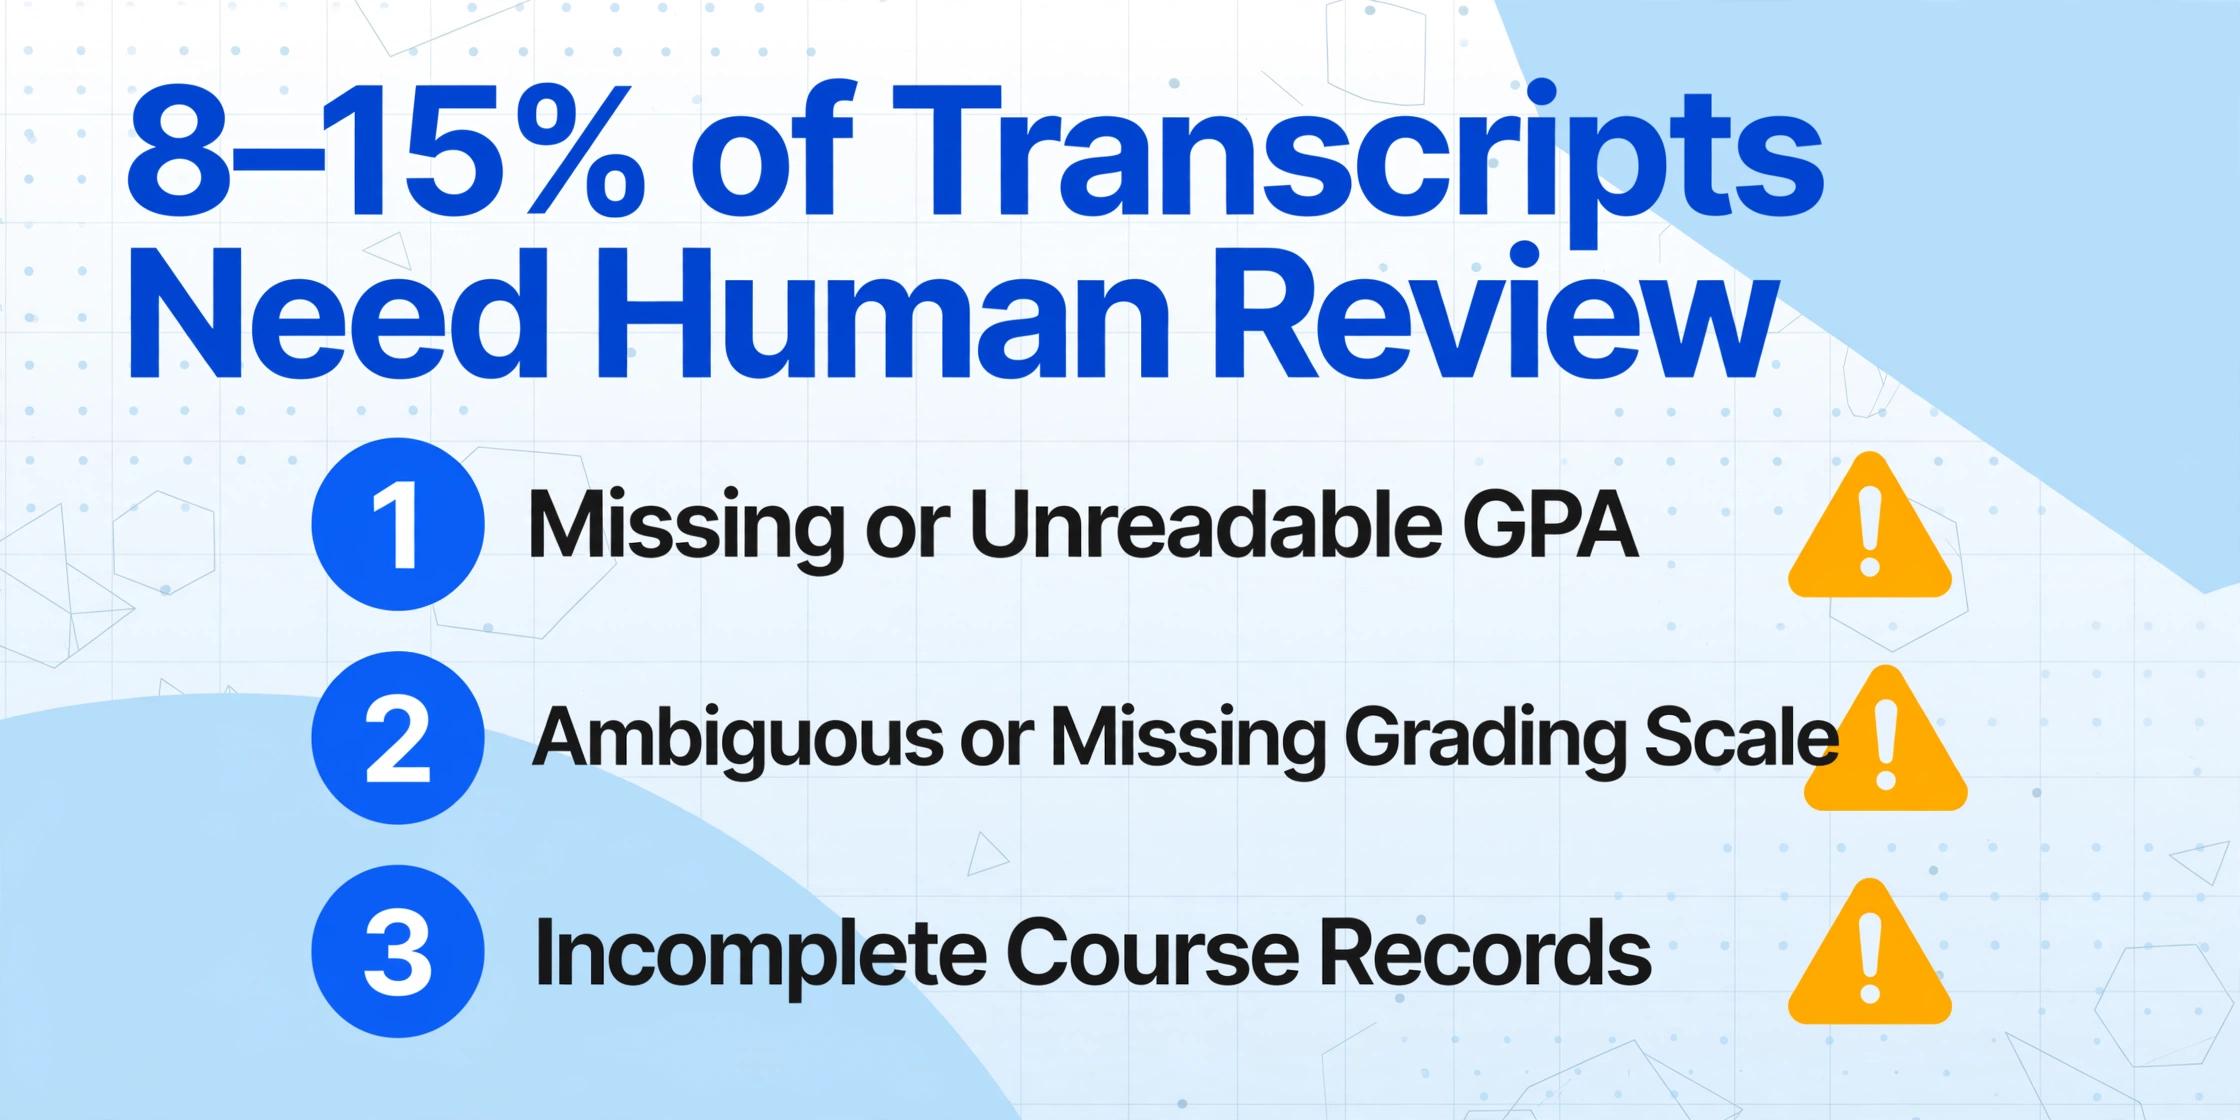
모든 일괄 파이프라인은 예외를 생성합니다. 목표는 예외가 없는 것이 아니라, 검토자 한 명이 한 시간 안에 처리할 수 있는 구조화된 예외 대기열을 만드는 것입니다. 다음은 성적 증명서 일괄 처리에서 일관되게 나타나는 예외 범주와, 파이프라인을 중단하지 않고 각각을 처리하는 방법입니다.
GPA 누락 또는 판독 불가
일부 고등학교 성적 증명서 — 특히 소규모 학군과 해외 기관의 경우 — 누적 GPA를 단일 수치로 표시하지 않습니다. 다른 경우에는 스캔본에서 번진 점으로 보일 정도로 작은 글꼴로 인쇄됩니다. 추출 결과에서 GPA 필드가 비어 있으면 행에 플래그를 지정하되 일괄 처리를 중단하지 마십시오. 해당 행은 "GPA 미추출 — 원본에서 확인"이라는 메모와 함께 예외 대기열로 이동합니다.
성적 척도가 모호하거나 누락된 경우
GPA가 "3.8"로 표시되어 있지만 척도가 4.0, 5.0, 12.0 중 무엇인지 명시되지 않은 성적 증명서는 배치 리스크가 있습니다. 추출 출력에서 GPA 척도를 "미지정"으로 채우고 해당 행을 예외 처리로 라우팅해야 합니다. 검토자는 성적 증명서의 범례, 하단, 뒷면에 척도가 명시되어 있는지, 또는 고등학교 웹사이트에 채점 정책이 문서화되어 있는지 확인합니다.
불완전한 교과목 기록
일부 성적 증명서는 각 교과목의 기말 성적만 표시하고 학기별 세부 내역, 학점 시간, 교과목 코드가 없습니다. 다른 증명서는 교과목명을 20자로 잘라서 표시하기도 합니다. 이러한 행은 기술적으로는 깨끗하게 추출될 수 있지만 학점 인정 목적에는 불완전합니다. 교과목 코드 필드가 비어 있거나 학년별 교과목 수가 예상보다 적은 행에 플래그를 지정하세요.
학기가 드문드문 있거나 누락된 경우
4학년 가을 학기 교과목은 표시되지만 봄 학기는 표시되지 않는 성적 증명서는 흔한 상황을 시사합니다: 학생이 봄 학기 성적이 게시되기 전인 학기 중에 성적 증명서를 보낸 경우입니다. 이는 오류가 아니라 부분 기록입니다. 이를 예외가 아닌 "최종 성적 증명서 대기 중"으로 플래그를 지정하세요. 일괄 파이프라인은 "존재하지만 캡처되지 않은 데이터"와 "아직 생성되지 않은 데이터"를 구분해야 합니다.
예외 큐 워크플로우
각 배치가 완료된 후 필수 필드의 공백, 예상 범위를 벗어난 GPA 값, 임계값 미만의 교과목 수를 확인하는 검증 패스를 실행하세요. 플래그가 지정된 행은 전용 예외 시트로 이동합니다. 자동 수정은 절대 시도하지 마세요. 지나치게 자신 있는 자동 수정은 빈 셀보다 찾기 어려운 오류를 만들기 때문입니다.
다운스트림 결정을 차단하는 예외를 우선 처리하세요: 학생 이름 또는 졸업 날짜 공백이 첫 번째, GPA 누락이 두 번째, 불완전한 교과목 기록이 세 번째. 도착 순서 처리는 영향력이 낮은 예외에 시간을 낭비하고 중요도가 높은 행은 대기하게 만듭니다.
단일 예외에 2분 이상을 소비하고 있다면 에스컬레이션하세요. 상급 검토자에게 올리거나 학생 또는 고등학교에 업데이트된 성적 증명서를 요청하는 "설명 요청" 큐로 보내세요. 일괄 처리의 효율성 이점은 예외가 절약하려던 시간을 소비하게 되면 사라집니다.
잘 구조화된 예외 큐는 500명의 신입생 클래스 기준으로 20~45분 내에 처리됩니다. 핵심은 "인간 검토 필요"와 "원본 문서 재검토 필요"를 분리하는 것입니다. 이는 불량 파이프라인이 하나의 "문제" 더미로 혼합하는 완전히 다른 두 가지 작업 범주입니다.
자주 묻는 질문
일괄 처리가 비표준 성적 체계를 사용하는 해외 성적증명서도 처리할 수 있나요?
네, 하지만 중요한 전제가 있습니다. 일괄 추출은 IB, A-Levels(A*–E), 프랑스 바칼로레아, 인도 CBSE 백분율 체계 등 어떤 성적 체계든 과목명, 성적, GPA를 레이블이 지정된 열로 추출할 수 있습니다. 하지만 성적 평가, 즉 IB Mathematics HL 5점이 귀교의 MATH 101과 동등한지 판단하는 작업은 수행할 수 없습니다. 그 영역에 대한 전문 지식은 귀교의 국제입학처나 WES, ECE 같은 외부 학력평가 기관에 있습니다. 일괄 처리 파이프라인의 역할은 원시 데이터를 데이터베이스에 넣어 평가자가 PDF가 아닌 행을 비교할 수 있도록 하는 것입니다.
일괄 추출 후 일반적으로 몇 퍼센트의 성적증명서를 수동 검토해야 하나요?
성적증명서 처리 사례에서 일반적으로 8~15%의 행에 대해 사람의 검토가 필요합니다. 이는 서식 변동 폭이 더 큰 송장 일괄 처리보다는 낮지만, ACORD 25 양식이 레이아웃을 표준화하는 COI 일괄 처리보다는 높은 수치입니다. 수동 검토의 가장 일반적인 원인은 이미지 품질이 낮은 스캔 종이 성적증명서, 비표준 성적 표기법을 사용하는 학교의 성적증명서, 그리고 과목명이 미국 관행을 따르지 않는 해외 성적증명서입니다. 예외율이 20%를 초과하면 스캔 품질을 재검토하십시오. 낮은 품질의 스캔은 추출 오류의 가장 큰 원인입니다.
일괄 추출이 Parchment 및 National Student Clearinghouse PDF에서도 작동하나요?
네. Parchment Receive와 National Student Clearinghouse를 통해 전달되는 성적증명서는 표준 PDF입니다. 전자 전달 계층이 인증과 라우팅을 처리하지만, 문서 자체는 여전히 시각적 레이아웃이며 일괄 추출이 다른 PDF와 동일한 방식으로 읽습니다. 전자 전달 성적증명서의 장점은 일관된 디지털 품질입니다. 스캐너 기울어짐, 손으로 쓴 여백 메모, 바랜 감열지가 없습니다. 하지만 Parchment PDF도 고등학교마다 다릅니다. 각 학교가 Parchment 시스템 내에서 자체 성적증명서 템플릿을 구성하기 때문에 레이아웃은 여전히 다양하지만 기본 품질은 더 좋습니다.
올바른 코스 데이터가 올바른 학생에게 매핑되도록 하려면 어떻게 해야 하나요?
세 가지 안전장치가 있습니다. 첫째, 파일명 규칙은 모든 원본 파일에 학생 신원을 포함시킵니다. 둘째, 각 추출 행은 원본 파일명을 상속받아 지속적인 추적을 가능하게 합니다. 셋째, 학생 이름과 고등학교를 명시적 열로 추출한 후, 지원자 데이터베이스와 교차 참조하여 최종 입학 데이터베이스에 병합합니다. 추출된 이름이 등록된 학생과 일치하지 않거나, 성적증명서에 학생 지원서에 없는 고등학교가 언급된 경우 플래그를 지정하세요 — 이는 시스템 입력 오류 또는 여러 기관의 자격 증명을 제출한 학생일 수 있습니다.
동일한 배치 파이프라인이 신입생 성적증명서와 함께 편입생 성적증명서를 처리할 수 있나요?
기술적으로는 가능하지만, 물류적으로는 분리하는 것이 좋습니다. 편입생 성적증명서에는 고등학교 성적증명서와 다른 평가 과정이 필요한 과목 코드, 학점, 선수과목 체계가 포함된 대학 수준의 교과 과정이 있습니다. 동일한 열 정의로 동일한 파이프라인을 통해 처리하면 깔끔해 보이는 행이 생성되지만, 편입 학점 매핑 중 재검토가 필요합니다 — 이 시점에서 배치를 결합하여 절약한 시간이 사라집니다. 신입생과 편입생 성적증명서는 각 문서 유형에 최적화된 다른 열 세트를 사용하여 별도의 배치 프로젝트로 실행하세요.
수동 입력을 중단하고 처리를 시작할 때 무엇이 바뀌나요?
수동 입력에서 배치 처리로의 전환은 속도 이상의 변화를 가져옵니다. 여름철 업무량이 많은 기간 동안 입학 팀이 실제로 시간을 어떻게 사용하는지가 바뀝니다.
이전에 SIS에 과목 이름을 입력하는 데 167시간을 보냈던 직원은 이제 그 시간을 평가 및 편입 학점 인정에 사용합니다 — 예외 행 검토, 과목 동등성 매핑, 비표준 척도의 추출된 GPA가 장학금 기준에 맞게 올바르게 가중치가 적용되었는지 확인하는 작업입니다. 이것이 기관 지식과 인간의 판단이 필요한 작업이며, 수동 입력이 오리엔테이션 이후인 9월로 미루었던 작업으로, 그때는 과정 수정이 더 어렵습니다.
배치 처리는 인간의 검토를 없애는 것이 아니라 파이프라인의 올바른 위치, 즉 데이터가 구조화된 후 영구 기록에 입력되기 전으로 이동시킵니다. 결과는 모든 행이 원본 파일로 추적 가능하고, 모든 예외가 해결 방법과 함께 기록되며, 모든 GPA가 원래 척도로 주석 처리된 하나의 데이터베이스입니다 — 수동 입력이 본질적으로 결코 생성할 수 없었던 감사 추적입니다.
500개의 신입생 성적증명서를 처리하는 중간 규모 대학의 경우, 그 차이는 여름을 데이터 입력에 보내는 것과 학생 준비 상태에 보내는 것 사이의 거리입니다. 단일 배치로 시작하세요. 얼마나 많은 행이 깨끗하게 통과하는지, 예외 큐를 처리하는 데 얼마나 오래 걸리는지 확인하세요. 그 하나의 파일럿 실행은 어떤 기능 비교 차트보다 기관의 배치 준비 상태에 대해 더 많은 것을 알려줍니다.
학생 성적증명서를 배치 처리하여 하나의 데이터베이스로
열을 한 번 정의하고, 성적증명서를 로드하고, 병합된 단일 입학 데이터베이스를 얻으세요 — 수동 데이터 입력이 필요 없습니다.
처리 시작