500 Históricos de Calouros,
Um Banco de Dados de Admissões
Todo verão, após o prazo de depósito de 1º de maio, o escritório de admissões de uma universidade de médio porte enfrenta o mesmo problema matemático: cerca de 500 calouros, cada um com pelo menos um histórico escolar do ensino médio — e cada histórico levando cerca de 20 minutos para ser inserido manualmente no Sistema de Informação do Estudante. Isso representa 167 horas de trabalho — quatro semanas completas para uma pessoa — entre junho e agosto, com prazos de orientação e matrícula em cursos pressionando o tempo todo. O gargalo não é o volume. É que 500 históricos chegam em 500 formatos diferentes de 500 escolas diferentes, e cada formato exige os mesmos olhos humanos para decodificá-lo.
Principais Conclusões
- 167 horas de trabalho — é o que 500 históricos de calouros a 20 minutos cada representam, e tudo isso ocorre entre junho e agosto, quando os prazos de orientação não esperam.
- Processar 5 históricos é uma tarde, mas 500 é um colapso estrutural — a atenção humana não escala linearmente, e no histórico 120 você para de perceber que um B+ de uma escala de GPA de 13 pontos foi inserido como 3,3 em uma escala de 4,0.
- A extração em lote não elimina o revisor — ela transforma essas 167 horas de digitação de nomes de cursos em avaliação de equivalências de cursos, que é o que seu conhecimento institucional foi contratado para fazer em primeiro lugar.
Para os fundamentos da extração de dados de um único histórico escolar — quais campos extrair, como configurar suas definições de colunas e como é um resultado final — comece com nosso guia para extrair dados de histórico escolar de estudantes para o Excel. O que segue aqui é a camada de escala: tudo o que muda quando você passa de processar um histórico para processar 500, e como construir um pipeline que entrega um banco de dados pronto para admissões até agosto.
O Pico de Históricos Escolares no Verão: Volume em Números
A maioria das discussões sobre fluxo de trabalho de admissões se concentra na temporada de inscrições — decisão antecipada em novembro, decisão regular de janeiro a março. Mas o gargalo do processamento de históricos escolares ocorre depois, após os depósitos serem feitos. A National Association for College Admission Counseling relata que aproximadamente 2,9 milhões de calouros de primeira viagem se matriculam em faculdades dos EUA anualmente. Para uma universidade de médio porte — definida pela Carnegie Classification como aquela que matricula entre 5.000 e 15.000 alunos de graduação — isso se traduz em aproximadamente 3.000 a 10.000 inscrições por ciclo.
Uma universidade de médio porte que admite 2.500 alunos e efetiva 1.000 calouros matriculados processa aproximadamente 500 a 700 históricos escolares de ensino médio durante os meses de verão, além de históricos adicionais de alunos transferidos e programas de dupla matrícula. Cada histórico precisa ter nomes de cursos, notas, créditos, GPA e verificação de graduação extraídos antes que o aluno possa ser alocado nos cursos corretos. Um artigo de 2023 do AACRAO Connect patrocinado pela Parchment estimou a inserção manual de dados de históricos em 20 minutos por inscrição. Com 500 históricos, isso representa 167 horas — comprimidas em uma janela de 8 a 10 semanas entre os prazos de depósito e a orientação.
O timing é o multiplicador. Os escritórios de admissão não têm 167 horas de folga. Eles têm as mesmas semanas de 40 horas de sempre, com a mesma equipe, durante a mesma janela. E cada dia de atraso — cada histórico parado em uma fila de processamento enquanto o aluno aguarda um e-mail de alocação — reduz a taxa de matrícula. Alunos que não recebem resposta rapidamente se comprometem em outro lugar ou se matriculam em cursos com base em avaliação incompleta, criando caos de adição/remoção de disciplinas em setembro.
Por que a Inserção Manual de Históricos Escolares Quebra aos 500
Processar um histórico manualmente é tedioso, mas administrável. Cinco históricos — o trabalho de uma tarde. Cinquenta — uma semana inteira. Aos 500, a conta deixa de ser sobre tempo e passa a ser sobre uma falha estrutural na forma como a atenção humana opera em escala.
Cada histórico exige a mesma sequência cognitiva: localizar o nome do aluno e o ensino médio, decifrar a escala de notas (a escola usa escala 4.0, 5.0 ou 100 pontos?), ler cada nome de disciplina e sua nota, mapear as designações de semestre, verificar o status de conclusão e digitar cada campo no SIS. Os nomes das disciplinas são o maior ponto de atrito. "English 9 Honors" em uma escola é "ENGL 101H" em outra e "Composition & Literature I (Advanced)" numa terceira — mas todas precisam ser mapeadas para a mesma entrada no seu banco de dados de articulação.
Com 20 históricos, um funcionário percebe essas variações. Com 120, os centros de reconhecimento de padrões do cérebro começam a colapsar entradas de aparência semelhante. Um "B+" de uma escola que usa uma escala de GPA de 13 pontos (A+ = 4,33) é inserido como 3,3 em uma escala de 4,0 porque o cursor esteve no modo de escala 4,0 a manhã toda. Um histórico com uma coluna "Aprovado/Reprovado" para as disciplinas da primavera de 2020 — uma variação comum da era COVID — é inserido sem sinalização, porque o operador parou de ler os cabeçalhos das colunas no histórico número 80. O conteúdo patrocinado do Inside Higher Ed da Laserfiche confirma isso: "os históricos escolares dos alunos são tão propensos a erros humanos" que sua solução automatizada foi projetada para sinalizar entradas com formato errado antes que cheguem aos revisores humanos — uma admissão de que a inserção manual gera erros suficientes para exigir sua própria camada de validação.
A diferença entre 5 e 500 históricos não é apenas mais tempo — é uma categoria de problema totalmente diferente. Com 5, você verifica. Com 500, você faz uma amostragem — e torce para que os outros 495 não contenham erros que se propaguem em colocações incorretas em disciplinas, erros de cálculo de créditos ou auditorias de conclusão atrasadas.
O Panorama dos Formatos: Eletrônico, Papel e Tudo Entre os Dois
A fantasia é que todas as transcrições cheguem via Parchment ou National Student Clearinghouse em um formato eletrônico uniforme. A realidade na maioria dos escritórios de admissões é uma caixa de entrada híbrida que se parece mais com isto:
| Canal | Participação Típica | Formato | Desafio de Extração |
|---|---|---|---|
| Parchment / Clearinghouse ETX | 55–65% | EDI (SPEEDE TS130), PDF ou XML estruturado | EDI é analisado automaticamente em alguns sistemas SIS; variantes de PDF diferem conforme a configuração do Parchment de cada escola |
| Integração Common App | 10–15% | Fluxo de dados estruturado | Campos limitados — geralmente apenas GPA e resumo de matérias principais, sem detalhes completos da transcrição |
| E-mail Direto / Portal de Upload | 10–15% | PDF (digitalizado ou exportado digitalmente) | Layout varia muito; alguns são digitalizados de papel, outros exportados do SIS da escola com formatação personalizada |
| Correio Físico (Papel) | 5–10% | Papel → digitalizado para PDF pela admissão | Qualidade da digitalização, inclinação, sombras; anotações manuscritas em formulários oficiais |
| Internacional / Não Tradicional | 3–5% | PDF, imagens digitalizadas, documentos traduzidos | Sistemas de notas não padronizados (IB, A-Levels, currículos nacionais), tradução de idiomas, avaliação de credenciais |
A pesquisa AACRAO de 2018 sobre custo, tipo e volume de transcrições constatou que aproximadamente 15% das transcrições ainda eram entregues em papel. Esse número provavelmente caiu desde então, mas distritos escolares menores e instituições internacionais ainda enviam papel — e essas transcrições chegam na bandeja do scanner antes de chegarem ao seu SIS. Cada digitalização introduz suas próprias variáveis: contraste, inclinação, corte de margem, legibilidade de escalas de notas em letras pequenas.
Um pipeline de processamento em lote que só lida com Parchment EDI está resolvendo metade do problema. As transcrições que consomem mais tempo da equipe são justamente as que chegam fora das redes eletrônicas — papel digitalizado, PDFs enviados por e-mail de escolas sem acordos de intercâmbio e credenciais internacionais. Um fluxo de trabalho que vale a pena construir lida com todas elas.
Construindo o Pipeline de Processamento em Lote: 6 Etapas da Caixa de Entrada ao Banco de Dados
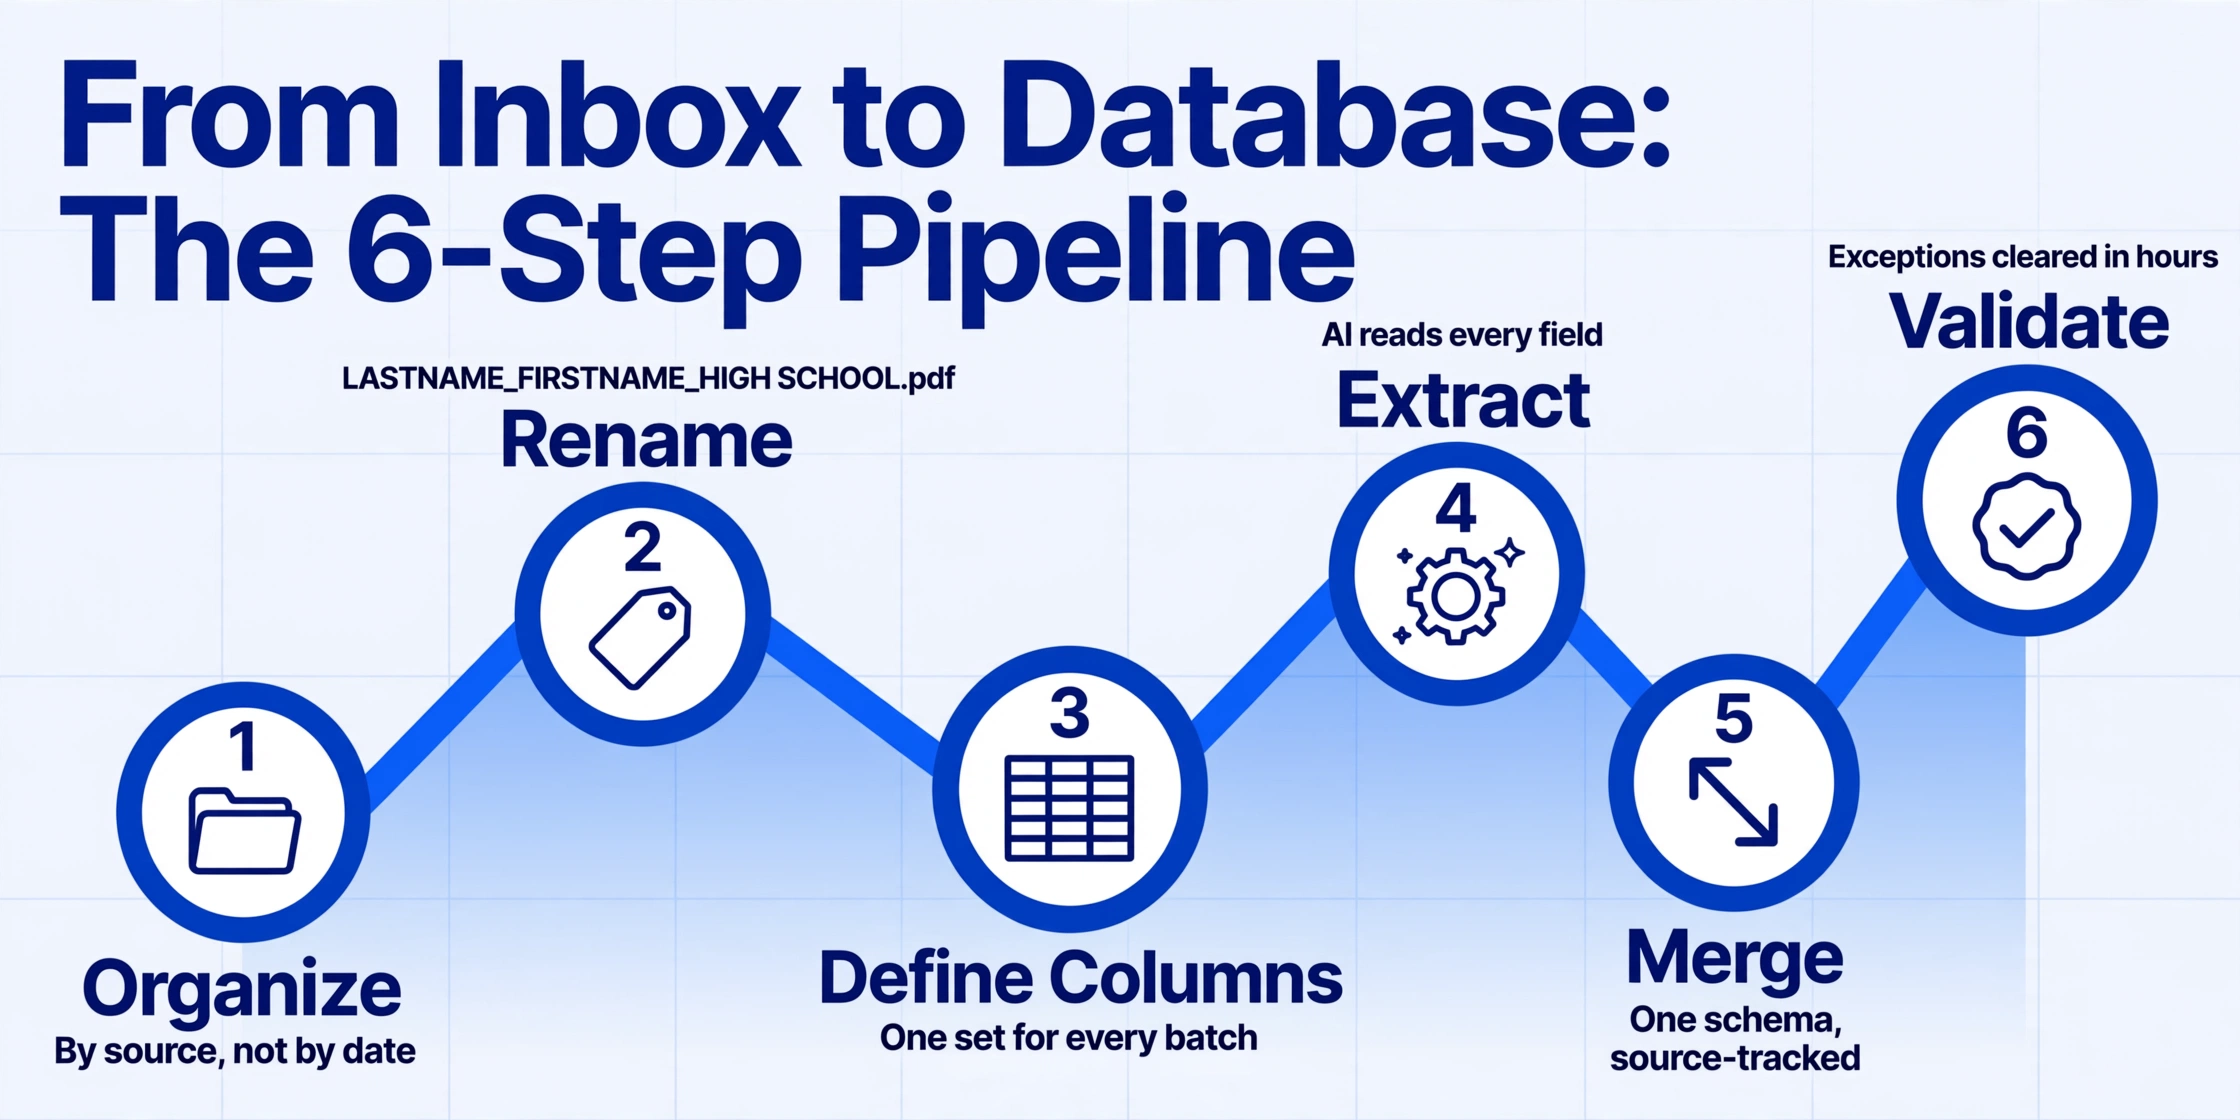
Esta não é uma seção de análise de software. É o fluxo de trabalho prático que transforma 500 documentos incompatíveis em um único banco de dados de admissão limpo, independentemente da ferramenta de extração que você usar. Para uma análise mais aprofundada do lado da seleção de ferramentas no processamento de documentos em lote — quais capacidades procurar e onde diferentes níveis de ferramentas ficam aquém — consulte nosso guia para fluxos de trabalho de OCR em lote. Esse artigo aborda OCR de desktop, APIs de nuvem e níveis de extração com IA. Aqui, focamos no pipeline específico de transcrições.
Crie uma pasta por tipo de fonte: parchment/, common-app/, scanned-paper/, international/. A fonte é o indicador mais forte de consistência de formato, e agrupar por fonte permite configurar regras de extração em lote uma vez por pasta, em vez de por arquivo. Se sua ferramenta suporta processamento em sub-lotes, cada pasta se torna seu próprio lote de processamento.
Nomeie cada arquivo antes do processamento: SOBRENOME_NOME_ESCOLA.pdf. Essa convenção tem tripla função: serve como fila legível, incorpora uma chave de referência cruzada em cada linha de saída e torna o tratamento de exceções pesquisável. O pior cenário é 500 arquivos nomeados transcript(1).pdf até transcript(500).pdf — se uma linha falhar na validação, você não terá como rastrear até o documento de origem.
Seu conjunto de colunas deve ser abrangente o suficiente para capturar todas as variantes de histórico escolar, mas não tão granular que degrade a extração de IA: Student Name, High School, Graduation Date, GPA, GPA Scale, Course Name, Course Code, Grade, Credits Earned, Term/Semester. A coluna GPA Scale é a mais valiosa — ela captura se a escola usa escala de 4.0, 5.0 ou 100 pontos, o que informa ao seu revisor de articulação se um "3.8" e um "95" são equivalentes ou não.
Processe cada pasta como um lote próprio, em vez de despejar todos os 500 em uma única fila de processamento. Transcrições originadas do Parchment compartilham uma estrutura de PDF comum — processá-las juntas melhora a consistência da extração, pois a IA encontra menos descontinuidades de formato. Transcrições em papel escaneado vão em um lote separado, idealmente depois que você verificar a qualidade do escaneamento nos primeiros 5 a 10 arquivos. Para uma visão geral de como a extração baseada em IA difere do OCR tradicional — e por que isso importa quando seus documentos não têm um layout consistente — consulte nosso guia sobre OCR vs. extração de documentos com IA.
Após cada lote ser concluído, sinalize qualquer linha em que campos-chave estejam ausentes — Nome do Estudante em branco, GPA em branco ou menos entradas de cursos do que o esperado. Essas se tornam sua fila de exceções: uma lista curta de 5 a 15% das transcrições que precisam de revisão humana. A diferença entre processamento em lote e caos em lote é se as exceções são tratadas imediatamente ou enterradas na saída mesclada. Crie uma planilha "Exceções" ao lado do seu banco de dados principal e direcione as linhas sinalizadas para lá no meio do pipeline, não como uma etapa de limpeza pós-mesclagem.
Consolide todas as saídas dos lotes em uma única planilha ou tabela de banco de dados, adicionando uma coluna Lote de Origem e preservando o nome do arquivo original em uma coluna Arquivo de Origem. Essas duas colunas são sua trilha de auditoria — quando um estudante contesta uma colocação de curso, você precisa rastrear a decisão até a transcrição exata e o lote de extração, não apenas confiar no banco de dados pelo valor de face. Para fluxos de trabalho de exportação em lote em vários grupos de origem, o mesmo princípio de mesclar e rastrear se aplica à verificação em lote em qualquer tipo de documento — a coluna de origem é o que mantém uma planilha mesclada auditável.
De 500 Transcrições a Um Banco de Dados: A Etapa de Mesclar e Validar
Neste ponto, você tem saídas em lote — uma planilha por pasta de origem — mas ainda não um banco de dados de admissão unificado. A etapa de mesclagem é onde a maioria dos pipelines em lote perde a coerência, porque é onde dados de diferentes fontes, processados em momentos diferentes, devem se conformar a um único esquema.
A aplicação do esquema acontece no momento da mesclagem. Antes de consolidar, padronize cada saída em lote para a mesma ordem de colunas e convenção de nomenclatura. Se seu lote do Parchment nomeou a coluna de GPA como "Cumulative GPA" e seu lote digitalizado a chamou de "GPA (Weighted)", reconcilie-os antes de mesclar — caso contrário, você terá duas colunas de GPA paralelas com dados parciais em cada uma. Uma passagem de normalização pré-mesclagem leva 10 minutos e evita horas de investigação em planilhas depois.
O rastreamento da fonte é inegociável. Adicione duas colunas a cada linha mesclada: Source Batch (qual lote de processamento produziu esta linha) e Source File (o nome do arquivo original). Quando uma decisão de equivalência de curso for questionada por um chefe de departamento em outubro, essas colunas informam em 30 segundos qual transcrição e qual passagem de extração geraram os dados — em vez de gastar uma hora refazendo os passos por 500 arquivos. Esta é a camada de auditoria que o processamento manual nunca teve.
A normalização do GPA precisa de uma regra, não de uma fórmula. Quando seu banco de dados contém GPAs de escolas de ensino médio com escala de 4,0, escala de 5,0, escala de 100 pontos e escala de 7 pontos do IB na mesma coluna, qualquer comparação automática de GPA é sem sentido. Crie uma coluna complementar — GPA Scale — que preserva a escala original junto com o valor bruto do GPA. A normalização em uma métrica comparável acontece a jusante na etapa de avaliação de créditos, não no nível do banco de dados. Colapsar todos os GPAs em um único número recalculado durante a extração é um erro comum: destrói a evidência que você precisa quando um estudante ou pai questiona a avaliação.
Para entradas de cursos, a etapa de mesclagem também é onde você pode iniciar o mapeamento de articulação — correspondendo os nomes de cursos extraídos ao banco de dados de equivalência de cursos da sua universidade. Esta não é uma tarefa de extração em lote; é uma consulta pós-mesclagem que associa cada linha de curso extraída a uma equivalência conhecida quando ela existe, e sinaliza linhas sem correspondência para revisão manual. O trabalho da ferramenta de extração é colocar o nome do curso, o código e a nota em colunas rotuladas. O mapeamento de articulação é a experiência do domínio da sua equipe de admissões, aplicada a um banco de dados limpo, em vez de PDFs individuais.
Tratamento de Exceções: O Que Fazer Quando 8–15% dos Históricos Escolares Precisam de Revisão Humana
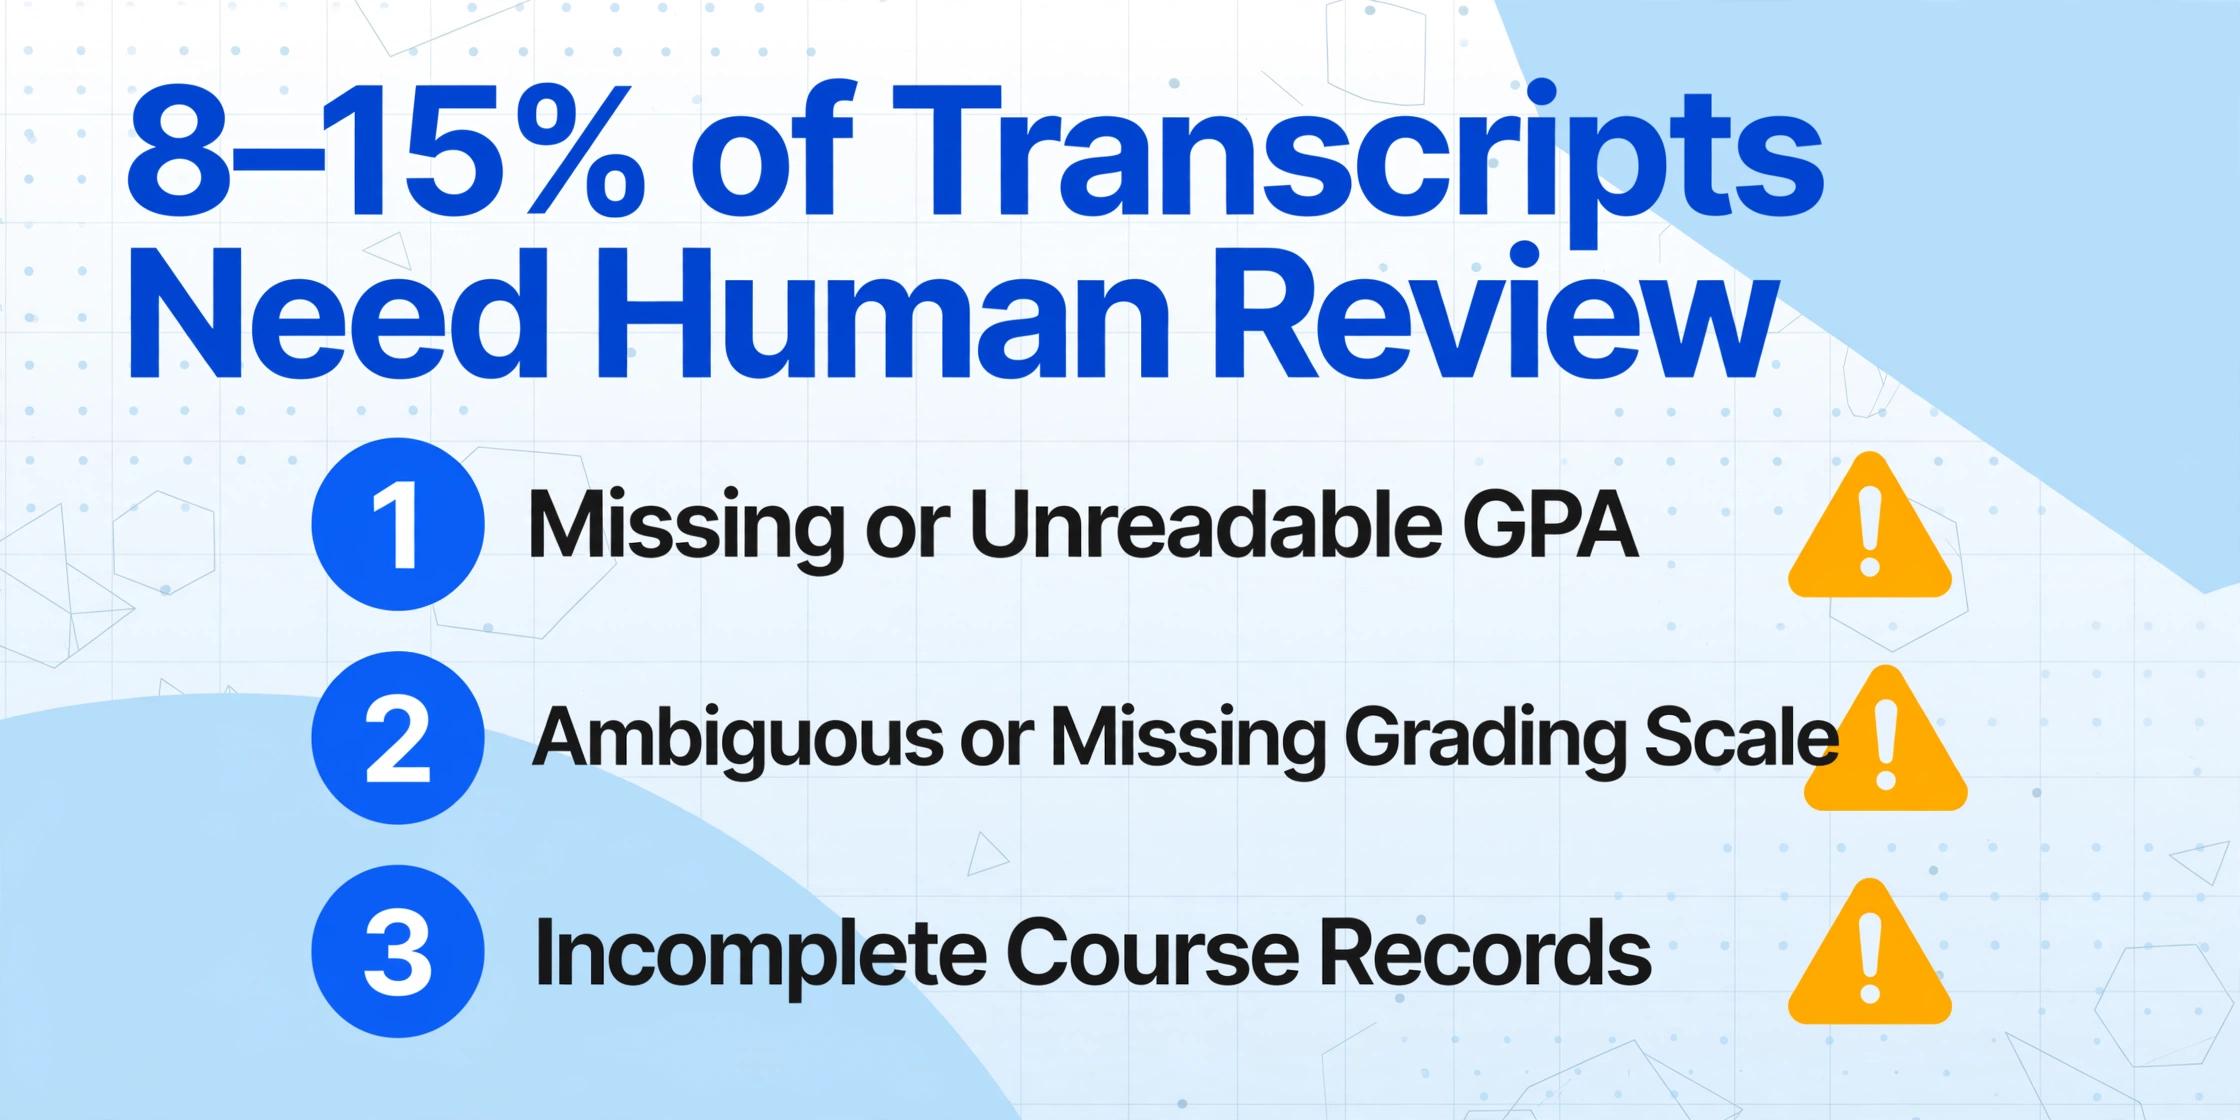
Todos os pipelines em lote produzem exceções. O objetivo não é zero exceções — é uma fila de exceções estruturada que um único revisor pode limpar em menos de uma hora. Aqui estão as categorias de exceção que aparecem consistentemente no processamento em lote de históricos escolares e como lidar com cada uma sem interromper o pipeline.
GPA Ausente ou Ilegível
Alguns históricos escolares do ensino médio — particularmente de distritos menores e instituições internacionais — não exibem um GPA cumulativo como um único número. Outros o imprimem em um tamanho de fonte pequeno o suficiente para que cópias digitalizadas o tornem pontos borrados. Quando o campo GPA estiver em branco na sua saída de extração, sinalize a linha, mas não pare o lote. Essas linhas vão para a fila de exceções com uma nota: "GPA não extraído — verificar a partir do original."
Escala de Notas Ambígua ou Ausente
Um histórico que mostra GPA como "3.8" sem indicar se a escala é 4.0, 5.0 ou 12.0 é um risco para a colocação. A saída da extração deve preencher a Escala de GPA como "Não Especificada" e encaminhar a linha para exceções. O revisor verifica se a legenda, o rodapé ou o verso do histórico indica a escala — ou se o site da escola de ensino médio documenta sua política de notas.
Registros de Cursos Incompletos
Alguns históricos mostram apenas as notas finais de cada curso, sem detalhamento por semestre, horas de crédito ou códigos de curso. Outros truncam os nomes dos cursos em 20 caracteres. Essas linhas podem ser extraídas tecnicamente sem erros, mas estão incompletas para fins de articulação. Sinalize linhas em que o campo Código do Curso esteja em branco ou em que o número de entradas de curso por ano letivo seja menor que o esperado (normalmente de 5 a 8 cursos por ano em uma escola de ensino médio padrão dos EUA).
Semestres Escassos ou Ausentes
Um histórico que mostra cursos do outono do último ano, mas nada da primavera, levanta um cenário comum: o estudante enviou o histórico no meio do ano, antes da publicação das notas da primavera. Esses não são erros — são registros parciais. Sinalize-os como "Aguardando Histórico Final", não como exceções. O pipeline em lote deve diferenciar entre "dados que existem, mas não foram capturados" e "dados que ainda não foram produzidos".
O Fluxo de Trabalho da Fila de Exceções
Após cada lote ser concluído, execute uma passagem de validação que verifique campos obrigatórios em branco, valores inesperados de GPA (fora das faixas de 0–5.0 ou 0–100) e contagens de cursos abaixo de um limite. Linhas sinalizadas vão para uma planilha de Exceções dedicada — nunca tente correções automáticas, pois uma correção automática excessivamente confiante cria erros mais difíceis de encontrar do que células em branco.
Priorize exceções que bloqueiam decisões a jusante: Nome do Estudante ou Data de Formatura em branco (não é possível verificar identidade ou elegibilidade) primeiro; GPA ausente em segundo lugar (bloqueia a avaliação de bolsas e honrarias); registros de cursos incompletos em terceiro lugar (bloqueia a colocação, mas não a admissão). O processamento por ordem de chegada gasta tempo com exceções de baixo impacto enquanto linhas de alto risco esperam.
Se você estiver gastando mais de 2 minutos em uma única exceção, encaminhe-a — seja para um revisor sênior ou para uma fila de "Solicitar Esclarecimento", na qual o estudante ou a escola de ensino médio é contatado para obter um histórico atualizado. O ganho de eficiência do processamento em lote desaparece quando as exceções consomem o tempo que deveriam economizar.
Uma fila de exceções bem estruturada processa em 20 a 45 minutos uma turma de 500 estudantes. O segredo é separar "precisa de revisão humana" de "precisa de reexame do documento original" — duas categorias de trabalho totalmente diferentes que pipelines ruins misturam em uma única pilha de "problemas".
Perguntas Frequentes
O processamento em lote consegue lidar com históricos internacionais com sistemas de notas não padronizados?
Sim, mas com uma ressalva importante. A extração em lote pode capturar nomes de disciplinas, notas e GPA em colunas rotuladas, independentemente do sistema de notas — seja IB (1–7), A-Levels (A*–E), Baccalauréat francês (0–20) ou o sistema percentual do CBSE da Índia. O que não pode fazer é realizar a avaliação de credenciais — determinar se um IB 5 em Matemática HL equivale à disciplina MATH 101 da sua universidade. Esse conhecimento específico é de responsabilidade da sua equipe de admissões internacionais e de serviços externos de avaliação de credenciais, como WES ou ECE. O papel do pipeline em lote é inserir os dados brutos em um banco de dados para que os avaliadores comparem linhas, não PDFs.
Qual porcentagem de históricos normalmente precisa de revisão manual após a extração em lote?
No caso de uso de processamento de históricos, espere que de 8 a 15% das linhas exijam revisão humana — menos que o processamento de faturas em lote (onde a variação de formatação é maior), mas mais que o processamento de certificados de seguro em lote (onde o formulário ACORD 25 padroniza o layout). Os gatilhos mais comuns para revisão manual são históricos escaneados em papel com problemas de qualidade de imagem, históricos de escolas que usam notação de notas não padronizada e históricos internacionais onde os nomes das disciplinas não seguem as convenções dos EUA. Se sua taxa de exceção exceder 20%, reavalie a qualidade do escaneamento — escaneamentos ruins são o maior indicador de falhas na extração.
A extração em lote funciona com PDFs do Parchment e do National Student Clearinghouse?
Sim. Históricos entregues pelo Parchment Receive e pelo National Student Clearinghouse são PDFs padrão — a camada de entrega eletrônica lida com autenticação e roteamento, mas o documento em si ainda é um layout visual que a extração em lote lê da mesma forma que qualquer outro PDF. A vantagem dos históricos de entrega eletrônica é a qualidade digital consistente: sem distorção de scanner, sem anotações manuscritas nas margens, sem papel térmico desbotado. Dito isso, até mesmo os PDFs do Parchment variam entre escolas de ensino médio, pois cada escola configura seu próprio modelo de histórico dentro do sistema Parchment — portanto, o layout ainda varia, apenas com uma qualidade de base melhor.
Como garantir que os dados do curso certo sejam atribuídos ao aluno certo?
Três salvaguardas. Primeiro, a convenção de nomenclatura dos arquivos (SOBRENOME_NOME_ESCOLA.pdf) incorpora a identidade do aluno em cada arquivo de origem. Segundo, cada linha de extração herda o nome do arquivo de origem, criando um rastreamento persistente. Terceiro, extraia Nome do Aluno e Escola como colunas explícitas e faça a referência cruzada com seu banco de dados de candidatos antes de mesclar no banco de dados final de admissões. Se o nome extraído de uma linha não corresponder a nenhum aluno matriculado, ou se um histórico escolar referenciar uma escola não listada na inscrição do aluno, sinalize — é um erro de entrada no sistema ou um aluno que enviou documentos de várias instituições.
O mesmo pipeline de lote pode processar históricos de alunos transferidos junto com os de calouros?
Tecnicamente sim, mas logisticamente é melhor separá-los. Históricos de transferência contêm disciplinas de nível superior com códigos, créditos e cadeias de pré-requisitos que exigem um processo de avaliação de aproveitamento diferente dos históricos do ensino médio. Processá-los no mesmo pipeline com as mesmas definições de colunas produzirá linhas aparentemente corretas, mas que exigirão nova revisão durante o mapeamento de aproveitamento — momento em que o tempo economizado ao combinar lotes é perdido. Execute históricos de calouros e transferidos como projetos de lote separados, com conjuntos de colunas diferentes otimizados para cada tipo de documento.
O que muda quando você para de digitar e começa a processar
A mudança da entrada manual para o processamento em lote altera mais do que a velocidade. Altera o que sua equipe de admissões realmente faz com seu tempo durante o período de pico no verão.
Um funcionário que antes passava 167 horas digitando nomes de disciplinas no SIS agora dedica essas horas à avaliação e ao aproveitamento — revisando linhas de exceção, mapeando equivalências de disciplinas e verificando se os GPAs extraídos em escalas não padronizadas são ponderados corretamente em relação aos limites de bolsas de estudo. Esse é o trabalho que exige conhecimento institucional e julgamento humano, e é o trabalho que a entrada manual empurrava para setembro, após a orientação, quando as correções são mais difíceis de fazer.
O processamento em lote não elimina a revisão humana — ele a move para o lugar certo no pipeline: depois que os dados são estruturados, mas antes de entrarem no registro permanente. O resultado é um banco de dados onde cada linha é rastreável até um arquivo de origem, cada exceção é registrada com uma resolução e cada GPA é anotado com sua escala original — o tipo de trilha de auditoria que a entrada manual, por sua natureza, nunca poderia produzir.
Para uma universidade de médio porte processando 500 históricos de calouros, essa diferença é a distância entre um verão gasto com entrada de dados e um verão gasto com a prontidão do aluno. Comece com um único lote — uma pasta de origem, 50 históricos e o conjunto de colunas definido na Etapa 3 acima. Veja quantas linhas passam limpas e quanto tempo sua fila de exceções leva para ser resolvida. Esse teste piloto lhe dirá mais sobre a prontidão para lote da sua instituição do que qualquer gráfico de comparação de recursos.
Processe Históricos de Alunos em Lote em Um Único Banco de Dados
Defina suas colunas uma vez, carregue seus históricos e obtenha um banco de dados de admissões mesclado — sem entrada manual de dados.
Começar a Processar