200 Currículums, Una Base de Datos de Candidatos:
Cómo Filtrar Sin Copiar y Pegar
El informe de CNBC sobre el ciclo de contratación de 2025 encontró que una vacante popular puede recibir de 300 a 500 solicitudes en tres días — y más de mil durante un fin de semana — mientras que los reclutadores dedican de 30 segundos a 2 minutos a cada currículum (CNBC). Nadie discute el volumen de filtrado. Lo que nadie cuantifica es el paso anterior al filtrado: convertir ese montón de PDFs en una hoja de cálculo que realmente puedas ordenar.
Conclusiones Clave
- 200 currículums no son una versión más grande de un problema de un solo currículum — es una categoría de trabajo diferente, y la velocidad de filtrado no es lo que falla.
- De 10 a 20 horas desaparecen en transcripción manual antes de que un solo candidato sea filtrado, consumiendo la mayor parte de los 8 a 9 días que SHRM atribuye al filtrado en un tiempo de cobertura de 39 días.
- Define tus columnas una vez, procesa los 200 archivos en un solo lote y revisa solo las filas marcadas — un reclutador que extrae deja de transcribir y empieza a filtrar.
Qué cambia cuando llegan 200 currículos en lugar de uno
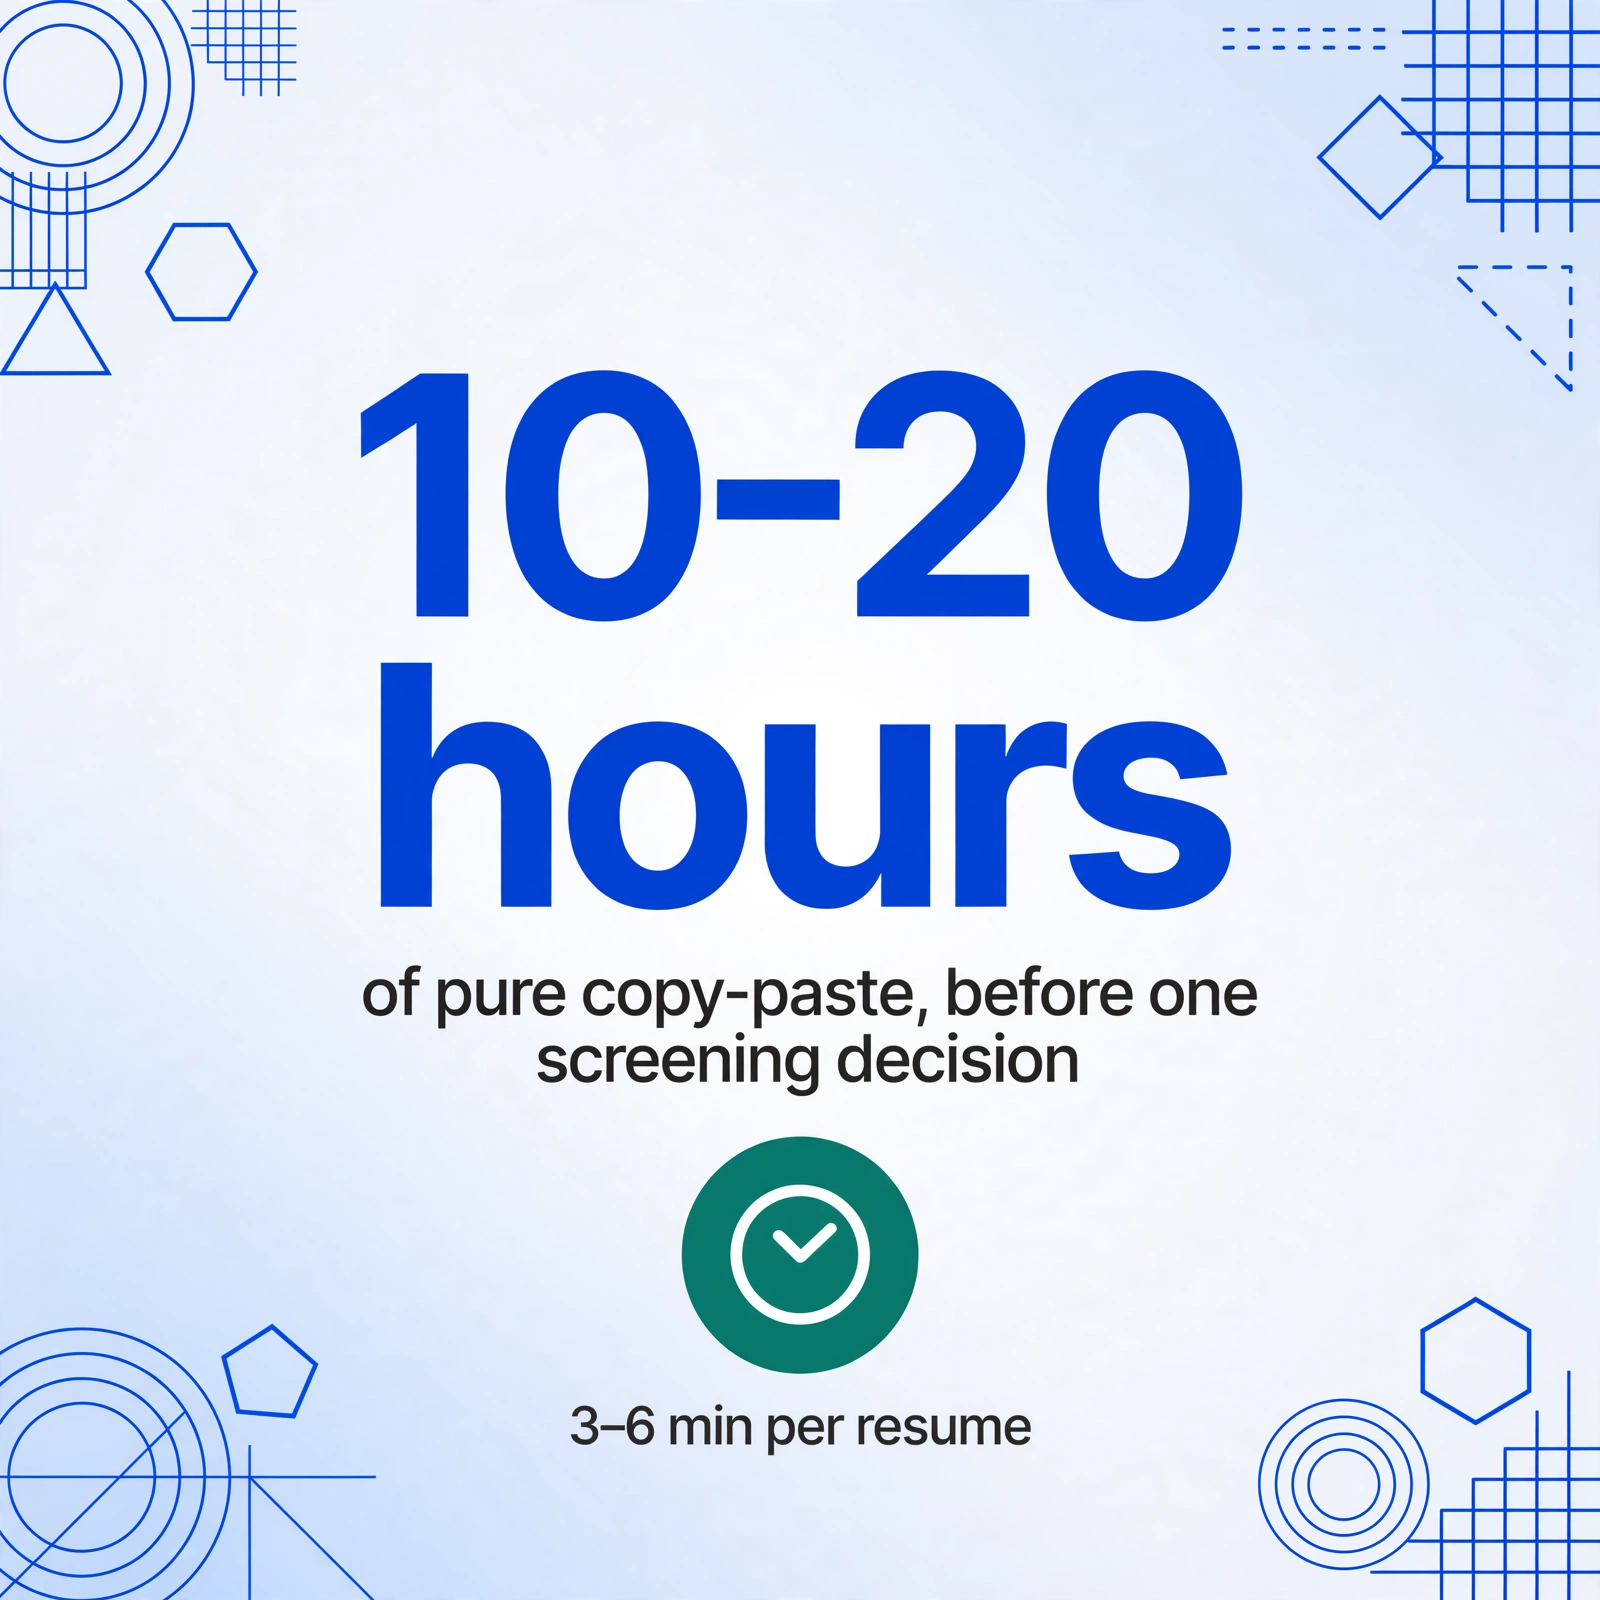
Doscientos currículos no son doscientas veces el trabajo de uno — es una categoría de trabajo diferente. A los 3 a 6 minutos por currículo que cuesta realmente la transcripción manual, un proceso de 200 candidatos suma de 10 a 20 horas de puro copiar y pegar antes de que alguien haya tomado una sola decisión de selección.
Esa matemática es la razón por la que un hilo de r/ResumeExperts describe exactamente la etapa de la que trata este artículo: "pasar de 50 a 200 es exactamente la etapa donde reclutar empieza a sentirse como triaje en lugar de estrategia." Por debajo de 50, tienes el contexto de cada candidato en la cabeza. A los 200, ese contexto desaparece — y tres problemas que eran invisibles en volúmenes pequeños toman el control: archivos que no puedes distinguir, resultados que no se fusionan, y un puñado de currículos que rompen cualquier herramienta que uses.
El volumen de selección no es el cuello de botella que la mayoría de los equipos enfrenta. El cuello de botella es el paso anterior a la selección — construir una tabla estructurada de candidatos a partir de 200 documentos no estructurados — y ese paso es casi completamente manual.
Problema de lotes 1: Archivos llamados "resume.pdf"
En un lote, el nombre del archivo es la única identidad que tiene un documento hasta que lo abres — y la mayoría de los archivos de currículos fueron nombrados por personas que nunca esperaron ser uno entre doscientos.
La realidad es la misma en foros de reclutamiento y hilos de profesionales: archivos que llegan como "Mi CV," "CV actualizado," "CV final final," y — para todos — "resume.pdf." Cuando dos candidatos suben archivos con nombres idénticos a la misma carpeta o a la misma zona de descarga del ATS, uno puede sobrescribir silenciosamente al otro. El candidato cuyo archivo sobrevivió ahora es inidentificable, porque "resume.pdf" no te dice nada sobre a quién pertenece.
La solución no es una campaña de disciplina de nombres dirigida a los solicitantes — perderás esa guerra. La solución es hacer que la identidad de fila reemplace la identidad de nombre de archivo. Cuando procesas un lote con una herramienta que registra una columna Archivo Fuente — una columna automática que registra qué documento produjo cada fila — cada candidato lleva una referencia de vuelta a su archivo original, como se llame. La verificación se convierte en una operación de filtro: ordena por fuente, no un juego de adivinanzas sobre qué "CV.pdf" pertenece a quién.
Para los archivos que controlas, una convención de nombres aún se paga sola: apellido_nombre_fuente (p. ej., chen_mei_linkedin) convierte el nombre del archivo fuente en un rastro de auditoría instantáneo y una pista de deduplicación cuando el mismo candidato aparece desde dos canales.
Problema de lote 2: 200 archivos, una tabla
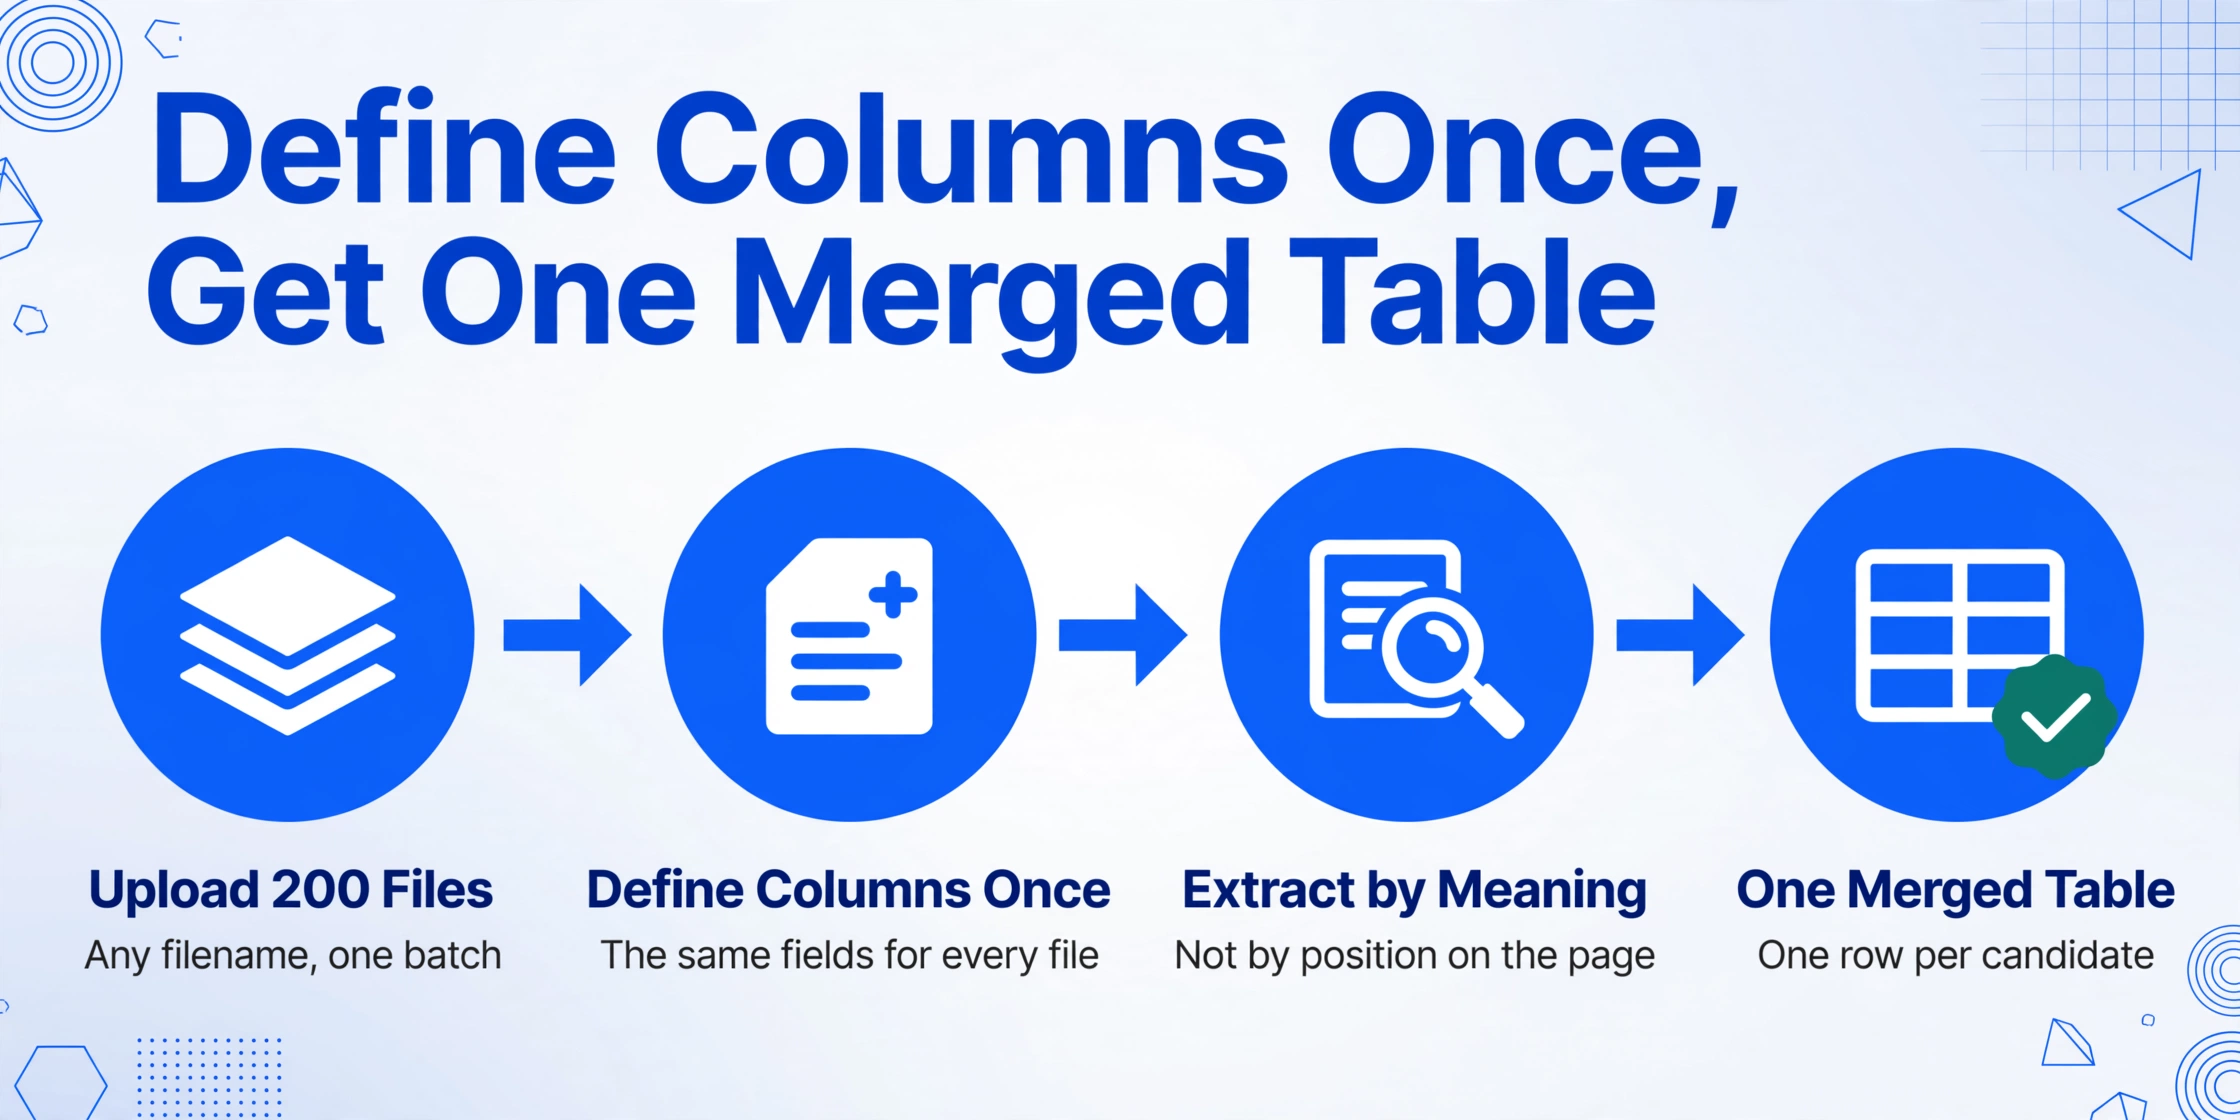
Extrae 200 currículums uno a la vez y obtendrás 200 resultados separados — 200 archivos, 200 respuestas de chat, 200 pestañas — y la tarea de fusionarlos a mano recrea exactamente la carga de entrada de datos que intentabas evitar.
La salida es un proceso donde tus definiciones de columnas se definen una vez y se aplican a cada archivo. Con Custom Column Extraction — el mecanismo central de ImageToTable.ai donde escribes los nombres de los campos que deseas y la IA localiza cada valor comprendiendo su significado en lugar de su posición en la página — defines "Nombre completo, Correo electrónico, Cargo actual, Empresa actual, Años de experiencia, Habilidades principales" una vez, subes los 200 archivos juntos y recibes una tabla fusionada donde cada currículum contribuye con una fila.
Dos tipos de columnas hacen que una base de datos de candidatos sea más útil que una transcripción en bruto. Las columnas inferidas permiten que la IA complete datos que no están escritos literalmente en el currículum: una columna "Fuente" que etiqueta cada fila como LinkedIn, referencia o bolsa de trabajo según dónde la recopilaste, o una columna "Años de experiencia" derivada de las fechas en el historial laboral. Las columnas calculadas van un paso más allá y ejecutan cálculos durante la extracción — una columna "Período de preaviso (Fecha objetivo − Fecha disponible)" que resuelve las operaciones de fechas antes de que los datos lleguen a tu hoja de cálculo.
Este es el mecanismo exacto que escala de un currículum a doscientos, porque las definiciones de columnas no cambian con el volumen. La demostración a continuación se ejecuta sin una plantilla preestablecida — los currículums no comparten un formato común, así que defines las columnas que necesitas y la IA las encuentra en cualquier currículum que subas. Las mismas definiciones de columnas cubren el lado en papel del embudo — el flujo de trabajo de formulario de solicitud de empleo a Excel lee el historial laboral, la educación y las referencias de las solicitudes escaneadas en esa misma tabla fusionada.
Los archivos se procesan de forma segura y no se almacenan.
Si eres nuevo en los detalles campo por campo (qué columnas importan, cómo manejar los datos de candidatos de forma responsable y dónde fallan las herramientas tipo parser), nuestra guía paso a paso para extraer datos de currículums a Excel cubre en profundidad el flujo de archivo único, la lista de campos y el aspecto de cumplimiento.
Problema de lote 3: el 5 % que rompe un parser
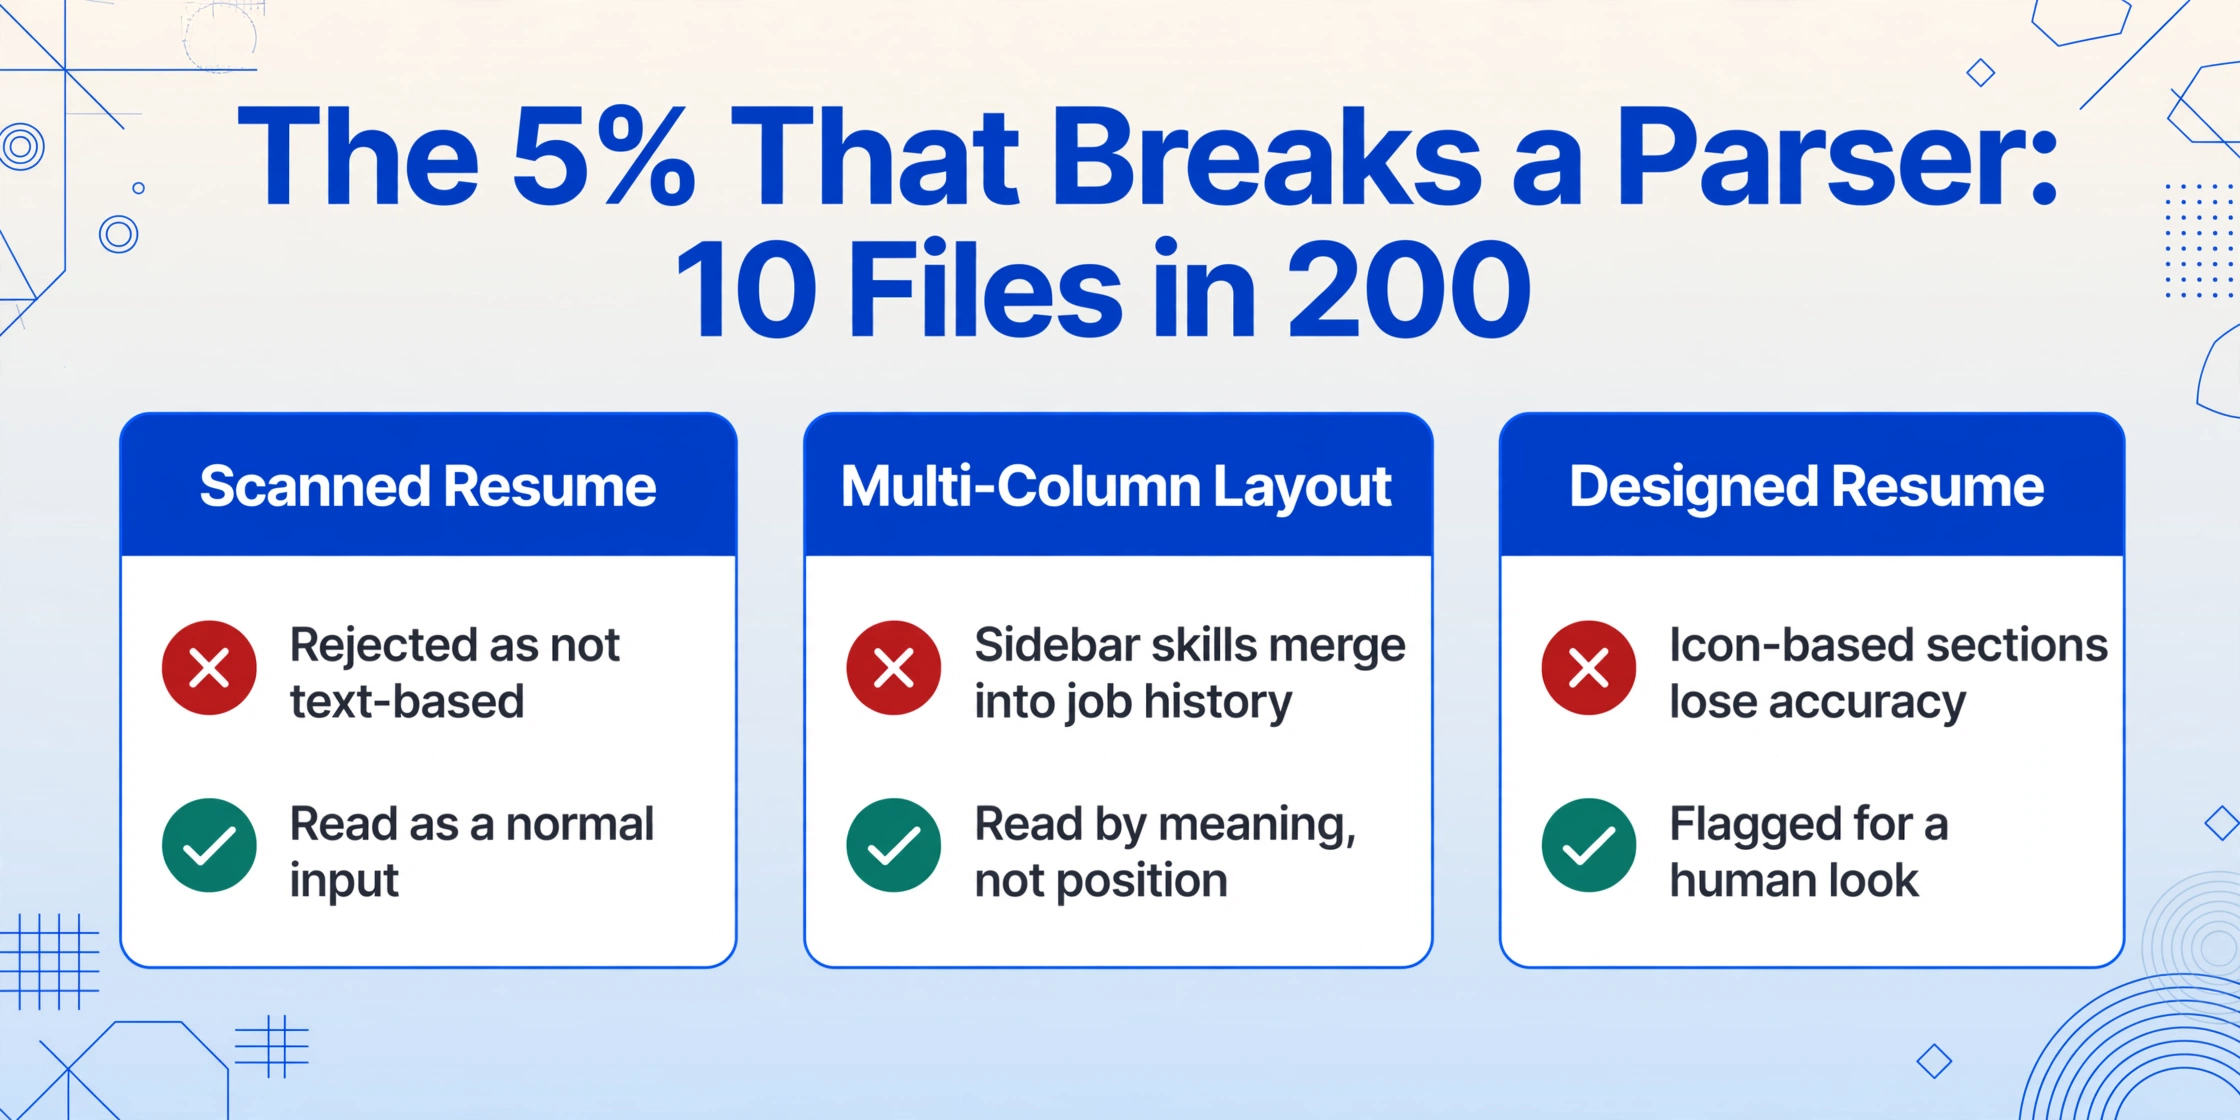
Incluso una tasa de excepciones del 5 % en un lote de 200 currículums significa 10 archivos que requieren manejo manual, y en un flujo por lotes, esos 10 son exactamente donde se estanca todo el proceso.
La excepción más común es el currículum escaneado o basado en imágenes. La documentación de importación masiva de Breezy HR indica que los currículums subidos deben ser documentos basados en texto (DOCX, TXT, RTF, ODT o PDF), "no copias escaneadas, imágenes ni PDF basados en imágenes", los cuales rechaza directamente (documentación de Breezy HR). Un ATS que no puede ingerir una foto de un currículum es una limitación real para puestos donde los candidatos aplican legítimamente desde el teléfono. Un motor de extracción basado en visión, por el contrario, lee los píxeles igual que una persona lee el documento: un currículum fotografiado o escaneado es una entrada normal, no una excepción.
Otras dos clases de excepciones aparecen en todo lote grande: PDFs cifrados o protegidos con contraseña (comunes cuando los candidatos aplican por canales de correo seguros) y diseños de varias columnas o muy maquetados que desordenan a los parsers basados en posición al fusionar las habilidades de la barra lateral con el historial laboral. La extracción semántica evita ambos problemas leyendo el significado, no las coordenadas, aunque los currículums de diseñadores gráficos muy estilizados con secciones basadas en iconos pueden seguir produciendo menor confianza en campos concretos, y esos realmente necesitan una revisión humana.
La forma segura para lotes de manejar excepciones es el Modo de revisión con verificación Bbox: pasa el cursor o haz clic en cualquier celda extraída y la herramienta resalta exactamente de dónde proviene ese valor en el currículum original, y a la inversa, haz clic en una región de la imagen y salta a su celda de tabla. En lugar de auditar las 200 filas, revisas el puñado que la IA marcó como incierto y confirmas cada una contra el archivo original en segundos. Con la precisión del 99 % en texto impreso que nuestro motor de extracción alcanza en pruebas, un lote de 200 currículums produce un número pequeño de filas que vale la pena revisar, no una auditoría de 10 horas.
El principio de manejo de excepciones que escala: no detengas el lote por un archivo malo y tampoco lo omitas en silencio. Procesa todo, marca los campos inciertos y envía solo esas filas a revisión humana. Esa es la diferencia entre una auditoría de 10 horas y una comprobación de 15 minutos.
Lo que 10 horas de copiar y pegar hacen con tu tiempo de contratación
El tiempo de contratación es donde la creación manual de candidatos deja de ser una pequeña ineficiencia y se convierte en una métrica de reclutamiento que no puedes alcanzar.
El informe de referencia de ejecutivos de reclutamiento de SHRM 2026 sitúa el tiempo medio de contratación para puestos no ejecutivos en 39 días — frente a los 44 del año anterior — y atribuye parte de esa mejora a la adopción de herramientas de IA; solo el cribado consume aproximadamente de 8 a 9 de esos días (Referencia de reclutamiento de SHRM). Las 10 a 20 horas de transcripción manual de un solo lote de 200 currículos se sitúan justo dentro de esa ventana de cribado, y es pura sobrecarga: no implica criterio, solo mover texto de PDF a celdas.
El informe de CNBC añade la segunda dimensión: más de uno de cada cinco profesionales de RR. HH. en EE. UU. dedica de 3 a 5 horas al día solo a revisar solicitudes. Cuando un reclutador ya consume un tercio del día en la revisión de solicitudes, las horas dedicadas a crear la tabla primero no son un error de redondeo. Son la diferencia entre un reclutador que criba y un reclutador que transcribe.
La creación manual de candidatos no solo se siente lenta — infla directamente los 8-9 días que SHRM atribuye al cribado, porque cada hora dedicada a copiar currículos en una hoja de cálculo es una hora que no se dedica a avanzar candidatos a la entrevista.
Tu ATS puede importar lo que has creado
La hoja de cálculo que creas es exactamente el archivo de importación que tu ATS espera — no necesitas que el parser propio del ATS toque ni un solo currículo.
La importación masiva de candidatos de Greenhouse acepta hasta 8,000 filas por carga desde una hoja de cálculo, con la salvedad de que un zip de currículos subido solo se adjunta a filas donde se puede analizar un correo electrónico coincidente (Documentación de Greenhouse). La importación personalizada de Bullhorn toma 1,000 registros por lote en CSV. El EIB de Workday tiene un límite de carga de 30MB y sin adjuntos. Todos comparten la misma forma: importan una tabla de candidatos y esperan que la proporciones — con una fila por candidato y un correo electrónico correcto en cada fila.
Primero extrae, luego importa. Cuando extraes por lotes a Excel con las columnas que tu ATS requiere — incluida una columna de correo electrónico correctamente completada, que la extracción debe verificar — el archivo exportado es el archivo de importación. Una sola exportación lleva toda tu base de datos de 200 candidatos a Greenhouse, Lever, Workday, iCIMS o BambooHR sin que sus parsers integrados vean nunca un PDF. Este es también el enfoque en torno al que está construido nuestro flujo de trabajo de extracción de datos de currículos a Excel: un archivo estructurado y limpio, listo tanto para tu hoja de cribado como para tu ATS.
El cribado no se detiene en el currículo: una pasada de verificación de antecedentes a Excel añade los resultados de verificación penal, laboral y educativa de cada candidato como sus propias columnas en esa misma fila.
Preguntas Frecuentes
¿Puedo procesar por lotes currículums escaneados o solo con imágenes?
Sí: un motor de extracción basado en visión lee currículums fotografiados y escaneados como entrada normal, a diferencia de muchas funciones de carga masiva de ATS que rechazan documentos basados en imágenes (la documentación de Breezy HR, por ejemplo, indica que las cargas masivas deben ser de texto). La calidad del escaneo sigue importando: los escaneos claros se extraen limpiamente, mientras que las fotos muy borrosas o inclinadas producen campos de menor confianza que se marcan para revisión en lugar de completarse silenciosamente.
¿Qué columnas debo definir para una base de datos de candidatos?
Un conjunto básico práctico para una hoja de cálculo de selección: Nombre completo, Correo electrónico, Teléfono, Puesto actual, Empresa actual, Años de experiencia, Principales habilidades, Ubicación, Educación y Fuente (de dónde proviene el candidato). Agrega una columna de Archivo de origen para trazabilidad, además de columnas inferidas o calculadas como Años de experiencia o Período de preaviso si tus decisiones de contratación dependen de ellas. Extrae solo lo que tu proceso utiliza: una base de datos de candidatos es para filtrar y comparar, no para archivar cada línea del historial laboral.
¿Cuánto tarda realmente un lote de 200 currículums?
Cada currículum tarda aproximadamente de 5 a 10 segundos de procesamiento de IA, por lo que un lote de 200 archivos se completa en unos 20 a 35 minutos, tiempo que no tienes que dedicar a nada. El tiempo de revisión depende de cuántos campos se marquen; con las tasas de precisión que alcanzan los modelos de visión en currículums impresos limpios, espera un pequeño puñado de filas que valga la pena revisar, no una auditoría completa. Compáralo con las 10 a 20 horas de transcripción manual para el mismo volumen.
¿Cómo sé qué fila proviene de qué currículum?
Las exportaciones por lotes incluyen una columna automática de Archivo de origen que registra el nombre de archivo de cada documento de origen, por lo que cada fila hace referencia a su archivo fuente incluso si el archivo se llamaba "resume.pdf". Para mayor trazabilidad, renombra los archivos que controlas con una convención apellido_nombre_fuente antes de subirlos: el nombre de archivo pasa a formar parte del registro de auditoría y ayuda a detectar candidatos duplicados de múltiples canales.
¿Puedo importar los resultados a Greenhouse, Lever o Workday?
Sí. Primero extrae a una hoja de cálculo limpia y luego usa la importación estándar de candidatos de cada plataforma: importación masiva de Greenhouse (hasta 8,000 filas por carga, requiere un correo coincidente en cada fila), importación personalizada de Bullhorn (1,000 registros por lote, CSV) o Workday EIB (límite de 30MB). Como el archivo extraído ya tiene una fila por candidato con una columna de correo verificado, se importa limpiamente — y te saltas por completo el analizador de currículums integrado de cada plataforma.
¿En qué se diferencia la extracción por lotes de una API de análisis de currículums?
Las APIs de análisis de currículums (Textkernel, RChilli, Affinda, Daxtra) están entrenadas con un esquema fijo de currículum, cobran por documento y devuelven JSON estructurado que luego tienes que integrar. La extracción por lotes lee cualquier documento según las columnas que definas, no tiene una tarifa por archivo ligada a un esquema de currículum y genera directamente una hoja de cálculo que puedes abrir, filtrar e importar a un ATS. Si tu equipo maneja más que currículums — cartas de oferta, formularios de incorporación, contratos — un solo flujo de extracción cubre todos, por eso el mismo enfoque por lotes se extiende naturalmente a una base de datos de documentos de empleados.
Un montón de 200 currículums no es una versión más grande de un problema de un currículum — es una categoría diferente de problema, y se resuelve con nombres, fusión y gestión de excepciones en lugar de más escritura. La base de datos de candidatos que construyes es la base sobre la que se apoya cada decisión de selección; la pregunta es si la construyes a mano o una sola vez.
Pruébalo con tu propio montón de currículums