Compartir un lote de documentos entre un equipo suena simple
Luego dos personas procesan la misma factura
El modo de falla de un lote de documentos compartido no es la velocidad. Cuando un puñado de personas divide un lote de facturas, contratos o informes de gastos, los dos fallos que aparecen son el mismo documento procesado dos veces y un documento que nadie recogió. El Auditor del Estado de Washington, cuya oficina audita agencias públicas, sitúa la proporción de pagos totales que son duplicados o erróneos entre el 0.8 por ciento y el 2 por ciento, y su guía nombra la causa con claridad: cuando diferentes miembros del personal introducen facturas por separado, pueden acabar introduciendo la misma factura personas distintas (Auditor del Estado de WA, 2022).
Conclusiones clave
- El 0.8 al 2 por ciento de los pagos son duplicados o erróneos, y la causa suele ser que dos personas introducen la misma factura.
- Los duplicados y las brechas son la misma enfermedad, porque el lote no tiene un propietario por elemento y su estado es una suposición compartida en lugar de un registro.
- Un espacio de trabajo compartido más un estado consultable convierten la cobertura en un cálculo, donde cada elemento del roster sin estado finalizado es un elemento sin propietario.
El verdadero fracaso es la cobertura, no el rendimiento
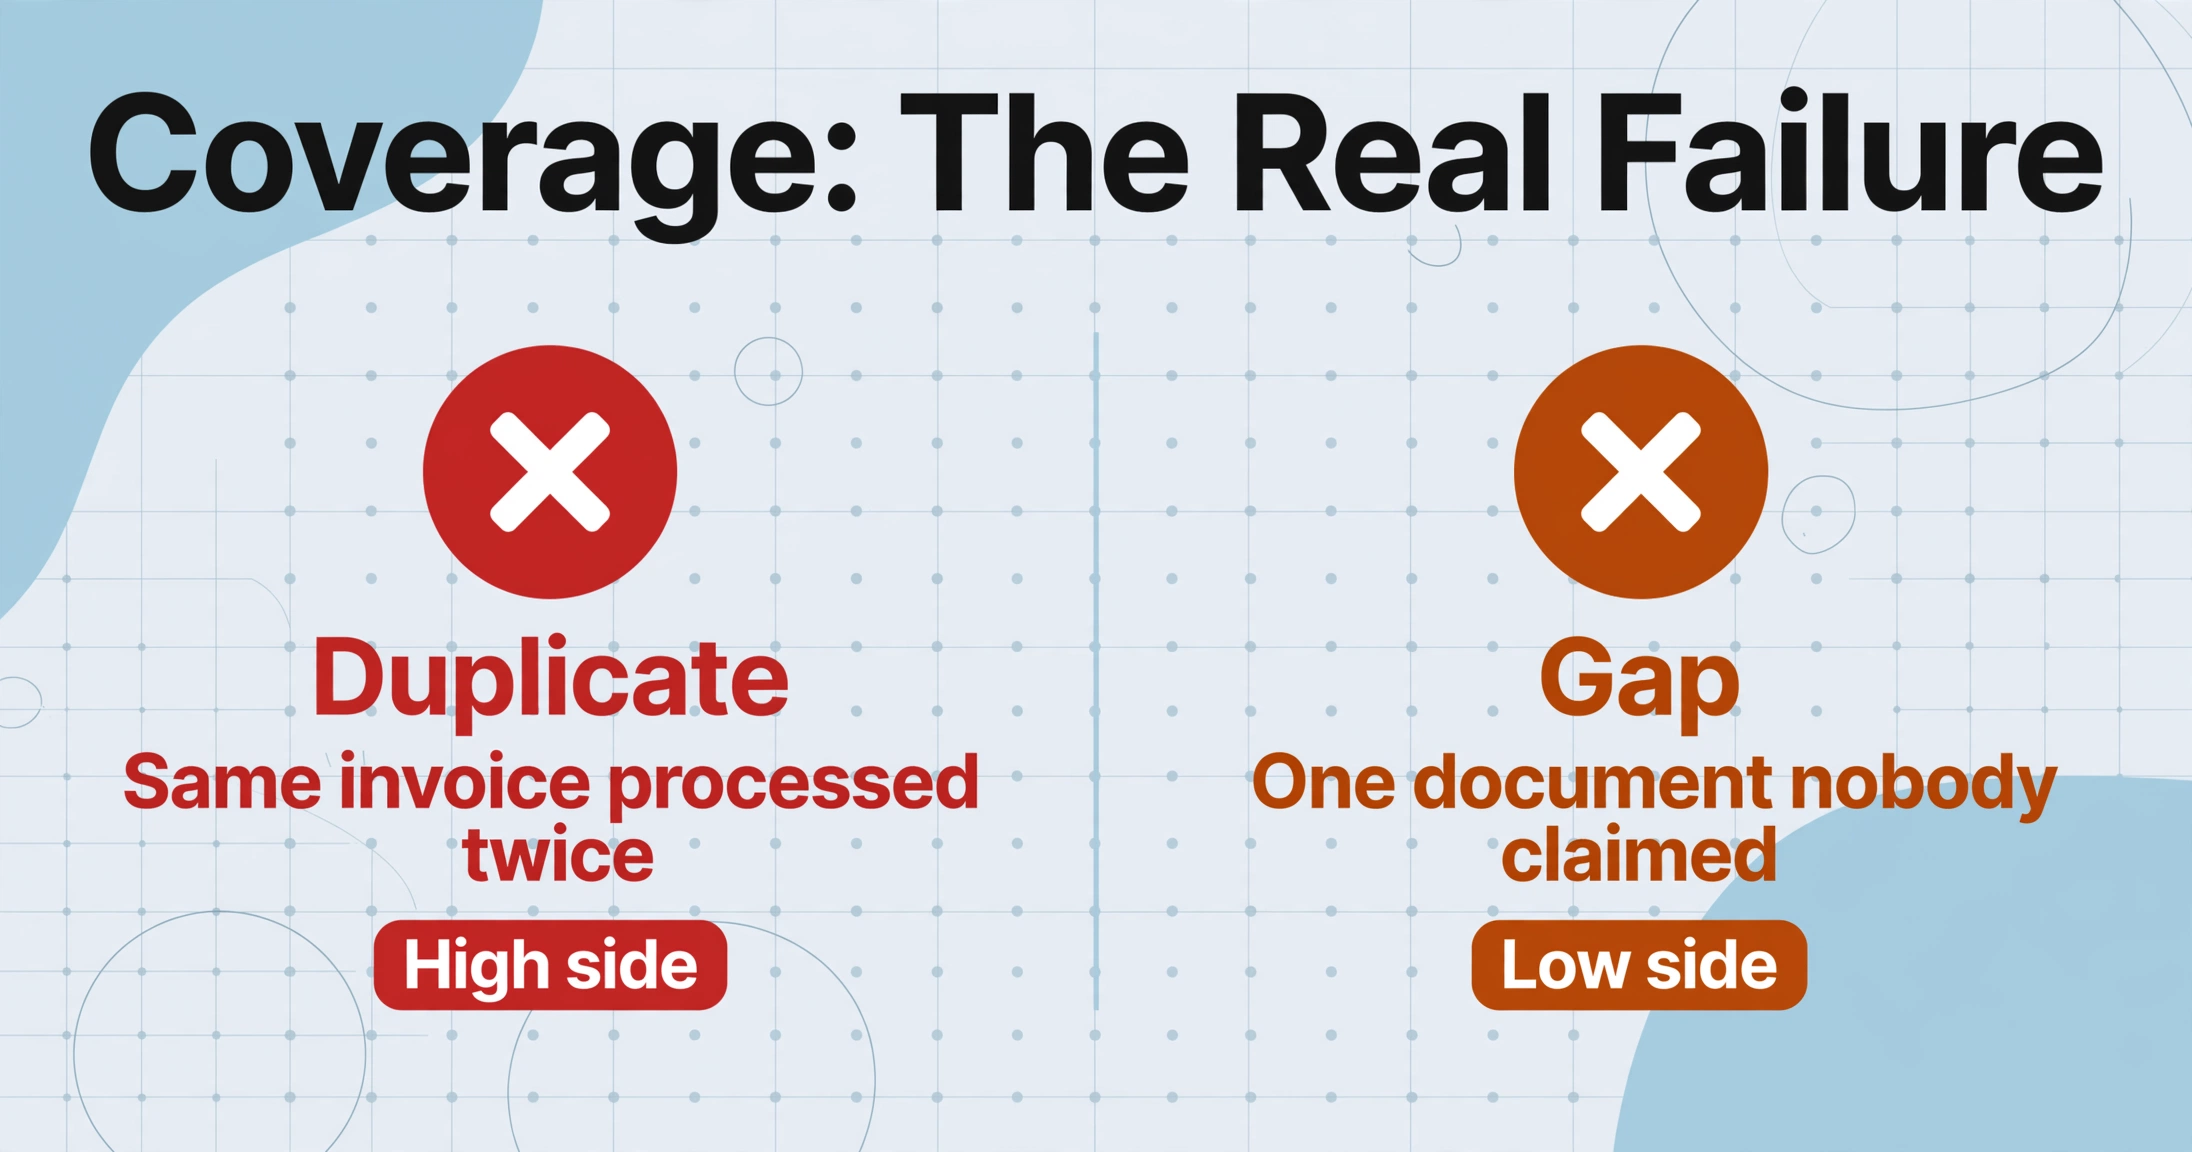
La cobertura es la propiedad de que cada documento de un lote se procese exactamente una vez. Un duplicado es un fallo de cobertura por el lado alto: la misma factura procesada por dos personas, extraída dos veces, exportada en el lote dos veces. Una brecha es un fallo de cobertura por el lado bajo: un documento del lote que nadie reclamó, descubierto solo a fin de mes cuando el estado de cuenta del proveedor no coincide. Ambos generan retrabajo y ambos son la misma enfermedad.
Las personas dentro de esos equipos describen el resultado sin dramatismo. Un usuario de r/QuickBooks que gestiona cuentas por pagar para una empresa mediana escribió: "tuvimos una situación en la que la misma factura de proveedor se pagó dos veces" (r/QuickBooks, 2025). En r/Accounting, alguien cuyo trabajo en su firma se estaba desmoronando describió el lado bajo: "Cada vez se revelan más problemas y los clientes se están cayendo por las grietas" (r/Accounting, 2025).
Un lote de documentos es una cola donde cada elemento necesita exactamente un propietario y un estado de finalización registrado. Ese es todo el problema. El rendimiento se puede resolver con herramientas más rápidas. La cobertura no, porque nada la está resolviendo.
Quién toca un lote compartido y dónde vive realmente el "terminado"
Un lote dividido involucra tres roles distintos, y cada uno tiene una relación diferente con la cola.
| Rol | Qué hace realmente | Qué posee |
|---|---|---|
| Dueño del lote | Define el contrato de salida (qué columnas debe producir cada documento procesado), divide el lote, verifica la finalización, es dueño de la fecha límite | La lista maestra de lo que contiene el lote, generalmente una carpeta compartida o una hoja de cálculo |
| Procesadores | Reclaman una parte del lote, suben cada documento, revisan los datos extraídos, confirman que está terminado | Su pila local de "terminados" y el hilo de chat compartido donde anuncian el progreso |
| Revisor | Detecta excepciones, resuelve elementos que dos personas tocaron, verifica una muestra antes de la exportación | Un criterio sobre la confianza en el lote, formado preguntando a las personas en lugar de consultar un sistema |
Un ritmo saludable se ve así: el dueño divide según una regla documentada (los primeros cincuenta por orden de llegada, un proveedor por persona, una región por persona), cada procesador trabaja su parte, y antes de la fecha límite el revisor comprueba que cada elemento de la lista maestra tenga un estado final. La mecánica es simple. Lo que hace o rompe el ritmo es la segunda pregunta: ¿dónde vive realmente "terminado"?
En este momento, para la mayoría de los equipos, vive en dos lugares que no se pueden conciliar. Vive en la memoria del dueño del lote como un recuento acumulado, y vive en el hilo de chat como una serie de mensajes como "tomé el lote del proveedor Met" y "terminado con el conjunto 3." Ninguno es un registro que se pueda consultar a las 11 p.m. la noche anterior al cierre. La carpeta compartida muestra los archivos tal como se subieron, no como se procesaron. El rastreador de tareas muestra las asignaciones que el dueño escribió, no los documentos que los procesadores realmente terminaron.
Por qué el mismo documento se procesa dos veces y otro se pasa por alto
Ambos fallos provienen de una misma decisión de diseño: el lote no tiene propiedad por elemento, y su estado es una suposición compartida en lugar de un registro.
El duplicado ocurre por una condición de carrera. Dos procesadores revisan la misma carpeta compartida casi al mismo tiempo, ambos ven la misma factura sin una señal evidente de trabajo, ambos deciden tomarla y ambos la procesan. Cada uno estableció el estado de "yo haré esto" en su propia mente antes de que cualquiera lo registrara en un lugar verificable. Para cuando un sistema podría haber señalado el conflicto, el trabajo ya está hecho dos veces.
La brecha ocurre por la imagen especular. Cada procesador asume que un documento pertenece a otra persona. El propietario asume que alguien lo notó. Nada señala los elementos no reclamados, por lo que el lote se declara terminado cuando se completa la última parte asignada, no cuando se completa el último elemento del lote. Un usuario en r/Accounting que describía el caos de la recepción de documentos expresó el estado subyacente: "Los clientes envían las cosas por partes, una factura aquí, un contrato allá, un documento fiscal en un correo de hace tres semanas, y todo se vuelve caótico rápidamente" (r/Accounting, 2025).
Las herramientas que los equipos utilizan no rompen el ciclo, porque cada una tiene una mitad diferente de la imagen. Asana, Monday.com y Jira son registros a nivel de tareas: asignan tareas y plazos, pero nunca ven el estado de los documentos dentro del lote, por lo que "tarea completada" no le dice nada sobre el archivo. La capa contable, QuickBooks, Sage Intacct, Xero o NetSuite, es donde llegan los datos terminados, pero responde "¿se facturó esto?", no "¿alguien ha tocado este escaneo?". La herramienta de extracción contiene los documentos y el estado del procesamiento, pero si solo una persona vigila la cola, los demás trabajan de memoria. Dos o tres registros de verdad que nunca se consultan entre sí.
Este es un patrón reconocido en la literatura sobre exactamente este tipo de trabajo administrativo. El Auditor del Estado de Washington llama a la entrada descentralizada "demasiados cocineros en la cocina", donde "diferentes departamentos podrían ingresar la misma factura" y, sin saberlo, eludir los controles del software (Auditor del Estado de WA, 2022). La más reciente Encuesta de Servicios Compartidos Globales de Deloitte encuentra que las organizaciones de servicios compartidos mencionan la mejora de la "propiedad de extremo a extremo" como un objetivo central, porque la ausencia de propiedad es exactamente el fallo que esto describe. La causa raíz no es la falta de IA. Es un proceso donde la asignación y la finalización nunca tuvieron un sistema de registro.
La solución: un espacio de trabajo compartido y un estado que pueda consultar
Dos capacidades de la herramienta de extracción se corresponden con los dos pasos fallidos, y cada una incluye un ajuste específico que hace el trabajo.
El primer paso fallido, "quién puede trabajar este lote y bajo la capacidad de quién", es lo que manejan los espacios de trabajo de equipo. Un espacio de trabajo de equipo es una estructura de cuenta compartida: un plan de equipo cubre a un conjunto de miembros con un límite de miembros configurado, los miembros se unen con un código que comparte el propietario, el plan de equipo establece el lote y la capacidad de procesamiento de forma centralizada, y el trabajo de todos se extrae de un único fondo de créditos compartido. El cambio práctico para un lote dividido es que los cuatro procesadores trabajen los mismos lotes en la misma cuenta. No hay cinco cuentas gratuitas separadas con cinco límites separados, no hay "envíalo a mi cuenta para que cuente contra mi cuota", no hay una persona que actúe como enrutador humano porque solo ella puede ver la cola.
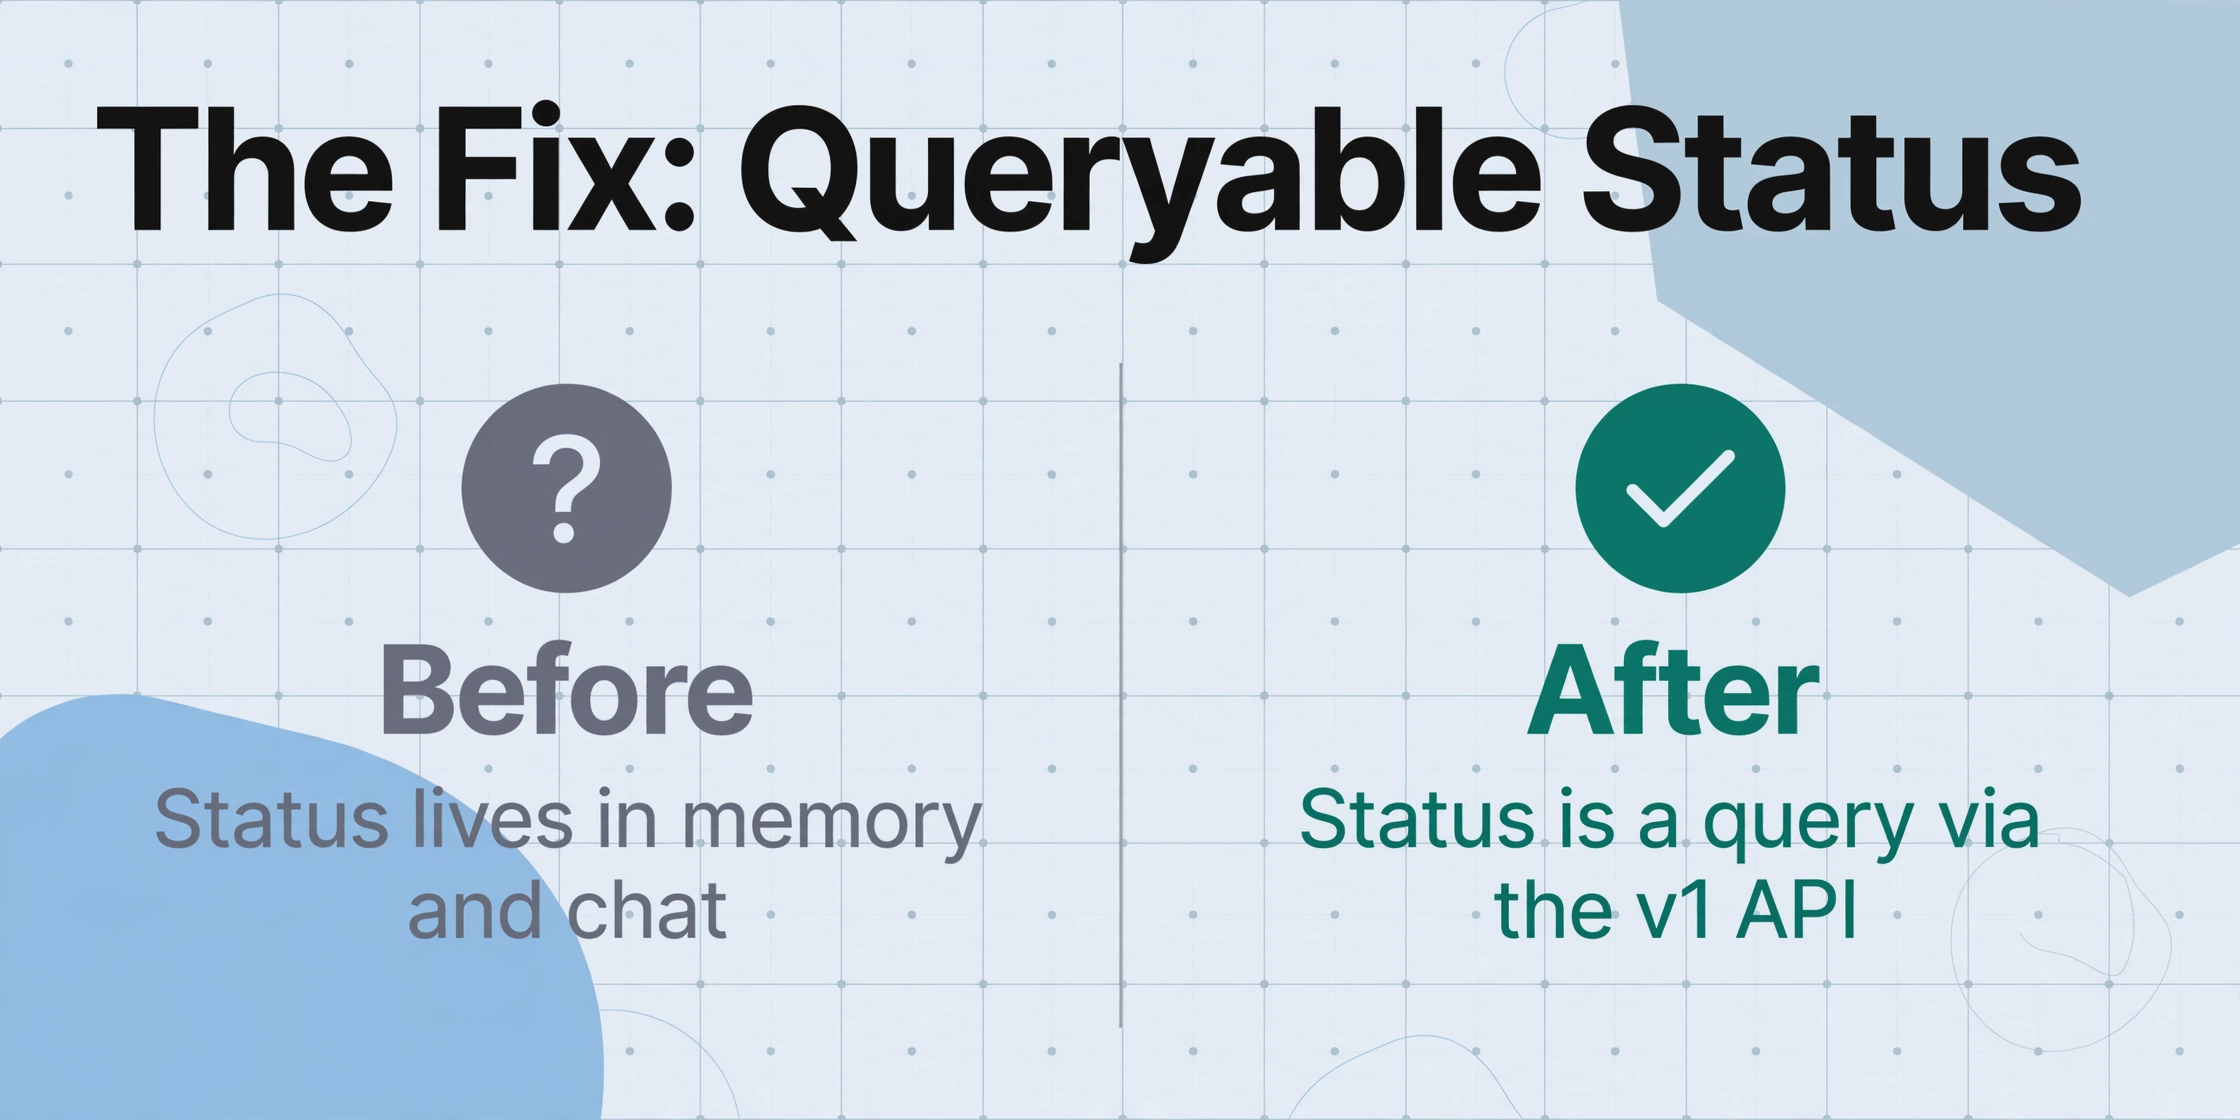
El segundo paso fallido, "dónde vive el estado", es lo que resuelve la API v1. La API v1 es la interfaz REST pública de la herramienta de extracción, documentada en /developers: permite que su propio sistema suba documentos, inicie el procesamiento de lotes, recupere el estado y los resultados de cada documento, y reciba una notificación webhook cuando el procesamiento se complete para que no haya que hacer sondeos. La salida es JSON estructurado, independiente de la aplicación web, y una primera llamada tarda unos cinco minutos en funcionar. Lo que importa para la cobertura es la propiedad que le otorga: el estado de cada elemento se convierte en una consulta en lugar de un recuerdo.
Cuando el roster del lote y el estado de finalización son legibles mediante programación, la cobertura deja de ser una sensación y se convierte en un cálculo: cada elemento del roster sin un estado finalizado es un elemento sin propietario, al minuto.
Configurado con un ritmo real, con un lote de fin de mes de 200 facturas y cuatro procesadores, se ve así:
Los archivos se procesan de forma segura y no se almacenan.
Decidir si la ruta de la API o la interfaz sin código es la adecuada para su lote es una disyuntiva en sí misma: la aplicación web es más rápida de iniciar, la API es más rápida de verificar, y la comparación entre API y sin código y la comparación de herramientas de API analizan ambos lados. Los equipos que desean extraer datos directamente en una herramienta interna comienzan con la ruta de la API de OCR. El flujo de trabajo que describe este artículo, donde los documentos se recopilan de personas externas antes de llegar al lote, se cubre en el flujo de recopilación y extracción de documentos.
Lo que esta configuración aún no puede automatizar
El límite honesto es que hace que la cobertura sea medible; no hace que el juicio sea automático y no asigna la responsabilidad por sí solo.
La persona que posee un elemento en disputa sigue siendo una decisión. Cuando dos procesadores han tocado la misma factura, la API muestra el duplicado en el rastro de estado, pero alguien tiene que decidir qué resultado es el que se envía. Ese es el propietario del lote o el revisor, y ninguna herramienta lo elimina. De manera similar, la calidad de la extracción en un documento difícil es una decisión humana: la herramienta extrae y un revisor decide si el resultado es lo suficientemente bueno para exportar. La consulta de cobertura hace visible la lista no reclamada todos los días, pero alguien aún tiene que ejecutarla o programarla; la herramienta no insiste.
La división en sí misma es tan buena como su responsable. Las porciones asignadas en papel pero nunca conciliadas con el roster reintroducen el problema original, porque el rastreador de tareas y el estado del documento vuelven a ser dos registros que no se comunican. Para los equipos que manejan un volumen demasiado bajo como para justificar una integración de API, un espacio de trabajo compartido sin la API ya elimina la capa de "cinco cuentas separadas", y el mismo patrón de procesamiento por lotes prioritario con un volumen más reducido se cubre en la configuración de extracción para equipos pequeños. Cuando el volumen supera por completo la división manual, el camino es escalar sin agregar personal.
Lo que nada de esto hace es publicar en el libro mayor, ejecutar aprobaciones o enrutar el trabajo a personas individuales dentro de la herramienta. La API es la superficie de enrutamiento: si desea una asignación automática, la construye contra la API. La herramienta proporciona la cola, el estado y la tabla final. El flujo de trabajo que las rodea es suyo, y ese es el punto. Los equipos que tratan el lote como un espacio de trabajo compartido más un estado consultable dejan de gastar su energía de coordinación en "quién recuerda qué está hecho".
Procesamiento por lotes en equipo: preguntas frecuentes
¿Todos los miembros del equipo necesitan su propio plan de pago?
No. El espacio de trabajo de equipo permite que un plan de equipo cubra a varios miembros. Los procesadores se unen con el código compartido, trabajan los mismos lotes en la misma cuenta y utilizan el fondo de créditos compartido del equipo y la capacidad planificada centralmente, de modo que el equipo no compra cinco suscripciones separadas.
¿Cómo sabemos qué documentos están terminados?
A través de la API v1 se consulta el estado de cada documento directamente, y un webhook le notifica cuando se completa el procesamiento de un lote. Los estados finales provienen del registro, no de la memoria, que es toda la diferencia entre cubrir un lote y esperar que esté cubierto.
¿Usar la API requiere un desarrollador?
La API requiere algo de programación para llamarla, ya que devuelve JSON. Una primera solicitud se puede hacer en unos cinco minutos copiando un ejemplo documentado. Los equipos sin desarrollador aún obtienen la mayor parte del beneficio de cobertura con un espacio de trabajo compartido, donde todos ven la misma cola, y pueden dejar la automatización completa de la API para un momento en que se pague por sí sola.
¿Podrían dos personas procesar el mismo archivo?
Sí, si ambas se apresuran al mismo elemento antes de que cualquiera lo registre. La API hace que esa carrera sea rara y visible: el roster y el estado son consultables, por lo que un procesador puede verificar si un elemento está reclamado antes de comenzar, y el rastro de estado muestra cuándo ocurrió un duplicado. No impide que dos personas decidan tomar el mismo elemento con cinco minutos de diferencia, por lo que las porciones asignadas de antemano son el hábito más sólido.
¿Cómo detectamos documentos que nadie recogió?
Ejecute la consulta de cobertura: todo elemento en el roster que no tenga un estado final no está reclamado. Hacerlo a diario, en lugar de esperar que la carpeta esté completa, es lo que convierte "¿todos terminaron?" en una verificación de una línea.
¿A dónde van los datos finales?
Los resultados se devuelven como datos estructurados que puede leer a través de la API o exportar como hoja de cálculo con las columnas que definió el propietario del lote. La exportación se genera en un formato nativo de hoja de cálculo que luego alimenta un sistema de contabilidad o una hoja de conciliación; la herramienta es la capa de extracción, no el libro mayor.
El cambio es una reorientación. Un equipo que coordina de memoria se pregunta cada mes "¿alguien pasó algo por alto?" y espera la respuesta del estado de cuenta del proveedor. Un equipo que trata el estado como una consulta se hace la misma pregunta con una sola lectura y la responde el mismo día. Configure su propio lote en el espacio de trabajo compartido, obtenga el roster a través de la API y compruebe si "quién hizo qué" puede dejar de ser una conversación y convertirse en una columna.