Einen Dokument-Batch im Team zu teilen klingt einfach
Dann verarbeiten zwei Personen dieselbe Rechnung
Der Fehlermodus eines geteilten Dokument-Batches ist nicht die Geschwindigkeit. Wenn mehrere Personen einen Batch aus Rechnungen, Verträgen oder Spesenabrechnungen aufteilen, treten zwei Fehler auf: dasselbe Dokument wird zweimal verarbeitet und ein Dokument wird von niemandem übernommen. Der Washington State Auditor, dessen Büro öffentliche Einrichtungen prüft, beziffert den Anteil doppelter oder fehlerhafter Zahlungen an allen Zahlungen auf 0,8 bis 2 Prozent, und seine Leitlinien benennen die Ursache klar: Wenn verschiedene Mitarbeiter jeweils Rechnungen erfassen, können verschiedene Personen dieselbe Rechnung erfassen (WA State Auditor, 2022).
Wichtigste Erkenntnisse
- 0,8 bis 2 Prozent der Zahlungen sind Duplikate oder fehlerhaft, und die Ursache ist meist, dass zwei Personen dieselbe Rechnung erfassen.
- Duplikate und Lücken sind dieselbe Krankheit, weil der Batch keinen Besitzer pro Element hat und sein Status eine gemeinsame Vermutung statt eines Datensatzes ist.
- Ein Shared Workspace plus ein abfragbarer Status macht die Abdeckung zu einer Berechnung, bei der jedes Roster-Element ohne abgeschlossenen Status ein Element ohne Besitzer ist.
Der eigentliche Fehler ist Coverage, nicht Durchsatz
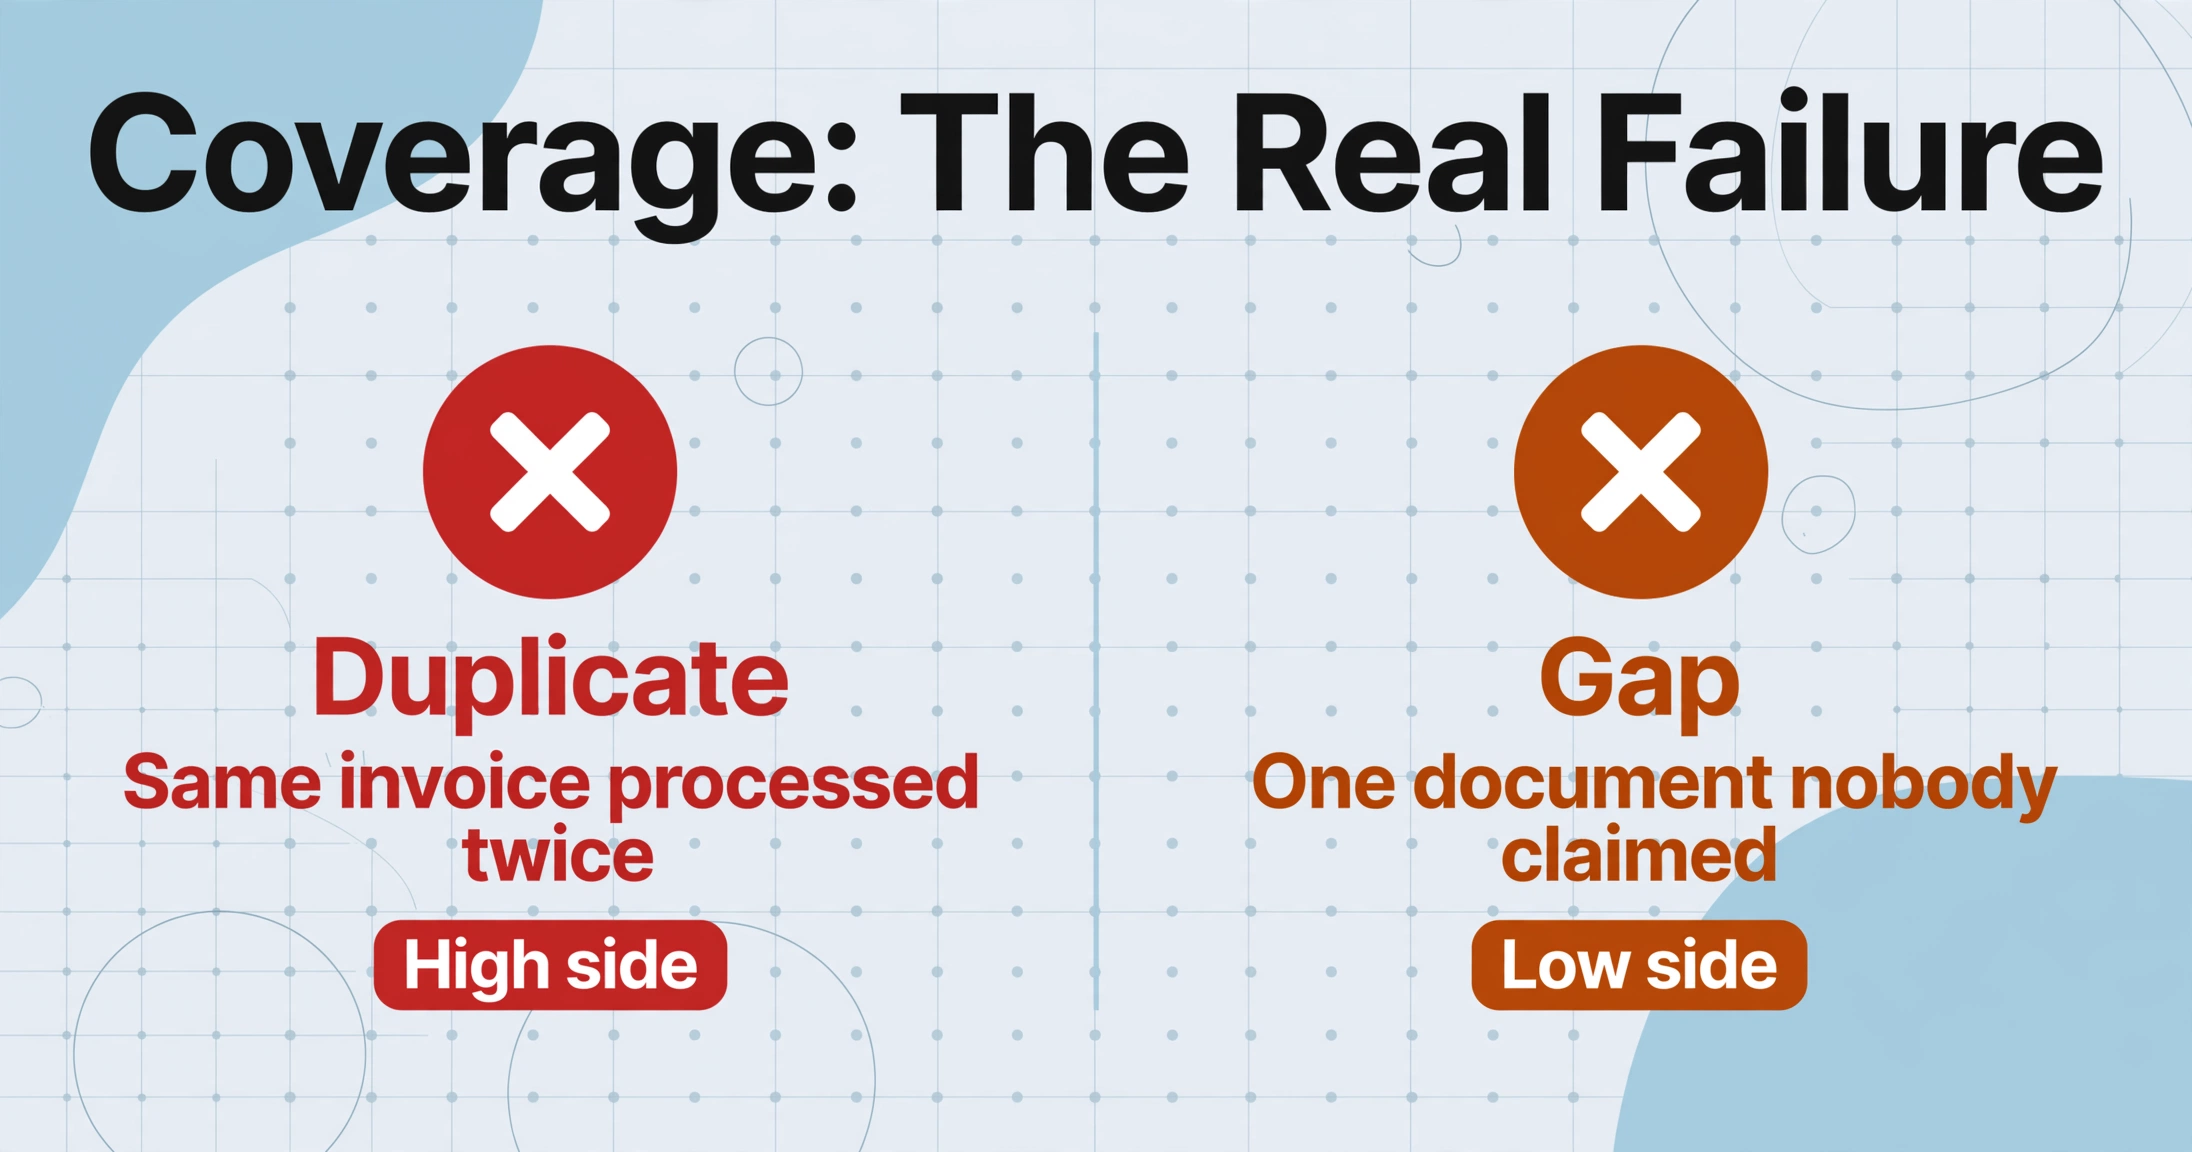
Coverage ist die Eigenschaft, dass jedes Dokument in einem Batch genau einmal verarbeitet wird. Ein Duplikat ist ein Coverage-Fehler auf der oberen Seite: dieselbe Rechnung von zwei Personen verarbeitet, zweimal extrahiert, zweimal im Batch exportiert. Eine Lücke ist ein Coverage-Fehler auf der unteren Seite: ein Dokument im Batch, das niemand übernommen hat, entdeckt erst am Monatsende, wenn der Lieferantenauszug nicht übereinstimmt. Beides erzeugt Nacharbeit, und beides ist dieselbe Krankheit.
Die Personen in diesen Teams beschreiben das Ergebnis ohne Dramatik. Ein Nutzer auf r/QuickBooks, der die Kreditorenbuchhaltung für ein mittelständisches Unternehmen leitet, schrieb: „wir hatten eine Situation, in der dieselbe Lieferantenrechnung zweimal bezahlt wurde" (r/QuickBooks, 2025). Auf r/Accounting beschrieb jemand, dessen Kanzlei auseinanderzufallen drohte, die untere Seite: „Immer mehr Probleme kommen ans Licht, und Mandanten fallen durch die Raster" (r/Accounting, 2025).
Ein Dokumenten-Batch ist eine Warteschlange, in der jedes Element genau einen Besitzer und einen dokumentierten Endstatus benötigt. Das ist das gesamte Problem. Durchsatz lässt sich mit schnelleren Tools beantworten. Coverage nicht, weil nichts darauf antwortet.
Wer einen gemeinsamen Batch bearbeitet – und wo „Erledigt" tatsächlich lebt
Ein aufgeteilter Batch umfasst drei verschiedene Rollen, und jede hat eine andere Beziehung zur Warteschlange.
| Rolle | Was sie tatsächlich tun | Was sie besitzen |
|---|---|---|
| Batch-Besitzer | Definiert den Ausgabe-Vertrag (welche Spalten jedes verarbeitete Dokument erzeugen muss), teilt den Batch auf, prüft die Fertigstellung, verantwortet die Frist | Die Masterliste des Batch-Inhalts, in der Regel ein gemeinsamer Ordner oder eine Tabellenkalkulation |
| Bearbeiter | Übernehmen einen Teil des Batches, laden jedes Dokument hoch, prüfen die extrahierten Daten, bestätigen die Fertigstellung | Ihren lokalen „Erledigt"-Stapel und den gemeinsamen Chat-Thread, in dem sie Fortschritt melden |
| Prüfer | Erkennt Ausnahmen, klärt Positionen, die zwei Personen bearbeitet haben, verifiziert eine Stichprobe vor dem Export | Ein Urteil über das Vertrauen in den Batch, das durch Befragen von Personen statt durch Abfragen eines Systems entsteht |
Ein gesunder Ablauf sieht so aus: Der Besitzer teilt nach einer dokumentierten Regel auf (die ersten fünfzig nach Eingangsreihenfolge, ein Anbieter pro Person, eine Region pro Person), jeder Bearbeiter arbeitet seinen Teil ab, und bis zur Frist prüft der Prüfer, dass jede Position in der Masterliste einen abgeschlossenen Status hat. Die Mechanik ist einfach. Was den Ablauf trägt oder bricht, ist die zweite Frage: Wo lebt „Erledigt" tatsächlich?
Derzeit lebt es bei den meisten Teams an zwei Orten, die nicht in Einklang zu bringen sind. Es lebt im Gedächtnis des Batch-Besitzers als laufende Zählung, und es lebt im Chat-Thread als eine Reihe von Nachrichten wie „Ich habe den Met-Lieferantenstapel übernommen" und „fertig mit Satz 3." Keines davon ist ein Datensatz, der um 23 Uhr am Abend vor dem Abschluss geprüft werden kann. Der gemeinsame Ordner zeigt die Dateien, wie sie hochgeladen wurden, nicht wie sie verarbeitet wurden. Das Aufgaben-Tool zeigt die Zuweisungen, die der Besitzer eingetippt hat, nicht die Dokumente, die die Bearbeiter tatsächlich abgeschlossen haben.
Warum dasselbe Dokument zweimal verarbeitet wird und ein anderes übersehen wird
Beide Fehler haben dieselbe Designentscheidung als Ursache: Der Batch hat keine Besitzzuordnung pro Element, und sein Status ist eine gemeinsame Annahme statt einer Aufzeichnung.
Das Duplikat entsteht durch einen Wettlauf. Zwei Prozessoren prüfen etwa gleichzeitig denselben gemeinsamen Ordner, beide sehen dieselbe Rechnung ohne offensichtliches Zeichen einer Bearbeitung, beide entscheiden sich, sie zu übernehmen, und beide verarbeiten sie. Jeder setzte den Zustand auf „Ich werde das tun" in seinem eigenen Kopf, bevor einer es irgendwo überprüfbar aufzeichnete. Bis ein System den Konflikt hätte kennzeichnen können, ist die Arbeit doppelt erledigt.
Die Lücke entsteht durch das Spiegelbild. Jeder Prozessor nimmt an, dass ein Dokument jemand anderem gehört. Der Besitzer nimmt an, dass jemand es bemerkt hat. Nichts kennzeichnet nicht beanspruchte Elemente, sodass der Batch für abgeschlossen erklärt wird, wenn das letzte zugewiesene Segment fertig ist, nicht wenn das letzte Element im Batch fertig ist. Ein Nutzer auf r/Accounting, der das Aufnahme-Chaos beschreibt, brachte den zugrunde liegenden Zustand auf den Punkt: „Clients senden Dinge stückweise, Rechnung hier, Vertrag dort, Steuerdokument in einer E-Mail von vor drei Wochen, und es wird schnell chaotisch" (r/Accounting, 2025).
Die Tools, zu denen Teams greifen, durchbrechen den Kreislauf nicht, weil jedes eine andere Hälfte des Bildes hält. Asana, Monday.com und Jira sind Aufzeichnungen auf Aufgabenebene: Sie weisen Aufgaben und Fristen zu, sehen aber nie den Zustand der Dokumente im Batch, sodass „Aufgabe erledigt" nichts über die Datei aussagt. Die Buchhaltungsebene, QuickBooks, Sage Intacct, Xero oder NetSuite, ist der Ort, an dem fertige Daten landen, aber sie beantwortet „wurde das abgerechnet", nicht „hat jemand diesen Scan angefasst". Das Extraktionstool hält die Dokumente und den Verarbeitungszustand, aber wenn nur eine Person die Warteschlange überwacht, arbeiten die anderen aus dem Gedächtnis. Zwei oder drei Wahrheitsquellen, die sich nie miteinander abstimmen.
Dies ist ein anerkanntes Muster in der Literatur zu genau dieser Art von Backoffice. Der Washington State Auditor nennt dezentrale Erfassung „zu viele Köche in der Küche", bei der „verschiedene Abteilungen dieselbe Rechnung erfassen könnten" und dabei unwissentlich Softwarekontrollen umgehen (WA State Auditor, 2022). Die neueste Global Business Services Survey von Deloitte zeigt, dass Shared-Services-Organisationen eine verbesserte „End-to-End-Verantwortung" als Kernziel nennen, weil das Fehlen von Verantwortung genau das Versagen ist, das hier beschrieben wird. Die Ursache ist keine fehlende KI. Es ist ein Prozess, in dem Zuweisung und Abschluss nie ein System der Aufzeichnung erhielten.
Die Lösung: Ein gemeinsamer Team Workspace und ein abfragbarer Status
Zwei Funktionen des Extraktionstools entsprechen den beiden fehlerhaften Schritten, und jede davon verfügt über eine spezifische Einstellung, die die Arbeit übernimmt.
Der erste fehlerhafte Schritt – „wer darf diesen Batch bearbeiten und unter wessen Kapazität" – wird von Team Workspaces übernommen. Ein Team Workspace ist eine gemeinsame Kontostruktur: Ein Teamplan umfasst eine Gruppe von Mitgliedern mit einem konfigurierten Mitgliederlimit, Mitglieder treten über einen Code bei, den der Besitzer teilt, der Teamplan legt Batch- und Verarbeitungskapazität zentral fest, und die Arbeit aller Beteiligten wird aus einem gemeinsamen Credit-Pool gespeist. Die praktische Änderung für einen geteilten Batch besteht darin, dass alle vier Bearbeiter dieselben Batches im selben Konto verarbeiten. Es gibt keine fünf separaten kostenlosen Konten mit fünf separaten Limits, kein „schick es an mein Konto, damit es auf mein Kontingent angerechnet wird", keine einzelne Person, die als menschlicher Router fungiert, weil nur sie die Warteschlange sehen kann.
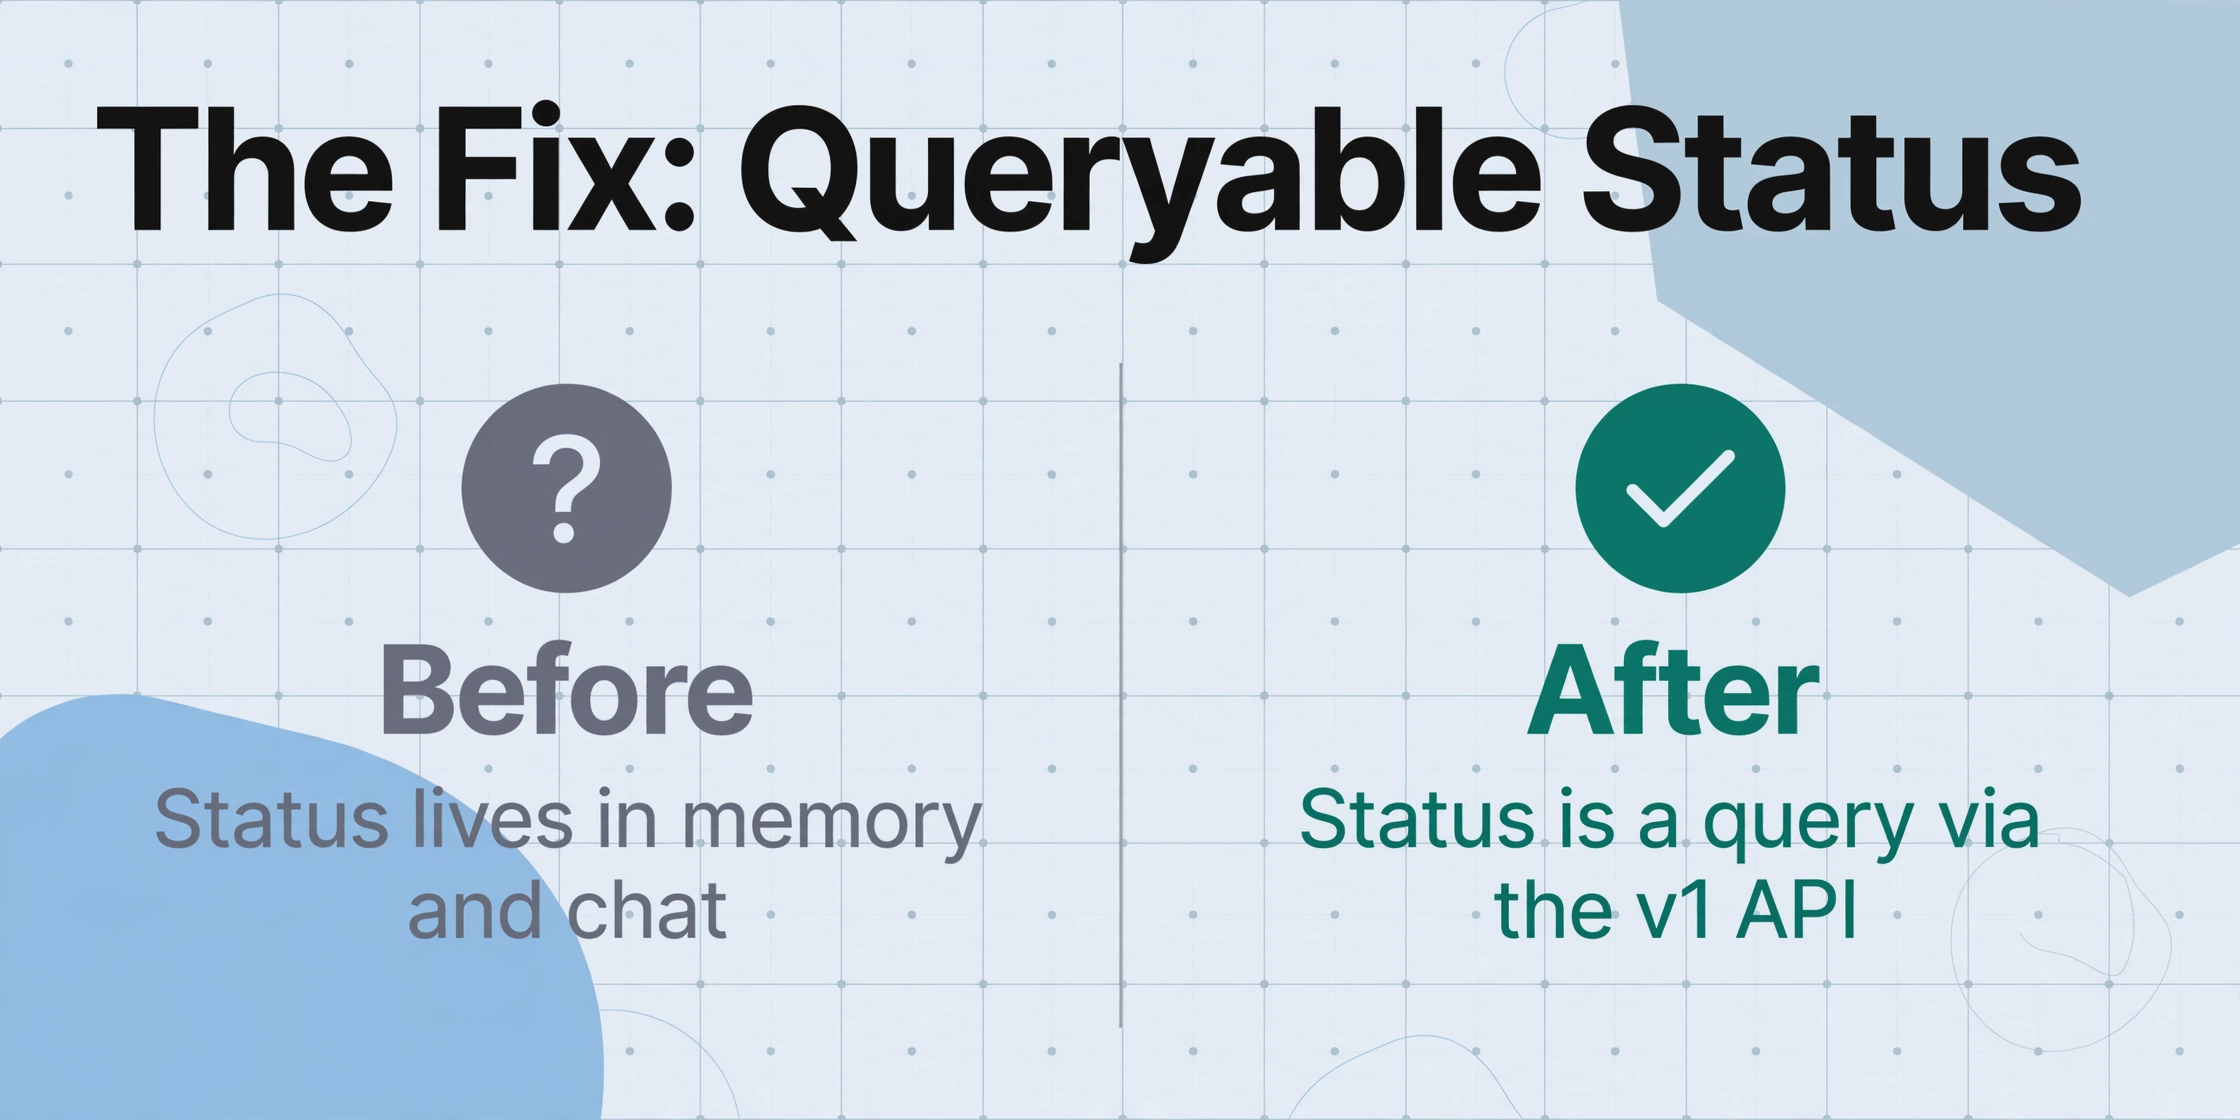
Der zweite fehlerhafte Schritt – „wo lebt der Status" – wird von der v1 API gelöst. Die v1 API ist die öffentliche REST-Schnittstelle des Extraktionstools, dokumentiert unter /developers: Sie ermöglicht es Ihrem eigenen System, Dokumente hochzuladen, Batch-Verarbeitung zu starten, Status und Ergebnisse pro Dokument abzurufen und eine Webhook-Benachrichtigung zu erhalten, wenn die Verarbeitung abgeschlossen ist, sodass nichts abgefragt werden muss. Die Ausgabe ist strukturiertes JSON, unabhängig von der Web-App, und ein erster Aufruf benötigt etwa fünf Minuten, um zum Laufen zu kommen. Was für die Coverage zählt, ist die Eigenschaft, die sie bietet: Der Status pro Element wird zu einer Abfrage statt zu einer Erinnerung.
Wenn die Batch-Roster und der Abschlussstatus beide programmatisch lesbar sind, hört Coverage auf, ein Gefühl zu sein, und wird zu einer Berechnung: Jedes Element im Roster ohne abgeschlossenen Status ist ein Element ohne Besitzer – auf die Minute genau.
Eingerichtet für einen realen Rhythmus, mit einem Monatsend-Batch von 200 Rechnungen und vier Bearbeitern, sieht das so aus:
Dateien werden sicher verarbeitet und nicht gespeichert.
Ob der API-Weg oder die No-Code-Oberfläche für den eigenen Batch die richtige Wahl ist, ist für sich genommen ein Abwägen: Die Web-App ist schneller gestartet, die API ist schneller geprüft, und der Vergleich zwischen API und No-Code sowie der Vergleich der API-Werkzeuge beleuchten beide Seiten. Teams, die Extraktionen direkt in ein internes Tool ziehen möchten, beginnen mit dem OCR-API-Weg. Der in diesem Artikel beschriebene Workflow, bei dem Dokumente von externen Personen gesammelt werden, bevor sie den Batch erreichen, wird im Workflow zur Dokumentsammlung und -extraktion behandelt.
Was dieses Setup weiterhin nicht automatisieren kann
Die ehrliche Grenze ist, dass es Coverage messbar macht; es macht Urteile nicht automatisch und weist auch keine Verantwortlichkeit von selbst zu.
Wer ein strittiges Element besitzt, bleibt eine Entscheidung. Wenn zwei Bearbeiter dieselbe Rechnung bearbeitet haben, zeigt die API das Duplikat im Statusverlauf, aber jemand muss entscheiden, welches Ergebnis übernommen wird. Das ist der Batch-Besitzer oder Prüfer, und kein Tool macht das überflüssig. Ebenso ist die Extraktionsqualität bei einem schwierigen Dokument eine menschliche Entscheidung: Das Tool extrahiert, und ein Prüfer entscheidet, ob das Ergebnis gut genug für den Export ist. Die Coverage-Abfrage macht die nicht zugeordnete Liste täglich sichtbar, aber jemand muss sie weiterhin ausführen oder planen; das Tool erinnert nicht von selbst.
Die Aufteilung selbst ist nur so gut wie die Person, die sie pflegt. Auf Papier zugewiesene Slice, die nie mit dem Roster abgeglichen werden, führen das ursprüngliche Problem wieder ein, weil Aufgabenverfolgung und Dokumentenstatus wieder zwei Datensätze sind, die nicht miteinander sprechen. Für Teams, deren Volumen eine API-Integration nicht rechtfertigt, entfällt mit einem Shared Workspace ohne API bereits die Ebene „fünf getrennte Konten“, und dasselbe Batch-First-Muster mit geringerem Volumen wird im Setup für die Extraktion in kleinen Teams behandelt. Wenn das Volumen die manuelle Aufteilung vollständig übersteigt, führt der Weg über Skalierung ohne zusätzliche Stellen.
Was keines dieser Mittel tut, ist, in das Hauptbuch zu buchen, Genehmigungen durchzuführen oder Arbeit einzelnen Personen innerhalb des Tools zuzuweisen. Die API ist die Routing-Oberfläche: Für automatische Zuweisung baut man diese gegen die API. Das Tool stellt die Warteschlange, den Status und die fertige Tabelle bereit. Der Workflow darum herum bleibt in eigener Hand – und genau das ist der Punkt. Teams, die den Batch als Shared Workspace plus abfragbaren Status behandeln, hören auf, ihre Koordinationsenergie in „wer erinnert sich, was erledigt ist“ zu stecken.
Team-Batch-Verarbeitung: Häufig gestellte Fragen
Benötigen alle Teammitglieder einen eigenen kostenpflichtigen Plan?
Nein. Der Team-Workspace ermöglicht es einem Teamplan, mehrere Mitglieder abzudecken. Bearbeiter treten mit dem gemeinsamen Code bei, arbeiten an denselben Batches im selben Konto und nutzen den gemeinsamen Credit-Pool des Teams sowie die zentral geplante Kapazität – das Team kauft also nicht fünf separate Abonnements.
Woher wissen wir, welche Dokumente fertig sind?
Über die v1 API fragen Sie den Status pro Dokument direkt ab, und ein Webhook benachrichtigt Sie, wenn die Verarbeitung eines Batches abgeschlossen ist. Fertig-Status stammen aus dem Datensatz und nicht aus dem Gedächtnis – das ist der gesamte Unterschied zwischen einem abgedeckten Batch und einem Batch, von dem man nur hofft, dass er abgedeckt ist.
Erfordert die Nutzung der API einen Entwickler?
Die API erfordert etwas Skripterstellung, da sie JSON zurückgibt. Eine erste Anfrage kann in etwa fünf Minuten gestellt werden, indem man ein dokumentiertes Beispiel kopiert. Teams ohne Entwickler profitieren dennoch in hohem Maße von der Coverage durch einen Shared Workspace, in dem alle dieselbe Warteschlange sehen, und können die vollständige API-Automatisierung auf einen Zeitpunkt verschieben, an dem sie sich selbst amortisiert.
Könnten zwei Personen trotzdem dieselbe Datei verarbeiten?
Ja, wenn beide zum selben Element eilen, bevor einer es erfasst. Die API macht dieses Rennen selten und sichtbar: Roster und Status sind abfragbar, sodass ein Bearbeiter prüfen kann, ob ein Element bereits beansprucht ist, bevor er beginnt, und der Statusverlauf zeigt, wann ein Duplikat aufgetreten ist. Sie verhindert nicht, dass zwei Personen im Abstand von fünf Minuten beschließen, dasselbe Element zu übernehmen – weshalb im Voraus zugewiesene Slices die stärkere Gewohnheit sind.
Wie erkennen wir Dokumente, die niemand übernommen hat?
Führen Sie die Coverage-Abfrage aus: Jedes Element im Roster ohne fertigen Status ist nicht beansprucht. Dies täglich zu tun, statt zu hoffen, dass der Ordner vollständig ist, macht aus „Hat jeder fertig?" eine Prüfung in einer Zeile.
Wohin gehen die fertigen Daten?
Die Ergebnisse kommen als strukturierte Daten zurück, die über die API gelesen oder als Tabelle mit den vom Batch-Besitzer definierten Spalten exportiert werden können. Der Export erfolgt in einem tabellenbasierten Format, das später ein Buchhaltungssystem oder eine Abstimmungsliste speist; das Tool ist die Extraktionsebene, nicht das Hauptbuch.
Der Wandel ist eine Änderung der Ausrichtung. Ein Team, das sich über das Gedächtnis koordiniert, fragt jeden Monat: „Hat jemand etwas übersehen?" – und wartet auf die Anbieterabrechnung, um die Antwort zu erhalten. Ein Team, das Status als Abfrage behandelt, stellt dieselbe Frage mit einer einzigen Abfrage und beantwortet sie am selben Tag. Richten Sie Ihren eigenen Batch im Shared Workspace ein, ziehen Sie den Roster über die API und prüfen Sie, ob „wer hat was getan" aufhören kann, ein Gespräch zu sein, und stattdessen zu einer Spalte wird.