Partager un lot de documents entre une équipe semble simple
Puis deux personnes traitent la même facture
Le mode de défaillance d'un lot de documents partagé n'est pas la vitesse. Lorsqu'une poignée de personnes répartit un lot de factures, de contrats ou de notes de frais, les deux échecs qui apparaissent sont le même document traité deux fois et un document que personne n'a pris en charge. L'Auditeur de l'État de Washington, dont le bureau audite les agences publiques, estime que la part des paiements totaux qui sont en double ou erronés se situe entre 0,8 pour cent et 2 pour cent, et ses directives nomment clairement la cause : lorsque différents employés saisissent chacun des factures, différentes personnes peuvent finir par saisir la même facture (Auditeur de l'État de Washington, 2022).
Points clés à retenir
- 0,8 à 2 pour cent des paiements sont en double ou erronés, et la cause est généralement deux personnes saisissant la même facture.
- Les doublons et les oublis sont la même maladie, car le lot n'a pas de propriétaire par élément et son statut est une supposition partagée plutôt qu'un enregistrement.
- Un espace de travail partagé plus un statut interrogeable transforment la couverture en un calcul, où chaque élément de la liste sans état finalisé est un élément sans propriétaire.
L'échec réel, c'est la couverture, pas le débit
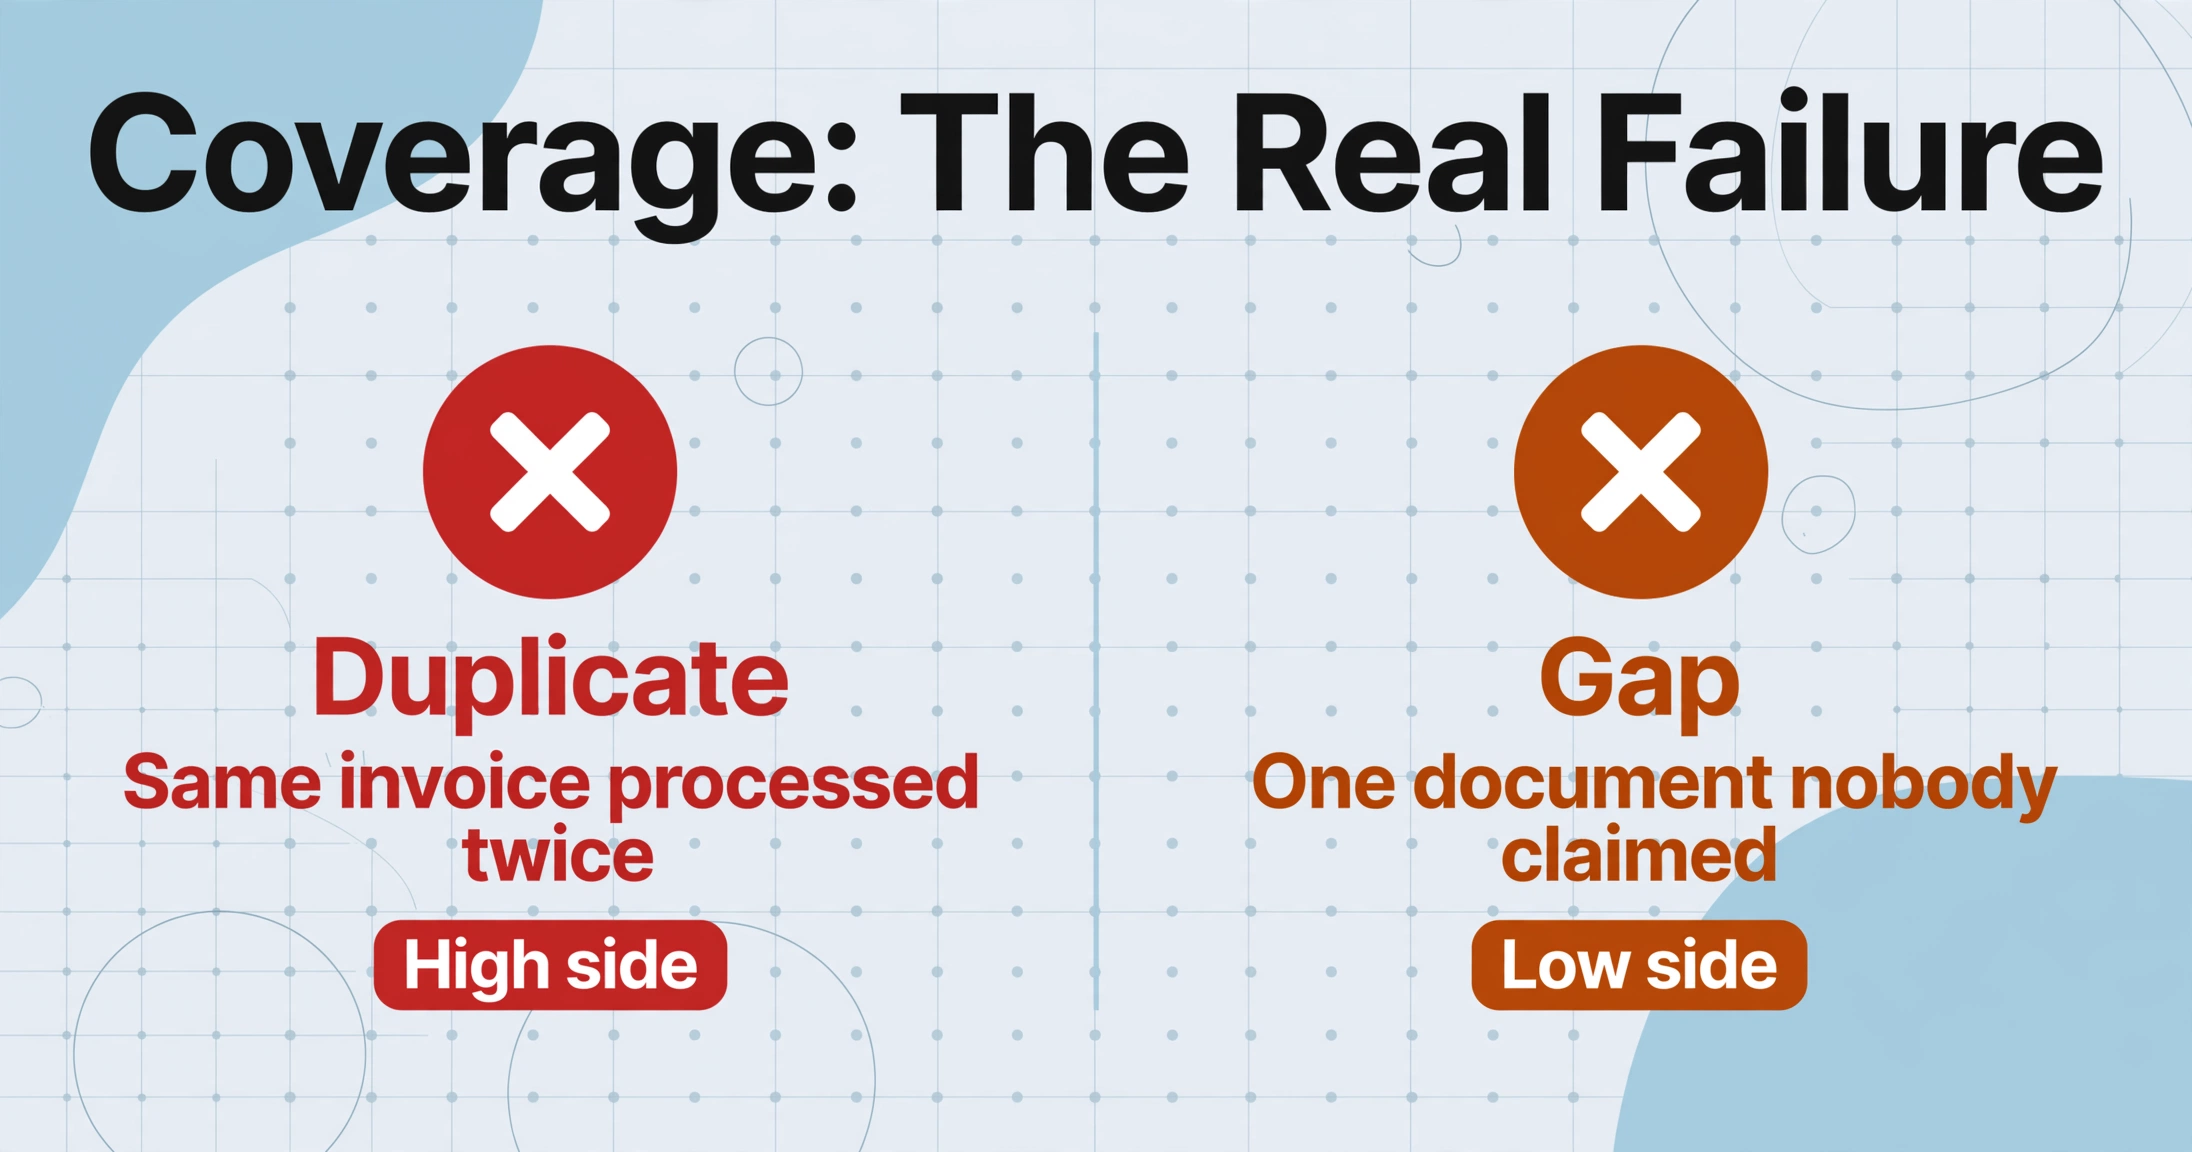
La couverture est la propriété selon laquelle chaque document d'un lot est traité exactement une fois. Un doublon est un échec de couverture côté excédentaire : la même facture traitée par deux personnes, extraite deux fois, exportée deux fois dans le lot. Un écart est un échec de couverture côté déficitaire : un document du lot que personne n'a réclamé, découvert seulement en fin de mois lorsque le relevé fournisseur ne correspond pas. Les deux génèrent des reprises, et les deux relèvent de la même maladie.
Les personnes au sein de ces équipes décrivent le résultat sans dramatiser. Un utilisateur de r/QuickBooks qui gère la comptabilité fournisseurs d'une entreprise de taille moyenne a écrit : « nous avons eu une situation où la même facture fournisseur a été payée deux fois » (r/QuickBooks, 2025). Sur r/Accounting, quelqu'un dont le travail du cabinet s'effondrait a décrit le côté déficitaire : « De plus en plus de problèmes sont révélés, et des clients passent entre les mailles du filet » (r/Accounting, 2025).
Un lot de documents est une file d'attente où chaque élément nécessite exactement un propriétaire et un état de fin enregistré. C'est tout le problème. Le débit se règle avec des outils plus rapides. La couverture, non, car rien n'y répond.
Qui touche à un lot partagé, et où « terminé » existe réellement
Un lot divisé implique trois rôles distincts, et chacun entretient un rapport différent avec la file d'attente.
| Rôle | Ce qu'ils font concrètement | Ce qu'ils détiennent |
|---|---|---|
| Propriétaire du lot | Définit le contrat de sortie (quelles colonnes chaque document traité doit produire), divise le lot, vérifie l'achèvement, assume l'échéance | La liste maîtresse du contenu du lot, généralement un dossier partagé ou une feuille de calcul |
| Processeurs | Réclament une partie du lot, téléversent chaque document, examinent les données extraites, confirment que c'est terminé | Leur pile locale « terminé » et le fil de discussion partagé où ils annoncent leur progression |
| Réviseur | Repère les exceptions, résout les éléments que deux personnes ont touchés, vérifie un échantillon avant l'export | Un jugement sur la fiabilité du lot, formé en interrogeant les personnes plutôt qu'en interrogeant un système |
Un rythme sain ressemble à ceci : le propriétaire divise selon une règle documentée (les cinquante premiers par ordre d'arrivée, un fournisseur par personne, une région par personne), chaque processeur travaille sur sa partie, et à l'échéance, le réviseur vérifie que chaque ligne de la liste maîtresse a un état final. La mécanique est simple. Ce qui fait ou défait le rythme, c'est la deuxième question : où « terminé » existe-t-il réellement ?
Actuellement, pour la plupart des équipes, cela existe à deux endroits impossibles à concilier. Cela existe dans la mémoire du propriétaire du lot comme un décompte en cours, et cela existe dans le fil de discussion comme une série de messages du type « j'ai pris la pile de fournisseurs Met » et « terminé avec le lot 3 ». Aucun des deux n'est un registre consultable à 23 h la veille de la clôture. Le dossier partagé montre les fichiers tels qu'ils ont été téléversés, pas tels qu'ils ont été traités. Le suivi de tâches montre les affectations saisies par le propriétaire, pas les documents réellement terminés par les processeurs.
Pourquoi le même document est traité deux fois et un autre est oublié
Ces deux échecs découlent d'une même décision de conception : le lot n'a pas de propriétaire par élément, et son statut est une supposition partagée plutôt qu'un enregistrement.
Le doublon survient à cause d'une course. Deux processeurs vérifient le même dossier partagé à peu près au même moment, voient tous deux la même facture sans signe évident de travail, décident tous deux de la prendre et la traitent tous deux. Chacun s'est dit « je vais m'en occuper » dans sa tête avant que l'un ou l'autre ne l'enregistre quelque part de vérifiable. Au moment où un système aurait pu signaler le conflit, le travail est déjà fait deux fois.
L'écart survient par l'effet miroir. Chaque processeur suppose qu'un document appartient à quelqu'un d'autre. Le propriétaire suppose que quelqu'un l'a remarqué. Rien ne signale les éléments non réclamés, donc le lot est déclaré terminé lorsque la dernière tranche assignée est finie, et non lorsque le dernier élément du lot est fini. Un utilisateur sur r/Accounting décrivant le chaos de la réception a mis des mots sur cet état sous-jacent : « Les clients envoient les choses au compte-gouttes, une facture ici, un contrat là, un document fiscal dans un e-mail d'il y a trois semaines, et ça devient vite chaotique » (r/Accounting, 2025).
Les outils auxquels les équipes recourent ne brisent pas ce cycle, car chacun détient une moitié différente du tableau. Asana, Monday.com et Jira sont des enregistrements au niveau des tâches : ils assignent des tâches et des échéances, mais ils ne voient jamais l'état des documents dans le lot, donc « tâche terminée » ne vous dit rien sur le fichier. La couche comptable, QuickBooks, Sage Intacct, Xero ou NetSuite, est l'endroit où aboutissent les données finales, mais elle répond à « cela a-t-il été facturé », pas à « quelqu'un a-t-il touché à ce scan ». L'outil d'extraction détient les documents et l'état du traitement, mais si une seule personne surveille la file d'attente, les autres travaillent de mémoire. Deux ou trois registres de vérité qui ne se consultent jamais mutuellement.
C'est un schéma reconnu dans la littérature sur ce type précis de back-office. L'auditeur de l'État de Washington qualifie la saisie décentralisée de « trop de cuisiniers dans la cuisine », où « différents services peuvent chacun saisir la même facture » et contourner sans le savoir les contrôles logiciels (WA State Auditor, 2022). La dernière Global Business Services Survey de Deloitte montre que les organisations de services partagés citent l'amélioration de la « propriété de bout en bout » comme un objectif central, car l'absence de propriété est précisément l'échec décrit ici. La cause profonde n'est pas une IA manquante. C'est un processus où l'assignation et l'achèvement n'ont jamais reçu de système d'enregistrement.
La solution : un espace de travail partagé et un statut interrogeable
Deux capacités de l'outil d'extraction correspondent aux deux étapes défaillantes, et chacune est accompagnée d'un paramètre spécifique qui fait le travail.
La première étape défaillante, « qui est autorisé à traiter ce lot et sous la capacité de qui », est ce que les espaces de travail d'équipe gèrent. Un espace de travail d'équipe est une structure de compte partagée : un plan d'équipe couvre un ensemble de membres avec une limite de membres configurée, les membres rejoignent avec un code partagé par le propriétaire, le plan d'équipe définit la capacité de traitement et de lot de manière centralisée, et le travail de chacun est puisé dans un pool de crédits partagé. Le changement concret pour un lot divisé est que les quatre processeurs travaillent sur les mêmes lots dans le même compte. Il n'y a plus cinq comptes gratuits distincts avec cinq limites distinctes, plus de « envoyez-le sur mon compte pour que ça compte contre mon quota », plus de personne agissant comme routeur humain parce qu'elle est la seule à voir la file d'attente.
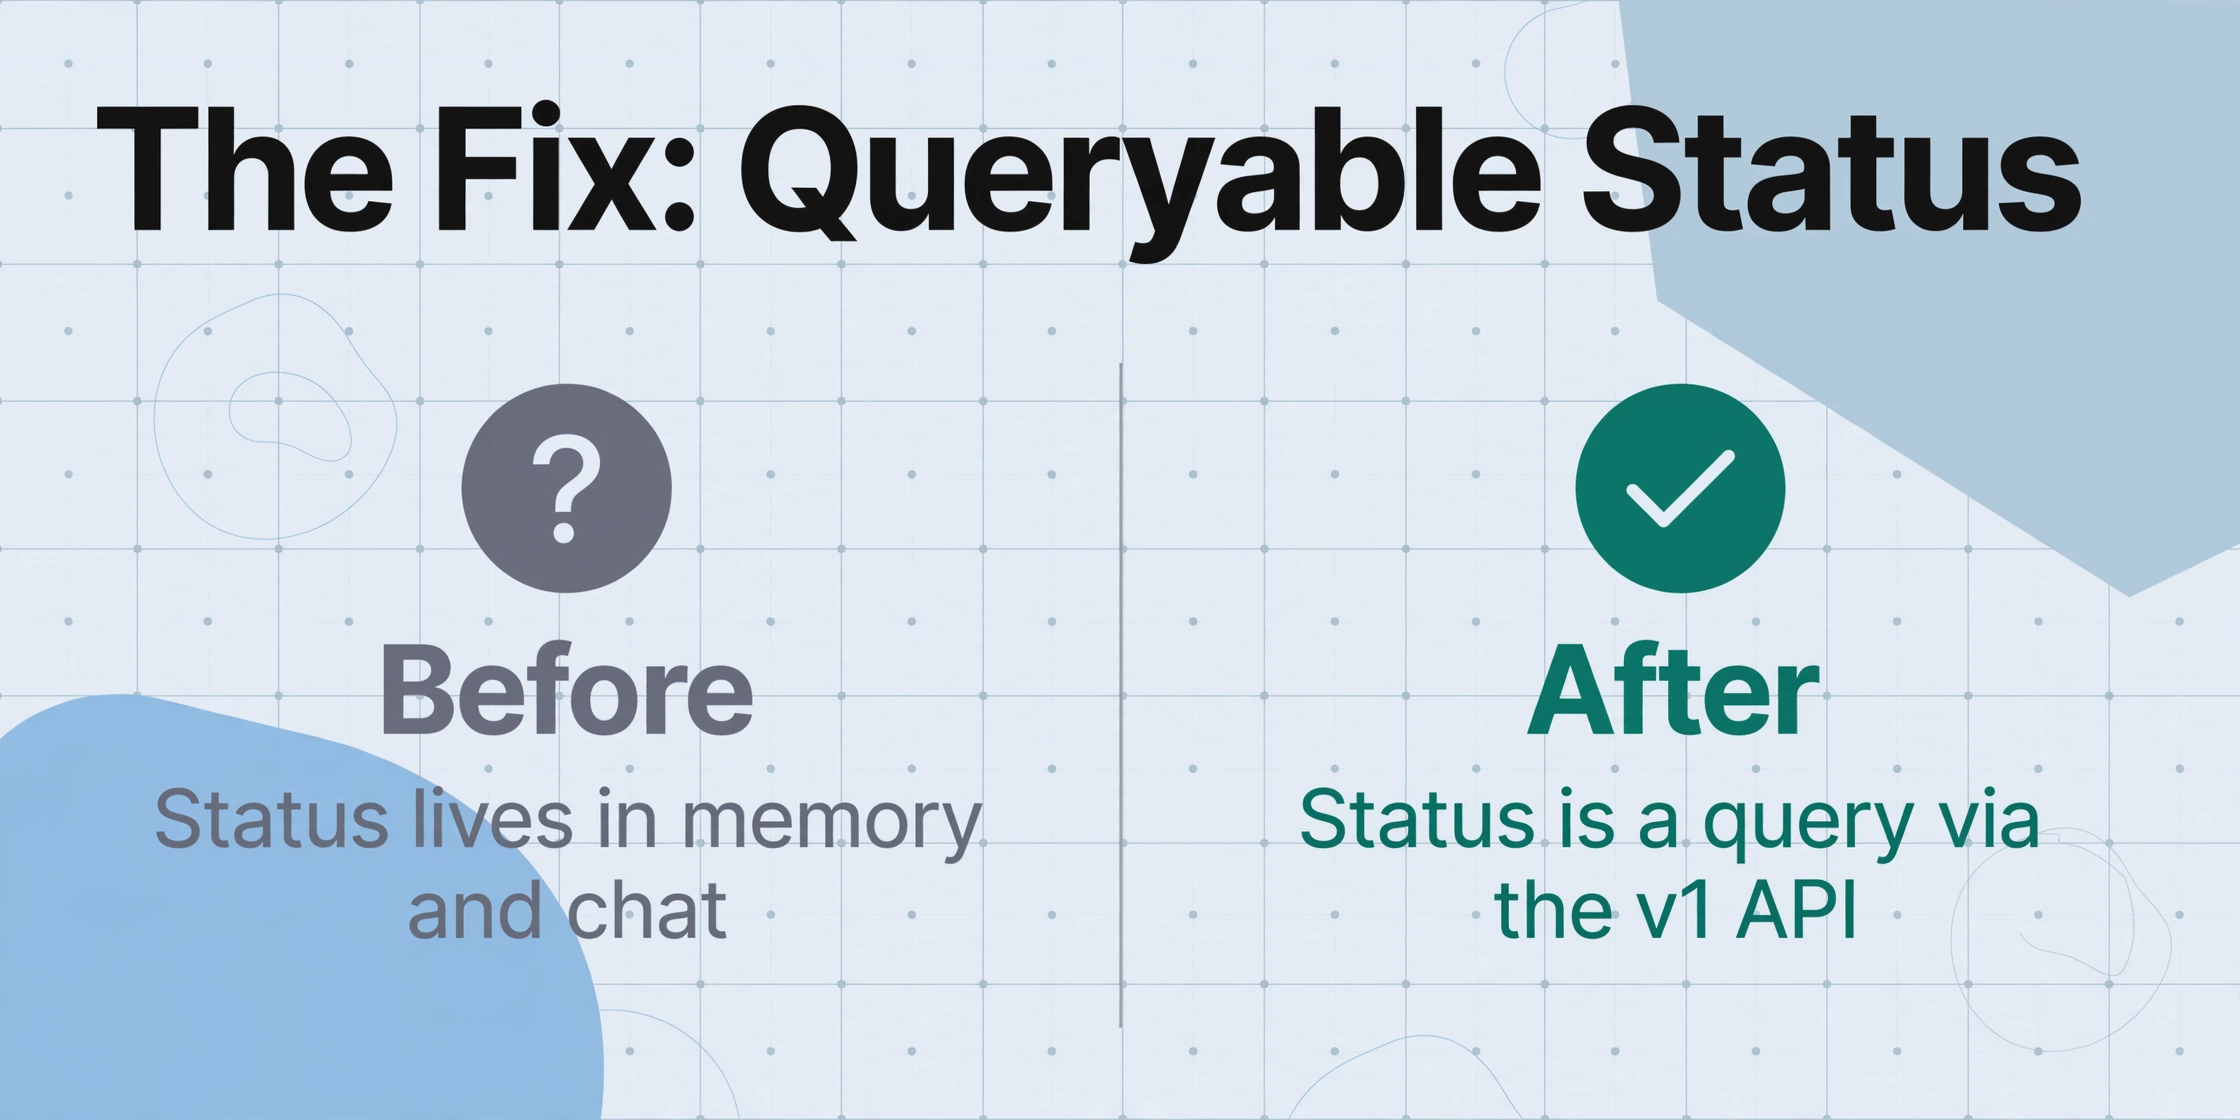
La deuxième étape défaillante, « où vit le statut », est ce que l'API v1 résout. L'API v1 est l'interface REST publique de l'outil d'extraction, documentée dans /developers : elle permet à votre propre système de téléverser des documents, de lancer le traitement par lots, de récupérer le statut et les résultats par document, et de recevoir une notification webhook à la fin du traitement, de sorte que rien n'a besoin d'être interrogé en boucle. La sortie est un JSON structuré, indépendant de l'application web, et un premier appel prend environ cinq minutes à mettre en place. Ce qui compte pour la couverture, c'est la propriété qu'elle vous donne : le statut par élément devient une requête au lieu d'un souvenir.
Lorsque le registre du lot et l'état d'achèvement sont tous deux lisibles par programmation, la couverture cesse d'être une impression et devient un calcul : chaque élément du registre sans état terminé est un élément sans propriétaire, à la minute près.
Configuré selon un rythme réel, avec un lot de fin de mois de 200 factures et quatre processeurs, cela ressemble à ceci :
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Choisir entre la voie de l'API et l'interface sans code pour votre batch est un compromis en soi : l'application web est plus rapide à démarrer, l'API est plus rapide à vérifier, et la comparaison entre l'API et le sans code ainsi que la comparaison des outils API présentent les deux aspects. Les équipes qui souhaitent intégrer l'extraction directement dans un outil interne commencent par la voie de l'API OCR. Le workflow décrit dans cet article, où les documents sont collectés auprès de personnes externes avant d'atteindre le batch, est couvert dans le workflow de collecte et d'extraction de documents.
Ce que cette configuration ne peut toujours pas automatiser
La limite honnête est que cela rend le coverage mesurable ; cela ne rend pas le jugement automatique et n'attribue pas la responsabilité par lui-même.
Décider qui est responsable d'un élément contesté reste une décision. Lorsque deux processeurs ont tous deux traité la même facture, l'API affiche le duplicate dans l'historique de status, mais quelqu'un doit décider quel résultat est celui qui est envoyé. C'est le propriétaire du batch ou le réviseur, et aucun outil ne supprime cette décision. De même, la qualité d'extraction sur un document difficile relève d'un jugement humain : l'outil extrait, et un réviseur décide si la sortie est assez bonne pour être exportée. La requête de coverage rend la liste non réclamée visible chaque jour, mais quelqu'un doit encore l'exécuter ou la planifier ; l'outil ne relance pas.
La répartition elle-même ne vaut que ce que vaut son responsable. Des tranches attribuées sur papier mais jamais rapprochées du roster réintroduisent le problème initial, car le suivi des tâches et le status du document redeviennent deux enregistrements qui ne communiquent pas. Pour les équipes qui ont un volume trop faible pour justifier une intégration API, un shared workspace sans l'API supprime déjà la couche « cinq comptes séparés », et le même modèle batch-first avec un volume plus léger est couvert dans la configuration d'extraction pour petite équipe. Lorsque le volume dépasse entièrement la division manuelle, la voie est de passer à l'échelle sans ajouter de personnel.
Ce que tout cela ne fait pas, c'est inscrire au grand livre, gérer les approbations ou acheminer le travail vers des individus dans l'outil. L'API est la surface d'acheminement : si vous voulez une attribution automatique, vous la construisez sur l'API. L'outil fournit la file d'attente, le status et le tableau final. Le workflow autour d'eux vous appartient, et c'est là tout l'intérêt. Les équipes qui traitent le batch comme un shared workspace plus un status interrogeable cessent de dépenser leur énergie de coordination à se demander « qui se souvient de ce qui est fait ».
Traitement par lots en équipe : questions fréquentes
Tous les membres de l'équipe doivent-ils avoir leur propre plan payant ?
Non. L'espace de travail d'équipe permet à un plan d'équipe de couvrir plusieurs membres. Les processeurs rejoignent avec le code partagé, travaillent sur les mêmes lots dans le même compte et puisent dans le pool de crédits partagé et la capacité planifiée centralement de l'équipe, afin que l'équipe n'achète pas cinq abonnements distincts.
Comment savoir quels documents sont terminés ?
Via l'API v1, vous interrogez directement le statut de chaque document, et un webhook vous notifie lorsque le traitement d'un lot est terminé. Les états terminés proviennent du registre plutôt que de la mémoire, ce qui fait toute la différence entre couvrir un lot et espérer qu'il l'a été.
L'utilisation de l'API nécessite-t-elle un développeur ?
L'API nécessite un peu de script pour être appelée, car elle renvoie du JSON. Une première requête peut être effectuée en environ cinq minutes en copiant un exemple documenté. Les équipes sans développeur bénéficient quand même de l'essentiel de l'avantage de couverture grâce à un espace de travail partagé, où chacun voit la même file d'attente, et peuvent laisser l'automatisation complète de l'API à un moment où elle sera rentable.
Deux personnes pourraient-elles encore traiter le même fichier ?
Oui, si toutes deux se précipitent sur le même élément avant que l'une d'elles ne l'enregistre. L'API rend cette course rare et visible : le registre et le statut sont interrogeables, donc un processeur peut vérifier si un élément est déjà pris avant de commencer, et la trace de statut montre quand un doublon s'est produit. Cela n'empêche pas deux personnes de décider toutes deux de prendre le même élément à cinq minutes d'intervalle, c'est pourquoi les tranches attribuées à l'avance constituent la meilleure habitude.
Comment repérer les documents que personne n'a pris en charge ?
Exécutez la requête de couverture : chaque élément du registre sans état terminé est non pris en charge. Le faire quotidiennement, au lieu d'espérer que le dossier est complet, transforme « tout le monde a-t-il terminé ? » en une vérification d'une seule ligne.
Où vont les données finales ?
Les résultats reviennent sous forme de données structurées que vous pouvez lire via l'API ou exporter sous forme de feuille de calcul avec les colonnes définies par le propriétaire du lot. L'export arrive dans un format natif de feuille de calcul qui alimente ensuite un système comptable ou une feuille de rapprochement ; l'outil est la couche d'extraction, pas le registre.
Ce changement est un changement d'orientation. Une équipe qui coordonne par mémoire se demande chaque mois « est-ce que quelqu'un a manqué quelque chose ? » et attend le relevé du fournisseur pour répondre. Une équipe qui traite le statut comme une requête pose la même question en une seule lecture et y répond le jour même. Configurez votre propre lot sur l'espace de travail partagé, récupérez le registre via l'API, et voyez si « qui a fait quoi » peut cesser d'être une conversation pour devenir une colonne.