Compartilhar um lote de documentos entre uma equipe parece simples
Até que duas pessoas processem a mesma fatura
O modo de falha de um lote de documentos compartilhado não é a velocidade. Quando algumas pessoas dividem um lote de faturas, contratos ou relatórios de despesas, as duas falhas que aparecem são o mesmo documento processado duas vezes e um documento que ninguém assumiu. O Auditor do Estado de Washington, cujo escritório audita agências públicas, estima que a parcela dos pagamentos totais que são duplicados ou errôneos esteja entre 0,8% e 2%, e sua orientação nomeia a causa com clareza: quando diferentes funcionários inserem faturas, pessoas diferentes podem acabar inserindo a mesma fatura (Auditor do Estado de WA, 2022).
Principais Conclusões
- 0,8% a 2% dos pagamentos são duplicados ou errôneos, e a causa geralmente é duas pessoas inserindo a mesma fatura.
- Duplicatas e lacunas são a mesma doença, porque o lote não tem um responsável por item e seu status é uma suposição compartilhada, não um registro.
- Um espaço de trabalho compartilhado com um status consultável transforma a cobertura em um cálculo, onde todo item do roster sem estado concluído é um item sem responsável.
A Falha Real É a Cobertura, Não a Produtividade
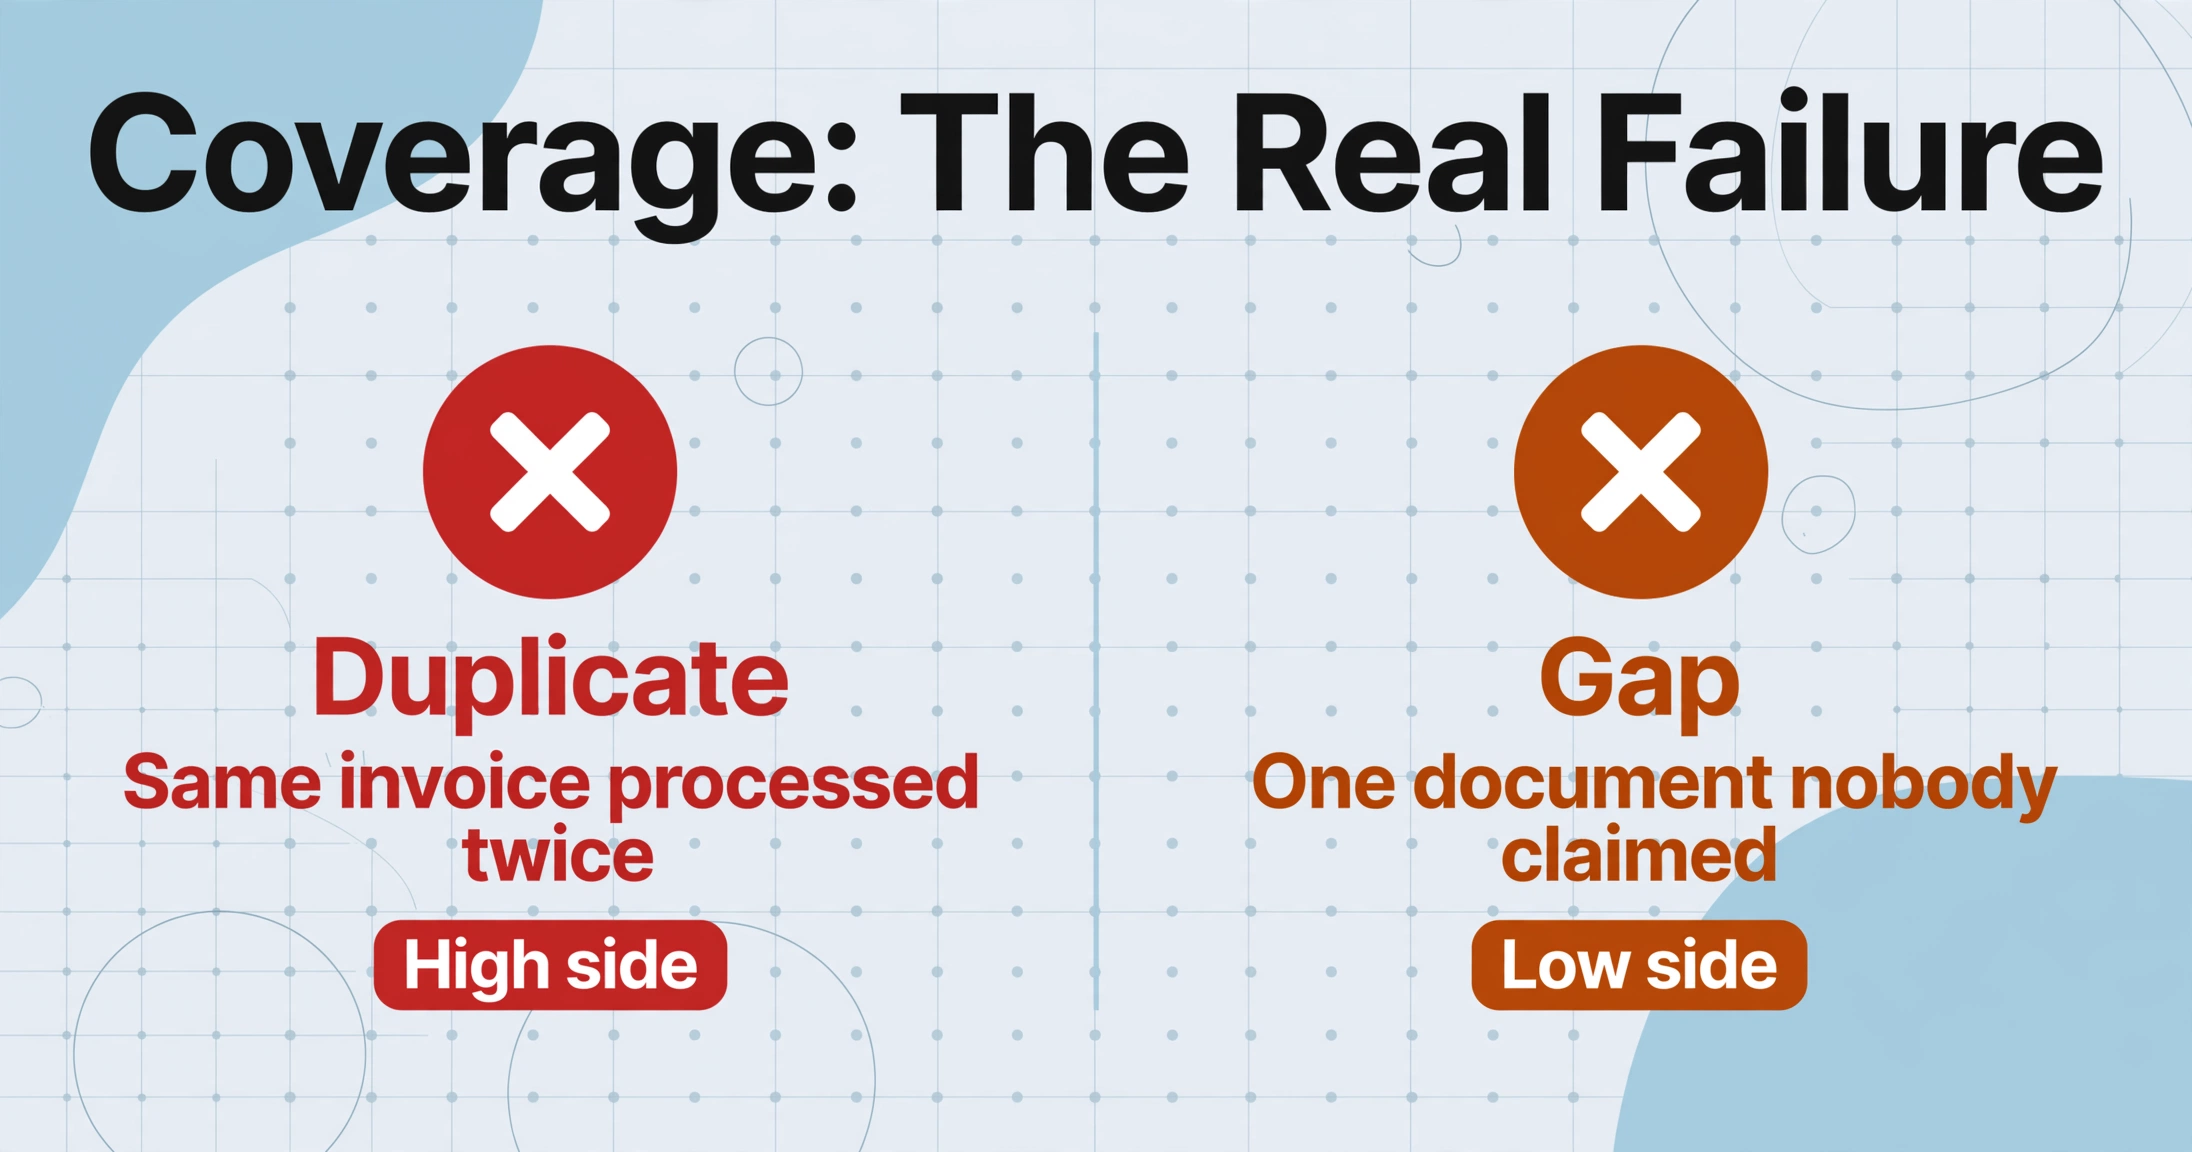
Cobertura é a propriedade de que cada documento em um lote seja processado exatamente uma vez. Uma duplicata é uma falha de cobertura no lado alto: a mesma fatura processada por duas pessoas, extraída duas vezes, exportada duas vezes no lote. Uma lacuna é uma falha de cobertura no lado baixo: um documento no lote que ninguém reivindicou, descoberto apenas no fechamento do mês, quando o extrato do fornecedor não confere. Ambas geram retrabalho, e ambas são a mesma doença.
As pessoas nesses times descrevem o resultado sem dramatização. Um usuário no r/QuickBooks que faz contas a pagar para uma empresa de médio porte escreveu: "tivemos uma situação em que a mesma fatura de fornecedor foi paga duas vezes" (r/QuickBooks, 2025). No r/Accounting, alguém cujo trabalho no escritório estava desmoronando descreveu o lado baixo: "Cada vez mais problemas estão sendo revelados, e clientes estão caindo pelas frestas" (r/Accounting, 2025).
Um lote de documentos é uma fila em que cada item precisa de exatamente um dono e um estado final registrado. Esse é o problema inteiro. A produtividade é respondida com ferramentas mais rápidas. A cobertura não é, porque nada está respondendo por ela.
Quem Toca um Lote Compartilhado e Onde "Concluído" Realmente Vive
Um lote dividido envolve três papéis distintos, e cada um tem uma relação diferente com a fila.
| Papel | O que realmente fazem | O que detêm |
|---|---|---|
| Proprietário do lote | Define o contrato de saída (quais colunas cada documento processado deve produzir), divide o lote, verifica a conclusão, é responsável pelo prazo | A lista mestre do que está no lote, geralmente uma pasta compartilhada ou uma planilha |
| Processadores | Reivindicam uma parte do lote, enviam cada documento, revisam os dados extraídos, confirmam que está concluído | Sua pilha local de "concluídos" e o tópico de chat compartilhado onde anunciam o progresso |
| Revisor | Identifica exceções, resolve itens que duas pessoas tocaram, verifica uma amostra antes da exportação | Um julgamento sobre a confiança no lote, formado perguntando às pessoas em vez de consultar um sistema |
Um ritmo saudável é assim: o proprietário divide por uma regra documentada (os primeiros cinquenta por ordem de chegada, um fornecedor por pessoa, uma região por pessoa), cada processador trabalha sua parte e, até o prazo, o revisor verifica se cada item da lista mestre tem um estado concluído. A mecânica é simples. O que faz ou quebra o ritmo é a segunda pergunta: onde "concluído" realmente vive?
Agora, para a maioria das equipes, isso vive em dois lugares que não podem ser reconciliados. Vive na memória do proprietário do lote como uma contagem contínua, e vive no tópico de chat como uma série de mensagens como "peguei a pilha do fornecedor Met" e "concluído com o conjunto 3." Nenhum é um registro que possa ser verificado às 23h na noite anterior ao fechamento. A pasta compartilhada mostra os arquivos como foram enviados, não como foram processados. O rastreador de tarefas mostra as atribuições que o proprietário digitou, não os documentos que os processadores realmente terminaram.
Por que o Mesmo Documento é Processado Duas Vezes e Outro é Ignorado
Ambas as falhas vêm de uma decisão de design: o lote não tem propriedade por item, e seu status é uma suposição compartilhada, não um registro.
A duplicação acontece por uma corrida. Dois processadores verificam a mesma pasta compartilhada ao mesmo tempo, ambos veem a mesma fatura sem sinal óbvio de trabalho, ambos decidem pegá-la e ambos a processam. Cada um definiu o estado como "eu vou fazer isso" em sua própria cabeça antes de qualquer um registrá-lo em algum lugar verificável. Quando um sistema poderia ter sinalizado o conflito, o trabalho já foi feito duas vezes.
A lacuna acontece pela imagem espelhada. Cada processador assume que um documento pertence a outra pessoa. O proprietário assume que alguém o notou. Nada sinaliza itens não reclamados, então o lote é declarado concluído quando a última fatia atribuída é finalizada, não quando o último item do lote é finalizado. Um usuário no r/Accounting descrevendo o caos na entrada de dados colocou em palavras o estado subjacente: "Os clientes enviam coisas aos poucos, fatura aqui, contrato ali, documento fiscal em um e-mail de três semanas atrás, e fica caótico rapidamente" (r/Accounting, 2025).
As ferramentas que as equipes usam não quebram o ciclo, porque cada uma detém uma metade diferente do quadro. Asana, Monday.com e Jira são registros de camada de tarefas: eles atribuem tarefas e prazos, mas nunca veem o estado dos documentos dentro do lote, então "tarefa concluída" não diz nada sobre o arquivo. A camada contábil, QuickBooks, Sage Intacct, Xero ou NetSuite, é onde os dados finalizados chegam, mas responde "foi cobrado", não "alguém tocou nesta digitalização". A ferramenta de extração detém os documentos e o estado de processamento, mas se apenas uma pessoa observa a fila, os outros trabalham de memória. Dois ou três registros de verdade que nunca se consultam.
Este é um padrão reconhecido na literatura sobre exatamente esse tipo de back office. O Auditor do Estado de Washington chama a entrada descentralizada de "muitos cozinheiros na cozinha", onde "departamentos diferentes podem inserir a mesma fatura" e, sem saber, contornar os controles de software (Auditor do Estado de WA, 2022). A mais recente Pesquisa Global de Serviços Compartilhados da Deloitte constata que organizações de serviços compartilhados nomeiam a melhoria da "propriedade de ponta a ponta" como um objetivo central, porque a ausência de propriedade é exatamente a falha que isso descreve. A causa raiz não é uma IA ausente. É um processo onde a atribuição e a conclusão nunca receberam um sistema de registro.
A Solução: Um Espaço de Trabalho Compartilhado e um Status que Você Pode Consultar
Dois recursos da ferramenta de extração correspondem às duas etapas problemáticas, e cada um vem com uma configuração específica que faz o trabalho.
A primeira etapa problemática, "quem pode trabalhar neste lote e sob a capacidade de quem", é o que os espaços de trabalho de equipe resolvem. Um espaço de trabalho de equipe é uma estrutura de conta compartilhada: um plano de equipe cobre um conjunto de membros com um limite de membros configurado, os membros entram com um código que o proprietário compartilha, o plano de equipe define o lote e a capacidade de processamento centralmente, e o trabalho de todos é retirado de um pool de crédito compartilhado. A mudança prática para um lote dividido é que todos os quatro processadores trabalham nos mesmos lotes na mesma conta. Não há cinco contas gratuitas separadas com cinco limites separados, nenhum "envie para minha conta para contar contra minha cota", nenhuma pessoa atuando como roteador humano porque só ela consegue ver a fila.
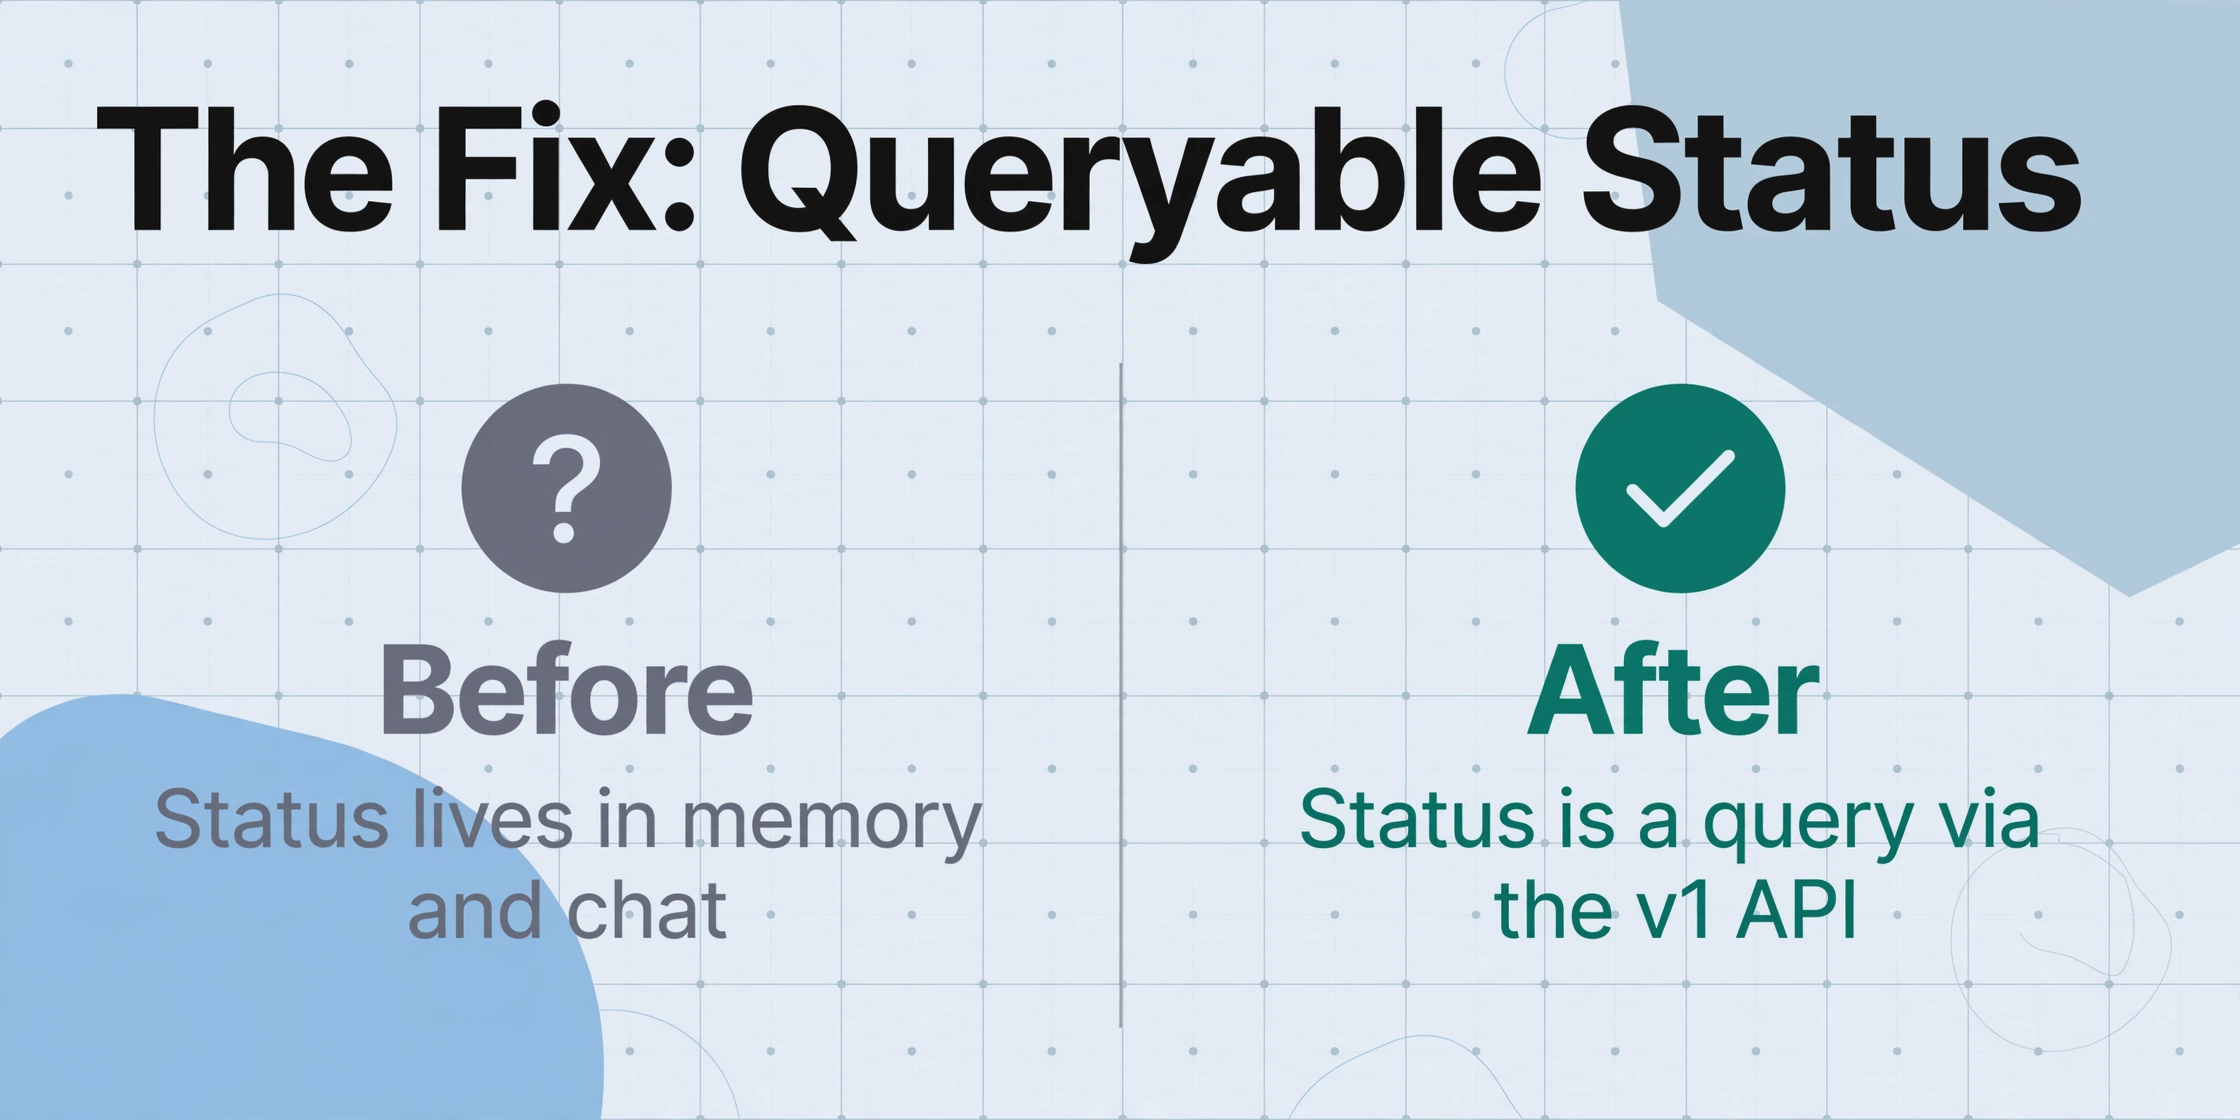
A segunda etapa problemática, "onde o status vive", é o que a API v1 resolve. A API v1 é a interface REST pública da ferramenta de extração, documentada em /developers: ela permite que seu próprio sistema envie documentos, inicie o processamento em lote, recupere o status e os resultados por documento e receba uma notificação via webhook quando o processamento for concluído, para que nada precise ser consultado repetidamente. A saída é JSON estruturado, independente do aplicativo web, e a primeira chamada leva cerca de cinco minutos para funcionar. O que importa para a cobertura é a propriedade que ela oferece: o status por item se torna uma consulta em vez de uma memória.
Quando o roster do lote e o estado de conclusão são ambos legíveis programaticamente, a cobertura deixa de ser uma sensação e se torna um cálculo: cada item no roster sem estado finalizado é um item sem dono, ao minuto.
Configurado em um ritmo real, com um lote de fim de mês de 200 faturas e quatro processadores, fica assim:
Os arquivos são processados com segurança e não são armazenados.
Decidir se a rota da API ou a interface sem código é a certa para o seu lote é um trade-off por si só: o aplicativo web é mais rápido para começar, a API é mais rápida para verificar, e a comparação entre API e sem código e a comparação de ferramentas de API exploram ambos os lados. Equipes que querem extrair dados diretamente para uma ferramenta interna começam com a rota da API OCR. O fluxo de trabalho descrito neste artigo, onde os documentos são coletados de pessoas externas antes de chegarem ao lote, é abordado no fluxo de coleta e extração de documentos.
O Que Esta Configuração Ainda Não Consegue Automatizar
A fronteira honesta é que ela torna a cobertura mensurável; não torna o julgamento automático e não atribui responsabilidade por si só.
A pessoa que é dona de um item contestado ainda é uma decisão. Quando dois processadores tocaram a mesma fatura, a API mostra a duplicata no histórico de status, mas alguém precisa decidir qual resultado é o que segue. Esse é o dono do lote ou revisor, e nenhuma ferramenta elimina isso. Da mesma forma, a qualidade da extração em um documento difícil é uma decisão humana: a ferramenta extrai, e um revisor decide se a saída é boa o suficiente para exportar. A consulta de cobertura torna a lista de itens não reclamados visível todos os dias, mas alguém ainda precisa executá-la ou agendá-la; a ferramenta não cobra.
A própria divisão só é tão boa quanto quem a mantém. Fatias atribuídas no papel, mas nunca reconciliadas com o roster, reintroduzem o problema original, porque o rastreador de tarefas e o status do documento novamente se tornam dois registros que não conversam. Para equipes com volume pequeno demais para justificar uma integração de API, um espaço de trabalho compartilhado sem a API já elimina a camada de "cinco contas separadas", e o mesmo padrão de processamento em lote com volume mais enxuto é abordado na configuração de extração para equipes pequenas. Quando o volume supera completamente a divisão manual, o caminho é escalar sem aumentar o quadro de funcionários.
Nada disso lança no razão, executa aprovações ou encaminha trabalho para pessoas individuais dentro da ferramenta. A API é a superfície de roteamento: se você quer atribuição automática, você a constrói contra a API. A ferramenta fornece a fila, o status e a tabela final. O fluxo de trabalho ao redor deles é seu, e esse é o ponto. Equipes que tratam o lote como um espaço de trabalho compartilhado mais um status consultável deixam de gastar energia de coordenação em "quem lembra o que está feito".
Processamento em Lote para Equipes: Perguntas Frequentes
Todos os membros da equipe precisam de um plano pago individual?
Não. O espaço de trabalho de equipe permite que um plano de equipe cubra vários membros. Os processadores entram com o código compartilhado, trabalham nos mesmos lotes na mesma conta e utilizam o pool de créditos compartilhado e a capacidade planejada centralmente da equipe, então a equipe não compra cinco assinaturas separadas.
Como sabemos quais documentos estão concluídos?
Pela API v1 você consulta o status de cada documento diretamente, e um webhook notifica você quando o processamento de um lote é concluído. Os estados concluídos vêm do registro em vez da memória, o que é toda a diferença entre cobrir um lote e torcer para que ele tenha sido coberto.
Usar a API exige um desenvolvedor?
A API exige algum script para ser chamada, pois retorna JSON. Uma primeira solicitação pode ser feita em cerca de cinco minutos copiando um exemplo documentado. Equipes sem desenvolvedor ainda obtêm a maior parte do benefício de cobertura com um espaço de trabalho compartilhado, onde todos veem a mesma fila, e podem deixar a automação completa da API para um momento em que ela se pague.
Duas pessoas ainda poderiam processar o mesmo arquivo?
Sim, se ambas correrem para o mesmo item antes de qualquer uma registrá-lo. A API torna essa corrida rara e visível: o roster e o status são consultáveis, então um processador pode verificar se um item já foi reivindicado antes de começar, e o histórico de status mostra quando uma duplicata aconteceu. Isso não impede que duas pessoas decidam pegar o mesmo item com cinco minutos de diferença, por isso fatiar as tarefas antecipadamente é o hábito mais forte.
Como identificamos documentos que ninguém pegou?
Execute a consulta de cobertura: todo item no roster que não tem estado concluído está não reivindicado. Fazer isso diariamente, em vez de torcer para que a pasta esteja completa, é o que transforma "todos terminaram?" em uma verificação de uma linha.
Para onde vão os dados finalizados?
Os resultados retornam como dados estruturados que você pode ler pela API ou exportar como uma planilha com as colunas definidas pelo proprietário do lote. A exportação é gerada em um formato nativo de planilha que posteriormente alimenta um sistema contábil ou uma planilha de conciliação; a ferramenta é a camada de extração, não o livro-razão.
A mudança é uma mudança de orientação. Uma equipe que coordena pela memória pergunta todo mês "alguém perdeu algo?" e espera a declaração do fornecedor para responder. Uma equipe que trata o status como uma consulta faz a mesma pergunta em uma única leitura e responde no mesmo dia. Configure seu próprio lote no espaço de trabalho compartilhado, puxe o roster pela API e veja se "quem fez o quê" pode deixar de ser uma conversa e passar a ser uma coluna.