ドキュメントバッチのチーム共有は簡単そうに見える
しかし、2人が同じ請求書を処理してしまう
共有ドキュメントバッチの失敗要因は速度ではありません。複数の担当者が請求書、契約書、経費報告書のバッチを分担するとき、発生する2つの失敗は、同じドキュメントが2回処理されることと、誰も手に取らないドキュメントが残ることです。公共機関を監査するワシントン州監査官事務所は、重複または誤った支払いの割合を0.8パーセントから2パーセントとし、その原因を明確に示しています。担当者がそれぞれ請求書を入力すると、同じ請求書を別の担当者が入力してしまうことがあるのです(WA State Auditor, 2022)。
重要ポイント
- 支払いの0.8〜2パーセントが重複または誤りであり、その原因は通常、2人が同じ請求書を入力することです。
- 重複とギャップは同じ問題です。バッチに項目ごとの所有者がなく、ステータスが記録ではなく共有の推測にすぎないからです。
- 共有ワークスペースと照会可能なステータスにより、カバレッジを計算に変えられます。完了状態のないロースター項目はすべて、所有者のない項目となります。
本当の失敗はスループットではなくカバレッジです
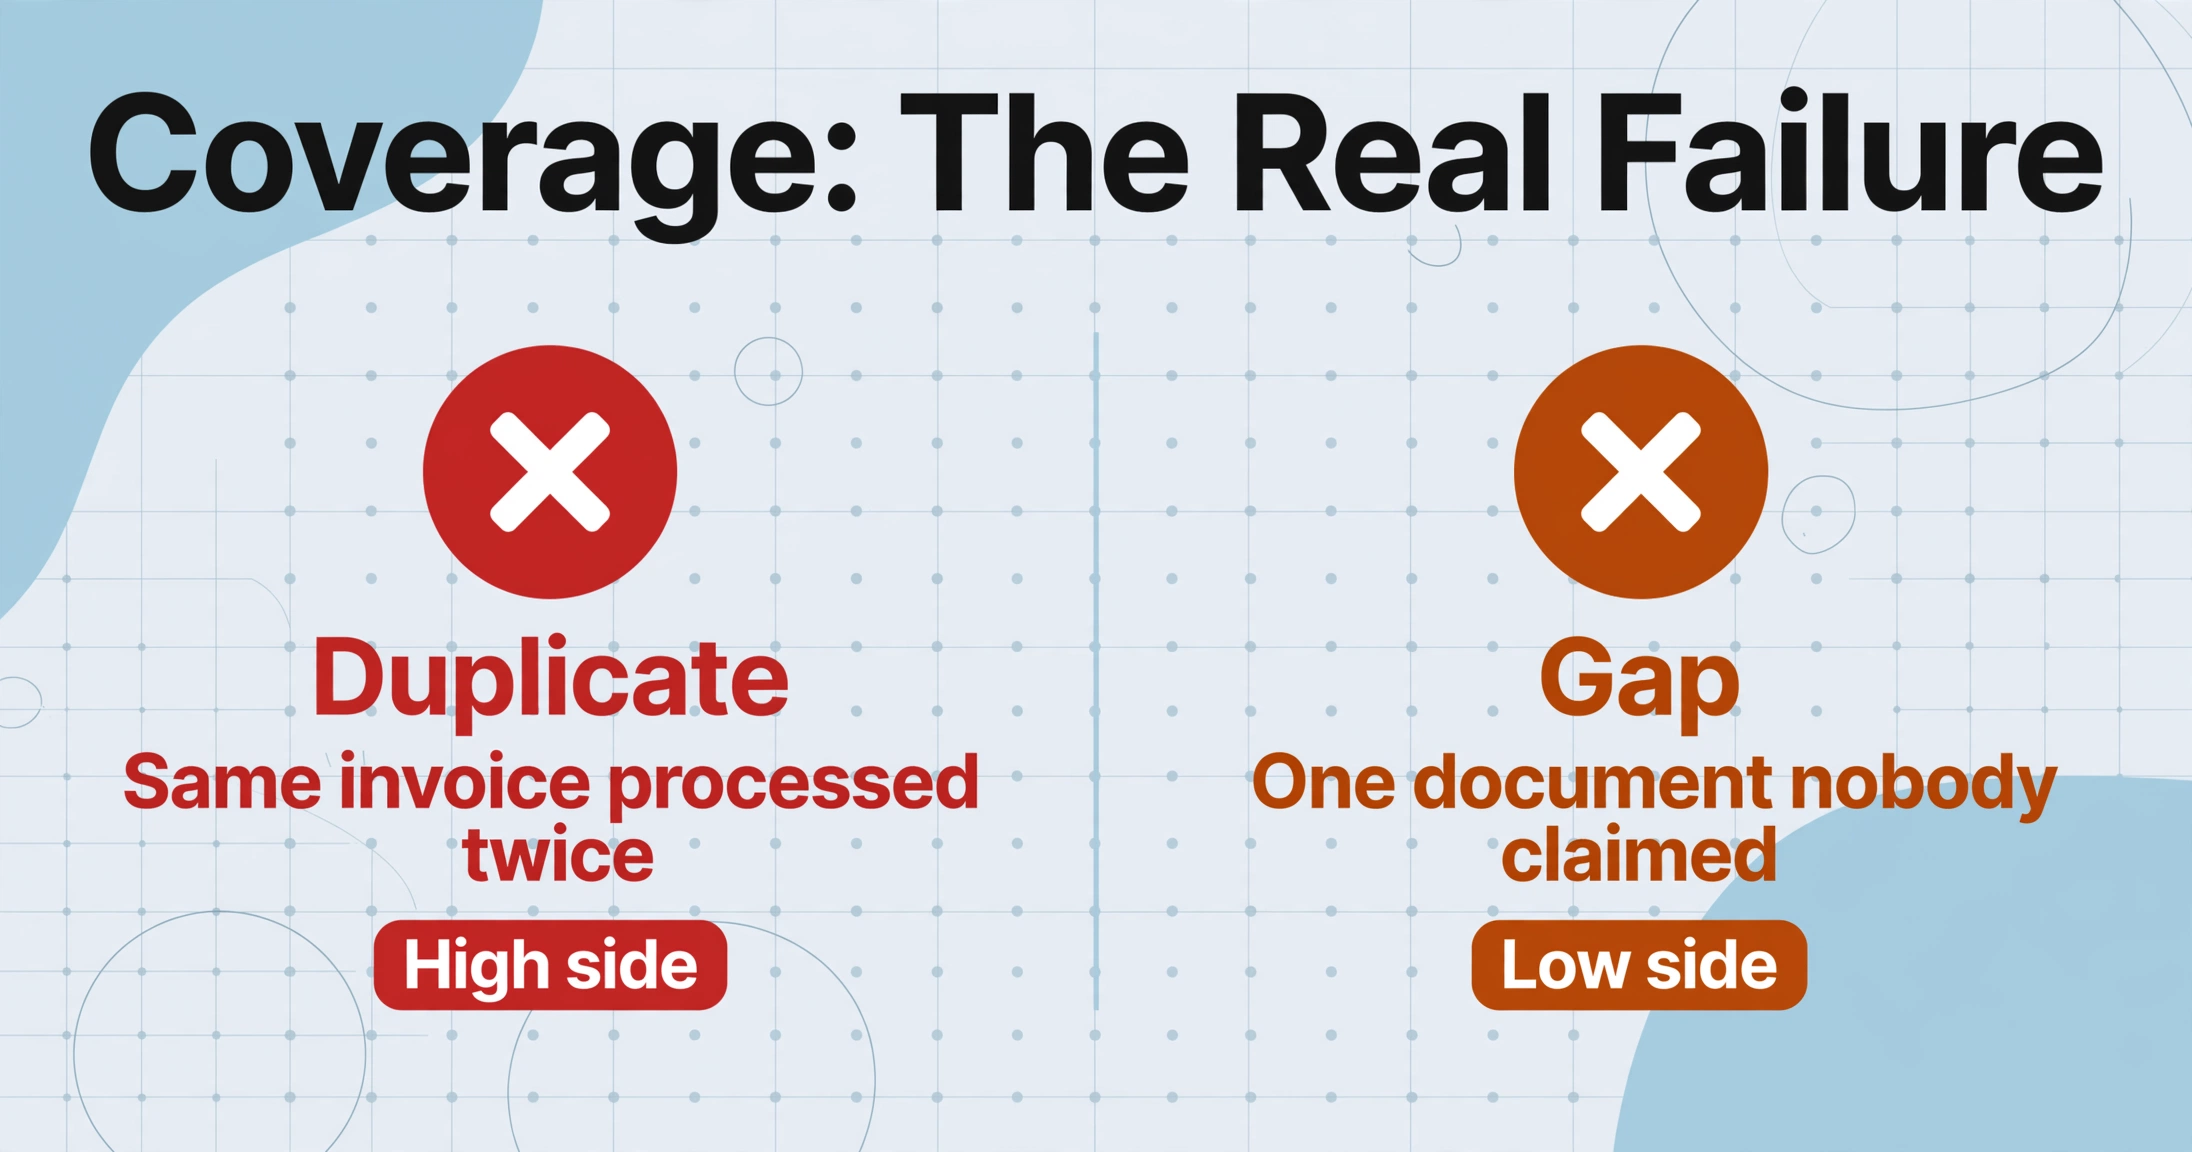
カバレッジとは、バッチ内のすべてのドキュメントが正確に1回だけ処理されるという性質です。重複は高すぎる側のカバレッジ失敗です。同じ請求書が2人によって処理され、2回抽出され、バッチ内で2回エクスポートされます。ギャップは低すぎる側のカバレッジ失敗です。バッチ内の1件のドキュメントを誰も担当せず、月末にベンダー明細が一致しないときに初めて発覚します。どちらも手戻りを生み、同じ病気の症状です。
そうしたチームの担当者は、この結果を大げさに語りません。中規模企業の買掛金を担当するr/QuickBooksのユーザーはこう書いています。「同じベンダー請求書が2回支払われた状況がありました」(r/QuickBooks、2025年)。r/Accountingでは、業務が崩壊しつつあった企業の担当者が低すぎる側をこう説明しています。「ますます多くの問題が明らかになり、クライアントが抜け落ちています」(r/Accounting、2025年)。
ドキュメントバッチはキューであり、各項目には正確に1つの所有者と1つの記録済み完了ステータスが必要です。それが問題のすべてです。スループットはより高速なツールで解決できます。カバレッジは、それに答えているものが何もないため、解決できません。
共有バッチに触れるのは誰か、「完了」が実際に存在する場所
分割されたバッチには3つの異なる役割が関わり、それぞれがキューに対して異なる関係を持ちます。
| 役割 | 実際に行うこと | 保持するもの |
|---|---|---|
| バッチ所有者 | 出力契約(処理済みの各ドキュメントが生成すべき列)を定義し、バッチを分割し、完了を確認し、期限を管理する | バッチに含まれる内容のマスターリスト(通常は共有フォルダまたはスプレッドシート) |
| 処理担当者 | バッチの一部を取得し、各ドキュメントをアップロードし、抽出されたデータを確認し、完了を確定する | 各自のローカルな「完了」リストと、進捗を報告する共有チャットスレッド |
| レビュー担当者 | 例外を発見し、複数人が触れた項目を解決し、エクスポート前にサンプルを検証する | システムに問い合わせるのではなく人に尋ねることで形成される、バッチへの信頼に関する判断 |
健全なリズムは次のようになります。所有者が文書化されたルール(到着順で最初の50件、担当者ごとに1ベンダー、担当者ごとに1地域)で分割し、各処理担当者が自分の担当分を処理し、期限までにレビュー担当者がマスターリストのすべての項目に完了状態があることを確認します。仕組みは単純です。リズムを左右するのは2つ目の質問です。「完了」は実際にどこに存在するのか。
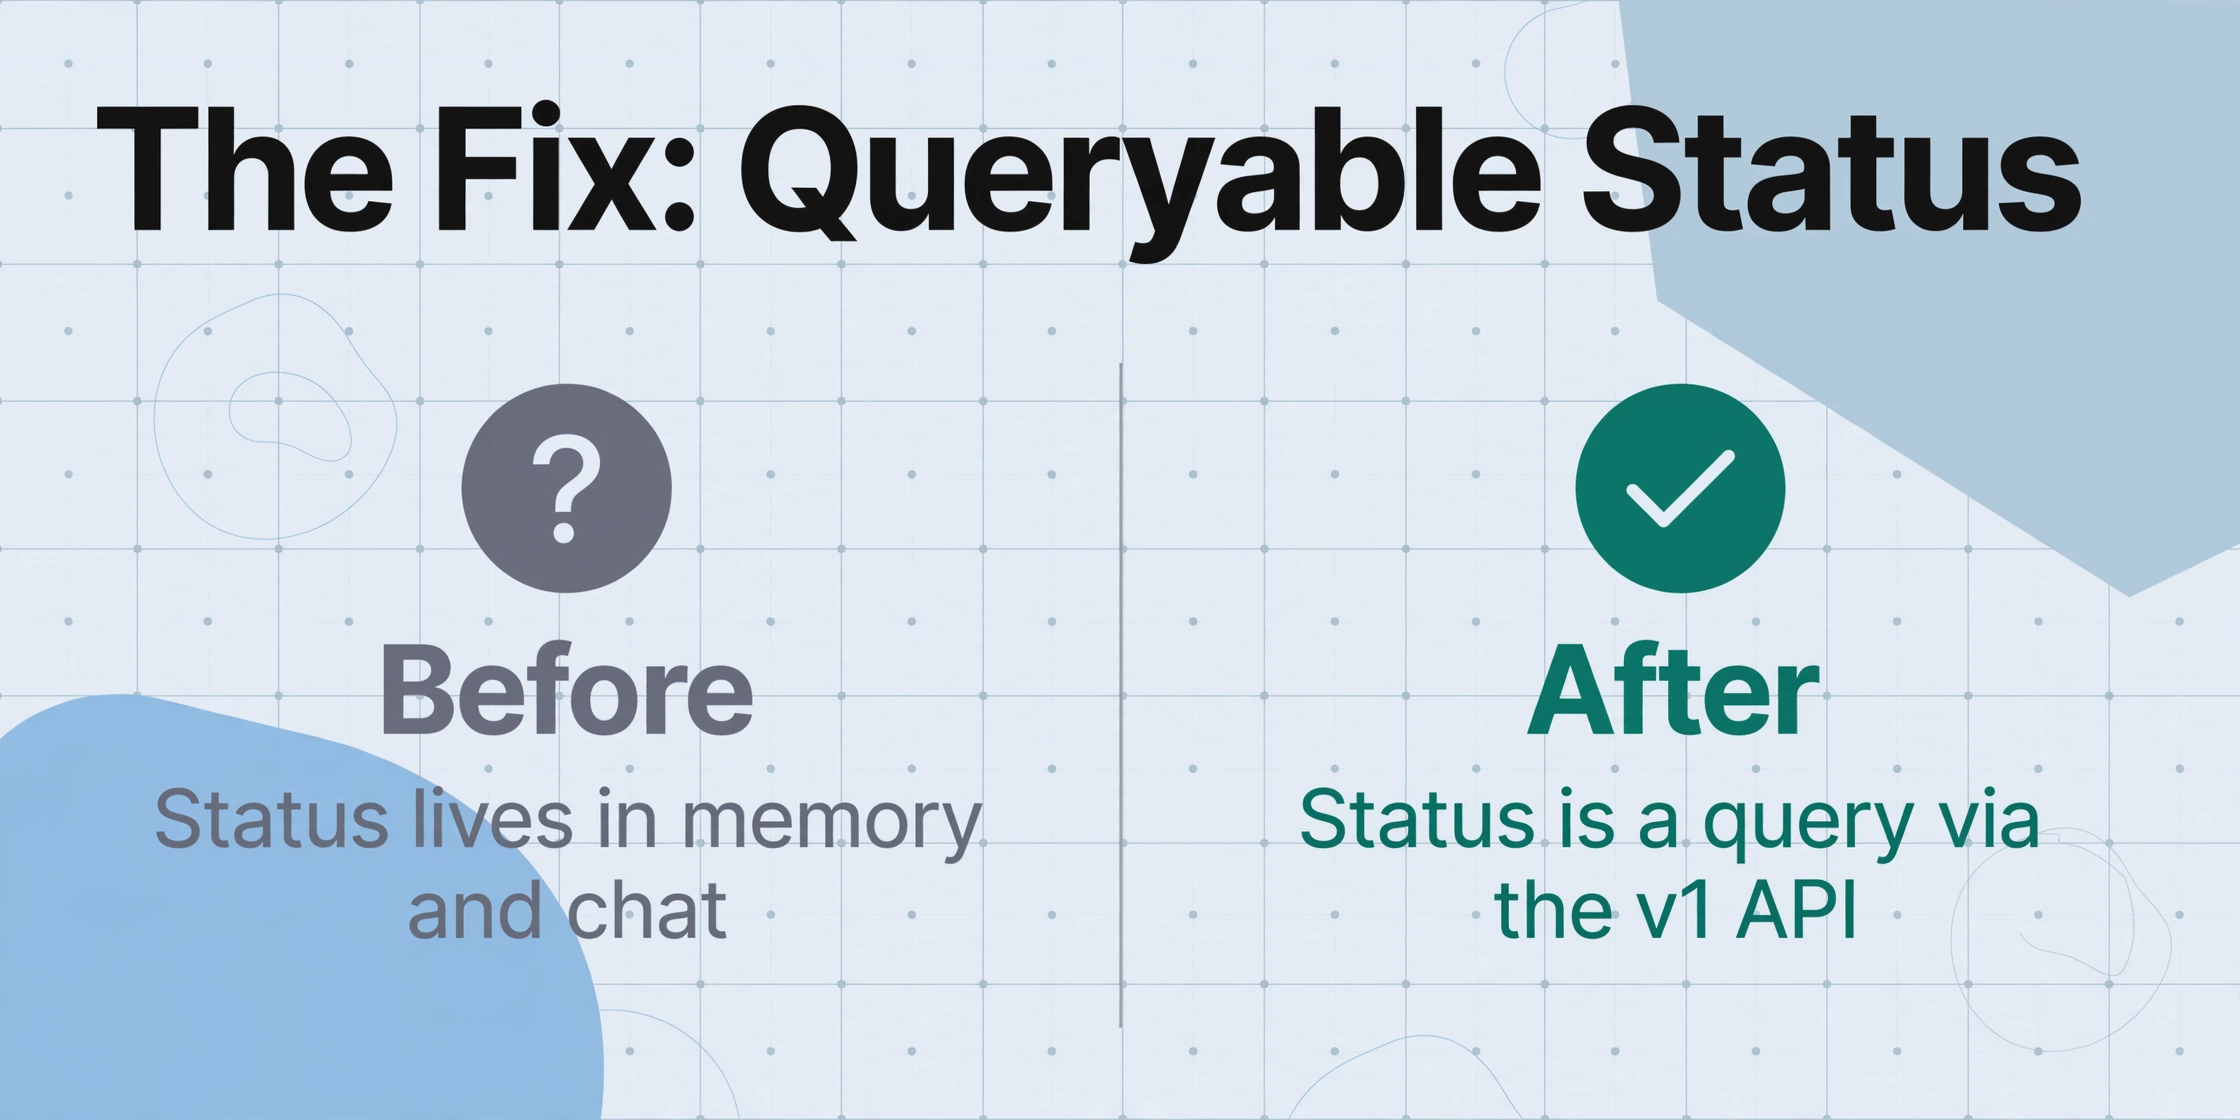
現在、ほとんどのチームでは、それは統合できない2つの場所に存在します。バッチ所有者の記憶の中に進行中の集計として存在し、チャットスレッドの中に「Metサプライヤーのスタックを引き受けました」「セット3は完了です」といった一連のメッセージとして存在します。どちらも締め切りの前夜の午後11時に確認できる記録ではありません。共有フォルダにはアップロードされた時点のファイルが表示されますが、処理された時点のものは表示されません。タスクトラッカーには所有者が入力した割り当てが表示されますが、処理担当者が実際に完了したドキュメントは表示されません。
同じドキュメントが二重処理され、別のドキュメントが漏れる理由
両方の障害は、1つの設計上の判断に起因します。バッチにはアイテム単位の所有権がなく、そのステータスは記録ではなく共有された推測にすぎません。
重複は競合状態によって発生します。2つのプロセッサがほぼ同時に同じ共有フォルダを確認し、両方とも同じ請求書に作業の明確な痕跡がないのを確認し、両方ともそれを処理することに決定し、両方とも処理します。それぞれがチェック可能な場所に記録する前に、自分の頭の中で「これを処理する」と状態を設定しました。システムが競合をフラグできるようになる頃には、作業は2回完了しています。
漏れはその鏡像によって発生します。すべてのプロセッサがドキュメントは誰か他の人のものだと想定します。所有者は誰かが気づいたと想定します。未請求のアイテムをフラグするものは何もないため、バッチ内の最後のアイテムが完了したときではなく、割り当てられた最後のスライスが完了したときにバッチは完了と宣言されます。r/Accountingで入力の混乱を説明しているユーザーは、根本的な状態を次のように言葉にしました。「クライアントは断片的に送ってきます。ここに請求書、あそこに契約書、税務書類は3週間前のメールにあり、すぐに混乱します」(r/Accounting, 2025)。
チームが頼るツールはこのループを断ち切りません。それぞれが状況の異なる半分を保持しているからです。Asana、Monday.com、Jiraはタスク層の記録です。タスクと締め切りを割り当てますが、バッチ内のドキュメントの状態は確認できません。そのため「タスク完了」はファイルについて何も教えてくれません。QuickBooks、Sage Intacct、Xero、NetSuiteなどの会計層は、完了したデータが置かれる場所ですが、「これは請求されたか」には答えても、「このスキャンに誰かが触れたか」には答えません。抽出ツールはドキュメントと処理状態を保持しますが、1人だけがキューを監視している場合、他の人は記憶に基づいて作業します。互いに相談しない、2つまたは3つの真実の記録です。
これは、まさにこの種のバックオフィスに関する文献で認識されているパターンです。ワシントン州監査官は、分散エントリを「料理人が多すぎる台所」と呼び、「異なる部門がそれぞれ同じ請求書を入力する」可能性があり、知らないうちにソフトウェアの制御を迂回すると述べています(WA State Auditor, 2022)。Deloitteの最新のGlobal Business Services Surveyによると、共有サービス組織は、改善された「エンドツーエンドの所有権」を中核的な目標として挙げています。所有権の不存在こそが、ここで説明されている障害そのものだからです。根本原因は、AIの欠如ではありません。割り当てと完了にシステム・オブ・レコードが与えられなかったプロセスです。
解決策:共有ワークスペースと照会可能なステータス
抽出ツールの2つの機能が、この2つの問題ステップに対応しており、それぞれに具体的な設定が用意されています。
1つ目の問題ステップ「このバッチを処理できるのは誰か、どの容量の下で処理するか」は、チームワークスペースが対応します。チームワークスペースは共有アカウント構造です。1つのチームプランが設定済みのメンバー上限を持つメンバーセットをカバーし、メンバーはオーナーが共有するコードで参加し、チームプランがバッチと処理容量を中央で設定し、全員の作業が1つの共有クレジットプールから消費されます。分割バッチに対する実際の変化は、4人の処理担当者全員が同じアカウントで同じバッチを処理することです。5つの別々の無料アカウントと5つの別々の上限はなくなり、「クォータにカウントされるように自分のアカウントに送って」というやり取りもなくなり、キューを見られるのが自分だけだからという理由で一人が人間ルーターになることもありません。
2つ目の問題ステップ「ステータスはどこに存在するか」は、v1 APIが解決します。v1 APIは抽出ツールの公開RESTインターフェースで、/developersにドキュメントがあります。自社システムからドキュメントをアップロードし、バッチ処理を開始し、ドキュメントごとのステータスと結果を取得し、処理完了時にウェブフック通知を受け取れるため、ポーリングの必要はありません。出力は構造化JSONで、ウェブアプリから独立しており、最初の呼び出しは約5分で動作するようになります。カバレッジにとって重要なのは、これが提供する特性です。アイテムごとのステータスが記憶ではなく照会になることです。
バッチロースターと完了状態の両方がプログラムで読み取り可能になると、カバレッジは感覚ではなく計算になります。ロースター上の完了状態のないすべてのアイテムは、所有者のないアイテムであり、分単位まで正確です。
実際のリズムに合わせて設定すると、月末バッチの請求書200件と処理担当者4人の場合、次のようになります。
ファイルは安全に処理され、保存されることはありません。
バッチに対してAPIルートとノーコードインターフェースのどちらが適しているかを判断するのは、それ自体がトレードオフです。ウェブアプリは開始が速く、APIは確認が速いという違いがあり、APIとノーコードの比較とAPIツールの比較で両方の側面を説明しています。抽出を内部ツールに直接取り込みたいチームは、OCR APIルートから始めます。この記事で説明するワークフロー(外部の人からドキュメントを収集してからバッチに到達させる)は、ドキュメント収集と抽出ワークフローで詳しく説明しています。
この設定でも自動化できないこと
正直な限界は、カバレッジを測定可能にすることはできても、判断を自動化することはできず、それ自体で責任を割り当てることもできないということです。
紛争のある項目を所有する人物は、依然として判断事項です。2人の処理担当者が同じ請求書に触れた場合、APIはステータストレイルに重複を表示しますが、どの結果を出荷するかを決定するのは誰かでなければなりません。それはバッチオーナーまたはレビュー担当者であり、どのツールもそれを排除できません。同様に、難しいドキュメントの抽出品質は人間の判断です。ツールが抽出し、レビュー担当者が出力がエクスポートに十分かどうかを決定します。カバレッジクエリは未請求リストを毎日可視化しますが、それを実行またはスケジュールするのは誰かでなければならず、ツールが催促することはありません。
分割自体は、その管理者の質に依存します。紙上で割り当てられたスライスがロースターと照合されないままになると、元の問題が再発します。タスクトラッカーとドキュメントステータスが再び通信しない2つのレコードになるからです。API統合を正当化するほどのボリュームがないチームにとっては、APIなしの共有ワークスペースで「5つの別々のアカウント」という層がすでに排除され、同じバッチファーストパターンをより少ないボリュームで適用する方法は小規模チームの抽出設定で説明しています。ボリュームが手動分割を完全に超えた場合の道筋は人員を増やさずにスケールするです。
これらすべてが行わないのは、元帳への転記、承認の実行、ツール内での個々の担当者への作業ルーティングです。APIはルーティング面です。自動割り当てが必要な場合は、APIに対して構築します。ツールはキュー、ステータス、完成したテーブルを提供します。それらの周りのワークフローはチームのものであり、それがポイントです。バッチを共有ワークスペースとクエリ可能なステータスとして扱うチームは、「誰が何を完了したかを覚えているか」という調整エネルギーを費やすことをやめます。
チームバッチ処理:よくある質問
チームメンバー全員に個別の有料プランが必要ですか?
いいえ。チームワークスペースでは、チームプラン1つで複数のメンバーをカバーできます。プロセッサーは共有コードで参加し、同じアカウントで同じバッチを処理し、チームの共有クレジットプールと中央で計画されたキャパシティを利用するため、チームが5つの個別サブスクリプションを購入する必要はありません。
どのドキュメントが完了したかをどうやって確認できますか?
v1 APIを通じてドキュメントごとのステータスを直接照会でき、バッチの処理が完了するとウェブフックが通知します。完了状態は記憶ではなくレコードから得られるため、バッチをカバーすることと、カバーされたことを期待することの違いはまさにここにあります。
APIの利用には開発者が必要ですか?
APIはJSONを返すため、呼び出しにはある程度のスクリプト作成が必要です。最初のリクエストは、ドキュメント化された例をコピーすれば約5分で実行できます。開発者がいないチームでも、共有ワークスペースでカバレッジのメリットの大部分を得られます。全員が同じキューを確認でき、APIの完全な自動化は、それが価値を生む時期まで先延ばしにできます。
2人の担当者が同じファイルを処理してしまう可能性はありますか?
はい、両方が記録する前に同じアイテムに競合した場合には起こり得ます。APIはその競合を稀にし、可視化します。ロースターとステータスは照会可能なため、プロセッサーは開始前にアイテムがクレーム済みかどうかを確認でき、ステータスの履歴は重複が発生した時期を示します。ただし、5分の間隔で2人が同じアイテムを担当すると決めるのを防ぐことはできないため、事前にスライスを割り当てることがより強力な習慣となります。
誰も取得しなかったドキュメントをどうやって見つけますか?
カバレッジクエリを実行してください。ロースター上で完了状態のないすべてのアイテムが未取得です。フォルダが完了していることを期待するのではなく、これを毎日実行することが、「全員が完了したか?」を1行のチェックに変える方法です。
完成したデータはどこに保存されますか?
結果は構造化データとして返され、APIで読み取るか、バッチ所有者が定義した列でスプレッドシートとしてエクスポートできます。エクスポートはスプレッドシートネイティブ形式で保存され、後で会計システムや照合シートに取り込まれます。このツールは抽出レイヤーであり、台帳ではありません。
この変化は考え方の転換です。記憶で調整しているチームは毎月「誰かが見落としたものはないか?」と尋ね、ベンダーの明細書を待って答えを出します。ステータスをクエリとして扱うチームは、同じ質問を一度の読み取りで行い、同じ日に答えを出します。共有ワークスペースで自分のバッチを設定し、APIでロースターを取得し、「誰が何をしたか」が会話ではなく列になるかどうかを確認してください。