Como Extrair Dados de Currículos para o Excel
em Recrutamento (Guia 2026)
A maioria dos recrutadores não tem um problema de análise de currículos. Eles têm um problema de planilha. Depois que sites de vagas, anexos de e-mail e indicações internas despejam dezenas de PDFs na caixa de entrada, alguém precisa transformar esses currículos em uma planilha de acompanhamento de candidatos — e a resposta padrão ainda é copiar e colar manualmente. E se essa resposta custasse mais do que a própria contratação?
Principais Conclusões
- 40 currículos levam de 2 a 4 horas de cópia e colagem manual — e um endereço de e-mail digitado errado perde o candidato por completo.
- Os parsers de ATS leem currículos por posição, então um layout de duas colunas insere as habilidades da sua barra lateral diretamente no seu histórico profissional.
- Defina suas colunas uma vez, insira qualquer formato de currículo e obtenha uma planilha de candidatos filtrável sem tocar em uma API de parser.
A Planilha Por Trás de Cada Decisão de Contratação
Todo processo de recrutamento, seja conduzido por uma equipe de talentos da Fortune 500 ou por uma startup de cinco pessoas, acaba convergindo para um único artefato: uma planilha de candidatos. Nomes na coluna A. Cargos atuais na coluna B. Origem — LinkedIn, indicação, site de vagas — na coluna C. Habilidades e anos de experiência distribuídos pelas colunas D a H.
Para empregadores de pequeno e médio porte que não podem justificar um ATS (Applicant Tracking System) corporativo, essa planilha é toda a sua infraestrutura de recrutamento. É onde os candidatos são classificados, onde as datas de acompanhamento são registradas e onde os gestores de contratação são informados. O problema é que construí-la — linha por linha, currículo por currículo — é a etapa que mais consome tempo em todo o funil de contratação. Formulários de candidatura em papel e PDF se somam à mesma pilha, e converter um formulário de candidatura para Excel traz nome do candidato, histórico profissional, formação e referências para a planilha de candidatos junto com os dados do currículo.
A SHRM estima o custo médio por contratação em aproximadamente $4.700, com um tempo de preenchimento de 33 dias em todos os setores (SHRM Benchmarking). Isso não são apenas taxas de publicidade e agências. Uma parte significativa são horas de recrutador — horas gastas em tarefas como copiar dados de currículos para planilhas de acompanhamento, uma etapa que não agrega valor estratégico mas consome dólares reais de folha de pagamento.
O ponto não é que planilhas sejam ruins. É que preenchê-las manualmente a partir de documentos não estruturados é caro de uma forma que escala com o volume — e a maioria das equipes de recrutamento não tem uma alternativa clara.
O Que a Entrada Manual Realmente Custa a uma Equipe de Recrutamento
Aqui está a aritmética que ninguém faz até que um acúmulo force. Um recrutador abrindo um pipeline de 40 candidatos gasta cerca de 3 a 6 minutos por currículo extraindo campos-chave para uma planilha de acompanhamento — nome, e-mail, telefone, cargo atual, empresa, anos de experiência, formação, principais habilidades e origem. Com 40 candidatos, isso são 2 a 4 horas de pura entrada de dados.
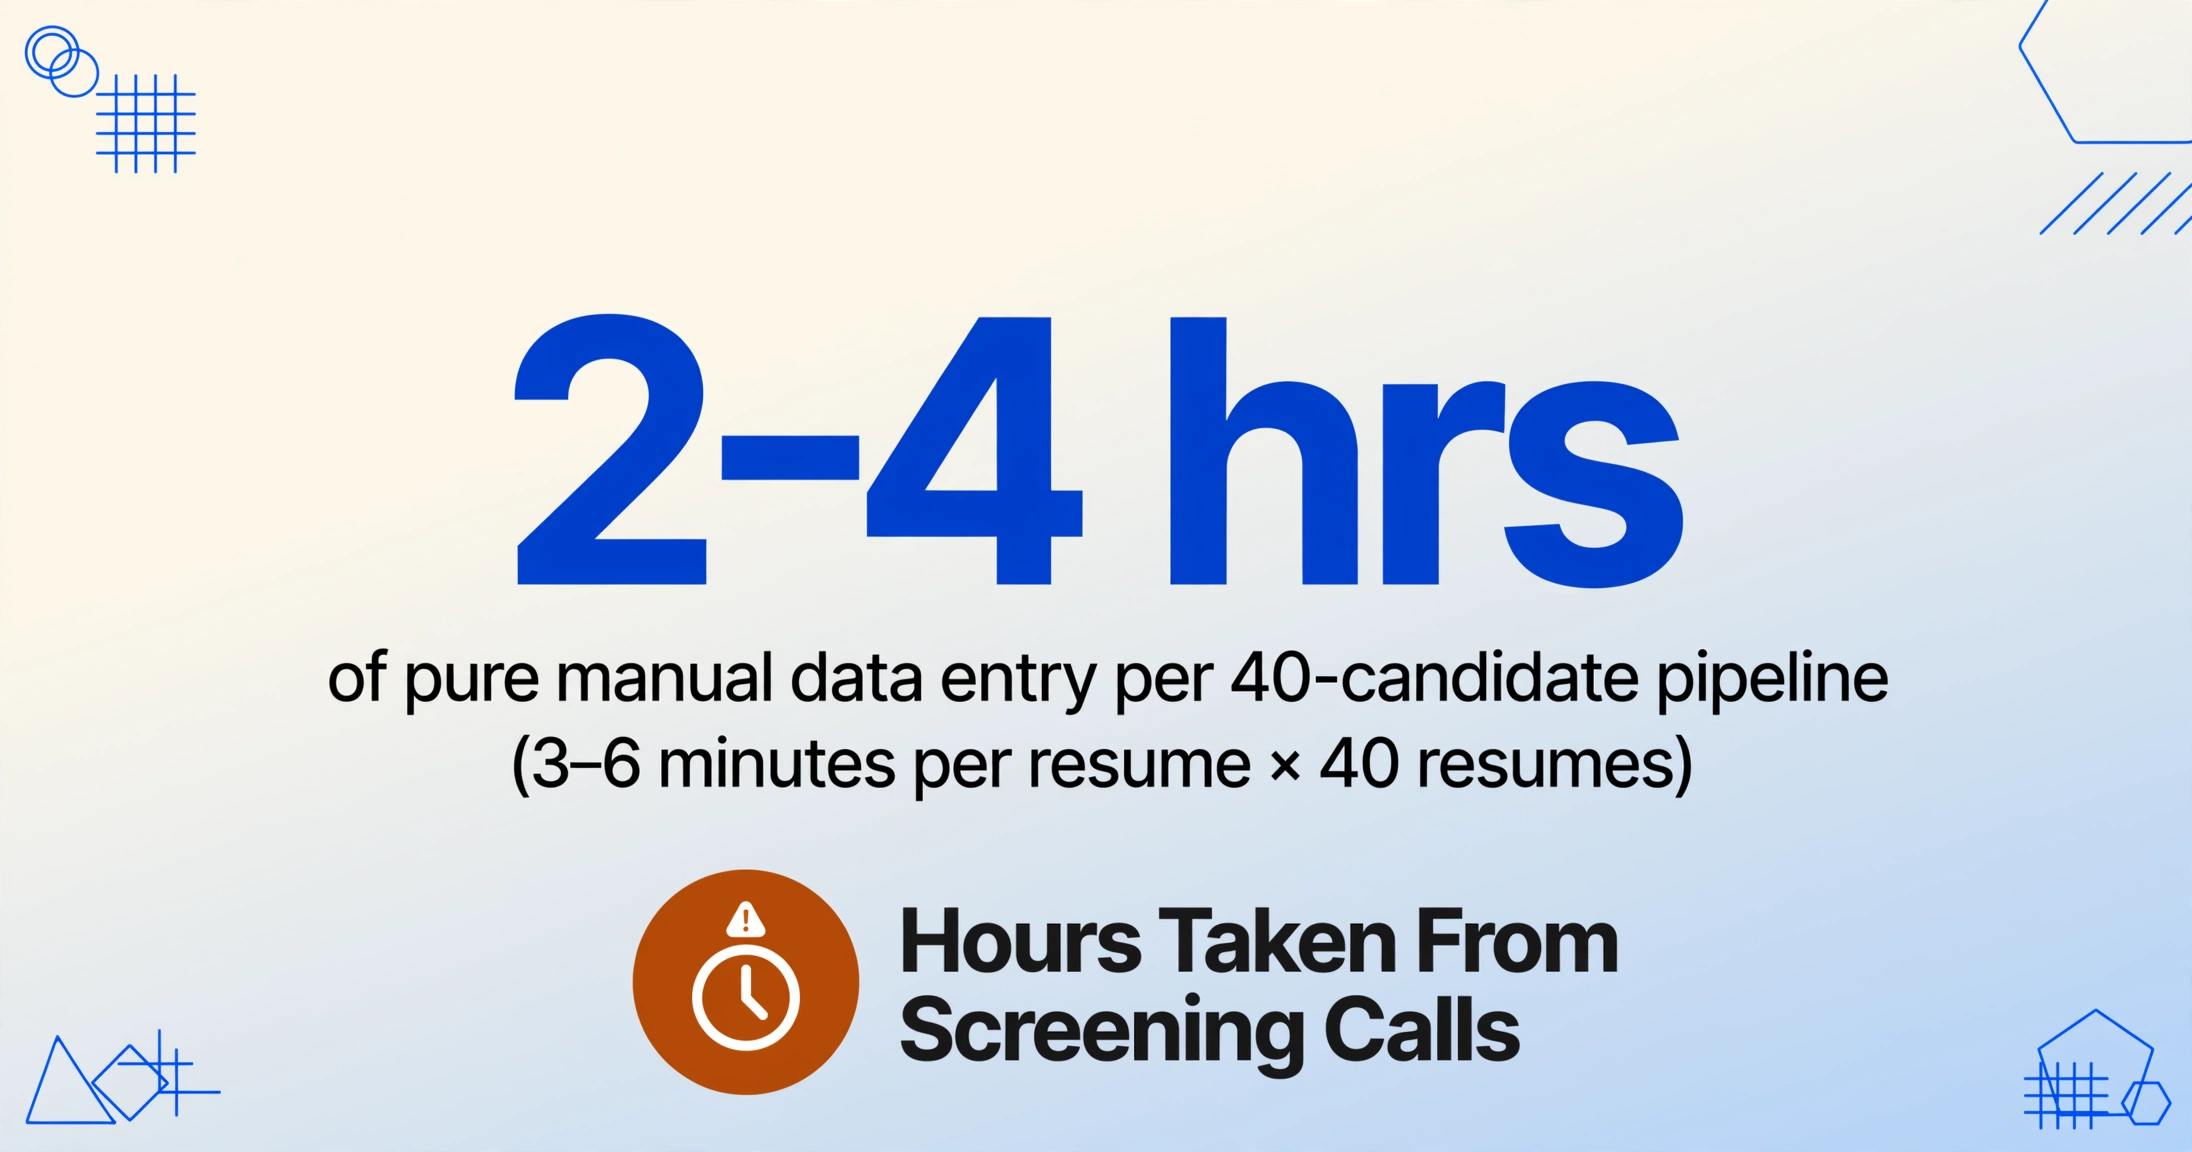
Mas não é só tempo. É aquilo em que esse tempo deveria ter sido gasto: chamadas de triagem, sincronizações com gestores de contratação, busca de candidatos passivos. Essas são as atividades que realmente fazem uma contratação avançar. A entrada de dados é um imposto sobre todas elas.
A taxa de erro também importa. Um endereço de e-mail digitado errado significa que um candidato nunca recebe um convite para entrevista. Um número de telefone transposto desperdiça o tempo do gestor de contratação. Uma habilidade que não foi copiada porque estava listada em uma barra lateral passa despercebida no filtro da primeira rodada. Quando a planilha se torna a única fonte de verdade para decisões de contratação, a qualidade dessa planilha impacta diretamente a qualidade dessas decisões.
Para contexto: o padrão do setor para preços de API de análise de currículos varia de $0,05 a $0,30 por currículo através de ferramentas especializadas como Textkernel (Sovren), RChilli, Daxtra e Affinda. Isso pode parecer barato — até você estar pagando uma taxa por documento além de uma assinatura de ATS, e ainda gastando tempo corrigindo erros de análise em layouts de várias colunas.
O Registro do Candidato: O Que Extrair de um Currículo
Antes de extrair qualquer coisa, você precisa definir o que "um registro de candidato" realmente significa para o seu processo de contratação. O erro que a maioria das equipes comete é extrair tudo — copiando históricos profissionais inteiros literalmente — quando o trabalho da planilha é filtrar e comparar, não arquivar.
Aqui está o conjunto principal de campos que vale a pena extrair para uma planilha prática de acompanhamento de candidatos. (Se você está lidando com dezenas ou centenas de currículos, veja nosso guia de processamento de currículos em lote para lidar com volume, caos de nomes de arquivos e estratégias de mesclagem.)
| Campo | Por Que Ele Pertence à Planilha |
|---|---|
| Nome do Candidato | Identificador principal. O único campo que você não pode errar. |
| Canal de contato. Digite errado e você perdeu o candidato. | |
| Telefone | Ligações de triagem e agendamento por SMS. O formato varia por país. |
| Cargo Atual | A triagem inicial mais rápida: o cargo mais recente corresponde à vaga? |
| Empresa Atual | Contexto do setor. Um "Engenheiro de Software" no Google versus em uma agência de 10 pessoas significa coisas diferentes. |
| Anos de Experiência | Uma coluna inferida: a IA lê o histórico profissional e calcula o total de anos, mesmo que o currículo liste apenas intervalos de datas. |
| Formação / Diploma | Diploma mais alto + área. Menos relevante na contratação por competências, mas ainda um filtro comum. |
| Principais Competências | Competências técnicas e comportamentais. A NACE relata que 64,8% dos empregadores agora usam práticas de contratação por competências, com dois terços aplicando-as na etapa de triagem (NACE Job Outlook 2025). Esta coluna é o filtro mais importante no pipeline moderno. |
| Período de Aviso Prévio | Crítico para o planejamento do cronograma. "Disponível imediatamente" versus "aviso prévio de 3 meses" muda a lista final. |
| Origem | De onde veio o currículo: LinkedIn, indicação, site de vagas, agência. Essencial para medir o ROI do canal. |
| Etapa do Pipeline | Atualizada manualmente após a extração: Inscrito, Triado, Entrevista, Oferta, Contratado. Transforma a planilha em um ATS leve. |
A decisão de design principal: você está extraindo o que precisa comparar, não o que poderia extrair. Cada coluna que não ajuda a filtrar ou classificar candidatos é uma coluna que adiciona tempo de extração e ruído visual.
Uma coluna que merece atenção especial é Anos de Experiência. Ela raramente é listada como um único número em qualquer currículo — está embutida em vários intervalos de datas na seção de histórico profissional. Com uma coluna calculada, a IA analisa cada período de emprego, calcula o total e gera um único número. Você define a coluna como "Anos de Experiência (soma de todos os períodos de emprego)" e a IA cuida da aritmética durante a extração — sem pós-processamento no Excel.
Como Extrair Dados de Currículos para o Excel, Passo a Passo
O principal desafio da extração de currículos não é a tecnologia — é a diversidade de layouts. Um currículo de um designer gráfico tem barras laterais, ícones e layouts de duas colunas. Um CV de um acadêmico chega a quatro páginas. Um PDF exportado do LinkedIn tem uma estrutura completamente diferente. Parsers baseados em modelo falham nisso porque são treinados com uma expectativa de layout fixo. A extração semântica — em que a IA lê pelo significado e não pela posição — é o que faz esse fluxo de trabalho funcionar em todos os formatos.
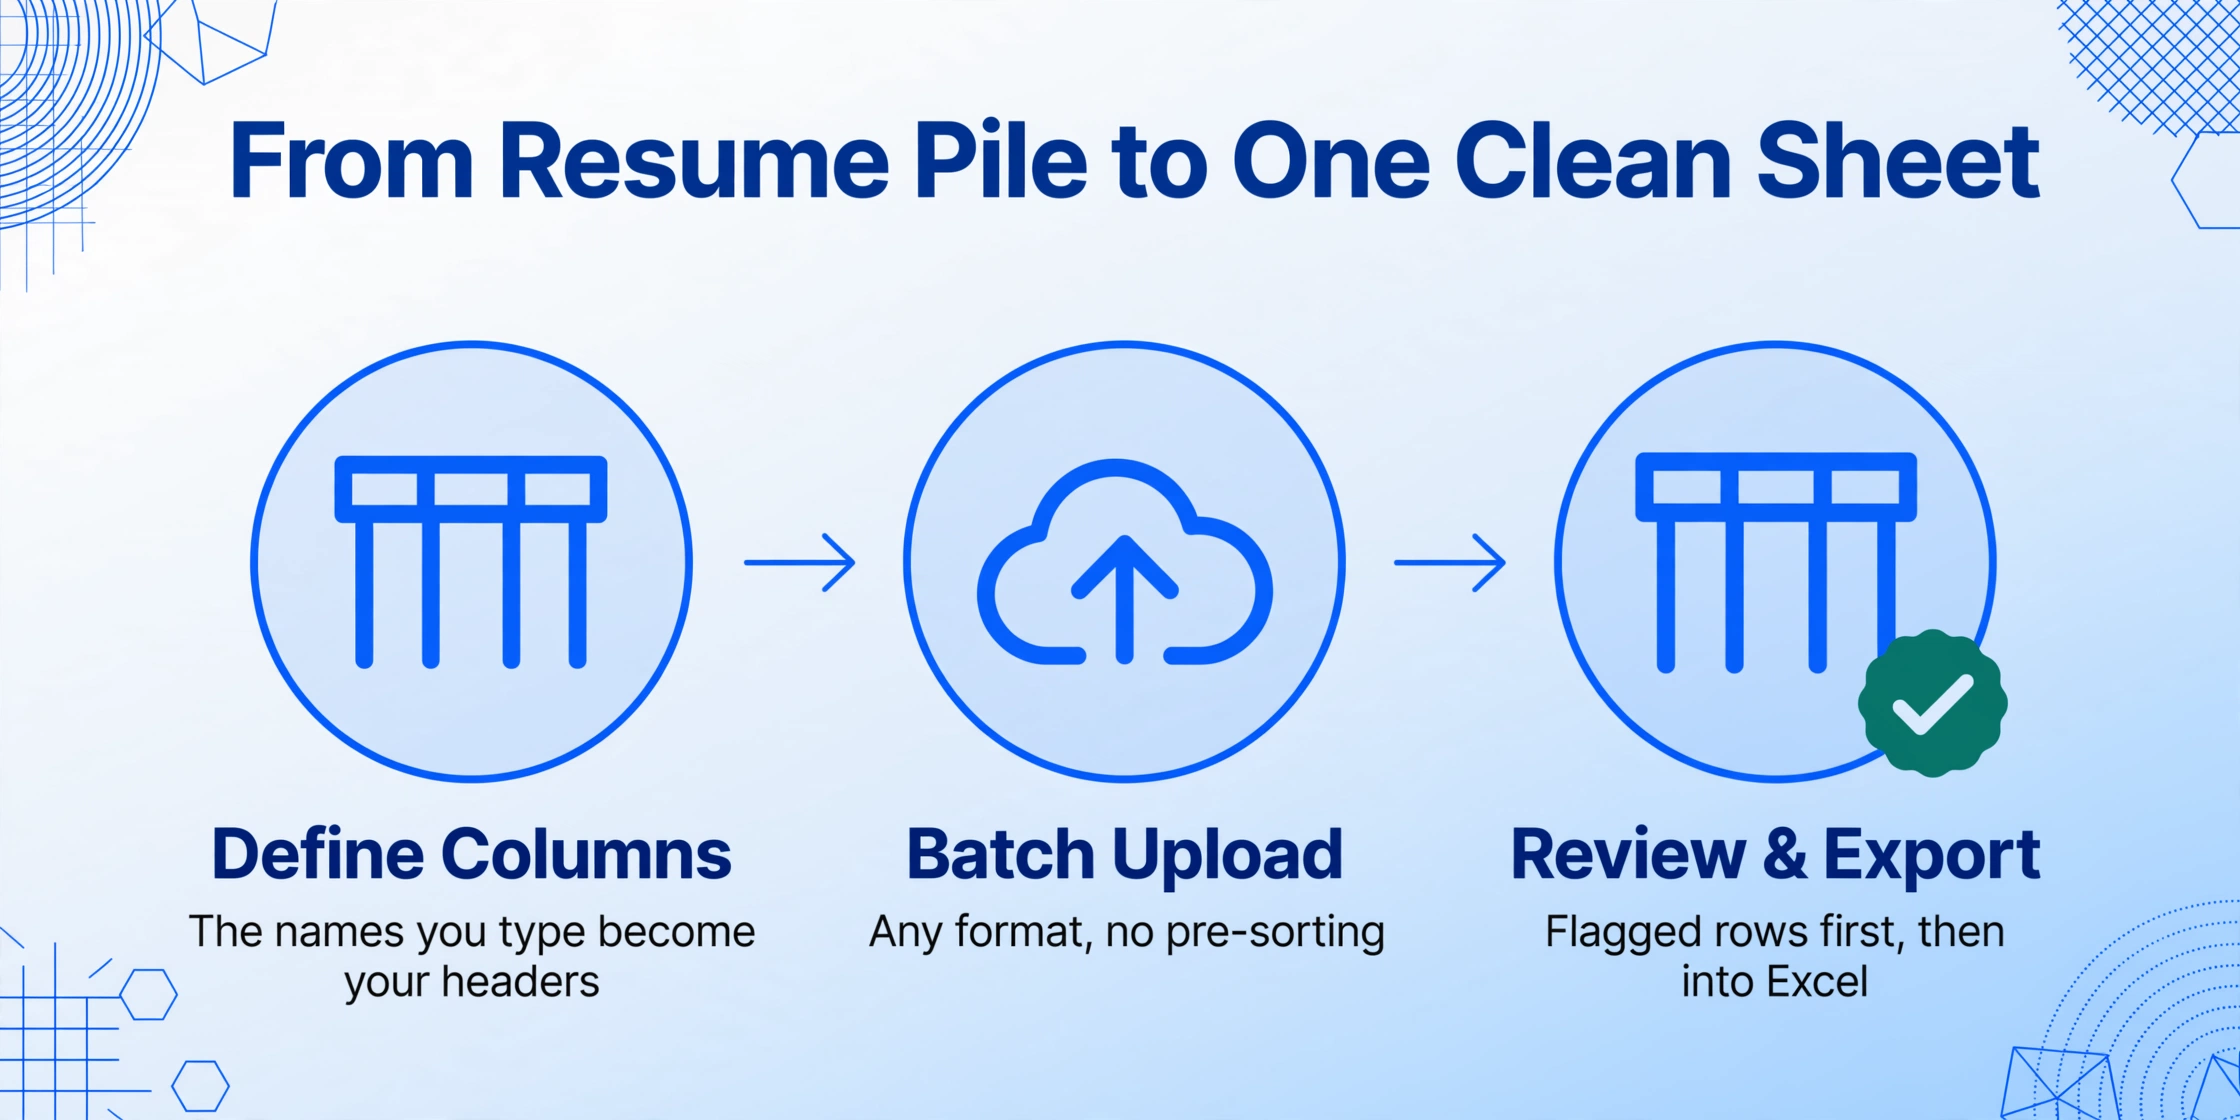
O ImageToTable.ai usa Extração de Colunas Personalizadas: você digita os nomes dos campos que deseja — "Nome do Candidato", "E-mail", "Principais Habilidades", "Anos de Experiência" — e a IA localiza cada valor em qualquer lugar de cada currículo entendendo o que o campo significa, não onde ele está. Os nomes das colunas que você digita se tornam os cabeçalhos da sua planilha de saída.
Etapa 1: Defina Suas Colunas
Comece com a lista de campos da seção acima e depois ajuste conforme os requisitos da sua função. Para uma contratação técnica, adicione linguagens de programação e certificações. Para uma função de vendas, adicione cumprimento de metas e território. As colunas que você define determinam o que você poderá classificar, filtrar e comparar em todo o seu conjunto de candidatos.
Etapa 2: Faça o Upload de Todos os Currículos em Lote
Arraste todos os currículos — PDFs, documentos do Word, capturas de tela, exportações do LinkedIn — para a área de upload. Não há limite de formatos e não é preciso pré-organizar por layout. A IA processa cada documento de forma independente e mapeia os valores extraídos para as colunas que você definiu.
Etapa 3: Revisar e exportar para Excel
Depois que o processamento termina, você recebe uma única tabela com uma linha por candidato e uma coluna por campo. Antes de exportar, passe o mouse sobre qualquer célula extraída para ver exatamente de onde, no currículo original, veio aquele valor — uma caixa delimitadora destacada no documento de origem oferece confirmação visual em segundos. Depois, exporte para Excel (XLSX) e ele estará pronto para filtrar, ordenar e compartilhar com a equipe de recrutamento.
Os arquivos são processados com segurança e não são armazenados.
Quando os parsers leem o currículo errado: layouts que quebram ferramentas posicionais
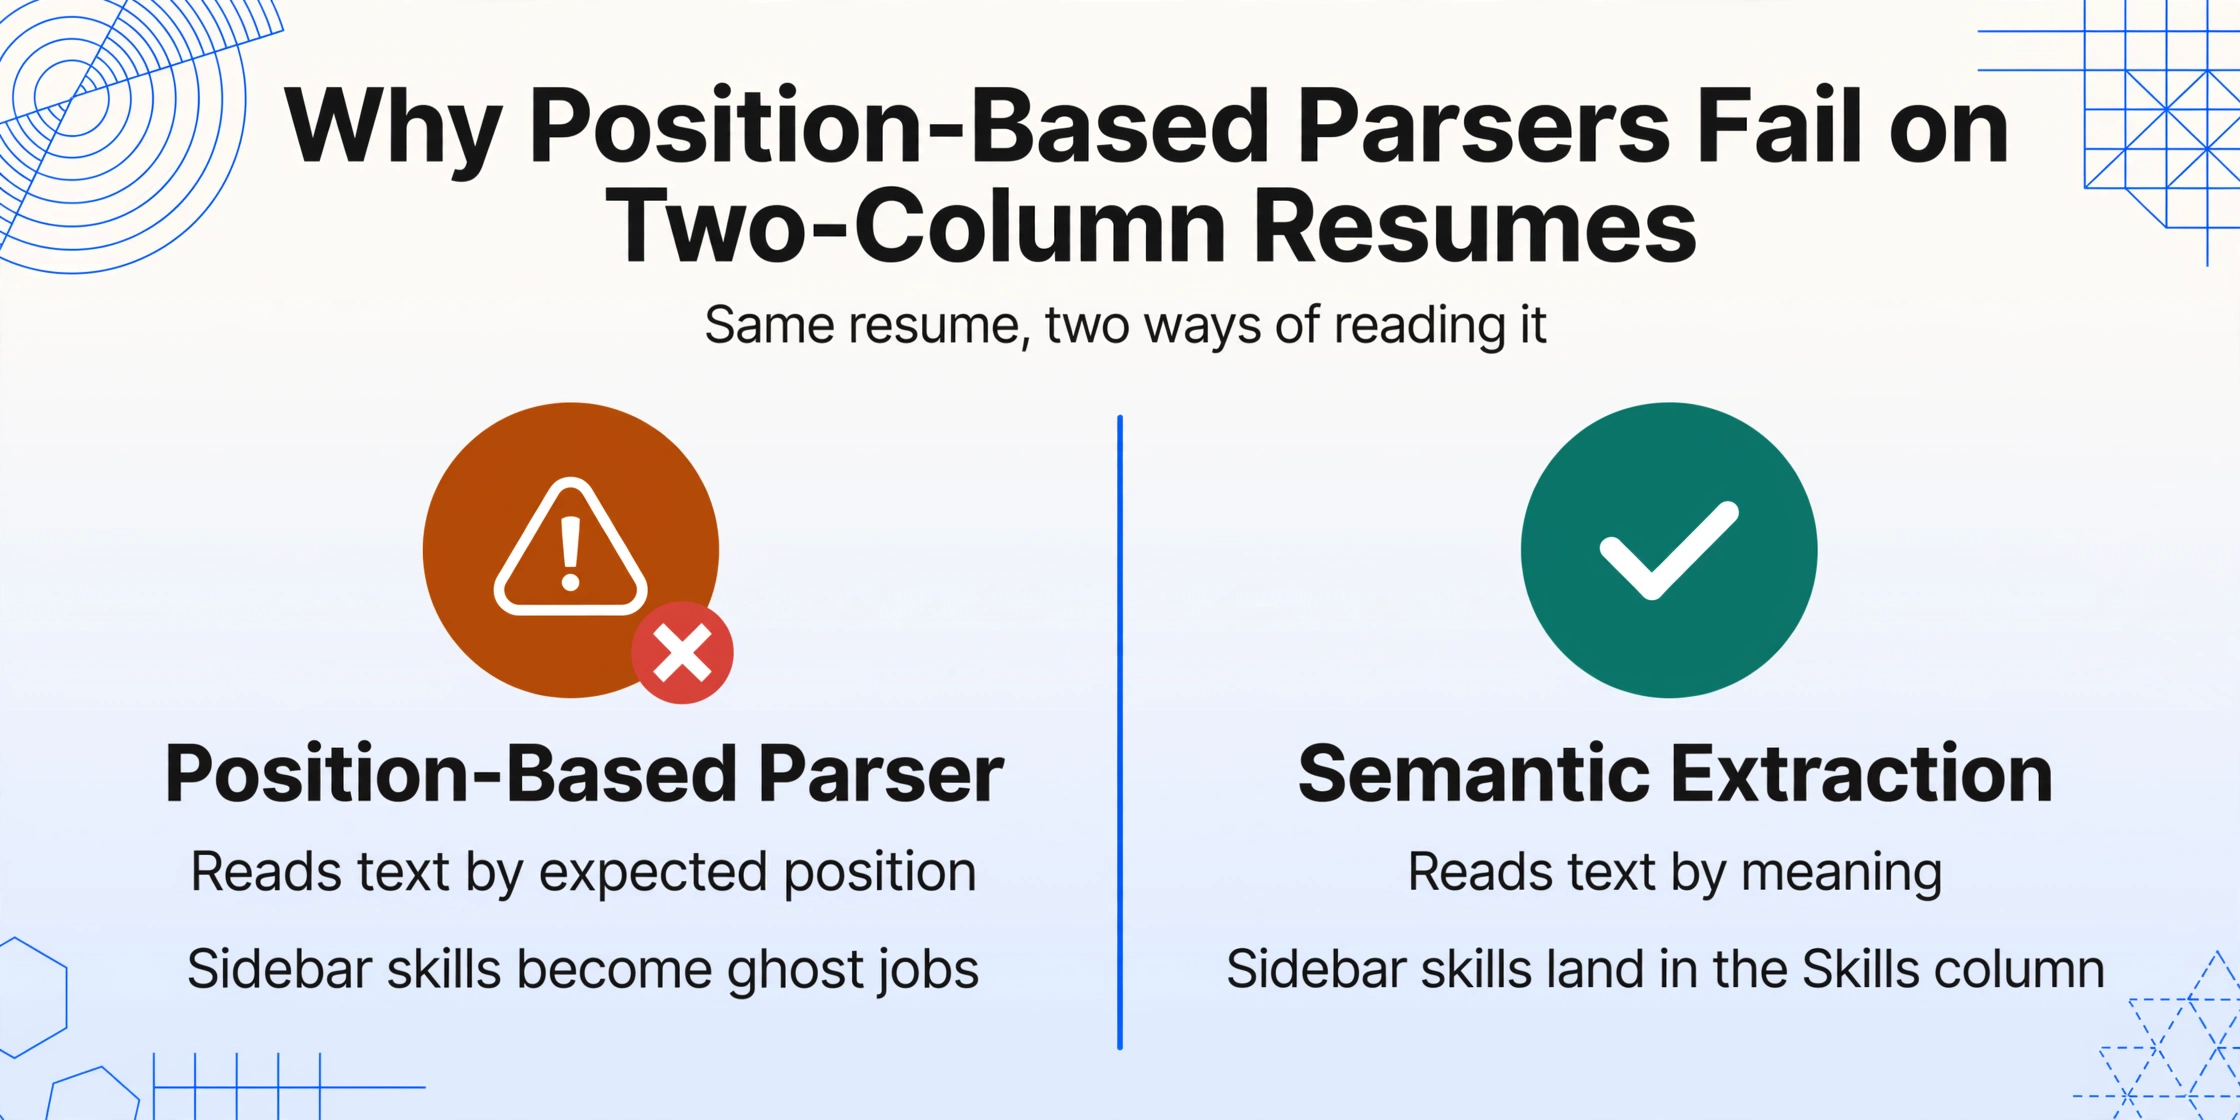
Parsers de currículo baseados em posição — o tipo embutido na maioria das plataformas de ATS — funcionam procurando texto em locais esperados. Uma seção de contato no topo. Histórico profissional no meio. Formação na parte inferior. Quando um currículo segue esse modelo, o parser funciona. Quando não segue, o resultado varia de sutilmente errado a comicamente inutilizável.
No r/recruiting do Reddit, um recrutador descreveu o que acontece quando um sistema com tecnologia Phenom encontra um currículo de duas colunas: "O perfil no CRM me disse que a pessoa era barista em uma fábrica da GM" — a seção de habilidades da barra lateral foi mesclada ao histórico profissional principal, produzindo uma trajetória de carreira sem sentido (r/recruiting). Outro relatou que inserir informações de autorização no formulário de candidatura do Workday fez "seu nome aparecer como nome clearance" — o delimitador de campo quebrou com uma entrada inesperada.
"O Greenhouse funciona igual a todos os outros", concluiu o mesmo tópico. "ATS significa Applicant Tracking System. Nada de especial nisso." Os parsers integrados não estão quebrados — eles apenas são posicionais em um mundo de documentos não posicionais.
Modos de falha comuns em parsers baseados em posição:
- Layouts de duas colunas: O conteúdo da barra lateral (habilidades, idiomas, certificações) é lido como histórico profissional em linha, criando empregos fantasmas e empregadores fantasma.
- Formatação criativa: Currículos de designers gráficos com cabeçalhos de seção baseados em ícones, barras de avaliação de habilidades e visualizações de linha do tempo produzem sequências de texto embaralhadas.
- Conteúdo de cabeçalho/rodapé: URLs do LinkedIn, links de portfólio e números de página colocados em cabeçalhos são mesclados ao bloco de texto mais próximo.
- Documentos de várias páginas: CVs acadêmicos com 4+ páginas frequentemente têm quebras de seção que redefinem as suposições posicionais do parser no meio do documento.
A extração semântica evita essas falhas por não depender de posição alguma. A IA lê o documento como um humano faria — entendendo que "Educação" é uma seção, não uma coordenada, e que habilidades listadas em uma barra lateral são categoricamente diferentes do histórico de emprego listado no corpo principal. Isso não significa 100% de precisão em todo layout criativo — anotações manuscritas nas margens ou tipografia muito estilizada ainda apresentam desafios — mas elimina o modo de falha estrutural que torna os parsers baseados em posição não confiáveis em formatos variados de currículo. Para uma comparação detalhada de APIs de parsing versus extração semântica por IA — incluindo preço por documento, esforço de configuração e qual abordagem se adequa à sua equipe — leia nossa comparação entre parsing de currículo e extração por IA.
Transformando a Planilha em um Pipeline de Candidatos
Depois que os dados extraídos estão no Excel, a planilha deixa de ser um depósito de dados e passa a ser uma ferramenta de recrutamento leve. (Se você prefere uma página de ferramenta dedicada com demonstração, experimente nossa ferramenta de extração de dados de currículo para Excel.) Veja como as melhores equipes operacionalizam isso:
Adicione uma coluna de status. "Inscrito", "Triado", "Primeira Entrevista", "Segunda Entrevista", "Oferta", "Contratado" — atualize manualmente conforme os candidatos avançam pelas etapas. Ordene por status para ver todo o seu pipeline de relance.
Acompanhe a atribuição de origem. A coluna "Origem" permite calcular quais canais produzem os melhores candidatos. Contratações por indicação superam consistentemente as contratações por sites de vagas em retenção — mas você não pode provar isso sem rastrear de onde veio cada currículo.
Use os filtros nativos do Excel. Filtre por "Principais Habilidades" contendo "Python" e "Anos de Experiência" > 3. Filtre por "Período de Aviso" contendo "imediatamente" para pré-selecionar candidatos que podem começar rápido. Essas são exatamente as operações pelas quais um ATS dedicado cobra — executadas nativamente dentro de uma planilha.
Colete currículos de várias fontes. Se gerentes de contratação, recrutadores externos ou indicações de funcionários enviarem currículos de candidatos por e-mail, use um Link de Coleta (uma página de upload compartilhável que alimenta diretamente sua fila de processamento) ou Email Inbox (encaminhe currículos e eles chegam à fila automaticamente). Ninguém mais precisa de uma conta — basta enviar os arquivos.
Importe para o seu ATS. Greenhouse, Lever, Workday, iCIMS, BambooHR e a maioria das outras plataformas suportam importação de CSV de dados de candidatos. Extraia para o Excel primeiro, limpe e normalize os dados uma vez, depois importe — mais rápido e mais confiável do que depender do parser de currículo integrado de cada plataforma.
Tratamento responsável dos dados de candidatos: EEOC, GDPR e retenção
Quando você extrai dados de candidatos para uma planilha, está criando um banco de dados de informações pessoais sujeito a regulamentações trabalhistas e de privacidade. Isso não é uma preocupação secundária de RH — é parte central do fluxo de trabalho.
Nos Estados Unidos, ferramentas de triagem de currículos com IA ou automatizadas se qualificam como "procedimentos de seleção" segundo o Título VII da Lei dos Direitos Civis de 1964. As Diretrizes Uniformes do EEOC sobre Procedimentos de Seleção de Funcionários (UGESP) aplicam a regra dos quatro quintos: se a taxa de seleção de qualquer grupo protegido for inferior a 80% da taxa do grupo com maior seleção, isso é uma constatação preliminar de impacto adverso (EEOC Título VII). Para equipes de recrutamento que usam dados extraídos para filtrar candidatos, a conclusão prática é: documente seus critérios de filtragem. Se você filtra por "Anos de Experiência > 3" ou "Diploma = Bacharelado", esteja preparado para demonstrar que esse critério é relacionado ao cargo e consistente com a necessidade do negócio.
Para equipes que recrutam na UE ou no Reino Unido, o Artigo 22 do GDPR restringe decisões baseadas unicamente em processamento automatizado, e o Artigo 35 exige uma Avaliação de Impacto sobre a Proteção de Dados (DPIA) para processamento de alto risco de dados pessoais — o que a triagem sistemática de candidatos se qualifica como. O ICO do Reino Unido e as autoridades de proteção de dados da UE geralmente recomendam reter dados de candidatos não aprovados por no máximo 6 a 12 meses após o término do processo de recrutamento, a menos que o candidato dê consentimento explícito para retenção por mais tempo.
No lado operacional: minimização de dados significa extrair apenas os campos necessários para a decisão de contratação — não cada linha de cada histórico profissional. O Review Mode com verificação visual por caixa delimitadora permite confirmar o que foi extraído e de onde, criando uma trilha auditável. E quando um candidato solicita exclusão, você está excluindo linhas de uma planilha, não desembaraçando registros de um banco de dados complexo de ATS.
O registro do candidato muitas vezes precisa conter resultados de triagem, não apenas campos de currículo — um fluxo de verificação de antecedentes para Excel arquiva resultados criminais, de referências e de MVR sob as regras de retenção acima.
A vantagem de conformidade de um pipeline baseado em planilha é a simplicidade. Os dados ficam em um só lugar. A exclusão é uma operação de linha. A lógica de filtragem é explícita (fórmulas do Excel, não pontuação de IA em caixa-preta). Para equipes pequenas e médias que operam sob obrigações do EEOC e do GDPR, essa transparência vale mais do que o conjunto de recursos de um ATS empresarial.
Perguntas frequentes
É possível ler currículos manuscritos?
Parcialmente. Escrita manual clara e legível — como um formulário impresso com campos preenchidos à mão — é extraída bem. Escrita cursiva densa em papel não estruturado gera resultados com menor confiança. Para currículos mistos (impressos e manuscritos), a IA extrai todo o texto impresso de forma confiável e sinaliza regiões de baixa confiança. Currículos apenas manuscritos devem ser tratados como casos que exigem revisão manual adicional.
Qual é a precisão em layouts de currículo com duas colunas?
Significativamente melhor do que parsers baseados em posição, porque a IA lê pelo significado semântico, não pela posição no layout. Uma barra lateral de habilidades à esquerda é entendida como uma seção "Habilidades", independentemente de onde esteja na página. Dito isso, currículos de designers gráficos com estilo muito elaborado e marcadores de seção baseados em ícones ainda podem gerar menor confiança em certos campos — a IA é boa em ler texto em contexto, não em decodificar metáforas visuais.
Quantos currículos posso processar de uma vez?
Envios em lote processam dezenas de currículos em uma única sessão. Todos os arquivos são processados em paralelo e mesclados em uma única tabela de saída unificada — uma linha por candidato, sem necessidade de configuração por documento.
Posso importar os resultados para o Greenhouse ou o Workday?
Sim. A maioria das plataformas de ATS — incluindo Greenhouse, Lever, Workday, iCIMS, BambooHR e Bullhorn — oferece suporte à importação de candidatos via CSV. Extraia para o Excel, limpe e valide os dados uma vez e depois importe um arquivo limpo. Esse fluxo de trabalho costuma ser mais rápido e confiável do que depender do parser de currículos integrado de cada plataforma, especialmente para candidatos originados fora do ATS.
O que acontece com os dados do currículo após a extração?
Os arquivos são processados e depois excluídos automaticamente do servidor após um período de retenção configurável. Nenhum dado de treinamento é retido a partir dos envios dos clientes. Para candidatos que solicitam exclusão sob o GDPR ou regulamentações semelhantes, os dados da planilha extraída ficam em um arquivo que você controla — não no banco de dados de um fornecedor.
Como isso é diferente de uma API de análise de currículos?
APIs de análise de currículos (Textkernel, RChilli, Affinda, Daxtra) são feitas especificamente para currículos e geralmente produzem JSON estruturado que exige código de integração para chegar a um formato utilizável. Elas cobram por documento ($0.05–$0.30 por análise). A extração por IA adota uma abordagem mais ampla: lê qualquer tipo de documento pelo significado dos campos, não por um esquema de currículo pré-treinado, e gera a saída diretamente em planilha. Não exige integração via API — você recebe um arquivo Excel. Para equipes que lidam com mais do que apenas currículos (cartas de oferta, formulários de integração, contratos de trabalho), um único fluxo de extração cobre todos os tipos de documento.