La causa raíz de las alucinaciones de RAG
es el análisis defectuoso
Una respuesta incorrecta de un sistema de generación aumentada por recuperación parece un problema del modelo. La respuesta es fluida, específica y segura, que es lo que parece una alucinación. Pero al modelo se le pidió razonar sobre un fragmento de texto, y razonó sobre ese fragmento con fidelidad. La pregunta que vale la pena hacerse es quién construyó el fragmento, porque para cuando el modelo lo vio, el documento ya había sido leído una vez, por un analizador que la mayoría de los equipos nunca inspeccionan.
La cadena de fallos corre en una sola dirección. Un análisis deficiente produce fragmentos deficientes, los fragmentos deficientes producen una recuperación deficiente, y la recuperación deficiente deja al modelo respondiendo a partir de evidencia corrupta. Este artículo recorre esa cadena desde el documento hacia arriba, nombra los fallos de análisis que causan más daño y muestra cómo revisar su propia capa de ingesta antes de gastar otro sprint ajustando indicaciones.
Conclusiones clave
- Usted culpó al modelo por una respuesta incorrecta que en realidad provenía de un fragmento que nunca inspeccionó.
- Incluso el mejor software de escaneo a texto en un punto de referencia de 8.561 documentos quedó al menos un 14% por debajo de los datos estructurados limpios, y esa brecha se convierte en su respuesta.
- La prueba más clara es alimentar al modelo con el texto de referencia de la página de la que respondió, ya que una respuesta correcta a partir de texto limpio demuestra que la culpa estaba en la ingesta.
La cadena de fallos comienza antes de la recuperación
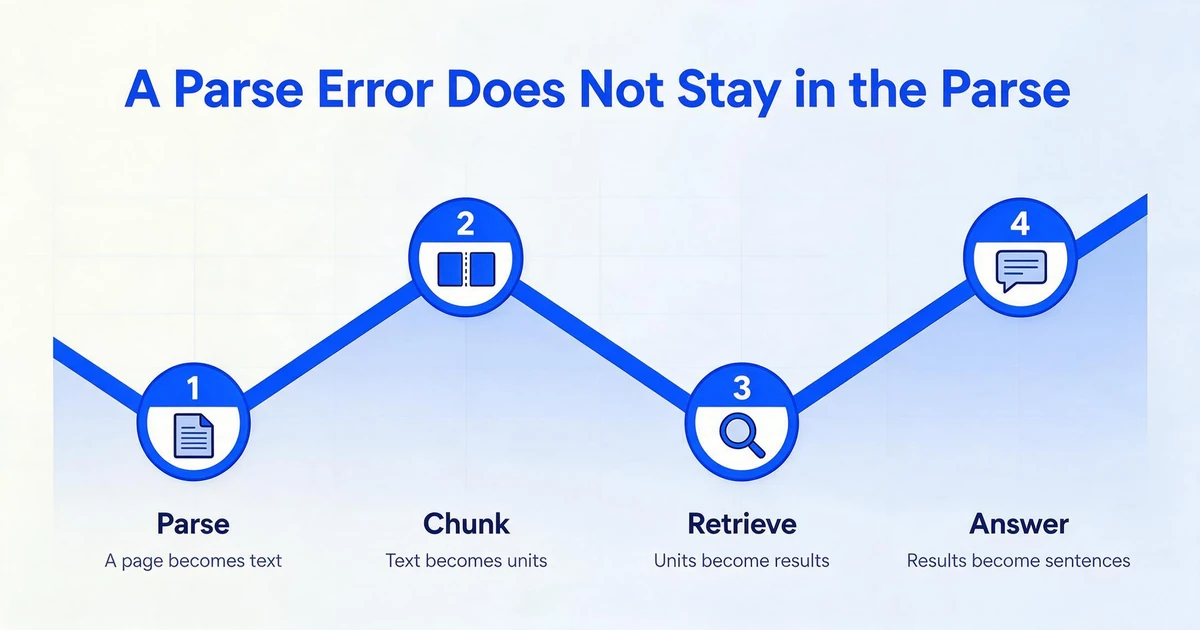
La generación aumentada por recuperación es una cadena de cuatro etapas, y cada etapa hereda exactamente lo que produjo la etapa anterior. El analizador convierte una página en texto y, si puede, en estructura. El fragmentador divide ese texto en unidades de recuperación. El recuperador selecciona unidades. El modelo escribe una respuesta a partir de lo que el recuperador le entregó.
La cadena importa porque un fragmentador solo puede dividir lo que el analizador le dio, y no puede añadir de nuevo la estructura que el analizador descartó. Si una tabla llega aplanada en una sola línea larga, el fragmentador no tiene ningún límite de fila que respetar. Si dos columnas llegan intercaladas, ningún tamaño de fragmento puede separarlas. La etapa de análisis establece el piso, y todas las etapas posteriores se apoyan en él.
Esto no es un caso límite poco común. El estudio OHR-Bench, publicado en ICCV 2025, construyó un conjunto de prueba de 8,561 imágenes de documentos no estructurados en siete dominios reales de aplicaciones RAG con 8,498 pares de preguntas y respuestas, y luego midió cómo el ruido del OCR se propaga a través de la recuperación y la generación. Incluso la mejor solución de OCR en el punto de referencia quedó al menos un 14% por debajo de los datos estructurados de texto de referencia limpios, y a medida que el ruido semántico aumentaba de leve a severo, la mayoría de los recuperadores y modelos de lenguaje perdieron cerca de la mitad de su rendimiento (Zhang et al., "OCR Hinders RAG", arXiv:2412.02592).
Esa brecha del 14% es la parte que los equipos subestiman. Un error de análisis no se queda en el análisis. Se convierte en un fragmento, luego en una incrustación, luego en un resultado de recuperación, y luego en una frase de la respuesta.
El análisis establece el techo para todo lo que está por encima. Ninguna estrategia de fragmentación puede añadir de nuevo una fila de tabla que el analizador aplanó ni separar dos columnas que leyó de forma cruzada.
Por qué se culpa al modelo
Cuando un sistema RAG falla en la práctica, el fallo suele estar en la recuperación o en el contenido, no en el generador. Un informe de experiencia de Deakin University analizó tres casos de estudio de RAG en producción y una ejecución empírica sobre 15,000 documentos y 1,000 preguntas, y luego catalogó siete puntos de fallo. Tres de ellos describen exactamente este patrón: la respuesta nunca se clasificó lo suficientemente alto como para ser devuelta, se recuperó pero se perdió en el ensamblaje del contexto, o estaba presente en el contexto y el modelo aun así no logró extraerla, lo que los autores atribuyen a demasiado ruido o información contradictoria (Barnett et al., "Seven Failure Points When Engineering a RAG System", arXiv:2401.05856).
"Ruido o información contradictoria" es la frase que importa. Un modelo que razona sobre un fragmento donde un número perdió su etiqueta se está basando en algo real que se extrajo mal, y no tiene forma de saber que la etiqueta falta. En una configuración con muchos documentos, un profesional describió el mismo descubrimiento después de semanas de cambios en los fragmentos, cambios de incrustaciones y rerankers: los documentos fuente en sí se estaban convirtiendo mal en texto, y muchas de las aparentes alucinaciones eran el modelo basándose en algo que se había extraído incorrectamente (r/Rag, marzo de 2026).
Luego está la solución a la que todos recurren primero: darle al modelo más contexto. Resulta contraproducente más a menudo de lo que ayuda.
La investigación sobre cómo los modelos de lenguaje usan entradas largas encontró una curva de rendimiento en forma de U. Los modelos usan la información mejor cuando está al principio o al final del contexto, y el rendimiento cae cuando el pasaje relevante está enterrado en el medio. En una prueba de dominio abierto, pasar de 20 documentos recuperados a 50 mejoró la precisión del lector solo en aproximadamente 1.5% mientras añadía una gran cantidad de entrada (Liu et al., "Lost in the Middle", arXiv:2307.03172).
Aumentar el top-k o la ventana de contexto añade más material para que el modelo razone. No hace que el material corrupto sea más limpio.
Los fallos de análisis que realmente envenenan el RAG
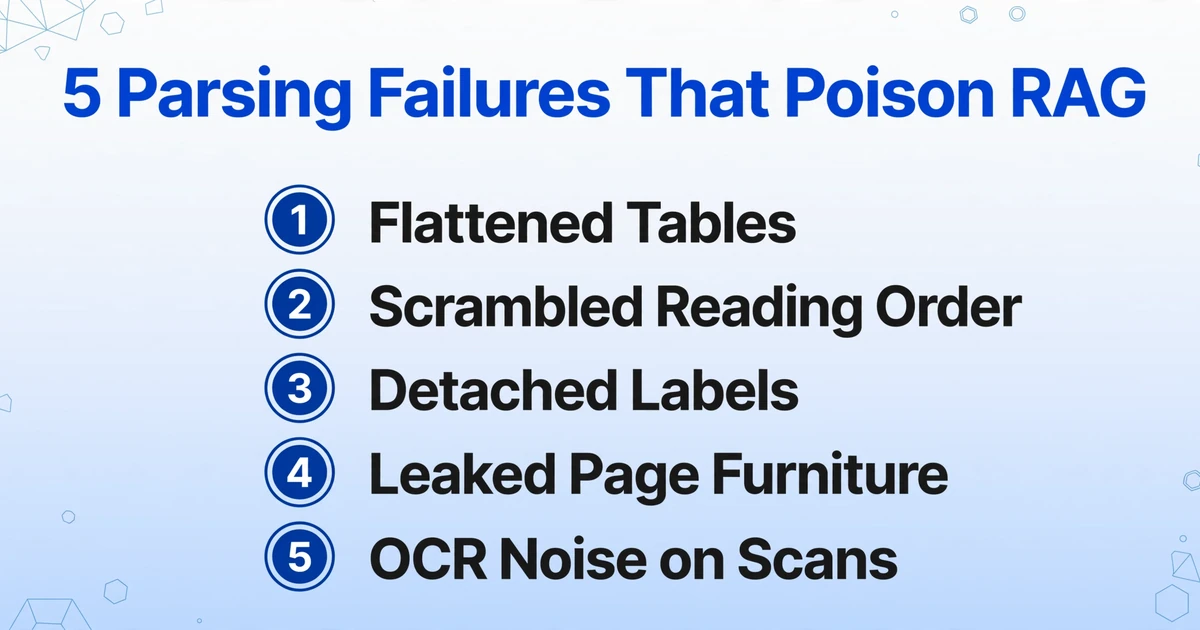
Los fallos de ingesta no son aleatorios. La mayoría se agrupan en un pequeño conjunto de tipos recurrentes, y cada uno deja un síntoma reconocible más adelante en la cadena. La tabla siguiente los muestra.
| Fallo de análisis | Qué se rompe en el texto | Cómo se manifiesta aguas abajo |
|---|---|---|
| Tablas aplanadas | Las filas y columnas se colapsan en una sola línea, y una celda pierde el encabezado que la identifica. | El recuperador devuelve la página correcta, pero el fragmento contiene "3.5" sin "Henry Hub" al lado, por lo que las preguntas de valores obtienen respuestas faltantes o incorrectas. |
| Orden de lectura alterado | En páginas de varias columnas, el analizador lee a través del margen e intercala dos columnas no relacionadas. | El fragmento se lee como prosa fluida pero mezcla dos ideas. La recuperación lo encuentra y el modelo responde basándose en la idea equivocada. |
| Etiquetas separadas y jerarquía perdida | Un valor se separa de su etiqueta, y un encabezado pierde su nivel. | Los fragmentos cruzan los límites de las secciones. "Penalización por terminación: 2%" se convierte en tokens huérfanos, y el modelo adjunta el número más cercano que encuentra. |
| Elementos de página filtrados | Encabezados de página, pies de página y números de página entran en el cuerpo del texto. | El texto repetitivo contamina los fragmentos y diluye la incrustación, por lo que los pasajes relevantes obtienen una puntuación más baja de lo que deberían. |
| Ruido de OCR en escaneos | Los caracteres y números se leen mal, o el texto desaparece en escaneos de baja calidad. | Los números e identificadores llegan sutilmente incorrectos. La respuesta es segura y difiere en un dígito. |
Un humano que lee una tabla aplanada a menudo puede reconstruir la cuadrícula a partir del contexto. Un fragmentador no puede, y tampoco una incrustación. La relación entre un número y su encabezado existe solo si el analizador la capturó. Esta es la diferencia entre las dos familias de análisis: el OCR basado en posición lee caracteres e infiere la estructura a partir de dónde se encuentran, mientras que un modelo de visión puede leer la página por significado y mantener una etiqueta unida a su valor. La evidencia de los puntos de referencia detrás de esa división está en nuestra página de referencia que compara el OCR tradicional con los modelos de visión para el análisis de documentos.
Cómo saber si el problema está en la capa de análisis
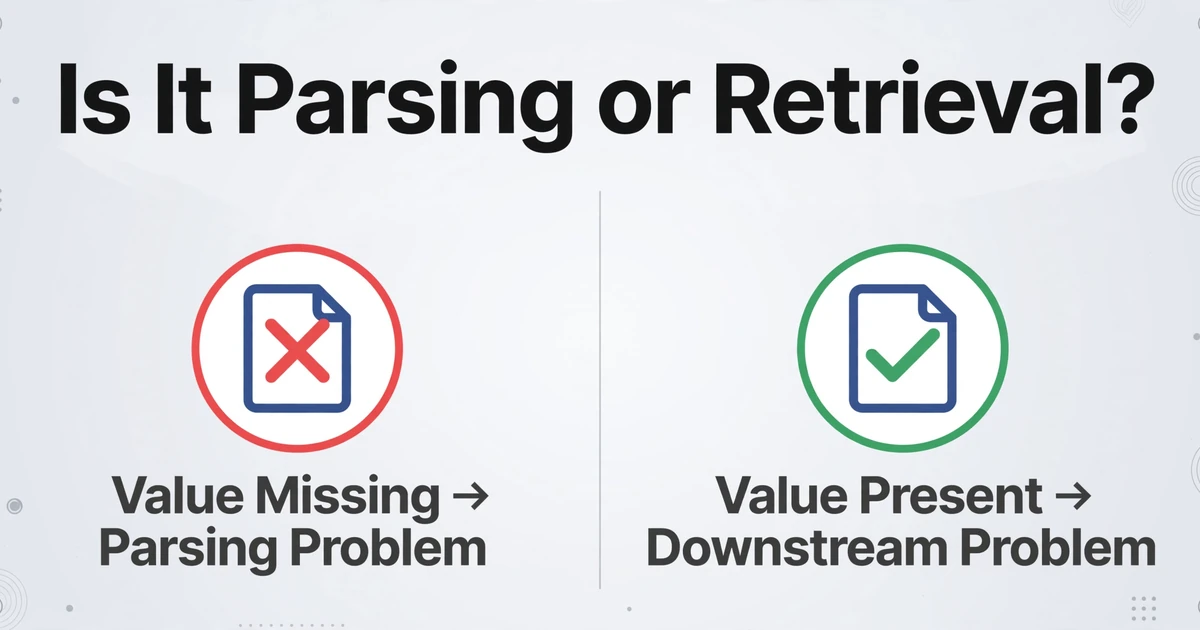
No tiene que adivinar qué etapa falló. La cadena le ofrece una prueba en cada eslabón, y las pruebas son económicas. Ejecútelas en orden y deténgase en cuanto tenga su respuesta.
Extraiga los fragmentos que la recuperación devolvió para una respuesta incorrecta
Casi todos los sistemas RAG pueden registrar qué fragmentos se incluyeron en el prompt. Empiece ahí, porque el resto de la auditoría depende de ver el contexto real que recibió el modelo, no un resumen del mismo.
Busque el valor correcto en esos fragmentos
Si el documento fuente contiene claramente la respuesta pero el fragmento recuperado no, el análisis o un límite de fragmento la descartó. Si el valor está presente y es correcto pero el modelo aun así respondió mal, su problema está después del análisis.
Inspeccione una página que contenga una tabla
Pegue la salida del analizador para esa página en una vista de texto plano. Si las filas y columnas sobrevivieron, la tabla está intacta. Si se colapsaron en una sola línea, todas las preguntas sobre tablas de ese documento están en riesgo.
Compruebe el orden de lectura en una página de dos columnas
Lea el texto extraído como lo leería una persona. Si salta entre dos columnas no relacionadas, los fragmentos extraídos de esa página están mezclados semánticamente aunque parezcan coherentes.
Busque elementos de página en el cuerpo del texto
Busque en el texto extraído el número de página o el encabezado corrido. Si aparecen dentro de un párrafo, se están incrustando como si fueran contenido y están diluyendo cada fragmento de la página.
Ejecute la pregunta contra el texto de referencia
Proporcione al modelo una versión corregida manualmente o de texto de referencia de la página de donde proviene la respuesta. Si responde correctamente con texto limpio y de forma incorrecta con el texto analizado, ha aislado la falla en la ingesta y puede dejar intactos la recuperación y el modelo.
La prueba única más limpia: dale al modelo el texto de referencia de la página de la que proviene la respuesta. Si obtiene la respuesta correcta, la recuperación y la generación nunca fueron el problema.
Estas comprobaciones se superponen con la resolución de problemas de extracción general, y el mapa de síntoma a causa en nuestra guía para diagnosticar problemas de extracción de documentos es un compañero útil cuando un tipo de documento sigue fallando de la misma manera. Una precaución sobre la medición: una puntuación a nivel de carácter puede clasificar a un buen analizador como el peor rendimiento, así que trata cualquier número único de calidad de análisis con cuidado, como explica este análisis de por qué CER engaña en el análisis de documentos.
Solucionarlo en la Capa de Extracción
La solución pertenece a la capa que primero convierte una página en texto, porque es la única capa donde la estructura aún se puede conservar. Si la salida del análisis es un flujo de caracteres en bruto, el fragmentador se queda inventando límites y el recuperador se queda clasificando ruido. Si la salida del análisis ya está estructurada y etiquetada, los pasos posteriores tienen algo honesto con lo que trabajar.
El cambio práctico es de la lectura basada en posición a la lectura semántica. El OCR basado en posición convierte una página en caracteres y los coloca por coordenadas, luego se basa en reglas de diseño para adivinar qué es un encabezado, un valor o una celda de tabla. Un modelo de visión puede leer la página para obtener significado en su lugar, que es el enfoque detrás de Custom Column Extraction. Escribes los nombres de las columnas que deseas, como "Número de Factura", "Número de Cuenta" o "Valor del Contrato", y la IA localiza cada valor en cualquier parte de la página al comprender qué significa el campo. Cada documento sale como una fila con esas columnas completadas, por lo que los valores llegan ya adjuntos a las etiquetas que definiste.
Para un pipeline RAG, eso cambia la entrada al fragmentador. En lugar de una pared de números, las filas de la tabla conservan sus encabezados. En lugar de una etiqueta flotando libre de su valor, el par viaja como una sola unidad. La capa de extracción no decide tus límites de fragmento ni elige tu modelo de incrustación. Entrega a la siguiente etapa una salida estructurada y etiquetada, para que los fragmentos construidos a partir de ella no se basen en texto corrupto.
Los archivos se procesan de forma segura y no se almacenan.
Si estás conectando la capa de extracción a tu propio código en lugar de a una hoja de cálculo, la v1 API es el punto de integración. Acepta cargas de documentos y trabajos por lotes, devuelve JSON estructurado y puede notificar a tu sistema mediante un webhook cuando finaliza el procesamiento, de modo que la extracción pueda ubicarse detrás de tu propia aplicación o flujo de trabajo. Para corpus donde un documento lógico abarca varias páginas, como un extracto bancario o un contrato, Multi-Page Merge agrupa las páginas en un único registro, de modo que un fragmento no se construye a partir de medio documento. El posprocesamiento de datos también puede normalizar fechas y montos a un formato fijo durante la extracción, lo que mantiene los identificadores consistentes de un fragmento al siguiente.
Lo que esto reemplaza es el paso de lectura de documentos, no tu stack de RAG. La mayoría de los equipos conservan el recuperador, el almacén vectorial y el modelo. La capa de extracción simplemente deja de alimentarlos con texto que ya estaba dañado. El mismo mecanismo, descrito para la tarea de análisis por sí sola, está en la página de AI document parser.
Lo que esto no resuelve
La honestidad importa más que un discurso pulido aquí, porque un proyecto de RAG construido sobre una afirmación exagerada falla de la misma manera que el pipeline.
No construye ni ejecuta tu sistema de RAG. Maneja la capa de lectura de documentos que alimenta la recuperación. No configura una base de datos vectorial, no elige una estrategia de recuperación ni ejecuta tu paso de generación.
No elige tus límites de fragmentos ni tu modelo de incrustación. Esas siguen siendo decisiones de tu pipeline. La capa de extracción solo cambia la calidad del texto sobre el que operan esas decisiones.
No compara campos entre documentos. Mapea campos dentro de cada documento a tus columnas nombradas. Comparar un valor en un documento contra un valor en otro y decidir automáticamente es una tarea diferente, y pertenece a tu lógica posterior.
No puede inventar un valor que no esté en el documento. Si un campo está genuinamente ausente, la salida queda en blanco en lugar de fabricarse. Ese es el comportamiento correcto, y un espacio en blanco es una señal para verificar la fuente, no un número en el que confiar.
Los escaneos deficientes aún reducen la precisión. Los recibos térmicos desvaídos, la inclinación pronunciada y las fotos de baja resolución siguen siendo difíciles para cualquier sistema. Esas salidas merecen una pasada de revisión. El objetivo es mover el juicio humano de arreglar el pipeline a verificar los pocos valores que necesitan una segunda mirada.
Preguntas Frecuentes
¿Por qué mi RAG alucina cuando la recuperación parece relevante?
Relevancia y corrección son cosas distintas. Un fragmento recuperado puede ser temáticamente similar a la pregunta pero carecer del valor que la responde, o contener ese valor separado de su etiqueta. El estudio OHR-Bench midió cómo el ruido del análisis degrada tanto la recuperación como la generación, por lo que un resultado que parece relevante puede ser evidencia corrupta sobre la que el modelo razona fielmente.
¿Puede una ventana de contexto más grande o un top-k más alto corregir las alucinaciones de RAG?
Rara vez. La investigación sobre modelos de contexto largo muestra que utilizan mejor la información al inicio y al final del contexto y se degradan hacia el medio, y añadir documentos más allá de cierto punto produce ganancias muy pequeñas. Más contexto le da al modelo más material para razonar. No repara un fragmento construido a partir de un análisis defectuoso.
¿Qué errores de análisis de documentos causan la mayoría de las fallas de RAG?
Tablas aplanadas, orden de lectura desordenado en páginas de varias columnas, valores separados de sus etiquetas, jerarquía de secciones perdida, encabezados y pies de página filtrados, y ruido de OCR en escaneos. Las fallas de tablas son las más perjudiciales, porque la relación entre una celda y su encabezado existe solo si el analizador la capturó, y ningún paso posterior puede reconstruir una cuadrícula que nunca sobrevivió al análisis.
¿Cómo pruebo si mi problema de RAG es de análisis o de recuperación?
Extraiga los fragmentos que la recuperación devolvió para una respuesta incorrecta conocida y busque el valor correcto en ellos. Inspeccione la salida de análisis sin procesar de una página de tabla comparándola con el original, y verifique el orden de lectura en una página de dos columnas. Luego proporcione al modelo el texto de referencia para la misma página. Si responde correctamente con texto limpio, la falla está en la ingesta, no en la recuperación.
¿ImageToTable.ai crea o ejecuta un pipeline de RAG?
No. Es una capa de extracción. Lee documentos y devuelve datos estructurados y etiquetados como Excel, CSV, JSON o Word. Su recuperación, almacén de vectores y generación siguen siendo suyos. El producto se encarga del paso de análisis que alimenta esos sistemas, y nada más allá de eso.
¿Qué salida produce la capa de extracción para un pipeline de RAG?
Una fila por documento con las columnas que usted definió, además de JSON estructurado a través de la v1 API. Dado que los valores llegan vinculados a las etiquetas que usted definió, la fragmentación y la recuperación posteriores funcionan sobre texto estructurado en lugar de un flujo de caracteres sin procesar.
¿Puede manejar PDF escaneados y documentos de varias páginas?
Acepta PDF, incluidos los protegidos con contraseña, imágenes JPG y PNG, archivos WebP y AVIF, y capturas de pantalla, y reconoce texto impreso y escrito a mano. La fusión de varias páginas agrupa páginas del mismo documento lógico en un solo registro, lo que ayuda cuando un fragmento se construiría a partir de parte de un estado de cuenta o un contrato. La precisión sigue disminuyendo en escaneos de muy baja calidad, por lo que vale la pena revisar esas salidas.
Los errores de RAG más costosos son los que parecen un problema del modelo y lo llevan a ajustar prompts, tamaños de fragmento y rerankers mientras el daño real ocurrió antes de que la recuperación siquiera se ejecutara. Audite el análisis primero. Cuando el texto que ingresa a su pipeline está estructurado y correctamente etiquetado, el modelo finalmente razona sobre evidencia digna de confianza.