¿Necesita un pipeline de análisis
para datos de hoja de cálculo?
El equipo promedio de cuentas por pagar todavía paga alrededor de $9.40 para procesar una factura, y solo el 32.6% de las facturas se procesan de principio a fin sin intervención humana (Ardent Partners, State of ePayables 2024). Cuando a un equipo que solo necesita datos de proveedores organizados en columnas se le presenta esa brecha, la respuesta estándar es "usted necesita un pipeline de análisis de documentos".
Un pipeline de análisis es una arquitectura real y resuelve problemas reales, pero fue diseñado para un destino diferente. Su salida es un modelo de documento: el diseño, el orden de lectura, las tablas, todo preservado para que el contenido pueda fragmentarse y alimentar un sistema de recuperación. Si su entregable son filas en una hoja de cálculo, es posible que esté comprando la arquitectura que necesita el proyecto RAG de otra persona, no la que necesita su hoja de cálculo. Este artículo explica qué produce realmente cada enfoque, qué le cuesta el pipeline cuando el objetivo son filas, y cuándo un pipeline de análisis es realmente la decisión correcta.
Conclusiones Clave
- Solo el 32.6% de las facturas se procesan sin intervención humana, y el pipeline que se presenta como la solución devuelve un modelo de documento en lugar de las filas que consume una hoja de cálculo.
- El pipeline no elimina el paso de extracción, lo traslada a una capa que usted aún debe escribir, y un contrato de 40 páginas sigue costando cuarenta páginas aunque solo necesite una fecha de renovación.
- La pregunta decisiva es el destino: las filas en una hoja de cálculo apuntan a la extracción de columnas nombradas, y un corpus de documentos consultable o que preserve el diseño es donde el pipeline de análisis justifica su costo.
Por qué un objetivo de hoja de cálculo termina vendiéndose como un pipeline de análisis
El término "análisis de documentos" tiene un significado preciso en la literatura de investigación. Una encuesta de 2024 en este campo lo define como la conversión de documentos no estructurados o semiestructurados en representaciones estructuradas y legibles por máquina para aplicaciones posteriores, como la construcción de bases de conocimiento y la generación aumentada por recuperación, o RAG (Document Parsing Unveiled, arXiv:2410.21169). Un pipeline de análisis reconstruye el documento: OCR en páginas escaneadas, análisis de diseño para encontrar bloques de texto y tablas, reconstrucción del orden de lectura para que las páginas de dos columnas fluyan correctamente, reconocimiento de la estructura de las celdas de las tablas, y serialización de todo en Markdown o JSON. Esa representación luego se divide en fragmentos, se incorpora y se indexa para que una IA pueda responder preguntas sobre el documento más adelante.
Esa secuencia resuelve un problema específico: hacer que un corpus completo de documentos sea buscable y responda preguntas. Es una arquitectura de base de conocimiento. A los equipos que evalúan herramientas de automatización de documentos se les muestra habitualmente porque es donde se invirtió una gran parte del capital actual en IA documental, y es genuinamente impresionante. La pregunta es si el problema del equipo es "responder preguntas sobre un corpus de documentos" o "obtener el número de factura, la fecha de vencimiento y el total en tres columnas". Son problemas diferentes, y el segundo no se beneficia automáticamente de la maquinaria del primero.
Un pipeline de análisis produce una representación estructurada del documento. La extracción de columnas produce una representación estructurada de los campos solicitados. Son resultados diferentes, y el segundo está más cerca de lo que una hoja de cálculo realmente consume.
Qué hace realmente un pipeline de análisis, paso a paso
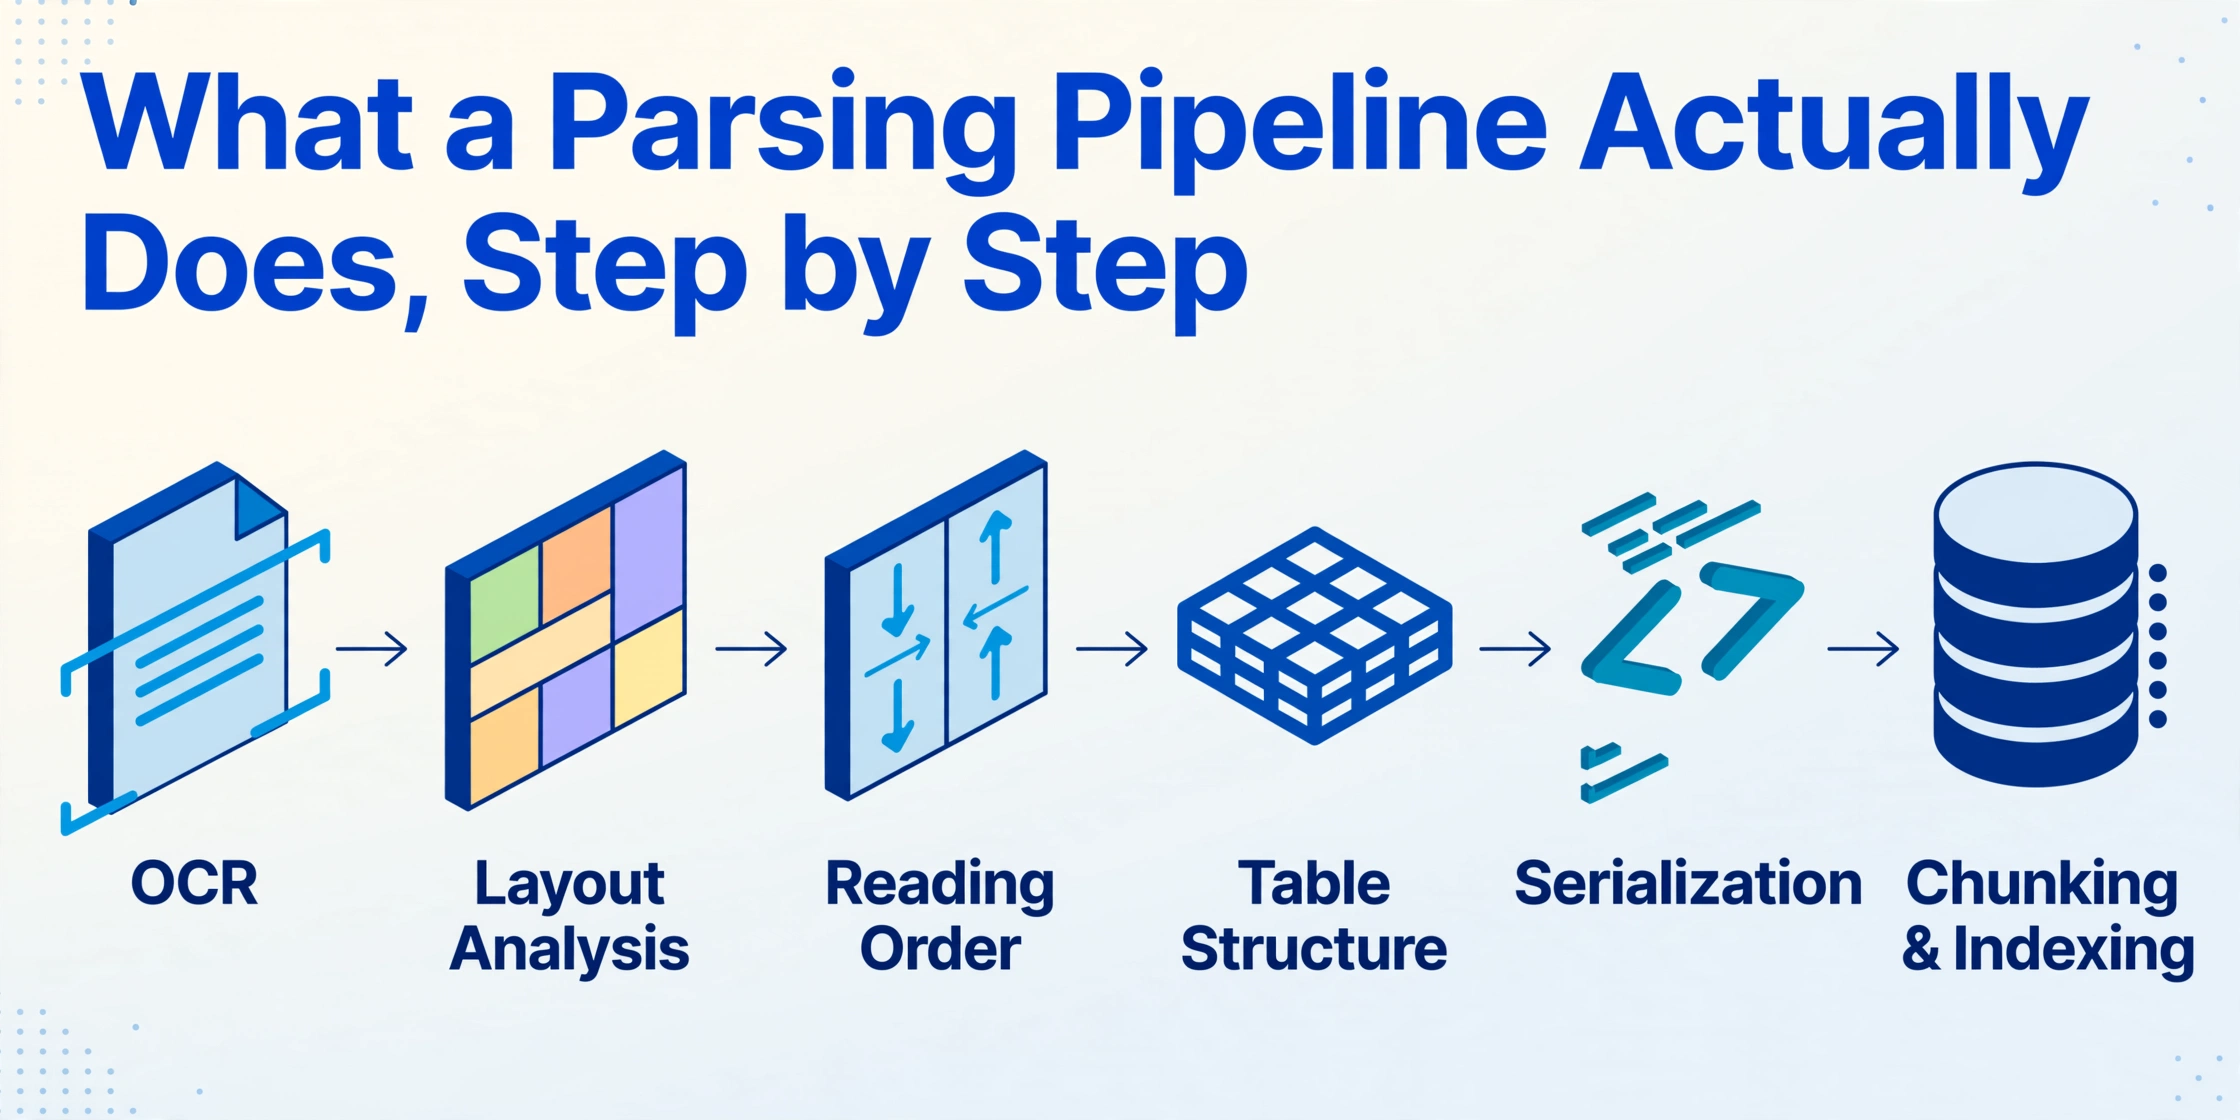
Cuando alguien propone un pipeline de análisis para los datos de sus documentos, este es el trabajo concreto que contiene, en el orden en que se ejecuta.
Adquisición de texto
Los documentos escaneados y fotografiados pasan por OCR para producir una capa de texto. Los PDF nacidos digitales pueden llevar una capa de texto incrustada que se puede leer directamente, lo cual es más rápido pero menos fiable para diseños complejos.
Análisis del diseño
La página se segmenta en bloques de texto, tablas, figuras, encabezados y pies de página. Aquí es donde el analizador aprende qué texto pertenece a una tabla y cuál a un párrafo.
Reconstrucción del orden de lectura
Las páginas de varias columnas se reensamblan en el orden en que una persona las leería. Sin este paso, una factura de dos columnas se lee de la columna izquierda hasta abajo y luego la derecha, lo que desordena el contenido para cualquier proceso posterior.
Reconocimiento de la estructura de tablas
Se identifican filas, columnas, celdas combinadas y extensiones para que una tabla sobreviva como tabla en lugar de aplanarse en una cadena de celdas.
Serialización
El resultado se escribe como Markdown, JSON o HTML, normalmente con cuadros delimitadores y números de página adjuntos para que cada elemento pueda rastrearse hasta sus coordenadas de origen.
Fragmentación e indexación
Para los stacks de RAG, la salida analizada se divide en fragmentos del tamaño adecuado para la incrustación, se incrustan en vectores y se cargan en un índice que un sistema de recuperación puede consultar.
Los motores conocidos en esta categoría incluyen AWS Textract, Azure Document Intelligence, Google Document AI, Unstructured, Docling y LlamaParse, que está construido sobre el stack de LlamaIndex. Extend es un participante más reciente en la misma vía de API de análisis y extracción. Se diferencian en niveles, precios por página y fidelidad de salida, pero comparten la misma arquitectura: analizar el documento en un modelo y luego entregar el modelo a quien lo consuma. Un desarrollador que comparaba estos motores en Reddit resumió la realidad práctica de todos ellos: "Todos son sólidos, todos se pagan por página y sí, todos requieren que orquestes el pipeline de análisis tú mismo" (r/LLMDevs).
Qué hace la Extracción de Columnas Personalizadas en su lugar
La filosofía alternativa detiene el flujo de trabajo en la respuesta. Con Extracción de Columnas Personalizadas, usted escribe los nombres de las columnas que desea: "Número de Factura", "Fecha de Vencimiento", "Monto Total". La IA lee el documento y localiza cada valor al comprender qué significa el nombre de la columna, en cualquier lugar de la página, sin coordenadas ni plantilla de diseño involucradas. Los nombres de columna que ingresa se convierten en los encabezados de la tabla de salida, por lo que la unidad de trabajo es un campo, no una página.
Nada en este flujo necesita un modelo de documento. No hay paso de análisis de diseño, ni reconstrucción del orden de lectura, ni serialización a Markdown, ni fragmentación. A la IA se le hace una pregunta por carga: "encuentre los valores de estas columnas y devuélvalos". Lo que recibe son filas, y las filas son el entregable. El procesamiento es procesamiento por lotes prioritario: cargue una carpeta de facturas de proveedores, y cada factura aterriza como su propia fila en una hoja de cálculo fusionada en lugar de un resultado de análisis por archivo (un recorrido más completo de cómo la extracción de documentos con IA lee una página explica el mecanismo con más detalle).
Debido a que los campos son la solicitud, el enfoque no le importa qué diseño de proveedor usa el documento, lo cual se cubre por separado en nuestro análisis de extracción de documentos sin plantilla. Un proveedor que cambia su plantilla de factura no invalida nada, porque las definiciones de columnas nunca estuvieron ligadas a una posición en la página.
Qué le cuesta el pipeline de análisis a un equipo que solo necesita filas
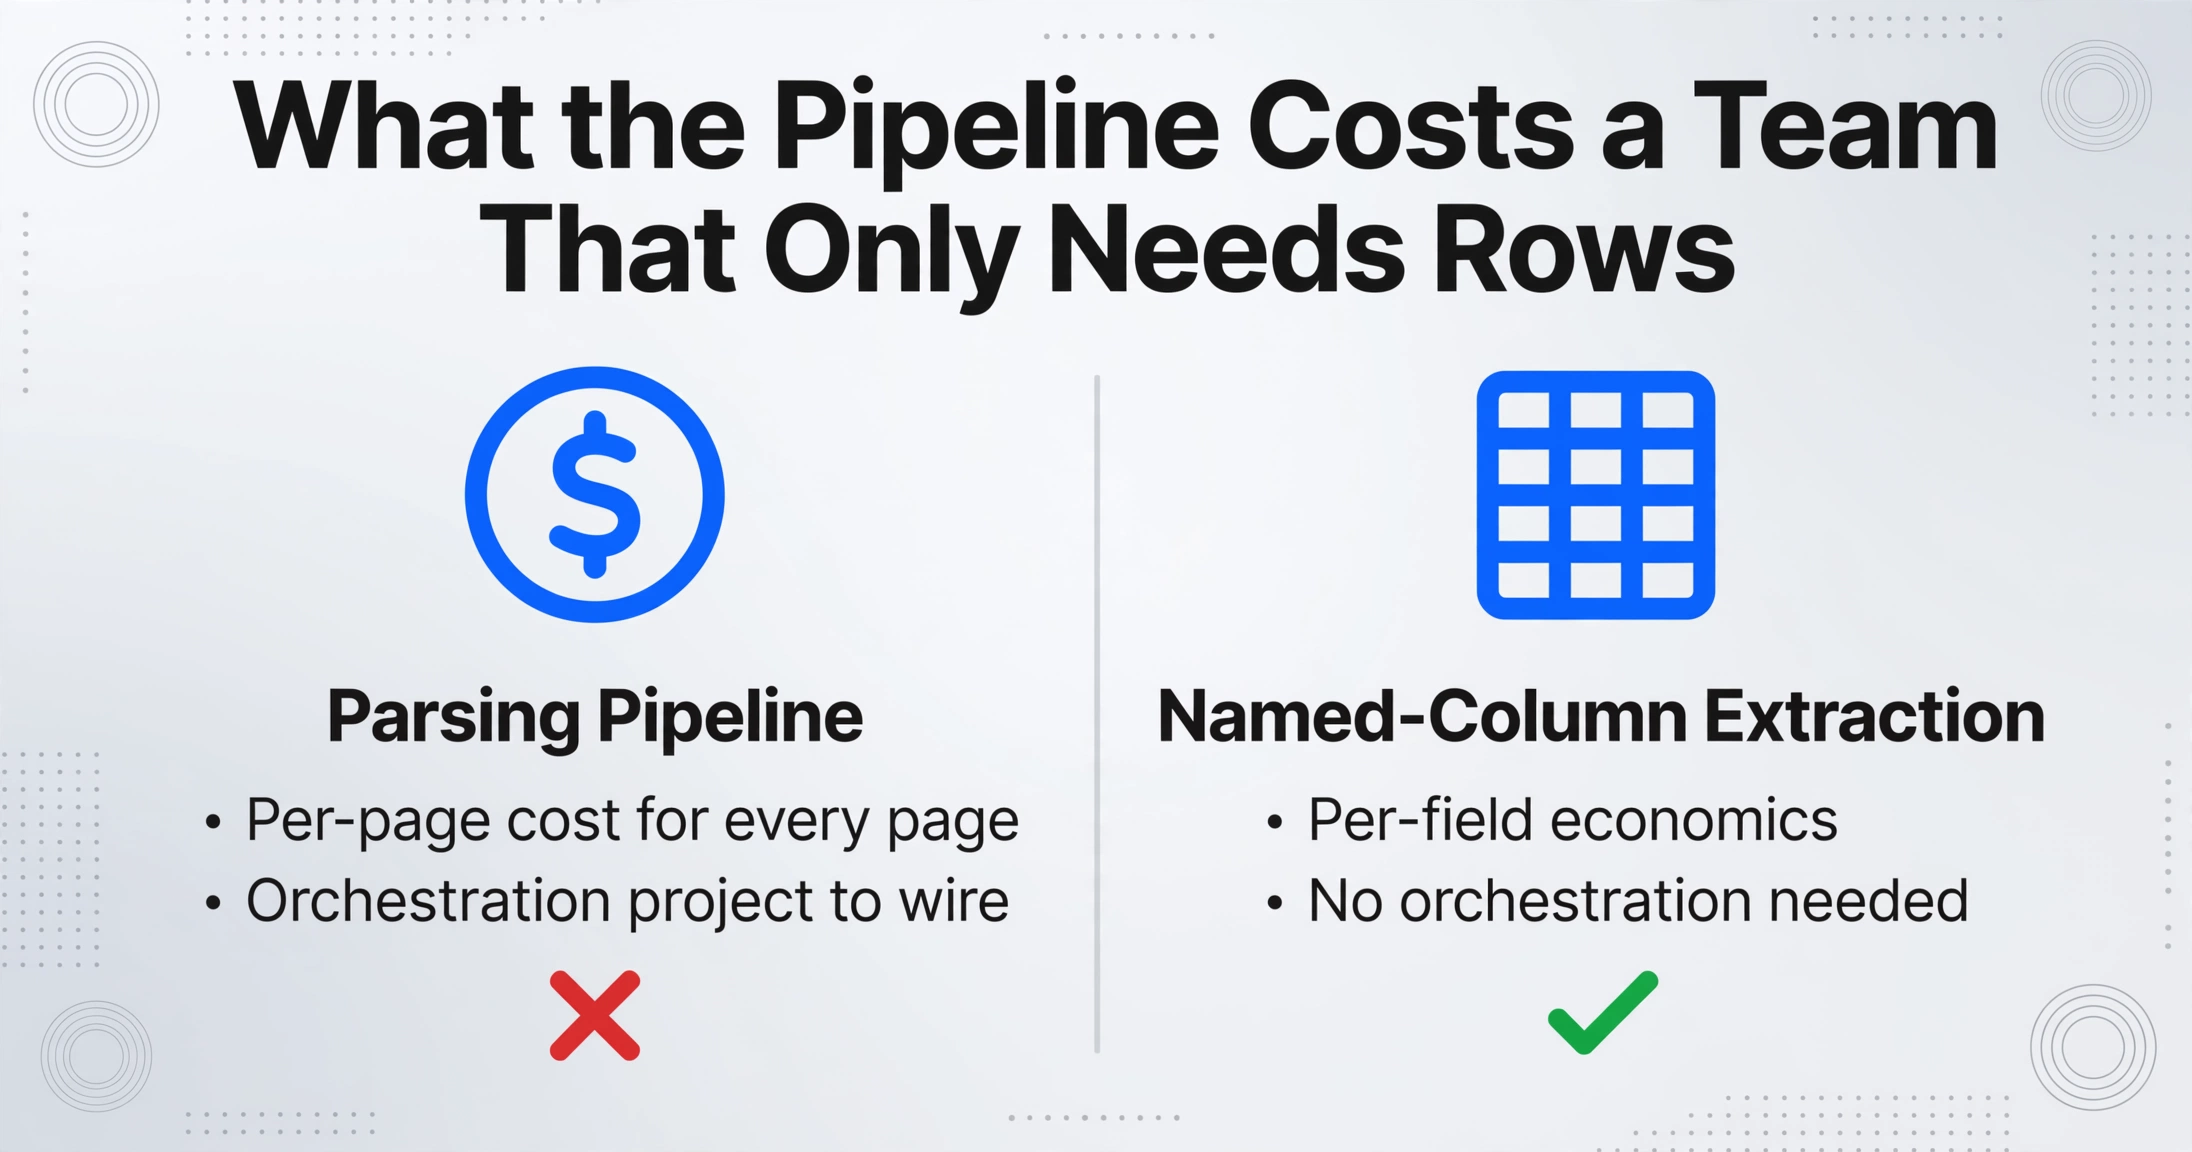
Un pipeline de análisis no es incorrecto para un objetivo de hoja de cálculo, solo es más máquina de la que el trabajo necesita, y la máquina adicional aparece en tres lugares.
Usted paga por páginas cuando su unidad de valor es un campo. Las API de análisis cobran por página o por crédito por OCR y procesamiento de diseño. Cada página se analiza por completo, incluido el texto repetitivo que nunca volverá a ver, porque eso es lo que significa la reconstrucción de documentos. Una factura que ocupa una página cuesta una página. Un contrato de 40 páginas cuesta cuarenta páginas, incluso cuando el entregable es una fecha de renovación y un nombre de parte. Las filas en una hoja de cálculo suelen ser un puñado de campos por documento, y la economía por campo es contra lo que factura la extracción de columnas, no el costo por página de reconstruirlo todo.
Usted hereda un proyecto de orquestación. El comentario de Reddit anterior lo dijo claramente: cada analizador en la categoría requiere que usted mismo conecte el pipeline. Un usuario de Textract en r/aws describió la misma experiencia en un registro diferente: es "bastante costoso para un gran número de documentos", y "si el diseño del documento es inusual, podría dar resultados incorrectos" (r/aws). Alguien tiene que unir el paso de OCR con el paso de diseño, manejar los reintentos, mantener la fragmentación consistente e implementar el resultado. Para un equipo de una o dos personas de operaciones cuyo trabajo real son los datos de proveedores en una hoja de cálculo, esa orquestación es el trabajo que intentaban automatizar.
El pipeline termina donde comienza su extracción. Esta es la parte que rara vez aparece en la página de comparación de proveedores: un pipeline de análisis le entrega Markdown, no campos. Para obtener la "fecha de vencimiento" de un documento analizado, todavía tiene que escribir su propia capa de extracción, ya sea mediante coincidencia de patrones sobre el Markdown o una solicitud de esquema a un LLM, y luego validar su salida. Algunas plataformas de análisis incluyen un endpoint de extracción, pero es un complemento, y el costo de ingeniería de convertir la salida analizada en las filas que su hoja de cálculo necesita sigue siendo suyo. Eso es un segundo proyecto de extracción añadido al primero.
Existe una versión humana de ese mismo doble manejo, y tiene tasas de error medidas. Una revisión sistemática y metaanálisis de 2023 sobre métodos de procesamiento de datos en investigación clínica encontró una tasa de error combinada de 6.57% cuando alguien lee un valor de un documento fuente y lo ingresa manualmente en un registro estructurado, frente al 0.29% para el ingreso directo y el 0.74% para el escaneo automatizado (Garza et al., 2023). Cuando el Markdown analizado se vuelve a ingresar manualmente en una hoja de cálculo, el paso es el mismo y el error reside en el mismo lugar: la interfaz humana entre dos representaciones.
El pipeline no elimina el paso de extracción. Lo traslada más abajo en la cadena: del documento al Markdown, y de usted al pequeño script o solicitud de esquema que todavía tiene que implementar.
Cómo la Extracción de Columnas Nombradas se Mapea Directamente a un Objetivo de Hoja de Cálculo
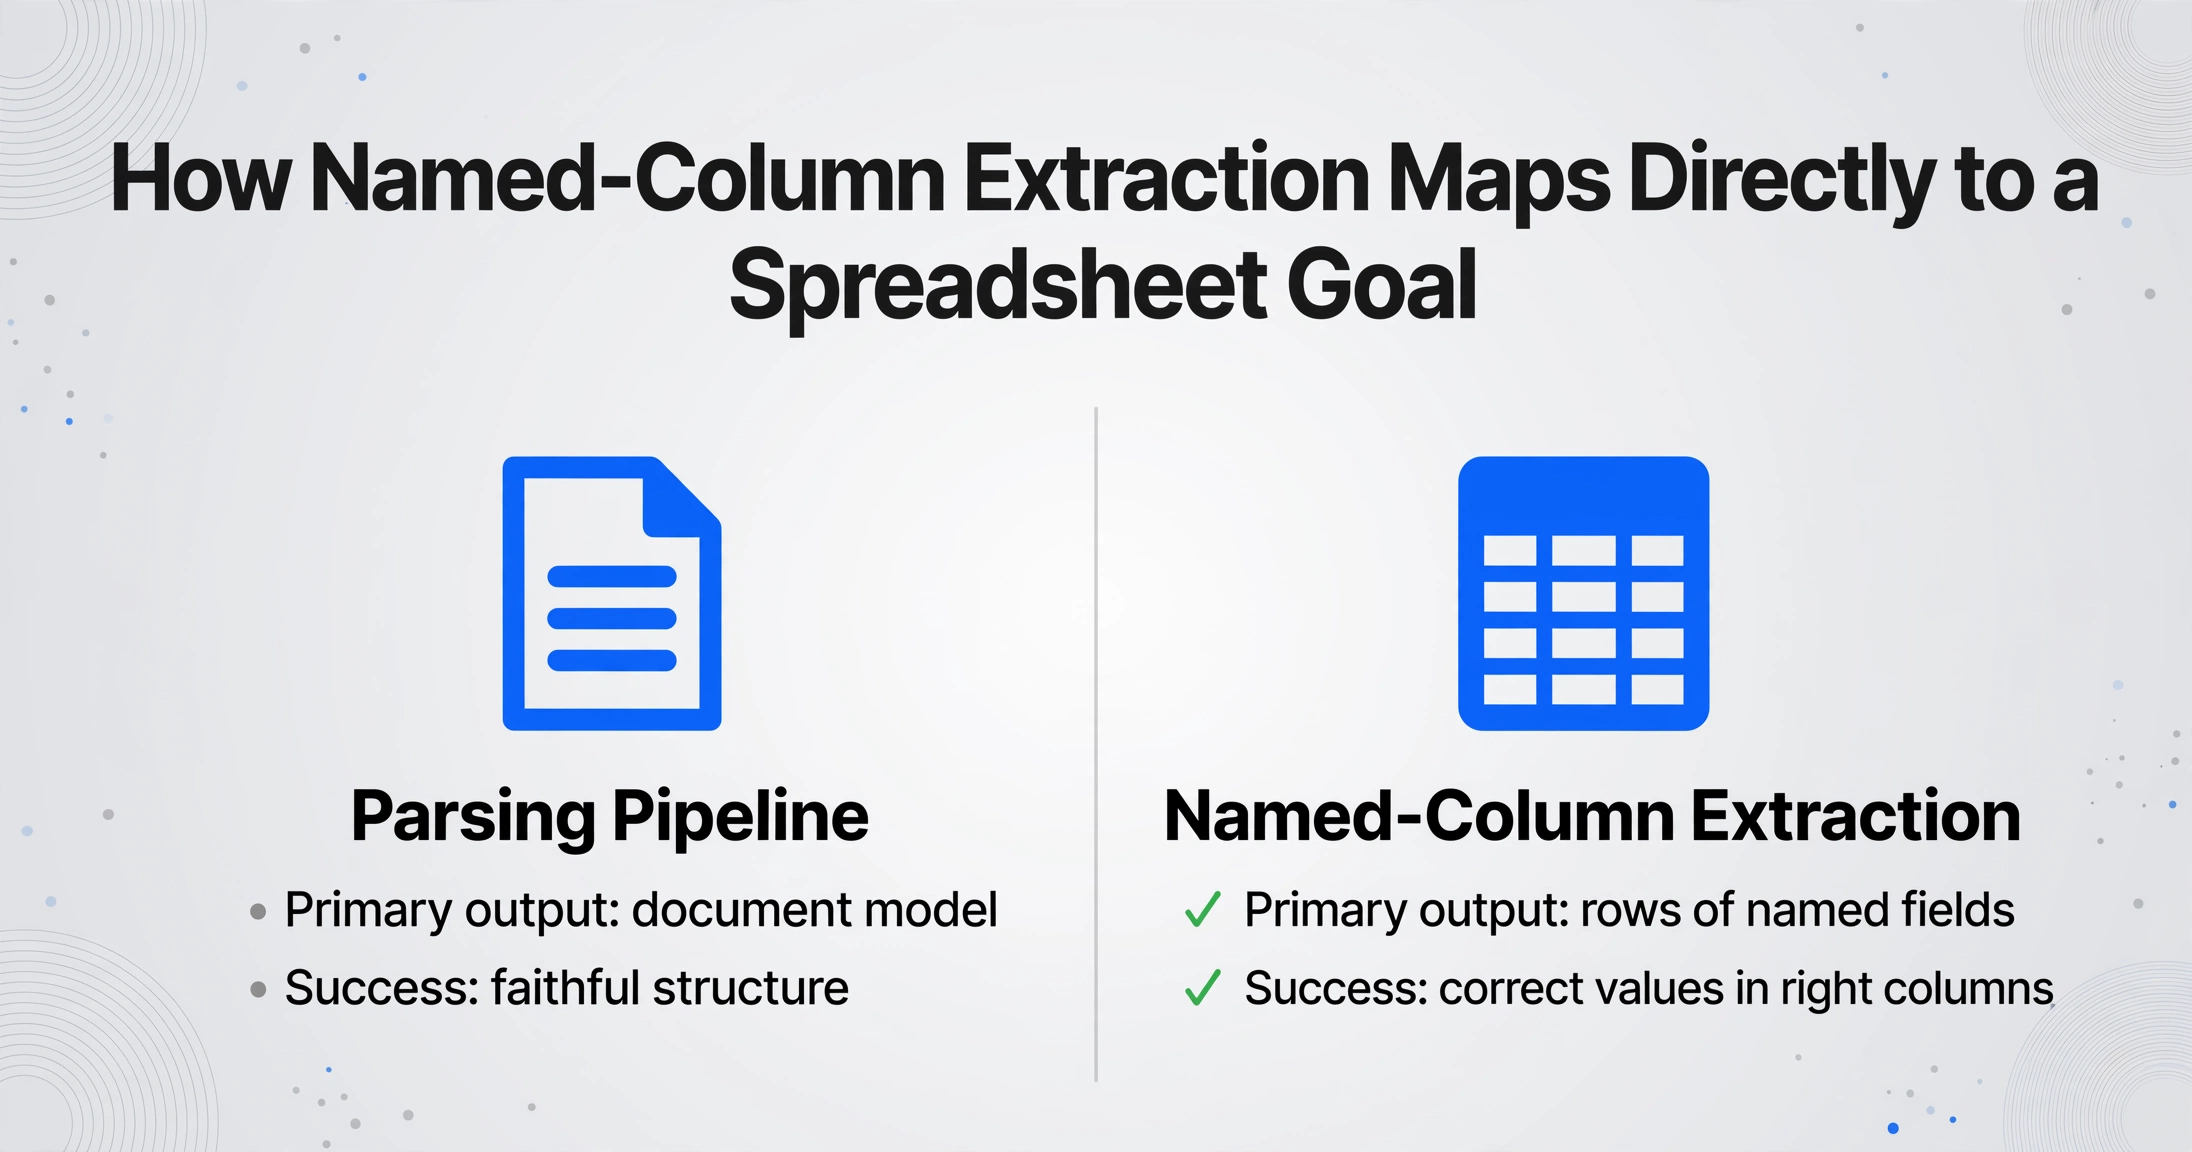
Frente a esa estructura de costos, la extracción de columnas es deliberadamente mínima. El flujo de trabajo es: subir los documentos, ingresar los nombres de las columnas una vez, ejecutar el lote. La herramienta lee cada archivo, completa las columnas y fusiona los resultados en una sola hoja de cálculo, sin proyecto de análisis, sin orquestación, sin segunda fase de extracción. Procesar una sola página toma entre 5 y 10 segundos, mientras que el ingreso manual toma alrededor de tres minutos, una diferencia de aproximadamente 18 veces que proviene de los mismos números de eficiencia que publicamos en todo el producto.
Dos configuraciones del producto son importantes para los equipos que necesitan confiar en la salida. El nivel de modelo permite que una cuenta elija un modelo de visión más potente para escritura densa, diseños complejos o documentos donde los pequeños errores son costosos, mientras que el nivel estándar ya cubre la mayoría de los documentos tabulares impresos. Y el modo de revisión con resaltado de cuadro delimitador mapea cada valor extraído a su ubicación exacta en la página original: pase el cursor sobre una celda y la región fuente se ilumina, haga clic en la región y se encuentra la celda. Los equipos que comparan esto con un volcado de Markdown analizado generalmente descubren que el rastreo de fuente por campo es exactamente la capa de verificación que una auditoría de hoja de cálculo necesita.
| Pipeline de análisis | Extracción de columnas nombradas | |
|---|---|---|
| Resultado principal | Modelo de documento: diseño, orden de lectura, tablas como Markdown o JSON | Filas de los campos que usted nombró |
| Qué determina el éxito | Estructura fiel, fragmentos limpios para la recuperación | Valores correctos en las columnas adecuadas |
| Configuración | Elección del motor, configuración por página, orquestación, fragmentación, índice | Escriba una vez los nombres de las columnas que desea |
| Uso posterior natural | RAG, agentes, búsqueda semántica sobre un corpus | Excel, Google Sheets, importaciones a ERP, informes |
| Qué se mantiene | Código de integración, reintentos, mapeo de esquema sobre la salida analizada | Revisión de las filas que requieren una segunda mirada |
La historia de la verificación es donde un flujo de extracción de columnas suele confirmarse en el primer lote. Ejecute sus facturas, abra el modo de revisión y compruebe los campos marcados contra las páginas de origen en lugar de leer cada valor dos veces. Para los equipos que vienen de herramientas con plantilla que fallan cada vez que un proveedor cambia su diseño, esa experiencia del primer lote suele ser el argumento decisivo, como se aborda en las discusiones sobre migrar desde Docparser y migrar desde Parseur. Si todavía está comparando nombres individuales en este ámbito, nuestra comparación con Parseur revisa herramienta por herramienta.
Cuando Realmente Necesita un Pipeline de Análisis
La extracción de columnas no es un reemplazo universal, y decir lo contrario sería deshonesto. Un pipeline de análisis es la arquitectura adecuada para cuatro necesidades concretas.
RAG y IA conversacional sobre un corpus. Si el entregable es "responder preguntas en 10,000 documentos de políticas" o "un agente que extrae citas de una base de conocimiento", necesita fragmentos, embeddings y un índice de recuperación. La extracción de columnas devuelve campos, no contenido recuperable. El modelo de documento del pipeline de análisis es exactamente lo que este caso de uso consume, y aquí es donde este enfoque realmente brilla.
Modelos de documento que preservan el diseño. Algunos sistemas posteriores deben mantener el documento como documento: una plataforma de revisión legal que necesita reconstruir una cláusula contractual en orden de lectura, un flujo de trabajo de investigación que necesita un artículo de dos columnas refluido correctamente, un sistema de archivo que mantiene la estructura visual de la fuente. Una tabla de campos descarta esa estructura por diseño. Cuando el resultado se consume como documento, se necesita el pipeline.
Búsqueda de contenido completo. Si la métrica de éxito es la búsqueda en lenguaje natural sobre todo lo que dicen los documentos, no sobre las columnas que completan, el índice necesita el contenido analizado completo. Una hoja de cálculo con campos clave no sustituye a un cuerpo de texto consultable.
La estructura del documento como producto. Un equipo que construye herramientas de documentos como producto propio, donde otros desarrolladores consumen Markdown analizado o árboles de diseño a través de una API, necesita la capa de análisis como infraestructura. Eso es un entregable para desarrolladores, no un entregable operativo.
La regla de decisión es el destino: las filas en una hoja de cálculo apuntan a la extracción de columnas, un corpus de documentos consultable o que preserva el diseño apunta a un pipeline de análisis. Los equipos que necesitan ambos ejecutan ambos, pero la mitad de la hoja de cálculo no requiere que la mitad del pipeline se construya primero.
Para los lectores que aún comparan herramientas por nombre, el resumen anual de OCR y APIs de documentos enumera los principales motores uno al lado del otro, incluidos los de pipeline de análisis. Lo que ninguno de esos motores promete es lo que la extracción de columnas ofrece de antemano: sin construcción de pipeline, sin esquema de fragmentación, solo las columnas que nombró.
Preguntas frecuentes
¿Cuál es la diferencia entre el análisis de documentos y la extracción de datos?
El análisis de documentos reconstruye el documento en sí: diseño, orden de lectura, tablas, serializado en Markdown o JSON para sistemas posteriores. La extracción de datos obtiene los campos específicos que usted define, como la fecha de la factura o el monto total, y los devuelve como filas. El primero produce un modelo de documento; el segundo produce la respuesta que usted solicitó.
¿Necesito un pipeline de análisis para extraer datos de PDF a una hoja de cálculo?
No. Si su entregable son filas de campos nombrados en una hoja de cálculo, la extracción de columnas lee el documento y completa las columnas directamente. Un pipeline de análisis añade costos de análisis por página, un paso de orquestación y una capa de extracción separada que convierte el Markdown analizado en los campos que usted desea.
¿Cuándo tiene sentido un pipeline de análisis?
Cuando el resultado debe ser el documento: sistemas RAG y de agentes que recuperan información de un corpus completo, flujos de trabajo que preservan el diseño, búsqueda de contenido completo o la creación de herramientas documentales como producto. En esos casos, el modelo de documento del pipeline es genuinamente la base correcta.
¿Es el análisis más preciso que la extracción de columnas para tablas?
Se miden en aspectos diferentes. El análisis se evalúa por la fidelidad con la que la estructura de la tabla sobrevive en Markdown o JSON. La extracción de columnas se evalúa por si el valor en una columna nombrada es correcto. Para una hoja de cálculo, la segunda métrica es la que importa, y por eso herramientas de verificación como el resaltado con cuadro delimitador comparan cada valor con la página de origen en lugar de confiar en la estructura serializada.
¿Qué herramientas son pipelines de análisis y cuáles son herramientas de extracción de columnas?
AWS Textract, Azure Document Intelligence, Google Document AI, Unstructured, Docling y LlamaParse son motores de pipeline de análisis: producen un modelo de documento para sistemas posteriores. ImageToTable.ai es una herramienta de extracción de columnas: cargue, nombre sus columnas y obtenga filas de hoja de cálculo. Las dos categorías resuelven resultados diferentes, que es exactamente la decisión de la que trata este artículo.
La próxima vez que un proveedor de IA documental le muestre un pipeline de análisis, pregunte qué parte de él consumirá su hoja de cálculo. Si la respuesta honesta es "solo los valores", usted ya conoce la ruta más corta: nombre las columnas, ejecute el lote y revise las filas que necesiten una segunda mirada. Ejecute sus propios documentos mediante la extracción de columnas y compare el resultado con lo que le daría un pipeline de análisis.