Você Precisa de um Pipeline de Análise
para Dados de Planilha?
A equipe média de contas a pagar ainda paga cerca de $9.40 para processar uma fatura, e apenas 32.6% das faturas passam de ponta a ponta sem que um humano as toque (Ardent Partners, State of ePayables 2024). Quando uma equipe que só precisa de dados de fornecedores em colunas recebe essa lacuna como justificativa, a resposta padrão é "você precisa de um pipeline de análise de documentos."
Um pipeline de análise é uma arquitetura real e resolve problemas reais, mas foi projetado para um destino diferente. Sua saída é um modelo de documento: o layout, a ordem de leitura, as tabelas, tudo preservado para que o conteúdo possa ser fragmentado e alimentado a um sistema de recuperação. Se o seu entregável são linhas em uma planilha, você pode estar comprando a arquitetura que o projeto de RAG de outra pessoa precisa, não a que sua planilha precisa. Este artigo explica o que cada abordagem realmente produz, o que o pipeline custa quando linhas são o objetivo e quando um pipeline de análise é realmente a escolha certa.
Principais Conclusões
- Apenas 32.6% das faturas são processadas sem que um humano as toque, e o pipeline apresentado como solução retorna um modelo de documento em vez das linhas que uma planilha consome.
- O pipeline não remove a etapa de extração, ele a move para uma camada que você ainda precisa escrever, e um contrato de 40 páginas ainda custa quarenta páginas mesmo quando você só precisa de uma data de renovação.
- A pergunta decisiva é o destino: linhas em uma planilha apontam para extração de colunas nomeadas, e um corpus de documentos consultável ou que preserva o layout é onde o pipeline de análise justifica seu custo.
Por que uma Meta de Planilha Acaba Vendendo um Pipeline de Análise
O termo "análise de documentos" tem um significado preciso na literatura de pesquisa. Uma pesquisa de 2024 na área o define como a conversão de documentos não estruturados ou semiestruturados em representações estruturadas e legíveis por máquina para aplicações downstream, como construção de base de conhecimento e geração aumentada por recuperação, ou RAG (Document Parsing Unveiled, arXiv:2410.21169). Um pipeline de análise reconstrói o documento: OCR em páginas digitalizadas, análise de layout para encontrar blocos de texto e tabelas, ordem de leitura reconstruída para que páginas de duas colunas fluam corretamente, estrutura de células de tabela reconhecida e tudo serializado em Markdown ou JSON. Essa representação é então dividida em fragmentos, incorporada e indexada para que uma IA possa responder perguntas sobre o documento posteriormente.
Essa sequência resolve um problema específico: tornar um corpus inteiro de documentos pesquisável e respondível. É uma arquitetura de base de conhecimento. Equipes que avaliam ferramentas de automação de documentos costumam vê-la porque é onde grande parte do investimento atual em IA para documentos foi direcionado, e é genuinamente impressionante. A questão é se o problema da equipe é "responder perguntas sobre um corpus de documentos" ou "colocar o número da fatura, a data de vencimento e o total em três colunas." São problemas diferentes, e o segundo não se beneficia automaticamente da maquinaria do primeiro.
Um pipeline de análise produz uma representação estruturada do documento. A extração de colunas produz uma representação estruturada dos campos que você solicitou. São saídas diferentes, e a segunda está mais próxima do que uma planilha realmente consome.
O que um Pipeline de Análise Realmente Faz, Passo a Passo
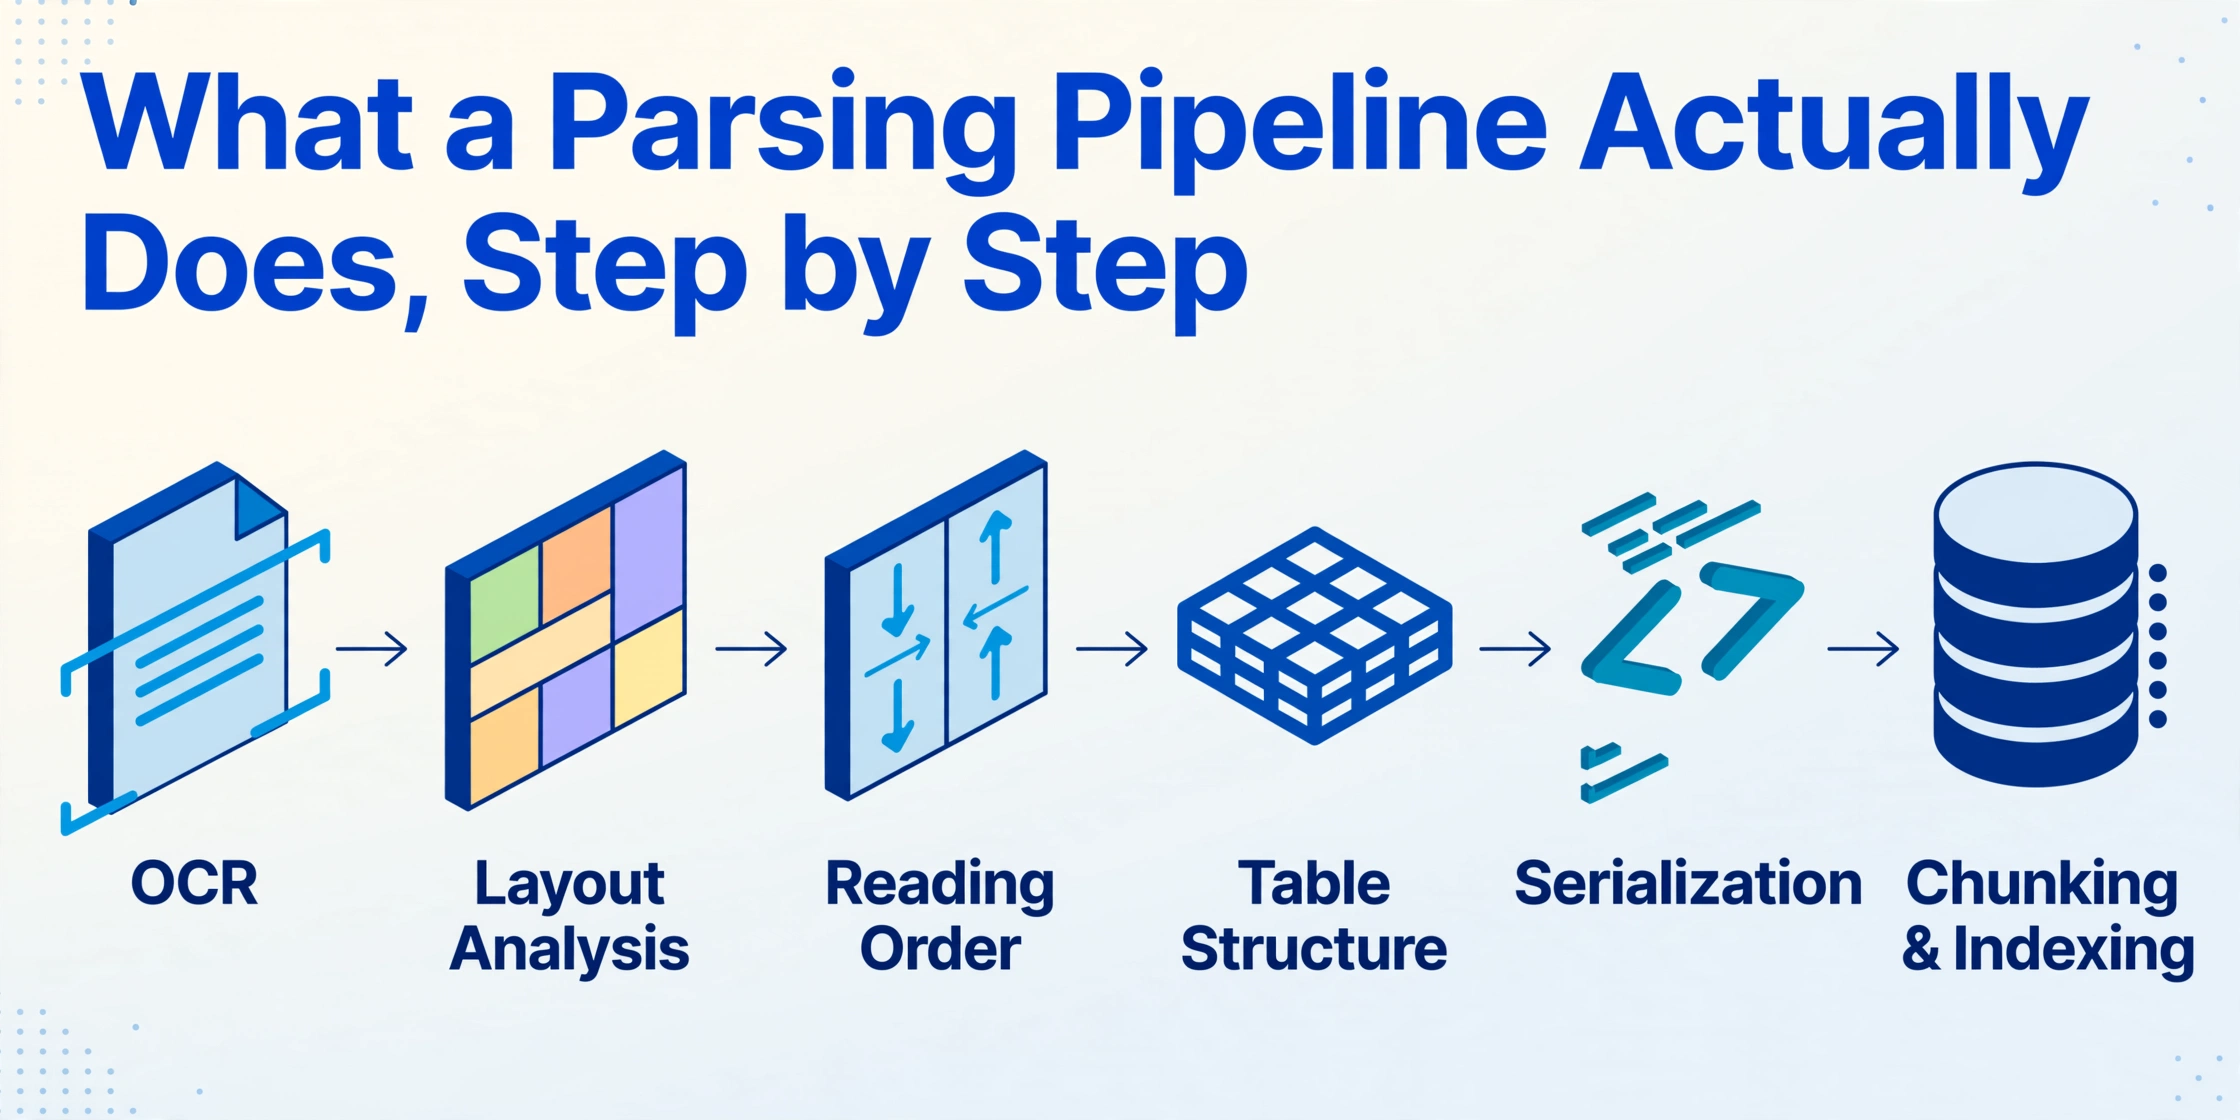
Quando alguém propõe um pipeline de análise para os dados dos seus documentos, este é o trabalho concreto envolvido, na ordem em que é executado.
Aquisição de texto
Documentos digitalizados e fotografados passam por OCR para produzir uma camada de texto. PDFs nativamente digitais podem ter uma camada de texto incorporada que pode ser lida diretamente, o que é mais rápido, porém menos confiável para layouts complexos.
Análise de layout
A página é segmentada em blocos de texto, tabelas, figuras, cabeçalhos e rodapés. É aqui que o parser aprende qual texto pertence a uma tabela e qual a um parágrafo.
Reconstrução da ordem de leitura
Páginas com várias colunas são remontadas na ordem em que uma pessoa as leria. Sem essa etapa, uma fatura de duas colunas é lida da coluna esquerda até o fim, depois a coluna direita, o que embaralha o conteúdo para qualquer uso posterior.
Reconhecimento da estrutura de tabelas
Linhas, colunas, células mescladas e extensões são identificadas para que uma tabela permaneça como tabela em vez de se achatar em uma sequência de células.
Serialização
O resultado é gravado como Markdown, JSON ou HTML, geralmente com caixas delimitadoras e números de página anexados, para que cada elemento possa ser rastreado até suas coordenadas de origem.
Fragmentação e indexação
Para stacks de RAG, a saída analisada é dividida em fragmentos dimensionados para embedding, incorporada em vetores e carregada em um índice que um sistema de recuperação pode consultar.
Mecanismos conhecidos nessa categoria incluem AWS Textract, Azure Document Intelligence, Google Document AI, Unstructured, Docling e LlamaParse, que é construído em torno do stack LlamaIndex. Extend é um participante mais recente no mesmo segmento de APIs de análise e extração. Eles diferem em níveis, preço por página e fidelidade da saída, mas compartilham a mesma arquitetura: analisar o documento em um modelo e, em seguida, entregar o modelo a quem o consome. Um desenvolvedor comparando esses mecanismos no Reddit resumiu a realidade prática de todos eles: "Todos sólidos, todos pagos por página e, sim, todos exigem que você orquestre o pipeline de análise você mesmo" (r/LLMDevs).
O que a Extração de Colunas faz em vez disso
A filosofia alternativa interrompe o fluxo de trabalho na resposta. Com a Extração de Colunas Personalizadas, você digita os nomes das colunas desejadas: "Número da Fatura", "Data de Vencimento", "Valor Total". A IA lê o documento e localiza cada valor entendendo o que o nome da coluna significa, em qualquer lugar da página, sem coordenadas e sem modelo de layout envolvido. Os nomes das colunas que você insere tornam-se os cabeçalhos da tabela de saída, então a unidade de trabalho é um campo, não uma página.
Nada neste fluxo precisa de um modelo de documento. Não há etapa de análise de layout, nem reconstrução de ordem de leitura, nem serialização em Markdown, nem fragmentação. A IA recebe uma pergunta por upload: "encontre os valores para estas colunas e retorne-os." O que você recebe de volta são linhas, e as linhas são o entregável. O processamento é prioritário em lote: envie uma pasta de faturas de fornecedores, e cada fatura vira sua própria linha em uma única planilha mesclada, em vez de um resultado de análise por arquivo (um passo a passo mais completo de como a extração de documentos por IA lê uma página detalha o mecanismo).
Como os campos são o pedido, a abordagem não se importa com o layout do fornecedor que o documento usa, o que é abordado separadamente em nossa análise sobre extração de documentos sem modelo. Um fornecedor que altera o modelo de sua fatura não invalida nada, porque as definições de coluna nunca foram vinculadas a uma posição na página.
O que o pipeline de análise custa para uma equipe que só precisa de linhas
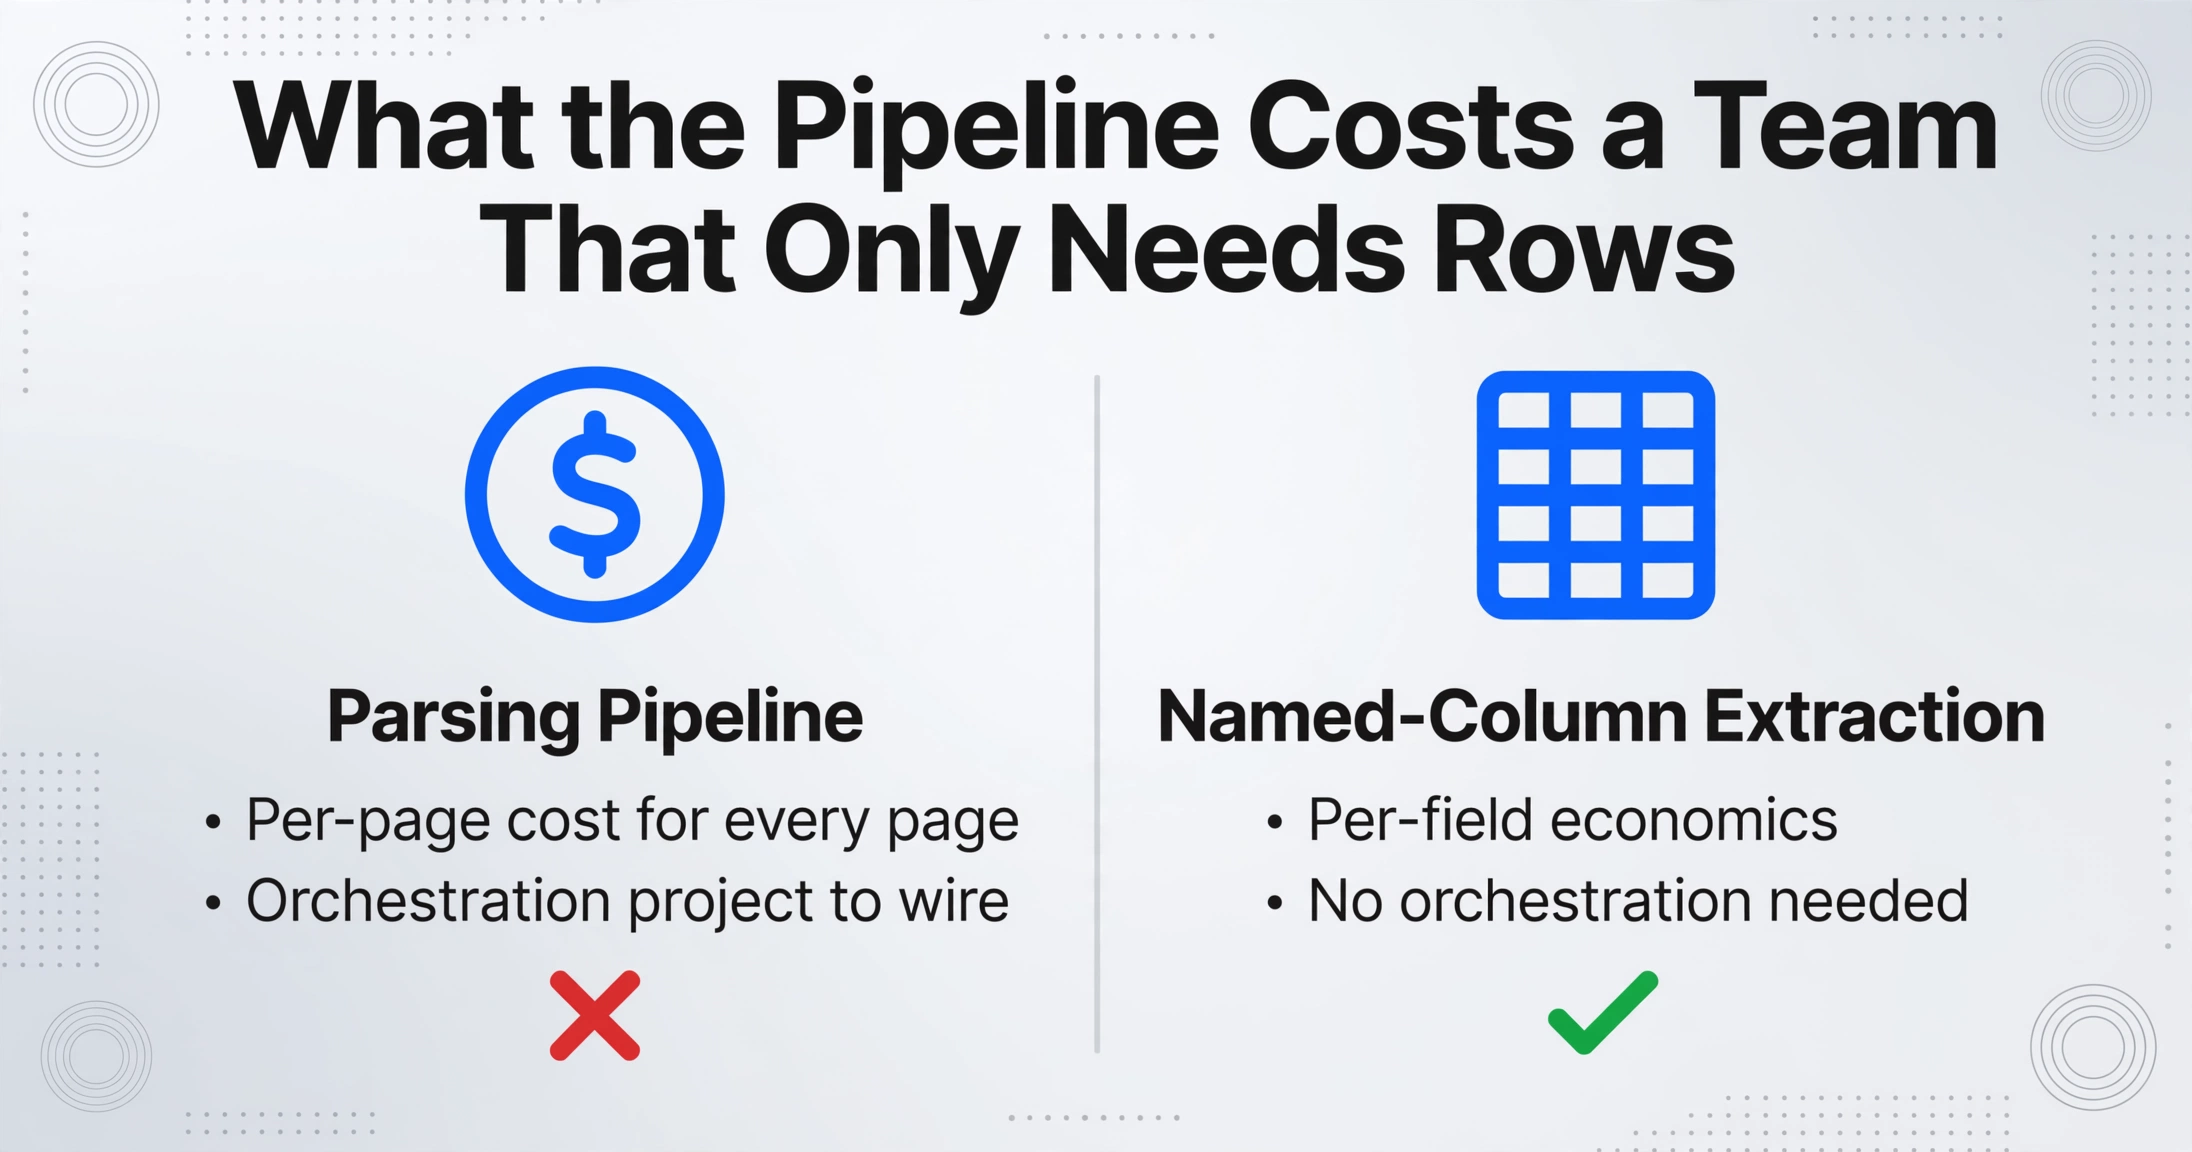
Um pipeline de análise não é errado para um objetivo de planilha, é apenas mais máquina do que o trabalho precisa, e a máquina extra aparece em três lugares.
Você paga por páginas quando sua unidade de valor é um campo. As APIs de análise cobram por página ou por crédito para OCR e processamento de layout. Cada página é analisada por completo, incluindo o texto padrão que você nunca mais verá, porque é isso que a reconstrução de documento significa. Uma fatura que ocupa uma página custa uma página. Um contrato de 40 páginas custa quarenta páginas, mesmo quando o entregável é uma data de renovação e um nome de parte. Linhas em uma planilha geralmente são alguns campos por documento, e a economia por campo é o que a extração de colunas cobra, não o custo por página de reconstruir tudo.
Você herda um projeto de orquestração. O comentário no Reddit acima disse claramente: todo analisador na categoria exige que você monte o pipeline sozinho. Um usuário do Textract no r/aws descreveu a mesma experiência em outro registro: é "bastante caro para um grande número de documentos", e "se o layout do documento for incomum, pode dar resultados errados" (r/aws). Alguém precisa conectar a etapa de OCR à etapa de layout, lidar com novas tentativas, manter a fragmentação consistente e implantar o resultado. Para uma equipe de uma ou duas pessoas de operações cujo trabalho real são dados de fornecedores em uma planilha, essa orquestração é o trabalho que elas tentavam automatizar.
The pipeline ends where your extraction starts. Here is the part that rarely appears in the vendor comparison page: a parsing pipeline hands you markdown, not fields. To get "due date" out of a parsed document, you still write your own extraction layer, either pattern matching over the markdown or a schema prompt against an LLM, and then you validate its output. Some parsing platforms bundle an extraction endpoint, but it is an add-on, and the engineering cost of mapping parsed output into the rows your sheet needs is still yours. That is a second extraction project bolted onto the first.
There is a human version of that same double-handling, and it has measured error rates. A 2023 systematic review and meta-analysis of data processing methods in clinical research found a pooled error rate of 6.57% when someone reads a value from a source document and manually enters it into a structured record, against 0.29% for direct keying and 0.74% for automated scanning (Garza et al., 2023). When the parsed markdown gets re-keyed into a spreadsheet by hand, the step is the same and the error lives at the same place: the human interface between two representations.
The pipeline does not remove the extraction step. It moves it down the chain: from the document to the markdown, and from you to the small script or schema prompt you still have to ship.
How Named-Column Extraction Maps Directly to a Spreadsheet Goal
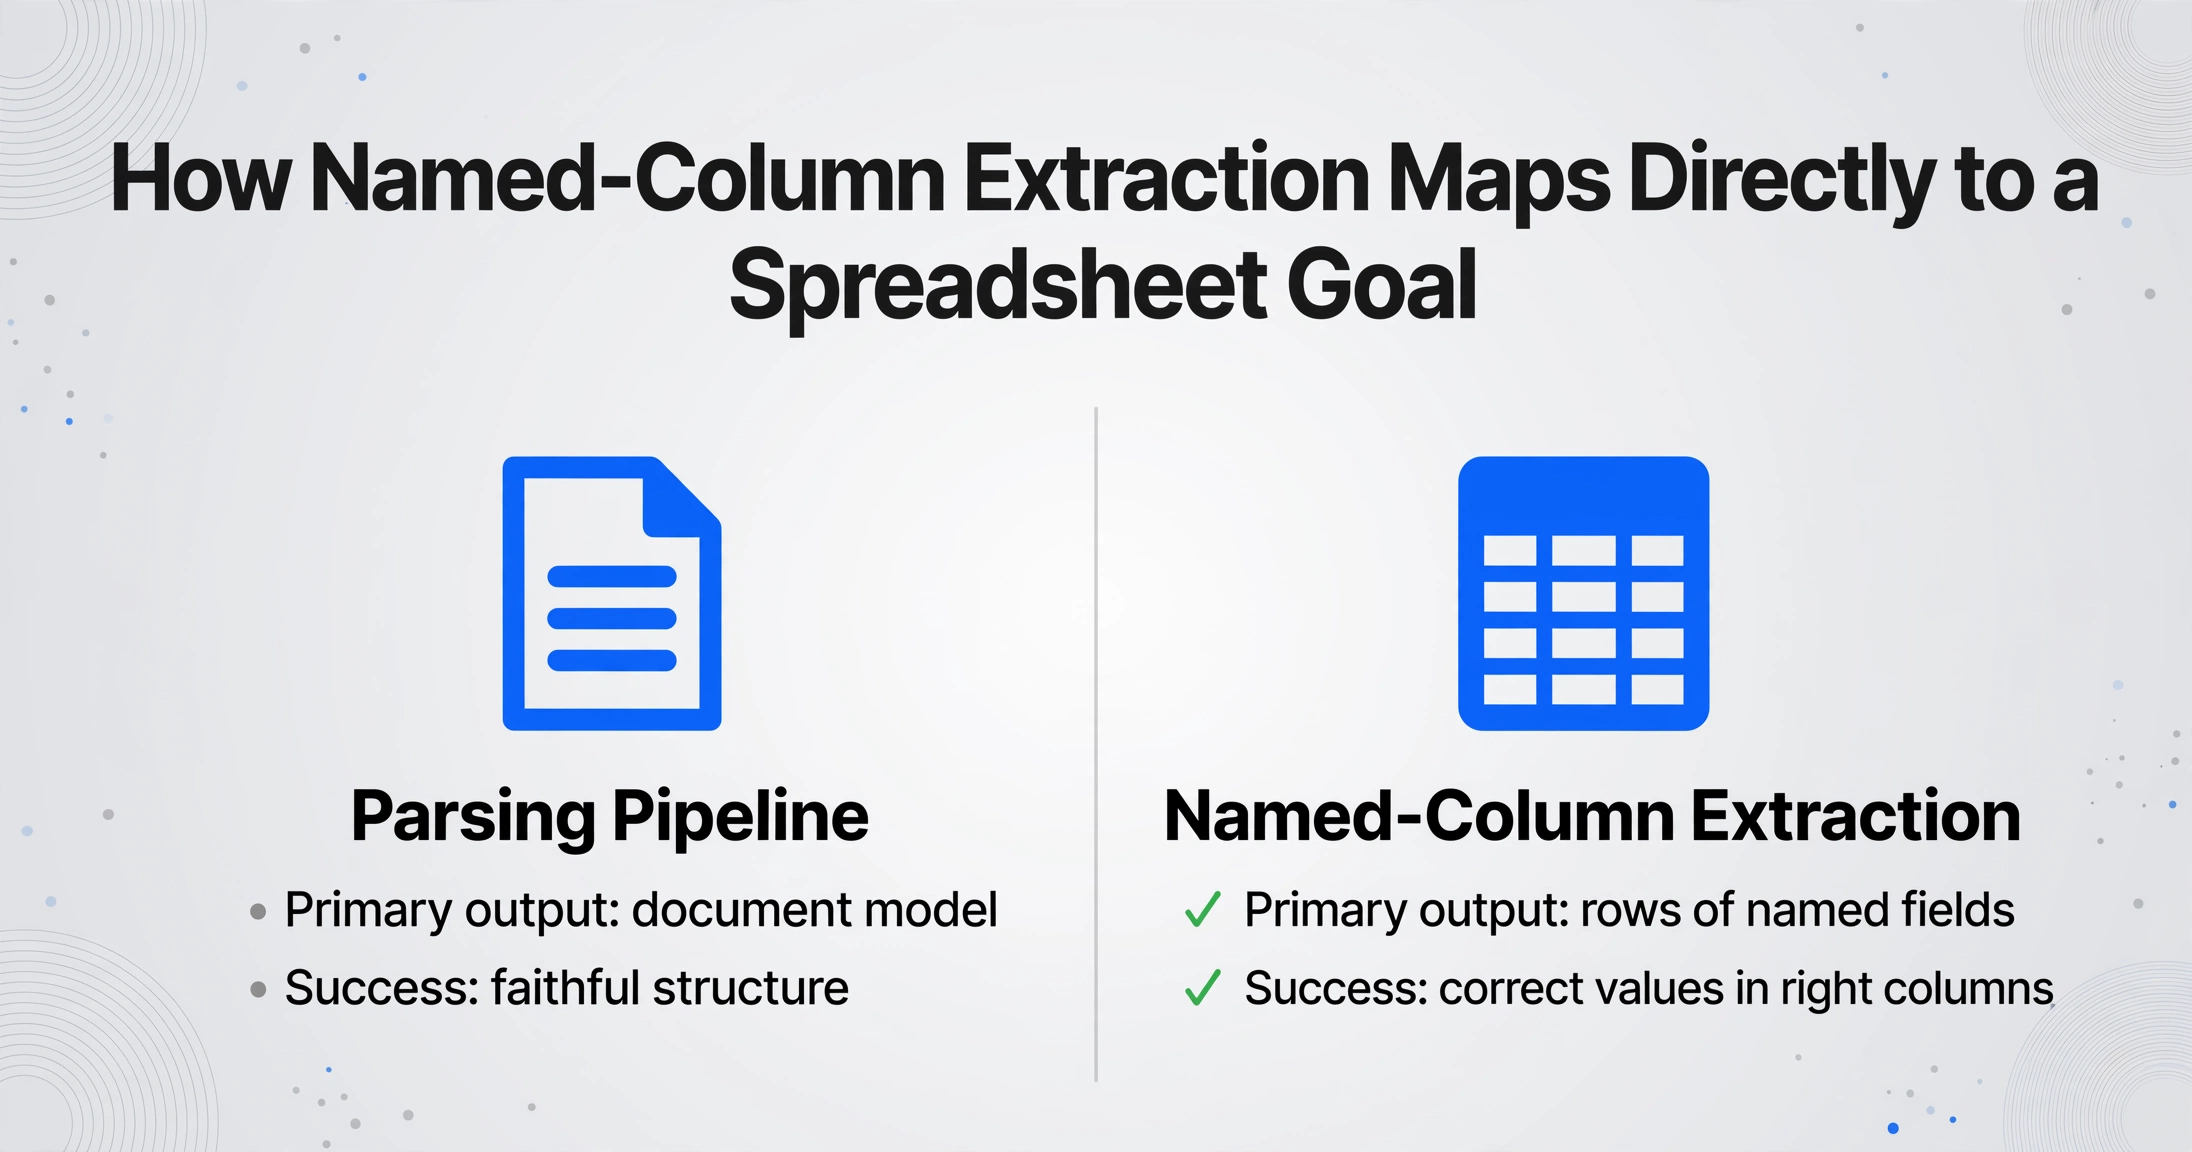
Against that cost structure, column extraction is deliberately minimal. The workflow is: upload the documents, enter the column names once, run the batch. The tool reads every file, fills the columns, and merges the results into a single spreadsheet, no parsing project, no orchestration, no second extraction phase. Processing a single page takes about 5 to 10 seconds where manual entry runs closer to three minutes, a roughly 18x difference that comes from the same efficiency numbers we publish across the product.
Two product settings matter for teams that need to trust the output. Model Tier lets an account pick a stronger vision model for dense handwriting, complex layouts, or documents where small slip-ups are costly, while the standard tier already covers most printed tabular documents. And Review Mode with bounding-box highlighting maps every extracted value back to its exact location on the original page: hover a cell and the source region lights up, click the region and the cell is found. Teams that compare this with a parsed markdown dump usually find the per-field source trace is exactly the verification layer a spreadsheet audit needs.
| Pipeline de análise | Extração de colunas nomeadas | |
|---|---|---|
| Saída principal | Modelo de documento: layout, ordem de leitura, tabelas como Markdown ou JSON | Linhas dos campos que você nomeou |
| O que determina o sucesso | Estrutura fiel, fragmentos limpos para recuperação | Valores corretos nas colunas certas |
| Configuração | Escolha do mecanismo, configuração por página, orquestração, fragmentação, índice | Digite os nomes das colunas desejadas uma vez |
| Uso natural posterior | RAG, agentes, busca semântica em um corpus | Excel, Google Sheets, importações de ERP, relatórios |
| O que você mantém | Código de integração, novas tentativas, mapeamento de esquema na saída analisada | Revisão das linhas que precisam de uma segunda olhada |
A história da verificação é onde um fluxo de extração de colunas muitas vezes se confirma no primeiro lote. Execute suas faturas, abra o modo de revisão e confira os campos sinalizados nas páginas de origem, em vez de ler cada valor duas vezes. Para equipes que vêm de ferramentas com modelo, que quebram sempre que um fornecedor muda o layout, essa experiência do primeiro lote costuma ser o argumento decisivo, como abordado nas discussões sobre migrar do Docparser e migrar do Parseur. Se você ainda está comparando nomes individuais nesse espaço, nossa comparação com o Parseur analisa ferramenta por ferramenta.
Quando Você Realmente Precisa de um Pipeline de Análisis
A extração de colunas não é um substituto universal, e dizer o contrário seria deshonesto. Um pipeline de análise é a arquitetura correta para quatro necessidades concretas.
RAG e IA conversacional sobre um corpus. Se o entregable é "responder perguntas em 10.000 documentos de políticas" ou "um agente que extrae citações de uma base de conhecimento", você precisa de chunks, embeddings e um índice de recuperação. A extração de colunas retorna campos, não conteúdo recuperable. O modelo de documento do pipeline de análise é exatamente o que este caso de uso consome, e é genuinamente aqui onde a abordagem brilla.
Modelos de documento que preservan o layout. Alguns sistemas downstream devem manter o documento como documento: uma plataforma de revisão legal que precisa reconstruir uma cláusula contractual em ordem de leitura, um fluxo de trabalho de pesquisa que precisa refluir corretamente um artigo de duas colunas, um sistema de arquivo que mantiene a estrutura visual da fonte. Uma tabela de campos descarta essa estrutura por design. Quando a saída é consumida como documento, você quer o pipeline.
Busca de conteúdo completo. Se a métrica de éxito é a busca em linguagem natural sobre tudo o que os documentos dizem, não sobre as colunas que eles preenchem, o índice precisa do conteúdo analizado completo. Uma planilha de campos clave não é substituto para um corpo de texto consultable.
Estrutura de documento como produto. Uma equipe que constrói ferramentas de documento como seu próprio produto, onde outros desenvolvedores consomem Markdown analizado ou árvores de layout via API, precisa da capa de análise como infraestructura. Isso é um entregable de desenvolvedor, não um entregable de operações.
A regra de decisión é o destino: filas em uma planilha apuntan a extração de colunas, um corpus de documentos consultable ou que preserva layout apunta a um pipeline de análise. Equipes que precisan ambos executan ambos, mas a metade da planilha não requer que a metade do pipeline seja construida primeiro.
Para leitores que ainda comparan ferramentas pelo nome, o resumen anual de APIs de OCR e documentos lista os principais motores lado a lado, incluindo os de pipeline de análise. O que nenhuno desses motores promete é o que a extração de colunas oferece de antemano: nenhuna construção de pipeline, nenhun esquema de fragmentación, apenas as colunas que você nomeou.
FAQ
Qual é a diferença entre análise de documentos e extração de dados?
A análise de documentos reconstrói o próprio documento: layout, ordem de leitura, tabelas, serializados em Markdown ou JSON para sistemas downstream. A extração de dados captura os campos específicos que você define, como data da fatura ou valor total, e os retorna como linhas. O primeiro produz um modelo de documento, o segundo produz a resposta que você pediu.
Preciso de um pipeline de análise para extrair dados de PDFs para uma planilha?
Não. Se o seu resultado final são linhas de campos nomeados em uma planilha, a extração de colunas lê o documento e preenche as colunas diretamente. Um pipeline de análise adiciona custos de análise por página, uma etapa de orquestração e uma camada de extração separada que mapeia o Markdown analisado para os campos desejados.
Quando um pipeline de análise faz sentido?
Quando a saída precisa ser o documento: sistemas RAG e agentes que recuperam informações de um corpus inteiro, fluxos de trabalho que preservam o layout, busca de conteúdo completo ou criação de ferramentas de documentos como produto. Nesses casos, o modelo de documento do pipeline é genuinamente a base certa.
A análise é mais precisa do que a extração de colunas para tabelas?
Elas são medidas por critérios diferentes. A análise é avaliada pela fidelidade com que a estrutura da tabela sobrevive em Markdown ou JSON. A extração de colunas é avaliada se o valor em uma coluna nomeada está correto. Para uma planilha, a segunda métrica é a que importa, e é por isso que ferramentas de verificação como o destaque de caixa delimitadora comparam cada valor com a página de origem em vez de confiar na estrutura serializada.
Quais ferramentas são pipelines de análise e quais são ferramentas de extração de colunas?
AWS Textract, Azure Document Intelligence, Google Document AI, Unstructured, Docling e LlamaParse são mecanismos de pipeline de análise: eles produzem um modelo de documento para sistemas downstream. ImageToTable.ai é uma ferramenta de extração de colunas: envie, nomeie suas colunas, obtenha linhas de planilha. As duas categorias resolvem saídas diferentes, que é exatamente a decisão sobre a qual este artigo trata.
Na próxima vez que um fornecedor de IA para documentos mostrar um pipeline de análise, pergunte qual parte dele sua planilha consumirá. Se a resposta honesta for "apenas os valores", você já sabe o caminho mais curto: nomeie as colunas, execute o lote e verifique as linhas que precisam de uma segunda olhada. Execute seus próprios documentos com extração de colunas e compare a saída com o que um pipeline de análise lhe daria.