スプレッドシートデータに
解析パイプラインは必要ですか?
平均的な買掛金チームは、1枚の請求書を処理するのに今でも約9.40ドルを支払っており、人間が触れることなく最初から最後まで処理される請求書はわずか32.6%です(Ardent Partners、State of ePayables 2024)。サプライヤーデータを列に並べるだけでよいチームがこのギャップを指摘されると、標準的な答えは「ドキュメント解析パイプラインが必要です」です。
解析パイプラインは本物のアーキテクチャであり、実際の問題を解決しますが、それは異なる目的地のために設計されました。その出力はドキュメントモデルです。レイアウト、読み順、テーブルがすべて保持され、コンテンツをチャンク分割して検索システムに供給できるようになっています。成果物がスプレッドシートの行である場合、あなたは誰か他の人のRAGプロジェクトが必要とするアーキテクチャを購入しているかもしれません。この記事では、各アプローチが実際に何を生成するのか、行が目標である場合にパイプラインがかかるコスト、そして解析パイプラインが本当に正しい選択となる場合について説明します。
重要なポイント
- 人間が触れることなく処理される請求書はわずか32.6%であり、その解決策として提案されるパイプラインは、スプレッドシートが消費する行ではなくドキュメントモデルを返します。
- パイプラインは抽出ステップをなくすのではなく、それをチェーンの下流の、まだ自分で書かなければならない層に移すだけであり、40ページの契約書は、更新日が1つだけ必要な場合でも40ページ分のコストがかかります。
- 決め手となる質問は目的地です。スプレッドシートの行は名前付き列抽出を指し、検索可能またはレイアウトを保持するドキュメントコーパスこそ、解析パイプラインがそのコストに見合う場所です。
スプレッドシートの目標なのに、なぜ解析パイプラインが売り込まれるのか
「ドキュメント解析」という用語は、研究文献において正確な意味を持ちます。2024年のこの分野の調査では、非構造化または半構造化ドキュメントを、ナレッジベース構築や検索拡張生成(RAG)などの下流アプリケーション向けに、構造化された機械可読な表現に変換することと定義されています(Document Parsing Unveiled、arXiv:2410.21169)。解析パイプラインはドキュメントを再構築します。スキャンされたページのOCR、テキストブロックとテーブルを見つけるレイアウト分析、二段組ページが正しく流れるようにする読み順の再構築、テーブルのセル構造の認識、そしてすべてをマークダウンまたはJSONにシリアライズします。その表現はその後、チャンクに分割され、埋め込まれ、インデックス作成され、AIが後でドキュメントに関する質問に答えられるようにします。
この一連の流れは、特定の問題を解決します。ドキュメントコーパス全体を検索可能で回答可能にすることです。これはナレッジベースのアーキテクチャです。ドキュメント自動化ツールを評価するチームは、現在のドキュメントAI投資の大部分がここに注がれており、実際に印象的であるため、日常的にこれを見せられます。問題は、チームの問題が「ドキュメントのコーパスに対する質問に答えること」なのか、「請求書番号、支払期日、合計額を3つの列に入れること」なのかです。これらは異なる問題であり、2番目の問題は1番目の仕組みから自動的に恩恵を受けるわけではありません。
解析パイプラインはドキュメントの構造化表現を生成します。列抽出は、要求したフィールドの構造化表現を生成します。これらは異なる出力であり、2番目の方がスプレッドシートが実際に消費するものに近いのです。
解析パイプラインが実際に行うこと、ステップバイステップ
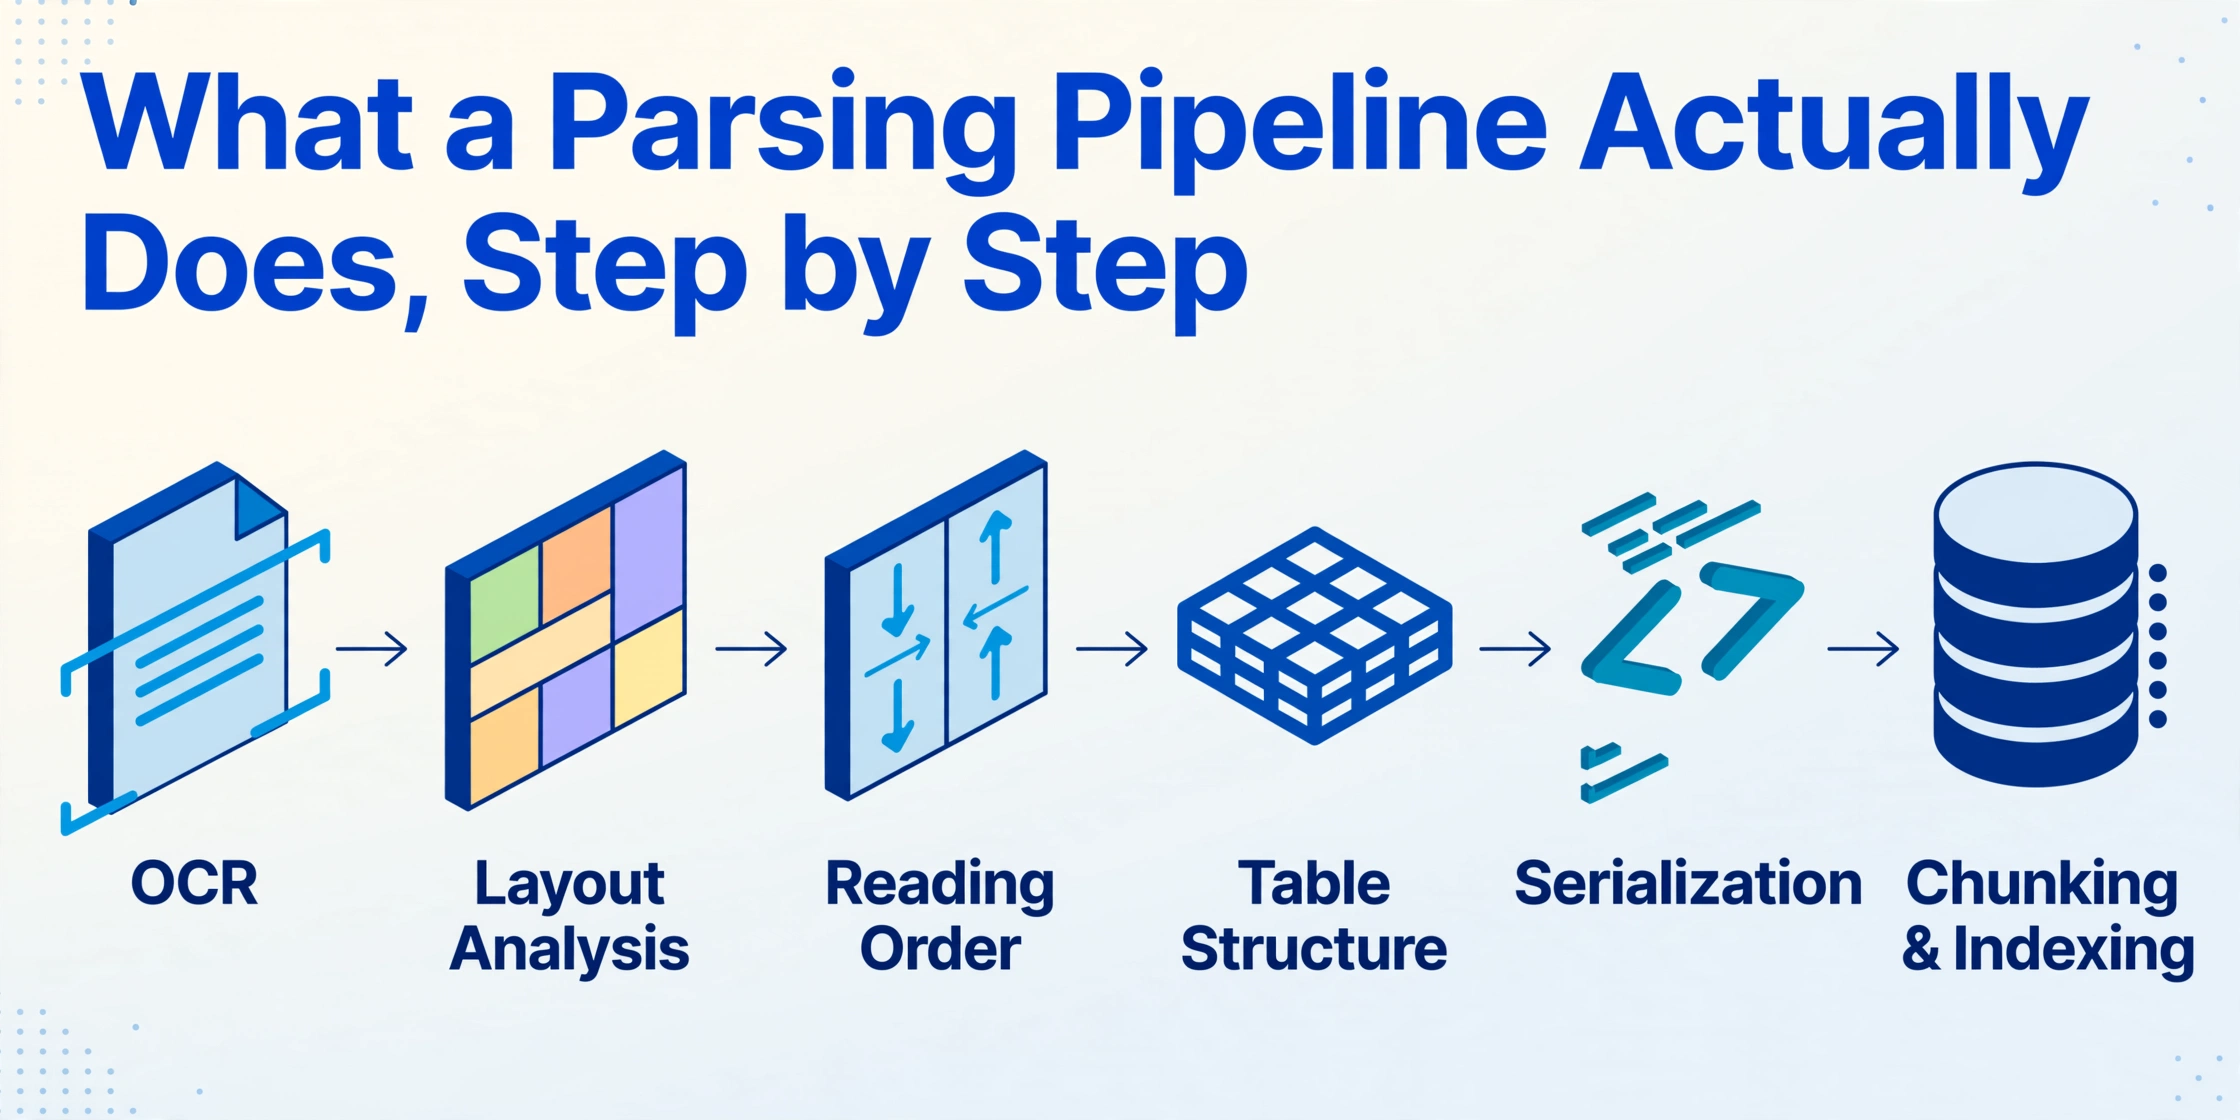
誰かがあなたのドキュメントデータに解析パイプラインを提案した場合、その中身の具体的な作業は、実行順に次のとおりです。
テキスト取得
スキャンや撮影されたドキュメントはOCRを経てテキストレイヤーが生成されます。生まれながらのデジタルPDFには埋め込みテキストレイヤーが含まれる場合があり、直接読み取れるため高速ですが、複雑なレイアウトでは信頼性が低くなります。
レイアウト分析
ページはテキストブロック、テーブル、図、ヘッダー、フッターに分割されます。ここでパーサーは、どのテキストがテーブルに属し、どのテキストが段落に属するかを学習します。
読み順の再構築
複数カラムのページは、人間が読む順序に再構成されます。このステップがないと、2カラムの請求書は左カラムを下まで読んでから右カラムに移るため、後続の処理でコンテンツが乱れてしまいます。
テーブル構造認識
行、列、結合セル、スパンが識別され、テーブルがセルの文字列に平坦化されることなく、テーブルとして保持されます。
シリアライズ
結果はマークダウン、JSON、またはHTMLとして出力され、通常はバウンディングボックスとページ番号が付与されるため、各要素を元の座標に追跡できます。
チャンク分割とインデックス作成
RAGスタックの場合、解析結果は埋め込みに適したサイズのチャンクに分割され、ベクトルに埋め込まれて、検索システムがクエリできるインデックスに読み込まれます。
このカテゴリの一般的なエンジンには、AWS Textract、Azure Document Intelligence、Google Document AI、Unstructured、Docling、LlamaIndexスタックを基盤とするLlamaParseなどがあります。Extendは同じ解析・抽出API分野の新規参入者です。これらはティアリング、ページ単位の価格設定、出力の忠実度が異なりますが、アーキテクチャは共通しています。ドキュメントをモデルに解析し、そのモデルを利用側に渡すという構造です。Redditでこれらのエンジンを比較していた開発者は、その現実を次のように要約しています。「どれも堅実で、すべてページ単位の課金で、パイプラインのオーケストレーションは自分で行う必要がある」(r/LLMDevs)。
カスタム列抽出が代わりに行うこと
この代替アプローチは、ワークフローを答えの時点で止めます。カスタム列抽出では、「請求書番号」「支払期日」「合計金額」など、必要な列名を入力するだけです。AIがドキュメントを読み取り、列名の意味を理解して、ページ上のどこにあっても各値を特定します。座標もレイアウトテンプレートも不要です。入力した列名が出力テーブルのヘッダーになるため、作業単位はページではなくフィールドになります。
このフローにはドキュメントモデルは一切必要ありません。レイアウト分析ステップも、読み取り順序の再構築も、マークダウンへのシリアライズも、チャンク分割もありません。AIにはアップロードごとに「これらの列の値を見つけて返してください」という1つの質問が投げられます。返ってくるのは行であり、その行が成果物です。処理はバッチファーストです。仕入先の請求書フォルダをアップロードすると、各請求書が1つの統合スプレッドシートの1行として格納され、ファイルごとの解析結果にはなりません(AIドキュメント抽出がページを読み取る仕組みの詳細な解説で、そのメカニズムを詳しく説明しています)。
フィールドが要求事項であるため、このアプローチはドキュメントがどのベンダーのレイアウトを使用しているかを気にしません。これについては、テンプレート不要のドキュメント抽出に関する記事で別途説明しています。仕入先が請求書テンプレートを変更しても、列定義がページ上の位置に紐付いていないため、何も無効になりません。
行だけが必要なチームにとってパイプラインがかかるコスト
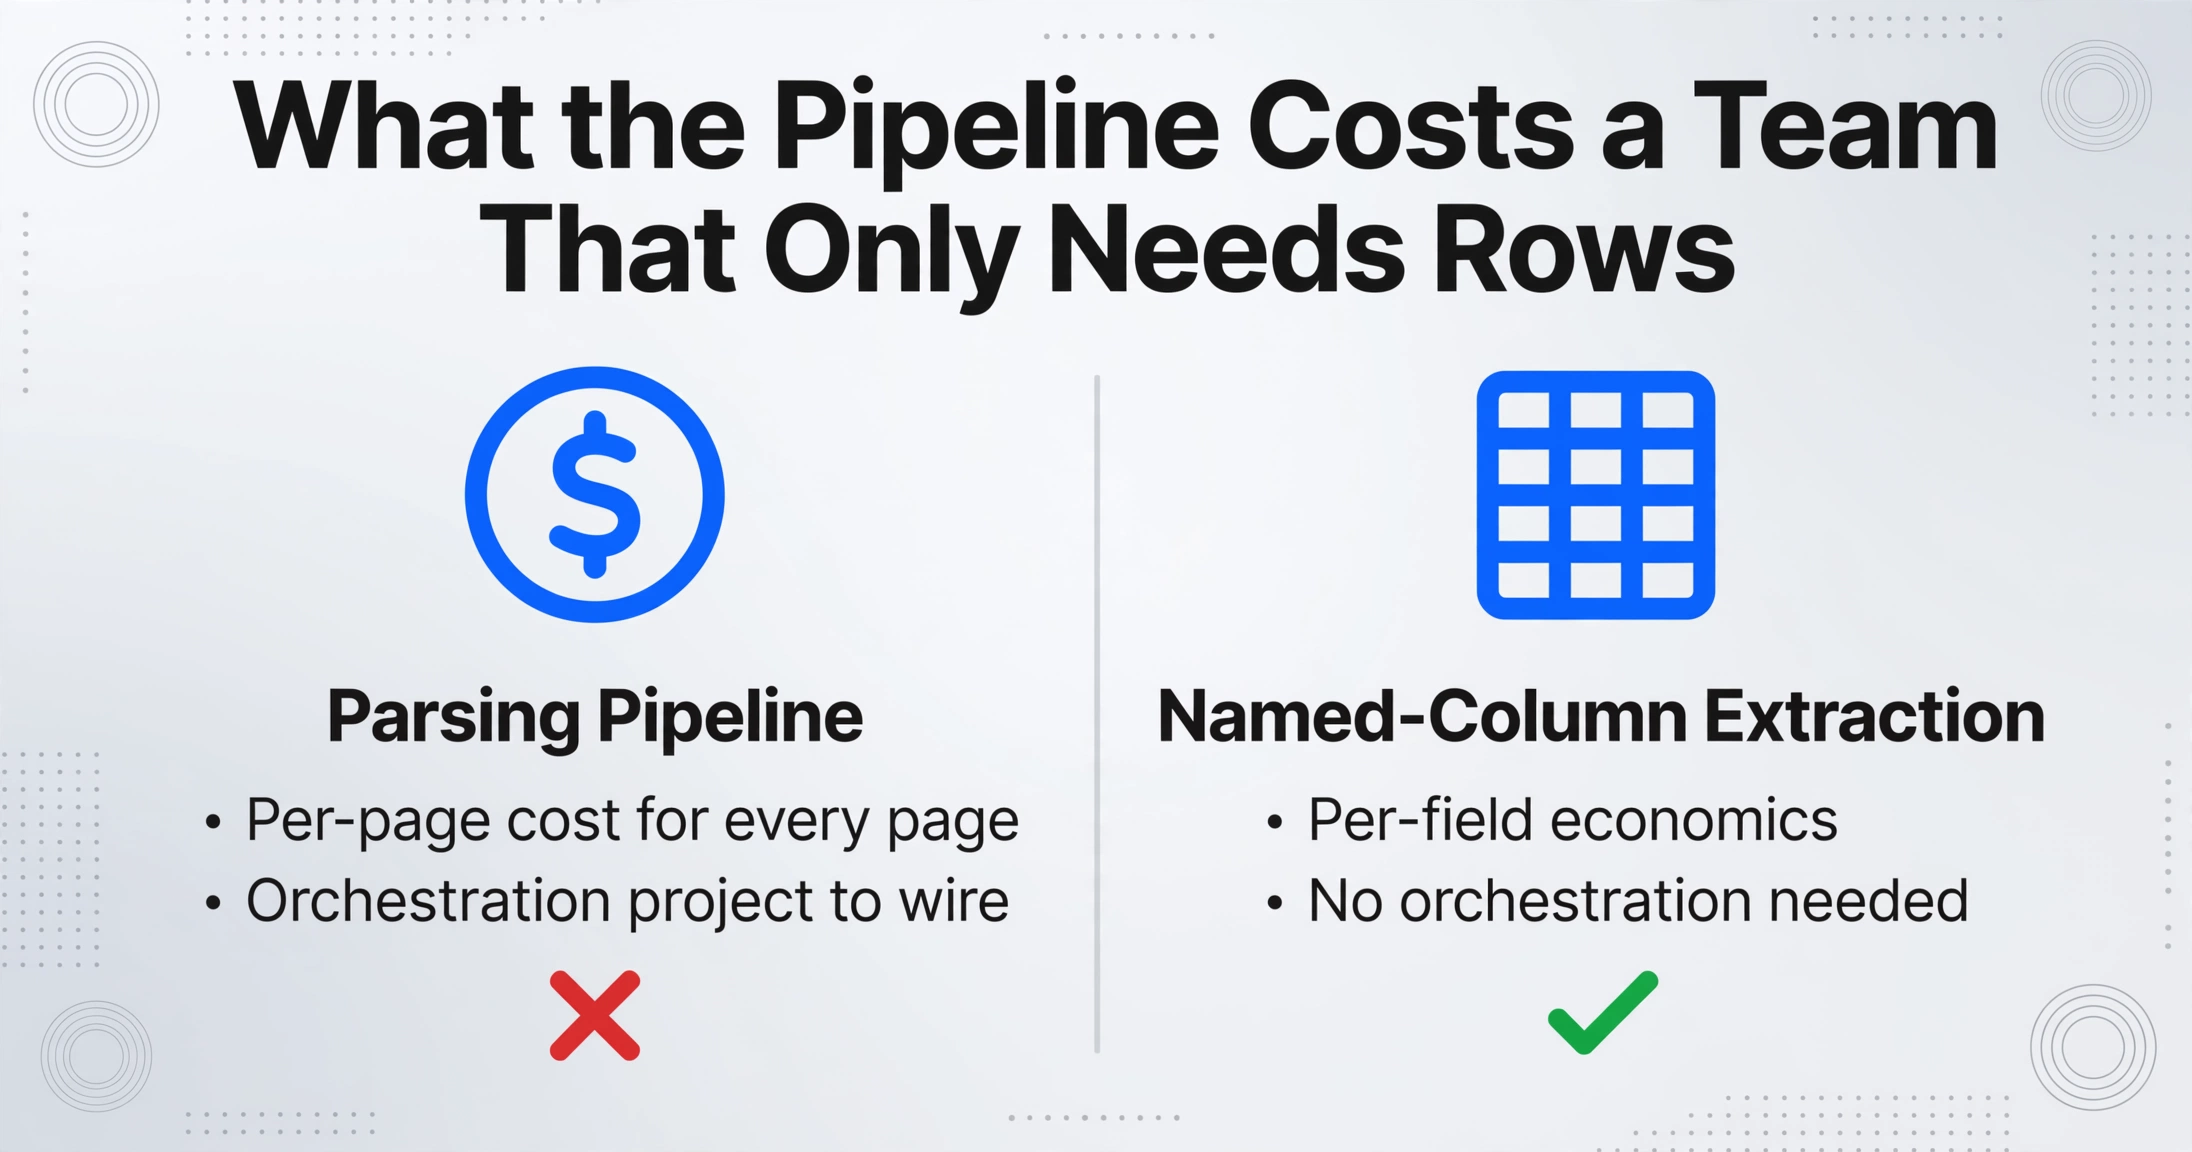
解析パイプラインはスプレッドシートを目的とする場合に間違っているわけではありません。ただ、必要な作業に対して過剰なマシンであり、その過剰さは3つの点に現れます。
価値の単位がフィールドであるのに、ページ単位で支払うことになります。解析APIは、OCRとレイアウト処理に対してページ単位またはクレジット単位で課金します。ドキュメント再構築の意味合いから、すべてのページが完全に解析され、二度と見ることのない定型文も含まれます。1ページの請求書は1ページ分のコストがかかります。40ページの契約書は、成果物が更新日と当事者名だけでも40ページ分かかります。スプレッドシートの行は通常、ドキュメントあたり数フィールドであり、列抽出はすべてを再構築するページ単位のコストではなく、フィールド単位の経済性に基づいて課金されます。
オーケストレーションプロジェクトを引き継ぐことになります。上記のRedditコメントは明確に述べています。このカテゴリのすべてのパーサーは、パイプラインを自分で配線する必要があります。r/awsのTextractユーザーは、別の表現で同じ経験を述べています。それは「大量のドキュメントに対してはかなり高価」であり、「ドキュメントのレイアウトが通常と異なる場合、誤った結果を返す可能性がある」としています(r/aws)。誰かがOCRステップをレイアウトステップに接続し、リトライを処理し、チャンク分割の一貫性を保ち、結果をデプロイする必要があります。実際の仕事がシート内の仕入先データである1〜2人の運用担当者のチームにとって、そのオーケストレーションこそが、自動化しようとしていた仕事そのものです。
パイプラインが終わるところから、抽出が始まります。ここは、ベンダーの比較ページにはほとんど載っていない部分です。解析パイプラインが渡してくるのはマークダウンであり、フィールドではありません。解析済みドキュメントから「期日」を取り出すには、マークダウン上のパターンマッチングか、LLMに対するスキーマプロンプトを使って、独自の抽出レイヤーを自分で書き、その出力を検証する必要があります。一部の解析プラットフォームには抽出エンドポイントがバンドルされていますが、それはアドオンであり、解析出力をシートが必要とする行にマッピングするエンジニアリングコストは依然としてユーザーの負担です。これは、最初のプロジェクトに後付けされた2つ目の抽出プロジェクトです。
同じ二重処理には人手によるバージョンもあり、測定されたエラー率が存在します。臨床研究におけるデータ処理方法に関する2023年の系統的レビューとメタ分析では、ソースドキュメントから値を読み取って構造化レコードに手動で入力する場合のプールエラー率は6.57%で、直接キー入力の0.29%、自動スキャンの0.74%と比較されています(Garza et al., 2023)。解析されたマークダウンを手作業でスプレッドシートに再入力する場合も、ステップは同じで、エラーは同じ場所、つまり2つの表現の間のヒューマンインターフェースに存在します。
パイプラインは抽出ステップを排除しません。それをチェーンの下流に移すだけです。ドキュメントからマークダウンへ、そしてユーザーから、依然として提供しなければならない小さなスクリプトやスキーマプロンプトへ。
名前付き列抽出がスプレッドシートの目標に直接マッピングされる仕組み
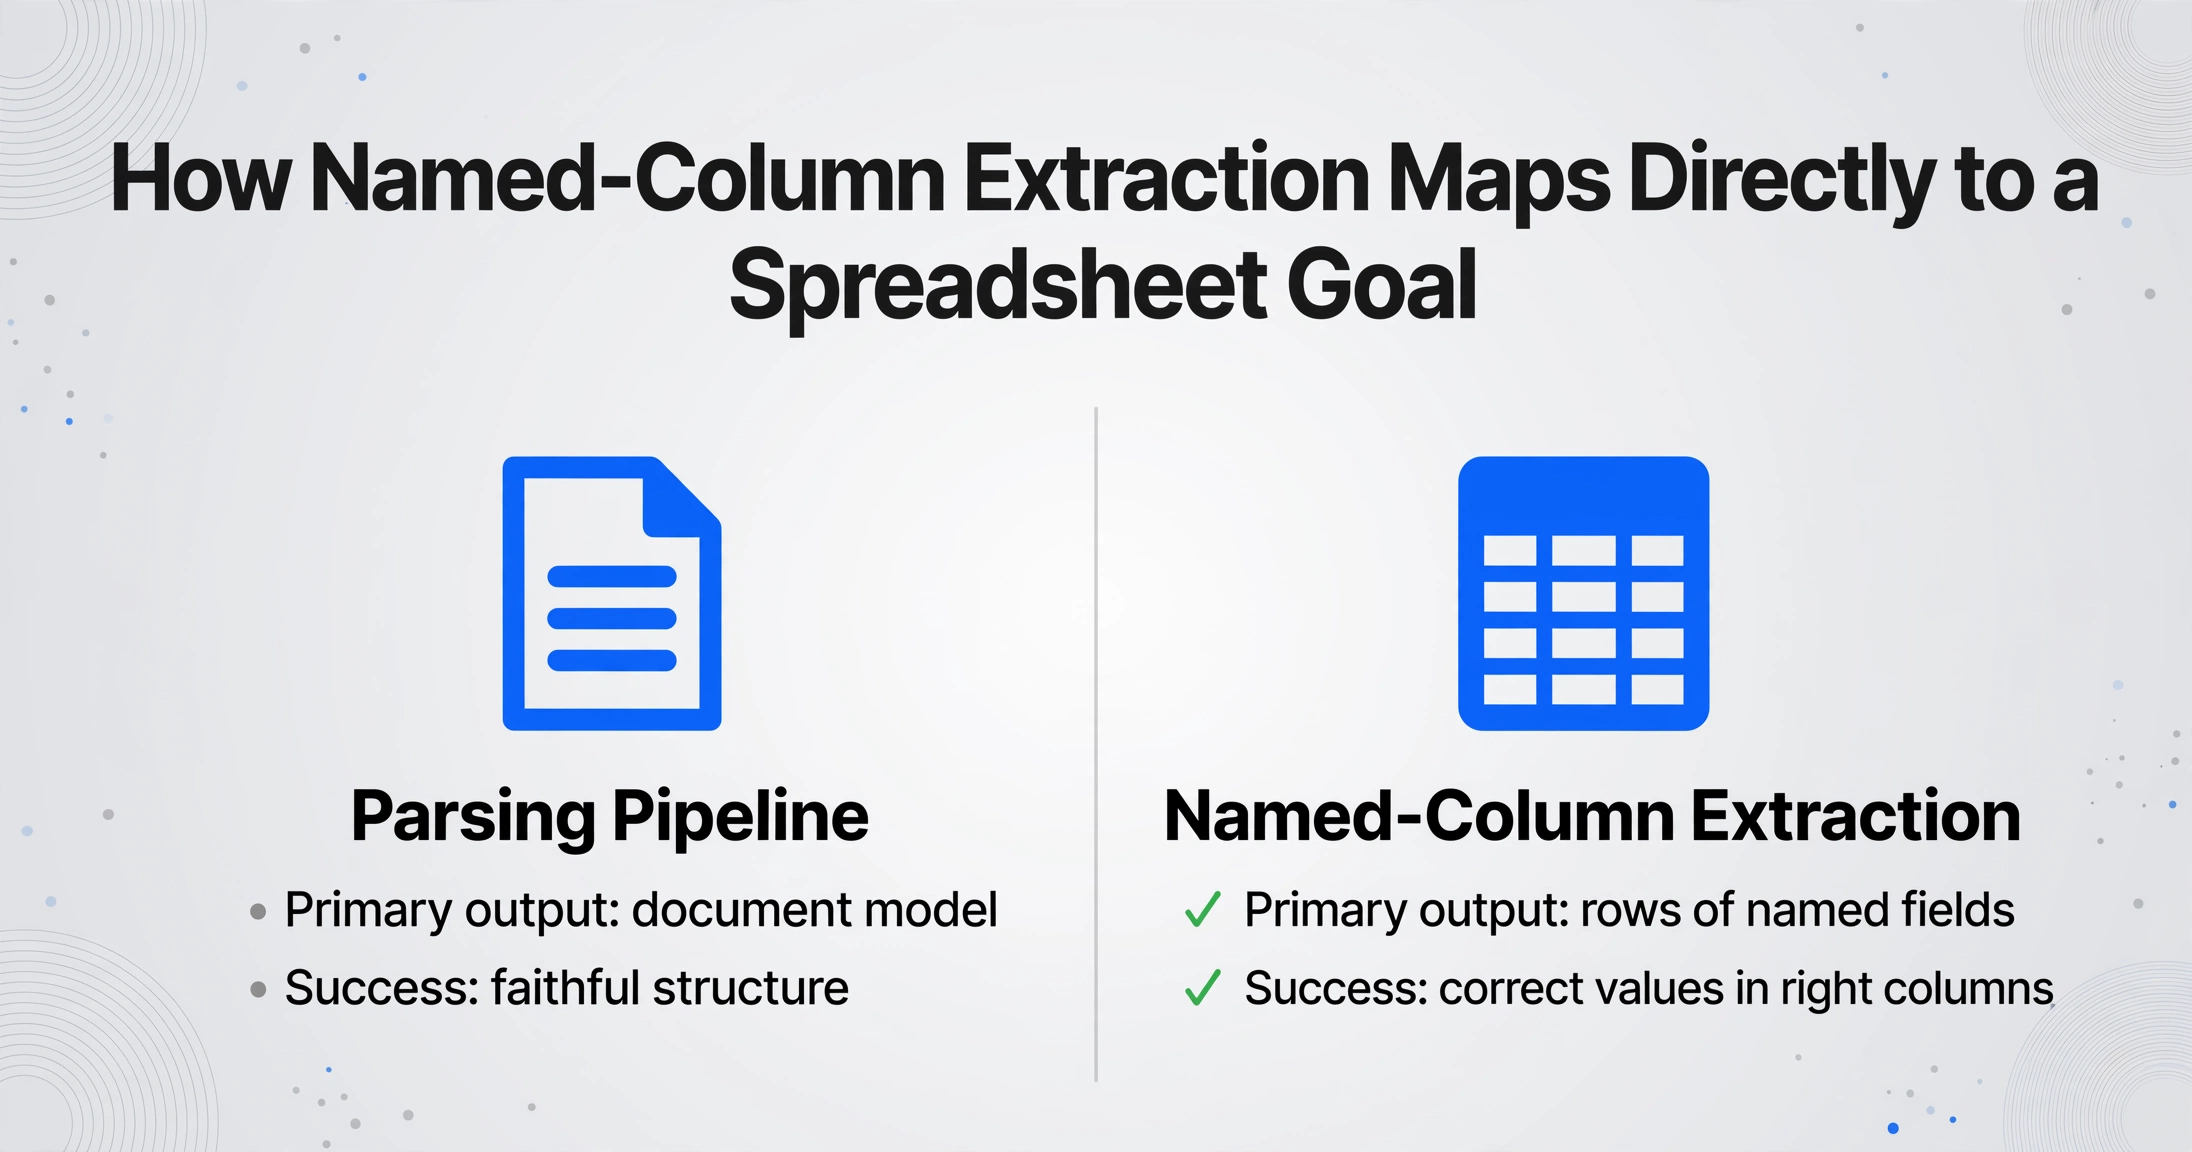
そのコスト構造に対して、列抽出は意図的に最小限に設計されています。ワークフローは次のとおりです。ドキュメントをアップロードし、列名を一度入力し、バッチを実行します。ツールはすべてのファイルを読み取り、列を埋め、結果を単一のスプレッドシートにマージします。解析プロジェクトも、オーケストレーションも、2番目の抽出フェーズもありません。単一ページの処理には約5〜10秒かかりますが、手動入力は約3分かかるため、製品全体で公開しているのと同じ効率数値に基づく約18倍の差があります。
出力を信頼する必要があるチームにとって、2つの製品設定が重要です。モデルティアを使用すると、アカウントは、密な手書き、複雑なレイアウト、または小さなミスが高くつくドキュメントに対して、より強力なビジョンモデルを選択できます。一方、標準ティアは、ほとんどの印刷された表形式ドキュメントをすでにカバーしています。また、バウンディングボックスハイライト付きのレビューモードは、抽出された各値を元のページ上の正確な場所にマッピングします。セルにホバーするとソース領域が点灯し、領域をクリックするとセルが見つかります。これを解析されたマークダウンダンプと比較するチームは、通常、フィールドごとのソーストレースが、まさにスプレッドシート監査に必要な検証レイヤーであることに気付きます。
| 解析パイプライン | 名前付き列抽出 | |
|---|---|---|
| 主な出力 | ドキュメントモデル: レイアウト、読み順、テーブルをマークダウンまたはJSONで出力 | 指定したフィールドの行 |
| 成功を左右する要素 | 忠実な構造、検索用のクリーンなチャンク | 正しい列に正しい値が入っていること |
| セットアップ | エンジン選定、ページごとの設定、オーケストレーション、チャンク分割、インデックス作成 | 必要な列名を一度入力するだけ |
| 自然な後続処理 | RAG、エージェント、コーパス全体のセマンティック検索 | Excel、Google Sheets、ERPインポート、レポート作成 |
| メンテナンス対象 | グルーコード、リトライ、解析結果へのスキーママッピング | 再確認が必要な行のレビュー |
検証の流れは、列抽出ワークフローが最初のバッチでその価値を証明できるポイントです。請求書を処理し、レビューモードを開いて、フラグが付いたフィールドをソースページと照合するだけで、すべての値を二重に確認する必要はありません。ベンダーがレイアウトを変更するたびに動作しなくなるテンプレートツールから移行してきたチームにとって、この最初のバッチでの体験が決定的な理由になることが多く、Docparserからの移行やParseurからの移行に関する検討で詳しく説明しています。この分野で個別の製品を比較している場合は、Parseur比較でツールごとに詳しく解説しています。
解析パイプラインが本当に必要な場合
列抽出は万能な代替手段ではなく、そう言うのは不誠実です。解析パイプラインは、4つの具体的なニーズに対して適切なアーキテクチャです。
コーパスに対するRAGと会話型AI。 成果物が「10,000件のポリシードキュメントにわたって質問に答える」または「ナレッジベースから引用を引き出すエージェント」である場合、チャンク、埋め込み、検索インデックスが必要です。列抽出はフィールドを返しますが、検索可能なコンテンツは返しません。解析パイプラインのドキュメントモデルは、まさにこのユースケースが消費するものであり、ここが本当にこのアプローチが輝く場所です。
レイアウトを保持するドキュメントモデル。 一部のダウンストリームシステムは、ドキュメントをドキュメントとして維持する必要があります。契約条項を読み順に再構築する必要がある法務レビュープラットフォーム、2段組の論文を正しくリフローする必要がある研究ワークフロー、ソースの視覚的構造を維持するアーカイブシステムなどです。フィールドテーブルは、設計上その構造を破棄します。出力がドキュメントとして消費される場合、パイプラインが必要です。
全文検索。 成功指標が、ドキュメントが埋める列ではなく、ドキュメントが言うすべてのことに対する自然言語検索である場合、インデックスは完全な解析済みコンテンツを必要とします。主要フィールドのスプレッドシートは、クエリ可能なテキスト本文の代わりにはなりません。
製品としてのドキュメント構造。 自社製品としてドキュメントツールを構築しているチームで、他の開発者がAPIを介して解析済みマークダウンやレイアウトツリーを消費する場合、解析レイヤーをインフラストラクチャとして必要とします。これは開発者向けの成果物であり、運用向けの成果物ではありません。
決定ルールは宛先です。スプレッドシートの行は列抽出を指し、クエリ可能またはレイアウトを保持するドキュメントコーパスは解析パイプラインを指します。両方必要とするチームは両方を実行しますが、スプレッドシート側はパイプライン側を先に構築する必要はありません。
まだツールを名前で比較している読者のために、毎年のOCRおよびドキュメントAPI総まとめでは、解析パイプライン系を含む主要エンジンを並べてリストしています。それらのエンジンが約束しないのは、列抽出が最初に提供するもの、つまりパイプライン構築なし、チャンク分割スキーマなし、名前を付けた列だけ、ということです。
FAQ
ドキュメント解析とデータ抽出の違いは何ですか?
ドキュメント解析はドキュメント自体を再構築します。レイアウト、読み順、テーブルをマークダウンやJSONにシリアライズし、下流システムに渡します。データ抽出は、請求書の日付や合計金額など、定義した特定のフィールドを取得し、行として返します。前者はドキュメントモデルを生成し、後者は求めた答えを生成します。
PDFからスプレッドシートにデータを抽出するのに解析パイプラインは必要ですか?
いいえ。成果物がスプレッドシート内の名前付きフィールドの行であれば、列抽出がドキュメントを読み取り、列に直接データを入力します。解析パイプラインは、ページごとの解析コスト、オーケストレーションステップ、解析済みマークダウンを必要なフィールドにマッピングする別の抽出レイヤーを追加します。
解析パイプラインが有効なのはどのような場合ですか?
出力がドキュメントそのものである必要がある場合です。コーパス全体を検索するRAGやエージェントシステム、レイアウトを保持するワークフロー、全文検索、ドキュメントツールを製品として構築する場合などです。これらの場合、パイプラインのドキュメントモデルが真に適切な基盤となります。
テーブルに関して、解析は列抽出よりも正確ですか?
両者は異なる基準で評価されます。解析は、テーブル構造がマークダウンやJSONでどれだけ忠実に保持されるかで評価されます。列抽出は、名前付き列の値が正しいかどうかで評価されます。スプレッドシートにとって重要なのは後者の指標であり、そのためバウンディングボックスハイライトなどの検証ツールは、シリアライズされた構造を信頼するのではなく、各値をソースページと比較します。
どのツールが解析パイプラインで、どのツールが列抽出ツールですか?
AWS Textract、Azure Document Intelligence、Google Document AI、Unstructured、Docling、LlamaParseは解析パイプラインエンジンで、下流システム向けのドキュメントモデルを生成します。ImageToTable.aiは列抽出ツールで、アップロードして列に名前を付け、スプレッドシートの行を取得します。この2つのカテゴリは異なる出力を目的としており、まさにこの記事が扱う判断ポイントです。
次にドキュメントAIベンダーが解析パイプラインを提示したら、スプレッドシートがそのどの部分を消費するのか尋ねてください。正直な答えが「値だけ」なら、すでに短いルートは分かっています。列に名前を付け、バッチを実行し、再確認が必要な行をチェックしてください。独自のドキュメントを列抽出で実行し、解析パイプラインが生成する出力と比較してください。