Avez-vous besoin d'un pipeline d'analyse
pour des données de feuille de calcul ?
L'équipe moyenne du service fournisseurs paie encore environ 9,40 $ pour traiter une facture, et seulement 32,6 % des factures sont traitées de bout en bout sans intervention humaine (Ardent Partners, State of ePayables 2024). Lorsqu'une équipe qui a simplement besoin de données fournisseurs dans des colonnes se voit citer cet écart, la réponse standard est « vous avez besoin d'un pipeline d'analyse de documents ».
Un pipeline d'analyse est une véritable architecture et il résout de vrais problèmes, mais il a été conçu pour une destination différente. Son résultat est un modèle de document : la mise en page, l'ordre de lecture, les tableaux, tout est préservé afin que le contenu puisse être découpé en segments et alimenter un système de récupération. Si votre livrable est des lignes dans une feuille de calcul, vous achetez peut-être l'architecture dont le projet RAG de quelqu'un d'autre a besoin, et non celle dont votre feuille de calcul a besoin. Cet article explique ce que chaque approche produit réellement, ce que le pipeline vous coûte lorsque les lignes sont l'objectif, et quand un pipeline d'analyse est vraiment le bon choix.
Points clés à retenir
- Seulement 32,6 % des factures sont traitées sans intervention humaine, et le pipeline présenté comme la solution renvoie un modèle de document plutôt que les lignes qu'une feuille de calcul consomme.
- Le pipeline ne supprime pas l'étape d'extraction, il la déplace plus bas dans la chaîne vers une couche que vous devez encore écrire, et un contrat de 40 pages coûte toujours quarante pages même si vous n'avez besoin que d'une seule date de renouvellement.
- La question décisive est la destination : des lignes dans une feuille de calcul indiquent l'extraction de colonnes nommées, et un corpus de documents interrogeable ou préservant la mise en page est là où le pipeline d'analyse justifie son coût.
Pourquoi un objectif de feuille de calcul se voit systématiquement vendu un pipeline d'analyse
Le terme « analyse de documents » a une signification précise dans la littérature de recherche. Une enquête de 2024 sur le domaine le définit comme la conversion de documents non structurés ou semi-structurés en représentations structurées et lisibles par machine, destinées à des applications en aval comme la construction de bases de connaissances et la génération augmentée par récupération, ou RAG (Document Parsing Unveiled, arXiv:2410.21169). Un pipeline d'analyse reconstruit le document : OCR sur les pages numérisées, analyse de la mise en page pour repérer les blocs de texte et les tableaux, reconstruction de l'ordre de lecture pour que les pages à deux colonnes s'enchaînent correctement, reconnaissance de la structure des cellules de tableau, et sérialisation de l'ensemble en Markdown ou JSON. Cette représentation est ensuite découpée en segments, intégrée et indexée pour qu'une IA puisse répondre à des questions sur le document ultérieurement.
Cette séquence résout un problème spécifique : rendre un corpus entier de documents interrogeable et exploitable pour des réponses. C'est une architecture de base de connaissances. Les équipes qui évaluent des outils d'automatisation documentaire se la voient systématiquement présenter, car c'est là qu'une grande part des investissements actuels en IA documentaire a été dirigée, et c'est effectivement impressionnant. La question est de savoir si le problème de l'équipe est « répondre à des questions sur un corpus de documents » ou « obtenir le numéro de facture, la date d'échéance et le total dans trois colonnes ». Ce sont des problèmes différents, et le second ne bénéficie pas automatiquement de la machinerie du premier.
Un pipeline d'analyse produit une représentation structurée du document. L'extraction de colonnes produit une représentation structurée des champs demandés. Ce sont des sorties différentes, et la seconde est plus proche de ce qu'une feuille de calcul consomme réellement.
Ce que fait réellement un pipeline d'analyse, étape par étape
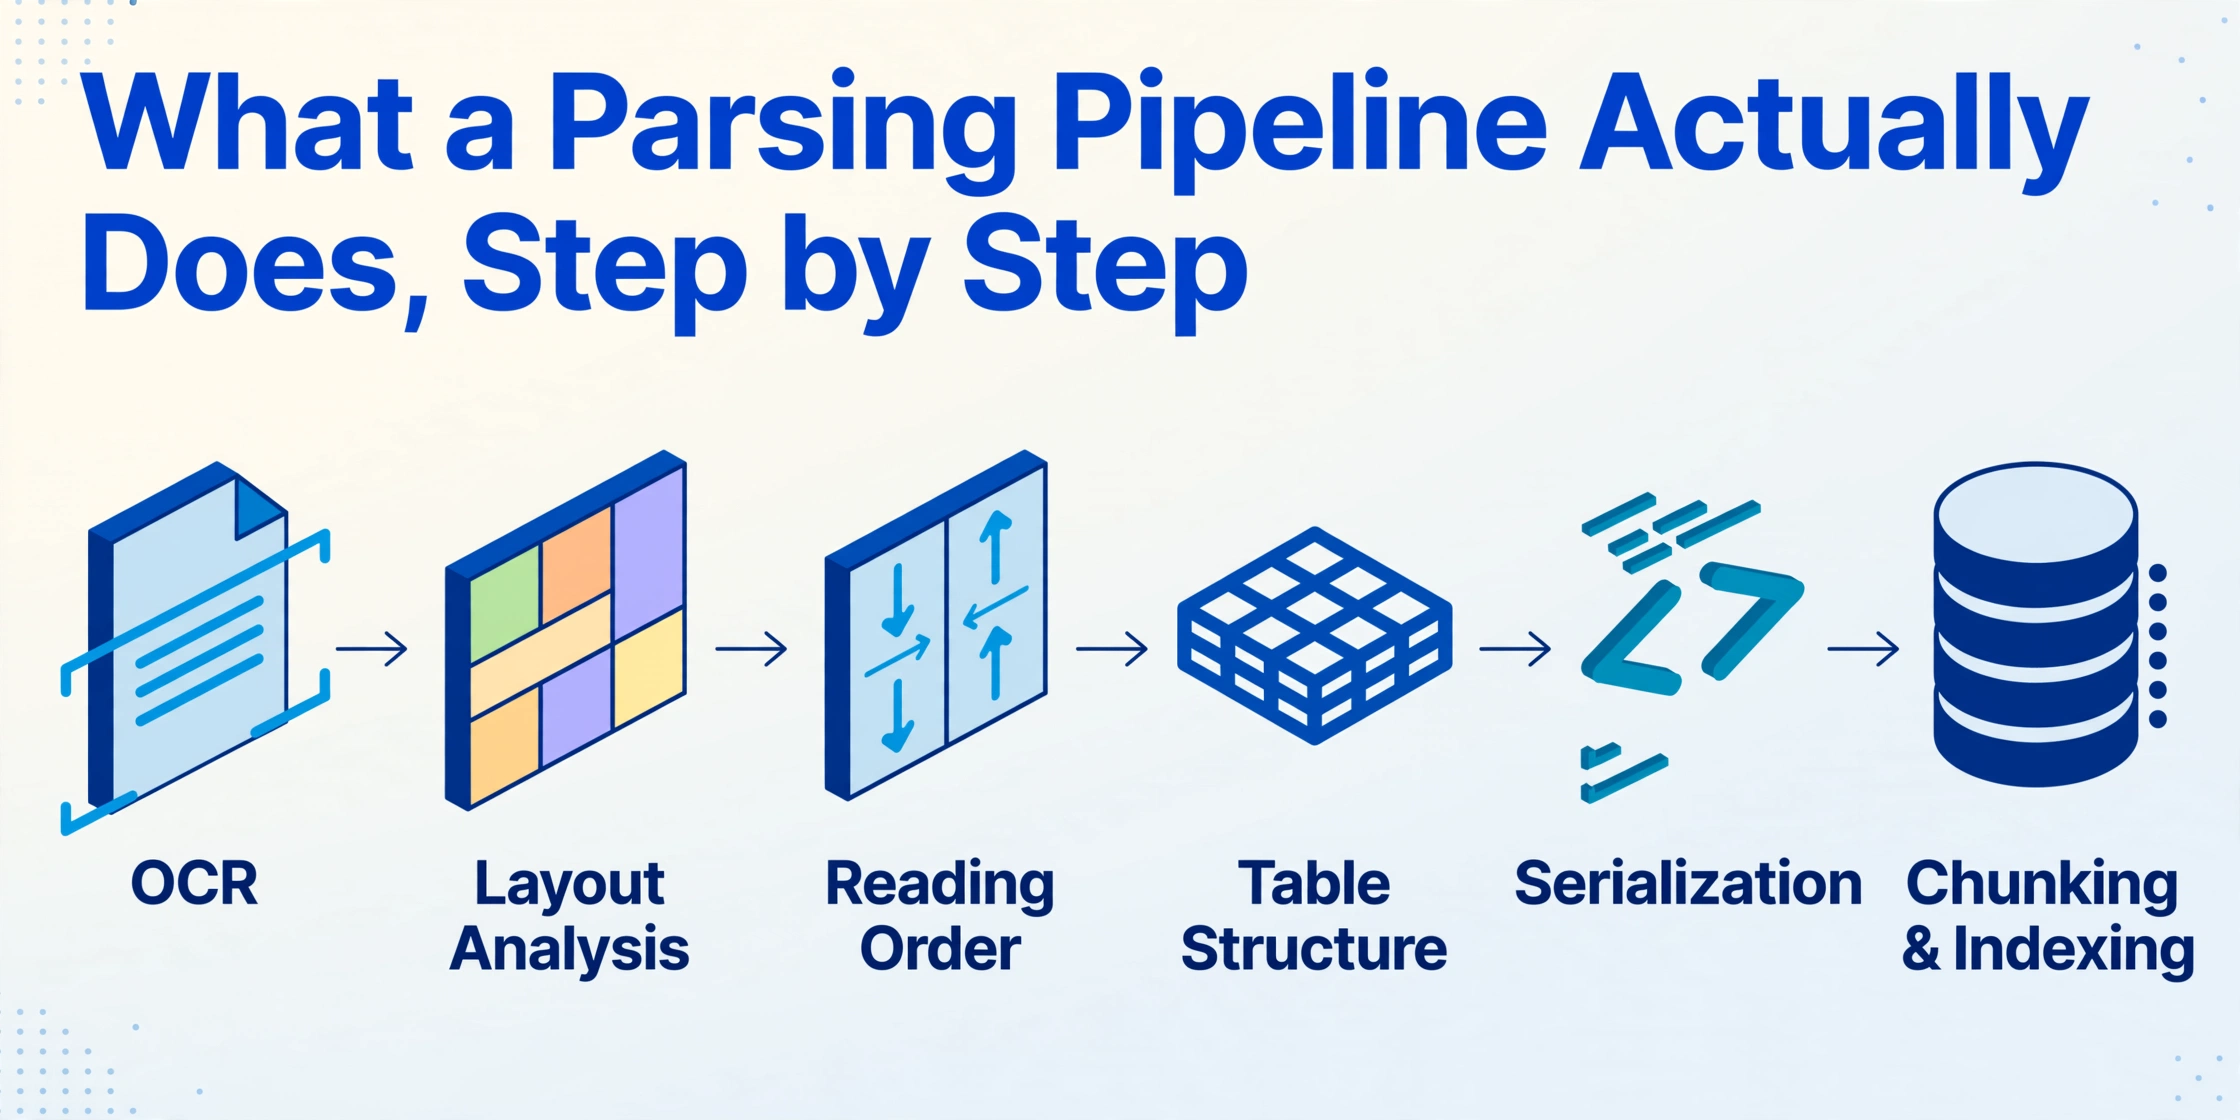
Lorsqu'on vous propose un pipeline d'analyse pour vos données documentaires, voici le travail concret qu'il contient, dans l'ordre où il s'exécute.
Acquisition du texte
Les documents scannés et photographiés passent par l'OCR pour produire une couche de texte. Les PDF natifs numériques peuvent contenir une couche de texte intégrée qui peut être lue directement, ce qui est plus rapide mais moins fiable pour les mises en page complexes.
Analyse de la mise en page
La page est segmentée en blocs de texte, tableaux, figures, en-têtes et pieds de page. C'est ici que l'analyseur apprend quel texte appartient à un tableau et lequel à un paragraphe.
Reconstruction de l'ordre de lecture
Les pages multi-colonnes sont réassemblées dans l'ordre qu'un lecteur humain suivrait. Sans cette étape, une facture sur deux colonnes est lue de la gauche vers le bas, puis de la droite, ce qui brouille le contenu pour tout traitement en aval.
Reconnaissance de la structure des tableaux
Les lignes, colonnes, cellules fusionnées et plages sont identifiées afin qu'un tableau reste un tableau au lieu d'être aplati en une chaîne de cellules.
Sérialisation
Le résultat est écrit en Markdown, JSON ou HTML, généralement avec des cadres englobants et des numéros de page associés, afin que chaque élément puisse être retracé jusqu'à ses coordonnées d'origine.
Découpage en segments et indexation
Pour les piles RAG, la sortie analysée est divisée en segments adaptés à l'embedding, convertie en vecteurs, puis chargée dans un index qu'un système de récupération peut interroger.
Les moteurs courants de cette catégorie incluent AWS Textract, Azure Document Intelligence, Google Document AI, Unstructured, Docling et LlamaParse, qui est construit autour de la pile LlamaIndex. Extend est un nouvel entrant dans le même créneau d'API d'analyse et d'extraction. Ils diffèrent par leur niveau de modèle, leur tarification à la page et la fidélité de la sortie, mais ils partagent la même architecture : analyser le document en un modèle, puis confier ce modèle à ce qui le consomme. Un développeur comparant ces moteurs sur Reddit a résumé la réalité pratique de tous : « Tous solides, tous payants à la page et oui, tous exigent d'orchestrer soi-même le pipeline » (r/LLMDevs).
Ce que fait l'extraction de colonnes à la place
La philosophie alternative arrête le flux de travail à la réponse. Avec l'Extraction de colonnes personnalisées, vous saisissez les noms de colonnes souhaités : « Numéro de facture », « Date d'échéance », « Montant total ». L'IA lit le document et localise chaque valeur en comprenant ce que signifie le nom de colonne, où qu'il se trouve sur la page, sans coordonnées ni modèle de mise en page. Les noms de colonnes que vous saisissez deviennent les en-têtes du tableau de sortie : l'unité de travail est donc un champ, et non une page.
Rien dans ce flux ne nécessite de modèle de document. Il n'y a pas d'étape d'analyse de mise en page, pas de reconstruction de l'ordre de lecture, pas de sérialisation en Markdown, pas de découpage en segments. L'IA reçoit une question par téléchargement : « trouvez les valeurs de ces colonnes et renvoyez-les ». Ce que vous obtenez en retour, ce sont des lignes, et ces lignes constituent le livrable. Le traitement est batch-first : téléchargez un dossier de factures fournisseurs, et chaque facture atterrit dans sa propre ligne d'une feuille de calcul fusionnée, au lieu d'un résultat d'analyse par fichier (une explication plus complète de comment l'extraction de documents par IA lit une page détaille le mécanisme).
Comme ce sont les champs qui sont demandés, l'approche ne se soucie pas de la mise en page du fournisseur, ce qui est traité séparément dans notre article sur l'extraction de documents sans modèle. Un fournisseur qui modifie son modèle de facture n'invalide rien, car les définitions de colonnes n'ont jamais été liées à une position sur la page.
Ce que coûte le pipeline à une équipe qui n'a besoin que de lignes
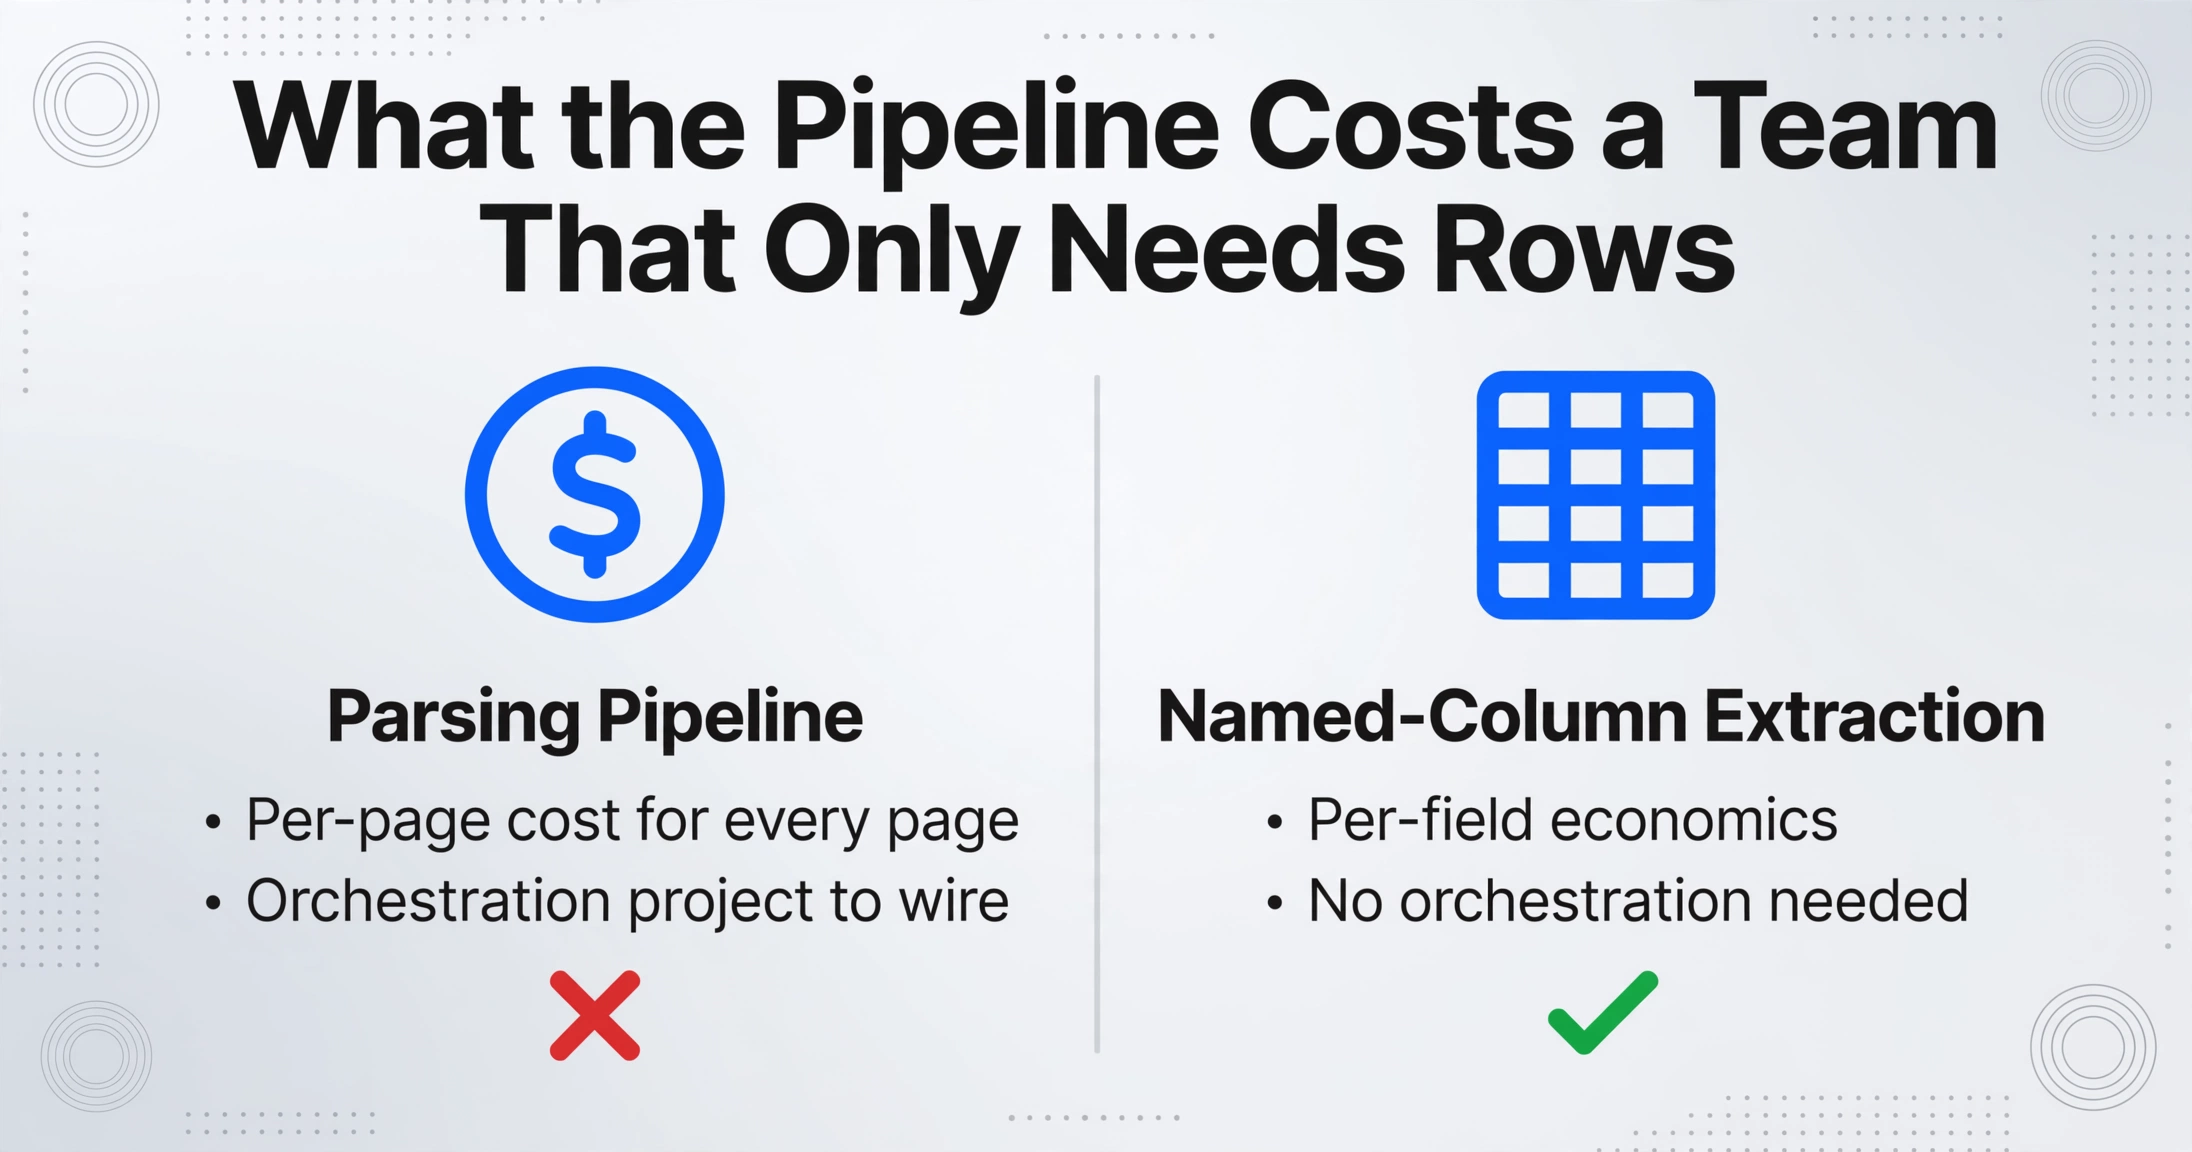
Un pipeline d'analyse n'est pas inadapté à un objectif de feuille de calcul, c'est simplement plus de machine que nécessaire, et cet excès se manifeste à trois endroits.
Vous payez pour des pages alors que votre unité de valeur est un champ. Les API d'analyse facturent par page ou par crédit pour l'OCR et le traitement de la mise en page. Chaque page est analysée intégralement, y compris les passages génériques que vous ne consulterez plus jamais, car c'est ce que signifie la reconstruction de document. Une facture d'une page coûte une page. Un contrat de 40 pages coûte quarante pages, même lorsque le livrable est une date de renouvellement et un nom de partie. Les lignes d'une feuille de calcul représentent généralement quelques champs par document, et c'est sur cette économie par champ que l'extraction de colonnes facture, et non sur le coût par page de la reconstruction intégrale.
Vous héritez d'un projet d'orchestration. Le commentaire Reddit ci-dessus le disait clairement : chaque analyseur de cette catégorie exige que vous câbliez le pipeline vous-même. Un utilisateur de Textract sur r/aws a décrit la même expérience sur un autre ton : c'est « assez cher pour un grand nombre de documents », et « si la mise en page du document est inhabituelle, cela peut donner des résultats erronés » (r/aws). Quelqu'un doit relier l'étape d'OCR à l'étape de mise en page, gérer les nouvelles tentatives, maintenir la cohérence du découpage en segments et déployer le résultat. Pour une équipe d'une ou deux personnes chargées des opérations dont le vrai travail est la gestion des données fournisseurs dans une feuille de calcul, cette orchestration est précisément la tâche qu'elles cherchaient à automatiser.
Le pipeline s'arrête là où commence votre extraction. Voici la partie qui apparaît rarement sur la page de comparaison des fournisseurs : un pipeline d'analyse vous remet du Markdown, pas des champs. Pour obtenir la « date d'échéance » d'un document analysé, vous devez encore écrire votre propre couche d'extraction, soit par correspondance de motifs sur le Markdown, soit par une invite de schéma adressée à un LLM, puis valider sa sortie. Certaines plateformes d'analyse incluent un point de terminaison d'extraction, mais il s'agit d'une option payante, et le coût d'ingénierie pour convertir la sortie analysée en lignes adaptées à votre feuille de calcul reste à votre charge. C'est un second projet d'extraction greffé sur le premier.
Il existe une version humaine de cette même double manipulation, avec des taux d'erreur mesurés. Une revue systématique et méta-analyse de 2023 sur les méthodes de traitement des données dans la recherche clinique a révélé un taux d'erreur groupé de 6,57 % lorsqu'une personne lit une valeur dans un document source et la saisit manuellement dans un enregistrement structuré, contre 0,29 % pour la saisie directe et 0,74 % pour la numérisation automatisée (Garza et al., 2023). Lorsque le Markdown analysé est ressaisi à la main dans une feuille de calcul, l'étape est la même et l'erreur se situe au même endroit : l'interface humaine entre deux représentations.
Le pipeline ne supprime pas l'étape d'extraction. Il la déplace plus bas dans la chaîne : du document au Markdown, et de vous au petit script ou à l'invite de schéma que vous devez encore livrer.
Comment l'extraction de colonnes nommées correspond directement à un objectif de feuille de calcul
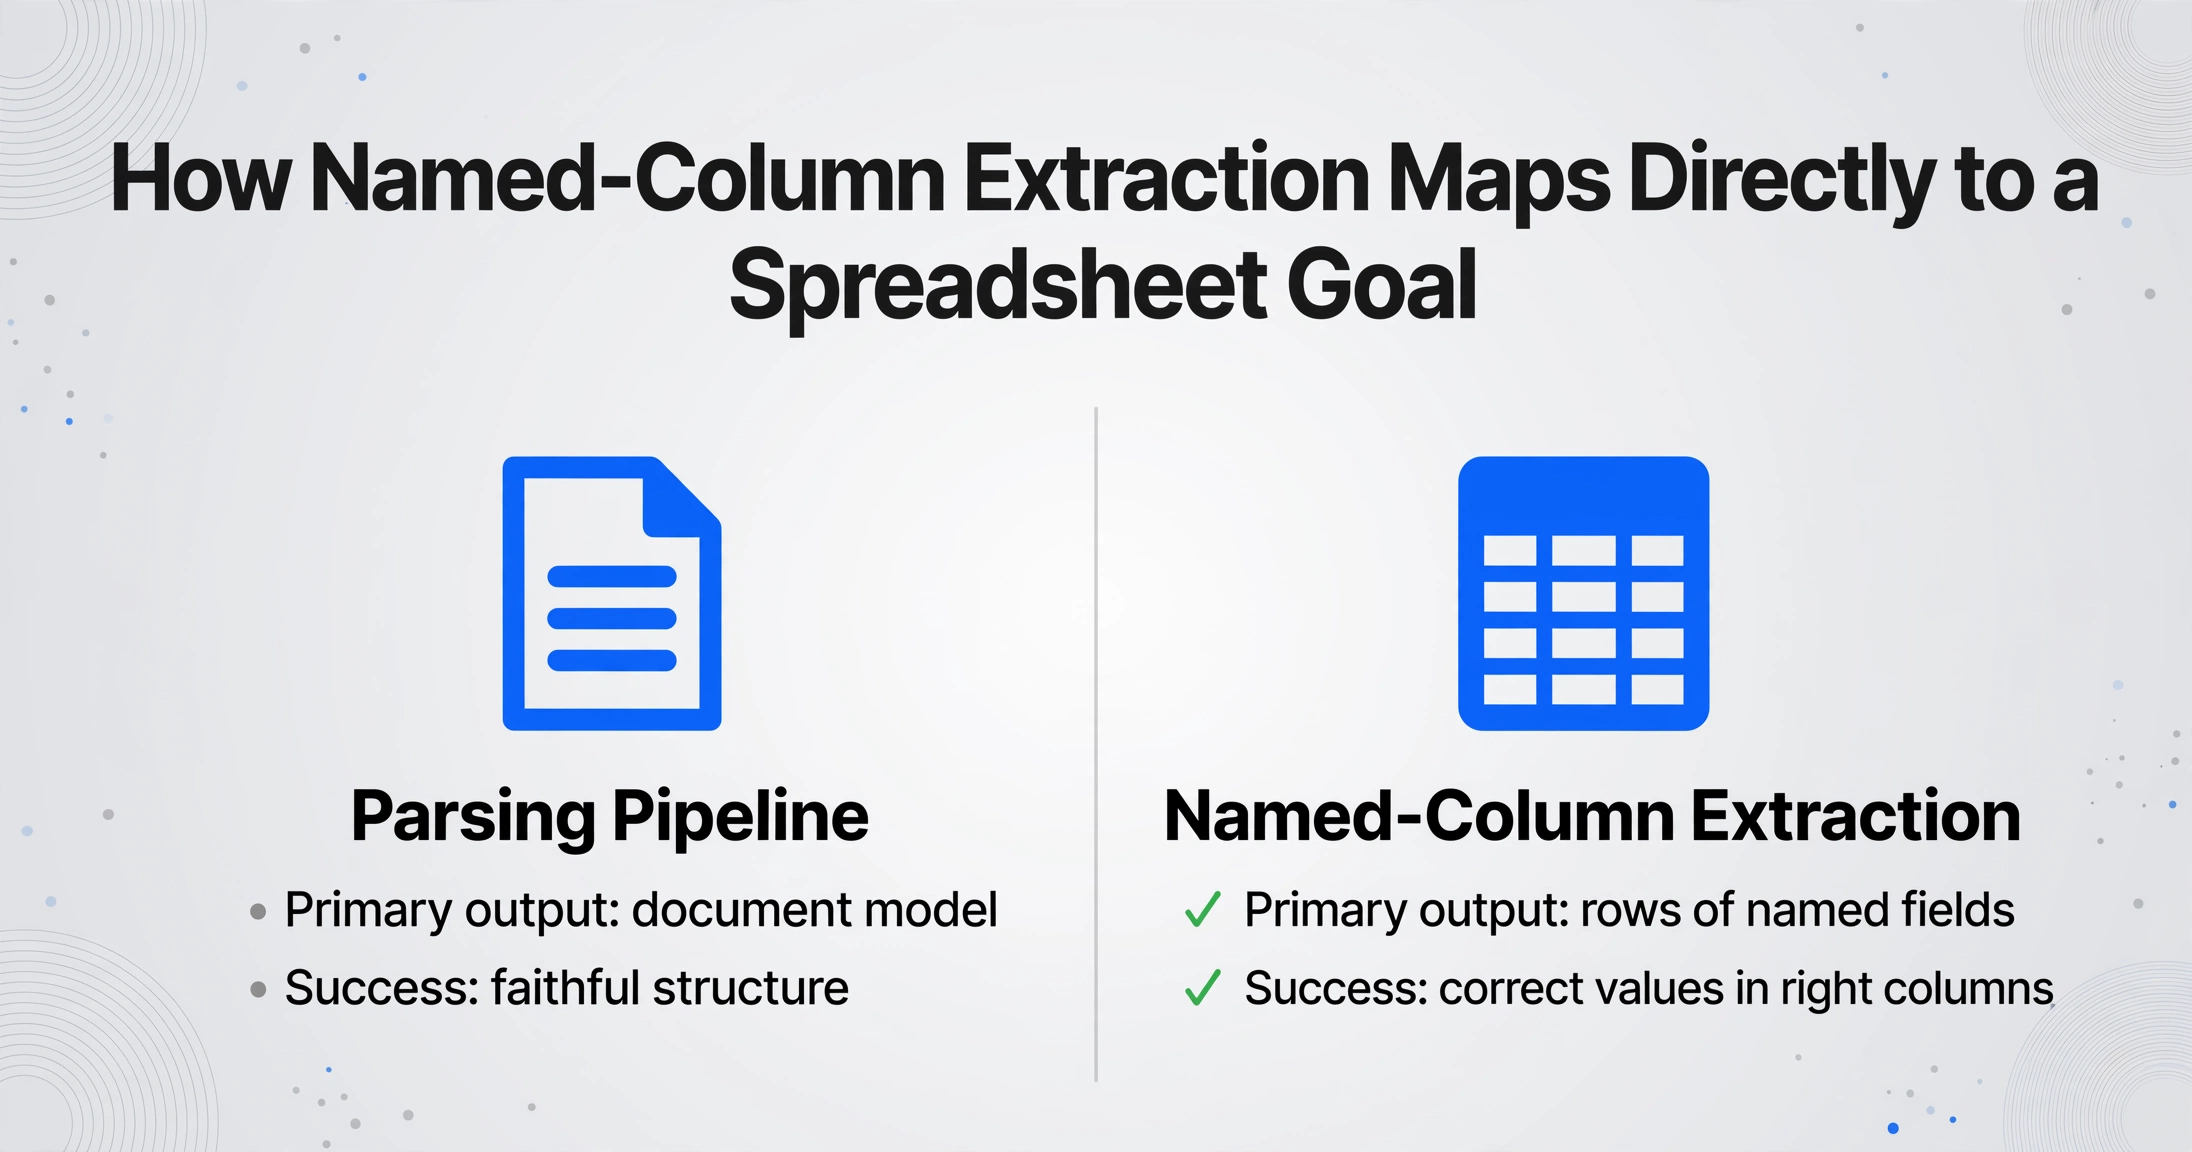
Face à cette structure de coûts, l'extraction de colonnes est délibérément minimale. Le flux de travail est le suivant : téléchargez les documents, saisissez une fois les noms de colonnes, lancez le lot. L'outil lit chaque fichier, remplit les colonnes et fusionne les résultats dans une seule feuille de calcul, sans projet d'analyse, sans orchestration, sans seconde phase d'extraction. Le traitement d'une seule page prend environ 5 à 10 secondes, contre près de trois minutes pour la saisie manuelle, soit une différence d'environ 18 fois, issue des mêmes chiffres d'efficacité que nous publions sur l'ensemble du produit.
Deux paramètres produit comptent pour les équipes qui doivent faire confiance à la sortie. Le niveau de modèle permet à un compte de choisir un modèle de vision plus puissant pour l'écriture manuscrite dense, les mises en page complexes ou les documents où de petites erreurs coûtent cher, tandis que le niveau standard couvre déjà la plupart des documents tabulaires imprimés. Et le mode de révision avec surlignage du cadre englobant fait correspondre chaque valeur extraite à son emplacement exact sur la page d'origine : survolez une cellule et la région source s'illumine, cliquez sur la région et la cellule est trouvée. Les équipes qui comparent cela à un vidage Markdown analysé constatent généralement que la trace de source par champ est exactement la couche de vérification dont un audit de feuille de calcul a besoin.
| Pipeline d'analyse | Extraction de colonnes nommées | |
|---|---|---|
| Sortie principale | Modèle de document : mise en page, ordre de lecture, tableaux en Markdown ou JSON | Lignes des champs nommés |
| Ce qui détermine la réussite | Structure fidèle, segments propres pour la récupération | Valeurs correctes dans les bonnes colonnes |
| Configuration | Choix du moteur, configuration par page, orchestration, découpage en segments, index | Saisir une fois les noms de colonnes souhaités |
| Usage aval naturel | RAG, agents, recherche sémantique sur un corpus | Excel, Google Sheets, imports ERP, reporting |
| Ce qui est à maintenir | Code de liaison, nouvelles tentatives, mappage de schéma sur la sortie analysée | Révision des lignes nécessitant un second examen |
La vérification est l'étape où un flux d'extraction de colonnes se confirme souvent dès le premier lot. Exécutez vos factures, ouvrez le mode de révision et vérifiez les champs signalés par rapport aux pages sources, au lieu de relire chaque valeur deux fois. Pour les équipes venant d'outils à modèles qui échouent dès qu'un fournisseur modifie sa mise en page, cette première expérience de lot constitue généralement l'argument décisif, comme abordé dans les discussions sur la migration depuis Docparser et la migration depuis Parseur. Si vous comparez encore des outils individuels dans ce domaine, notre comparaison Parseur passe chaque outil en revue.
Quand un pipeline d'analyse est réellement nécessaire
L'extraction de colonnes n'est pas un remplacement universel, et prétendre le contraire serait malhonnête. Un pipeline d'analyse est la bonne architecture pour quatre besoins concrets.
RAG et IA conversationnelle sur un corpus. Si le livrable est « répondre à des questions sur 10 000 documents de politique » ou « un agent qui extrait des citations d'une base de connaissances », il faut des segments, des embeddings et un index de récupération. L'extraction de colonnes renvoie des champs, pas du contenu interrogeable. Le modèle de document du pipeline d'analyse est exactement ce que ce cas d'usage consomme, et c'est là que cette approche excelle véritablement.
Modèles de document préservant la mise en page. Certains systèmes en aval doivent conserver le document en tant que document : une plateforme de revue juridique qui doit reconstituer une clause contractuelle dans l'ordre de lecture, un flux de recherche qui doit réorganiser correctement un article sur deux colonnes, un système d'archivage qui maintient la structure visuelle de la source. Un tableau de champs élimine cette structure par conception. Lorsque la sortie est consommée comme un document, le pipeline est préférable.
Recherche sur le contenu intégral. Si la mesure de succès est la recherche en langage naturel sur tout ce que les documents disent, et non sur les colonnes qu'ils remplissent, l'index doit contenir le contenu analysé complet. Une feuille de calcul de champs clés ne remplace pas un corpus de texte interrogeable.
La structure du document comme produit. Une équipe qui développe des outils documentaires comme produit propre, où d'autres développeurs consomment du Markdown analysé ou des arbres de mise en page via une API, a besoin de la couche d'analyse comme infrastructure. C'est un livrable pour développeurs, pas un livrable opérationnel.
La règle de décision est la destination : des lignes dans une feuille de calcul indiquent l'extraction de colonnes, un corpus documentaire interrogeable ou préservant la mise en page indique un pipeline d'analyse. Les équipes qui ont besoin des deux exécutent les deux, mais la partie feuille de calcul n'exige pas que la partie pipeline soit construite en premier.
Pour les lecteurs qui comparent encore les outils par nom, le tour d'horizon annuel des API OCR et documentaires liste les principaux moteurs côte à côte, y compris ceux basés sur des pipelines d'analyse. Ce qu'aucun de ces moteurs ne promet, c'est ce que l'extraction de colonnes offre d'emblée : pas de pipeline à construire, pas de schéma de découpage en segments, seulement les colonnes nommées.
FAQ
Quelle est la différence entre l'analyse de documents et l'extraction de données ?
L'analyse de documents reconstruit le document lui-même : mise en page, ordre de lecture, tableaux, sérialisés en Markdown ou JSON pour les systèmes en aval. L'extraction de données récupère les champs spécifiques que vous définissez, comme la date de facture ou le montant total, et les renvoie sous forme de lignes. La première produit un modèle de document, la seconde produit la réponse que vous avez demandée.
Ai-je besoin d'un pipeline d'analyse pour extraire des données de PDF vers une feuille de calcul ?
Non. Si votre livrable est des lignes de champs nommés dans une feuille de calcul, l'extraction de colonnes lit le document et remplit directement les colonnes. Un pipeline d'analyse ajoute des coûts d'analyse par page, une étape d'orchestration et une couche d'extraction distincte qui mappe le Markdown analysé vers les champs souhaités.
Quand un pipeline d'analyse est-il pertinent ?
Lorsque la sortie doit être le document : les systèmes RAG et agents qui interrogent un corpus entier, les flux de travail préservant la mise en page, la recherche en texte intégral ou la création d'outils documentaires en tant que produit. Dans ces cas, le modèle de document du pipeline est véritablement la bonne base.
L'analyse est-elle plus précise que l'extraction de colonnes pour les tableaux ?
Elles sont évaluées sur des critères différents. L'analyse est évaluée sur la fidélité de la structure du tableau dans le Markdown ou le JSON. L'extraction de colonnes est évaluée sur l'exactitude de la valeur dans une colonne nommée. Pour une feuille de calcul, c'est le deuxième critère qui compte, et c'est pourquoi les outils de vérification comme la mise en évidence par cadre englobant comparent chaque valeur à la page source au lieu de se fier à la structure sérialisée.
Quels outils sont des pipelines d'analyse et lesquels sont des outils d'extraction de colonnes ?
AWS Textract, Azure Document Intelligence, Google Document AI, Unstructured, Docling et LlamaParse sont des moteurs de pipeline d'analyse : ils produisent un modèle de document pour les systèmes en aval. ImageToTable.ai est un outil d'extraction de colonnes : importez, nommez vos colonnes, obtenez des lignes de feuille de calcul. Les deux catégories visent des sorties différentes, ce qui est précisément la décision dont traite cet article.
La prochaine fois qu'un fournisseur d'IA documentaire vous présente un pipeline d'analyse, demandez quelle partie votre feuille de calcul consommera. Si la réponse honnête est « juste les valeurs », vous connaissez déjà le chemin le plus court : nommez les colonnes, lancez le lot et vérifiez les lignes qui nécessitent un second examen. Testez vos propres documents avec l'extraction de colonnes et comparez le résultat avec ce qu'un pipeline d'analyse vous donnerait.