Brauchen Sie eine Parsing-Pipeline
für Tabellenkalkulationsdaten?
Die durchschnittliche Kreditorenbuchhaltung zahlt immer noch etwa 9,40 $ für die Verarbeitung einer einzigen Rechnung, und nur 32,6 % der Rechnungen werden ohne menschliches Eingreifen durchgängig verarbeitet (Ardent Partners, State of ePayables 2024). Wenn einem Team, das lediglich Lieferantendaten in Spalten benötigt, diese Lücke vor Augen geführt wird, lautet die Standardantwort: „Sie brauchen eine Dokument-Parsing-Pipeline."
Eine Parsing-Pipeline ist eine echte Architektur und löst echte Probleme, aber sie wurde für ein anderes Ziel entwickelt. Ihre Ausgabe ist ein Dokumentmodell: Layout, Lesereihenfolge und Tabellen bleiben erhalten, damit der Inhalt gechunkt und einem Retrieval-System zugeführt werden kann. Wenn das Ergebnis Zeilen in einer Tabellenkalkulation sein soll, kauft man womöglich die Architektur, die ein anderes RAG-Projekt braucht, nicht die, die die Tabellenkalkulation braucht. Dieser Artikel erläutert, was jeder Ansatz tatsächlich liefert, was die Pipeline kostet, wenn Zeilen das Ziel sind, und wann eine Parsing-Pipeline wirklich die richtige Wahl ist.
Die wichtigsten Erkenntnisse
- Nur 32,6 % der Rechnungen werden ohne menschliches Eingreifen verarbeitet, und die Pipeline, die als Lösung angepriesen wird, liefert ein Dokumentmodell statt der Zeilen, die eine Tabellenkalkulation benötigt.
- Die Pipeline entfernt den Extraktionsschritt nicht, sie verschiebt ihn nur auf eine Ebene, die trotzdem selbst geschrieben werden muss, und ein 40-seitiger Vertrag kostet weiterhin vierzig Seiten, selbst wenn nur ein einziges Verlängerungsdatum benötigt wird.
- Die entscheidende Frage ist das Ziel: Zeilen in einer Tabellenkalkulation sprechen für die Extraktion benannter Spalten, und ein durchsuchbares oder layout-erhaltendes Dokumentkorpus ist der Ort, an dem die Parsing-Pipeline ihren Preis wert ist.
Warum für ein Tabellenkalkulationsziel immer wieder eine Parsing-Pipeline verkauft wird
Der Begriff „Dokument-Parsing" hat in der Forschungsliteratur eine präzise Bedeutung. Eine Umfrage aus dem Jahr 2024 definiert ihn als die Umwandlung unstrukturierter oder halbstrukturierter Dokumente in strukturierte, maschinenlesbare Darstellungen für nachgelagerte Anwendungen wie den Aufbau von Wissensdatenbanken und die retrieval-gestützte Generierung, kurz RAG (Document Parsing Unveiled, arXiv:2410.21169). Eine Parsing-Pipeline rekonstruiert das Dokument: OCR auf gescannten Seiten, Layout-Analyse zur Erkennung von Textblöcken und Tabellen, Wiederherstellung der Lesereihenfolge, damit zweispaltige Seiten korrekt fließen, Erkennung der Tabellenzellenstruktur und Serialisierung in Markdown oder JSON. Diese Darstellung wird dann in Chunks aufgeteilt, eingebettet und indiziert, damit eine KI später Fragen zum Dokument beantworten kann.
Diese Abfolge löst ein spezifisches Problem: einen gesamten Dokumentbestand durchsuchbar und beantwortbar zu machen. Es ist eine Wissensdatenbank-Architektur. Teams, die Dokumentautomatisierungswerkzeuge evaluieren, bekommen sie routinemäßig gezeigt, weil dort ein großer Teil der aktuellen Investitionen in Dokument-KI geflossen ist – und sie ist tatsächlich beeindruckend. Die Frage ist, ob das Problem des Teams „Fragen über einen Dokumentbestand beantworten" lautet oder „Rechnungsnummer, Fälligkeitsdatum und Gesamtsumme in drei Spalten bringen". Das sind unterschiedliche Probleme, und das zweite profitiert nicht automatisch von der Maschinerie des ersten.
Eine Parsing-Pipeline erzeugt eine strukturierte Darstellung des Dokuments. Spaltenextraktion erzeugt eine strukturierte Darstellung der angefragten Felder. Das sind unterschiedliche Ergebnisse, und das zweite kommt dem, was eine Tabellenkalkulation tatsächlich konsumiert, näher.
Was eine Parsing-Pipeline tatsächlich tut, Schritt für Schritt
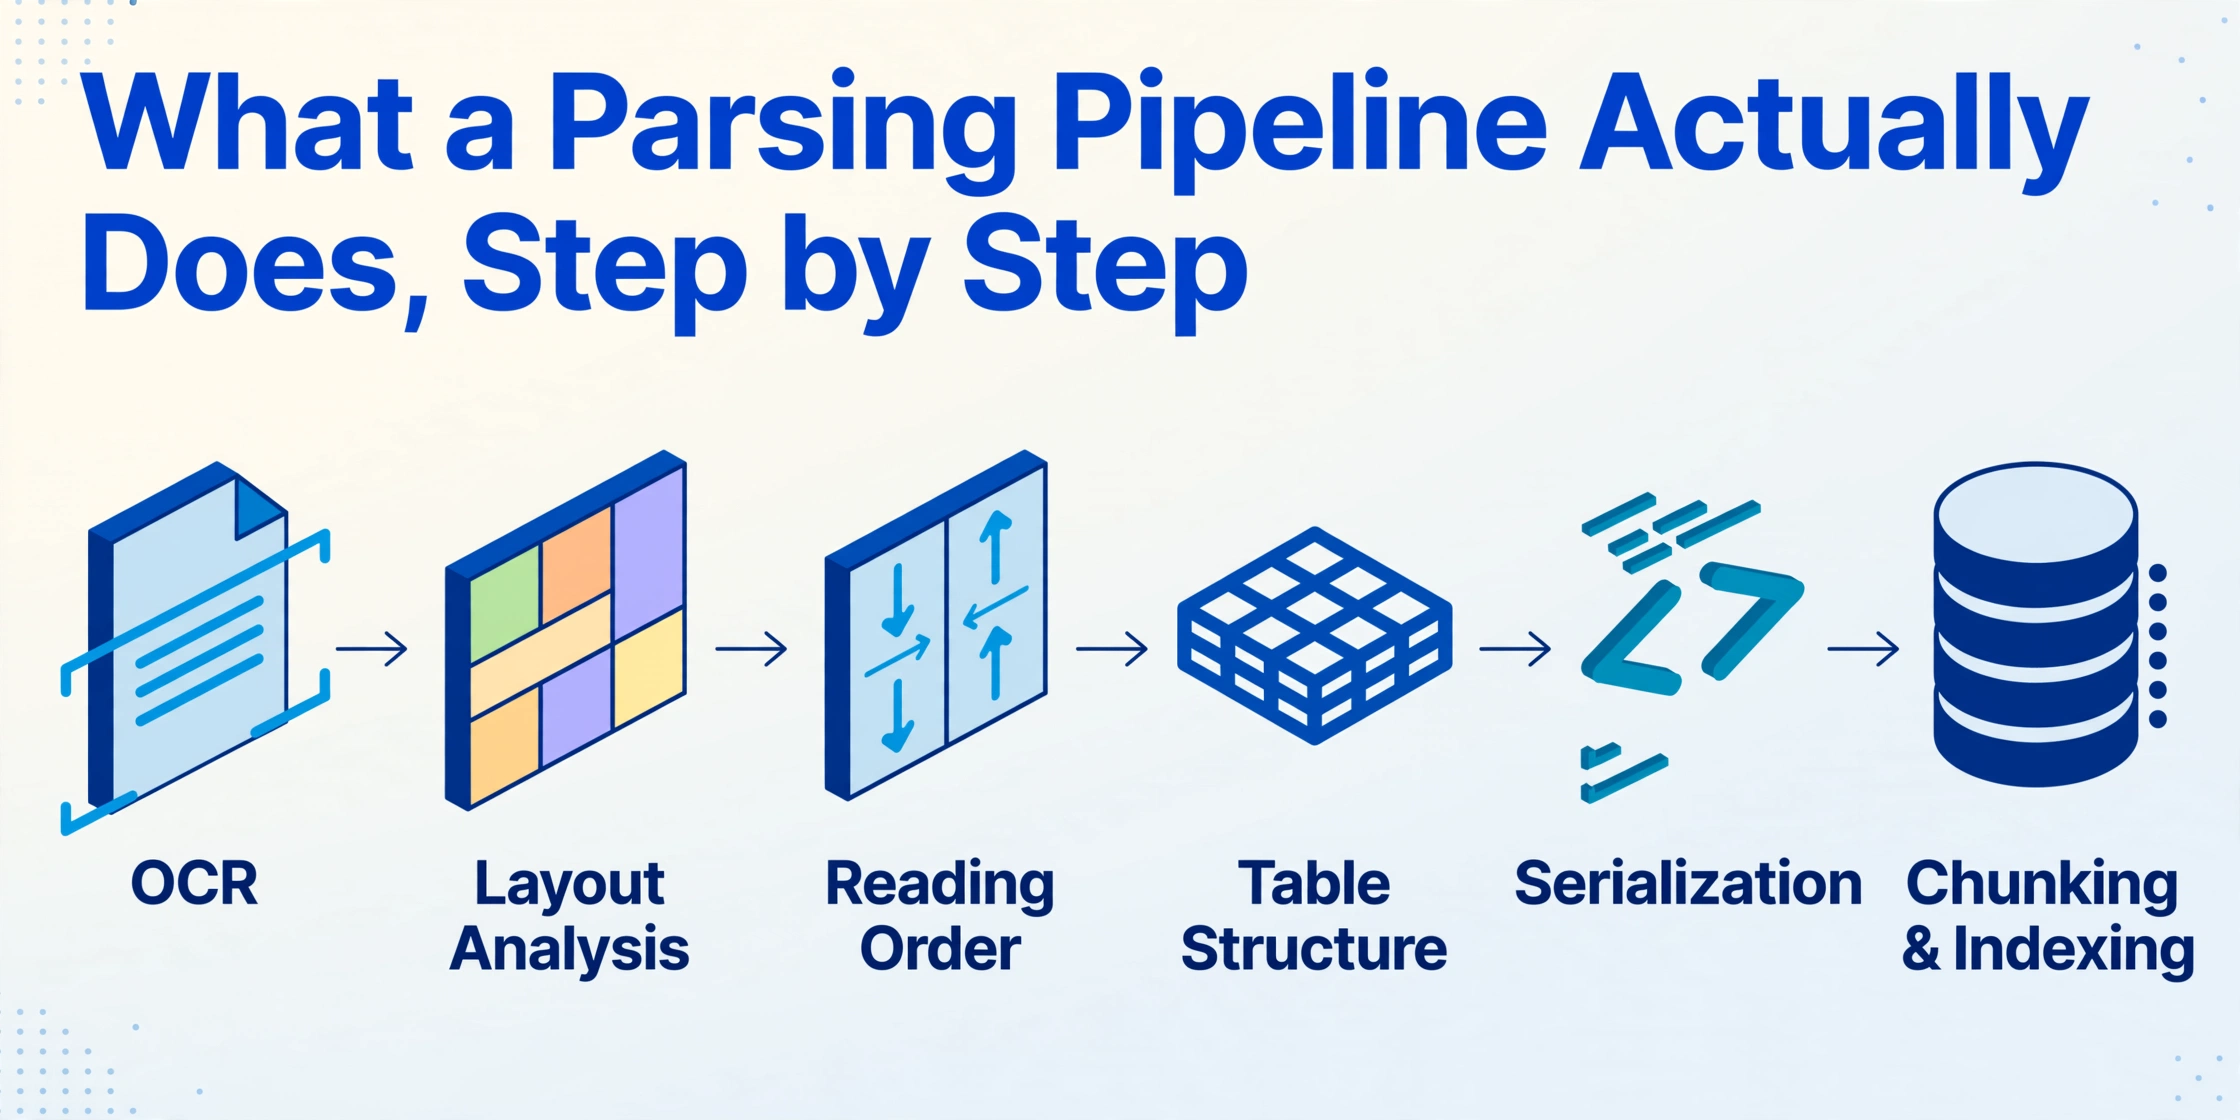
Wenn jemand für Ihre Dokumentdaten eine Parsing-Pipeline vorschlägt, ist das die konkrete Arbeit darin, in der Reihenfolge, in der sie abläuft.
Texterfassung
Gescannte und fotografierte Dokumente durchlaufen eine OCR, um eine Textebene zu erzeugen. Digital geborene PDFs können eine eingebettete Textebene enthalten, die direkt gelesen werden kann – das ist schneller, aber bei komplexen Layouts weniger zuverlässig.
Layoutanalyse
Die Seite wird in Textblöcke, Tabellen, Abbildungen, Kopf- und Fußzeilen segmentiert. Hier lernt der Parser, welcher Text zu einer Tabelle und welcher zu einem Absatz gehört.
Rekonstruktion der Lesereihenfolge
Mehrspaltige Seiten werden in der Reihenfolge wiederhergestellt, in der ein Mensch sie lesen würde. Ohne diesen Schritt wird eine zweispaltige Rechnung zuerst in der linken Spalte bis unten und dann in der rechten Spalte gelesen, was den Inhalt für alles Nachgelagerte durcheinanderbringt.
Erkennung der Tabellenstruktur
Zeilen, Spalten, verbundene Zellen und Spannen werden identifiziert, damit eine Tabelle als Tabelle erhalten bleibt, statt zu einer Zeichenkette von Zellen zu verflachen.
Serialisierung
Das Ergebnis wird als Markdown, JSON oder HTML ausgegeben, in der Regel mit Begrenzungsrahmen und Seitenzahlen, damit jedes Element auf seine Quellkoordinaten zurückgeführt werden kann.
Chunking und Indizierung
Für RAG-Stapel wird die geparste Ausgabe in für das Embedding geeignete Chunks aufgeteilt, in Vektoren eingebettet und in einen Index geladen, den ein Retrieval-System abfragen kann.
Bekannte Engines in dieser Kategorie sind AWS Textract, Azure Document Intelligence, Google Document AI, Unstructured, Docling und LlamaParse, das auf dem LlamaIndex-Stack aufbaut. Extend ist ein neuerer Anbieter in derselben Parse-and-Extract-API-Sparte. Sie unterscheiden sich in Modellstufe, Preis pro Seite und Ausgabetreue, teilen aber dieselbe Architektur: das Dokument in ein Modell parsen und das Modell dann an den jeweiligen Verbraucher übergeben. Ein Entwickler, der diese Engines auf Reddit verglich, fasste die praktische Realität aller zusammen: „Alle solide, alle zahlen pro Seite und ja, alle erfordern, dass man die Pipeline selbst orchestriert" (r/LLMDevs).
Was Spaltenextraktion stattdessen leistet
Die alternative Philosophie stoppt den Workflow bei der Antwort. Mit Benutzerdefinierte Spaltenextraktion geben Sie die gewünschten Spaltennamen ein: „Rechnungsnummer", „Fälligkeitsdatum", „Gesamtbetrag". Die KI liest das Dokument und lokalisiert jeden Wert, indem sie versteht, was der Spaltenname bedeutet – überall auf der Seite, ohne Koordinaten und ohne Layout-Vorlage. Die eingegebenen Spaltennamen werden zu den Kopfzeilen der Ausgabetabelle, sodass die Arbeitseinheit ein Feld ist, nicht eine Seite.
In diesem Ablauf wird kein Dokumentmodell benötigt. Es gibt keinen Layout-Analyseschritt, keine Wiederherstellung der Lesereihenfolge, keine Serialisierung in Markdown, kein Chunking. Der KI wird eine Frage pro Upload gestellt: „Finden Sie die Werte für diese Spalten und geben Sie sie zurück." Was Sie zurückbekommen, sind Zeilen, und die Zeilen sind das Ergebnis. Die Verarbeitung ist Batch-First: Laden Sie einen Ordner mit Lieferantenrechnungen hoch, und jede Rechnung landet als eigene Zeile in einer zusammengeführten Tabellenkalkulation statt als ein Parsing-Ergebnis pro Datei (eine ausführlichere Erläuterung, wie KI-Dokumentextraktion eine Seite liest, geht näher auf den Mechanismus ein).
Weil Felder das Ziel sind, spielt es keine Rolle, welches Layout der Anbieter verwendet – das wird separat in unserem Beitrag zur vorlagenfreien Dokumentextraktion behandelt. Ein Lieferant, der seine Rechnungsvorlage ändert, macht nichts ungültig, weil die Spaltendefinitionen nie an eine Position auf der Seite gebunden waren.
Was die Pipeline einem Team kostet, das nur Zeilen braucht
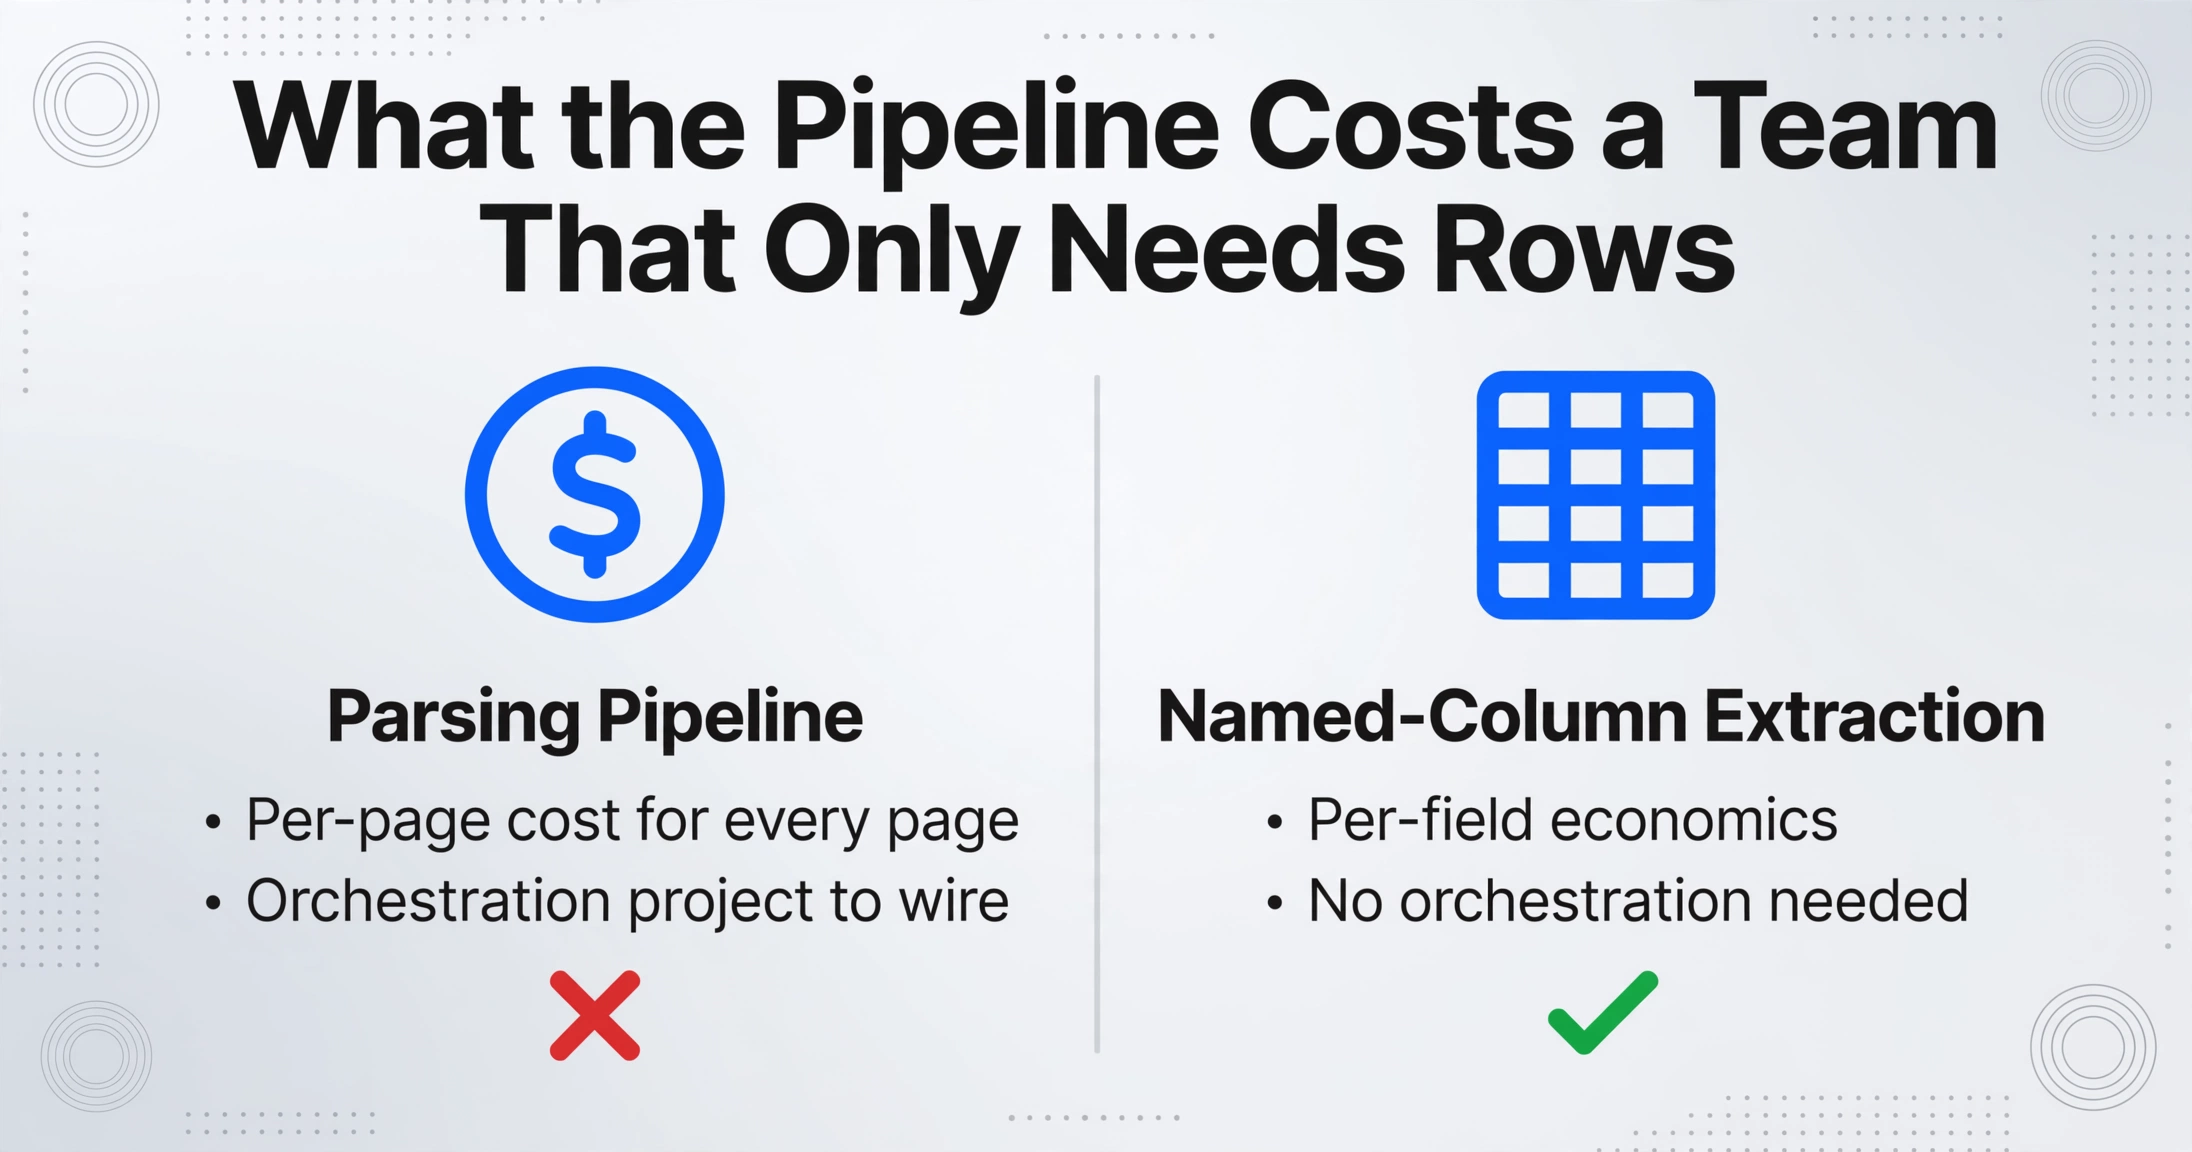
Eine Parsing-Pipeline ist für ein Tabellenkalkulationsziel nicht falsch, sie ist nur mehr Maschine, als der Job braucht – und die zusätzliche Maschine zeigt sich an drei Stellen.
Sie zahlen für Seiten, wenn Ihre Werteinheit ein Feld ist. Parsing-APIs werden pro Seite oder pro Credit für OCR und Layout-Verarbeitung abgerechnet. Jede Seite wird vollständig geparst, einschließlich des Texts, den Sie nie wieder ansehen werden, denn genau das bedeutet Dokumentrekonstruktion. Eine Rechnung, die eine Seite einnimmt, kostet eine Seite. Ein 40-seitiger Vertrag kostet vierzig Seiten, selbst wenn das Ergebnis ein Verlängerungsdatum und ein Parteiname sind. Zeilen in einer Tabellenkalkulation sind normalerweise eine Handvoll Felder pro Dokument – und die feldbezogene Ökonomie ist das, was Spaltenextraktion abrechnet, nicht die Seitenkosten für die Rekonstruktion von allem.
Sie erben ein Orchestrierungsprojekt. Der Reddit-Kommentar oben sagte es deutlich: Jeder Parser in dieser Kategorie verlangt, dass Sie die Pipeline selbst verdrahten. Ein Textract-Nutzer auf r/aws beschrieb dieselbe Erfahrung in anderem Ton: Es sei „ziemlich teuer für eine große Anzahl von Dokumenten", und „wenn das Layout des Dokuments ungewöhnlich ist, könnte es falsche Ergebnisse liefern" (r/aws). Jemand muss den OCR-Schritt mit dem Layout-Schritt verbinden, Wiederholungen behandeln, das Chunking konsistent halten und das Ergebnis bereitstellen. Für ein Team von ein oder zwei Operations-Mitarbeitern, deren eigentliche Aufgabe Lieferantendaten in einer Tabelle sind, ist diese Orchestrierung genau die Arbeit, die sie automatisieren wollten.
Die Pipeline endet dort, wo Ihre Extraktion beginnt. Hier ist der Teil, der auf der Vergleichsseite der Anbieter selten auftaucht: Eine Parsing-Pipeline liefert Ihnen Markdown, keine Felder. Um „Fälligkeitsdatum" aus einem geparsten Dokument zu erhalten, müssen Sie dennoch Ihre eigene Extraktionsebene schreiben, entweder durch Musterabgleich über das Markdown oder durch einen Schema-Prompt gegen ein LLM, und dann dessen Ausgabe validieren. Einige Parsing-Plattformen bündeln einen Extraktions-Endpunkt, aber das ist ein Add-on, und die technischen Kosten für die Zuordnung der geparsten Ausgabe zu den Zeilen, die Ihre Tabelle benötigt, bleiben bei Ihnen. Das ist ein zweites Extraktionsprojekt, das an das erste angehängt wird.
Es gibt eine menschliche Version derselben Doppelverarbeitung, und sie hat gemessene Fehlerraten. Eine systematische Übersichtsarbeit und Meta-Analyse von 2023 über Datenverarbeitungsmethoden in der klinischen Forschung ergab eine gepoolte Fehlerrate von 6,57 %, wenn jemand einen Wert aus einem Quelldokument liest und manuell in einen strukturierten Datensatz eingibt, gegenüber 0,29 % bei direkter Eingabe und 0,74 % bei automatisiertem Scannen (Garza et al., 2023). Wenn das geparste Markdown von Hand in eine Tabellenkalkulation übertragen wird, ist der Schritt derselbe und der Fehler liegt an derselben Stelle: an der menschlichen Schnittstelle zwischen zwei Darstellungen.
Die Pipeline entfernt den Extraktionsschritt nicht. Sie verschiebt ihn in der Kette nach unten: vom Dokument zum Markdown und von Ihnen zum kleinen Skript oder Schema-Prompt, das bzw. den Sie trotzdem bereitstellen müssen.
Wie die Extraktion benannter Spalten direkt auf ein Tabellenkalkulationsziel abbildet
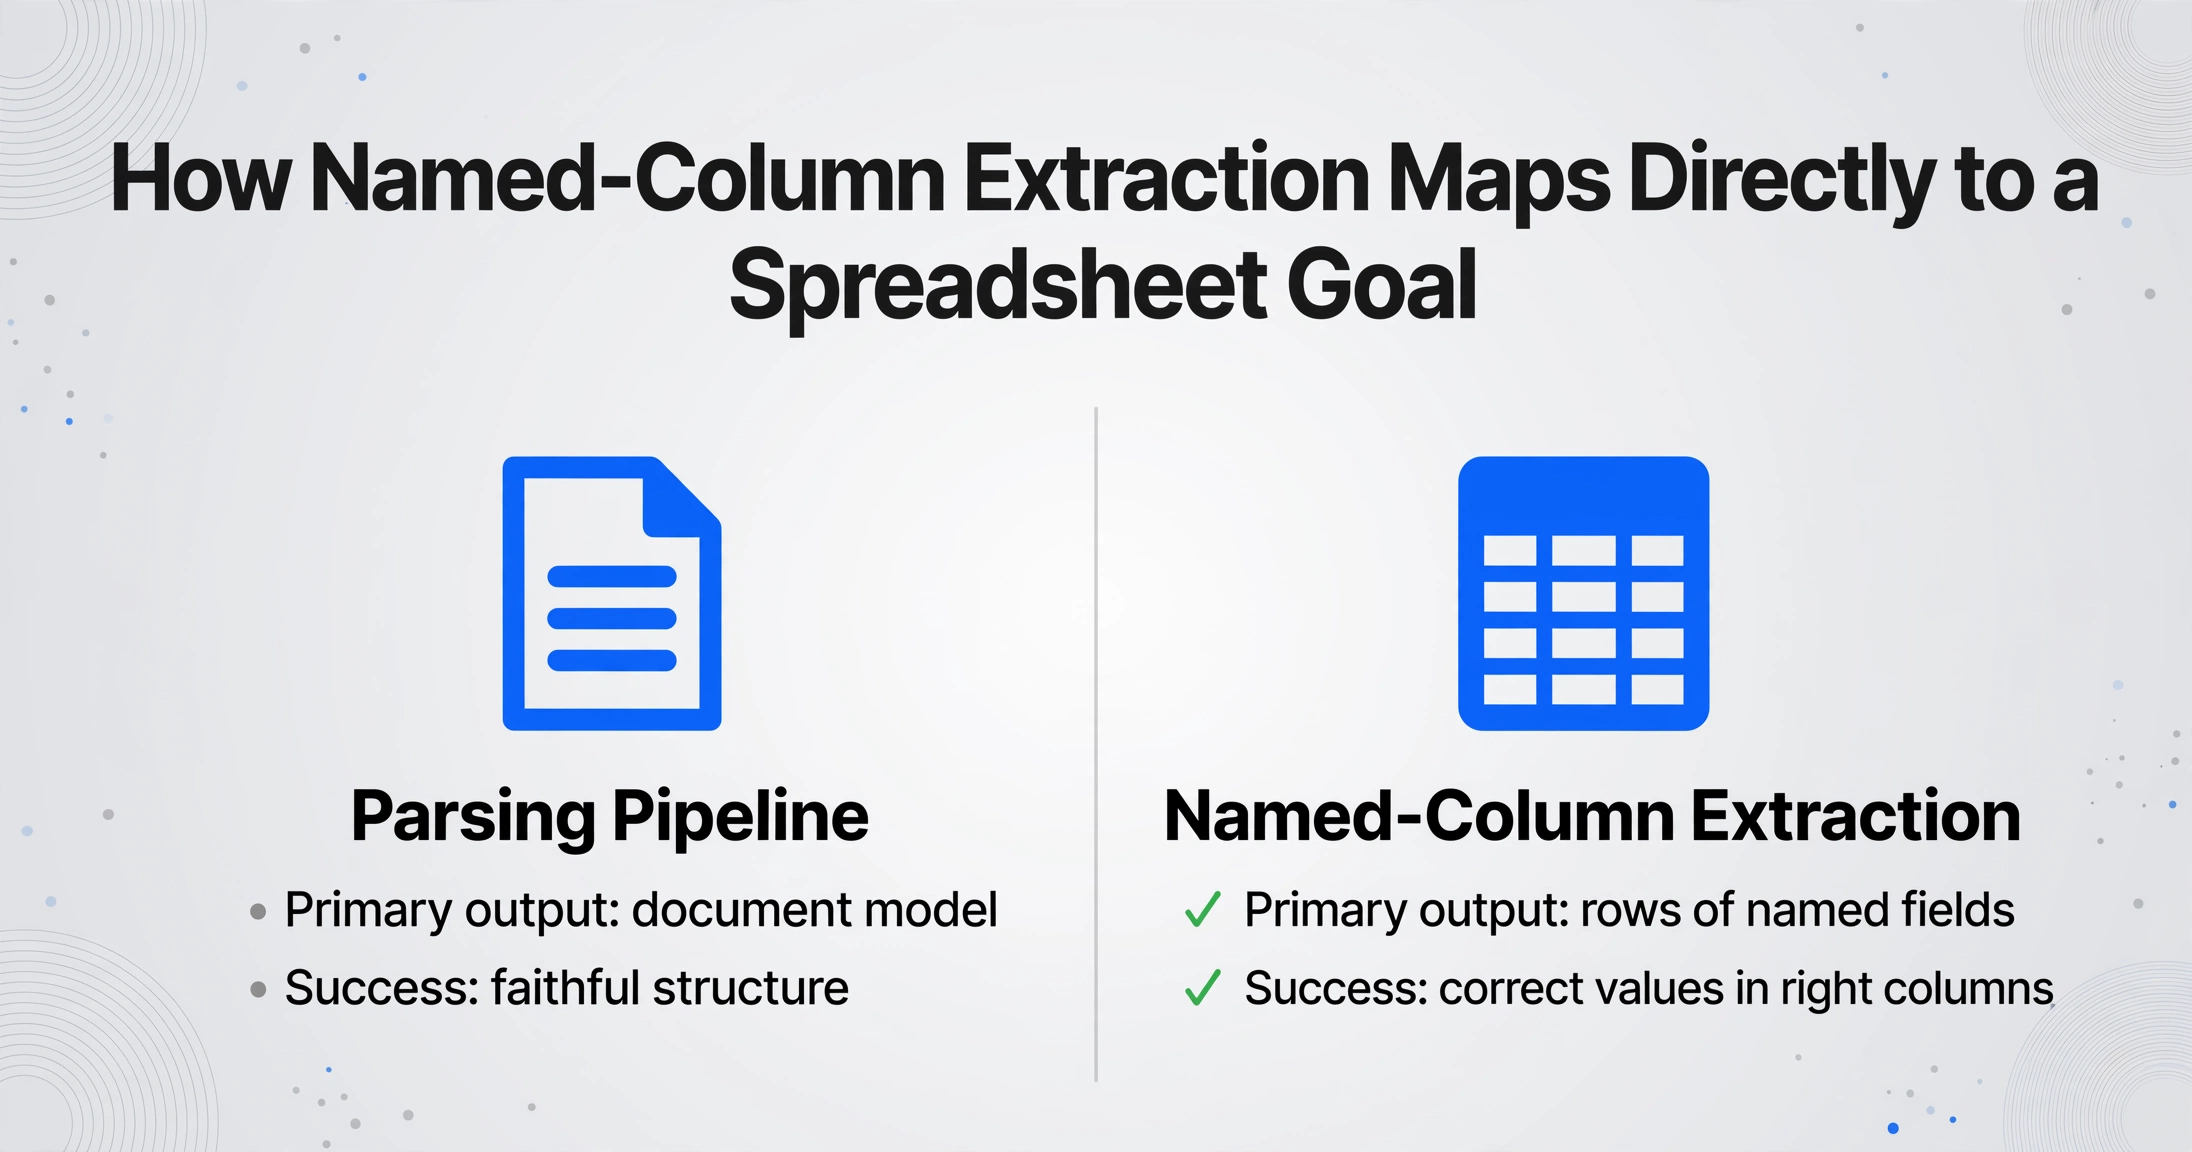
Gegenüber dieser Kostenstruktur ist die Spaltenextraktion bewusst minimal. Der Arbeitsablauf ist: Dokumente hochladen, die Spaltennamen einmal eingeben, den Batch ausführen. Das Tool liest jede Datei, füllt die Spalten und führt die Ergebnisse in einer einzigen Tabellenkalkulation zusammen – kein Parsing-Projekt, keine Orchestrierung, keine zweite Extraktionsphase. Die Verarbeitung einer einzelnen Seite dauert etwa 5 bis 10 Sekunden, während die manuelle Eingabe näher an drei Minuten liegt – ein ungefähr 18-facher Unterschied, der auf denselben Effizienzzahlen basiert, die wir produktweit veröffentlichen.
Zwei Produkteinstellungen sind für Teams wichtig, die der Ausgabe vertrauen müssen. Die Modellstufe ermöglicht es einem Konto, ein stärkeres Vision-Modell für dichte Handschrift, komplexe Layouts oder Dokumente zu wählen, bei denen kleine Fehler teuer sind, während die Standardstufe die meisten gedruckten tabellarischen Dokumente bereits abdeckt. Und der Überprüfungsmodus mit Hervorhebung des Begrenzungsrahmens bildet jeden extrahierten Wert auf seine genaue Position auf der Originalseite ab: Fahren Sie mit der Maus über eine Zelle und der Quellbereich leuchtet auf, klicken Sie auf den Bereich und die Zelle wird gefunden. Teams, die dies mit einem geparsten Markdown-Dump vergleichen, stellen normalerweise fest, dass die feldbezogene Quellenverfolgung genau die Verifikationsebene ist, die eine Tabellenkalkulationsprüfung benötigt.
| Parsing-Pipeline | Extraktion benannter Spalten | |
|---|---|---|
| Primäre Ausgabe | Dokumentmodell: Layout, Lesereihenfolge, Tabellen als Markdown oder JSON | Zeilen der benannten Felder |
| Was den Erfolg bestimmt | Originalgetreue Struktur, saubere Chunks für die Abfrage | Korrekte Werte in den richtigen Spalten |
| Einrichtung | Engine-Auswahl, Konfiguration pro Seite, Orchestrierung, Chunking, Index | Spaltennamen einmal eingeben |
| Natürliche Folgeanwendung | RAG, Agents, semantische Suche über einen Korpus | Excel, Google Sheets, ERP-Importe, Berichte |
| Was gewartet wird | Verbindungscode, Wiederholungen, Schema-Zuordnung auf die geparste Ausgabe | Überprüfung der Zeilen, die einen zweiten Blick benötigen |
Die Verifizierungsgeschichte ist der Punkt, an dem sich ein Spaltenextraktions-Workflow oft schon beim ersten Batch selbst bestätigt. Rechnungen durchlaufen lassen, den Überprüfungsmodus öffnen und die markierten Felder mit den Quellseiten abgleichen, anstatt jeden Wert doppelt zu lesen. Für Teams, die von Vorlagen-Tools kommen, die bei jeder Layout-Änderung eines Anbieters versagen, ist diese Erfahrung mit dem ersten Batch meist das entscheidende Argument, wie in den Diskussionen zum Wechsel von Docparser und zum Wechsel von Parseur behandelt. Wer in diesem Bereich noch einzelne Namen vergleicht, findet im Parseur-Vergleich eine Tool-für-Tool-Analyse.
Wenn Sie wirklich eine Parsing-Pipeline benötigen
Die Spaltenextraktion ist kein universeller Ersatz, und das Gegenteil zu behaupten wäre unehrlich. Eine Parsing-Pipeline ist die richtige Architektur für vier konkrete Anforderungen.
RAG und konversationelle KI über ein Korpus. Wenn das Ergebnis „Fragen über 10.000 Policendokumente beantworten" oder „ein Agent, der Zitate aus einer Wissensdatenbank zieht" ist, benötigen Sie Chunks, Embeddings und einen Retrieval-Index. Die Spaltenextraktion liefert Felder, keinen durchsuchbaren Inhalt. Das Dokumentmodell der Parsing-Pipeline ist genau das, was dieser Anwendungsfall konsumiert, und hier glänzt der Ansatz tatsächlich.
Layout-erhaltende Dokumentmodelle. Einige nachgelagerte Systeme müssen das Dokument als Dokument erhalten: eine Plattform für Rechtsprüfung, die eine Vertragsklausel in Lesereihenfolge rekonstruieren muss, ein Forschungsworkflow, der ein zweispaltiges Paper korrekt umfließen muss, ein Archivsystem, das die visuelle Struktur der Quelle bewahrt. Eine Feldtabelle verwirft diese Struktur von Natur aus. Wenn die Ausgabe als Dokument konsumiert wird, möchten Sie die Pipeline.
Volltextsuche. Wenn die Erfolgskennzahl die Suche in natürlicher Sprache über alles ist, was die Dokumente aussagen, und nicht über die Spalten, die sie ausfüllen, benötigt der Index den vollständigen geparsten Inhalt. Eine Tabellenkalkulation mit Schlüsselfeldern ist kein Ersatz für einen durchsuchbaren Textkorpus.
Dokumentstruktur als Produkt. Ein Team, das Dokument-Tools als eigenes Produkt entwickelt, bei dem andere Entwickler geparstes Markdown oder Layout-Bäume über eine API konsumieren, benötigt die Parsing-Ebene als Infrastruktur. Das ist ein Entwickler-Ergebnis, kein Betriebs-Ergebnis.
Die Entscheidungsregel ist das Ziel: Zeilen in einer Tabellenkalkulation weisen auf Spaltenextraktion hin, ein durchsuchbares oder layout-erhaltendes Dokumentkorpus weist auf eine Parsing-Pipeline hin. Teams, die beides benötigen, betreiben beides, aber die Tabellenkalkulationshälfte erfordert nicht, dass die Pipeline-Hälfte zuerst gebaut wird.
Für Leser, die Tools weiterhin nach Namen vergleichen, listet der jährliche OCR- und Dokument-API-Überblick die wichtigsten Engines nebeneinander auf, einschließlich der Parsing-Pipeline-Varianten. Was keine dieser Engines im Voraus verspricht, ist das, was die Spaltenextraktion sofort liefert: kein Pipeline-Aufbau, kein Chunking-Schema, nur die Spalten, die Sie benannt haben.
FAQ
Was ist der Unterschied zwischen Dokument-Parsing und Datenextraktion?
Dokument-Parsing rekonstruiert das Dokument selbst: Layout, Lesereihenfolge, Tabellen, serialisiert in Markdown oder JSON für nachgelagerte Systeme. Datenextraktion zieht die spezifischen Felder, die Sie definieren, wie Rechnungsdatum oder Gesamtbetrag, und gibt sie als Zeilen zurück. Ersteres erzeugt ein Dokumentmodell, letzteres liefert die Antwort, die Sie gesucht haben.
Benötige ich eine Parsing-Pipeline, um Daten aus PDFs in eine Tabellenkalkulation zu extrahieren?
Nein. Wenn Ihr Ergebnis Zeilen benannter Felder in einer Tabellenkalkulation sind, liest die Spaltenextraktion das Dokument und füllt die Spalten direkt. Eine Parsing-Pipeline fügt Kosten pro Seite, einen Orchestrierungsschritt und eine separate Extraktionsebene hinzu, die geparstes Markdown in die gewünschten Felder überführt.
Wann ist eine Parsing-Pipeline sinnvoll?
Wenn das Ergebnis das Dokument selbst sein soll: RAG- und Agentensysteme, die über ein gesamtes Korpus abrufen, layout-erhaltende Workflows, Volltextsuche oder die Entwicklung von Dokument-Tools als Produkt. In diesen Fällen ist das Dokumentmodell der Pipeline tatsächlich die richtige Grundlage.
Ist Parsing bei Tabellen genauer als Spaltenextraktion?
Sie messen unterschiedliche Dinge. Parsing wird danach bewertet, wie getreu die Tabellenstruktur in Markdown oder JSON erhalten bleibt. Spaltenextraktion wird danach bewertet, ob der Wert in einer benannten Spalte korrekt ist. Für eine Tabellenkalkulation zählt die zweite Metrik, und genau deshalb vergleichen Verifikationswerkzeuge wie Begrenzungsrahmen-Hervorhebung jeden Wert mit der Quellseite, anstatt der serialisierten Struktur zu vertrauen.
Welche Tools sind Parsing-Pipelines und welche sind Spaltenextraktions-Tools?
AWS Textract, Azure Document Intelligence, Google Document AI, Unstructured, Docling und LlamaParse sind Parsing-Pipeline-Engines: Sie erzeugen ein Dokumentmodell für nachgelagerte Systeme. ImageToTable.ai ist ein Spaltenextraktions-Tool: Hochladen, Spalten benennen, Tabellenkalkulationszeilen erhalten. Die beiden Kategorien lösen unterschiedliche Ergebnisse, und genau darum geht es in diesem Artikel.
Wenn Ihnen ein Dokument-KI-Anbieter das nächste Mal eine Parsing-Pipeline zeigt, fragen Sie, welchen Teil davon Ihre Tabellenkalkulation nutzen wird. Wenn die ehrliche Antwort „nur die Werte“ ist, kennen Sie den kürzeren Weg bereits: Spalten benennen, Batch ausführen und die Zeilen prüfen, die einen zweiten Blick benötigen. Lassen Sie Ihre eigenen Dokumente durch Spaltenextraktion laufen und vergleichen Sie das Ergebnis mit dem, was eine Parsing-Pipeline liefern würde.