La cause racine des hallucinations RAG
est une analyse défaillante
Une mauvaise réponse d'un système de génération augmentée par récupération ressemble à un problème de modèle. La réponse est fluide, précise et confiante, ce qui est l'apparence d'une hallucination. Mais le modèle a été invité à raisonner sur un segment de texte, et il a raisonné fidèlement sur ce segment. La question qui vaut la peine d'être posée est de savoir qui a construit le segment, car au moment où le modèle l'a vu, le document avait déjà été lu une fois, par un analyseur que la plupart des équipes n'inspectent jamais.
La chaîne de défaillance va dans une seule direction. Une analyse faible produit de mauvais segments, de mauvais segments produisent une récupération faible, et une récupération faible laisse le modèle répondre à partir de preuves corrompues. Cet article suit cette chaîne depuis le document vers le haut, nomme les défaillances d'analyse qui causent le plus de dégâts, et montre comment vérifier votre propre couche d'ingestion avant de passer un autre sprint à ajuster des invites.
Points clés à retenir
- Vous avez blâmé le modèle pour une mauvaise réponse qui venait en réalité d'un segment que vous n'avez jamais inspecté.
- Même le meilleur logiciel de numérisation vers texte dans un benchmark de 8 561 documents a échoué d'au moins 14 % par rapport à des données structurées propres, et cet écart devient votre réponse.
- Le test le plus propre consiste à fournir au modèle le texte de vérité terrain de la page à partir de laquelle il a répondu, car une réponse correcte à partir d'un texte propre montre que la faute se situe dans l'ingestion.
La chaîne de défaillance commence avant la récupération
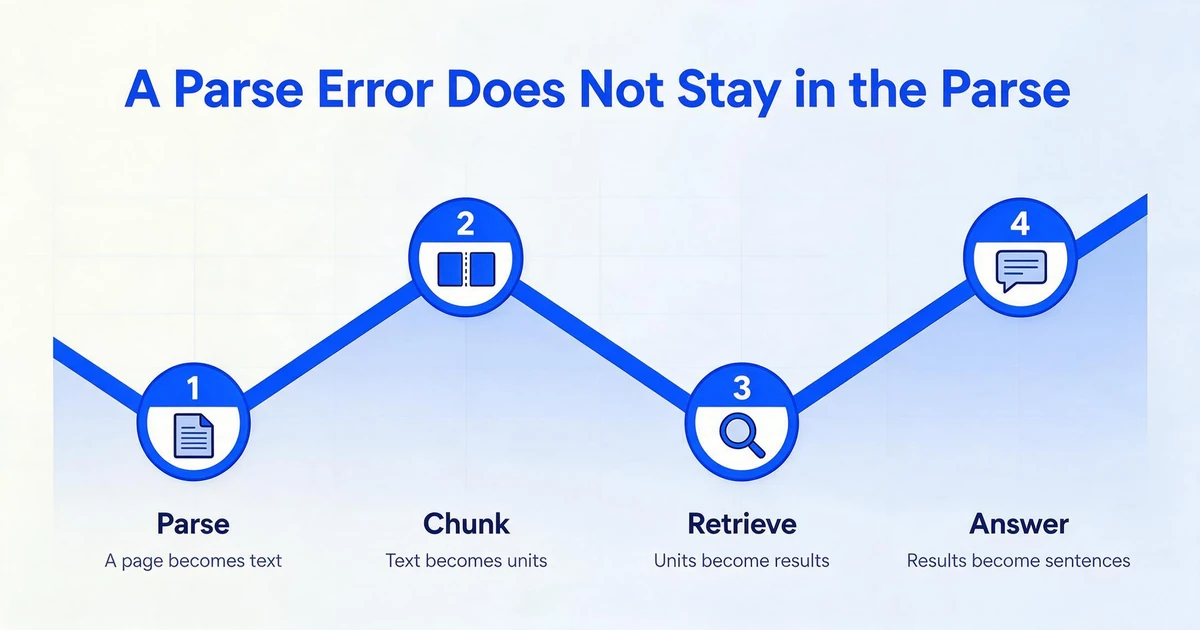
La génération augmentée par récupération est une chaîne en quatre étapes, et chaque étape hérite exactement de ce que l'étape précédente a produit. L'analyseur transforme une page en texte et, si possible, en structure. Le segmenteur divise ce texte en unités de récupération. Le récupérateur sélectionne les unités. Le modèle rédige une réponse à partir de ce que le récupérateur lui a fourni.
La chaîne est importante car un segmenteur ne peut diviser que ce que l'analyseur lui a donné, et il ne peut pas ajouter de la structure que l'analyseur a écartée. Si un tableau arrive aplati en une seule longue ligne, le segmenteur n'a aucune limite de ligne à respecter. Si deux colonnes arrivent entrelacées, aucune taille de segment ne peut les démêler. L'étape d'analyse définit le plancher, et chaque étape ultérieure repose dessus.
Ce n'est pas un cas limite rare. L'étude OHR-Bench, publiée à ICCV 2025, a construit un ensemble de test de 8 561 images de documents non structurés dans sept domaines d'application RAG réels avec 8 498 paires de questions-réponses, puis a mesuré comment le bruit OCR se propage à travers la récupération et la génération. Même la meilleure solution OCR du benchmark a échoué d'au moins 14 % par rapport aux données structurées de vérité terrain propres, et à mesure que le bruit sémantique passait de léger à sévère, la plupart des récupérateurs et des modèles de langage ont perdu près de la moitié de leurs performances (Zhang et al., « OCR Hinders RAG », arXiv:2412.02592).
Cet écart de 14 % est la partie que les équipes sous-estiment. Une erreur d'analyse ne reste pas dans l'analyse. Elle devient un segment, puis un embedding, puis un résultat de récupération, puis une phrase dans la réponse.
L'analyse définit le plafond pour tout ce qui se trouve au-dessus. Aucune stratégie de segmentation ne peut ajouter une ligne de tableau que l'analyseur a aplatie ou démêler deux colonnes qu'il a lues en travers.
Pourquoi le modèle est tenu pour responsable
Lorsqu'un système RAG échoue en pratique, l'échec se situe généralement dans la récupération ou dans le contenu, pas dans le générateur. Un rapport d'expérience de Deakin University a analysé trois études de cas RAG en production et une exécution empirique sur 15 000 documents et 1 000 questions, puis a répertorié sept points de défaillance. Trois d'entre eux décrivent exactement ce schéma : la réponse n'a jamais été classée assez haut pour être renvoyée, elle a été récupérée mais perdue lors de l'assemblage du contexte, ou elle était présente dans le contexte et le modèle n'a toujours pas réussi à l'extraire, ce que les auteurs attribuent à trop de bruit ou à des informations contradictoires (Barnett et al., « Seven Failure Points When Engineering a RAG System », arXiv:2401.05856).
« Bruit ou informations contradictoires » est l'expression qui compte. Un modèle raisonnant sur un segment où un nombre a perdu son étiquette s'appuie sur quelque chose de réel qui a été mal extrait, et il n'a aucun moyen de savoir que l'étiquette est manquante. Dans un environnement riche en documents, un praticien a décrit la même découverte après des semaines de modifications de segmentation, de changements d'intégrations et de reclassements : les documents sources eux-mêmes étaient mal convertis en texte, et bon nombre des hallucinations apparentes étaient le modèle s'appuyant sur quelque chose qui avait été mal extrait (r/Rag, mars 2026).
Ensuite, il y a la solution à laquelle tout le monde pense en premier : donner au modèle plus de contexte. Elle se retourne plus souvent contre vous qu'elle n'aide.
Des recherches sur la façon dont les modèles de langage utilisent les entrées longues ont révélé une courbe de performance en forme de U. Les modèles utilisent le mieux les informations lorsqu'elles se trouvent au tout début ou à la toute fin du contexte, et les performances chutent lorsque le passage pertinent est enfoui au milieu. Dans un test en domaine ouvert, passer de 20 documents récupérés à 50 n'a amélioré la précision du lecteur que d'environ 1,5 % tout en ajoutant une grande quantité d'entrées (Liu et al., « Lost in the Middle », arXiv:2307.03172).
Augmenter le top-k ou la fenêtre de contexte ajoute plus de matière sur laquelle le modèle doit raisonner. Cela ne rend pas un contenu corrompu plus propre.
Les échecs d'analyse qui empoisonnent réellement le RAG
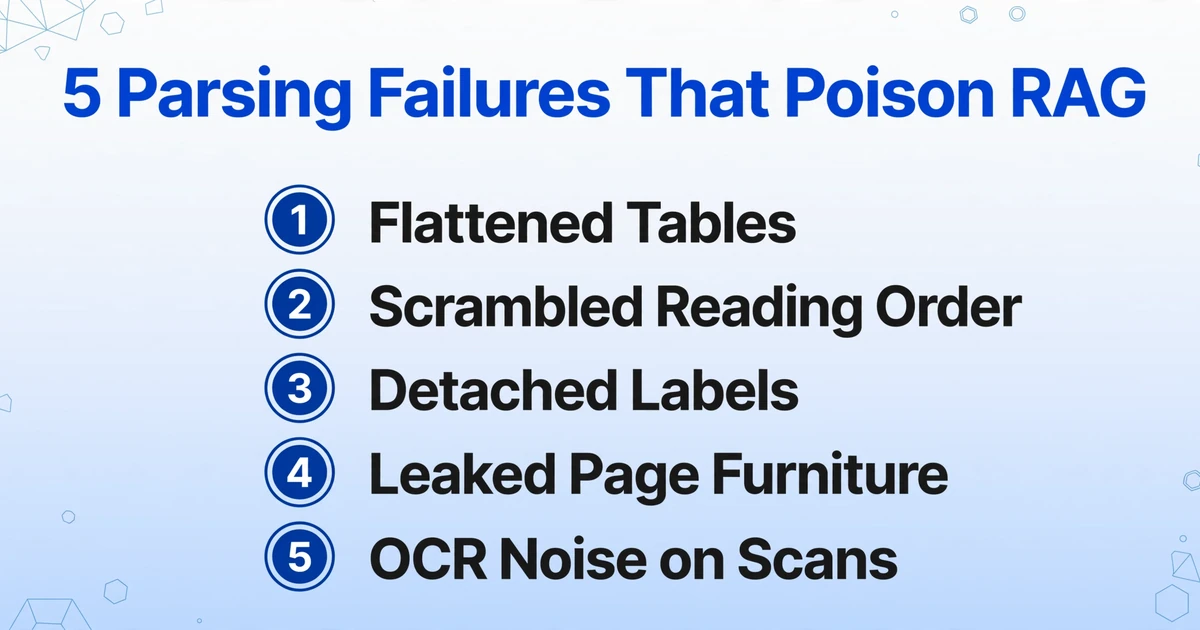
Les échecs d'ingestion ne sont pas aléatoires. La plupart relèvent d'un petit ensemble de types récurrents, et chacun laisse un symptôme reconnaissable plus loin dans la chaîne. Le tableau ci-dessous les répertorie.
| Échec d'analyse | Ce qui casse dans le texte | Comment cela se manifeste en aval |
|---|---|---|
| Tableaux aplatis | Les lignes et les colonnes s'effondrent en une seule ligne, et une cellule perd l'en-tête qui la nomme. | Le récupérateur renvoie la bonne page, mais le segment contient « 3,5 » sans « Henry Hub » à côté, donc les questions de valeur obtiennent des réponses manquantes ou erronées. |
| Ordre de lecture mélangé | Sur les pages multi-colonnes, l'analyseur lit à travers la gouttière et entremêle deux colonnes sans rapport. | Le segment se lit comme une prose fluide mais mélange deux idées. La récupération le fait correspondre, et le modèle répond à partir de la mauvaise. |
| Étiquettes détachées et hiérarchie perdue | Une valeur se sépare de son étiquette, et un titre perd son niveau. | Les segments traversent les limites de section. « Pénalité de résiliation : 2 % » devient des jetons orphelins, et le modèle rattache le nombre le plus proche qu'il trouve. |
| Éléments de page divulgués | Les en-têtes courants, les pieds de page et les numéros de page entrent dans le corps du texte. | Les textes répétitifs polluent les segments et diluent l'embedding, donc les passages pertinents obtiennent un score inférieur à ce qu'ils devraient. |
| Bruit OCR sur les scans | Les caractères et les chiffres sont mal lus, ou le texte disparaît sur les scans de mauvaise qualité. | Les chiffres et les identifiants arrivent subtilement faux. La réponse est confiante et décalée d'un chiffre. |
Un humain qui lit un tableau aplati peut souvent reconstruire la grille à partir du contexte. Un segmenteur ne le peut pas, et un embedding non plus. La relation entre un nombre et son en-tête n'existe que si l'analyseur l'a capturée. C'est la différence entre les deux familles d'analyse : l'OCR basé sur la position lit les caractères et déduit la structure de leur emplacement, tandis qu'un modèle de vision peut lire la page par le sens et garder une étiquette attachée à sa valeur. Les preuves issues des benchmarks derrière cette distinction figurent sur notre page de référence comparant l'OCR traditionnel aux modèles de vision pour l'analyse de documents.
Comment savoir si le problème vient de la couche d’analyse
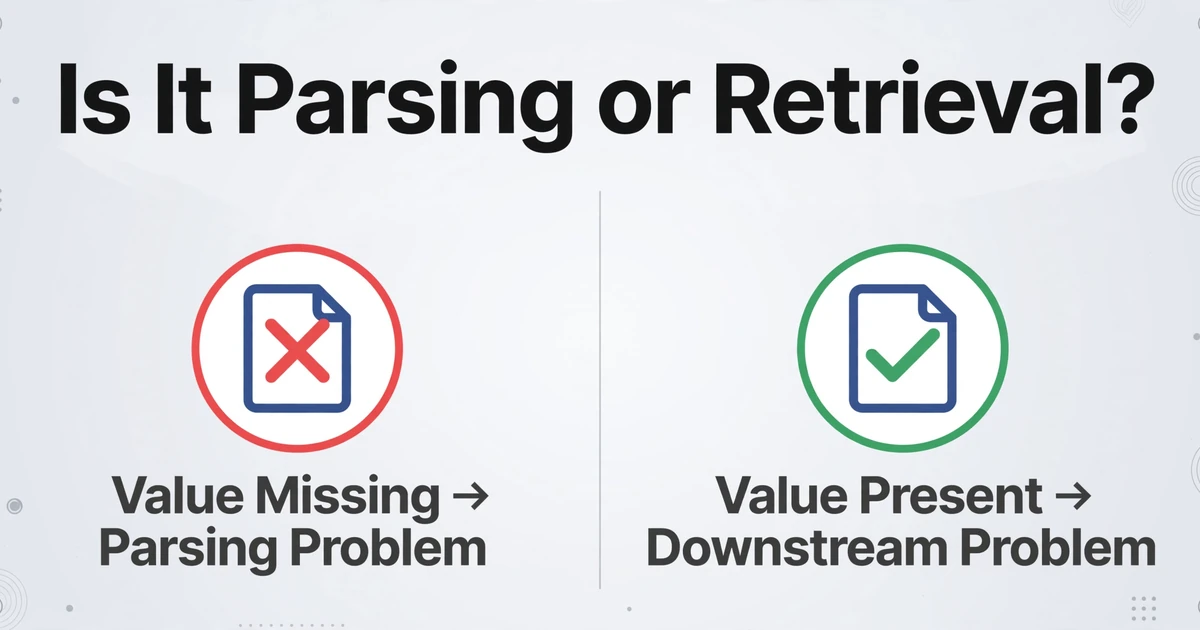
Vous n’avez pas à deviner quelle étape a échoué. La chaîne vous offre un test à chaque maillon, et ces tests sont peu coûteux. Exécutez-les dans l’ordre et arrêtez-vous dès que vous avez votre réponse.
Récupérez les segments renvoyés pour une réponse erronée
Presque toutes les piles RAG peuvent journaliser les segments envoyés dans le prompt. Commencez par là, car le reste de l’audit dépend de la visualisation du contexte réel reçu par le modèle, et non d’un résumé de celui-ci.
Cherchez la valeur correcte dans ces segments
Si le document source contient clairement la réponse mais que le segment récupéré ne la contient pas, c’est l’analyse ou une limite de segment qui l’a perdue. Si la valeur est présente et correcte mais que le modèle répond encore mal, votre problème se situe en aval de l’analyse.
Inspectez une page contenant un tableau
Collez la sortie de l’analyse de cette page dans une vue en texte brut. Si les lignes et les colonnes ont survécu, le tableau est intact. Si elles se sont effondrées en une seule ligne, toutes les questions portant sur des tableaux de ce document sont à risque.
Vérifiez l’ordre de lecture sur une page à deux colonnes
Lisez le texte extrait comme un humain lirait la page. S’il saute entre deux colonnes sans rapport, les segments tirés de cette page sont sémantiquement mélangés, même s’ils semblent cohérents.
Cherchez les éléments de page dans le corps du texte
Recherchez le numéro de page ou l’en-tête courant dans le texte extrait. S’ils apparaissent au milieu d’un paragraphe, ils sont intégrés comme s’ils étaient du contenu et ils diluent chaque segment de la page.
Testez la question avec un texte de vérité terrain
Fournissez au modèle une version corrigée manuellement ou de vérité terrain de la page d’où provient la réponse. S’il répond correctement avec un texte propre et incorrectement avec le texte analysé, vous avez isolé le défaut à l’ingestion et pouvez laisser la récupération et le modèle tranquilles.
Le test unique le plus fiable : donner au modèle le texte de vérité terrain de la page d'où provient la réponse. S'il obtient la bonne réponse, la récupération et la génération n'ont jamais été le problème.
Ces vérifications recoupent le dépannage général de l'extraction, et la cartographie symptôme-cause de notre guide sur le diagnostic des problèmes d'extraction de documents est un compagnon utile lorsqu'un type de document échoue toujours de la même manière. Une précaution sur la mesure : un score au niveau des caractères peut classer un bon analyseur comme le moins performant, alors traitez tout chiffre unique de qualité d'analyse avec prudence, comme l'explique cette analyse de pourquoi le CER induit en erreur pour l'analyse de documents.
Corriger au niveau de l'extraction
La correction appartient à la couche qui transforme d'abord une page en texte, car c'est la seule couche où la structure peut encore être préservée. Si la sortie d'analyse est un flux de caractères bruts, le segmenteur doit inventer des limites et le récupérateur doit classer du bruit. Si la sortie d'analyse est déjà structurée et étiquetée, les étapes en aval ont quelque chose d'honnête avec quoi travailler.
Le changement pratique passe d'une lecture basée sur la position à une lecture sémantique. L'OCR basé sur la position convertit une page en caractères et les place par coordonnées, puis s'appuie sur des règles de mise en page pour deviner ce qui est un titre, une valeur ou une cellule de tableau. Un modèle de vision peut lire la page pour le sens à la place, ce qui est l'approche derrière Custom Column Extraction. Vous tapez les noms de colonnes souhaités, tels que « Numéro de facture », « Numéro de compte » ou « Valeur du contrat », et l'IA localise chaque valeur n'importe où sur la page en comprenant ce que le champ signifie. Chaque document ressort sous forme de ligne avec ces colonnes remplies, de sorte que les valeurs arrivent déjà rattachées aux étiquettes que vous avez définies.
Pour un pipeline RAG, cela change l'entrée du segmenteur. Au lieu d'un mur de chiffres, les lignes de tableau conservent leurs en-têtes. Au lieu d'une étiquette flottant sans sa valeur, la paire voyage comme une seule unité. La couche d'extraction ne décide pas de vos limites de segments ni ne choisit votre modèle d'intégration. Elle remet à l'étape suivante une sortie structurée et étiquetée, de sorte que les segments construits à partir de celle-ci ne sont pas bâtis sur un texte corrompu.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Si vous intégrez la couche d'extraction dans votre propre code plutôt que dans un tableur, l'API v1 est le point d'intégration. Elle accepte les téléversements de documents et les tâches par lots, renvoie du JSON structuré et peut notifier votre système via un webhook lorsque le traitement est terminé, afin que l'extraction puisse se placer derrière votre propre application ou flux de travail. Pour les corpus où un document logique s'étend sur plusieurs pages, comme un relevé bancaire ou un contrat, la fusion multipage regroupe les pages en un seul enregistrement, de sorte qu'un segment n'est pas construit à partir d'un demi-document. Le post-traitement des données peut également normaliser les dates et les montants dans un format fixe pendant l'extraction, ce qui maintient la cohérence des identifiants d'un segment à l'autre.
Ce que cela remplace, c'est l'étape de lecture des documents, pas votre pile RAG. La plupart des équipes conservent le récupérateur, le magasin vectoriel et le modèle. La couche d'extraction cesse simplement de leur fournir du texte déjà cassé. Le même mécanisme, décrit pour la tâche d'analyse en soi, se trouve sur la page analyseur de documents IA.
Ce que cela ne résout pas
L'honnêteté compte plus qu'un argumentaire propre ici, car un projet RAG fondé sur une affirmation exagérée échoue de la même manière que le pipeline.
Cela ne construit ni n'exécute votre système RAG. Cela gère la couche de lecture des documents qui alimente la récupération. Cela ne met pas en place une base de données vectorielle, ne choisit pas une stratégie de récupération et n'exécute pas votre étape de génération.
Cela ne choisit pas vos limites de segments ni votre modèle d'embedding. Ces décisions restent celles de votre pipeline. La couche d'extraction ne modifie que la qualité du texte sur lequel ces décisions s'appuient.
Cela ne fait pas correspondre les champs entre les documents. Cela mappe les champs de chaque document à vos colonnes nommées. Comparer une valeur d'un document à une valeur d'un autre et décider automatiquement est une tâche différente, qui relève de votre logique en aval.
Cela ne peut pas inventer une valeur absente du document. Si un champ est réellement absent, la sortie est vide plutôt que fabriquée. C'est le comportement correct, et un vide est un signal pour vérifier la source, pas un chiffre à croire.
Les numérisations de mauvaise qualité réduisent toujours la précision. Les reçus thermiques délavés, les inclinaisons importantes et les photos basse résolution restent difficiles pour tout système. Ces sorties méritent une passe de vérification. L'objectif est de déplacer le jugement humain de la réparation du pipeline vers la vérification des quelques valeurs qui nécessitent un second regard.
Questions fréquemment posées
Pourquoi mon RAG hallucine-t-il alors que la récupération semble pertinente ?
La pertinence et l'exactitude sont deux choses différentes. Un segment récupéré peut être thématiquement proche de la question tout en ne contenant pas la valeur qui y répond, ou en portant cette valeur détachée de son libellé. L'étude OHR-Bench a mesuré que le bruit d'analyse dégrade à la fois la récupération et la génération, si bien qu'un résultat qui semble pertinent peut tout de même être une preuve corrompue sur laquelle le modèle raisonne fidèlement.
Une fenêtre de contexte plus large ou un top-k plus élevé peut-il corriger les hallucinations du RAG ?
Rarement. Les recherches sur les modèles à contexte long montrent qu'ils utilisent le mieux les informations au début et à la fin du contexte et se dégradent vers le milieu, et qu'ajouter des documents au-delà d'un certain point ne procure que de très faibles gains. Plus de contexte donne au modèle davantage de matière pour raisonner. Cela ne répare pas un segment construit à partir d'une analyse défaillante.
Quelles erreurs d'analyse de documents causent le plus d'échecs du RAG ?
Les tableaux aplatis, l'ordre de lecture brouillé sur les pages multi-colonnes, les valeurs détachées de leurs libellés, la hiérarchie de sections perdue, les en-têtes et pieds de page qui fuient, et le bruit d'OCR sur les scans. Les échecs de tableaux sont les plus dommageables, car la relation entre une cellule et son en-tête n'existe que si l'analyseur l'a capturée, et aucune étape aval ne peut reconstruire une grille qui n'a jamais survécu à l'analyse.
Comment tester si mon problème de RAG vient de l'analyse ou de la récupération ?
Extrayez les segments que la récupération a renvoyés pour une réponse erronée connue et cherchez-y la valeur correcte. Inspectez la sortie d'analyse brute d'une page de tableau par rapport à l'original, et vérifiez l'ordre de lecture sur une page à deux colonnes. Ensuite, fournissez au modèle le texte de vérité terrain de la même page. S'il répond correctement à partir d'un texte propre, le défaut se situe dans l'ingestion, pas dans la récupération.
ImageToTable.ai construit-il ou exécute-t-il un pipeline RAG ?
Non. Il s'agit d'une couche d'extraction. Il lit les documents et renvoie des données structurées et étiquetées sous forme Excel, CSV, JSON ou Word. Votre récupération, votre stockage vectoriel et votre génération restent les vôtres. Le produit gère l'étape d'analyse qui alimente ces systèmes, et rien au-delà.
Quelle sortie la couche d'extraction produit-elle pour un pipeline RAG ?
Une ligne par document avec les colonnes que vous avez nommées, plus du JSON structuré via l'API v1. Comme les valeurs arrivent associées aux étiquettes que vous avez définies, le segmentation et la récupération en aval travaillent sur du texte structuré plutôt que sur un flux de caractères brut.
Peut-il gérer les PDF scannés et les documents multipages ?
Il accepte les PDF, y compris ceux protégés par mot de passe, les images JPG et PNG, les fichiers WebP et AVIF, ainsi que les captures d'écran, et il reconnaît le texte imprimé et manuscrit. La fusion multipage regroupe les pages d'un même document logique en un seul enregistrement, ce qui est utile lorsqu'un segment serait autrement construit à partir d'une partie d'un relevé ou d'un contrat. La précision diminue toutefois sur les scans de très mauvaise qualité ; ces sorties méritent donc une passe de vérification.
Les bugs RAG les plus coûteux sont ceux qui ressemblent à un problème de modèle et vous poussent à ajuster les prompts, les tailles de segments et les rerankers alors que les dégâts réels ont été causés avant même que la récupération ne s'exécute. Auditez d'abord l'analyse. Lorsque le texte qui entre dans votre pipeline est structuré et correctement étiqueté, le modèle raisonne enfin sur des preuves dignes de confiance.