誤った署名者を拾わない
メール署名の解析
電話番号は簡単な部分です。正規表現はミリ秒で署名から電話番号を見つけます。難しいのは、それが誰の番号なのか、その上の行が役職なのか部署なのか、そしてその値がまだ有効なのかどうかです。
このギャップがあるため、メール署名解析のデモは実際のメールボックスよりも良く見えます。デモには送信者が1人、署名が1つ、言語が1つしかなく、引用履歴もありません。実際に使われている受信箱には、それぞれが複数あり、しばしば同じスレッド内に存在します。このガイドでは、署名ブロックに含まれるもの、抽出が壊れる4つの箇所、どのフィールドがクライアントや言語をまたいで生き残るのか、そして2人を1行にマージせずにメッセージを連絡先テーブルに変換するワークフローを扱います。
主なポイント
- 署名が完璧に読み取れても、誤った人物のものである可能性があります。
- MailgunのTalonは署名行の92%を正しく分類しましたが、それでも約12行に1行は誤っていました。
- まず行の所有者を設定します。本文の最後の名前ではなく、メッセージを送信したアドレスです。
署名ブロックに実際に含まれるもの
署名とはメッセージ末尾にある短い連絡先ブロックであり、そのレイアウトについて標準化されているものはほとんどありません。メールには抽出ツールにとって重要な6つの部分があります。ヘッダー、新規メッセージ、結びの挨拶、署名ブロック、引用履歴、そしてその後に続くものです。最後の部分は忘れられがちです。法的免責事項、バナー画像、他人からの引用返信、あるいは何もないこともあります。
| 部分 | 含まれる内容 | 抽出を混乱させる理由 |
|---|---|---|
| ヘッダー | From、To、Date | 表示名が氏名ではなくイニシャルや役職である場合がある |
| 本文 | メッセージそのもの | 他の人物、他の電話番号、他の会社に言及することがある |
| 結びの挨拶 | 「Best,」「Thanks,」、名前 | 連絡先ブロックが続かなくても署名の始まりのように見える |
| 署名 | 氏名、役職、会社、電話、リンク | 行の順序が人物、クライアント、言語によって変わる |
| 引用履歴 | 以前のメッセージとその署名 | 現在の署名の下に他人のブロックが追加される |
| フッター | 免責事項、登記上の住所、バナー広告 | 会社らしい文字列と、実際の住所の下に2つ目の住所が追加される |
標準と呼べる唯一の目印は、2つのダッシュとスペースを含む行、2004年のRFC 3676に文書化されたUsenet署名区切りです。これは慣習であり要件ではなく、多くのクライアントはこれを使わずに署名を作成します。HTMLでは境界がさらに曖昧になります。テーブルとしてレイアウトされた署名では、名前をあるセルに、役職を別のセルに、ロゴをさらに別のセルに配置できます。テキストはすべて存在しますが、読み取り順序はHTMLソースが示すとおりであり、人間が見る順序とは限りません。
署名には必須の開始マーカーがありません。すべての抽出ツールはブロックがどこから始まるかを推測しなければなりません。
失敗の原因は帰属であり、パターンマッチングではない
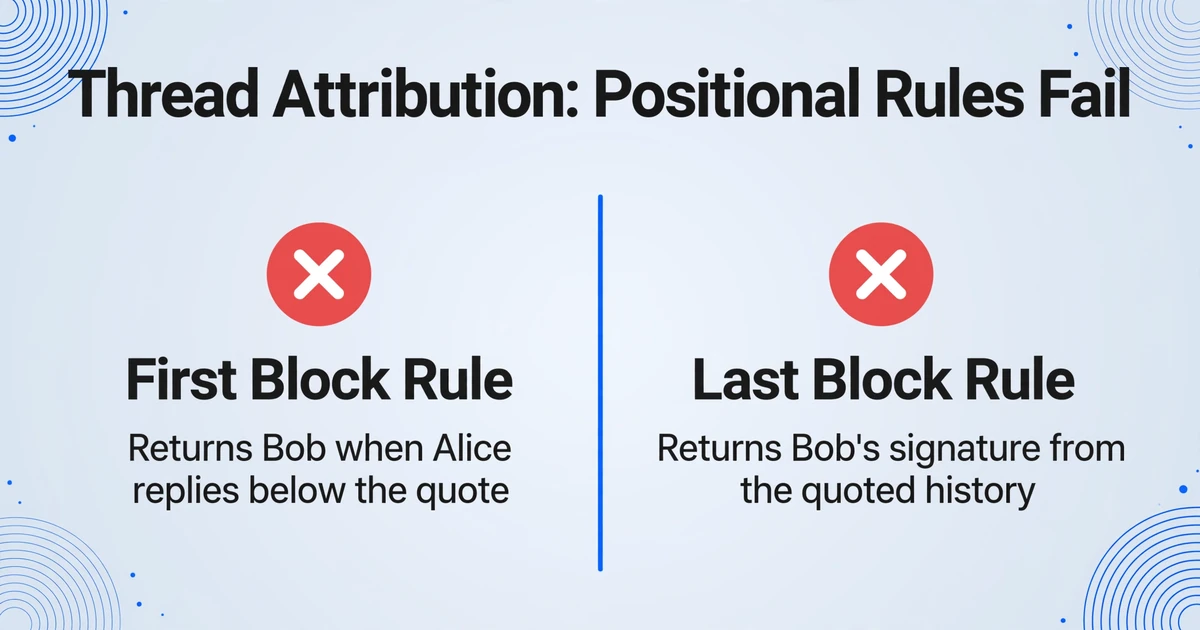
メール署名抽出で最も重大な失敗は、正しい署名だが別人のものであるケースです。この結果を生む状況は4つあり、いずれも十分に一般的なので事前に対策を講じるべきです。
署名が2つある返信チェーン。 AliceがBobに返信します。彼女のメッセージが上部にあり、Bobの引用メッセージと彼の署名がその下にあります。最後のブロックを取得するパーサーはBobを返します。最初のブロックを取得するパーサーは、Aliceが引用の上に書いた場合のみAliceを返します。引用の下に返信した場合、最初のブロックもBobのものになります。どちらのルールも位置ベースであり、スレッドはどちらのルールにも安定した位置を与えません。
共有メールボックスまたはロールアドレス。 sales@やinfo@のようなアドレスは、1人が署名する場合もあれば、2人を記載したチームブロックの場合もあり、役員のために書くアシスタントの場合もあります。レコードキーが送信者アドレスであれば、2人が1つの連絡先になります。キーが署名内の名前であれば、名前の形式が変わったときに1人が2つの連絡先になります。2021年のHubSpot Communityスレッドで、CRMユーザーが同じ混乱を描写しています。問い合わせメールは汎用アドレスから届き、実際の連絡先情報は本文内にあり、誰かが手作業で人物とメールボックスを切り離しているのです(HubSpot Community)。
同じパターンは不動産リードメールの受信箱にも現れます。そこではポータルアラートとオープンハウスの受付名簿が、同じ買い手を2つの形式で記述しています。
転送メッセージ。 「FYI、以下参照」には転送者の署名がありません。本文内の唯一の署名は元の送信者のものです。転送者のアドレスをキーとする行は、今や他人の電話番号を保持しています。
これらのいずれも、より優れたパターンでは解決しません。解決するのは、抽出前にその行の所有者を決めることです。つまり、本文の最後の名前ではなく、処理対象のメッセージのアドレスです。入力がスレッドの場合、署名の境界だけでなくメッセージの境界も必要です。名前の形式は同じ問題の小規模版を生みます。「J. Rivera」と書かれたヘッダーと「Jordan Rivera, VP of Sales」と書かれた署名は、1人の人物の2つの形式であり、マージルールはそれを認識する必要があります。
スレッド内の最後のブロックを取得するパーサーは、最後に書いた人物を返すのであり、処理対象のメッセージを送信した人物を返すのではありません。
正規表現が破綻する4つの具体的なケース
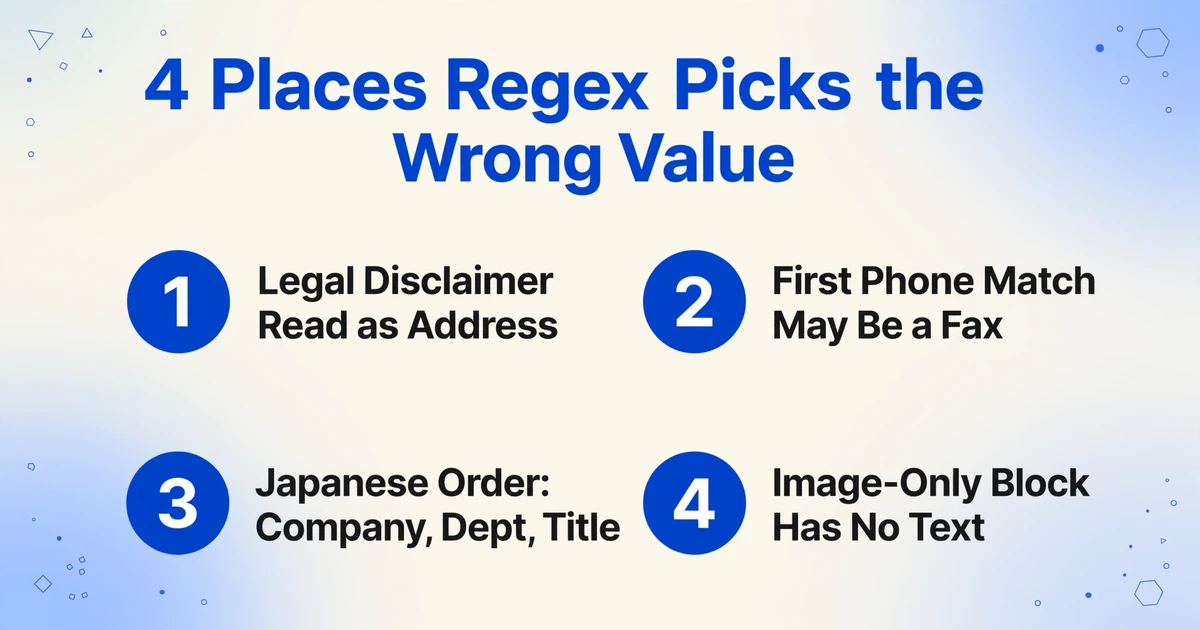
正規表現は句読点のあるフィールドでは信頼できますが、意味を持つフィールドでは信頼できません。そして署名の大半は後者です。ルールでメール署名を解析するチームは通常、電話番号、メールアドレス、URLから始めます。これらのパターンは機能するからです。失敗はその周辺の行に現れます。
署名の下にある法的免責事項。機密保持通知、登記上の会社名、登記上の所在地が実際のブロックの下に置かれることがよくあります。結びの挨拶以降のすべてを収集するルールは、通知を住所として読み取り、その中のLLCやGmbHといった接尾辞を会社名として取得してしまいます。セマンティックリーダーは法的通知と「Acme GmbH, Musterstrasse 1」を区別できます。通知はメッセージについての文であり、住所は場所だからです。
2回現れる電話番号。本文の行に「携帯に電話して」と1つの番号が書かれ、署名には固定電話、FAX、携帯が記載されていることがあります。正規表現は最初の一致を返しますが、それはFAX番号やメッセージ内で引用された顧客番号かもしれません。ラベルがフィールドです: Tel、Mobile、Fax、または携帯。ラベルを外すと、抽出器はそれが何なのか分からないまま番号を返します。
英語の順序ではない署名。英語の署名は氏名、役職、会社の順に並ぶ傾向があります。日本語の署名は会社、部署、役職、氏名の順で、単語間にスペースがないこともよくあります。部長は役職ですが、英語の役職辞書にはありませんし、氏名は姓が先に書かれているかもしれません。ドイツ語のGeschäftsführer(マネージングディレクター)やフランス語のDirecteur général(ゼネラルマネージャー)は逆の形で同じ不一致を生みます。タイトルケースと役職と会社の間のカンマを期待するルールには、一致するものがありません。
テキストがない、あるいはほとんどないブロック。画像のみの署名にはテキストが一切含まれません。携帯からの返信には「Sent from my iPhone」しかなく、これは1行の署名の形をしていてフィールドはありません。HTMLテーブルは、タグが除去されると氏名と役職の視覚的な順序が逆になることがあります。
より巧妙な正規表現でもこれは解決しません。Mailgunが2013年にTalonライブラリをオープンソース化したとき、機械学習分類器を使って署名行と非署名行を分類しました。2,912行のテストセットで、分類器は92%の行を正しく判定しましたが、それでも約12行に1行は誤りです(Mailgun)。これは行の分類であり、フィールドの割り当てではありません。2018年にHPIメールコーパスに注釈を付けた研究者たちは、メッセージを署名を含む5つのゾーンに分割しました。このタスクは抽出の前にセグメンテーションだからです(Hasso Plattner Institute)。
正規表現は形を読み取り、役割は読み取りません。FAX番号と携帯番号は同じ形をしています。
どのフィールドがクライアントや言語をまたいで残るか
メールアドレス、氏名、会社、役職はほとんどの署名で残ります。電話と住所は、抽出ツールがそれを識別するラベルを保持している場合にのみ残ります。
| フィールド | 取得元 | 壊れる原因 | 実務上のルール |
|---|---|---|---|
| メールアドレス | ヘッダー | ロール別名、プラスアドレッシング、転送メール | 小文字化し、プラスタグを除去し、ロールアドレスは別扱いにする |
| 氏名 | ヘッダーの表示名と署名 | イニシャル、姓名の順序、中国語・日本語・韓国語の氏名慣習、敬称 | イニシャルでない最長の形を優先し、ヘッダーの値はフォールバックとして保持する |
| 役職 | 署名 | 言語、略語、部署か役職かの区別 | 元の文字列を保存し、序列へのマッピングは後で行う |
| 会社 | 署名とメールドメイン | ブランド名か法人名か、接尾辞、翻訳 | 法人名は署名から取得し、ドメインは確認用にとどめる |
| 電話 | 署名 | 複数の番号、ラベル、国番号 | ラベルごとに1列: 固定電話、携帯、FAX |
| 住所 | 署名 | 行の順序、郵便番号の位置 | 複数行のブロックとして保持し、国フィールドが必要なときだけ分割する |
| ウェブサイトとソーシャル | 署名 | 短縮リンク、トラッキングパラメータ | 生のURLを保存し、抽出後に正規化する |
パターンは単純です。フィールドは、その意味がブロック内の位置ではなくヘッダーやラベルから来ているときに残ります。電話番号にはラベルが必要であり、住所は改行をまとめたまま保持する必要があります。
言語は2つ目のフィルターです。SigParser自身のFAQでは英語が1位、ドイツ語が2位、次いでスペイン語、フランス語、ポルトガル語、ロシア語、オランダ語と続きます(SigParser)。これは有益な告白です。多くのパーサーは英語優先であり、署名が英語の慣習から離れるほど、ツールは役職リストではなく汎用の言語モデルに頼るようになります。
元の役職文字列を保持してください。抽出時にGeschäftsführerを「Managing Director」と翻訳するのは後戻りできない判断であり、その人の法的な役割にとって誤りである可能性があります。元のまま保存し、後でマッピングしましょう。
ヘッダーフィールドはクライアントが書き込むため安定しています。署名フィールドは、そのラベルが残る場合にのみ安定します。
メールボックスから連絡先テーブルへ
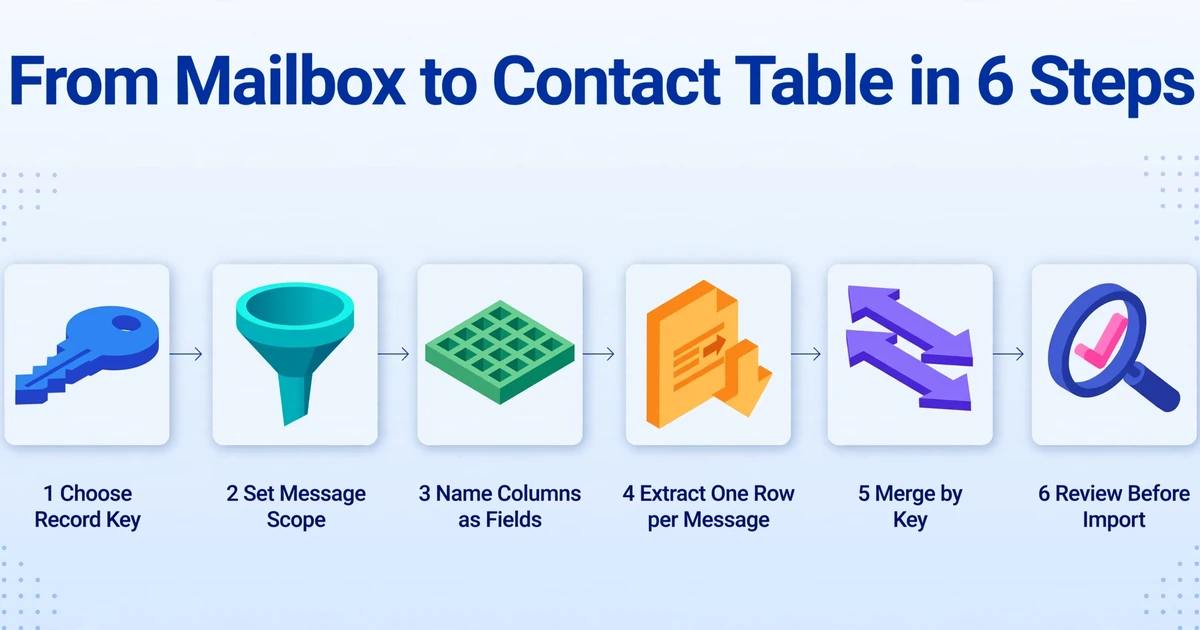
テーブルは2つのパスで構築します。まず1メッセージを1行にし、次に明示的な競合処理ルールの下でメールアドレスごとに行をマージします。この両方を同時に行うと、2人が1つの連絡先になってしまいます。メールから連絡先情報を抽出する多くのチームは2つ目のパスから始め、1つ目のパスが間違っていたことに気づきます。この作業は通常、セールスオペレーションのリードやCRM管理者が担当し、メールを転送する営業担当者と、詳細が保存される連絡先の両方に対して説明がつくものでなければなりません。
レコードキーを選択する
送信者の完全なメールアドレスを小文字にし、プラスタグを除去して使用します。sales@ や info@ などのロールアドレスには独自の行または別の会社テーブルを割り当ててください。個人をロールアドレスにマージすると、両方が見えなくなります。
メッセージ範囲を設定する
固定期間内の受信メールから始め、抽出前に自動送信者を除外します。カレンダーの返信、no-reply通知、チケットシステムには人間の署名がほとんど含まれません。
列をフィールドとして命名する
氏名、役職、会社、固定電話、携帯、国、ソース日付。ブロブである「連絡先情報」や、曖昧な「電話」は避けてください。帰属が重要な場合は列名に入れます:このメッセージの送信者の名前。
1メッセージにつき1行を抽出する
ソース日付とメッセージ識別子を行に保持してください。同じ人物が再び現れたとき、2つの値のどちらが新しいかを決めるのはこれらの詳細です。名前付き列を中心に構築されたメールパーサーは、クライアントごとのルールセットよりもこのパスを確実に処理します。
キーでマージする
役職と電話については、最も新しい空でない値が優先されます。名前はイニシャルでない最も長い形式を保持してください。署名から法人名を取得し、ドメインは確認用としてのみ使用します。2つの値が競合し、どちらも明らかに新しいわけではない場合は、黙って選択するのではなくその行にフラグを立ててください。
インポート前にレビューする
ロールアドレス、名前の欠落、ソース内に複数の署名、レビュアーが読めないスクリプトの役職がある行を確認してください。インポートは、ある行が同僚のものであることに気づく場所としては不適切です。同じ規律が解析された列をHubSpotにマッピングする場合にも当てはまります。
| フィールド | マージルール | 理由 |
|---|---|---|
| 氏名 | 最も長い非イニシャル形式 | 「J. Rivera」と「Jordan Rivera」は同一人物 |
| 役職 | 最新の空でない値 | 人は役割が変わり、古いメールには古い役職が残る |
| 会社 | 署名ブロックの法人名 | ブランド名やメールドメインは登記上の法人名とずれる |
| 電話 | ラベルごとの最新値 | 固定電話と携帯は別のフィールドであり、競合する値ではない |
| 住所 | 最新の完全なブロック | 不完全な住所が完全な住所を上書きすべきではない |
競合を黙って解決することが、連絡先テーブルの信頼を損ないます。代わりに行にフラグを立てましょう。
ImageToTable.ai が適する範囲と、その限界
ImageToTable.ai は転送メッセージに対する抽出パスを実行できますが、メールボックスクローラーや CRM が必要な部分の手前で止まります。機能するかどうかを決めるのは処理モードです。
Email Inbox はアカウントごとに専用アドレスを付与します。メッセージをそこに転送するか、Gmail や Outlook で一致するメールを転送するルールを設定します。受信箱には3つの処理モードがあります:添付ファイルのみ、本文のみ、添付ファイルと本文。署名の作業では本文のみが該当します。署名はファイルではなくメッセージ内にあるためです。
次に行われるのが Custom Column Extraction です。欲しい列名を入力すると、AI が意味に基づいて各値を特定します。その名前が出力テーブルのヘッダーになります。署名の場合、氏名、役職、会社、固定電話、携帯が該当し、列名は値が引用されたブロックではなく送信者のブロックから取得されるべきことを示します。各メッセージは1行になります。結果は Excel、CSV、JSON としてエクスポートでき、Google Sheets アドオンは開いているシートに行を書き込むため、リストが既にある場所でマージが行われます。
Review Mode では、行を開き、セルを確認し、AI の元の値を表示し、編集を元に戻せます。マージルールがフラグを立てた行を手動でチェックする機能であり、インポート後にエラーを発見するより低コストです。
3つの限界があります。メールボックス接続や履歴クロールはありません。ツールは送信されたものを読み取るのであり、Gmail アカウントの過去10年分を読むわけではありません。署名ブロック検出器は保証されていません。メッセージを読み取り、指定した列を埋めるだけなので、署名が3つある転送スレッドも1つのドキュメントとして扱われ、帰属が誤る可能性があります。そして重複排除や CRM 同期はありません。同じ人物からの2つのメッセージは、マージしない限り2行になります。出力はテーブルであり、連絡先レコードではありません。
同じフィールドの問題は紙の上でも現れます。名刺の写真は、それを取り巻くメールのない署名ブロックです。
引き継がれるプライバシールール
仕事用のメールアドレス、役職、直通電話番号はEUおよび英国では個人データにあたるため、連絡先テーブルには適法性の根拠と保存義務が引き継がれます。ビジネスメールで目にしたデータであっても、自由に保持してよいわけではありません。
多くのチームはビジネス連絡先データについて正当な利益に依拠しています。ICOのガイダンスによれば、ビジネス連絡先は自身の職務上の情報が処理されることを比較的想定しやすいとされていますが、根拠は自動的に成立するものではありません。文書化された正当な利益の評価、必要性のテスト、均衡性のテストが必要です。直接マーケティングに対する異議申立ての権利は絶対的であり、異議はキャンペーン内の配信停止リンクだけでなく、テーブルにまで届かなければなりません(ICO)。
データ最小化は実務的な部分です。署名が提供するすべてのフィールドではなく、実際に使用するフィールドを収集してください。B2B連絡先のルーティングに個人の携帯番号やソーシャルプロフィールは必要なく、保存すれば削除請求のコストが増えます。取得元の日付を記録し、保存期間を設定し、メールボックスの所有者がテーブルの存在を把握しているようにしてください。クライアントのために連絡先を処理する場合、契約書とプライバシー通知でそれをカバーする必要があります。これはチェックリストであり、法的助言ではありません。
使用するフィールドを収集し、出所を記録し、理由がなくなったら削除しましょう。
FAQ
正規表現でメール署名を解析できますか?
メールアドレス、電話番号、URLについては可能です。氏名、役職、会社名については確実にはできません。正規表現は値の形には一致できますが、その行が役職なのか部署なのか、その番号がFAXなのか携帯なのか、そのブロックが送信者のものなのか下部に引用された人物のものなのかを判別することはできません。
スレッドからパーサーが誤った人物を選ぶのはなぜですか?
スレッドには複数の署名が含まれており、位置ベースのルールにはメッセージの帰属という概念がないためです。通常、最後のブロックは最後に書いた人物のものですが、それは引用された人物であり、処理中のメッセージの送信者ではない可能性があります。帰属が重要な場合は、1行につき1通の転送メッセージにしてください。
メール署名から確実に抽出できるフィールドはどれですか?
メールアドレス、氏名、会社、役職が信頼できる核心です。電話番号はラベルを保持している場合にのみ信頼できるため、固定電話、携帯、FAXを別々の列にしてください。住所は国によって行の順序や郵便番号の位置が異なるため、最も信頼性の低いフィールドです。
署名の解析は日本語、ドイツ語、アラビア語でも機能しますか?
ツールが意味を読むか、英語のパターンに照合するかによります。日本語の署名は会社、部署、役職、氏名がスペースなしで並ぶことが多く、部長のような役職は英語の役職リストに存在しません。ドイツ語やフランス語の役職も逆の形で同じ問題を抱えており、右から左に書くスクリプトは行順序の前提を崩します。セマンティックモデルはキーワードリストよりもうまく処理しますが、出力には依然としてレビューが必要です。
ImageToTable.aiはメールボックス全体をスキャンできますか?
いいえ。Email Inboxアドレスに転送したメッセージ、または転送ルールでそこにルーティングされたメールを処理します。メールボックス接続、過去のクロール、転送していないメールへのアクセスはありません。
メール署名から連絡先情報を保存することは合法ですか?
EUおよび英国では、評価を文書化し、必要なものだけを収集し、保存期間を設定し、異議申し立てに対応する場合、通常は正当な利益に基づきます。ダイレクトマーケティングへの異議申し立ては絶対です。EUおよび英国以外ではルールが異なるため、連絡先が所在する法域を確認してください。
署名は慣習であり、フォームではない
署名はメッセージを丁寧に締めくくるために設計されたものであり、データベースにデータを投入するためのものではありません。だからこそ、そのブロックには信頼できるマーカーがなく、同じ人物が5通のメールで2つのレコードのように見えることがあります。抽出ステップは自動化できますが、どの行が誰のものか、どの値が最新かという判断は、依然として受信箱に関する判断です。
知っている署名を含むメールを転送し、実際に必要な列に名前を付け、その行が期待した人物のものかどうかを確認してください。最初の誤った署名者は、CRMへのインポートで見つけるよりもそこで見つける方が安上がりです。