すべてのECF通知はドケットの1行
になるのを待っている
Notice of Electronic Filing(NEF)は、普通のメールと間違えやすいものです。裁判所は文書が提出された瞬間にこれを生成し、事件番号、文書番号、提出日、ドケットテキスト、送達先リストがすべてメッセージ本文に含まれた、通常の連絡のように見える形で届きます。記録はすでに構造化されています。ただし、列ではなく段落に分散しているため、多くの法務チームは今でも各通知を開いて読み、スプレッドシートやケース管理システムにフィールド単位で打ち直しています。
重要なポイント
- 裁判所の通知はすでにデータレコードであり、事件番号、提出日、ドケットテキストが列ではなく固定フィールドに格納されています。
- メールボックスに汎用パーサーを向けても失敗します。データはメッセージ本文にあり、裁判所ごとに通知のレイアウトが異なるためです。
- 列を一度指定すれば、AIが各フィールドを意味で読み取るため、単一のテンプレートでどの裁判所の通知も処理できます。
Notice of Electronic Filing(NEF)に実際に含まれる内容
Notice of Electronic Filing(地方裁判所および破産裁判所ではNEF、控訴裁判所ではNotice of Docket Activity(NDA)と呼ばれる)は、単なる通知ではありません。文書がCM/ECFに提出されると、システムが自動的に通知を生成し、事件の登録当事者にメールで送信します(PACER)。これは提出が行われたという裁判所自身の記録であり、そのためチームはこれを日常的な連絡ではなくデータソースとして扱います。
内容は固定フィールドを持つレコードとして扱えるほど一貫しています。破産裁判所の参加者ガイドには、すべてのNEFに含まれる項目とサンプルが記載されています。提出日時、事件名(ケースキャプション)、ドケットへのリンク付きの事件番号、提出されたPDFへのリンク付きの文書番号、提出内容を説明するドケットテキスト、および電子受領者リストです(S.D. Miss. Bankr., NEF参加者ガイド)。 presiding judgeは通常、事件番号の接尾辞またはドケットテキストに表示され、提出者はドケットエントリに記載されています。
| フィールド | メール内の位置 | ドケットシートに必要な理由 |
|---|---|---|
| 事件名 | キャプション行 | 案件ファイルとの人間が読める照合 |
| 事件番号 | ドケットにリンクされた専用行 | 並べ替えとマージのための案件識別子 |
| 文書番号 | 提出物にリンクされた専用行 | ドケットエントリの参照 |
| 提出日時 | 先頭の取引行 | 全体の時系列のソートキー |
| ドケットテキスト | エントリの説明 | 何が提出されたか、多くの場合誰が提出したか |
| 受領者リスト | 通知の下部 | 誰に送達されたか、誰が通知を受けているか |
| 文書リンク | 文書番号のハイパーリンク | 15日以内のPDFの無料閲覧1回 |
この通知は、名前付きフィールドを持つデータレコードです。欠けているのは、それらのフィールドを列に変換する仕組みがないことです。
最後の行には、メールの扱い方を変える小さな運用上の詳細があります。各NEFは、受領から15日間有効で、1回の閲覧に限り、提出されたPDFを無料で閲覧できます。文書を一度取得すれば保存できますが、メールを共有受信トレイに置いたままにすると無料期間が終了し、以降の閲覧にはPACERの料金がかかります。
裁判所メールの手動処理が破綻する場面
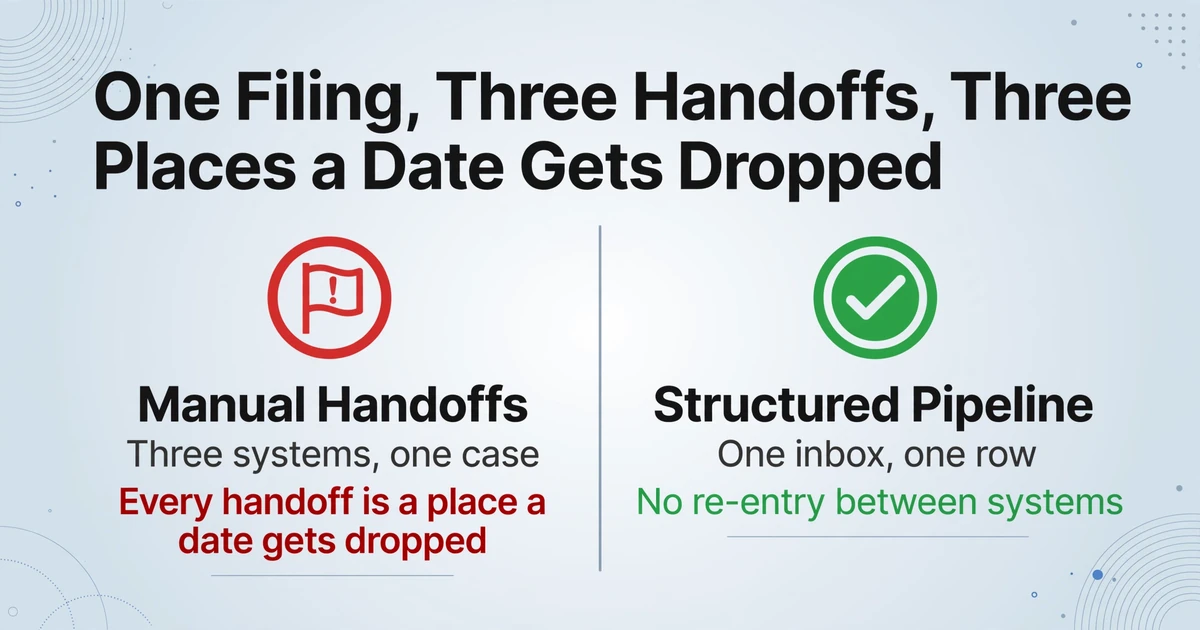
手動処理が失敗する理由は、労力というより構造にあります。同じ通知が複数の受信箱に送られ、届くものの大半は定型業務であり、重要な一件が他のものと見分けがつかないために、処理が破綻します。
まず、通知の拡散から見てみましょう。一件の提出は、事件の登録当事者全員に通知を生成し、事務所は複数の担当者が対応できるよう、それらの通知を共有アドレスにルーティングするのが一般的です。複数の地区と数十件の進行中の事件にわたって提出状況を追跡している事務所は、1日に数通のメッセージを読んでいるわけではありません。各メッセージが潜在的な行となる大量のストリームを監視しており、担当者はどの行を最初に処理すべきかを判断しなければなりません。
次に、ツールの問題があります。複数の連邦地区で人身傷害事件を扱う実務家は、2026年のr/paralegalスレッドで現実を次のように述べています。PACER通知は一貫性なく発火し、ルールベースのカレンダー管理ツールは期限を捉えますが提出を見逃し、地元ルールのスプレッドシートはその年にすでに2回、最新情報から逸脱していました。問題全体を捉えているのは、引き継ぎに関する次の一文です。「1つの事件に3つのシステムがあり、すべての引き継ぎが日付を失う場所になっている」(r/paralegal)。再入力自体がリスクなのではありません。リスクは、同じ事実が各引き継ぎで再入力され、各引き継ぎがそれを失う機会になることです。
通知自体も単一障害点です。通知は記録上の当事者に送られますが、共有アドレスにフィルタリングされたり、スパムフォルダに入ったり、その週に休暇中のパラリーガルに届いたりすると、背後に自動的な第二のチャネルはありません。出廷日や回答期限が付いた通知を見逃すことは、事務所が後から修復できない数少ない管理上のエラーの一つです。
このタスクは、開封、読解、再入力に依存するため、拡張性が低く、法的な結果を伴う部分こそ、受信箱が満杯のときに圧縮される部分です。誰も不注意でなくても、日付がすり抜ける可能性があります。
汎用メールパーサーでは対応できない理由
最初に思いつく解決策は、メールボックスにメール解析ツールを向けることですが、ここで最初の誤った前提が生じます。ほとんどのメール抽出ツールは、データが添付ファイル、仕入先請求書、またはPDFで届く領収書にあるケース向けに作られています。NEFには解析する価値のある添付ファイルがありません。事件番号、提出日、ドケットテキストはメッセージ本文にプレーンテキストとして含まれており、これはそれらのツールが想定する形式とは正反対です。受信パイプラインが添付ファイルのみを読み取る設定になっている場合、何も取得できません。
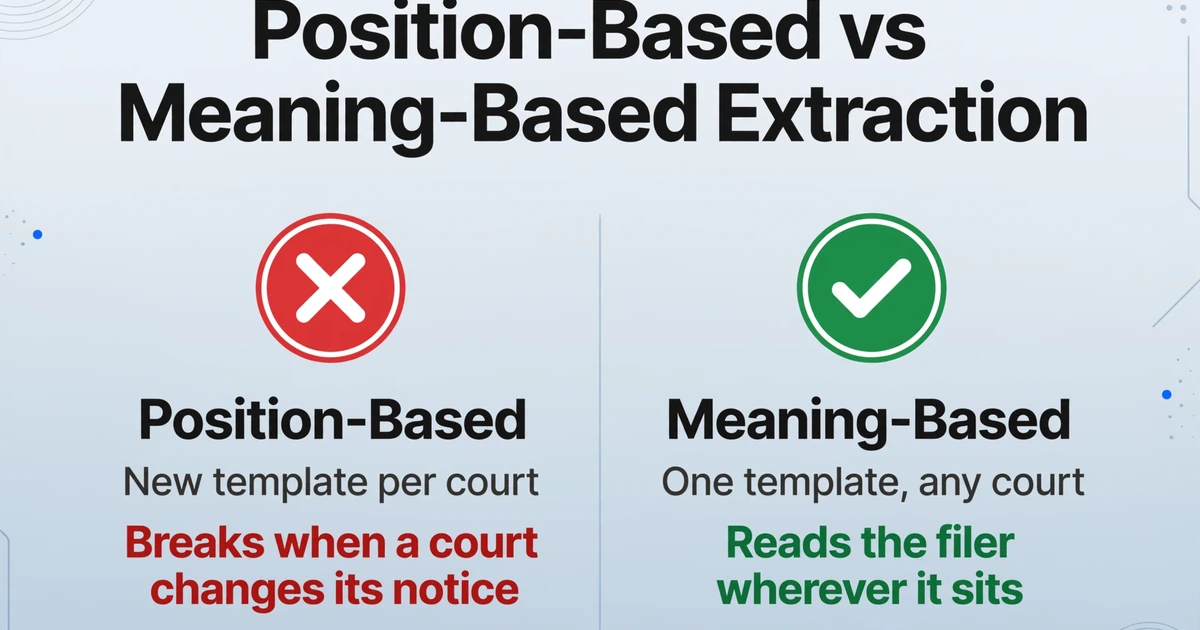
2つ目の問題は形式です。連邦地方裁判所と破産裁判所はそれぞれ独自のCM/ECFインスタンスを運用しているため、フィールドのセットは安定していても、正確なレイアウト、行の順序、ドケットテキストの表現は一定ではありません。テンプレートや描画されたゾーンのセットを使用して位置で抽出するツールは、裁判所の形式ごとに新しいテンプレートが必要になり、裁判所が通知を変更するたびに動作しなくなります。3つの地区で業務を行う事務所の場合、最初の通知を処理する前に、3つのテンプレートを構築して維持する必要があります。同じ問題は、ソースのレイアウトが自分の管理外にある場合、メールからの構造化データ抽出全般にも当てはまります。
代わりに有効なのは、位置ではなく意味を読み取ることです。Filerという名前の列が必要だとツールに伝えると、フィラーが何であるかを理解しているため、特定の裁判所の通知でその行がどこにあるかに関係なく、ドケットテキスト内のフィラーを特定します。これが座標の照合とフィールドの理解の違いであり、裁判所ごとのテンプレートを不要にする理由です。
ドケットスプレッドシートで名前を付ける列
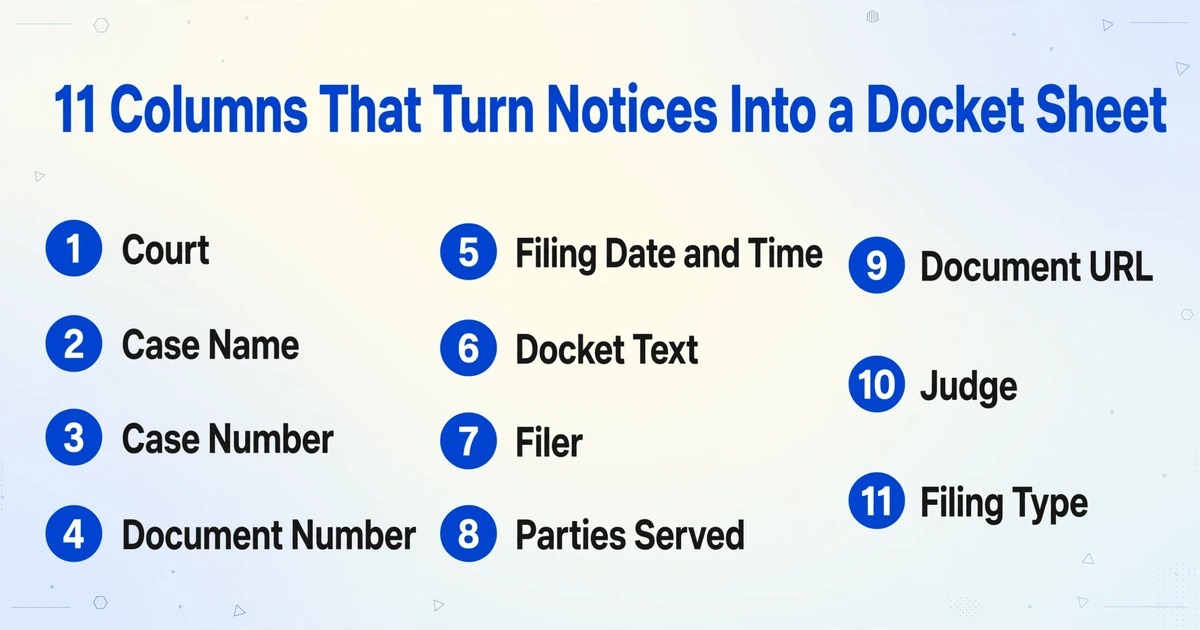
目指す出力は、通知ごとに1行で、通知のフィールドを選択した列にマッピングしたものです。これはカスタム列抽出に自然に適合します。列名を入力すると、AIが各フィールドの意味を理解してメールから一致する値を特定して入力します。場所ではなく意味で判断するためです。入力した列名が最終テーブルのヘッダーになります。
ECF受信トレイの場合、通知自体から得られる実用的な列セットは次のようになります。
- 裁判所(通知を送信した地方裁判所または破産裁判所)
- 事件名
- 事件番号
- 文書番号
- 提出日時
- ドケットテキスト
- 提出者
- 送達対象当事者
- 文書URL
基本が整ったら、さらに2つの列が加わります。裁判官列は事件番号の接尾辞またはドケットテキストから担当裁判官を取得し、提出種別列はストリームをカテゴリに分類します。提出種別は推論列の良い活用例であり、ツールが直接抽出とともにサポートする3つの列モードのうちの1つです。推論列では許可値を指定します。例えば提出種別(オプション: Motion, Order, Notice, Complaint, Scheduling, Other)のように指定すると、AIがドケットテキストを読み取り、通知に「提出種別」という文字が印刷されていなくても適切なラベルを割り当てます。この1つの列で、フラットな通知リストをカテゴリでフィルタリングできるものに変えます。
また、日付列が何であり何でないかを正確に理解する時でもあります。提出日は通知に明記されているため抽出されます。計算された応答期限は、管轄固有のルールと提出種別に依存するため抽出されません。その計算は、カレンダー管理ルールとその責任者に任せるべき場所に留まります。通知以外でも、希望するフィールドに名前を付けるという同じ規律が適用されます。詳細は契約書から主要な用語を抽出するをご覧ください。
ECF通知を構造化シートにルーティングする方法
これを実用的にする仕組みはEmail Inboxです。すべてのアカウントには専用の受信アドレスが割り当てられ、そこに転送されたメールは、誰もポータルにログインすることなく処理キューに入ります。裁判所の通知で最も重要な設定は、受信ボックスが読み取ることを許可される内容です。デフォルトでは添付ファイルのみですが、メール本文のみ、または添付ファイルと本文の両方を処理するように切り替えることができます。NEFはデータを本文に含むため、本文モードがワークフロー全体を機能させる設定です。
裁判所の通知先にアドレスを追加する
Email Inboxのアドレスをコピーし、CM/ECFアカウントの副次的な受信者として追加するか、事務所のメールボックスにNEFおよびNDAメールを転送するルールを設定します。どちらの方法でも、弁護士が自分のコピーを受け取る方法を変えることなく、通知を一か所に集めることができます。
受信ボックスをメール本文の読み取りに切り替える
デフォルトの添付ファイルのみモードはやめましょう。裁判所の通知データはメッセージ本文に含まれるため、受信ボックスを本文、または本文と添付ファイルを一緒に処理するように設定し、送信者ホワイトリストを有効にして、裁判所と事務所のアドレスだけがキューに届くようにします。
列を一度だけ定義する
前のセクションのドケット列を保存済みテンプレートとして入力します:裁判所、事件名、事件番号、文書番号、提出日時、ドケットテキスト、提出者、送付先当事者、文書URL、裁判官、提出種別。抽出は意味論的に行われるため、同じテンプレートが異なる裁判所からの通知を処理できます。
テンプレートで自動処理を有効にする
テンプレートを受信ボックスにバインドすると、通知が届いた瞬間に処理が開始されます。各通知は独自の行になり、処理はバッチファースト処理であるため、複数の裁判所からの通知がメールごとのファイルではなく、1つのテーブルに集約されます。
行を確認してから次へ進める
提出日でテーブルを整理し、日付や期限を含むエントリを確認します。Review Modeでは、セルにカーソルを合わせて値をそのソースまで追跡できるため、事件番号や提出者名の確認は数秒で完了します。Excel、CSV、JSONにエクスポートするか、Google Sheetsに書き込むか、v1 APIを通じて構造化出力を取得し、クリオ、マイケース、ファイルバインなどの記録システムにインポートします。
このワークフローは意図的に範囲を絞っています。受信ボックスでの読み取りと再入力の作業を排除し、解釈は元の場所に残します。すでに通信から構築した事件の時系列を保持している場合、同じ行ごとのドキュメントロジックがメールスレッドから事件の時系列を構築するにも適用されます。
対象外となる機能
裁判所データは過剰な期待を招きやすいため、ファームのワークフローを構築する前に、その境界を明確にしておくことが重要です。
ネイティブのPACERまたはCM/ECF統合はありません。 このツールは、すでに受信している通知メールを読み取ります。PACERにログインしてドケットを照会したり、書類を取得したりすることはなく、通知を受けていない事件を閲覧することもできません。
ケース管理システムとのコネクタはありません。 出力は、ユーザーが管理するスプレッドシートです。Excel、CSV、JSON、Google Sheetsへの行の書き込み、またはv1 APIを通じて取得される構造化データが該当します。これらの行をClio、MyCase、Filevineに取り込むことは、ユーザー自身のワークフローで定義されたステップであり、自動同期ではありません。また、それらのシステム名を挙げたことで、そのような統合が示唆されるわけではありません。
ドケッティングシステムではなく、期限の計算も行いません。 提出日とドケットテキストを抽出し、エントリにフラグを付けることはできますが、地方規則に基づく応答期限の計算は、カレンダリングルールと担当者に委ねられる別の機能です。抽出されたシートはドケッティングへの入力として扱い、その代替とはみなさないでください。
裁判所の形式は異なるため、拡大前にテストしてください。 フィールドセットは安定していますが、レイアウトやドケットの文言は裁判所によって異なります。各管轄区域の実際の通知をいくつかテンプレートに通し、列が期待どおりに配置されることを確認してから、受信トレイ全体を対象にしてください。
検証はユーザーの責任です。 ABA Formal Opinion 512に基づき、生成AIツールを使用する弁護士には、能力、機密保持、監督の義務が課され、出力を依拠する前にレビューする必要があります(American Bar Association)。抽出は転記を省くものであり、判断を省くものではありません。このワークフローにおけるレビューのステップこそ、その判断が行われる場です。
よくある質問
NEFと第三者製のドケットアラートの違いは何ですか?
NEFは、提出が発生した際に裁判所のCM/ECFシステムによって生成され、事件の登録当事者への法的通知および送達の役割を果たします。ドケットアラートは、事件活動に関する通知を指すより広い用語であり、多くの場合モニタリングサービスから提供され、裁判所自身の通知ではありません。このワークフローは裁判所の通知を対象として構築されているため、フィールドセットは第三者製のアラート形式ではなくNEFに従っています。
ECF通知メールから取得できるフィールドはどれですか?
通知自体に、事件名、事件番号、文書番号、提出日時、ドケットテキスト、提出者、送達対象当事者、および文書リンクが含まれています。裁判官の列は事件番号の接尾辞またはドケットテキストから導出でき、提出種別の列はドケットテキストから推論できます。提出日は記載のとおり抽出されます。応答期限は計算されません。
添付ファイルが必要ですか、それともメール本文を読み取れますか?
メール本文を読み取ることができます。受信トレイはデフォルトで添付ファイルのみを処理する設定になっており、その設定では事件データが本文にあるためECF通知を見逃してしまいます。本文を処理する設定、または本文と添付ファイルの両方を処理する設定に切り替えると、通知自体のテキストが情報源になります。
裁判所の期限を計算しますか?
いいえ。提出日とドケットテキストを抽出します。これはドケッティングまたはカレンダー処理の入力として必要なものですが、現地の規則を適用したり応答期限を計算したりはしません。その計算はカレンダーシステムに委ねられ、法的レビューが必要です。
これはクリオ、マイケース、またはドケッティングサービスを置き換えますか?
いいえ。これは、誰かが裁判所のメールを開いて事件番号、提出日、ドケットテキストをスプレッドシートに打ち直す手順を置き換えるものです。ケース管理システムは引き続きシステム・オブ・レコードであり、ルールベースのドケッティングサービスもその役割を維持します。抽出機能は、それらのツールに供給するクリーンな行を提供するものであり、それらに取って代わるものではありません。
ECF通知は、ドケットシートに欠けている行です。列を一度定義すれば、各通知が独自の事件番号、提出日、提出者、ドケットテキストを提供するため、すべての裁判所からの情報が1つのテーブルに集約され、並べ替えが可能になります。提出の意味とそれが何を引き起こすかについての判断は、それを担う人々に委ねられます。打ち直しはその必要はありません。