ケースクロノロジーは
メールスレッドの中にある
小規模事務所のパラリーガルにクロノロジー作成で時間がかかる理由を尋ねると、その答えが表そのものにあることはほとんどありません。ケースクロノロジー(ケースタイムラインまたはイベント年表とも呼ばれます)は、紛争における主要なイベントを日付順に並べたリストであり、各項目にはそれを裏付けるドキュメントや証言が紐付けられています。列はシンプルです。シンプルでないのは、何百通もの転送メッセージを読み、返信チェーンにある3つの日付のうちどれが重要かを判断し、それを1行に入力することです。タイムラインが成果物であり、メールがボトルネックなのです。
重要ポイント
- ケースクロノロジーは表作成の問題のように見えますが、実際には読解の問題です。
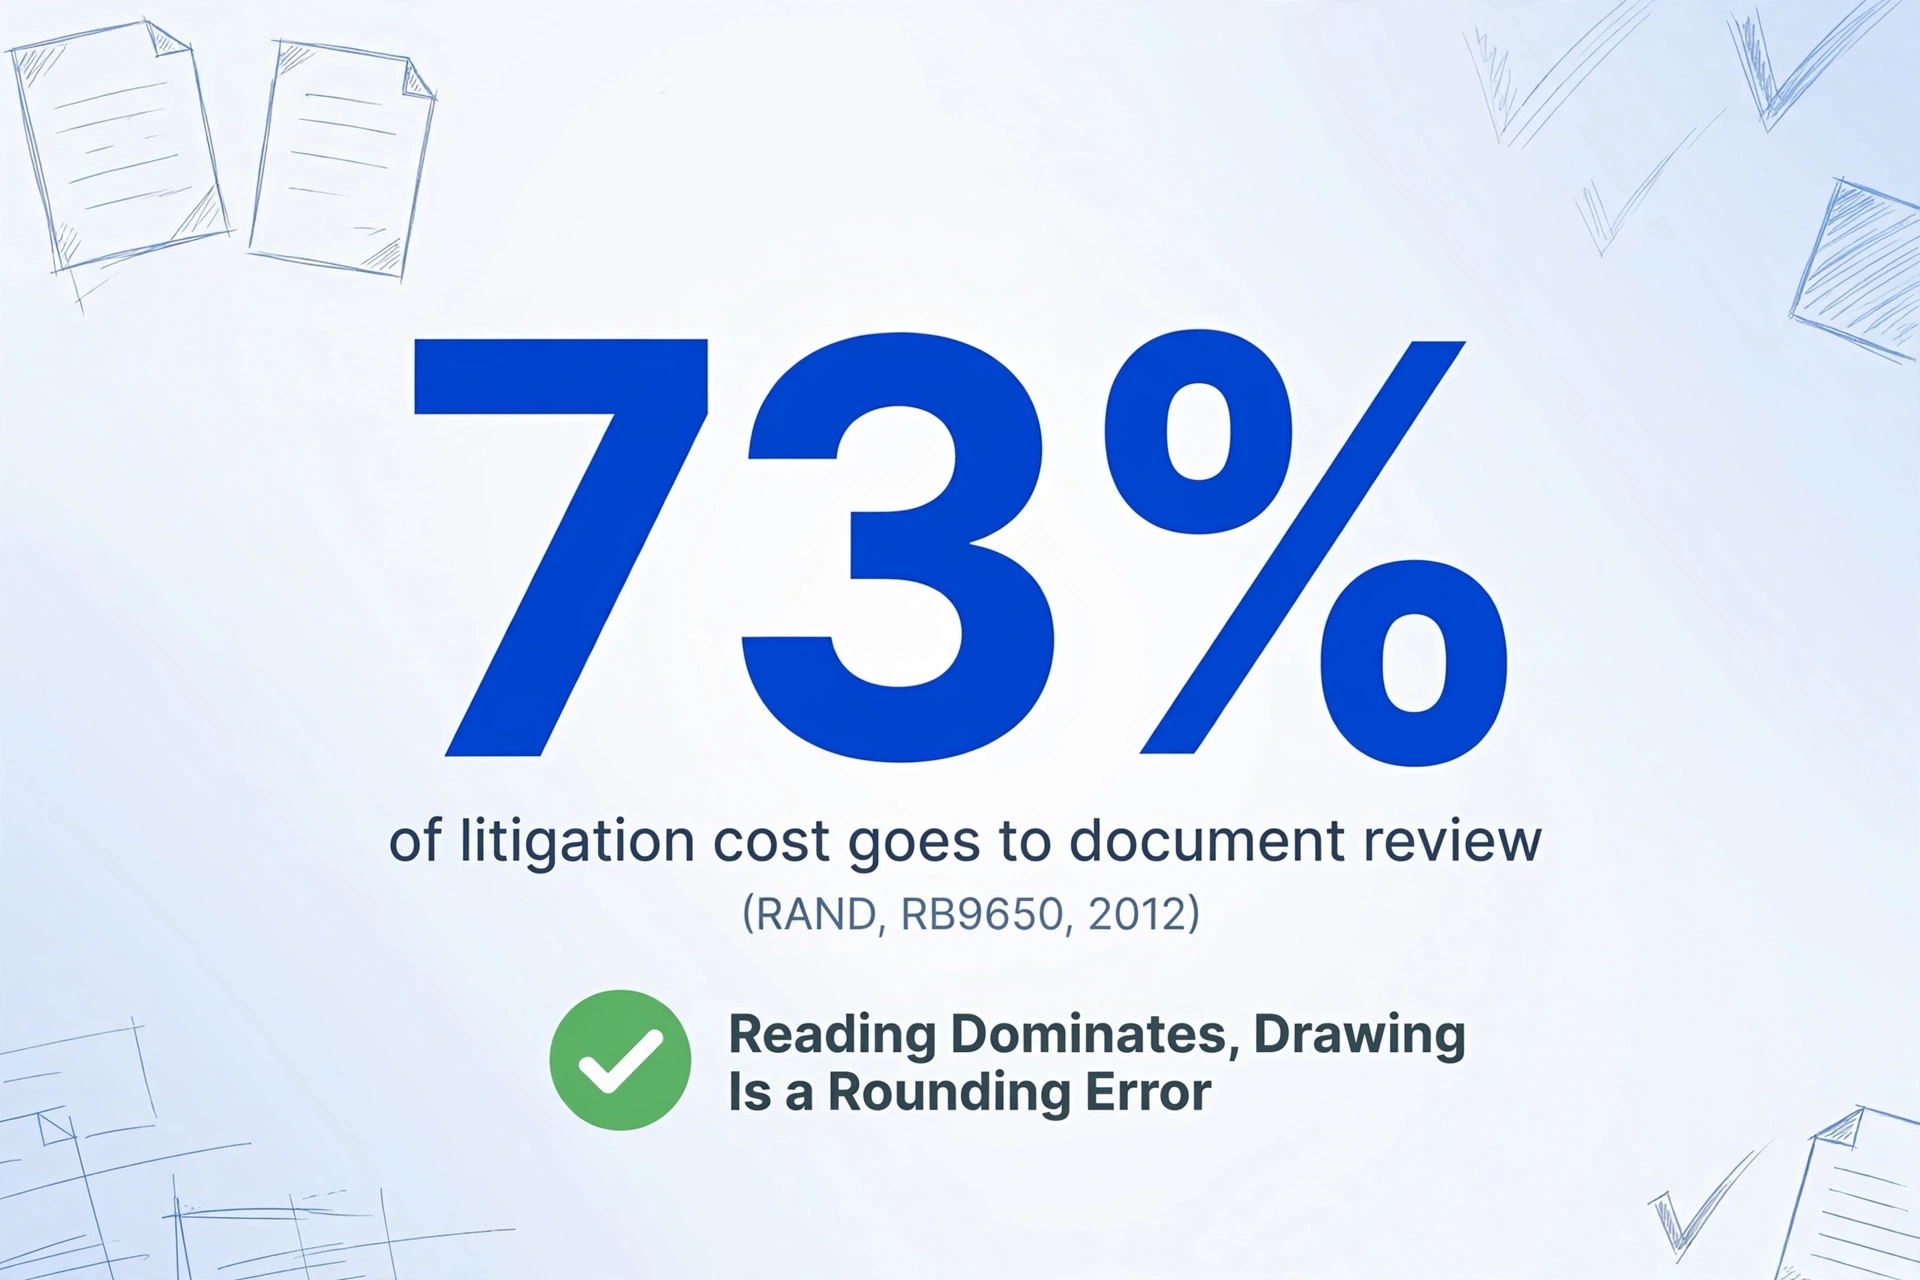
- 証拠提出にかかるコストの73%はドキュメントレビューに費やされており、熟練したレビュアーでも1時間あたり約100ドキュメントが上限です。
- 列を一度定義すれば、すべての転送メッセージが1行として取り込まれるため、タイムラインは並べ替え1つで完成します。
ケースクロノロジーの作成は簡単。読むことが本質的な作業です。
訴訟実務家は、ほぼすべての段階でクロノロジーを必要とします。証人の宣誓証言の準備、相手方弁護士に先んじて証拠の隙間を見つけること、請求が時効期間内にあるかを確認すること、クライアントや保険会社に和解の方針を説明することなどに使用します。これらの用途はすべて、同じものに依存しています。つまり、各イベントを時系列で並べた行と、ソースへの引用です。この構造を学ぶのは1時間で済みますが、データを入力するには数日かかります。
その理由は、時間を費やすのは図表の作成ではなく、ドキュメントレビューだからです。大規模訴訟に関するRANDコーポレーションの調査では、レビューが証拠提出にかかる総コストの73パーセントを占め、経験豊富なレビュアーでも1時間に約100ドキュメントが限界であることが判明しました(RAND, RB9650, 2012)。小規模事務所ではそのようなボリュームは扱いませんが、比率は同じです。読むことが大部分を占め、図表の作成は誤差程度にすぎません。
クロノロジーの作成自体は難しくありません。何かを描き始める前に、1通1通のメールを読み込んで情報を得ることが難しいのです。
この読むというステップには、コストに加えて専門職としての義務が伴うようになりました。2024年7月に発行された米国弁護士会の正式意見512は、生成AIツールに能力保持義務、クライアント秘密保持義務、監督義務を適用しています。AIを使用してクライアントの通信文を読むことは許可されていますが、弁護士はツールを理解し、入力される情報を保護し、出力結果を検証する必要があります(ABA正式意見512)。したがって、目的は弁護士をプロセスから排除することではありません。再入力作業を排除し、判断に時間を費やせるようにすることです。
実用的なケースクロノロジーには5つの列があり、各行に引用が必要
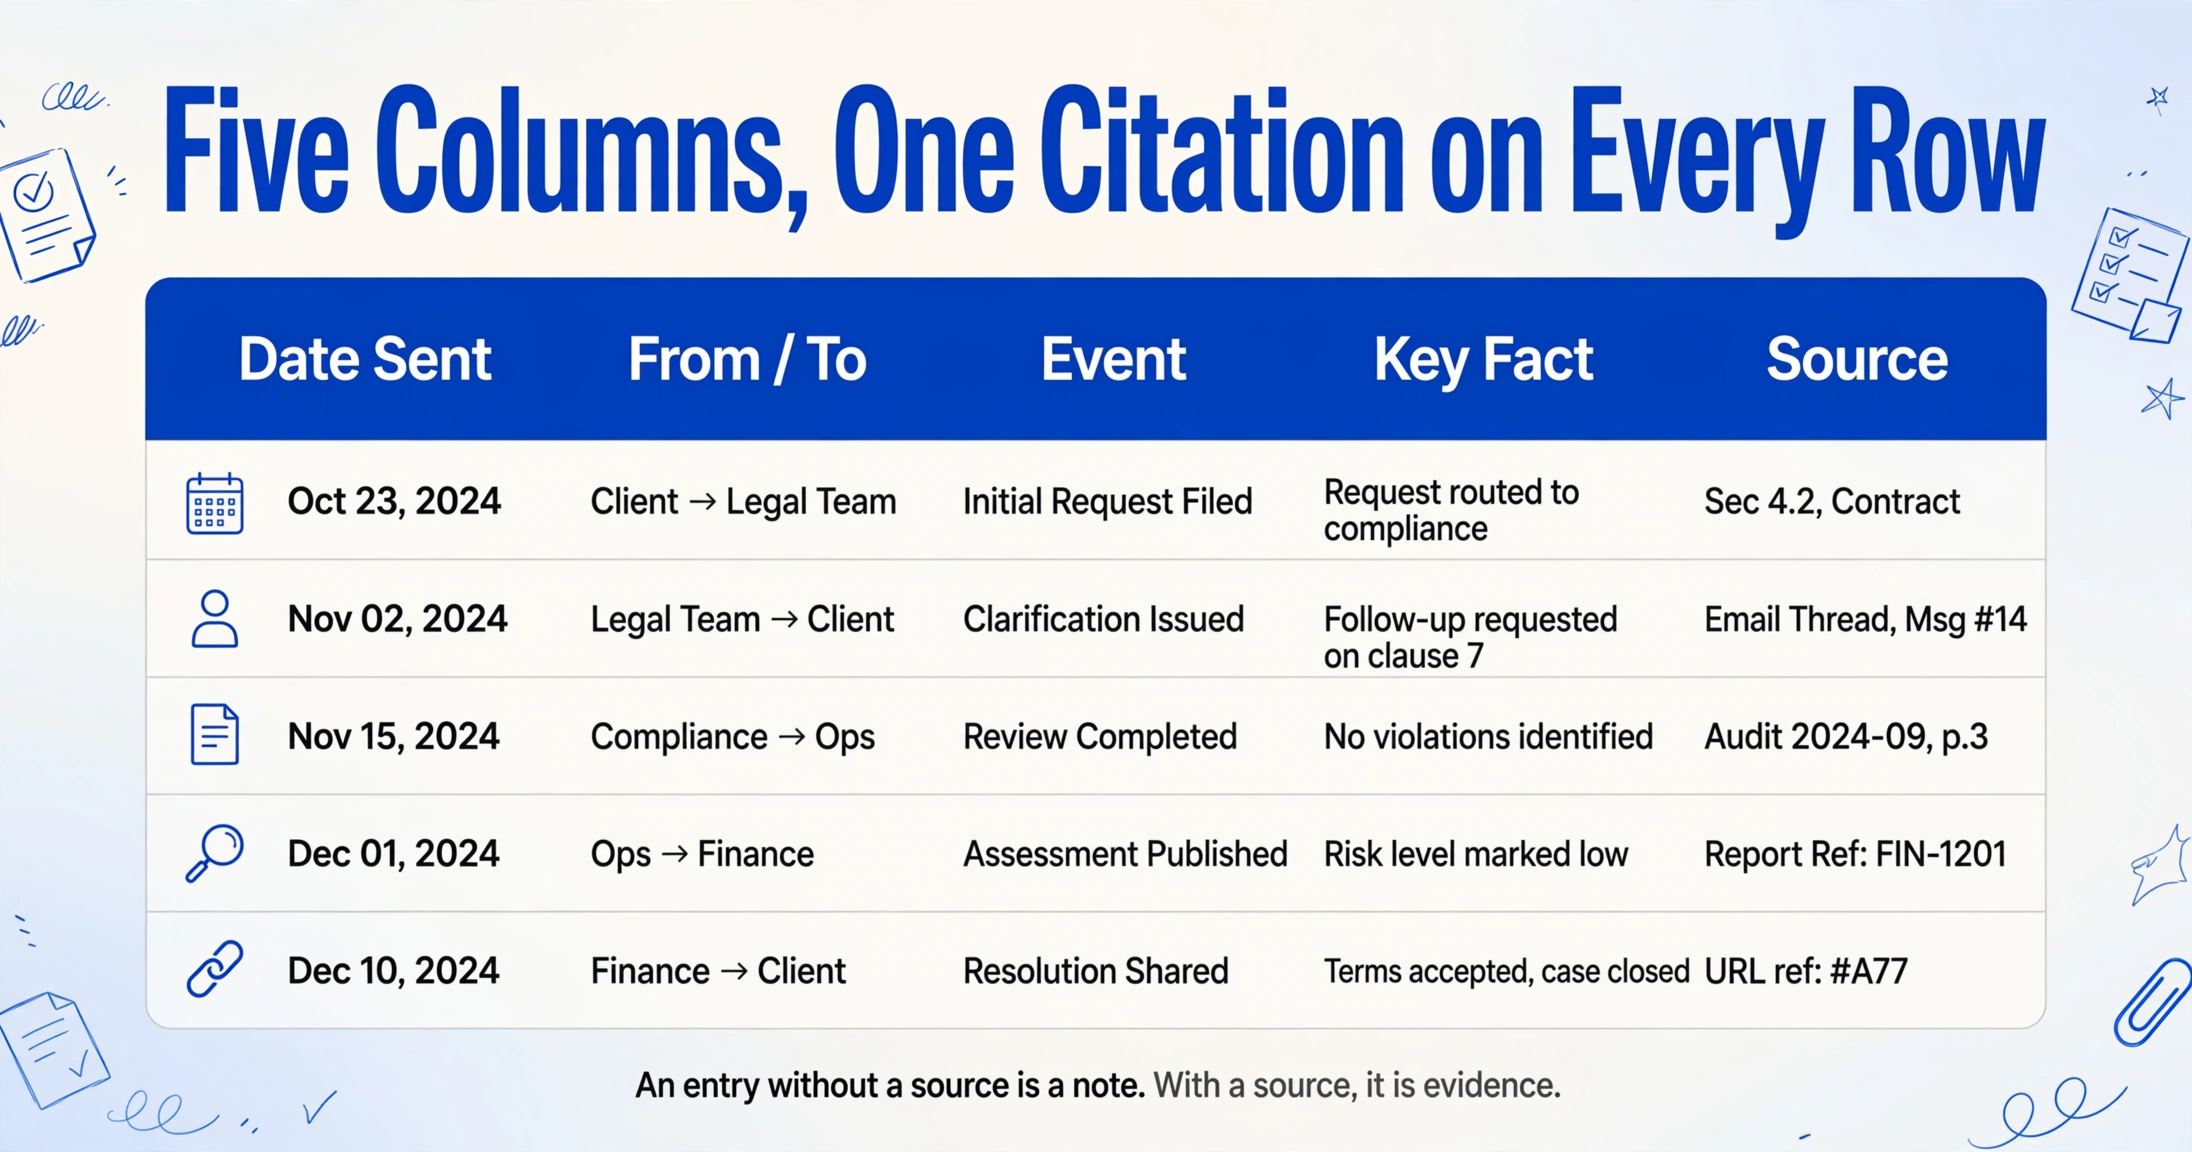
ツールを比較する前に、出力結果がどうあるべきかを明確にしておくと役立ちます。メール問題は結局のところ列の問題だからです。対応から作成したケースクロノロジーは、メールクロノロジーやメールタイムラインと呼ばれることもあり、他のものと同じ基本構造を持っています。日付、イベント、当事者、立証される事実、各行のソースです。裁判所や保険会社が受け入れるクロノロジーには、これら5つすべてが揃い、引用されている必要があります。
| 列 | 内容 | 重要度 |
|---|---|---|
| 送信日 | YYYY-MM-DD、メッセージが送信された日付。転送日とは区別されます | この列で並べ替えることで、山積みのデータがタイムラインに変わります |
| 差出人/宛先 | 送信者と受信者を、名前とアドレスで示します | 誰が、いつ、何を知っていたかを立証します |
| イベント | 何が起こったか、合意されたかを一行で説明します | 叙述の背骨となります |
| 重要事実 | メッセージに含まれる自認、指示、警告、または矛盾点 | 重要でない200行から、重要でない20行を区別します |
| ソース | 件名と日付、または添付ファイルの参照情報で、正確なメッセージを示します | ソースのない項目は単なるメモです。ソースがあれば証拠となります |
電子記録の場合、ソース列は飾りではありません。連邦民事訴訟規則は、電子的に保存された情報を独自のカテゴリとして扱い、規則26は発見の対象範囲を定義しており、事案の必要性への比例性も含まれます(FRCP規則26)。規則34により、要求側は情報がどのような形式で提供されるかを指定できます。そのため、メッセージに明確に遡れるクロノロジーの方が、「3月頃のメール」とだけ記載されたものより、はるかに防御力が高いのです。
メールはケースファイルの中で、クリーンな行に変換するのが最も難しいソースです
1つのフォワードされたスレッドには、10件のメッセージ、3つの候補日、そして信頼できる順序がない場合があります。そのため、どのタイムラインソフトウェアを使用しても、取り込み段階で作業が停滞します。リーガルタイムラインのコンテンツを占める文書(警察報告書、宣誓供述書、医療記録、訴状)は、それぞれ1つのファイルに1つの日付が付いています。しかし、メールは会話として届きます。会話は、分解せずに行に収めることはできません。
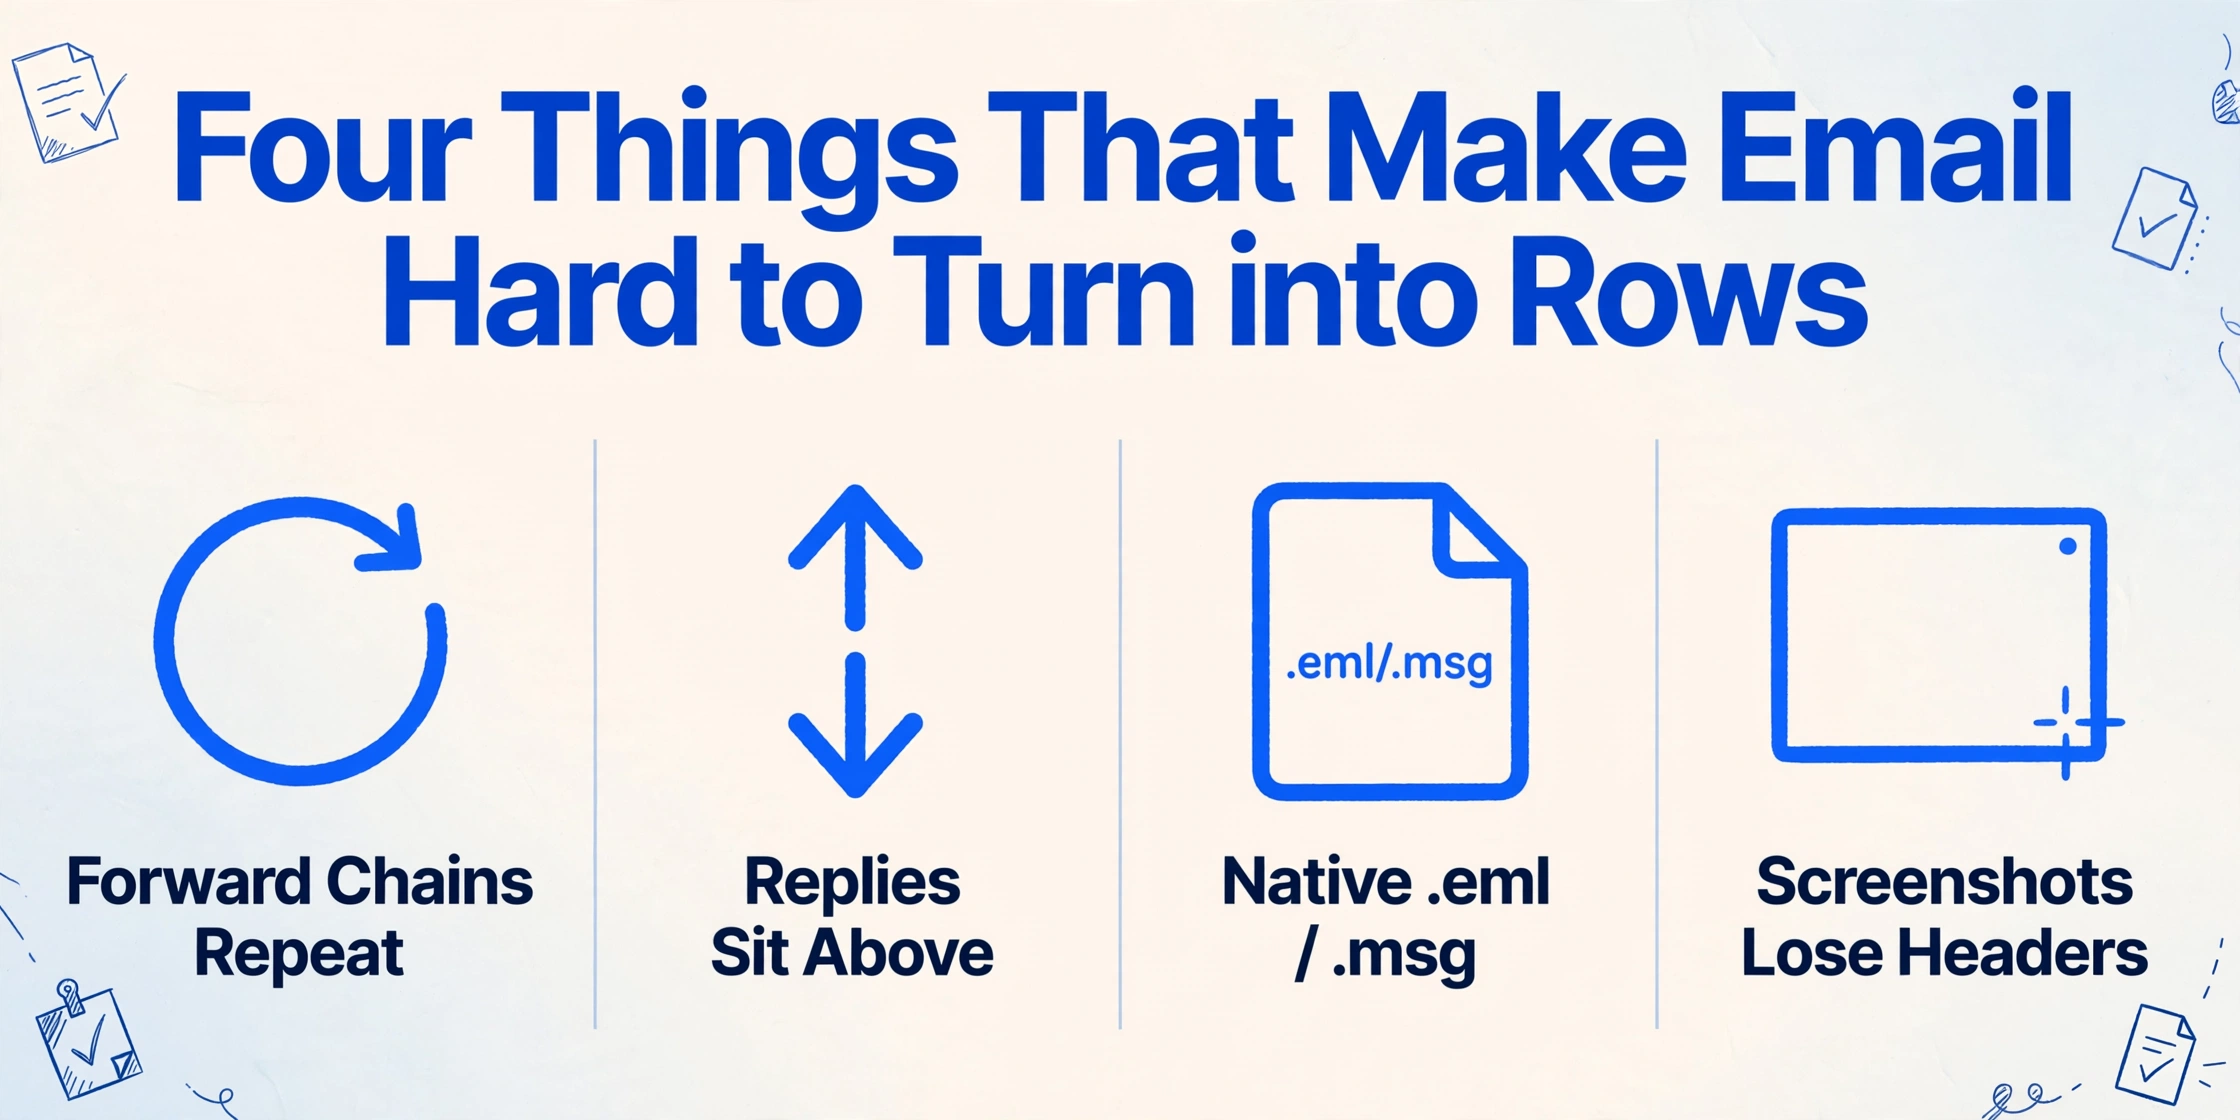
分解を難しくしているのは4つの点です。フォワードチェーンは、新しいメッセージの下にある古いメッセージをすべて引用するため、同じイベントが複数回表示され、引用されたコピーには異なる表示時刻が示されることがよくあります。返信は、返信先のメッセージの上に表示されるため、上から下に読んでも順序通りにはなりません。ネイティブの.emlおよび.msgファイルは、ほとんどの抽出ツールが受け入れるPDFや画像ではなく、メールボックスのエクスポートです。そして、クライアントが最も速く送信できるスレッドのスクリーンショットは、差出人と宛先のヘッダーが完全に失われます。
この作業を行う人々は、この記事の他の部分と同じ言葉でボトルネックを説明しています。r/paralegalでは、ある訴訟支援のコメンテーターが仕事全体を「本当の作業は抽出・正規化・順序付けだ」と要約し、詳細レベルの適切さを見つけるのが難しいと付け加え、「粗すぎると因果関係を見逃し、細かすぎるとノイズになる」と述べています。同じスレッドで、あるパラリーガルは、ブックマークを手作業で整理した後、タイムラインを弁護士にメールで送ったことを説明し、無駄を正確に指摘しました。「PDFのブックマークをコピーして弁護士にメールで送れれば、打ち直す手間が省けるのにと思います」(r/paralegal)。抽出、正規化、順序付け。順序付けの前に費やされるすべての分は、ケースに費やされない分です。
これは、宣誓供述書や医療記録などのディスカバリー文書から事実を引き出すことで既にカバーされている問題よりも狭い問題です。そこでは、ソースファイルは別々で、それぞれに独自の日付があります。メールは、入力がスレッドであるため異なり、取り込みの問題はフォーマットに本質的に内在しています。
メールスレッドを並べ替え可能な列に変換し、時系列に並べる
メールのフォルダを日付付きのケースクロノロジーに変換するには、各メッセージを行として扱い、読み取り前に列を定義します。これにより、読み取りステップはコピー&ペーストではなく入力作業になります。ImageToTable.aiは、製品にすでに存在する2つの機能でこれを実現します。メール受信ボックスは、ダウンロードや再アップロードなしでメッセージをキューに取り込み、カスタム列抽出は、メッセージの内容をクロノロジーに必要な正確な列に変換します。
メール受信ボックスは、各アカウントに専用の受信アドレスを提供します。案件に属するメッセージをそのアドレスに転送するか、自分のメールボックスに転送ルールを設定して、到着時に自動的にルーティングさせます。ログインもアップロードページも不要で、メッセージは処理キューに届きます。送信者ホワイトリストにより、無関係なメールは除外されます。ここで最も重要な設定は処理モードです。デフォルトでは、受信ボックスは実際の添付ファイルを読み取り、本文を無視しますが、これは会話のテキストに争点がある場合には適していません。本文のみ、または添付ファイルと本文の両方に切り替えることができ、プレーンテキストのメッセージとPDFが添付されたメッセージの両方を同じパスで読み取れます。
カスタム列抽出は、メッセージの内容をクロノロジーの列に変換します。送信日、差出人/宛先、件名、イベント、重要事実、ソースなどの名前を入力すると、それらの名前が出力のヘッダーになります。AIは、固定位置やテンプレートに一致させるのではなく、意味を理解して各値を特定するため、フォワードチェーン、プレーンメッセージ、引用返信を含むメッセージもすべて同じ方法で読み取られます。メールはHTMLであり、HTMLテーブルや引用ブロックは予測どおりに整列しないため、意味による読み取りが、異なる形式でメールを作成する送信者間でヘッダーを安定させる鍵となります。
バッチ処理により、すべてのメッセージが1つのシートにまとめられ、クロノロジーは1回の並べ替えで完成します。セット全体を一度にアップロードまたは転送すると、メッセージは1つのExcelファイルに統合され、各行が1メッセージになります。送信日の昇順で並べ替えると、タイムラインが表示されます。差出人/宛先でフィルタリングすると、一方の当事者の会話を抽出できます。重要事実の列をスキャンして矛盾を確認するのは、証人の供述を文書と照合するのと同じ方法です。
メールをキューにルーティングする
案件のメッセージをアカウント専用の受信ボックスアドレスに転送するか、転送ルールを設定して自動的に届くようにします。送信者ホワイトリストを有効にして無関係なメールを除外し、添付ファイルと本文を選択して、テキストにストーリーが含まれるメッセージも読み取れるようにします。
クロノロジーの列名を一度設定する
送信日、差出人/宛先、件名、イベント、重要事実、ソースを入力し、テンプレートとして保存します。列名が出力のヘッダーになります。テンプレートをバインドして自動処理を有効にすると、メッセージが届いた瞬間に抽出が開始されます。
結合したシートを並べ替えて検証する
すべてのメッセージが1つのスプレッドシートの行として表示されます。送信日で並べ替えて案件を時系列で読み、当事者でフィルタリングし、重要事実で自認や矛盾を確認します。引用返信によってソースが曖昧になった行では、セルにカーソルを合わせると、値がどのテキストから取得されたかを正確に確認できます。
検証ステップには価値があります。フォワードチェーンでは同じ日付が複数回繰り返されることがあるためです。ImageToTable.aiのレビューモードは、抽出されたセルの背後にあるソーステキストを強調表示するため、行がどの日付のコピーから取得されたかを確認するのは、読み直すのではなく一目で済みます。これは、メール添付ファイルで行う既存の作業、たとえばメッセージに添付されたファイルを読み取るメールパーサーや、法的調査文書を1つのシートにバッチ生成するで説明したのと同じバッチ処理アプローチと並行して機能します。
ファイルは安全に処理され、保存されません。
これが行わないこと
このアプローチはメールの内容を並べ替え可能な列に読み込みますが、ネイティブのメールボックスメタデータを保持せず、eDiscoveryプラットフォームを置き換えるものではなく、それだけで裁判所提出用の証拠を作成するものではありません。この上にワークフローを構築する前に、5つの境界を明確にしておく価値があります。
ネイティブの.emlおよび.msgファイルは、先に変換するか転送する必要があります。 生のメールボックスエクスポートは、ツールが直接アップロードするファイルではありません。PDFに変換するか、メール受信ボックスを通じてメッセージを転送すると、入力になります。これは聞こえる以上に重要です。クライアントから資料を収集する方法を形作るからです。
差出人、宛先、送信日の列は、元のメールヘッダーではなく抽出された値です。 これらはメッセージが読者に表示する内容に基づいています。これは通常、クロノロジーには十分であり、eDiscoveryプラットフォームが記録する生のヘッダー、タイムゾーンオフセット、配信経路とは同じではありません。認証のために元のヘッダーが必要な場合は、ソースのメールボックスから作業してください。
機密性の判断は引き続きあなた次第です。 ABA正式意見512に基づき、クライアントの通信をAIツールに入れることは、能力とクライアントの機密性に関する判断です。案件をツールに通す前に、各ツールがファイルをどのように処理し保持するかを確認してください。
これはeDiscoveryプラットフォームではありません。 特権ログ、ベイツ番号付け、クロスカストディアンのメールスレッド化、予測コーディングはありません。数万件のドキュメント、テラバイト規模のデータ、または防御可能な提出形式を伴う案件では、レビュープラットフォームがその作業を処理し、軽量な抽出ツールとフルプラットフォームの選択は、小規模事務所向けのレビューソフトウェアとAI抽出の比較で示されているまさにその比較です。ツールの全体像については、法務チーム向けドキュメント抽出ソフトウェアのガイドで各タイプの位置づけが説明されています。
出力はあなたが管理するスプレッドシートです。 Excel、CSV、JSONファイル、またはGoogle Sheetsに書き込まれた行が得られます。これはクライアント向けの可視化やコラボレーションの表面ではなく、ClioやMyCaseが提供するケース管理システムを置き換えるものではありません。これは、誰かがメールを読んで日付を入力するワークフローの部分を置き換えます。
FAQ
転送されたメールスレッドから日付や差出人を抽出できますか?
はい。セット内の各メッセージが1行になり、送信日、差出人/宛先、件名、重要事実など、定義した列がメッセージの内容を読み取って埋められます。古いメッセージを繰り返す引用ブロックは既知の曖昧さであり、そのためレビューモードで値の出典テキストを確認できます。
元のメールメタデータは保持されますか?
出力では、メッセージが提示する内容から差出人、宛先、日付を列として抽出します。これはネイティブのメールヘッダーやタイムゾーンデータとは異なります。認証用に生のヘッダーが必要な場合は、転送ではなくソースのメール受信ボックスからメッセージを収集してください。
.emlまたは.msgファイルを直接読み取れますか?
直接はできません。生のメールボックスエクスポートは、PDFに変換するか、メール受信ボックスを経由して転送する必要があります。対応入力はPDF、JPG、PNG、WebP、AVIFであり、ネイティブのメッセージファイルは処理前に1回の変換ステップが必要です。
ケースクロノロジーにはどの列を設定すべきですか?
実用的なセットは、送信日、差出人/宛先、件名、イベント、重要事実、ソースです。イベント列には1行の説明が入り、重要事実列にはメッセージが証明する内容が入り、ソース列は正確なメッセージを指し示すため、後でどのエントリも確認できます。
これはeDiscoveryやクロノロジープラットフォームの代替になりますか?
いいえ。メールやドキュメントを並べ替え可能なスプレッドシートに読み込みますが、特権レビュー、Bates番号付与、大規模な予測コーディングは行いません。これはケース管理・レビューツールの前段階であり、生のやり取りを構造化された行に変換して、担当者がクロノロジーを迅速に構築できるようにするものです。
クライアントのメールを入力しても安全ですか?
これは、ABA正式意見512における守秘義務と能力義務に基づく専門的判断であり、回答は事務所の義務とツールのファイル処理方法によって異なります。保持・処理方針を確認し、案件に必要なものだけを送信してください。抽出処理によって、出力を使用前に検証する義務が変わることはありません。
有益な転換は次のとおりです。メールを読んで打ち直す対象として扱うのをやめ、ヘッダーがまだないテーブルとして扱い始めることです。列を一度定義すれば、メッセージがその列を埋めていき、法的タイムラインは本来あるべき姿、つまり新たに書き起こしたものではなく、何が起こったかの整列されたビューになります。